
Kursus
Bekerja dengan Llama 3
2 jam
15.7K
Masa ketika kita puas dengan model bahasa besar yang hanya bisa memproses teks sudah berlalu. Kini kita membutuhkan LLM multimodal yang mampu memahami dan berinteraksi dengan teks, gambar, dan video.
Inilah model visi Llama 3.2 11B & 90B, model multimodal open-source pertama dari Meta AI, yang mampu memproses masukan teks dan gambar.
Dalam panduan praktik ini, saya akan memandu Anda melalui proses membuat asisten dukungan pelanggan multimodal dengan bantuan Llama 3.2 dan Gradio. Di akhir tutorial ini, Anda akan memiliki aplikasi web yang sepenuhnya berfungsi yang dapat menganalisis deskripsi teks dan gambar yang diunggah untuk menghasilkan solusi bermanfaat—persis seperti asisten tiket dukungan!
Jika Anda membutuhkan pengantar singkat tentang Llama 3.2 sebelum memulai, saya sarankan membaca panduan Llama 3.2 ini.
Dalam demo praktik ini, kita akan menggunakan model Llama3.2-11B-Vision (multimodal). Sebelum mulai menulis kode, pastikan semua dependensi yang diperlukan sudah tersedia.
Kita memerlukan beberapa pustaka agar semuanya berjalan. Yang utama adalah:
Jalankan perintah berikut untuk memasang dependensi yang diperlukan:
!pip3 install -U transformers bitsandbytes accelerate peft -q
!pip3 install gradio -qSekarang, mari muat model dan processor Llama 3.2. Kita akan menggunakan pustaka transformers dari Hugging Face untuk memuat model dan processor, memastikan model berjalan di GPU jika tersedia, atau menggunakan CPU jika tidak. Sebagai model 11B parameter, model ini berjalan baik pada GPU A100 di Google Colab.
Pada blok kode di bawah ini:
tie_weight(), yang memastikan bobot pada lapisan embedding input dan output identik. Ini mengurangi konsumsi memori dan dapat meningkatkan performa.import torch
from PIL import Image
import gradio as gr
from transformers import MllamaForConditionalGeneration, AutoProcessor
def load_model():
model_id = "meta-llama/Llama-3.2-11B-Vision-Instruct"
device = "cuda" if torch.cuda.is_available() else "cpu" # Check if GPU is available
model = MllamaForConditionalGeneration.from_pretrained(
model_id,
torch_dtype=torch.float16 if torch.cuda.is_available() else torch.float32,
device_map="auto", # Automatically map to available device
offload_folder="offload", # Offload to disk if necessary
)
model.tie_weights() # Tying weights for efficiency
processor = AutoProcessor.from_pretrained(model_id)
print(f"Model loaded on: {device}")
return model, processorGradio adalah pustaka Python ringan yang memungkinkan kita dengan cepat membangun aplikasi pembelajaran mesin dengan antarmuka berbasis web. Alih-alih menulis HTML atau JavaScript yang kompleks, kita dapat mendefinisikan komponen aplikasi (seperti kotak teks, tombol, atau gambar) langsung di Python.
Berikut tampilan UI Gradio dasar:
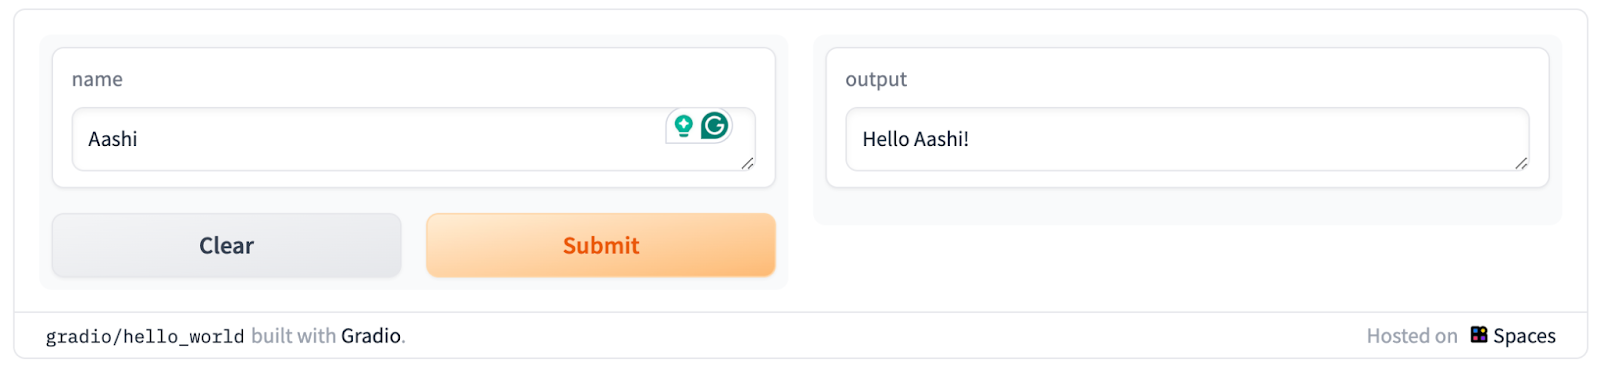
Gradio memiliki beberapa keunggulan:
Untuk demo ini, Gradio memudahkan pengguna memasukkan teks dan gambar serta melihat keluaran (analisis teks dan gambar, dalam kasus ini) secara real time. Ini sempurna untuk menunjukkan kemampuan model seperti Llama 3.2 dalam lingkungan yang ramah pengguna.
Setelah kita menyiapkan impor dan berhasil menyiapkan model, mari lanjut ke bagian utama aplikasi—memproses masukan (teks dan gambar) dan menghasilkan respons.
Kita mulai dengan mendefinisikan fungsi yang menerima teks pengguna dan, opsional, gambar. Fungsi ini kemudian menggunakan model Llama 3.2 untuk menghasilkan respons.
def process_ticket(text, image=None):
    model, processor = load_model()

    try:
        if image:
            # Resize the image for consistency
            image = image.convert("RGB").resize((224, 224))
            prompt = f"<|image|><|begin_of_text|>{text}"
            # Process both the image and text input
            inputs = processor(images=[image], text=prompt, return_tensors="pt").to(model.device)
        else:
            prompt = f"<|begin_of_text|>{text}"
            # Process text-only input
            inputs = processor(text=prompt, return_tensors="pt").to(model.device)

        # Generate response (restrict token length for faster output)
        outputs = model.generate(**inputs, max_new_tokens=200)
        # Decode the response from tokens to text
        response = processor.decode(outputs[0], skip_special_tokens=True)
        return response

    except Exception as e:
        print(f"Error processing ticket: {e}")
        return "An error occurred while processing your request."
Fungsi ini menangani dua jenis masukan dalam loop:
Setelah jenis masukan diidentifikasi, masukan tersebut diteruskan ke processor dari pustaka transformers untuk diproses. Lalu, model menghasilkan keluaran dalam batas max_new_tokens.
Antarmuka Gradio menyatukan semuanya dan memungkinkan kita menjalankan pengujian dalam format berbasis web. Antarmuka ini memungkinkan pengguna mengirimkan teks dan gambar dari masalah yang mereka hadapi dan melihat solusi yang dihasilkan AI.
Mari lihat kodenya dan kemudian kita jelaskan.
def create_interface():
    text_input = gr.Textbox(
        label="Describe your issue",
        placeholder="Describe the problem you're experiencing",
        lines=4,
    )

    image_input = gr.Image(label="Upload a Screenshot (Optional)", type="pil")

    # Output element
    output = gr.Textbox(label="Suggested Solution", lines=5)

    # Create the Gradio interface
    interface = gr.Interface(
        fn=process_ticket,  # Function to process inputs
        inputs=[text_input, image_input],  # User inputs (text and image)
        outputs=output,  # AI-generated output
        title="Multimodal Customer Support Assistant",
        description="Submit a description of your issue, along with an optional screenshot, and get AI-powered suggestions.",
    )

    # Launch the interface with debug mode
    interface.launch(debug=True)
Pada kode di atas, kita:
text_input untuk teksimage_input untuk gambardebug = True untuk menelusuri kesalahan. Setelah kode berjalan baik, ubah kembali ke False.Antarmuka akhir akan terlihat seperti ini:
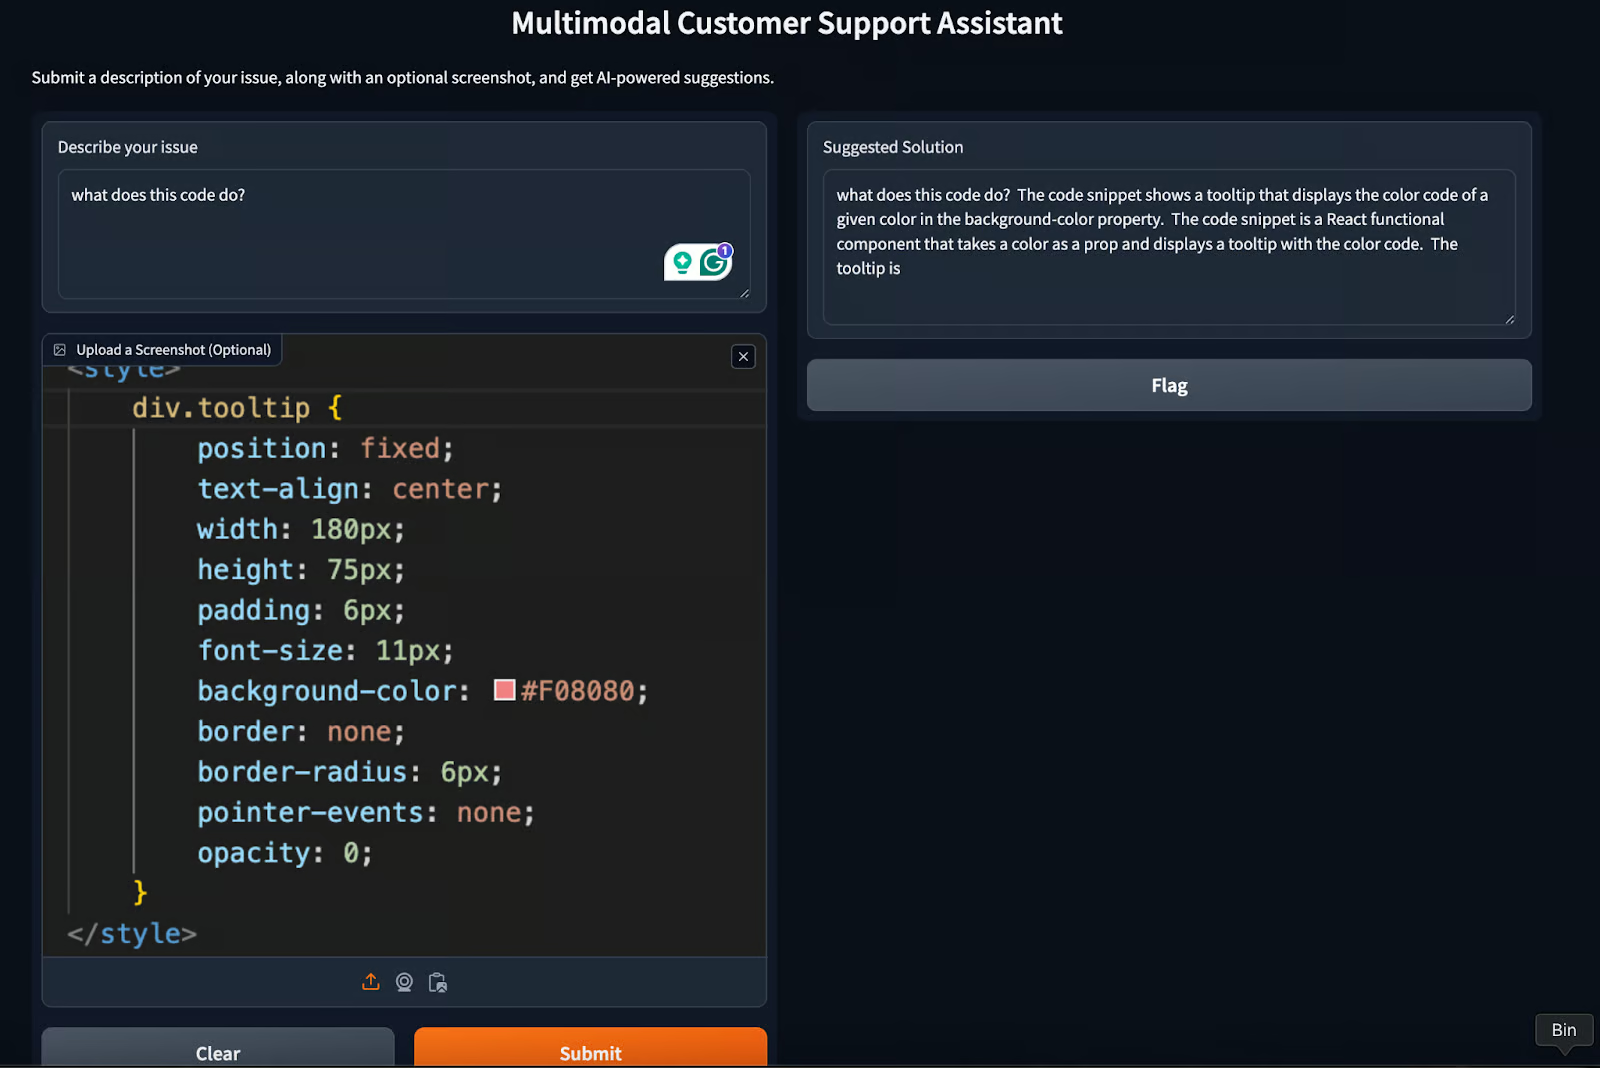
Aplikasi Gradio asisten dukungan pelanggan multimodal kita sudah siap! Untuk mendapatkan respons yang diinginkan, coba ubah parameter max_new_tokens atau bereksperimen sedikit dengan prompt.
Selain demo yang kita buat dalam tutorial ini, ada beberapa use case lain yang memerlukan upaya minimal. Di antaranya:
Untuk setiap use case, ada beberapa kiat yang dapat digunakan setiap pengembang saat membangun aplikasi seperti yang sudah kita buat. Berikut beberapa praktik terbaik yang dapat diadopsi saat bekerja dengan model seperti Llama 3.2.
Karena tugas multimodal dapat membutuhkan banyak sumber daya, mengurangi latensi adalah kunci. Pertimbangkan mengoptimalkan model untuk respons lebih cepat dengan menggunakan caching, pruning model, atau membatasi jumlah token yang dihasilkan.
Penting untuk menyiapkan mekanisme penanganan kesalahan. Jika model gagal menghasilkan respons bermakna (misalnya karena kualitas gambar buruk), kita dapat menyediakan respons cadangan atau pesan kesalahan. Kita bahkan dapat memilih umpan balik manusia, yang pada gilirannya membantu meningkatkan model.
Melacak performa aplikasi, seperti waktu respons dan data interaksi pengguna, dapat membantu mengoptimalkan antarmuka dan bahkan meningkatkan pengalaman pengguna. Dengan mencatat waktu performa, kita dapat mencoba mengoptimalkan latensi model menggunakan pustaka seperti bits and bytes.
Dalam panduan ini, kita mempelajari cara menggabungkan kemampuan multimodal Llama 3.2 dan antarmuka intuitif Gradio. Mulai dari dukungan pelanggan hingga pendidikan dan pembuatan konten, aplikasi potensialnya sangat luas dan beragam.
Dengan menerapkan praktik terbaik seperti pengelolaan latensi, penanganan kesalahan, dan pemantauan performa, kita dapat memastikan aplikasi Llama 3.2 dan Gradio yang tangguh, efisien, dan ramah pengguna.
Untuk mempelajari lebih lanjut, saya merekomendasikan tutorial berikut:
Pelajari AI dengan kursus-kursus ini!
Kursus
Program
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt




