Leerpad
Basisinfo over lama's
4 uur
Meta heeft eindelijk multimodaliteit toegevoegd aan het Llama-ecosysteem met de introductie van de Llama 3.2 11B & 90B vision-modellen. Deze twee modellen blinken uit in het verwerken van zowel tekst als afbeeldingen, wat me ertoe bracht een project te bouwen met de 90B-versie.
In dit artikel deel ik mijn werk en neem ik je stap voor stap mee bij het bouwen van een interactieve app voor afbeeldingsonderschriften, met Streamlit voor de front-end en Llama 3.2 90B als motor voor het genereren van onderschriften.
Llama 3.2-Vision 90B is een state-of-the-art multimodaal large language model (LLM), gebouwd voor taken met zowel beeld- als tekstinvoer.
Het model valt op door zijn vermogen om complexe taken aan te pakken, zoals visueel redeneren, beeldherkenning en het genereren van onderschriften. Het is getraind op een enorme dataset van 6 miljard beeld-tekstparen.
Llama 3.2-Vision is een uitstekende keuze voor onze app omdat het meerdere talen ondersteunt voor tekstrtaken, al ligt de primaire focus bij beeldgerelateerde toepassingen op Engels. De belangrijkste features maken het een sterke keuze voor taken als Visual Question Answering (VQA), Document VQA en image-text retrieval, waarbij het genereren van onderschriften een van de opvallendste toepassingen is.
Laten we verkennen hoe deze mogelijkheden zich vertalen naar een praktijktoepassing zoals afbeeldingsonderschriften.
Een afbeeldingsonderschrift is het geautomatiseerd genereren van beschrijvende tekst die de inhoud van een afbeelding samenvat. Het combineert computer vision en natural language processing om visuele details in taal uit te drukken.
Traditioneel vereist het genereren van onderschriften een complexe pijplijn, vaak met aparte fasen voor beeldverwerking en taalproductie. De standaardaanpak omvat drie hoofdstappen: beeldvoorbewerking, feature-extractie en het genereren van onderschriften.
Met Llama 3.2 90B wordt dit traditioneel ingewikkelde proces eenvoudiger. De vision-adapter van het model integreert visuele kenmerken in het kern-taalmodel, waardoor het direct afbeeldingen kan interpreteren en onderschriften kan genereren via eenvoudige prompts.
Door cross-attention-lagen in de architectuur op te nemen, stelt Llama 3.2 90B gebruikers in staat een afbeelding te beschrijven door het model simpelweg te prompten—zonder aparte verwerkingsstappen. Deze eenvoud maakt onderschriften toegankelijker en efficiënter: één prompt kan een natuurlijke, beschrijvende tekst opleveren die de essentie van een afbeelding goed vangt.
Om de kracht van Llama 3.2 90B tot leven te brengen, bouwen we een simpele maar effectieve app voor afbeeldingsonderschriften met Streamlit voor de front-end en Groq voor het genereren van onderschriften.
De app laat gebruikers een afbeelding uploaden en ontvangt met slechts twee klikken een beschrijvend onderschrift van het model. Deze opzet is gebruiksvriendelijk en vereist minimale programmeerkennis om te starten.
Onze applicatie bevat de volgende features:
De Groq API fungeert als brug tussen de geüploade afbeelding van de gebruiker en het Llama 3.2-Vision-model. Wil je meedenken en meecoden, zorg dan eerst dat je:
De onderstaande Python-code zet een Streamlit-app op die met de Groq API communiceert. Het omvat:
import streamlit as stfrom groq import Groqimport base64import osimport json# Set up Groq API Keyos.environ['GROQ_API_KEY'] = json.load(open('credentials.json', 'r'))['groq_token']# Function to encode the imagedef encode_image(image_path): with open(image_path, "rb") as image_file: return base64.b64encode(image_file.read()).decode('utf-8')We gaan verder met de onderstaande functie, die is bedoeld om met de Groq API een tekstuele beschrijving van een geüploade afbeelding te genereren. Dit doet de functie:
# Function to generate captiondef generate_caption(uploaded_image): base64_image = base64.b64encode(uploaded_image.read()).decode('utf-8') client = Groq() chat_completion = client.chat.completions.create( messages=[ { "role": "user", "content": [ {"type": "text", "text": "What's in this image?"}, { "type": "image_url", "image_url": { "url": f"data:image/jpeg;base64,{base64_image}", }, }, ], } ], model="llama-3.2-90b-vision-preview", ) return chat_completion.choices[0].message.contentTot slot genereren we onze interactieve webapp met Streamlit:
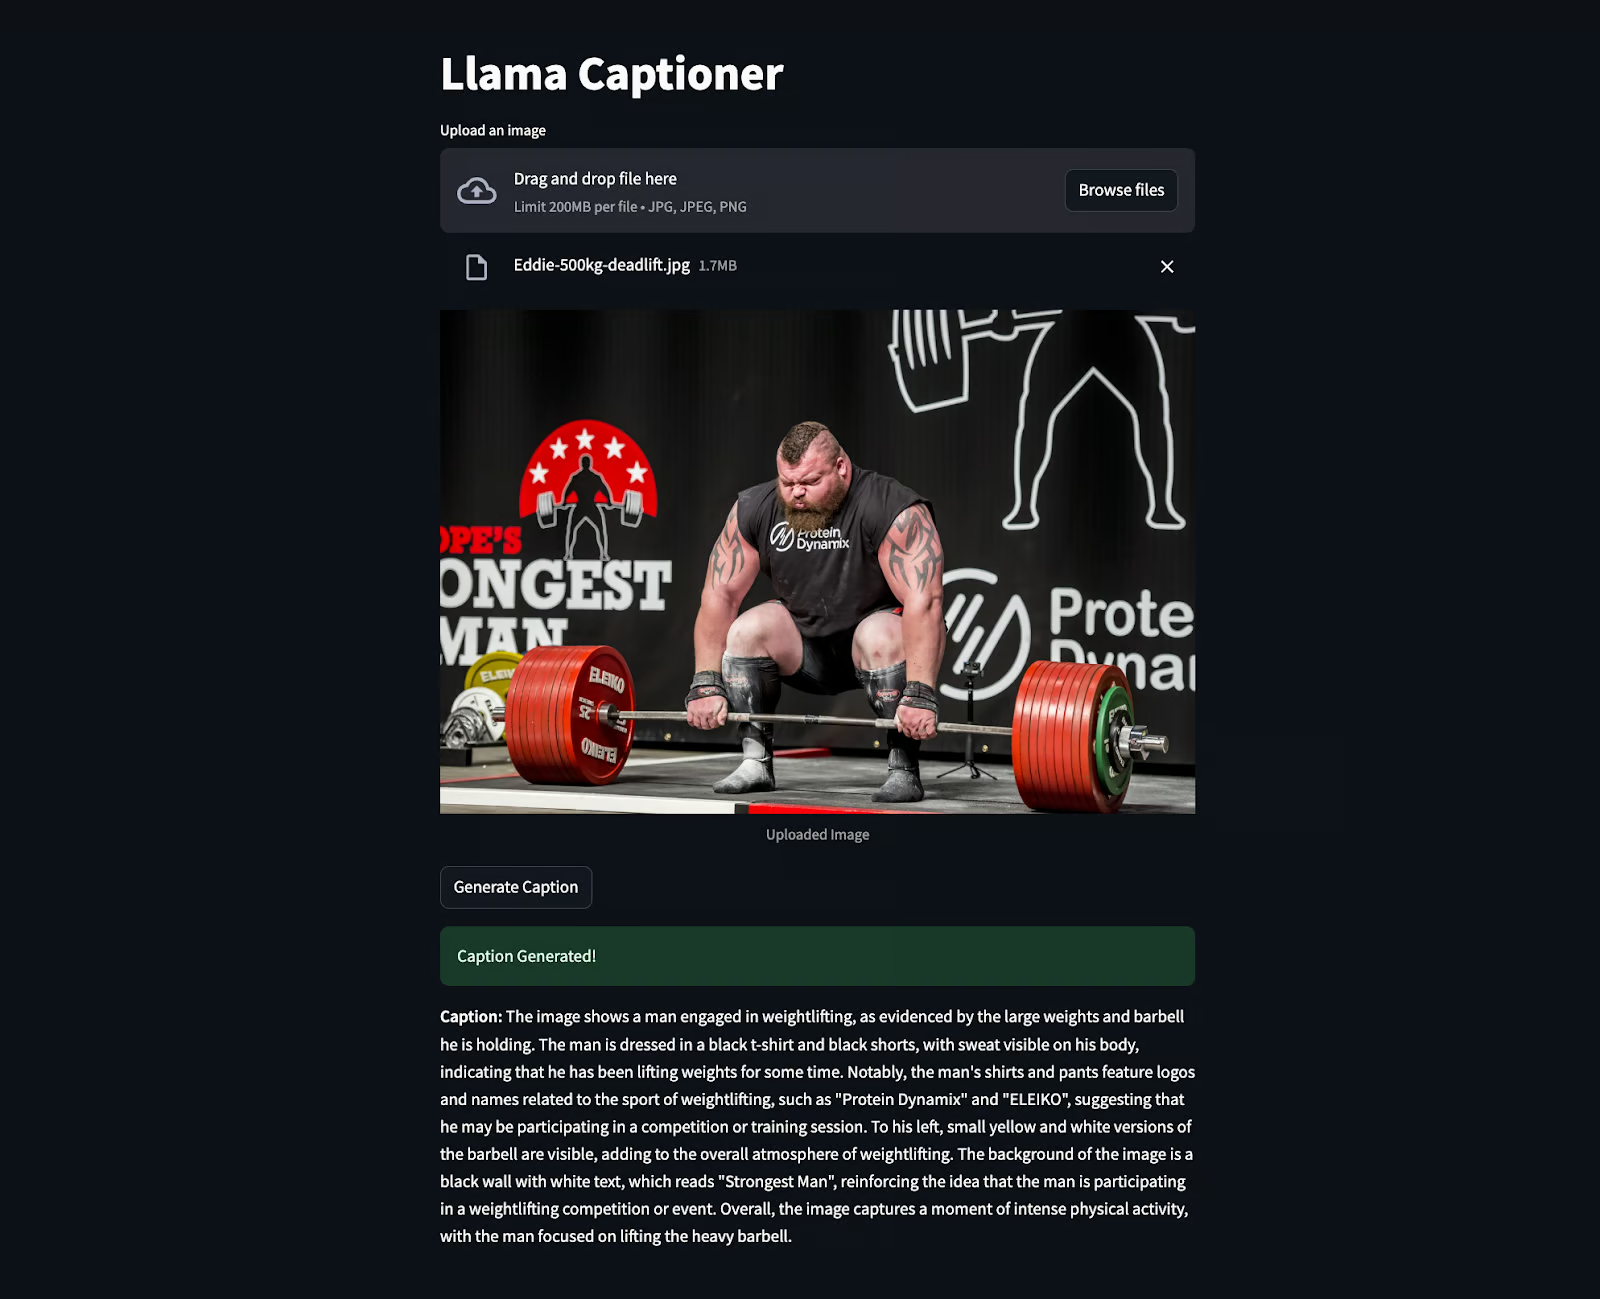
# Streamlit Appst.title("Llama Captioner")uploaded_file = st.file_uploader("Upload an image", type=["jpg", "jpeg", "png"])if uploaded_file is not None: # Show the uploaded image st.image(uploaded_file, caption="Uploaded Image", use_container_width=True) if st.button("Generate Caption"): with st.spinner("Generating caption..."): caption = generate_caption(uploaded_file) st.success("Caption Generated!") st.write("**Caption:**", caption)Deze Streamlit-app biedt een gebruiksvriendelijke interface voor het genereren van onderschriften. Zo werkt het:
st.image.Onderstaande snippet is code in actie waarbij een afbeelding van Eddie Hall is geüpload om het onderschrift te genereren. Verrassend genoeg haalde het zelfs informatie naar boven die niet duidelijk zichtbaar was, zoals "Strongest Man" enz.
Een app voor afbeeldingsonderschriften bouwen met Llama 3.2 90B en Streamlit laat zien hoe geavanceerde AI moeilijke taken eenvoudiger maakt. Dit project combineert een krachtig model met een eenvoudige interface tot een intuïtieve, toegankelijke tool.
Als AI-engineer zie ik enorm veel potentie in dit soort tools. Ze maken technologie toegankelijker, helpen mensen beter met content omgaan en automatiseren processen op slimmere manieren.
Wil je verder leren over Llama, bekijk dan deze resources:
Leer Llama met deze cursussen!
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

