

Kursus
Memahami Prompt Engineering
1 jam
239.8K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleDalam tutorial ini, saya akan mendemonstrasikan cara menggunakan BytePlus Ark API untuk berinteraksi dengan Seedance 2 menggunakan Python.
Seedance 2 adalah model AI generatif yang kuat dari ByteDance yang berfungsi sebagai "sutradara multimodal," mampu memproses input teks, gambar, video, dan audio secara bersamaan untuk membuat urutan video sinematik dengan audio tersinkron. Baik Anda ingin menganimasikan gambar statis atau menghidupkan prompt teks yang kompleks, panduan ini akan memandu Anda melalui proses penyiapan dan implementasinya.
Untuk memulai, kita perlu membuat akun BytePlus dan kunci API. Caranya:
Kunci ini digunakan untuk membuat permintaan ke ModelArk API, API resmi mereka.
Praktik terbaik adalah menyimpan kunci tersebut dalam berkas bernama .env di folder yang sama tempat kita menulis skrip Python. Pastikan untuk merahasiakan kunci tersebut karena siapa pun dapat menggunakannya untuk berinteraksi dengan API menggunakan akun Anda.
Tempelkan API key ke dalam berkas .env dengan format berikut:
ARK_API_KEY=<paste_api_key_here>Agar dapat menggunakan Seedance 2, kita perlu mengaktifkan modelnya terlebih dahulu:
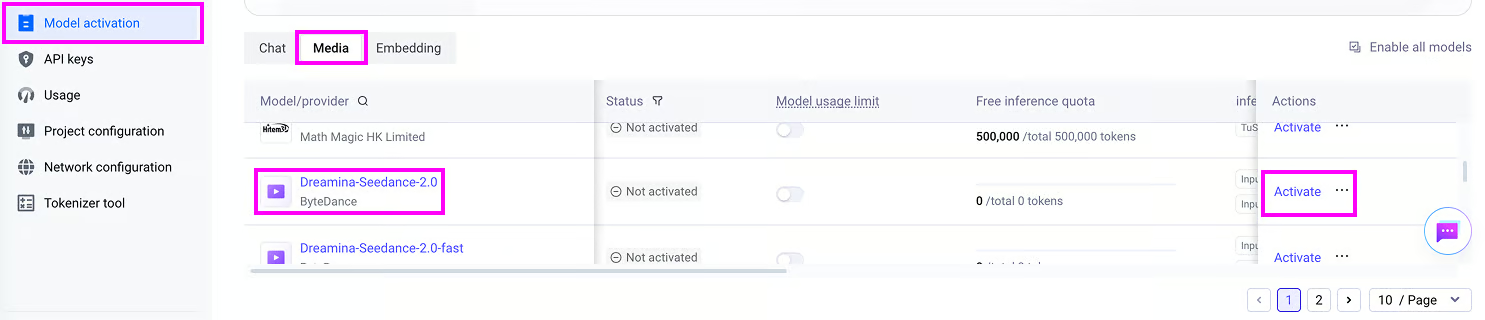
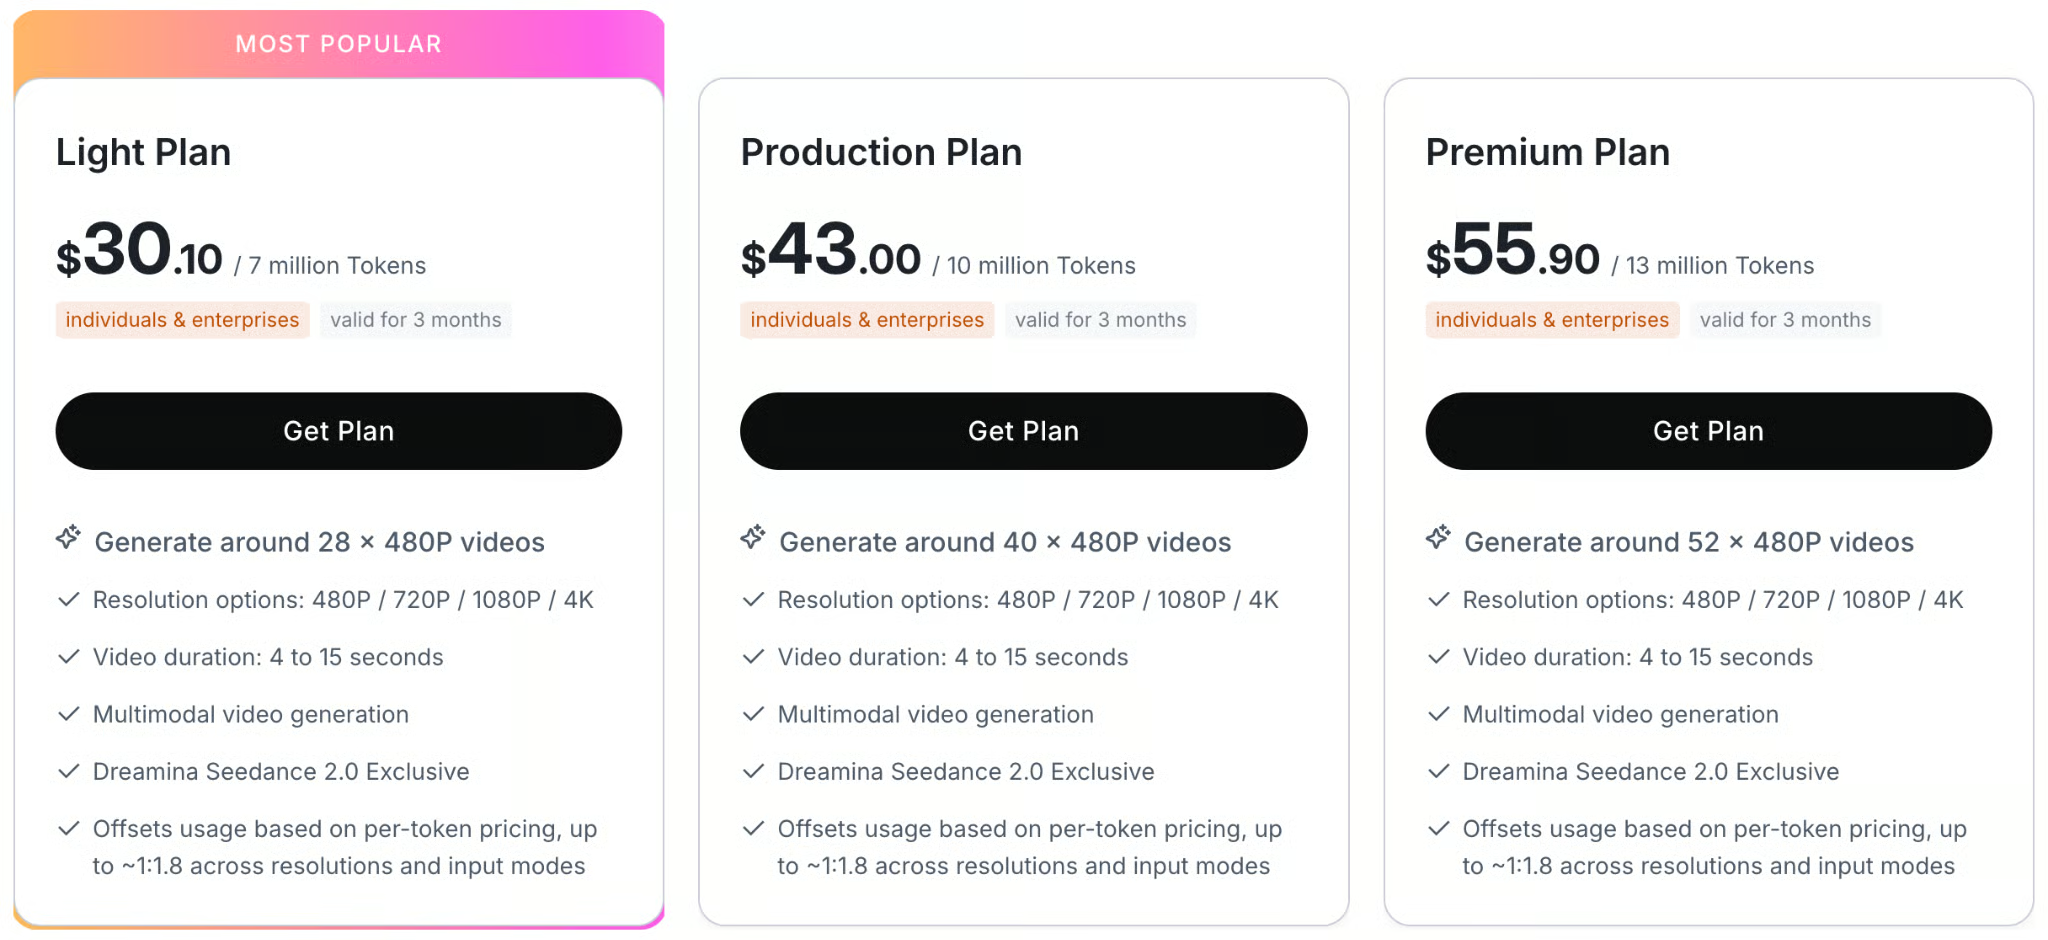
Perlu dicatat bahwa penggunaan API tidak gratis dan mengaktifkan Seedance 2 memerlukan pembelian kredit untuk model tersebut. Untuk artikel ini, saya membeli paket token sebanyak 7 juta untuk Seedance 2 seharga $30,10.
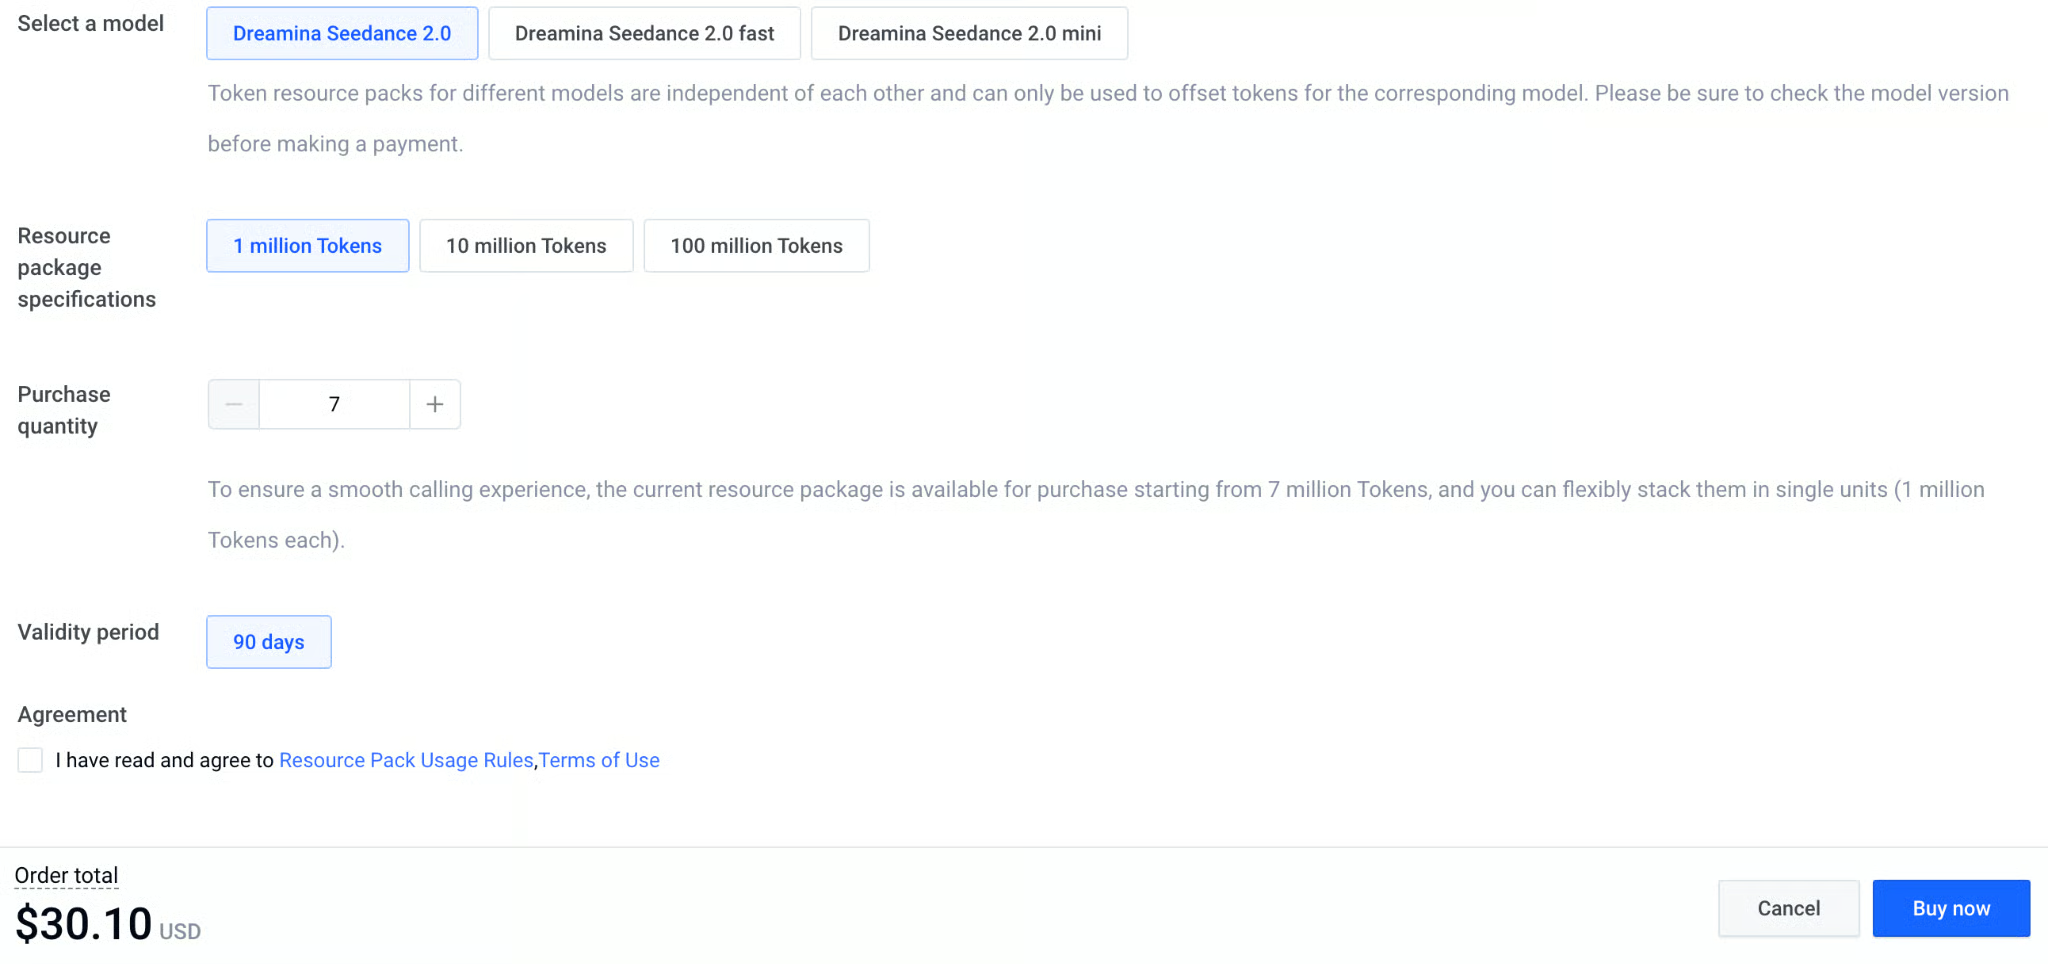
Sayangnya, token bersifat spesifik untuk model. Artinya, jika kita membeli token untuk versi fast atau mini dari Seedance 2, token tersebut tidak dapat digunakan dengan model dasar.
Berikut adalah tabel dengan paket harga untuk API:
Saya telah menyertakan skrip lengkap yang sesuai dengan kode yang dibuat dalam tutorial ini di repositori GitHub ini.
Di bagian ini, kita belajar cara membuat permintaan text-to-video untuk menghasilkan video berikut:
Untuk terhubung dengan BytePlus Ark API menggunakan Python, kita akan menggunakan paket resmi byteplus-python-sdk-v2.
Cara termudah untuk menyiapkan dependensi proyek ini adalah membuat environment Anaconda dan memasang berkas requirements.txt, seperti ini:
git clone git@github.com:fran-aubry/seedance2-tutorial.git
conda create --name seedance2 python=3.11
conda activate seedance2
pip install -r requirements.txtBuat skrip baru bernama text_to_video.py di folder yang sama dengan berkas .env yang kita buat sebelumnya.
Pertama, kita perlu mengimpor paket yang diperlukan:
import os
from byteplussdkarkruntime import Ark
from dotenv import load_dotenv
Selanjutnya, kita memuat API key dari berkas .env menggunakan fungsi load_dotenv():
load_dotenv()
API_KEY = os.getenv("ARK_API_KEY")
Sekarang kita inisialisasi klien Ark, yang memungkinkan kita membuat permintaan ke BytePlus Ark API.
Kita menggunakan pustaka os untuk mengambil API key dari variabel lingkungan dan menetapkan base URL yang sesuai untuk akses API internasional:
client = Ark(
    api_key=os.getenv("ARK_API_KEY"),
    base_url="https://ark.ap-southeast.bytepluses.com/api/v3"
)
Terakhir, kita menetapkan sebuah prompt dan menggunakan fungsi content_generation.tasks.create() dari klien untuk menghasilkan video:
prompt = """
A cinematic close-up of a weary but hopeful female astronaut inside a dimly lit, dusty spaceship cabin.
Soft blue light illuminates her face.
She takes a deep breath, showing subtle emotional relief, looks directly into the camera, and says:
'We finally made it. The atmosphere is stable.'
The ambient sound of a low, rhythmic spaceship engine hums in the background.
"""
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        }
    ],
    generate_audio=True,
    ratio="16:9",
    duration=8,
    watermark=True,
    resolution="480p",
)
task_id = response.id
print(f"Task successfully submitted! Task ID: {task_id}")
Setelah meminta pembuatan video, kita tidak langsung mendapatkan video karena video memerlukan waktu untuk diproses.
Ini berarti variabel response bukanlah videonya sendiri.
Sebaliknya, ini adalah objek yang berisi informasi tentang tugas pembuatan video.
Secara khusus, objek ini berisi pengenal tugas, yang memungkinkan kita melacak progres pembuatan video dan mengunduh video setelah model selesai menghasilkannya.
Kita dapat mengambil status suatu tugas dengan memberikan pengenal tugas ke fungsi content_generation.tasks.get(), seperti ini:
task = client.content_generation.tasks.get(task_id=task_id)
status = task.status
print(f"Status: {status}")
Agar lebih mudah melacak progres video, kita membuat skrip baru utils.py di folder yang sama dan menambahkan fungsi ini untuk melacak progres video berdasarkan instance klien dan pengenal tugas:
import time
import requests

def poll_task(client, task_id, poll_interval=5):
    while True:
        try:
            task_status = client.content_generation.tasks.get(task_id=task_id)
            status = getattr(task_status, "status", None) or (task_status.get("status") if isinstance(task_status, dict) else None)

            if status == "succeeded":
                print("\nTask completed successfully.")
                return task_status.content.video_url

            elif status == "failed":
                error_details = getattr(task_status, "error", "Unknown error occurred during processing.")
                raise RuntimeError(f"Task failed: {error_details}")

            print(".", end="", flush=True)
            time.sleep(poll_interval)
        except Exception as e:
            if isinstance(e, RuntimeError):
                raise
            print(f"\nWarning: Error polling task (will retry): {e}")
time.sleep(poll_interval)Fungsi poll_task() yang kita implementasikan di atas mengembalikan URL video
Sekarang setelah kita dapat melacak proses pembuatan video, yang kita perlukan hanyalah cara untuk mengunduhnya saat selesai dibuat.
Karena BytePlus Ark API mengembalikan URL langsung ke berkas video yang dihasilkan dalam respons tugas, kita dapat mengunduhnya menggunakan pustaka requests.
Berikut fungsi yang melakukan hal tersebut:
def download_video(url, output_path = "video.mp4"):
    try:
        print(f"Downloading video from {url} to {output_path}...")
        response = requests.get(url, stream=True)
        response.raise_for_status()

        with open(output_path, 'wb') as f:
            for chunk in response.iter_content(chunk_size=8192):
                f.write(chunk)
        print(f"Video successfully downloaded to '{output_path}'")
        return True
    except Exception as e:
        print(f"Error downloading video: {e}")
return FalseMenggabungkan semuanya, berikut skrip lengkap untuk menghasilkan video dari prompt teks menggunakan Seedance 2:
import os
from byteplussdkarkruntime import Ark
from dotenv import load_dotenv
import utils

load_dotenv()
API_KEY = os.getenv("ARK_API_KEY")

client = Ark(
    api_key=os.getenv("ARK_API_KEY"),
    base_url="https://ark.ap-southeast.bytepluses.com/api/v3"
)

prompt = """
A cinematic close-up of a weary but hopeful female astronaut inside a dimly lit, dusty spaceship cabin.
Soft blue light illuminates her face.
She takes a deep breath, showing subtle emotional relief, looks directly into the camera, and says:
'We finally made it. The atmosphere is stable.'
The ambient sound of a low, rhythmic spaceship engine hums in the background.
"""

response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        }
    ],
    generate_audio=True,
    ratio="16:9",
    duration=8,
    watermark=True,
    resolution="480p",
)

task_id = response.id
print(f"Task successfully submitted! Task ID: {task_id}")

# Wait for the video to finish generating
video_url = utils.poll_task(client, task_id)

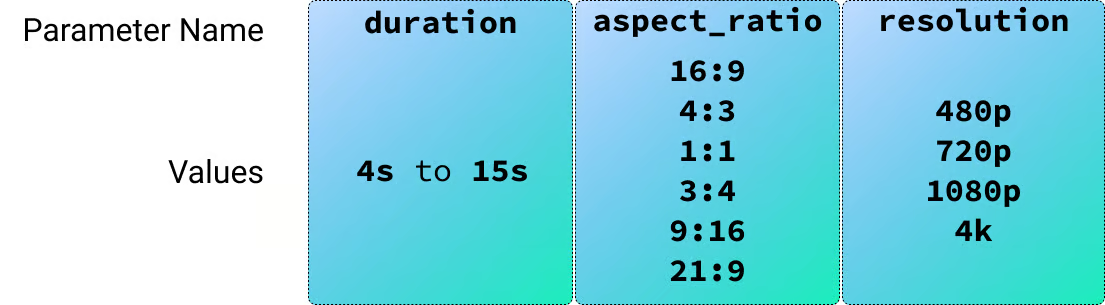
utils.download_video(video_url, "./videos/space.mp4")Berikut daftar nilai yang diterima untuk parameter inti dari permintaan pembuatan video:
Di bagian sebelumnya, kita mempelajari cara menghasilkan video menggunakan prompt teks. Seedance 2 juga mendukung input gambar, video, dan audio, jadi mari mulai dengan gambar.
Untuk menguji input gambar, saya menghasilkan dua karakter menggunakan AI untuk digunakan dalam adegan mirip sitkom.
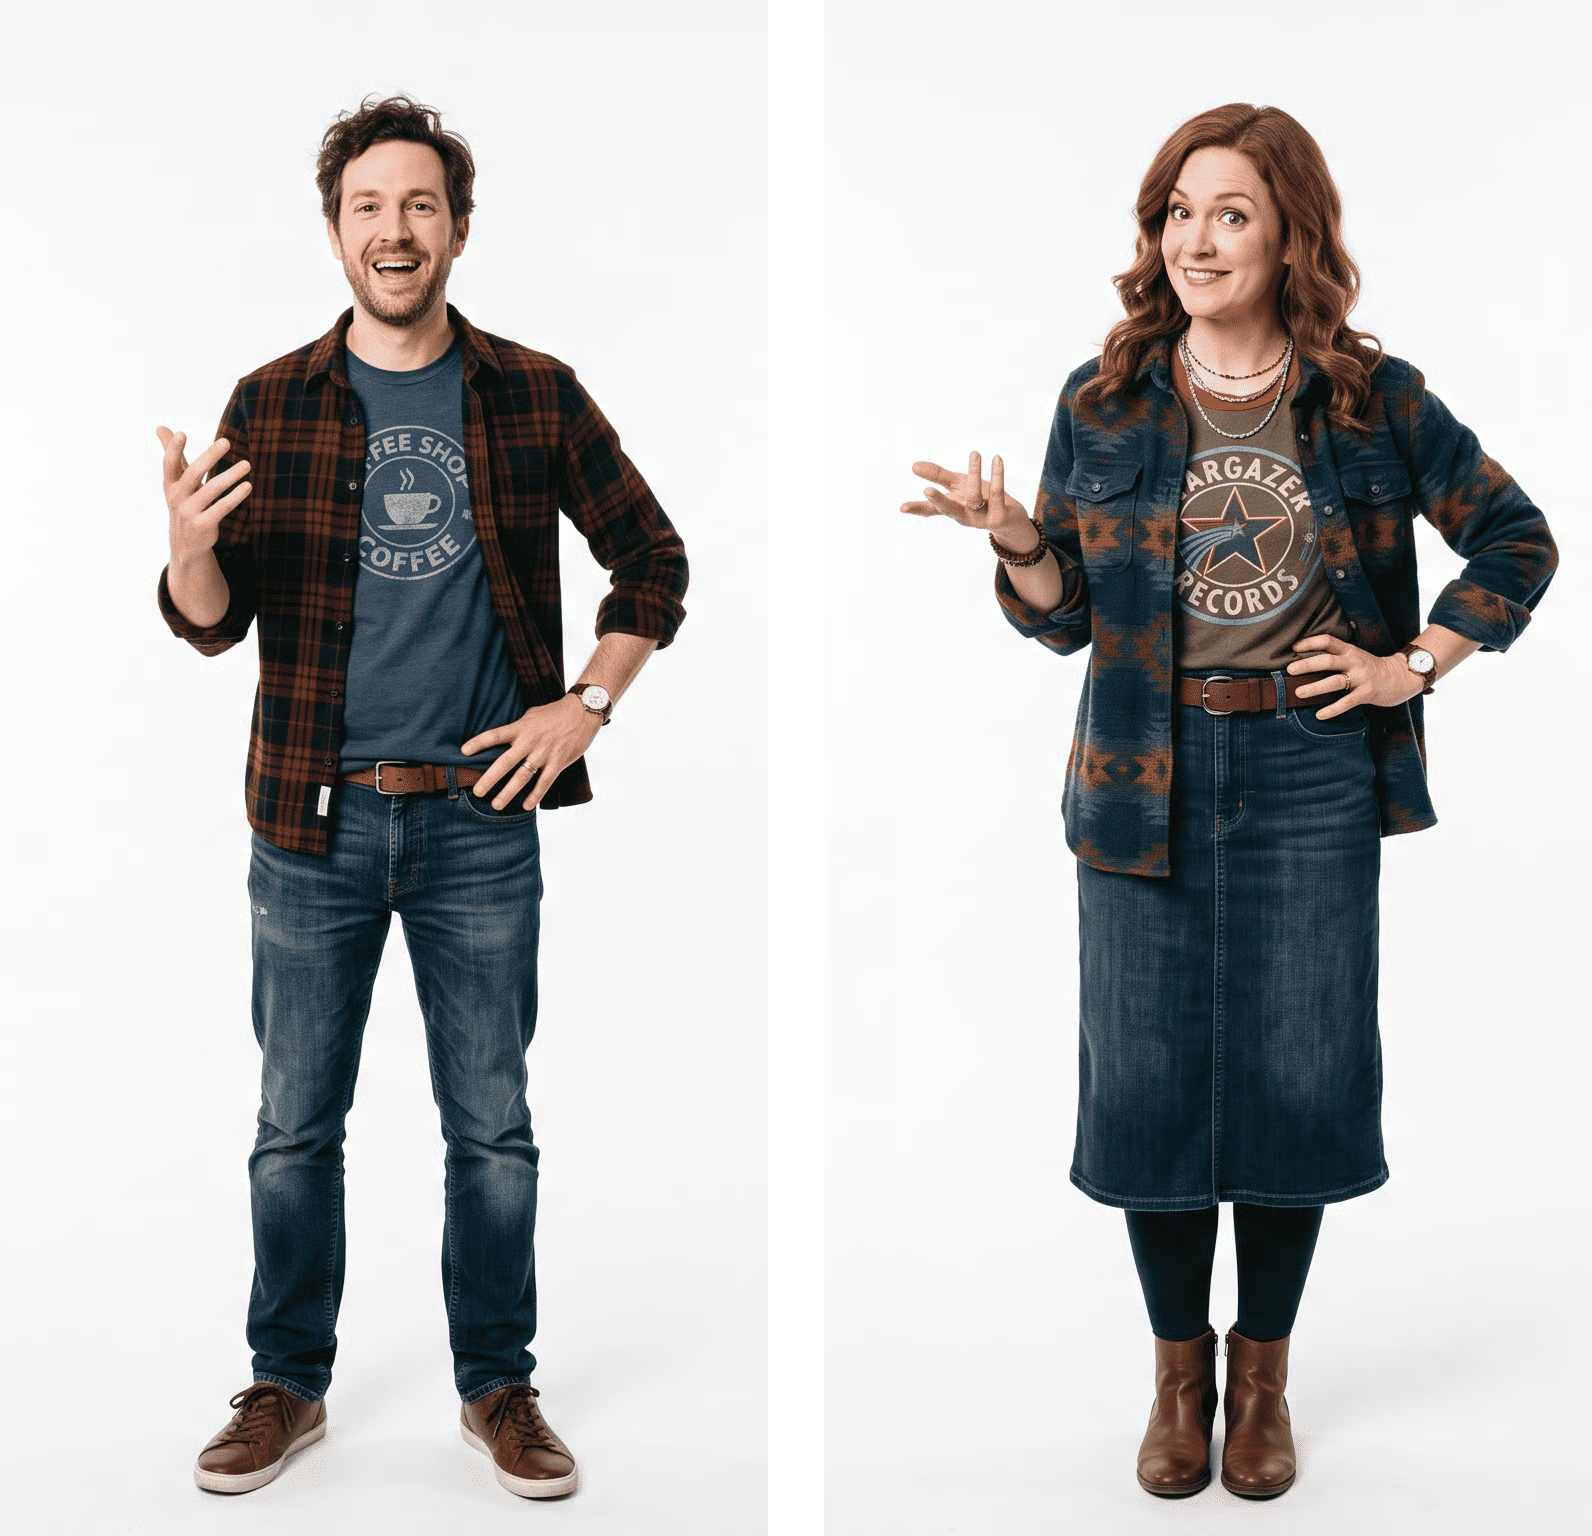
Kita dapat memberikan gambar referensi ke model dengan menambahkannya ke bidang content pada permintaan, seperti ini:
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/male-character.png")
            },
            "role": "reference_image"
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/female-character.png")
            },
            "role": "reference_image"
        }
    ],
    generate_audio=True,
    ratio="16:9",
    duration=15,
    watermark=True,
    resolution="480p",
)
Untuk video ini, saya menggunakan prompt berikut:
Context: A cozy, warmly lit independent coffee shop counter with wooden accents.
Reference:
- The male barista's face and clothing follow @Image1.
- The female customer's face and styling follow @Image2.

Action & Dialogue (10 Seconds Total):

0:00 - 0:04:
Medium close-up on the male barista (@Image1) standing behind the counter,
next to the coffee machine. He leans across the counter with a smooth,
flirtatious smirk, acting like he is making a highly exclusive offer:
"The WiFi password? It's actually my phone number: five-five-five, zero-one—"

0:04 - 0:07:
Camera cuts to the female customer (@Image2), instantly interrupting him.
She holds up her phone screen toward him, entirely unimpressed:
"Your network is called 'Free_Guest_WiFi' and there is literally no password."

0:07 - 0:08: Quick cut back to the two-shot.
Flustered, the barista becomes visibly embarrassed, his confident smirk
instantly vanishing as he nervously breaks eye contact.

0:08 - 0:10: Camera cuts back to a medium shot of the female customer (@Image2).
She lowers her phone, tapping her fingers lightly on the counter,
and delivers her order with perfect deadpan clarity:
"It will be an espresso please. No milk, no sugar, and no phone number."

Framing/Timing:
Clean cuts to perfectly pace the comedic timing over exactly 10 seconds.

Tone/Audio:
Lighthearted sitcom vibe. Synchronized voice generation for the dialogue, a subtle low cafe background hum, and the sound of the customer's fingers lightly tapping the wooden counter at the end.
Perhatikan bahwa prompt menggunakan @Image1 dan @Image2 untuk merujuk ke gambar sesuai urutan yang disediakan dalam daftar.
Sayangnya, ketika saya mencoba membuat video ini, saya mendapat galat yang mengatakan:
The request failed because the input image may contain a real person.Saya mendapati hal ini terjadi secara konsisten saat mencoba menggunakan Seedance 2 dengan gambar referensi yang berisi manusia realistis, bahkan yang dihasilkan AI sekalipun.
Untuk mengatasinya, saya mengonversi karakter menjadi kartun dan mencoba lagi.
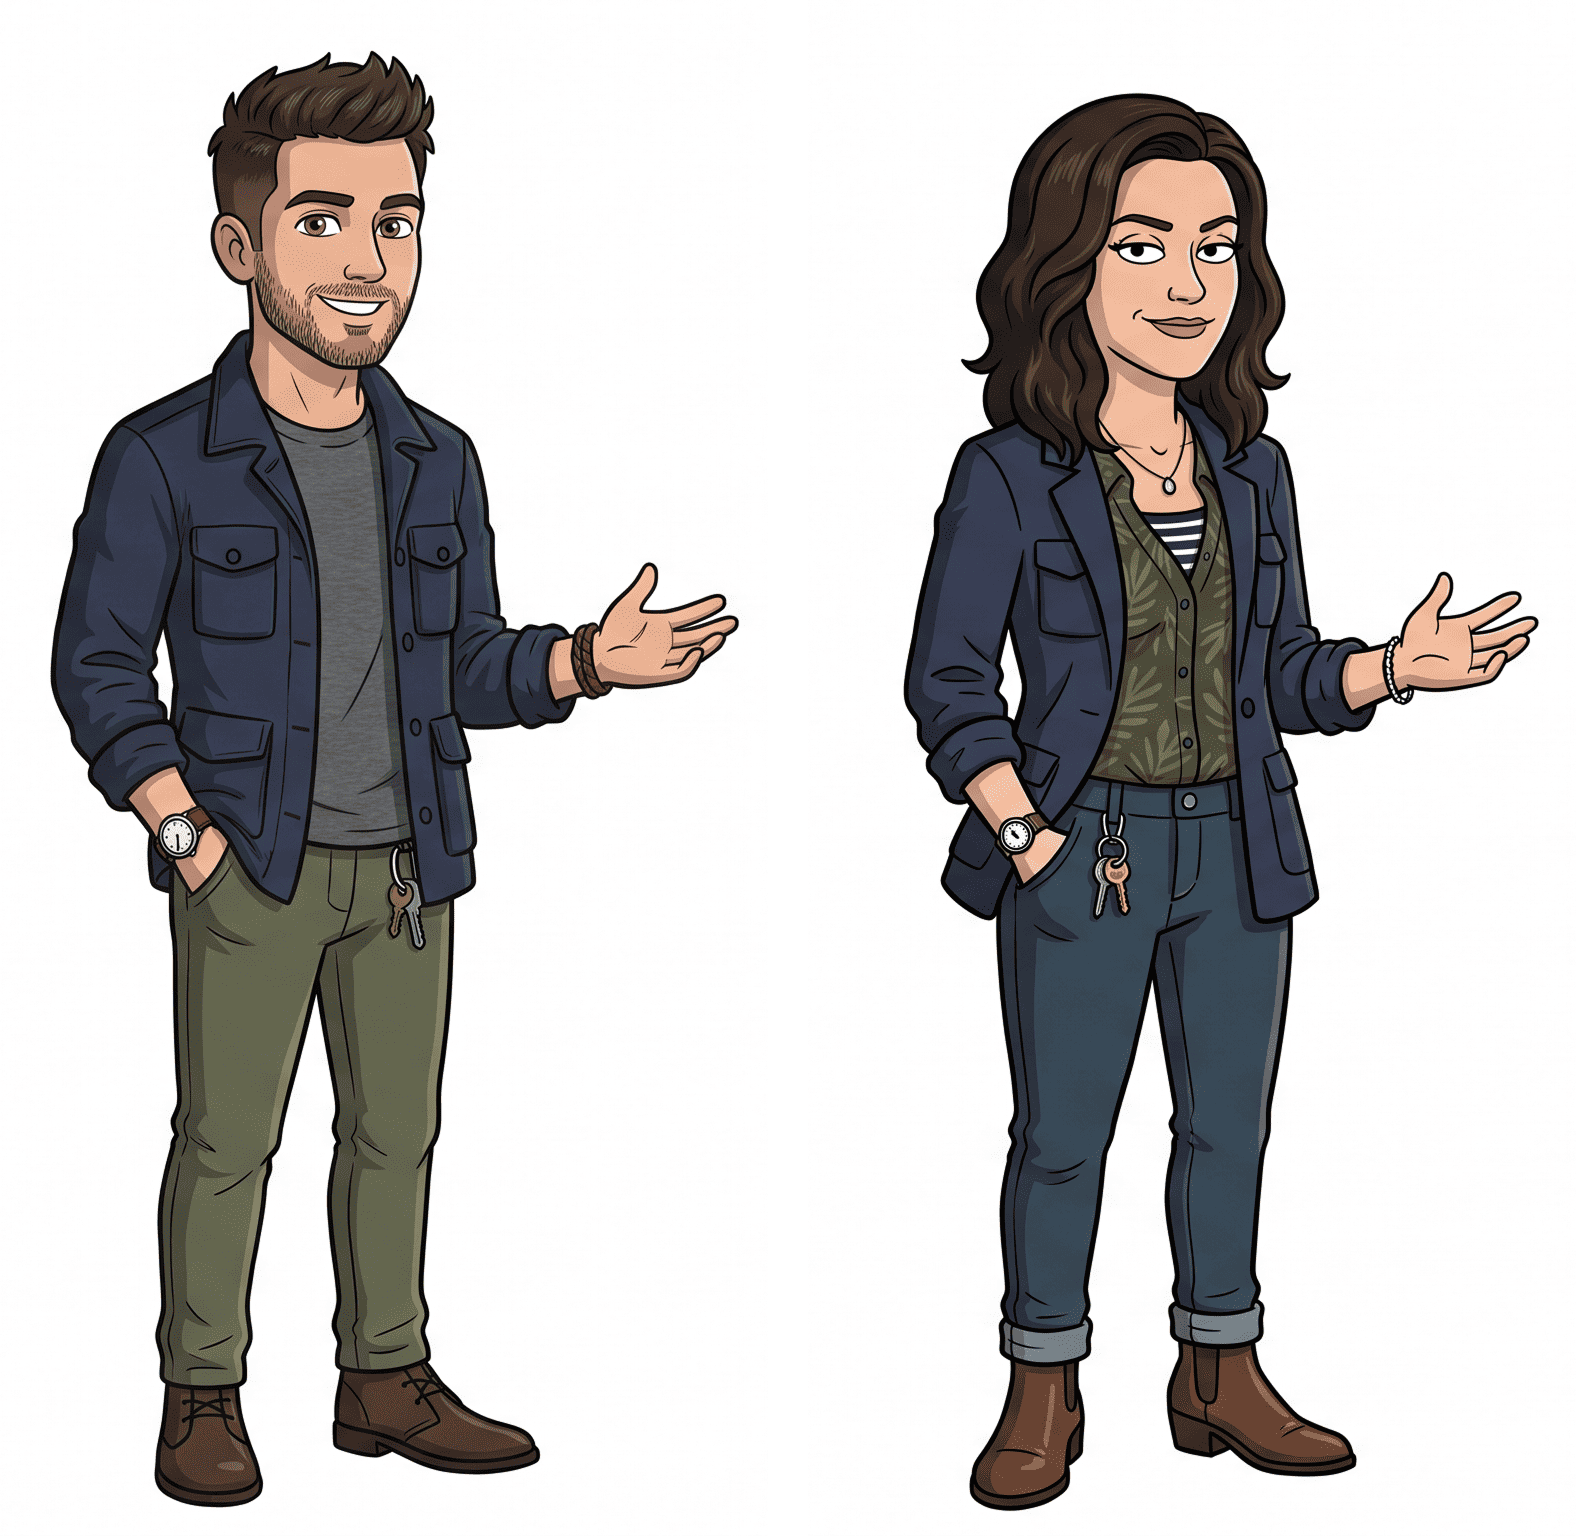
Kali ini berhasil sempurna, dan menurut saya hasilnya persis seperti yang ingin saya ciptakan.
Kode lengkap untuk contoh ini dapat ditemukan di berkas image_to_video.py.
Contoh sebelumnya menunjukkan cara menggunakan gambar sebagai referensi dengan menetapkan ”role”: “reference_image” dalam permintaan.
Seedance 2 mendukung dua peran gambar lainnya:
”first_frame”: Menginstruksikan model untuk menggunakan gambar yang diberikan sebagai frame awal persis dari video yang dihasilkan. Ini adalah pengaturan standar untuk pembuatan langsung Image-to-Video.”last_frame”: Menginstruksikan model untuk mengakhiri video yang dihasilkan pada gambar spesifik ini. Catatan: Anda hanya dapat menggunakannya jika Anda juga menyediakan first_frame dalam permintaan yang sama, sehingga secara efektif meminta model menginterpolasi video di antara kedua gambar.Saya mencoba ini dengan membuat serangkaian frame awal yang menampilkan lab AI robot yang mencoba menciptakan kembali tanaman di dunia di mana kehidupan alami telah menghilang.
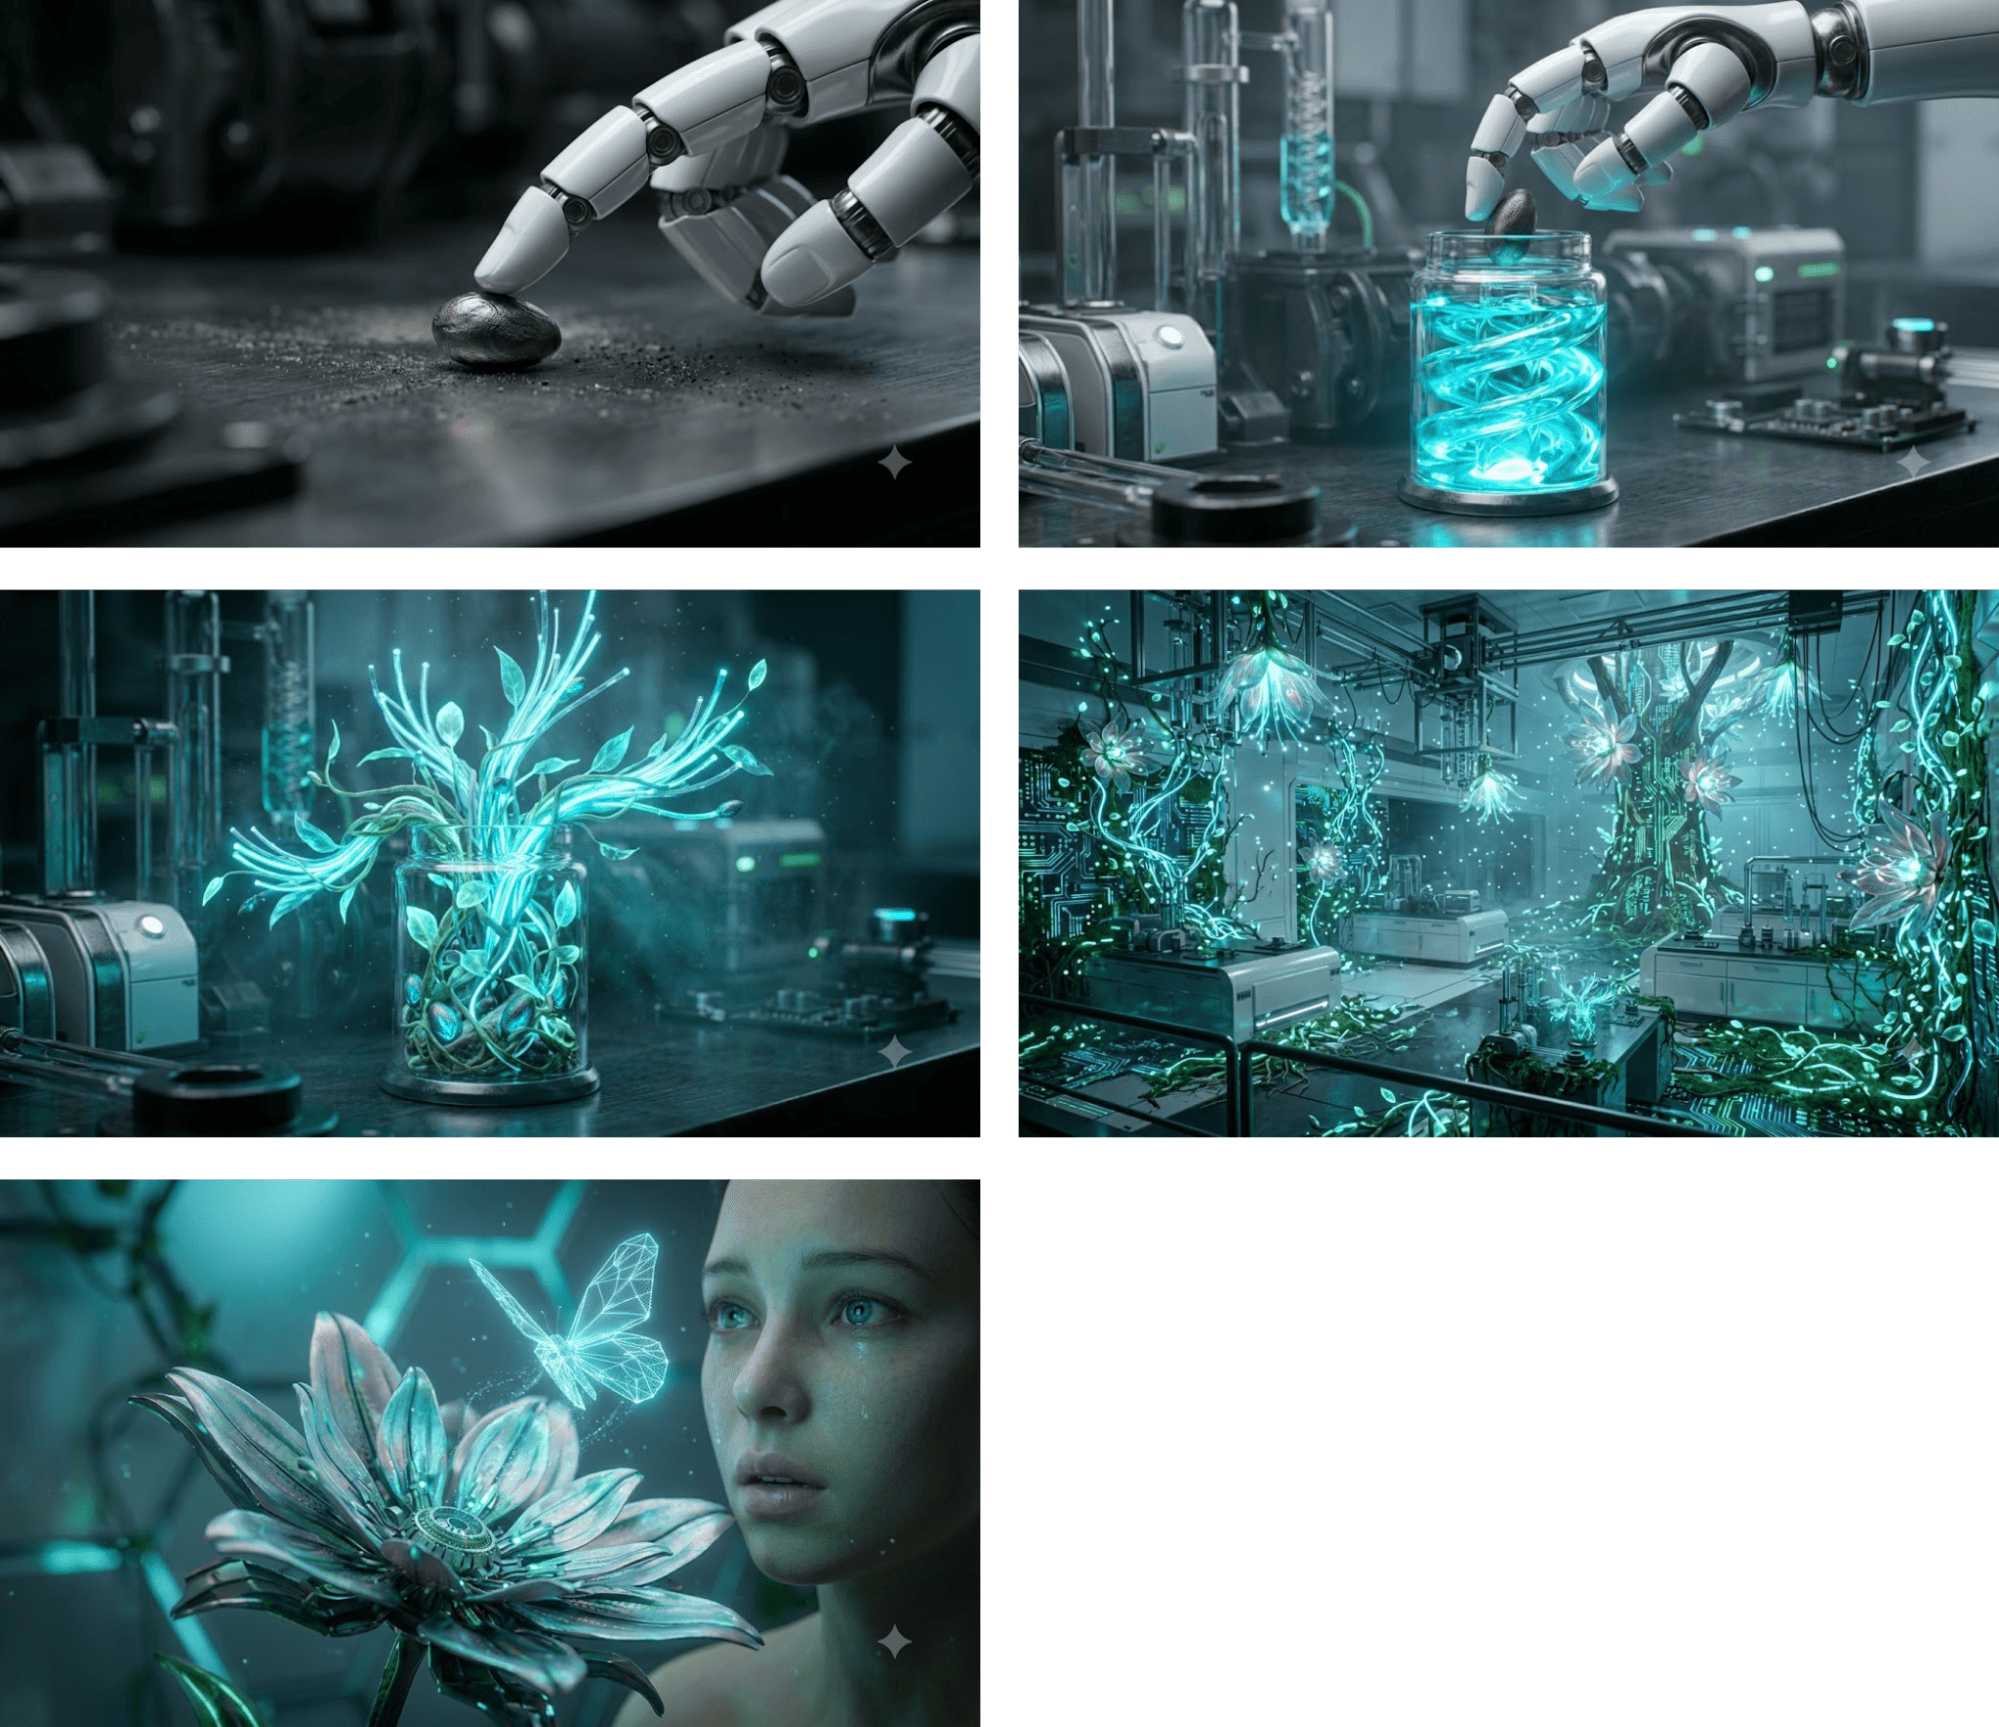
Untuk setiap frame, saya menghasilkan video dengan frame tersebut sebagai frame pertama. Berikut cara menyusun setiap permintaan:
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/robot-lab1.jpeg")
            },
            "role": "first_frame"
        }
    ],
    generate_audio=False,
    ratio="16:9",
    duration=4,
    watermark=True,
    resolution="480p",
)
Saya menghasilkan video tanpa audio karena audionya tidak akan konsisten, mengingat setiap video dibuat secara terpisah. Berikut hasil penggabungan kelima klip tersebut:
Skrip lengkap yang digunakan untuk menghasilkan video berdasarkan frame awal dapat ditemukan di sini.
last_frameDalam contoh ini, kita menyediakan first_frame dan last_frame untuk menghasilkan video di antara keduanya.
Saya menghasilkan dua gambar dari ruangan yang sama, satu kosong tanpa furnitur dan satu lagi dengan ruangan yang sepenuhnya berperabot. Tujuannya adalah menghasilkan video yang menganimasikan proses pengisian furnitur di ruangan tersebut.
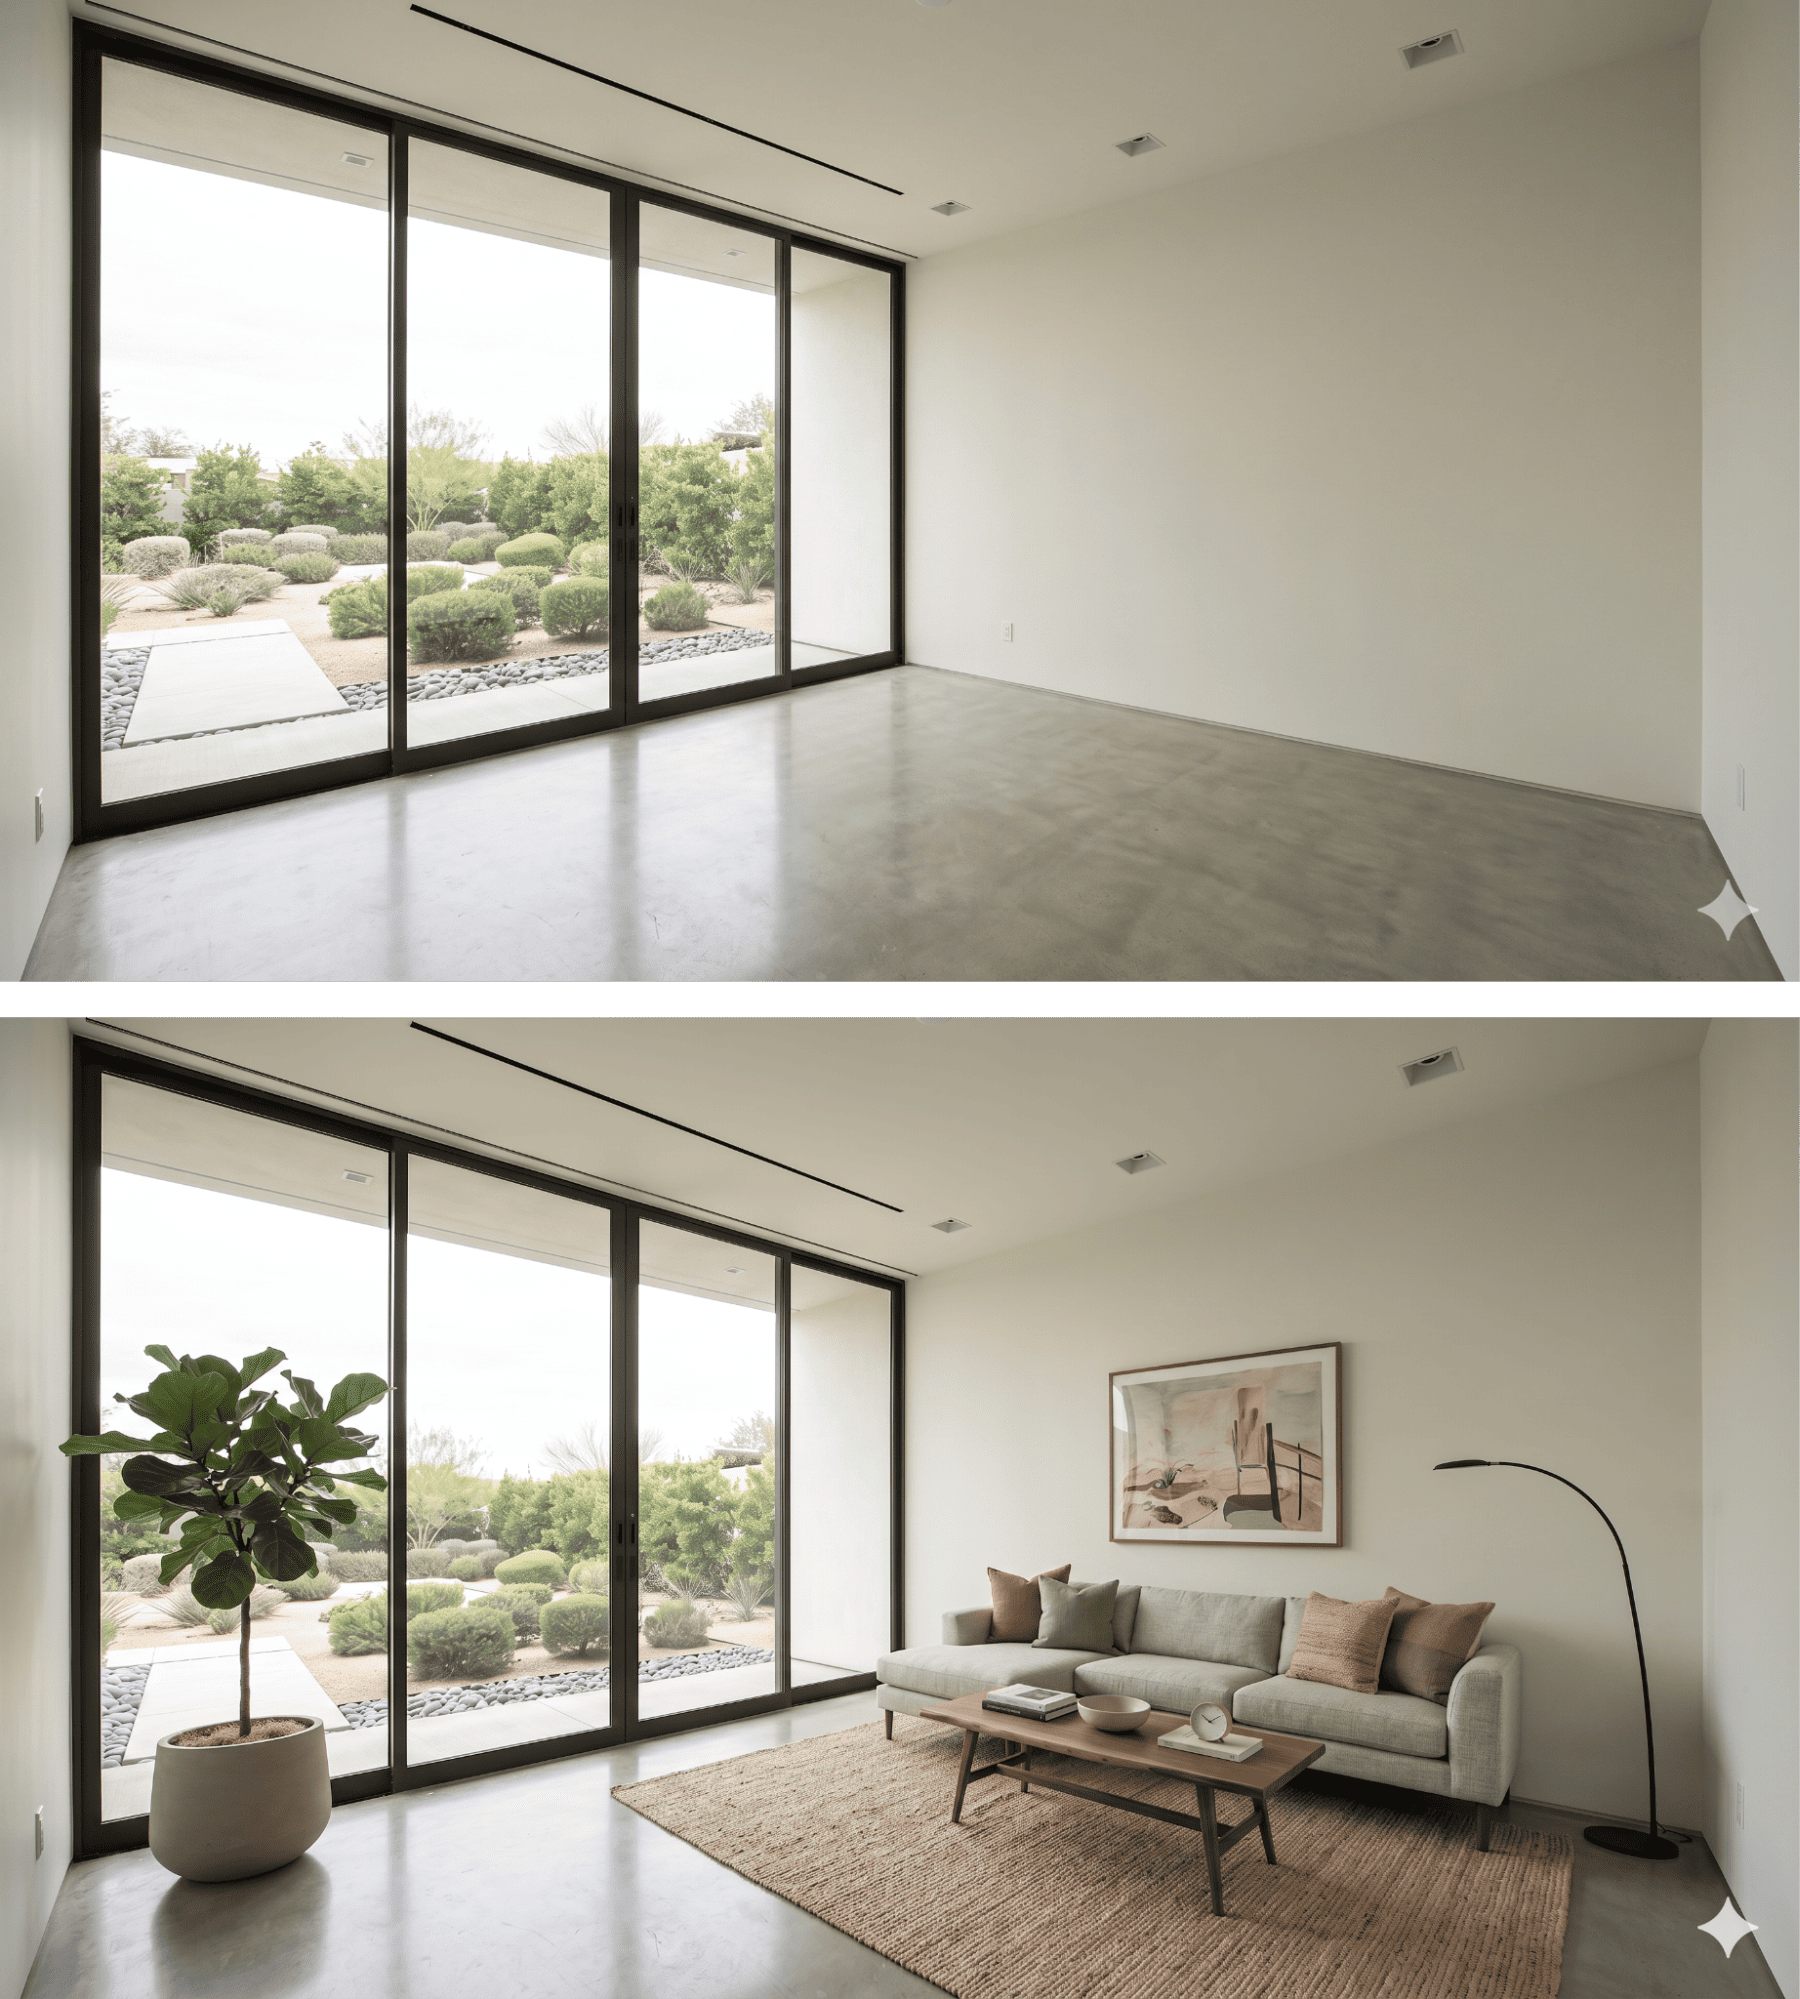
Prompt yang saya gunakan menjelaskan bagaimana saya ingin furnitur itu muncul dalam video:
A dynamic, fast-paced sequence where furniture pops into existence piece by piece. First, a rug rapidly unfolds itself, then the sofa drops from just above the floor with a heavy, realistic bounce. Lamps, artwork, and plants quickly spring into reality one after another. Vibrant lighting, photorealistic materials, lively and snappy energetic rhythm.Berikut permintaannya:
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/room-start.png")
            },
            "role": "first_frame"
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/room-end.png")
            },
            "role": "last_frame"
        }
    ],
    generate_audio=True,
    ratio="16:9",
    duration=8,
    watermark=True,
    resolution="480p",
)
Dan berikut hasilnya:
Untuk menghasilkan ini, saya menggunakan permintaan berikut:
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        },
        {
            "type": "video_url",
            "video_url": {
                "url": "https://www.pexels.com/download/video/38213009/"
            },
            "role": "reference_video"
        }
    ],
    generate_audio=True,
    ratio="16:9",
    duration=6,
    watermark=True,
    resolution="480p",
)
Skrip lengkapnya dapat ditemukan di sini. Prompt yang saya gunakan adalah:
The original skater, environment, and camera movement must remain
unchanged and untouched.

Only add gaming-style visual effects: intense glowing sparks and electric arcs
streaming from the skateboard-rail contact point during the grind, and a
brilliant energy shockwaves and dust burst at the jump/pop. Untuk menguji input audio, saya membuat gambar untuk sebuah karakter dan menggunakan Fish Audio untuk membuat trek audio dengan emosi yang berbeda-beda.
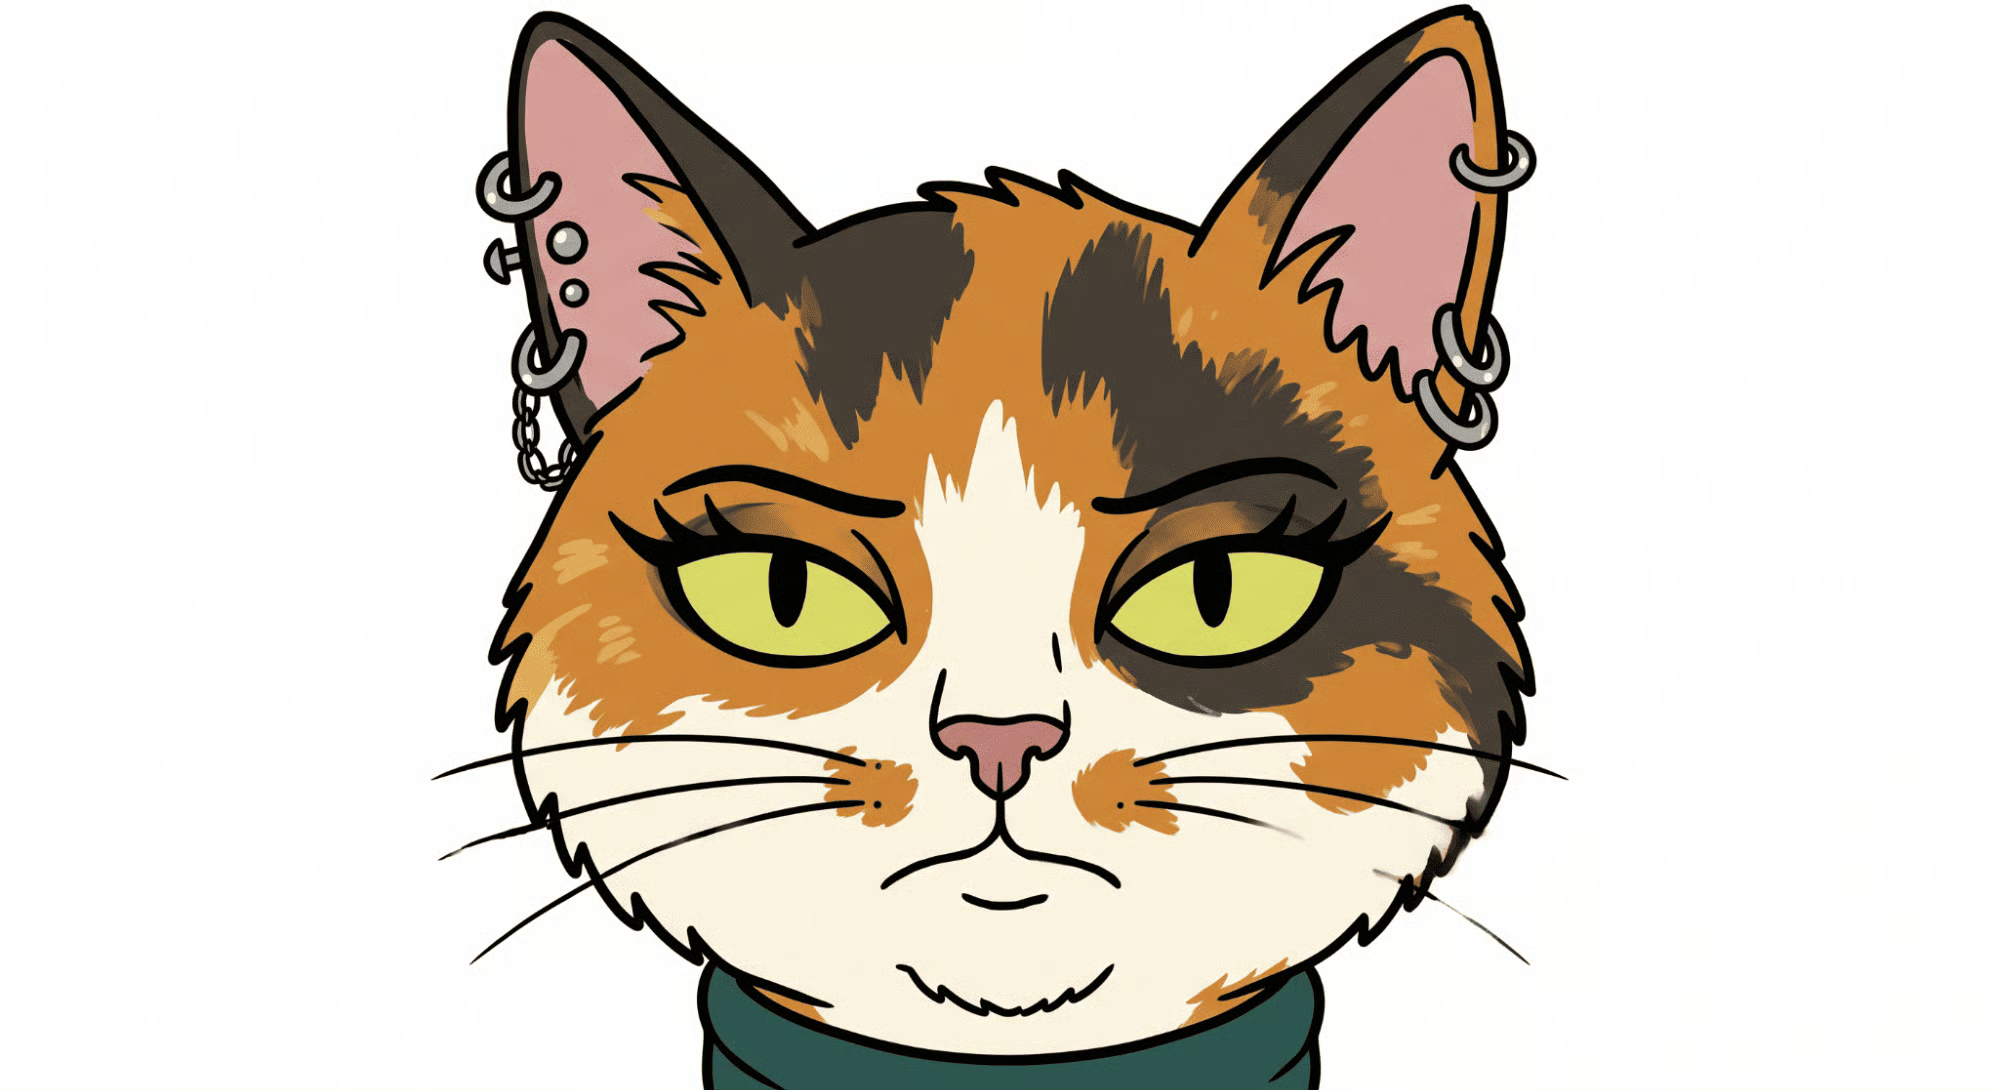
Untuk audionya, saya menginginkan beberapa emosi berbeda untuk melihat apakah Seedance 2 mampu mengidentifikasinya saat menghasilkan video.
Fish Audio AI memungkinkan kita menentukan emosi menggunakan [emotion] dalam prompt, jadi ini sangat cocok. Berikut prompt audio yang saya gunakan:
[sighing] Nothing much is happening today. [surprised] Wait a minute... what are those on my ears?[laughing] Oh my gosh, I can't believe I got piercings last night! [angry] But hold on, I specifically told you not to let me do it!Untuk memuat berkas audio, saya menulis fungsi ini yang saya tambahkan ke utils.py:
def load_audio(file_path):
    if not os.path.exists(file_path):
        raise FileNotFoundError(f"Audio file not found at: {file_path}")

    # Guess the mime type (e.g., audio/mpeg for mp3, audio/wav for wav)
    mime_type, _ = mimetypes.guess_type(file_path)
    if mime_type is None:
        mime_type = "audio/mpeg" # Fallback to mp3 just in case

    with open(file_path, "rb") as audio_file:
        encoded_string = base64.b64encode(audio_file.read()).decode('utf-8')

    return f"data:{mime_type};base64,{encoded_string}"
Memberikan audio ke model caranya sangat mirip dengan gambar.
Kita memuatnya sebagai data URI base 64 dan mengirimkannya ke model dalam parameter contents, seperti ini:
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/cat.png")
            },
            "role": "reference_image"
        },
        {
            "type": "audio_url",
            "audio_url": {
                "url": utils.load_audio("./audio/voice.mp3")
            },
            "role": "reference_audio"
        }
    ],
    ratio="16:9",
    duration=11,
    watermark=True,
    resolution="480p",
)
Ini adalah video yang dihasilkan Seedance 2:
Kursus Teratas di DataCamp
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




