

कोर्स
Prompt Engineering को समझना
1 घंटा
239.8K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंइस ट्यूटोरियल में, मैं Python का उपयोग करके Seedance 2 के साथ इंटरैक्ट करने के लिए BytePlus Ark API का उपयोग करना दिखाऊंगा।
Seedance 2 ByteDance का एक शक्तिशाली जनरेटिव AI मॉडल है जो एक "मल्टीमोडल डायरेक्टर" की तरह काम करता है—यह टेक्स्ट, इमेज, वीडियो और ऑडियो इनपुट्स को एक साथ प्रोसेस कर समकालिक ऑडियो के साथ सिनेमैटिक वीडियो सीक्वेंसेज़ बनाता है। चाहे आप स्थिर छवियों को एनिमेट करना चाहें या जटिल टेक्स्ट प्रॉम्प्ट्स को जीवन देना, यह गाइड आपको सेटअप और इम्प्लीमेंटेशन से होकर ले जाएगा।
शुरू करने के लिए, हमें एक BytePlus खाता और API की बनानी होगी। ऐसा करने के लिए:
यह की ModelArk API—उनका आधिकारिक API—को रिक्वेस्ट भेजने के लिए उपयोग होती है।
सर्वोत्तम तरीका है कि की को उसी फ़ोल्डर में .env नामक फ़ाइल में रखें जहां हम अपने Python स्क्रिप्ट लिखते हैं। की को गोपनीय रखें, क्योंकि कोई भी इसका उपयोग आपके खाते से API के साथ इंटरैक्ट करने के लिए कर सकता है।
API की को .env फ़ाइल में इस फ़ॉर्मेट में पेस्ट करें:
ARK_API_KEY=<paste_api_key_here>Seedance 2 का उपयोग करने के लिए, हमें पहले मॉडल को सक्रिय करना होगा:
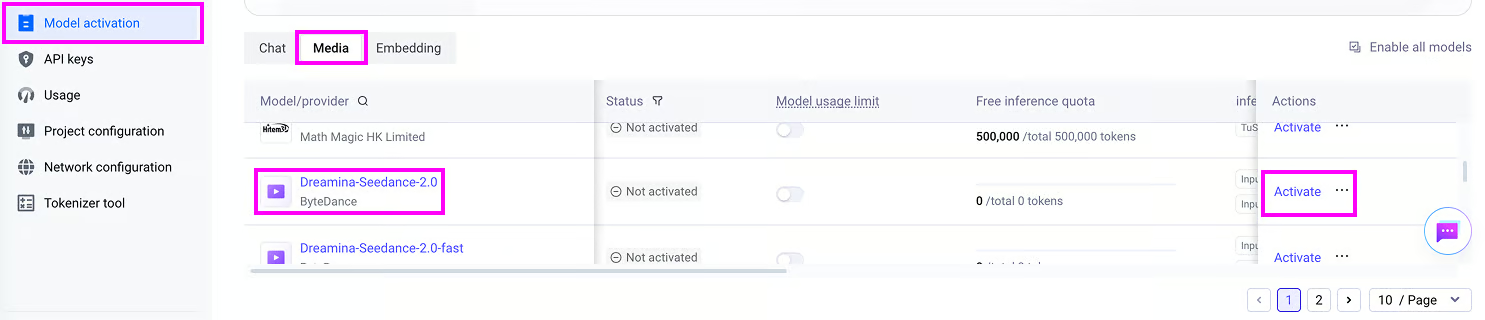
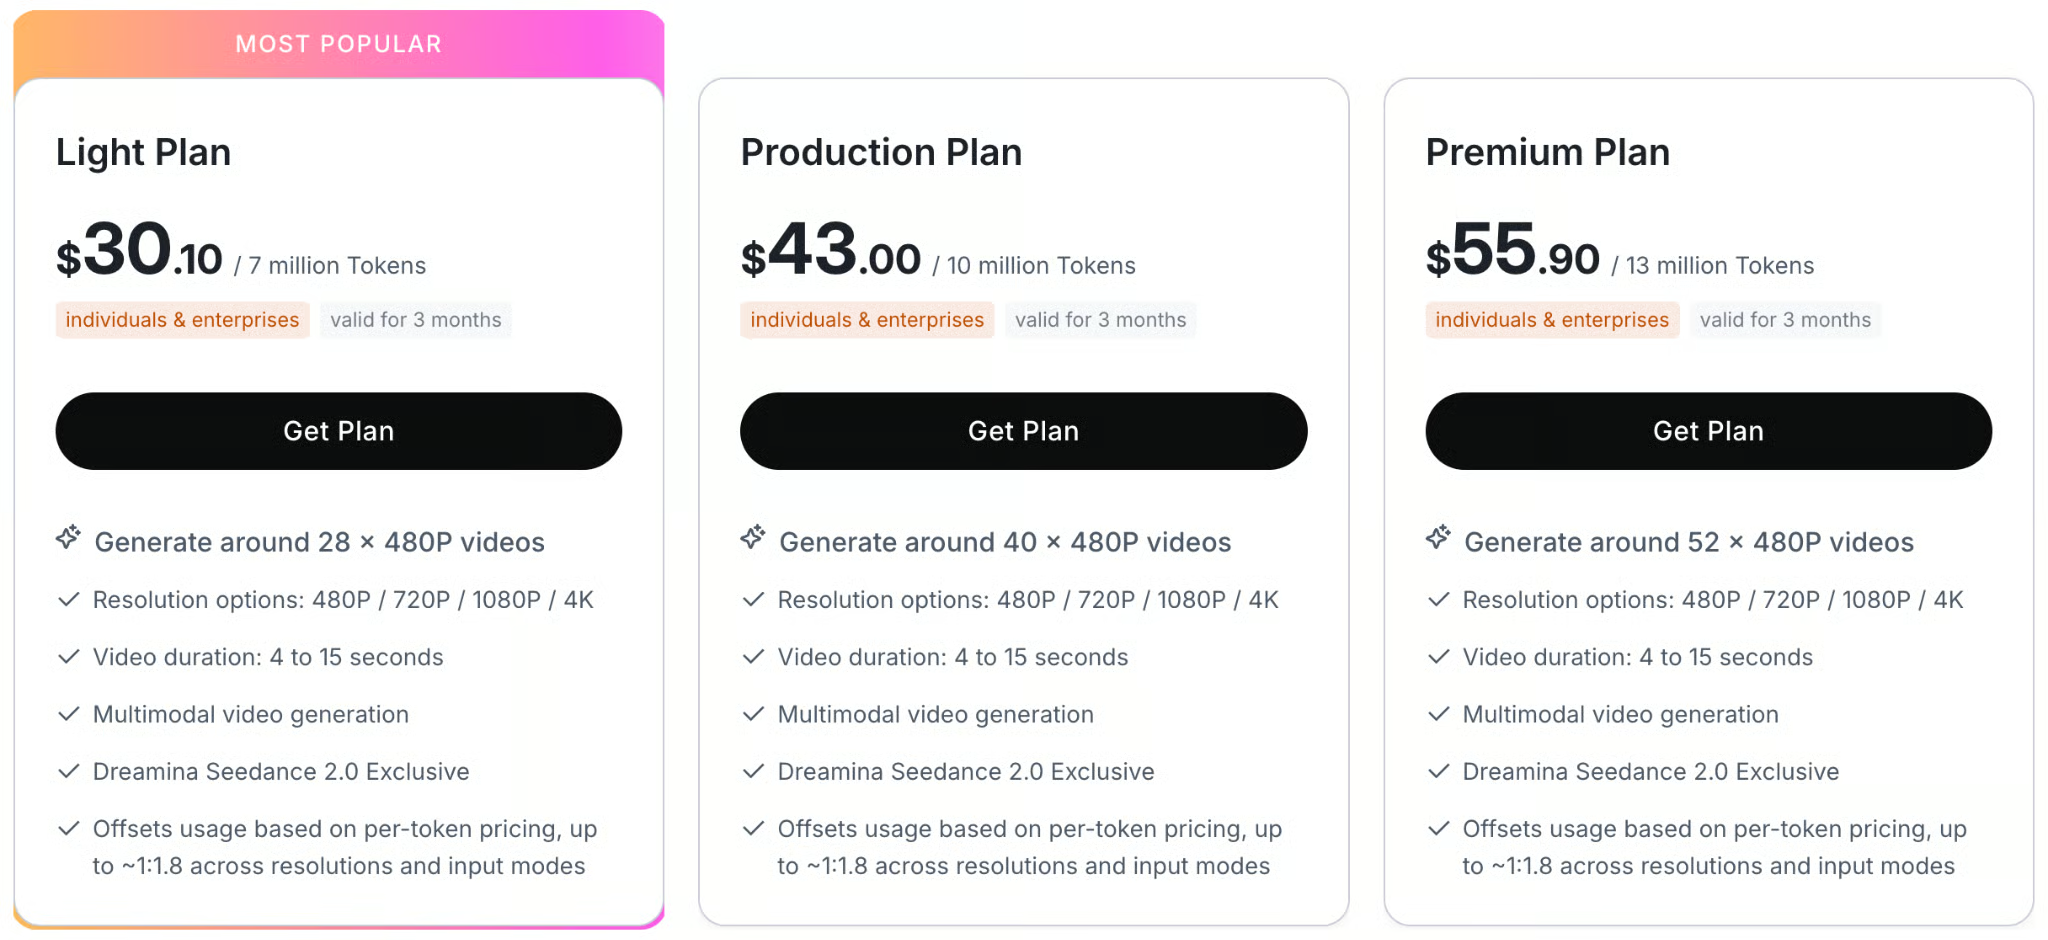
ध्यान दें कि API का उपयोग निःशुल्क नहीं है और Seedance 2 को सक्रिय करने के लिए मॉडल के लिए क्रेडिट खरीदने पड़ते हैं। इस लेख के लिए, मैंने Seedance 2 के लिए 70 लाख टोकन पैक $30.10 में खरीदा।
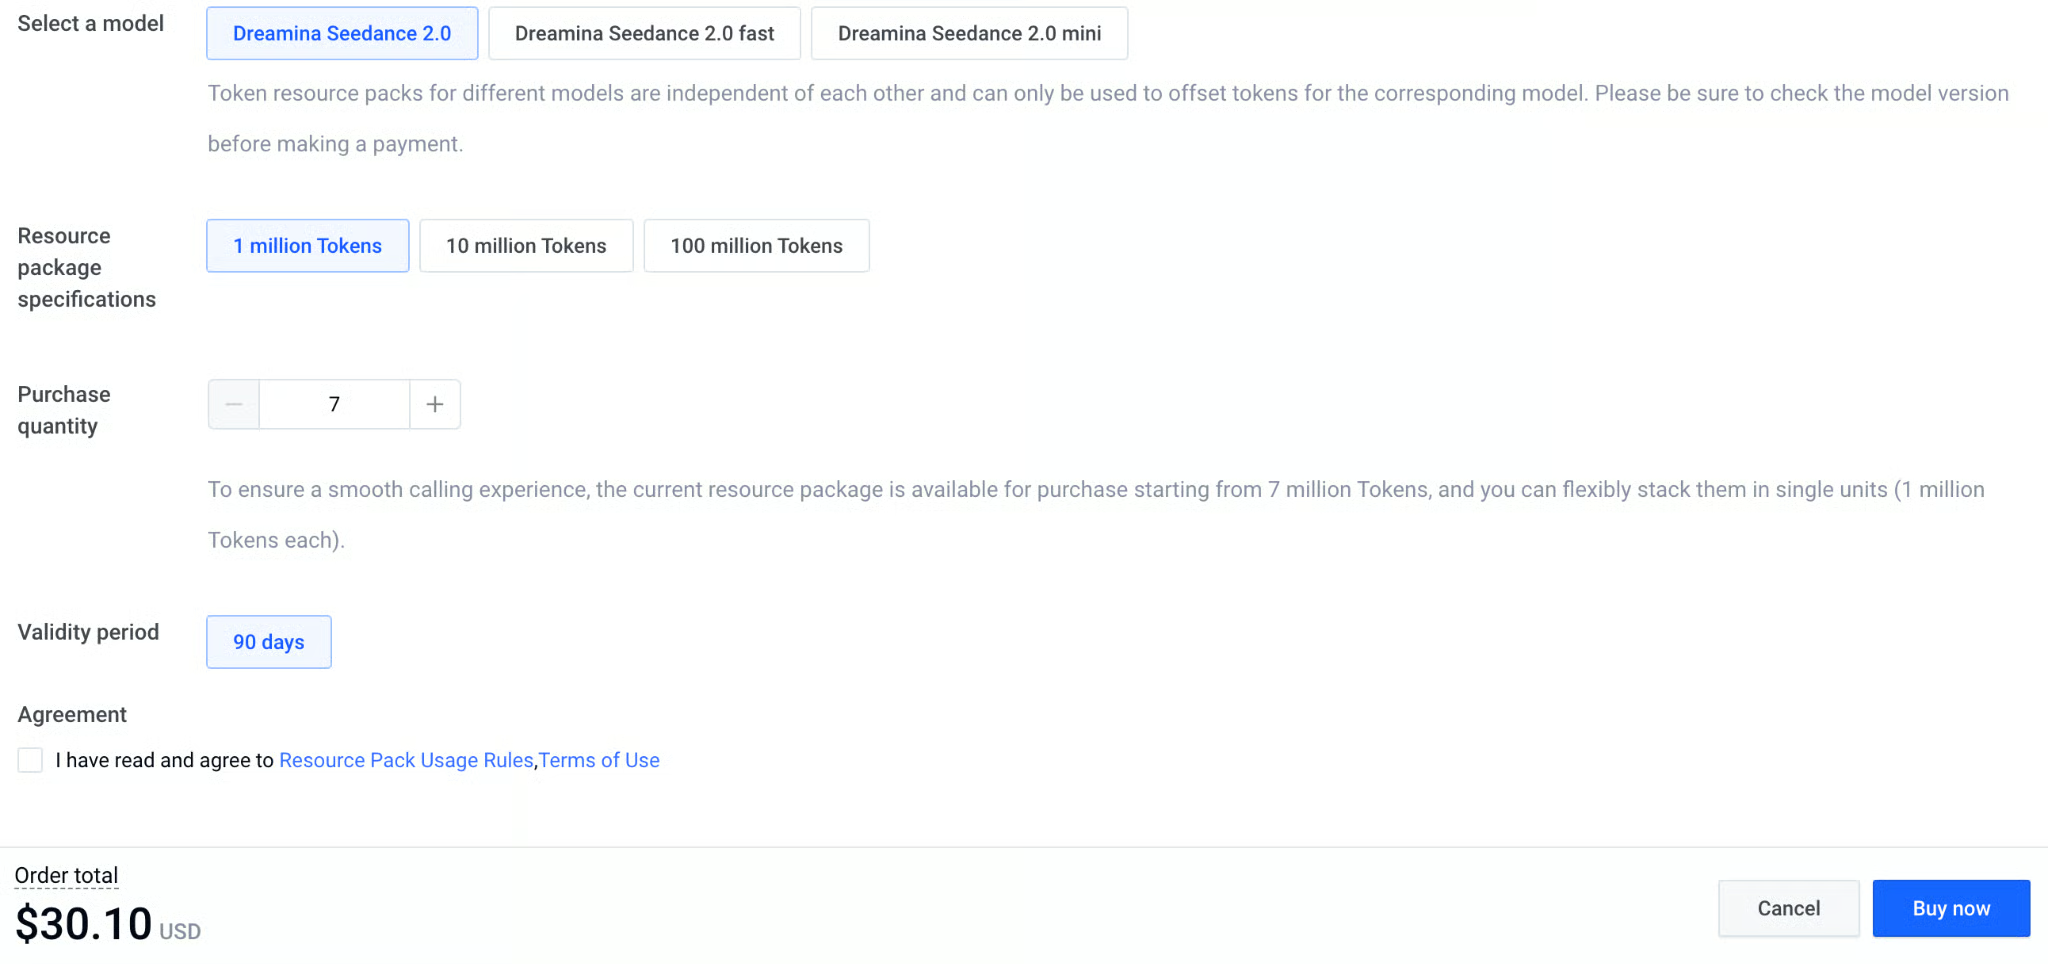
दुर्भाग्यवश, टोकन मॉडल-विशिष्ट होते हैं। यानी यदि हम Seedance 2 के fast या mini वेरिएंट्स के लिए टोकन खरीदते हैं, तो उन्हें बेस मॉडल के साथ उपयोग नहीं कर सकते।
नीचे API के प्राइसिंग प्लान्स की तालिका है:
मैंने इस ट्यूटोरियल में बनाए गए कोड के अनुरूप संपूर्ण स्क्रिप्ट्स इस GitHub रेपो में शामिल किए हैं।
इस सेक्शन में, हम टेक्स्ट-टू-वीडियो रिक्वेस्ट बनाना सीखेंगे ताकि यह वीडियो जनरेट हो:
Python के साथ BytePlus Ark API से कनेक्ट करने के लिए, हम आधिकारिक byteplus-python-sdk-v2 पैकेज का उपयोग करेंगे।
इस प्रोजेक्ट की डिपेंडेंसीज़ सेट करने का सरल तरीका है एक Anaconda वातावरण बनाना और requirements.txt फ़ाइल इंस्टॉल करना, इस तरह:
git clone git@github.com:fran-aubry/seedance2-tutorial.git
conda create --name seedance2 python=3.11
conda activate seedance2
pip install -r requirements.txtउसी फ़ोल्डर में एक नया स्क्रिप्ट text_to_video.py बनाएं जहां हमने पहले .env फ़ाइल बनाई थी।
सबसे पहले, हमें ज़रूरी पैकेज इम्पोर्ट करने हैं:
import os
from byteplussdkarkruntime import Ark
from dotenv import load_dotenv
इसके बाद, हम load_dotenv() फ़ंक्शन का उपयोग करके .env फ़ाइल से API की लोड करते हैं:
load_dotenv()
API_KEY = os.getenv("ARK_API_KEY")
अब हम Ark क्लाइंट इनिशियलाइज़ करते हैं, जो हमें BytePlus Ark API को रिक्वेस्ट भेजने देता है।
हम os लाइब्रेरी का उपयोग कर वातावरण वेरिएबल्स से API की लेते हैं और इंटरनेशनल API एक्सेस के लिए उपयुक्त बेस URL सेट करते हैं:
client = Ark(
    api_key=os.getenv("ARK_API_KEY"),
    base_url="https://ark.ap-southeast.bytepluses.com/api/v3"
)
अंत में, हम एक प्रॉम्प्ट सेट करते हैं और क्लाइंट के content_generation.tasks.create() फ़ंक्शन का उपयोग कर वीडियो जनरेट करते हैं:
prompt = """
A cinematic close-up of a weary but hopeful female astronaut inside a dimly lit, dusty spaceship cabin.
Soft blue light illuminates her face.
She takes a deep breath, showing subtle emotional relief, looks directly into the camera, and says:
'We finally made it. The atmosphere is stable.'
The ambient sound of a low, rhythmic spaceship engine hums in the background.
"""
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        }
    ],
    generate_audio=True,
    ratio="16:9",
    duration=8,
    watermark=True,
    resolution="480p",
)
task_id = response.id
print(f"Task successfully submitted! Task ID: {task_id}")
वीडियो जनरेट करने का अनुरोध करने के बाद, हमें तुरंत वीडियो नहीं मिलता क्योंकि वीडियो बनने में कुछ समय लगता है।
इसका मतलब है कि response वेरिएबल स्वयं वीडियो नहीं है।
इसके बजाय, यह एक ऑब्जेक्ट है जिसमें वीडियो जनरेशन टास्क के बारे में सूचना होती है।
विशेष रूप से, इसमें टास्क आइडेंटिफायर होता है, जो हमें वीडियो जनरेशन की प्रगति ट्रैक करने और मॉडल के पूरा होने पर वीडियो डाउनलोड करने देता है।
हम content_generation.tasks.get() फ़ंक्शन को टास्क आइडेंटिफायर देकर किसी टास्क का स्टेटस प्राप्त कर सकते हैं, इस तरह:
task = client.content_generation.tasks.get(task_id=task_id)
status = task.status
print(f"Status: {status}")
प्रगति ट्रैक करना आसान बनाने के लिए, हम उसी फ़ोल्डर में एक नई स्क्रिप्ट utils.py बनाते हैं और यह फ़ंक्शन जोड़ते हैं जो क्लाइंट इंस्टेंस और टास्क आइडेंटिफायर दिए जाने पर वीडियो प्रगति ट्रैक करता है:
import time
import requests

def poll_task(client, task_id, poll_interval=5):
    while True:
        try:
            task_status = client.content_generation.tasks.get(task_id=task_id)
            status = getattr(task_status, "status", None) or (task_status.get("status") if isinstance(task_status, dict) else None)

            if status == "succeeded":
                print("\nTask completed successfully.")
                return task_status.content.video_url

            elif status == "failed":
                error_details = getattr(task_status, "error", "Unknown error occurred during processing.")
                raise RuntimeError(f"Task failed: {error_details}")

            print(".", end="", flush=True)
            time.sleep(poll_interval)
        except Exception as e:
            if isinstance(e, RuntimeError):
                raise
            print(f"\nWarning: Error polling task (will retry): {e}")
time.sleep(poll_interval)poll_task() फ़ंक्शन जो हमने ऊपर इम्प्लीमेंट किया है, वीडियो
अब जब हम वीडियो जनरेशन प्रक्रिया को ट्रैक कर सकते हैं, तो हमें बस एक तरीका चाहिए जिससे यह पूरा होते ही हम उसे डाउनलोड कर सकें।
क्योंकि BytePlus Ark API टास्क रिस्पॉन्स में जनरेटेड वीडियो फ़ाइल का डायरेक्ट URL लौटाता है, इसलिए हम इसे requests लाइब्रेरी से डाउनलोड कर सकते हैं।
यहां एक फ़ंक्शन है जो यह काम करता है:
def download_video(url, output_path = "video.mp4"):
    try:
        print(f"Downloading video from {url} to {output_path}...")
        response = requests.get(url, stream=True)
        response.raise_for_status()

        with open(output_path, 'wb') as f:
            for chunk in response.iter_content(chunk_size=8192):
                f.write(chunk)
        print(f"Video successfully downloaded to '{output_path}'")
        return True
    except Exception as e:
        print(f"Error downloading video: {e}")
return Falseइन सबको एक साथ रखते हुए, यहां एक पूर्ण स्क्रिप्ट है जो Seedance 2 का उपयोग कर टेक्स्ट प्रॉम्प्ट से वीडियो जनरेट करती है:
import os
from byteplussdkarkruntime import Ark
from dotenv import load_dotenv
import utils

load_dotenv()
API_KEY = os.getenv("ARK_API_KEY")

client = Ark(
    api_key=os.getenv("ARK_API_KEY"),
    base_url="https://ark.ap-southeast.bytepluses.com/api/v3"
)

prompt = """
A cinematic close-up of a weary but hopeful female astronaut inside a dimly lit, dusty spaceship cabin.
Soft blue light illuminates her face.
She takes a deep breath, showing subtle emotional relief, looks directly into the camera, and says:
'We finally made it. The atmosphere is stable.'
The ambient sound of a low, rhythmic spaceship engine hums in the background.
"""

response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        }
    ],
    generate_audio=True,
    ratio="16:9",
    duration=8,
    watermark=True,
    resolution="480p",
)

task_id = response.id
print(f"Task successfully submitted! Task ID: {task_id}")

# Wait for the video to finish generating
video_url = utils.poll_task(client, task_id)

utils.download_video(video_url, "./videos/space.mp4")नीचे वीडियो जनरेशन रिक्वेस्ट के कोर पैरामीटर्स के स्वीकृत मानों की सूची है:
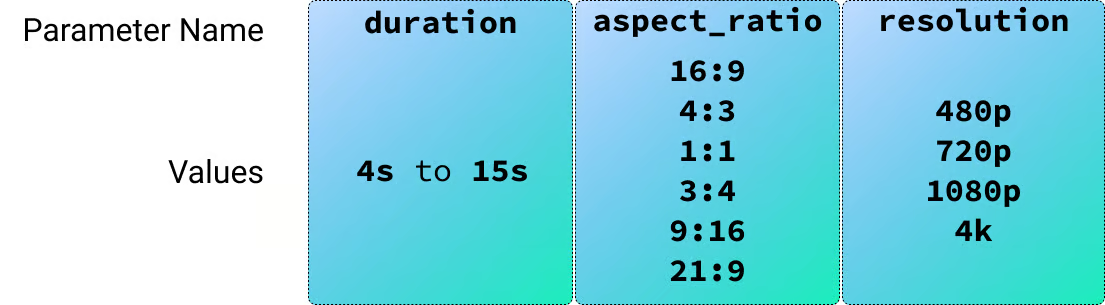
पिछले सेक्शन में, हमने टेक्स्ट प्रॉम्प्ट का उपयोग कर वीडियो जनरेट करना सीखा। Seedance 2 इमेज, वीडियो और ऑडियो इनपुट्स को भी सपोर्ट करता है, तो चलिए इमेज से शुरू करते हैं।
इमेज इनपुट्स को परखने के लिए, मैंने सिटकॉम-जैसे सीन में उपयोग हेतु AI से दो कैरेक्टर जनरेट किए।
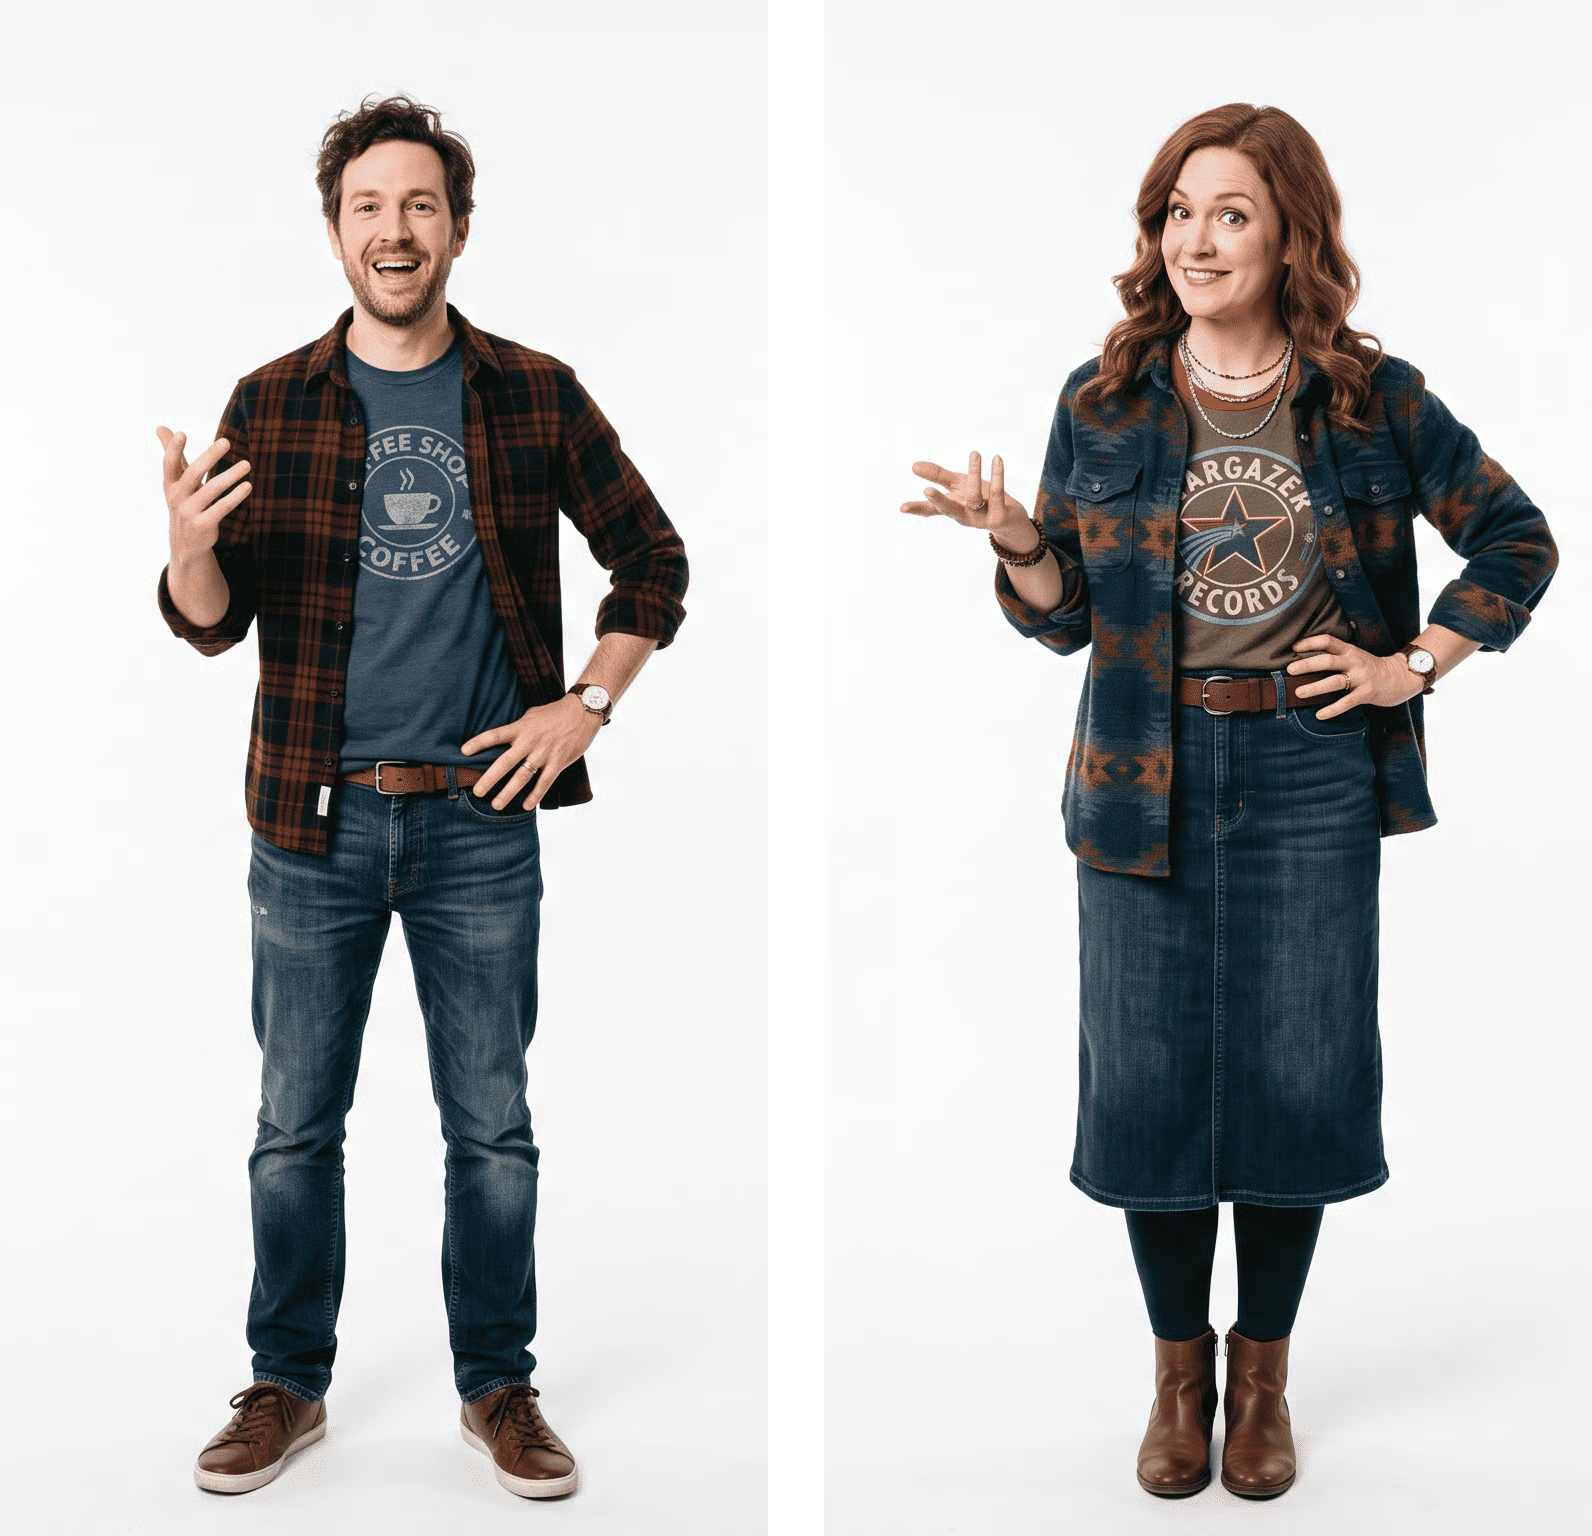
हम इमेज रेफ़रेंस को रिक्वेस्ट के content फ़ील्ड में इस तरह जोड़कर मॉडल को दे सकते हैं:
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/male-character.png")
            },
            "role": "reference_image"
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/female-character.png")
            },
            "role": "reference_image"
        }
    ],
    generate_audio=True,
    ratio="16:9",
    duration=15,
    watermark=True,
    resolution="480p",
)
इस वीडियो के लिए, मैंने यह प्रॉम्प्ट इस्तेमाल किया:
Context: A cozy, warmly lit independent coffee shop counter with wooden accents.
Reference:
- The male barista's face and clothing follow @Image1.
- The female customer's face and styling follow @Image2.

Action & Dialogue (10 Seconds Total):

0:00 - 0:04:
Medium close-up on the male barista (@Image1) standing behind the counter,
next to the coffee machine. He leans across the counter with a smooth,
flirtatious smirk, acting like he is making a highly exclusive offer:
"The WiFi password? It's actually my phone number: five-five-five, zero-one—"

0:04 - 0:07:
Camera cuts to the female customer (@Image2), instantly interrupting him.
She holds up her phone screen toward him, entirely unimpressed:
"Your network is called 'Free_Guest_WiFi' and there is literally no password."

0:07 - 0:08: Quick cut back to the two-shot.
Flustered, the barista becomes visibly embarrassed, his confident smirk
instantly vanishing as he nervously breaks eye contact.

0:08 - 0:10: Camera cuts back to a medium shot of the female customer (@Image2).
She lowers her phone, tapping her fingers lightly on the counter,
and delivers her order with perfect deadpan clarity:
"It will be an espresso please. No milk, no sugar, and no phone number."

Framing/Timing:
Clean cuts to perfectly pace the comedic timing over exactly 10 seconds.

Tone/Audio:
Lighthearted sitcom vibe. Synchronized voice generation for the dialogue, a subtle low cafe background hum, and the sound of the customer's fingers lightly tapping the wooden counter at the end.
ध्यान दें कि प्रॉम्प्ट में @Image1 और @Image2 का उपयोग सूची में दिए गए क्रम के अनुसार छवियों का संदर्भ देने के लिए किया गया है।
दुर्भाग्य से, जब मैंने यह वीडियो जनरेट करने की कोशिश की, तो मुझे यह त्रुटि मिली:
The request failed because the input image may contain a real person.मैंने यह लगातार देखा जब भी मैंने Seedance 2 को किसी यथार्थवादी मानव वाली रेफ़रेंस इमेज के साथ उपयोग करने की कोशिश की, भले ही वे AI-जनरेटेड हों।
इसे पार करने के लिए, मैंने कैरेक्टर्स को कार्टून में बदल दिया और फिर प्रयास किया।
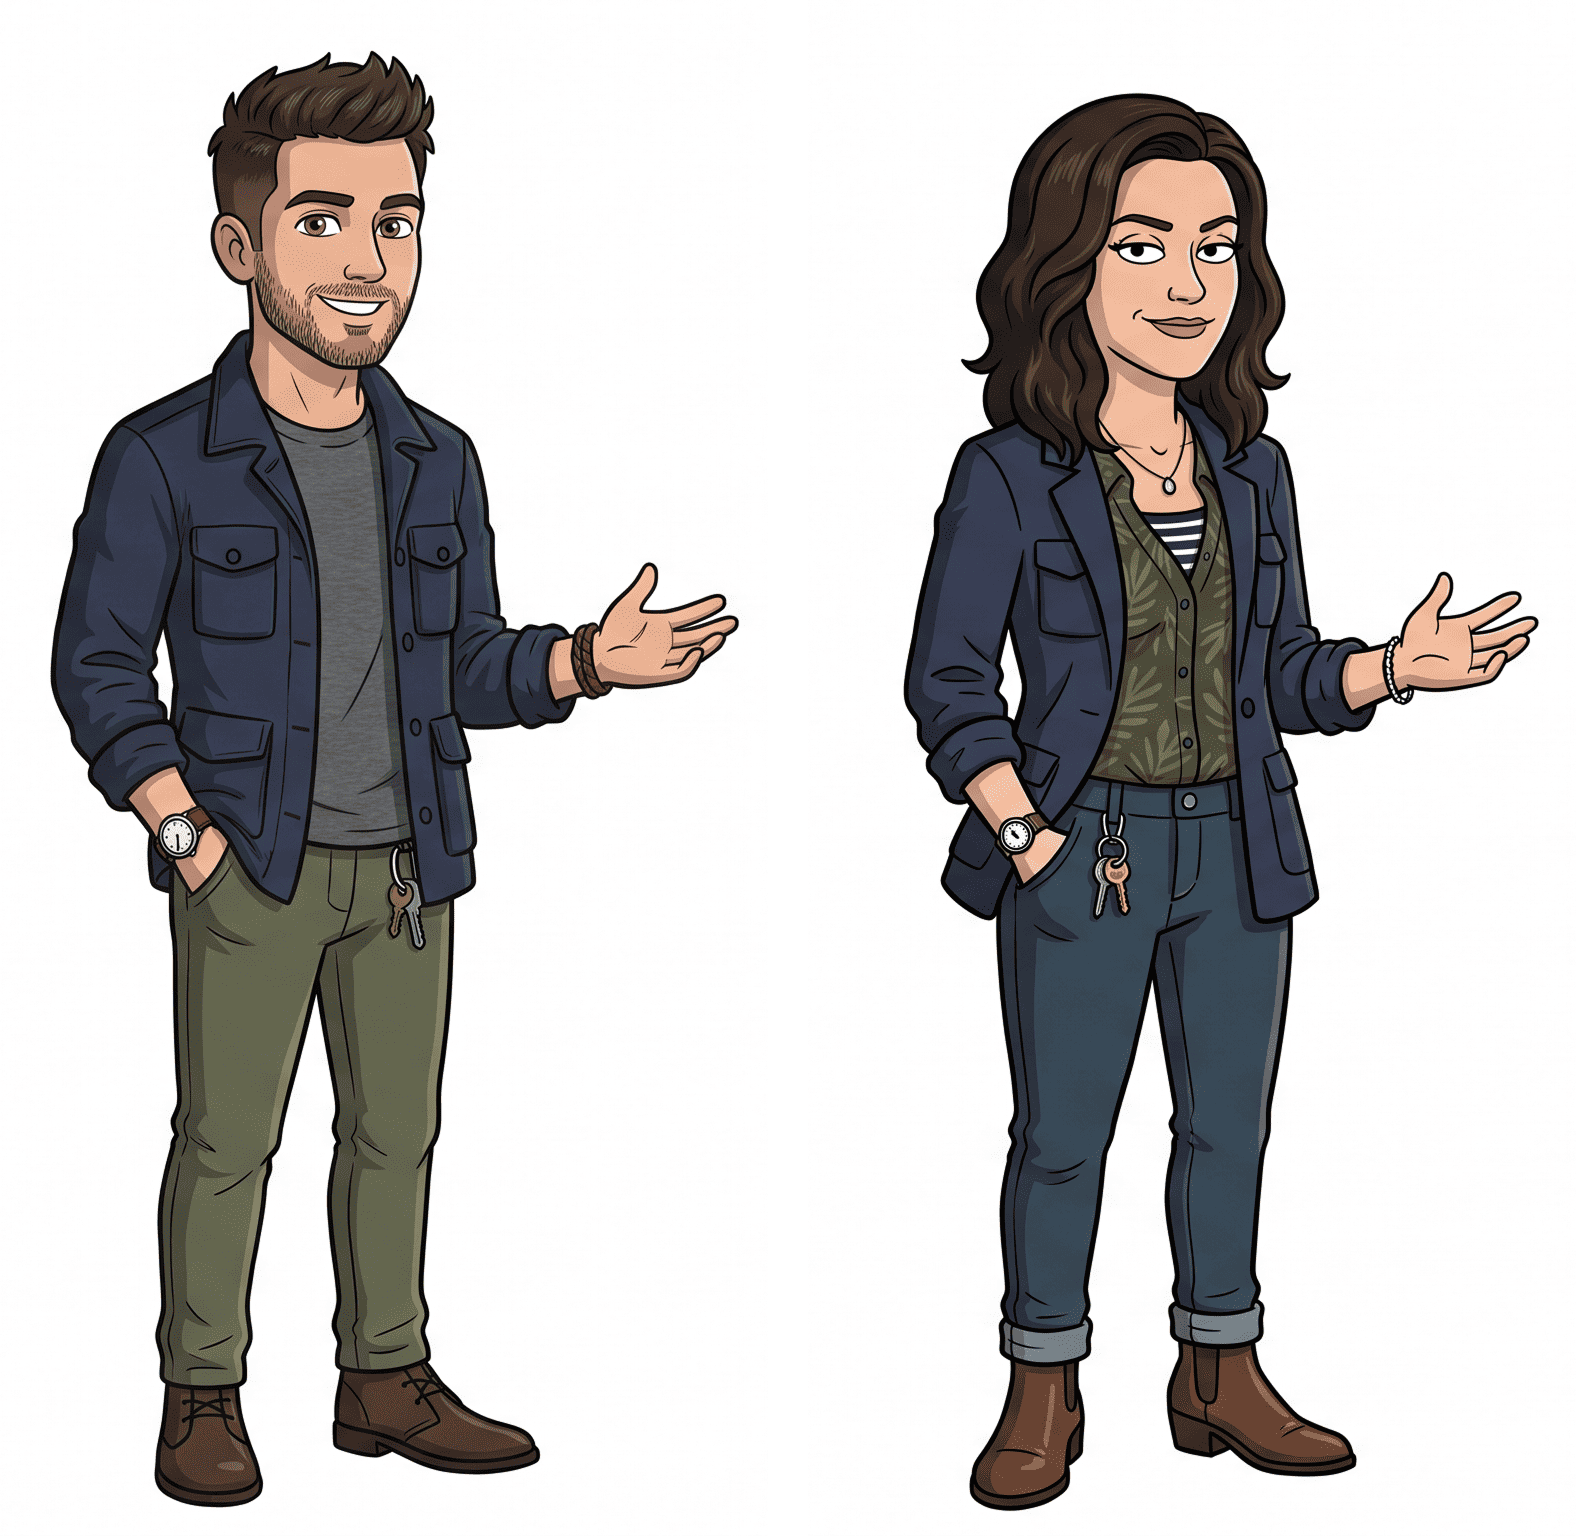
इस बार यह पूरी तरह काम किया, और मेरा मानना है कि परिणाम बिल्कुल वैसा ही था जैसा मैं बनाना चाहता था।
इस उदाहरण का पूरा कोड image_to_video.py फ़ाइल में मिल सकता है।
पिछले उदाहरण ने दिखाया कि रिक्वेस्ट में ”role”: “reference_image” सेट करके इमेज को रेफ़रेंस के रूप में कैसे उपयोग किया जाए।
Seedance 2 दो अन्य इमेज रोल्स को सपोर्ट करता है:
”first_frame”: मॉडल को निर्देश देता है कि प्रदान की गई इमेज को जनरेटेड वीडियो के ठीक शुरुआती फ़्रेम के रूप में उपयोग करे। यह डायरेक्ट इमेज-टू-वीडियो जनरेशन की मानक सेटिंग है।”last_frame”: मॉडल को निर्देश देता है कि जनरेटेड वीडियो को इस विशिष्ट इमेज पर समाप्त करे। नोट: आप इसे तभी उपयोग कर सकते हैं जब आप उसी रिक्वेस्ट में first_frame भी प्रदान कर रहे हों, यानी मॉडल से दोनों इमेज के बीच इंटरपोलेट करने के लिए कह रहे हों।मैंने इसे इस तरह आज़माया: शुरुआत के कई फ़्रेम जनरेट किए जो दिखाते हैं कि एक रोबोट AI लैब ऐसी दुनिया में पौधों को फिर से बनाने की कोशिश कर रही है जहां प्राकृतिक जीवन समाप्त हो चुका है।
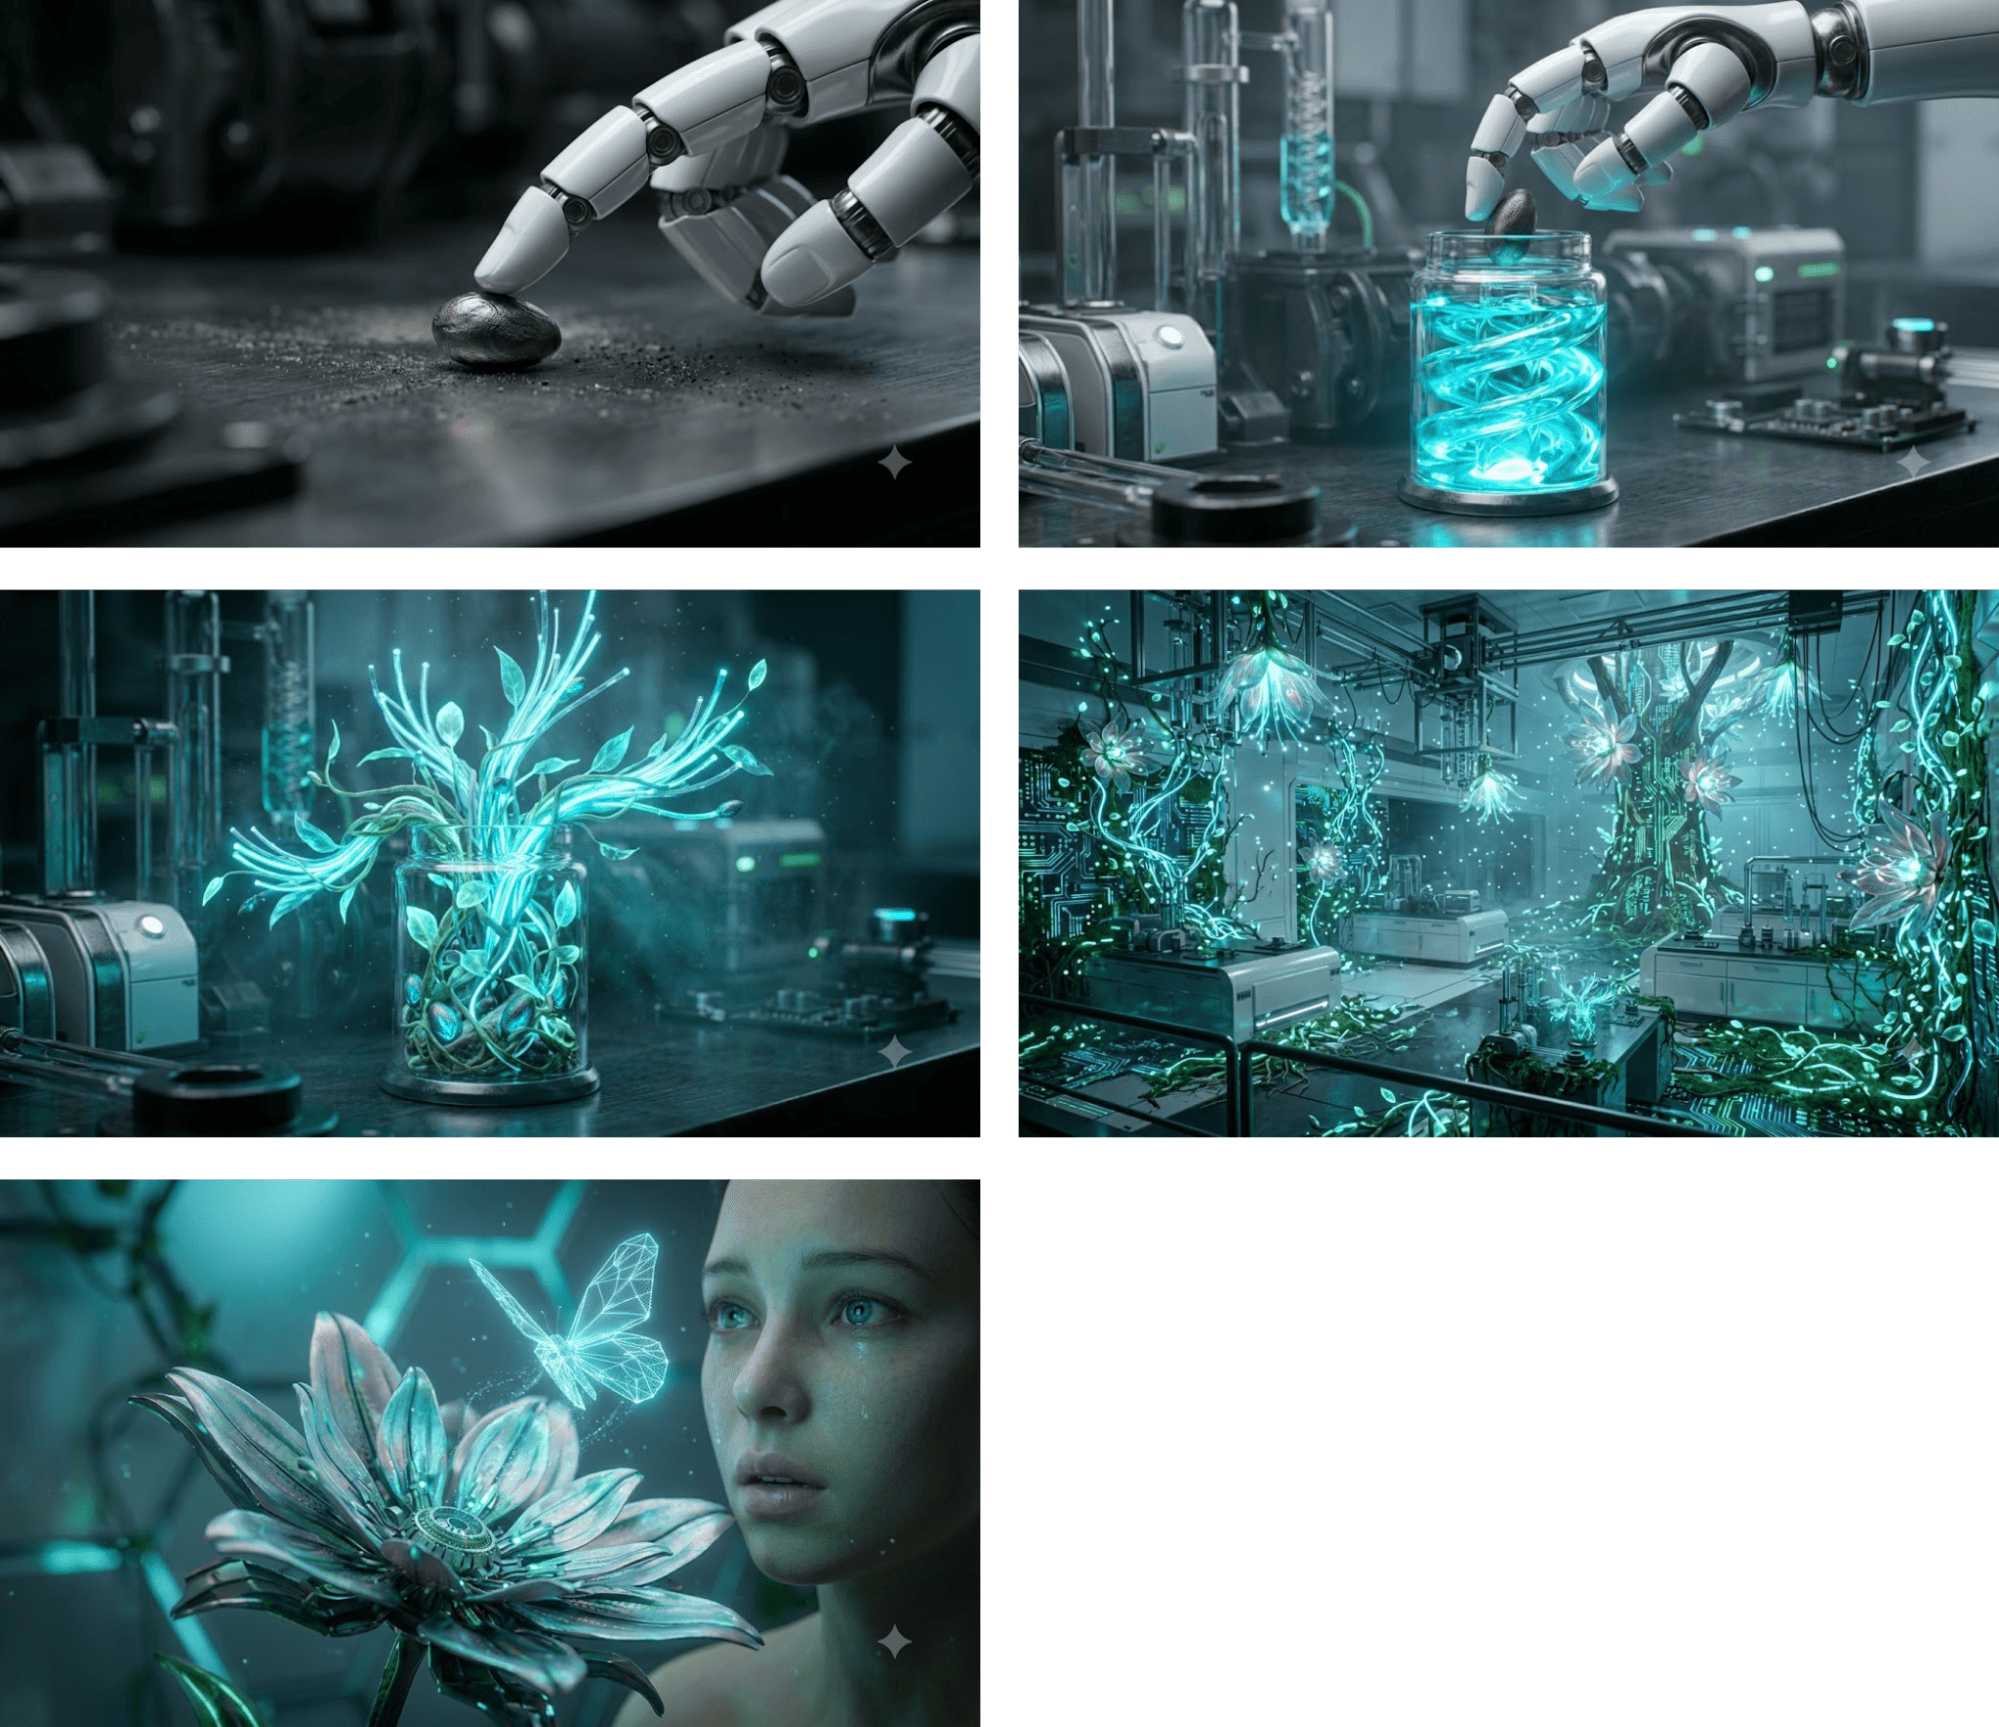
प्रत्येक फ़्रेम के लिए, मैंने उसी फ़्रेम को फर्स्ट फ़्रेम मानकर एक वीडियो जनरेट किया। हर रिक्वेस्ट को इस तरह स्ट्रक्चर करें:
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/robot-lab1.jpeg")
            },
            "role": "first_frame"
        }
    ],
    generate_audio=False,
    ratio="16:9",
    duration=4,
    watermark=True,
    resolution="480p",
)
मैंने वीडियो बिना ऑडियो के जनरेट किए क्योंकि ऑडियो सुसंगत नहीं रहता—क्योंकि हर वीडियो अलग से जनरेट हुआ। पांचों क्लिप्स को जोड़ने का परिणाम यह है:
स्टार्टिंग फ़्रेम के आधार पर वीडियो जनरेट करने के लिए प्रयुक्त पूर्ण स्क्रिप्ट यहां मिल सकती है।
last_frame के साथ इमेज इंटरपोलेशनइस उदाहरण में, हम first_frame और last_frame दोनों देते हैं ताकि इनके बीच वीडियो जनरेट हो।
मैंने एक ही कमरे की दो छवियां जनरेट कीं—एक बिना फर्नीचर के खाली, और दूसरी पूरी तरह सुसज्जित। लक्ष्य है ऐसा वीडियो जनरेट करना जिसमें कमरा सुसज्जित होता दिखे।
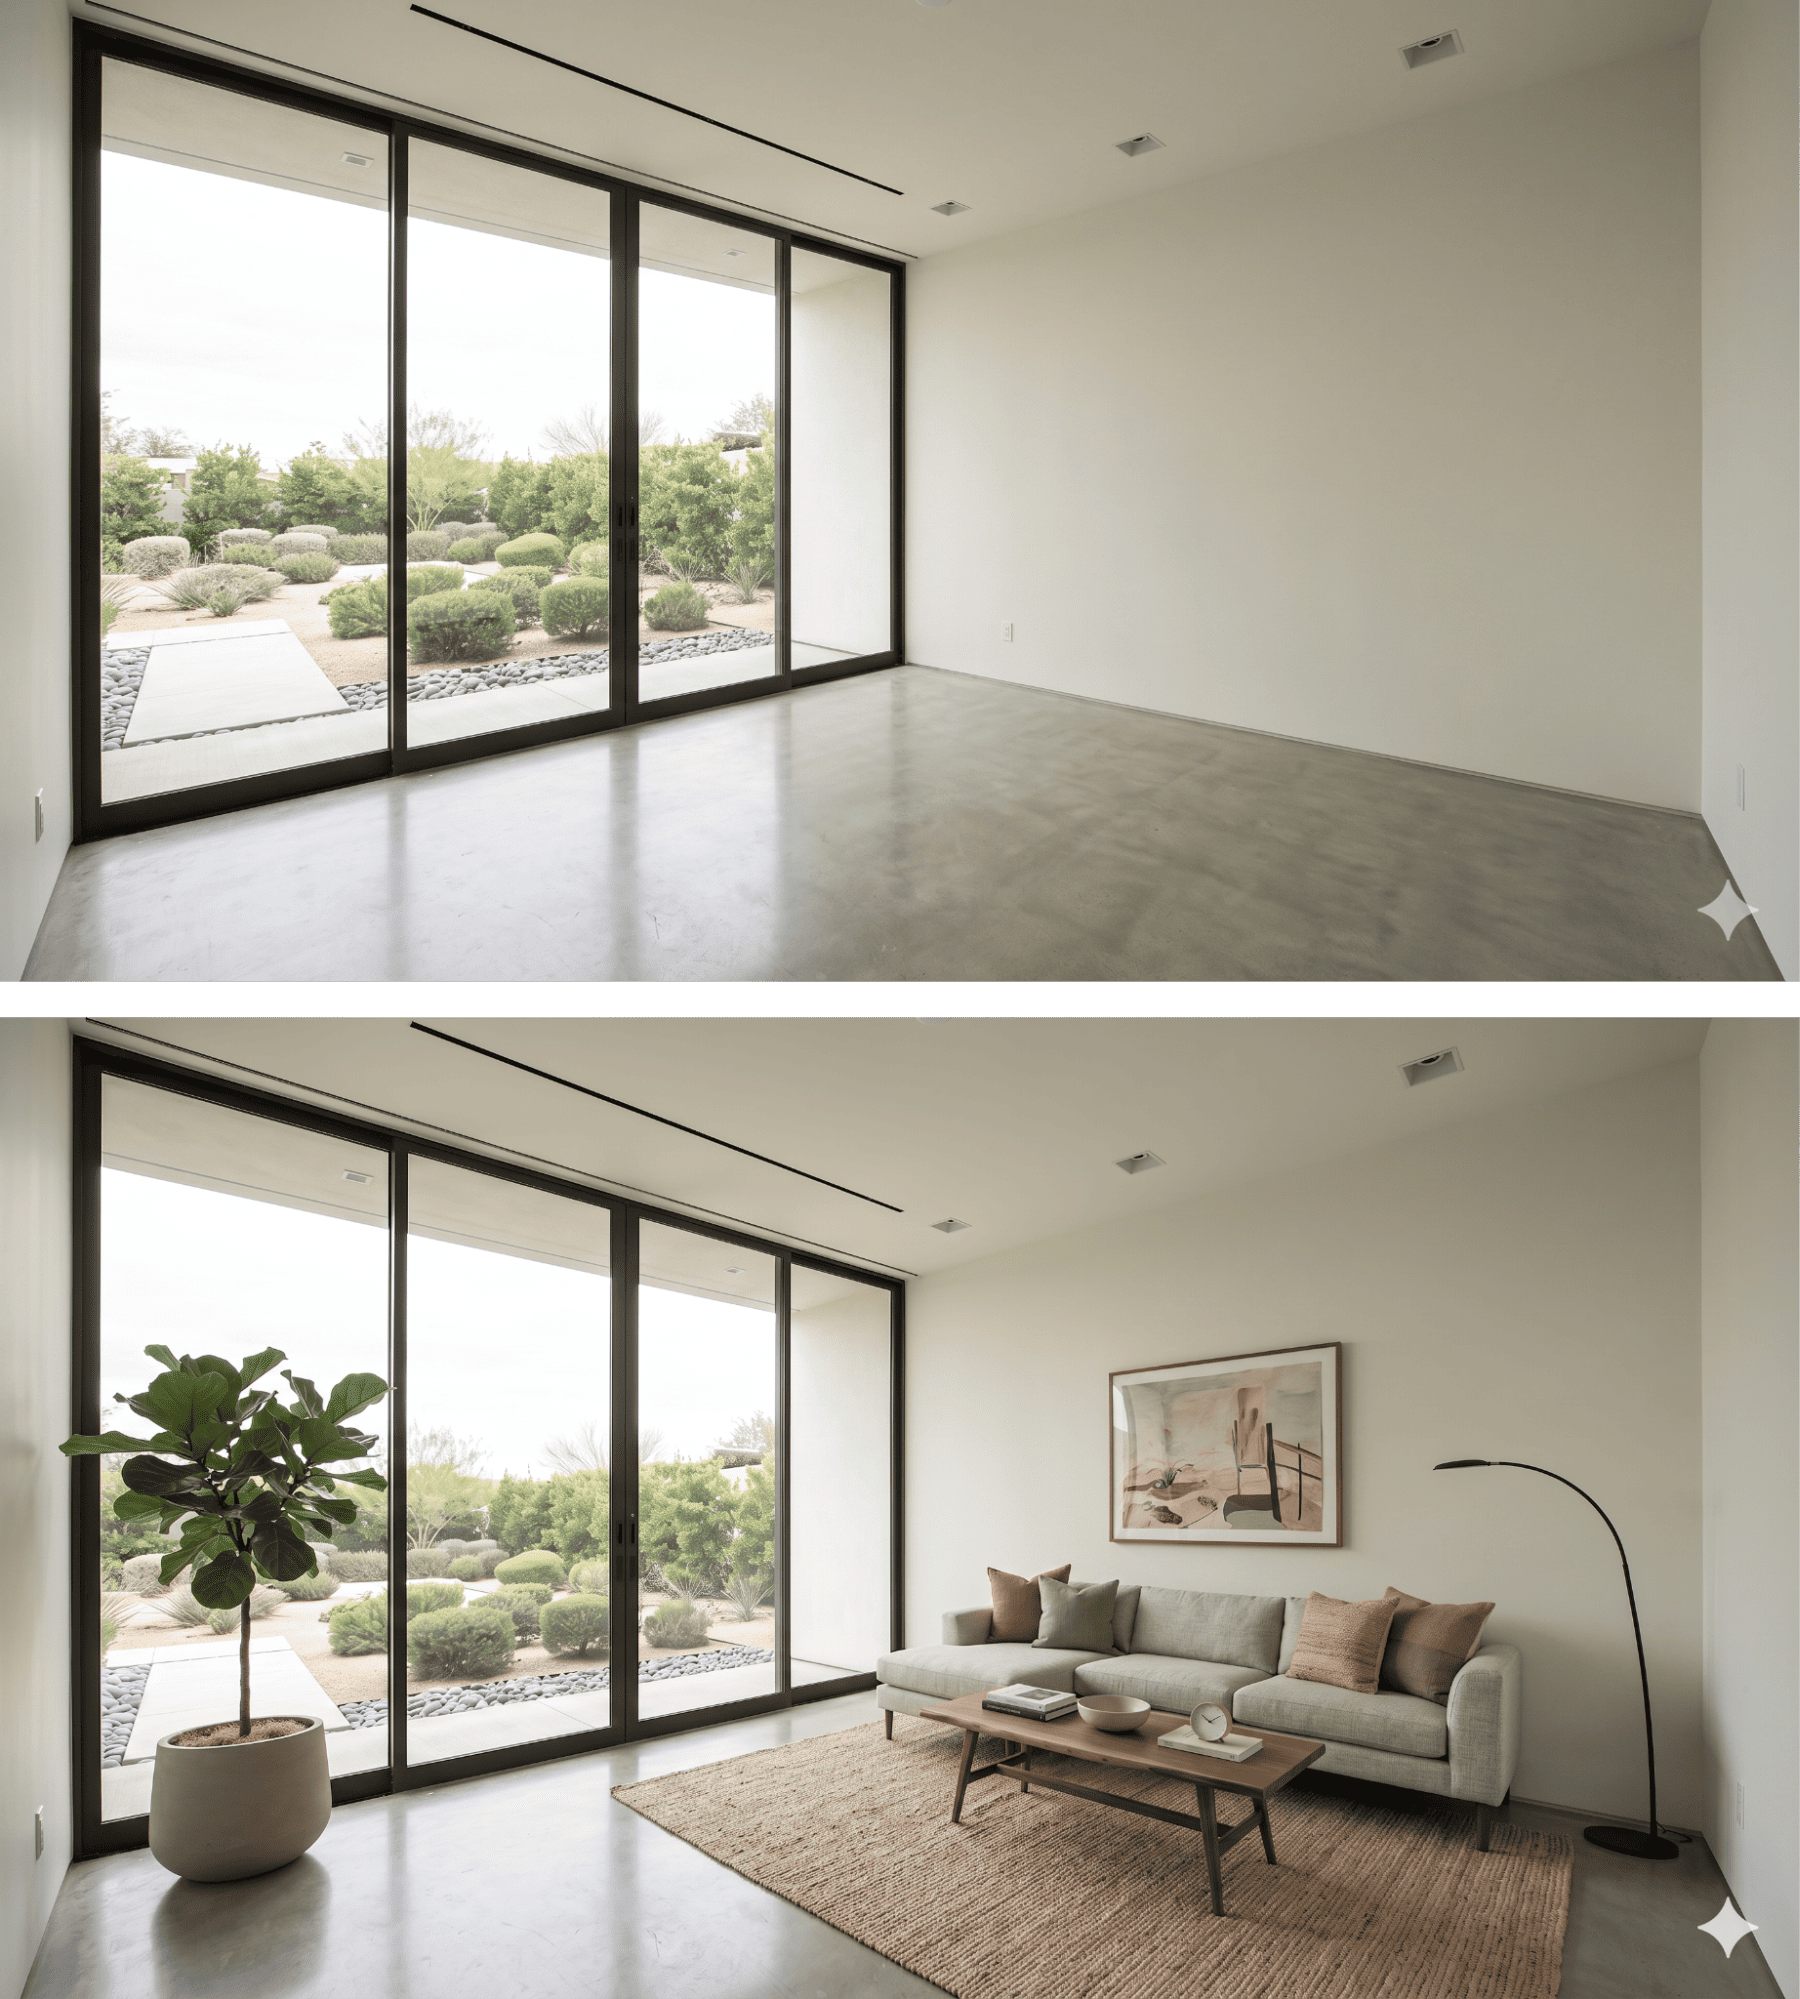
मैंने जो प्रॉम्प्ट इस्तेमाल किया, वह बताता है कि वीडियो में फर्नीचर कैसे दिखाई दे:
A dynamic, fast-paced sequence where furniture pops into existence piece by piece. First, a rug rapidly unfolds itself, then the sofa drops from just above the floor with a heavy, realistic bounce. Lamps, artwork, and plants quickly spring into reality one after another. Vibrant lighting, photorealistic materials, lively and snappy energetic rhythm.यह रही रिक्वेस्ट:
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/room-start.png")
            },
            "role": "first_frame"
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/room-end.png")
            },
            "role": "last_frame"
        }
    ],
    generate_audio=True,
    ratio="16:9",
    duration=8,
    watermark=True,
    resolution="480p",
)
और यह रहा परिणाम:
इसे जनरेट करने के लिए, मैंने निम्न रिक्वेस्ट का उपयोग किया:
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        },
        {
            "type": "video_url",
            "video_url": {
                "url": "https://www.pexels.com/download/video/38213009/"
            },
            "role": "reference_video"
        }
    ],
    generate_audio=True,
    ratio="16:9",
    duration=6,
    watermark=True,
    resolution="480p",
)
पूर्ण स्क्रिप्ट यहां मिल सकती है। मेरा इस्तेमाल किया गया प्रॉम्प्ट था:
The original skater, environment, and camera movement must remain
unchanged and untouched.

Only add gaming-style visual effects: intense glowing sparks and electric arcs
streaming from the skateboard-rail contact point during the grind, and a
brilliant energy shockwaves and dust burst at the jump/pop.
ऑडियो इनपुट्स को परखने के लिए, मैंने एक कैरेक्टर के लिए इमेज जनरेट की और Fish Audio का उपयोग अलग-अलग इमोशंस वाली ऑडियो ट्रैक जनरेट करने के लिए किया।
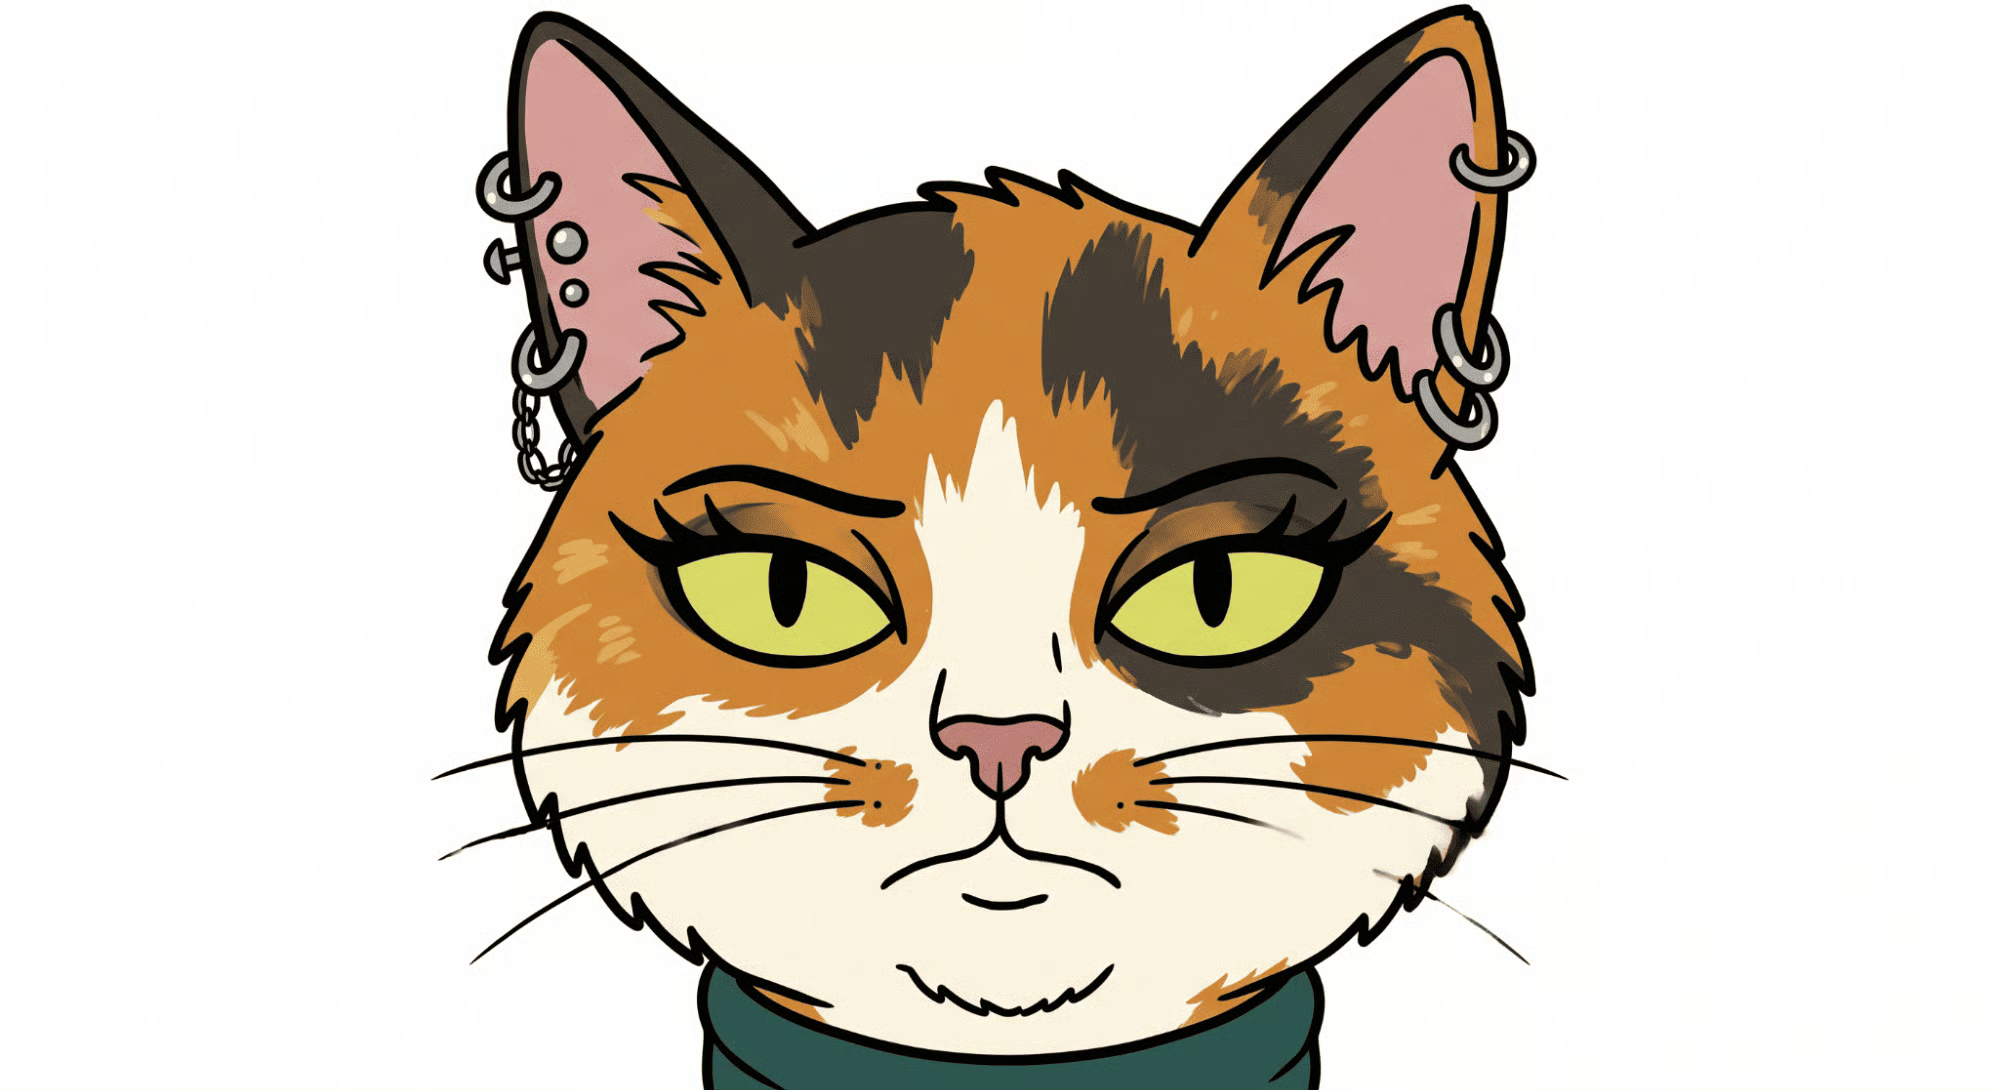
ऑडियो के लिए, मैं कुछ अलग-अलग इमोशंस चाहता था ताकि देख सकूं कि Seedance 2 वीडियो जनरेट करते समय उन्हें पहचान पाता है या नहीं।
Fish Audio AI हमें प्रॉम्प्ट में [emotion] का उपयोग कर इमोशंस बताने देता है, इसलिए यह काम के लिए उपयुक्त था। यह रहा मैंने उपयोग किया हुआ ऑडियो प्रॉम्प्ट:
[sighing] Nothing much is happening today. [surprised] Wait a minute... what are those on my ears?[laughing] Oh my gosh, I can't believe I got piercings last night! [angry] But hold on, I specifically told you not to let me do it!ऑडियो फ़ाइल लोड करने के लिए, मैंने यह फ़ंक्शन लिखा और utils.py में जोड़ा:
def load_audio(file_path):
    if not os.path.exists(file_path):
        raise FileNotFoundError(f"Audio file not found at: {file_path}")

    # Guess the mime type (e.g., audio/mpeg for mp3, audio/wav for wav)
    mime_type, _ = mimetypes.guess_type(file_path)
    if mime_type is None:
        mime_type = "audio/mpeg" # Fallback to mp3 just in case

    with open(file_path, "rb") as audio_file:
        encoded_string = base64.b64encode(audio_file.read()).decode('utf-8')

    return f"data:{mime_type};base64,{encoded_string}"
मॉडल को ऑडियो देना इमेज की तरह ही काम करता है।
हम उन्हें एक base64 डेटा URI के रूप में लोड करते हैं और contents पैरामीटर में मॉडल को सबमिट करते हैं, इस तरह:
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/cat.png")
            },
            "role": "reference_image"
        },
        {
            "type": "audio_url",
            "audio_url": {
                "url": utils.load_audio("./audio/voice.mp3")
            },
            "role": "reference_audio"
        }
    ],
    ratio="16:9",
    duration=11,
    watermark=True,
    resolution="480p",
)
यह है वह वीडियो जो Seedance 2 ने जनरेट किया:
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें