Curso
Noções Básicas de Engenharia de Prompts.
1 h
236.5K
Neste tutorial, vou mostrar como usar a API BytePlus Ark para interagir com a Seedance 2 usando Python.
Seedance 2 é um poderoso modelo de IA generativa da ByteDance que funciona como um "diretor multimodal", capaz de processar texto, imagens, vídeo e áudio ao mesmo tempo para criar sequências cinematográficas com áudio sincronizado. Seja para animar imagens estáticas ou dar vida a prompts de texto complexos, este guia vai te conduzir pela configuração e implementação.
Para começar, precisamos criar uma conta na BytePlus e gerar uma chave de API. Para isso:
Essa chave é usada para fazer requisições à ModelArk API, a API oficial deles.
A boa prática é armazenar a chave em um arquivo chamado .env na mesma pasta onde escrevemos nossos scripts Python. Mantenha a chave em sigilo, pois qualquer pessoa pode usá-la para interagir com a API pela sua conta.
Cole a chave de API no arquivo .env com o seguinte formato:
ARK_API_KEY=<paste_api_key_here>Para usar a Seedance 2, primeiro precisamos ativar o modelo:
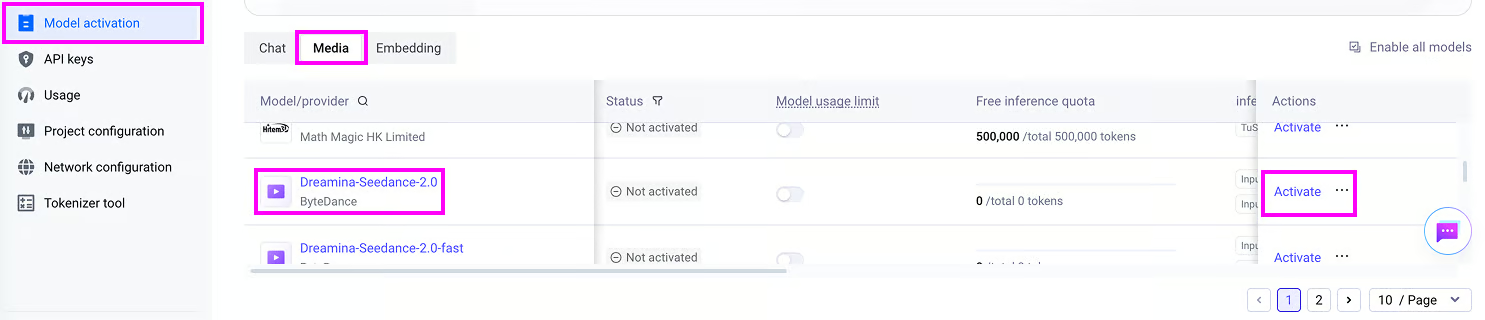
Observe que o uso da API não é gratuito e ativar a Seedance 2 exige a compra de créditos específicos do modelo. Para este artigo, comprei um pacote de 7 milhões de tokens para a Seedance 2 por US$ 30,10.
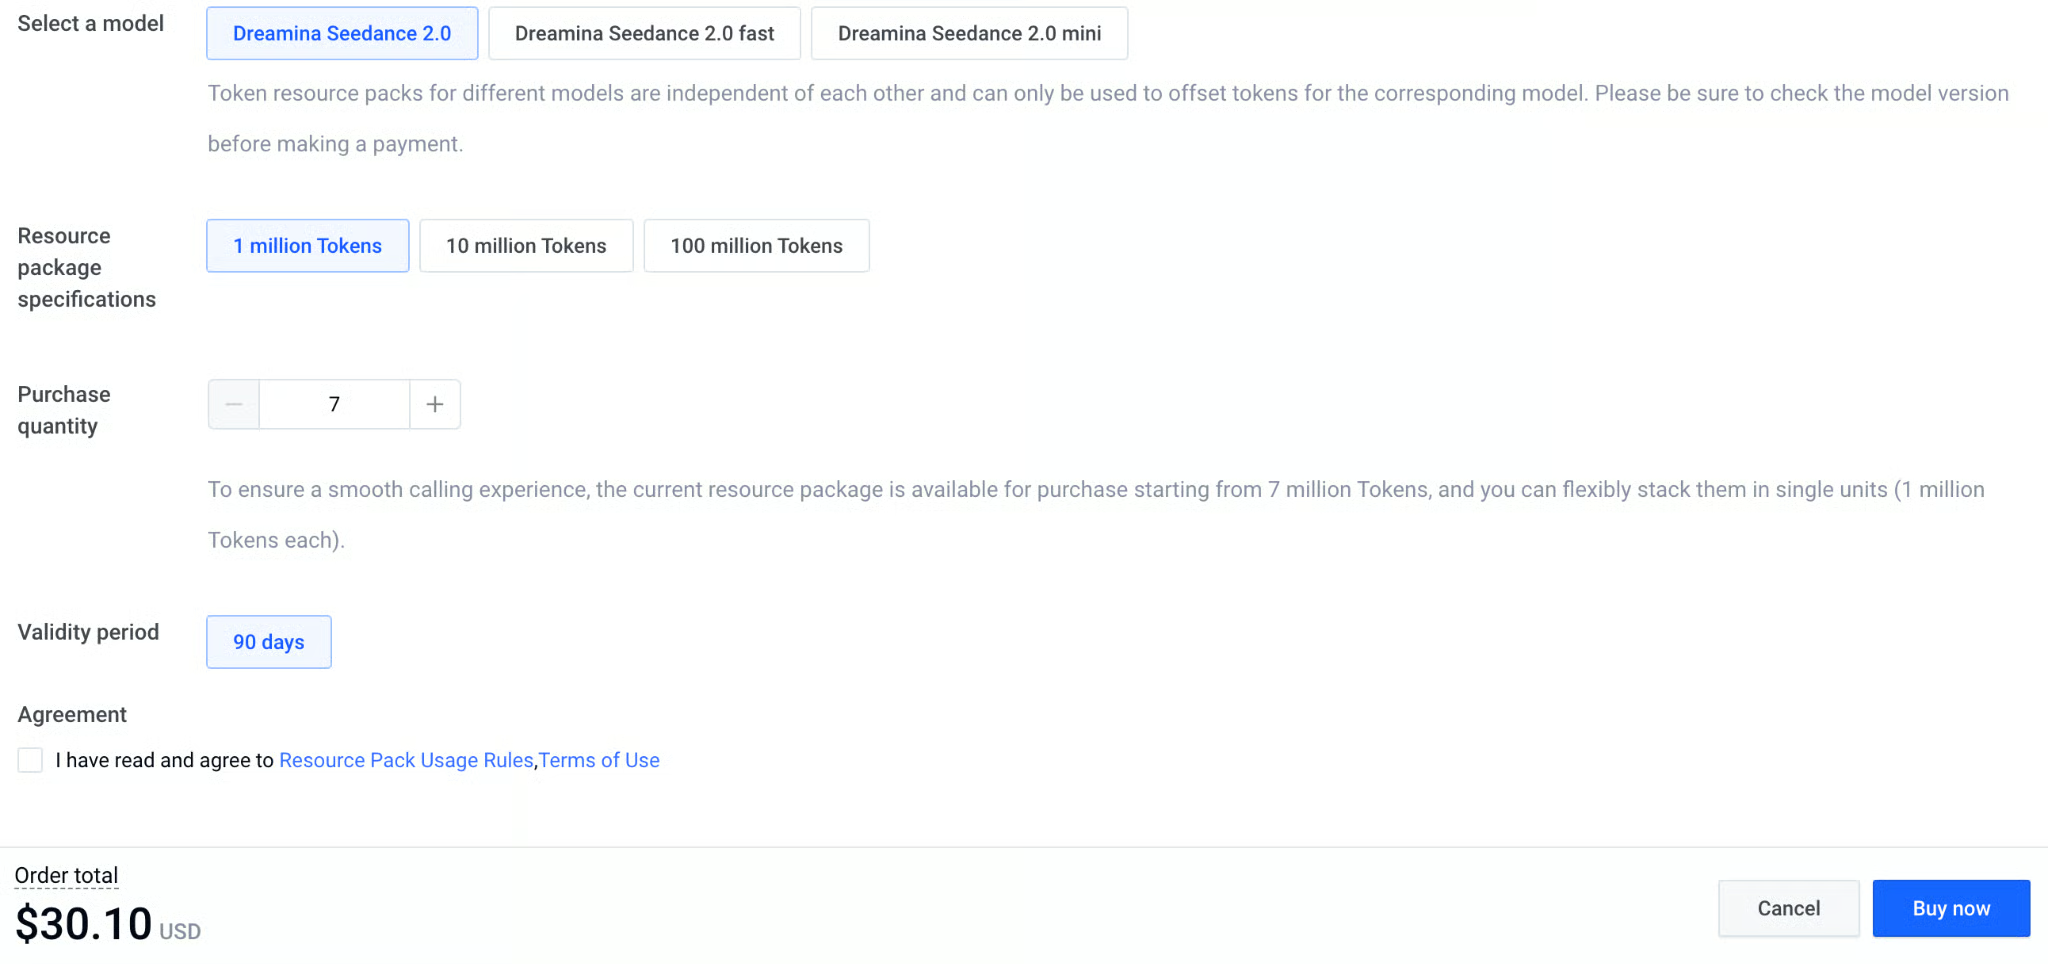
Infelizmente, os tokens são específicos por modelo. Isso significa que, se comprarmos tokens para as versões fast ou mini da Seedance 2, não poderemos usá-los no modelo base.
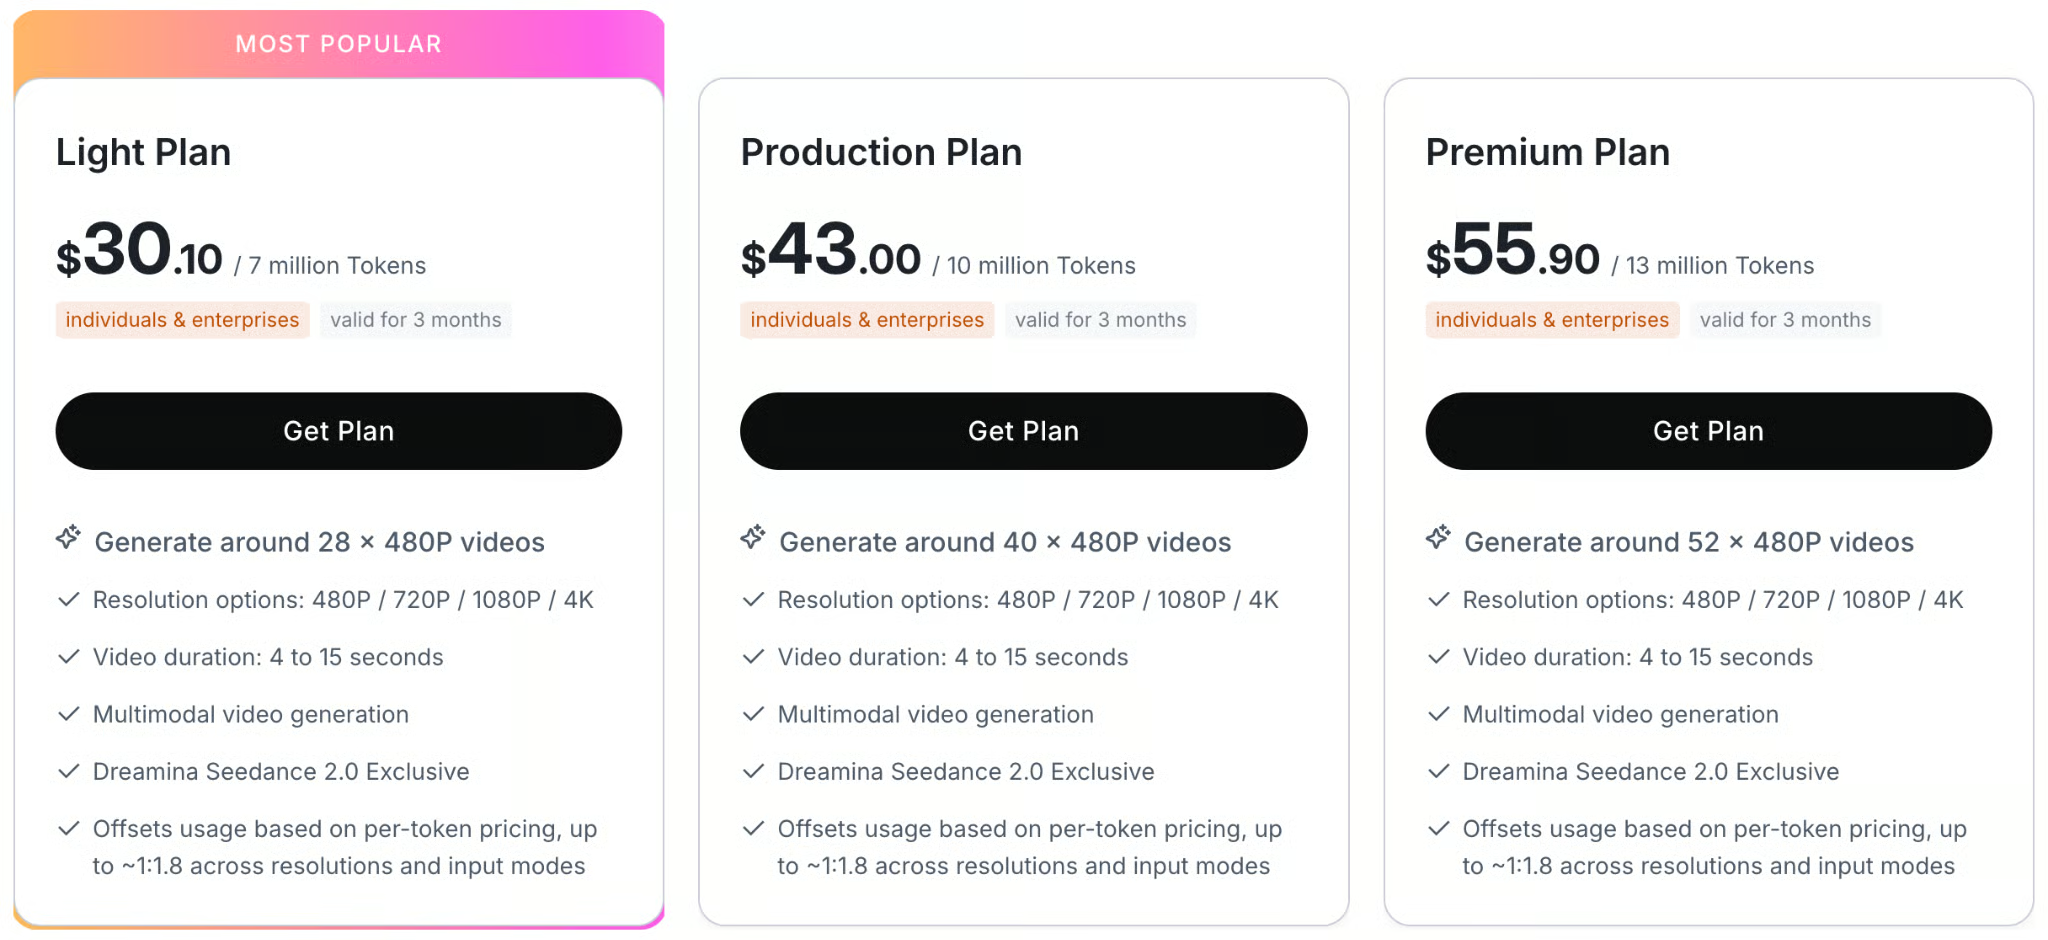
Abaixo está uma tabela com os planos de preços da API:
Incluí os scripts completos correspondentes ao código criado neste tutorial neste repositório do GitHub.
Nesta seção, vamos aprender a fazer uma requisição de texto para vídeo para gerar este vídeo:
Para conectar à API BytePlus Ark usando Python, vamos usar o pacote oficial byteplus-python-sdk-v2.
A forma mais fácil de configurar as dependências deste projeto é criar um ambiente Anaconda e instalar o arquivo requirements.txt, assim:
git clone git@github.com:fran-aubry/seedance2-tutorial.git
conda create --name seedance2 python=3.11
conda activate seedance2
pip install -r requirements.txtCrie um novo script chamado text_to_video.py na mesma pasta do arquivo .env que criamos antes.
Primeiro, precisamos importar os pacotes necessários:
import os
from byteplussdkarkruntime import Ark
from dotenv import load_dotenv
Em seguida, carregamos a chave de API do arquivo .env usando a função load_dotenv():
load_dotenv()
API_KEY = os.getenv("ARK_API_KEY")
Agora inicializamos o cliente Ark, que permite fazer requisições para a API BytePlus Ark.
Usamos a biblioteca os para obter a chave de API das variáveis de ambiente e definimos a base URL apropriada para acesso internacional à API:
client = Ark(
    api_key=os.getenv("ARK_API_KEY"),
    base_url="https://ark.ap-southeast.bytepluses.com/api/v3"
)
Por fim, definimos um prompt e usamos a função content_generation.tasks.create() do cliente para gerar o vídeo:
prompt = """
A cinematic close-up of a weary but hopeful female astronaut inside a dimly lit, dusty spaceship cabin.
Soft blue light illuminates her face.
She takes a deep breath, showing subtle emotional relief, looks directly into the camera, and says:
'We finally made it. The atmosphere is stable.'
The ambient sound of a low, rhythmic spaceship engine hums in the background.
"""
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        }
    ],
    generate_audio=True,
    ratio="16:9",
    duration=8,
    watermark=True,
    resolution="480p",
)
task_id = response.id
print(f"Task successfully submitted! Task ID: {task_id}")
Após solicitar a geração do vídeo, não recebemos o vídeo imediatamente, pois ele leva algum tempo para ser criado.
Isso significa que a variável response não é o vídeo em si.
Em vez disso, é um objeto que contém informações sobre a tarefa de geração do vídeo.
Em particular, ele contém o identificador da tarefa, que permite acompanhar o andamento da geração e fazer o download assim que o modelo terminar.
Podemos recuperar o status de uma tarefa informando o identificador à função content_generation.tasks.get(), assim:
task = client.content_generation.tasks.get(task_id=task_id)
status = task.status
print(f"Status: {status}")
Para facilitar o acompanhamento, criamos um novo script utils.py na mesma pasta e adicionamos esta função que acompanha o progresso do vídeo, dado o cliente e o id da tarefa:
import time
import requests

def poll_task(client, task_id, poll_interval=5):
    while True:
        try:
            task_status = client.content_generation.tasks.get(task_id=task_id)
            status = getattr(task_status, "status", None) or (task_status.get("status") if isinstance(task_status, dict) else None)

            if status == "succeeded":
                print("\nTask completed successfully.")
                return task_status.content.video_url

            elif status == "failed":
                error_details = getattr(task_status, "error", "Unknown error occurred during processing.")
                raise RuntimeError(f"Task failed: {error_details}")

            print(".", end="", flush=True)
            time.sleep(poll_interval)
        except Exception as e:
            if isinstance(e, RuntimeError):
                raise
            print(f"\nWarning: Error polling task (will retry): {e}")
time.sleep(poll_interval)A função poll_task() que implementamos acima retorna o vídeo
Agora que conseguimos acompanhar o processo de geração, só precisamos de uma forma de baixá-lo quando terminar.
Como a API BytePlus Ark retorna uma URL direta para o arquivo de vídeo gerado dentro da resposta da tarefa, podemos baixá-lo usando a biblioteca requests.
Aqui vai uma função que faz isso:
def download_video(url, output_path = "video.mp4"):
    try:
        print(f"Downloading video from {url} to {output_path}...")
        response = requests.get(url, stream=True)
        response.raise_for_status()

        with open(output_path, 'wb') as f:
            for chunk in response.iter_content(chunk_size=8192):
                f.write(chunk)
        print(f"Video successfully downloaded to '{output_path}'")
        return True
    except Exception as e:
        print(f"Error downloading video: {e}")
return FalseJuntando tudo, aqui está um script completo para gerar um vídeo a partir de um prompt de texto usando a Seedance 2:
import os
from byteplussdkarkruntime import Ark
from dotenv import load_dotenv
import utils

load_dotenv()
API_KEY = os.getenv("ARK_API_KEY")

client = Ark(
    api_key=os.getenv("ARK_API_KEY"),
    base_url="https://ark.ap-southeast.bytepluses.com/api/v3"
)

prompt = """
A cinematic close-up of a weary but hopeful female astronaut inside a dimly lit, dusty spaceship cabin.
Soft blue light illuminates her face.
She takes a deep breath, showing subtle emotional relief, looks directly into the camera, and says:
'We finally made it. The atmosphere is stable.'
The ambient sound of a low, rhythmic spaceship engine hums in the background.
"""

response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        }
    ],
    generate_audio=True,
    ratio="16:9",
    duration=8,
    watermark=True,
    resolution="480p",
)

task_id = response.id
print(f"Task successfully submitted! Task ID: {task_id}")

# Wait for the video to finish generating
video_url = utils.poll_task(client, task_id)

utils.download_video(video_url, "./videos/space.mp4")Abaixo está uma lista de valores aceitos para os parâmetros centrais de uma requisição de geração de vídeo:
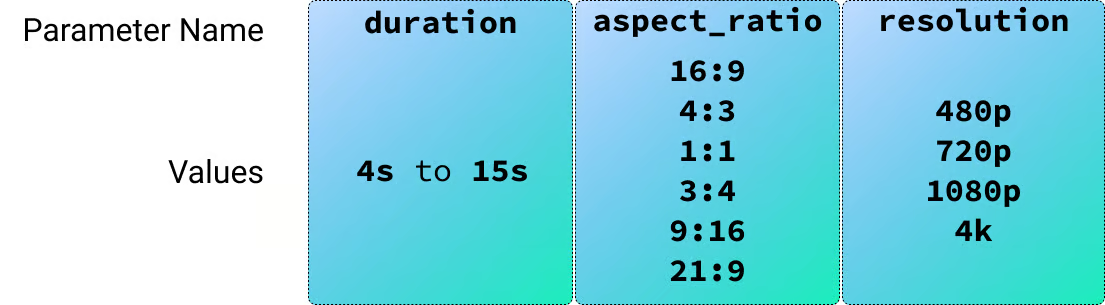
Na seção anterior, aprendemos a gerar um vídeo usando um prompt de texto. A Seedance 2 também aceita entradas de imagem, vídeo e áudio, então vamos começar por imagens.
Para testar entradas de imagem, gerei dois personagens com IA para usar em uma cena no estilo sitcom.
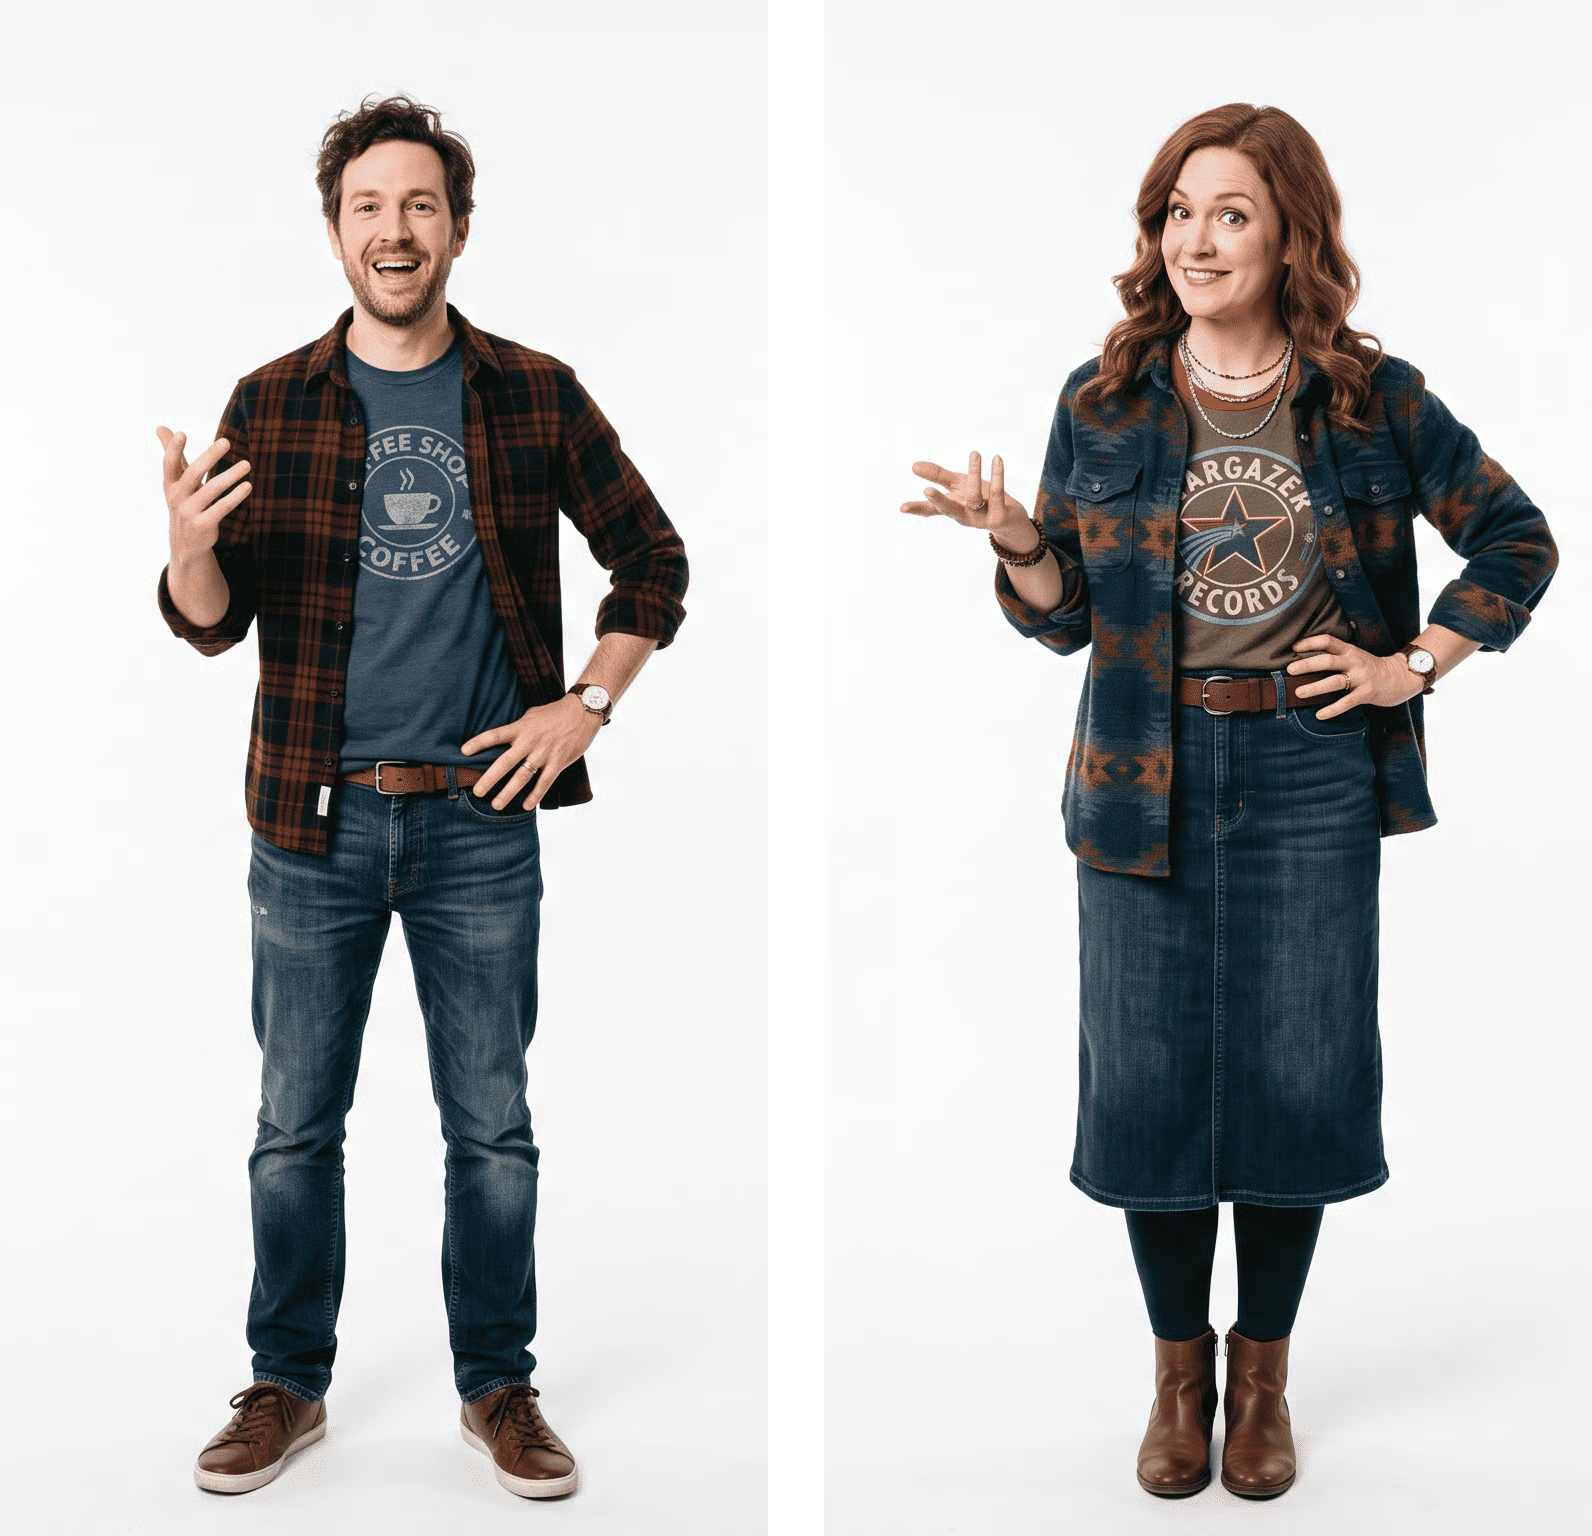
Podemos fornecer imagens de referência ao modelo adicionando-as ao campo content da requisição, assim:
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/male-character.png")
            },
            "role": "reference_image"
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/female-character.png")
            },
            "role": "reference_image"
        }
    ],
    generate_audio=True,
    ratio="16:9",
    duration=15,
    watermark=True,
    resolution="480p",
)
Para este vídeo, usei o seguinte prompt:
Context: A cozy, warmly lit independent coffee shop counter with wooden accents.
Reference:
- The male barista's face and clothing follow @Image1.
- The female customer's face and styling follow @Image2.

Action & Dialogue (10 Seconds Total):

0:00 - 0:04:
Medium close-up on the male barista (@Image1) standing behind the counter,
next to the coffee machine. He leans across the counter with a smooth,
flirtatious smirk, acting like he is making a highly exclusive offer:
"The WiFi password? It's actually my phone number: five-five-five, zero-one—"

0:04 - 0:07:
Camera cuts to the female customer (@Image2), instantly interrupting him.
She holds up her phone screen toward him, entirely unimpressed:
"Your network is called 'Free_Guest_WiFi' and there is literally no password."

0:07 - 0:08: Quick cut back to the two-shot.
Flustered, the barista becomes visibly embarrassed, his confident smirk
instantly vanishing as he nervously breaks eye contact.

0:08 - 0:10: Camera cuts back to a medium shot of the female customer (@Image2).
She lowers her phone, tapping her fingers lightly on the counter,
and delivers her order with perfect deadpan clarity:
"It will be an espresso please. No milk, no sugar, and no phone number."

Framing/Timing:
Clean cuts to perfectly pace the comedic timing over exactly 10 seconds.

Tone/Audio:
Lighthearted sitcom vibe. Synchronized voice generation for the dialogue, a subtle low cafe background hum, and the sound of the customer's fingers lightly tapping the wooden counter at the end.
Note que o prompt usa @Image1 e @Image2 para se referir às imagens na ordem em que foram fornecidas na lista.
Infelizmente, ao tentar gerar este vídeo, recebi um erro dizendo:
The request failed because the input image may contain a real person.Percebi isso de forma consistente ao tentar usar a Seedance 2 com imagem de referência contendo um humano realista, mesmo gerado por IA.
Para contornar, converti os personagens em estilo cartoon e tentei novamente.
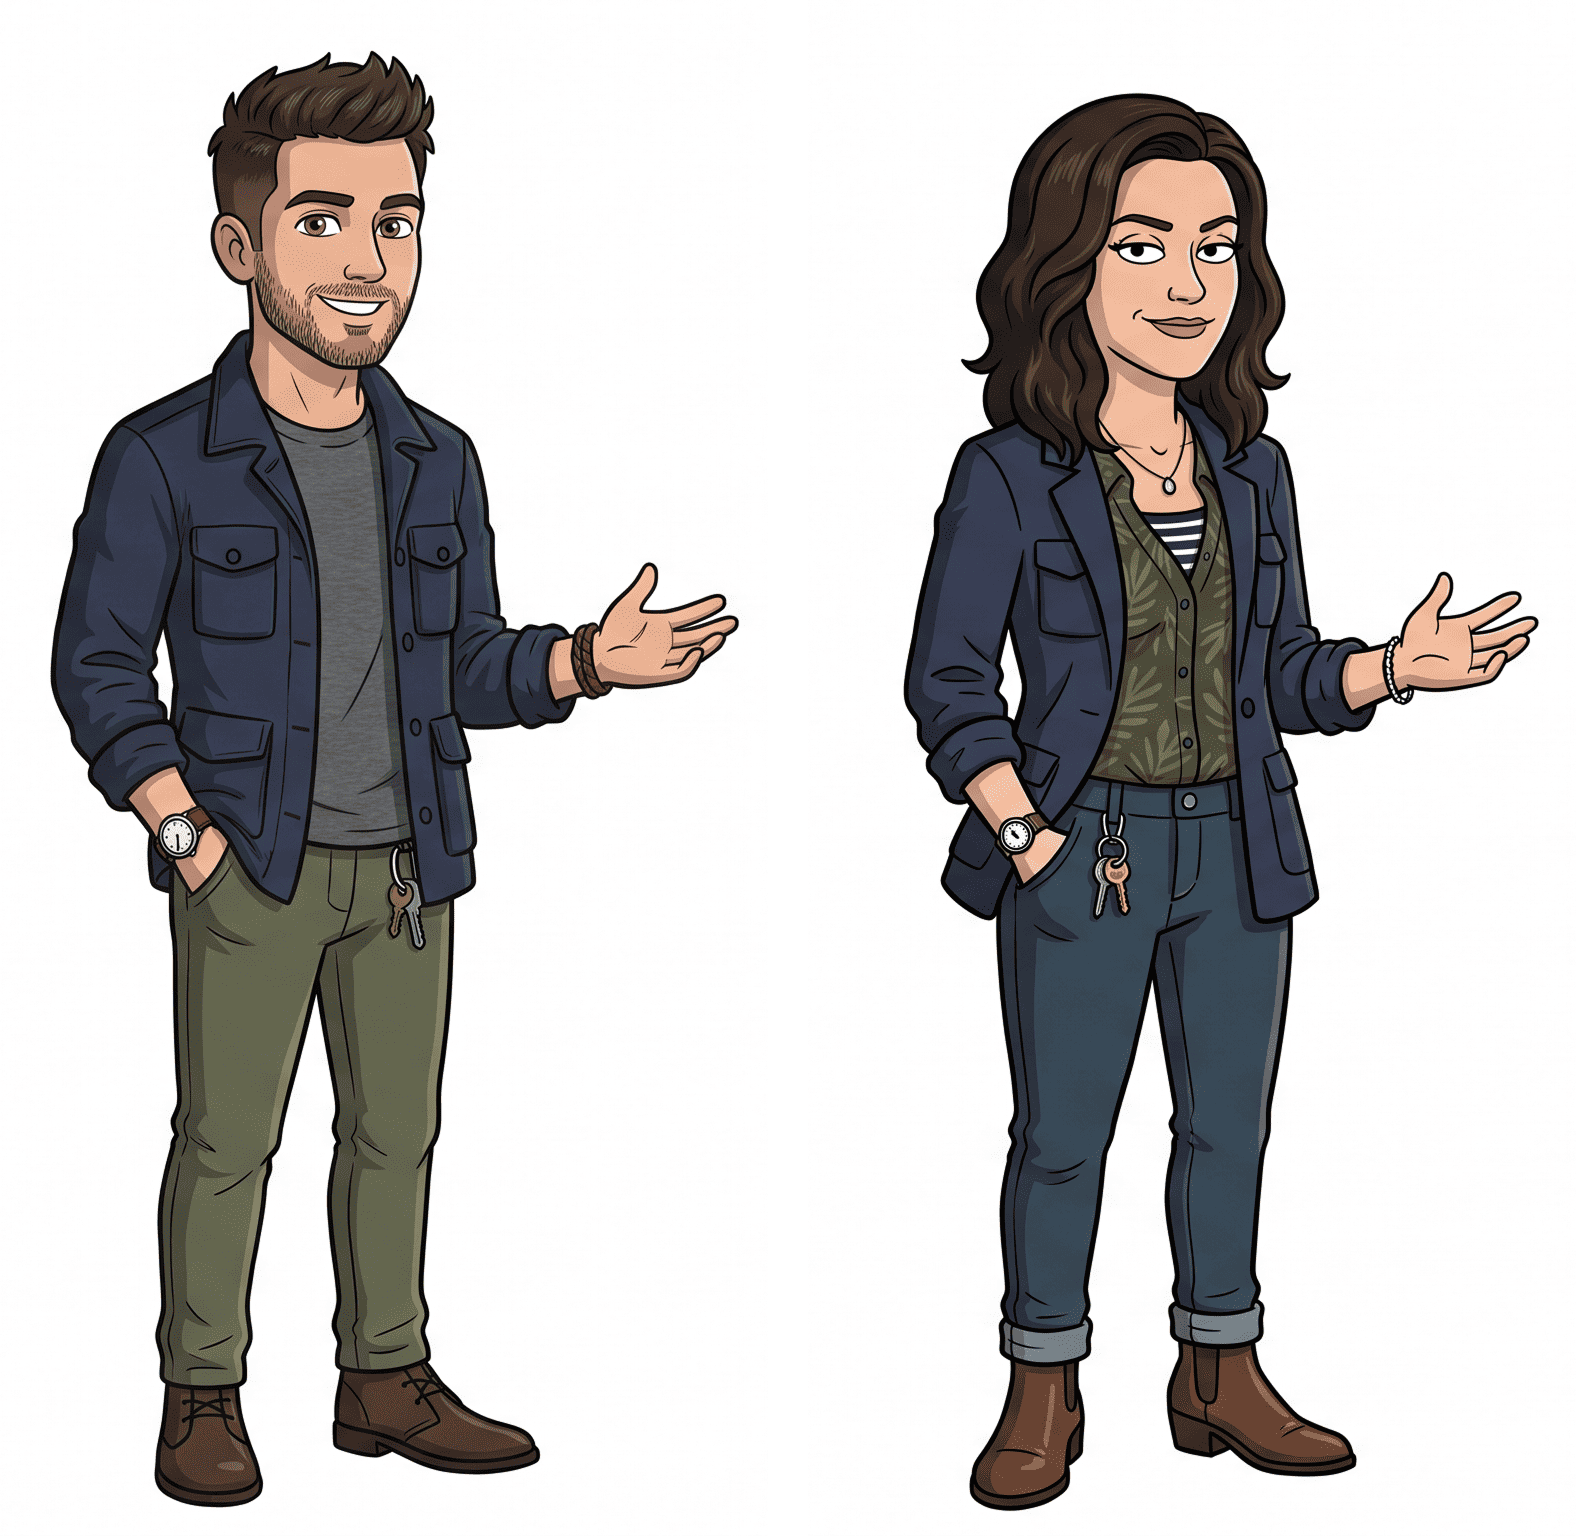
Dessa vez funcionou perfeitamente e o resultado ficou exatamente como eu queria.
O código completo deste exemplo está no arquivo image_to_video.py.
O exemplo anterior mostrou como usar imagens como referência definindo ”role”: “reference_image” na requisição.
A Seedance 2 aceita outras duas funções de imagem:
”first_frame”: instrui o modelo a usar a imagem fornecida como o quadro inicial exato do vídeo gerado. É a configuração padrão para geração direta de Image-to-Video.”last_frame”: instrui o modelo a encerrar o vídeo gerado nessa imagem específica. Observação: você só pode usar isso se também fornecer um first_frame na mesma requisição, pedindo ao modelo para interpolar o vídeo entre as duas imagens.Testei isso gerando uma sequência de quadros iniciais mostrando um laboratório de IA robótico tentando recriar plantas em um mundo onde a vida natural desapareceu.
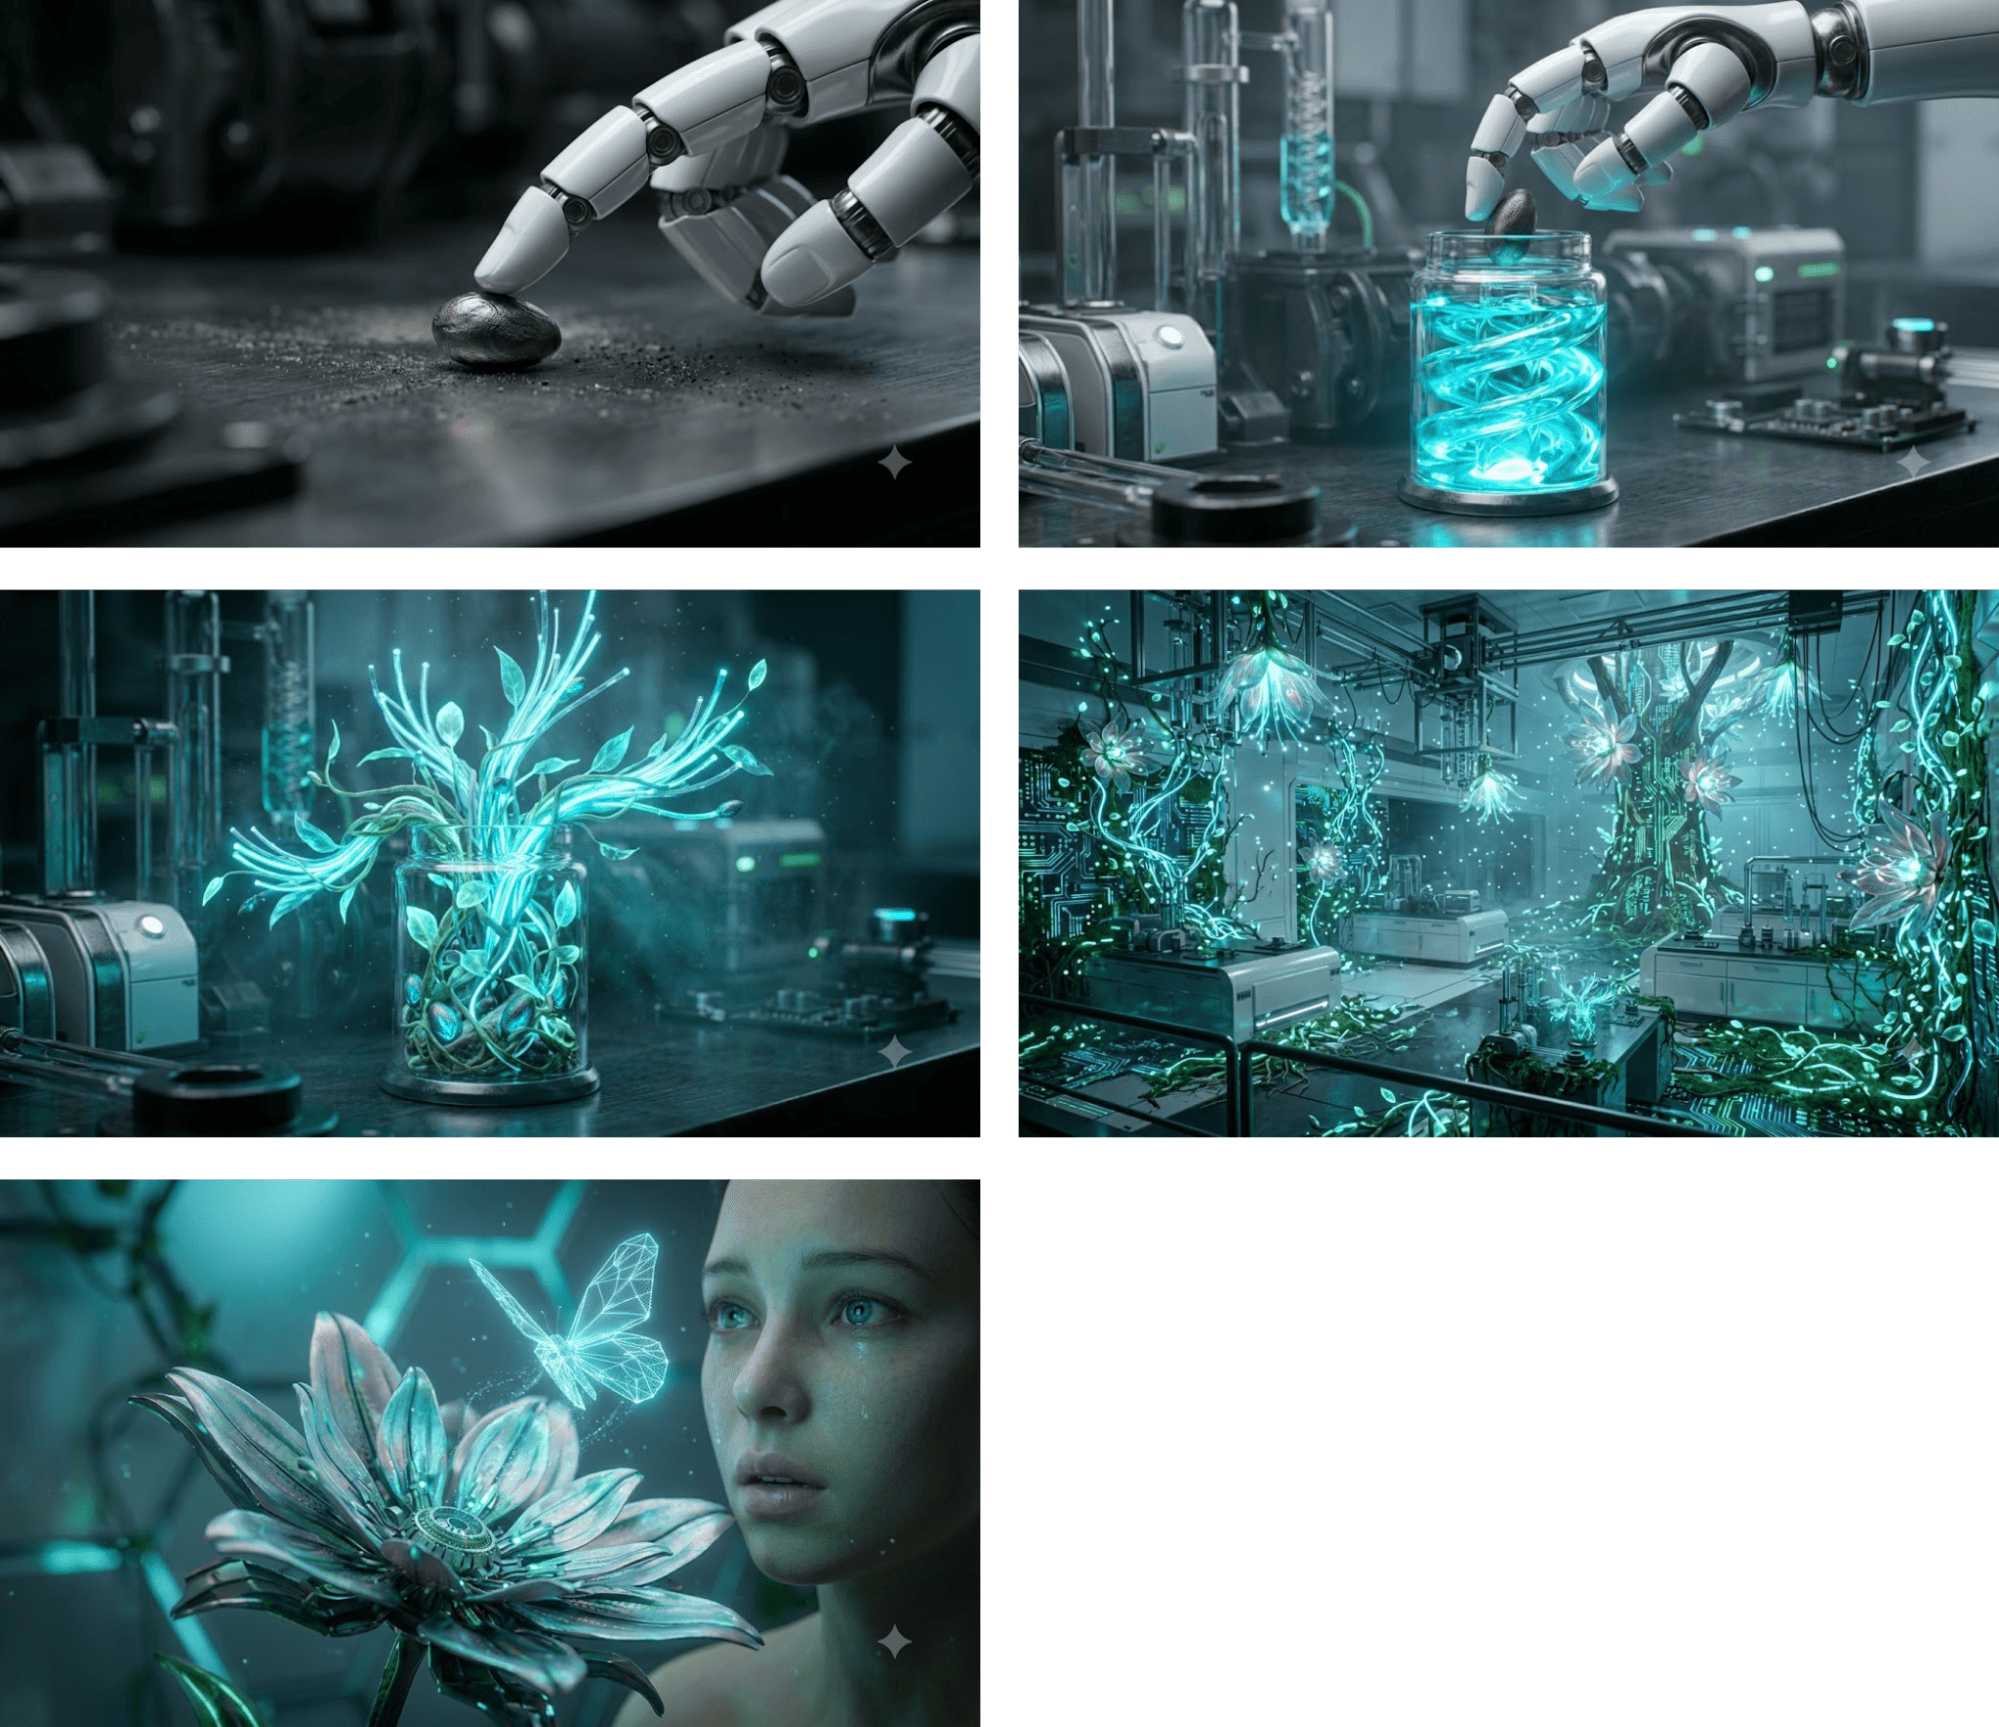
Para cada quadro, gerei um vídeo usando esse quadro como first frame. Veja como estruturar cada requisição:
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/robot-lab1.jpeg")
            },
            "role": "first_frame"
        }
    ],
    generate_audio=False,
    ratio="16:9",
    duration=4,
    watermark=True,
    resolution="480p",
)
Gerei os vídeos sem áudio porque o áudio não ficaria consistente, já que cada vídeo foi gerado separadamente. Aqui está o resultado de juntar os cinco clipes:
O script completo usado para gerar um vídeo com base em um quadro inicial está aqui.
last_frameNeste exemplo, fornecemos um first_frame e um last_frame para gerar um vídeo entre os dois.
Gerei duas imagens do mesmo cômodo, uma vazia sem mobília e outra com o ambiente totalmente mobiliado. A ideia é gerar um vídeo que anime o processo de mobiliar o cômodo.
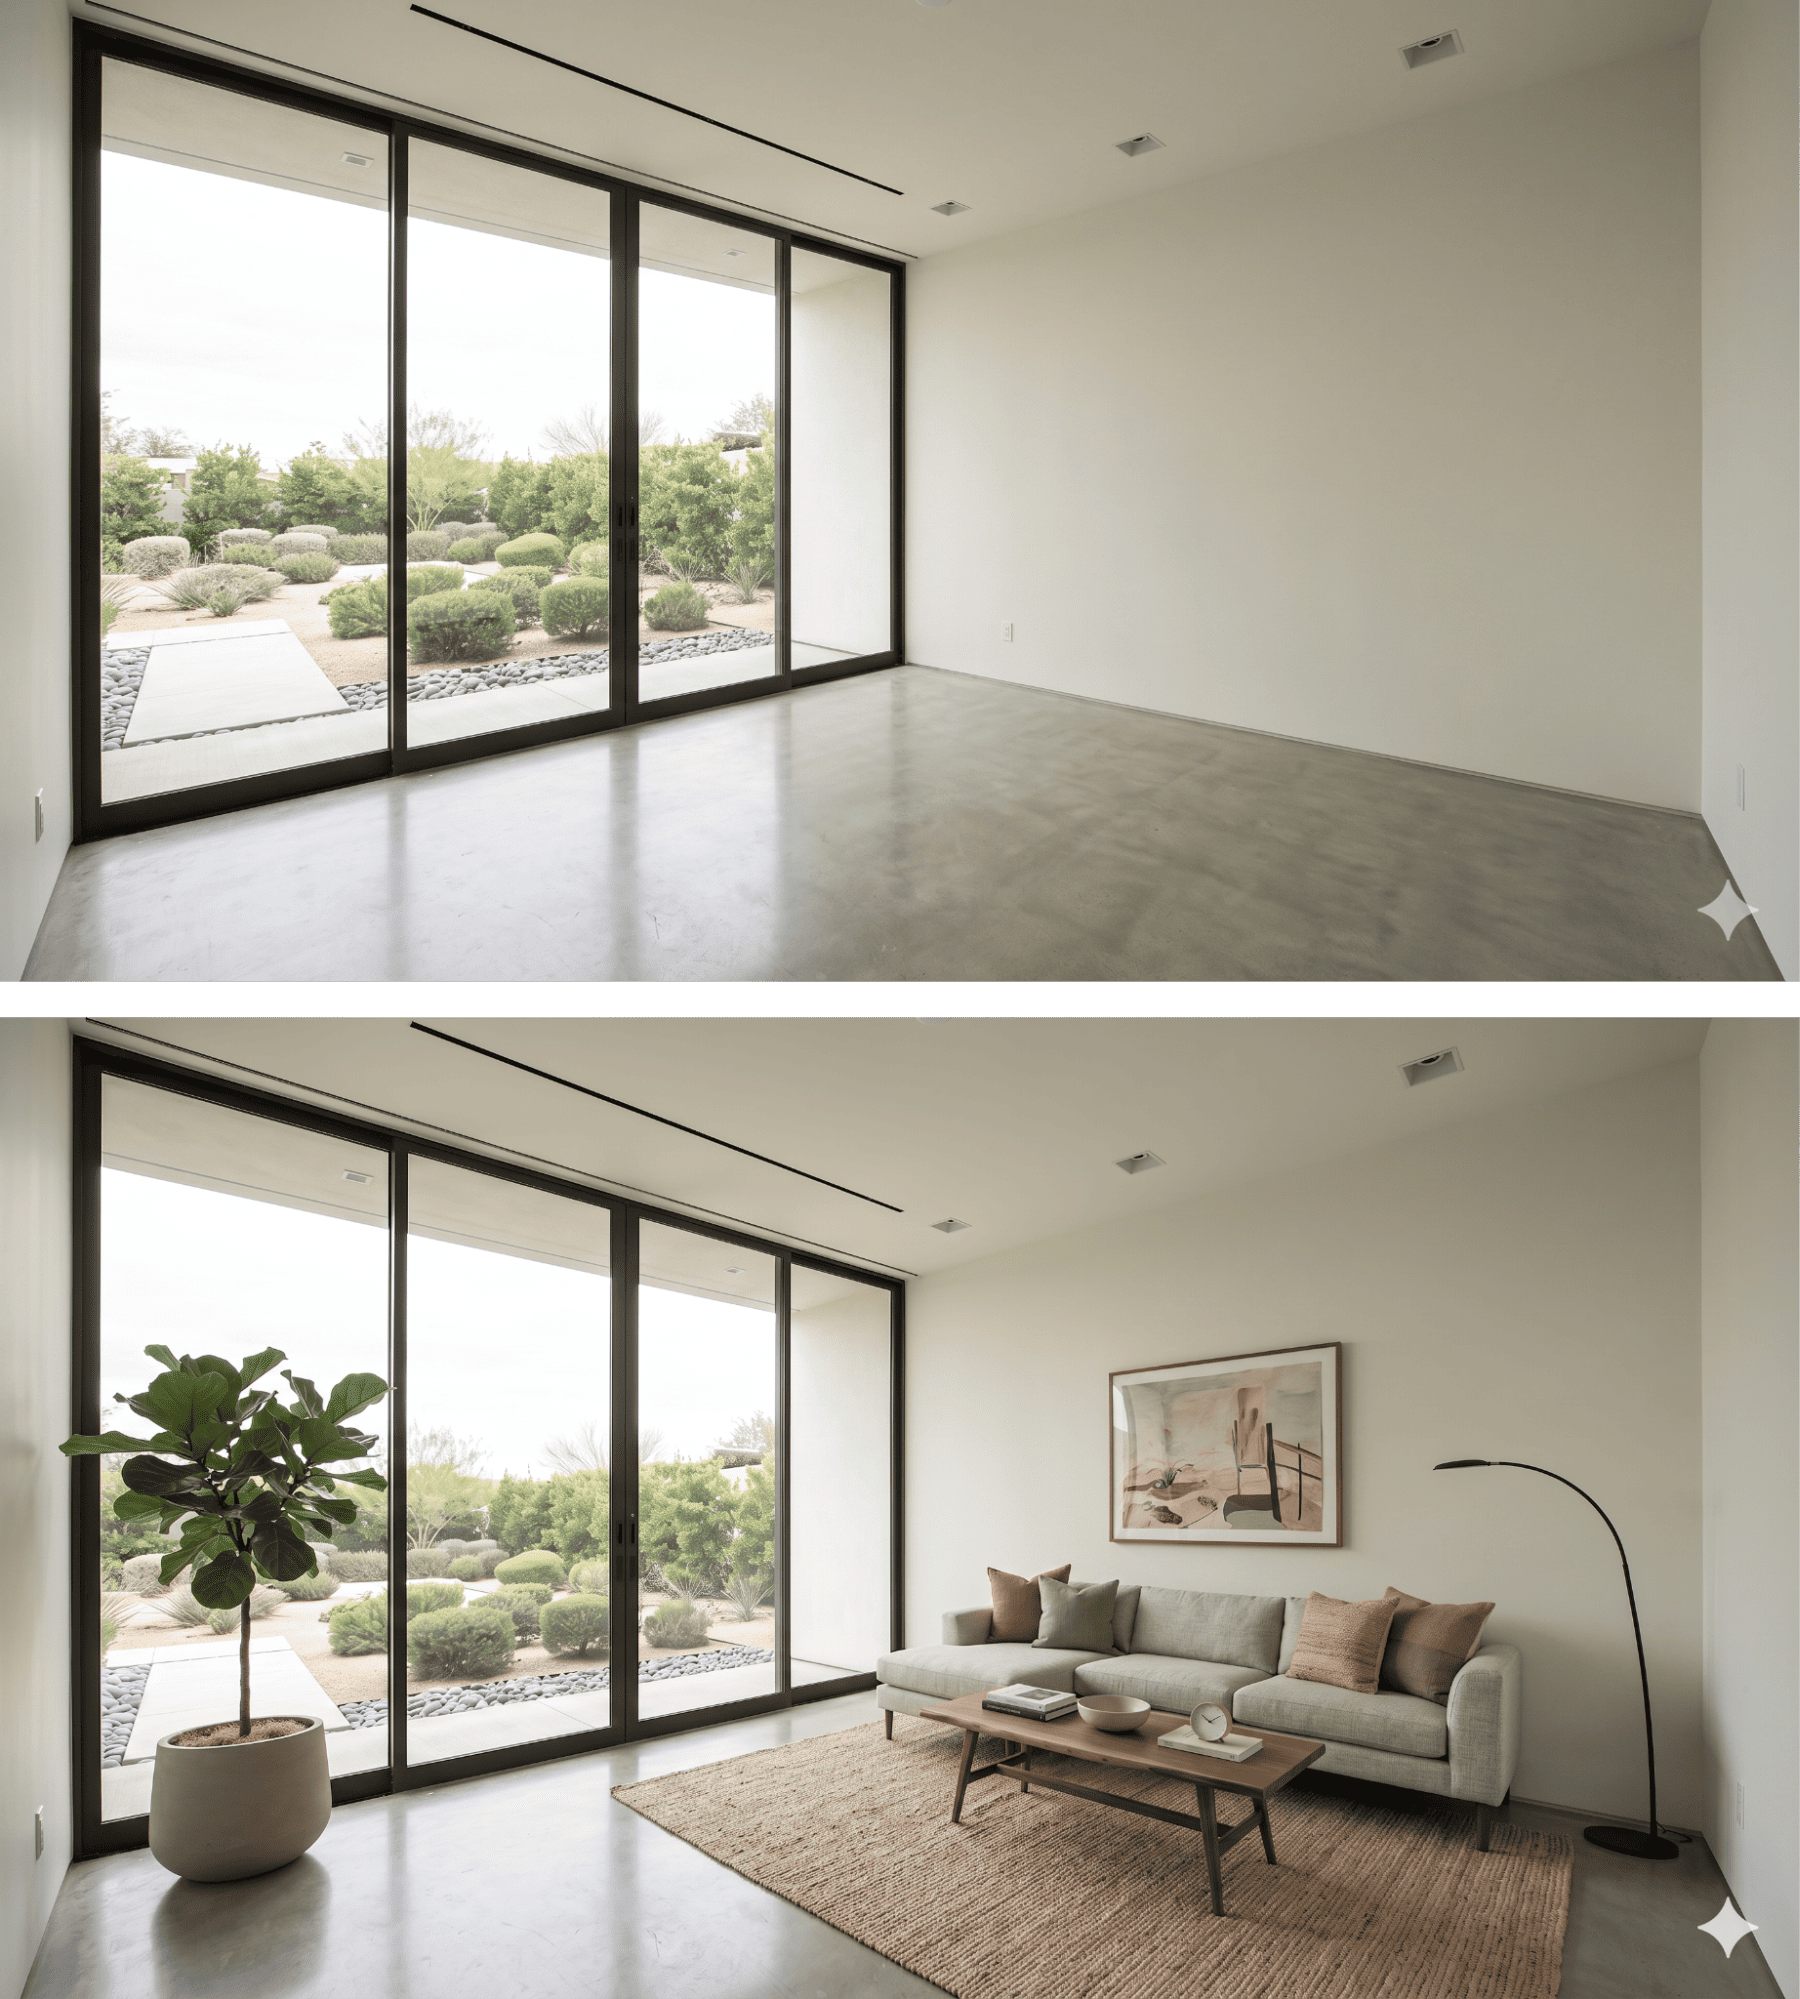
O prompt que usei descreveu como eu queria que os móveis aparecessem no vídeo:
A dynamic, fast-paced sequence where furniture pops into existence piece by piece. First, a rug rapidly unfolds itself, then the sofa drops from just above the floor with a heavy, realistic bounce. Lamps, artwork, and plants quickly spring into reality one after another. Vibrant lighting, photorealistic materials, lively and snappy energetic rhythm.Aqui está a requisição:
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/room-start.png")
            },
            "role": "first_frame"
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/room-end.png")
            },
            "role": "last_frame"
        }
    ],
    generate_audio=True,
    ratio="16:9",
    duration=8,
    watermark=True,
    resolution="480p",
)
E aqui está o resultado:
Para gerar isso, usei a seguinte requisição:
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        },
        {
            "type": "video_url",
            "video_url": {
                "url": "https://www.pexels.com/download/video/38213009/"
            },
            "role": "reference_video"
        }
    ],
    generate_audio=True,
    ratio="16:9",
    duration=6,
    watermark=True,
    resolution="480p",
)
O script completo está aqui. O prompt que usei foi:
The original skater, environment, and camera movement must remain
unchanged and untouched.

Only add gaming-style visual effects: intense glowing sparks and electric arcs
streaming from the skateboard-rail contact point during the grind, and a
brilliant energy shockwaves and dust burst at the jump/pop. Para testar entradas de áudio, gerei uma imagem para um personagem e usei Fish Audio para gerar uma faixa de áudio com diferentes emoções.
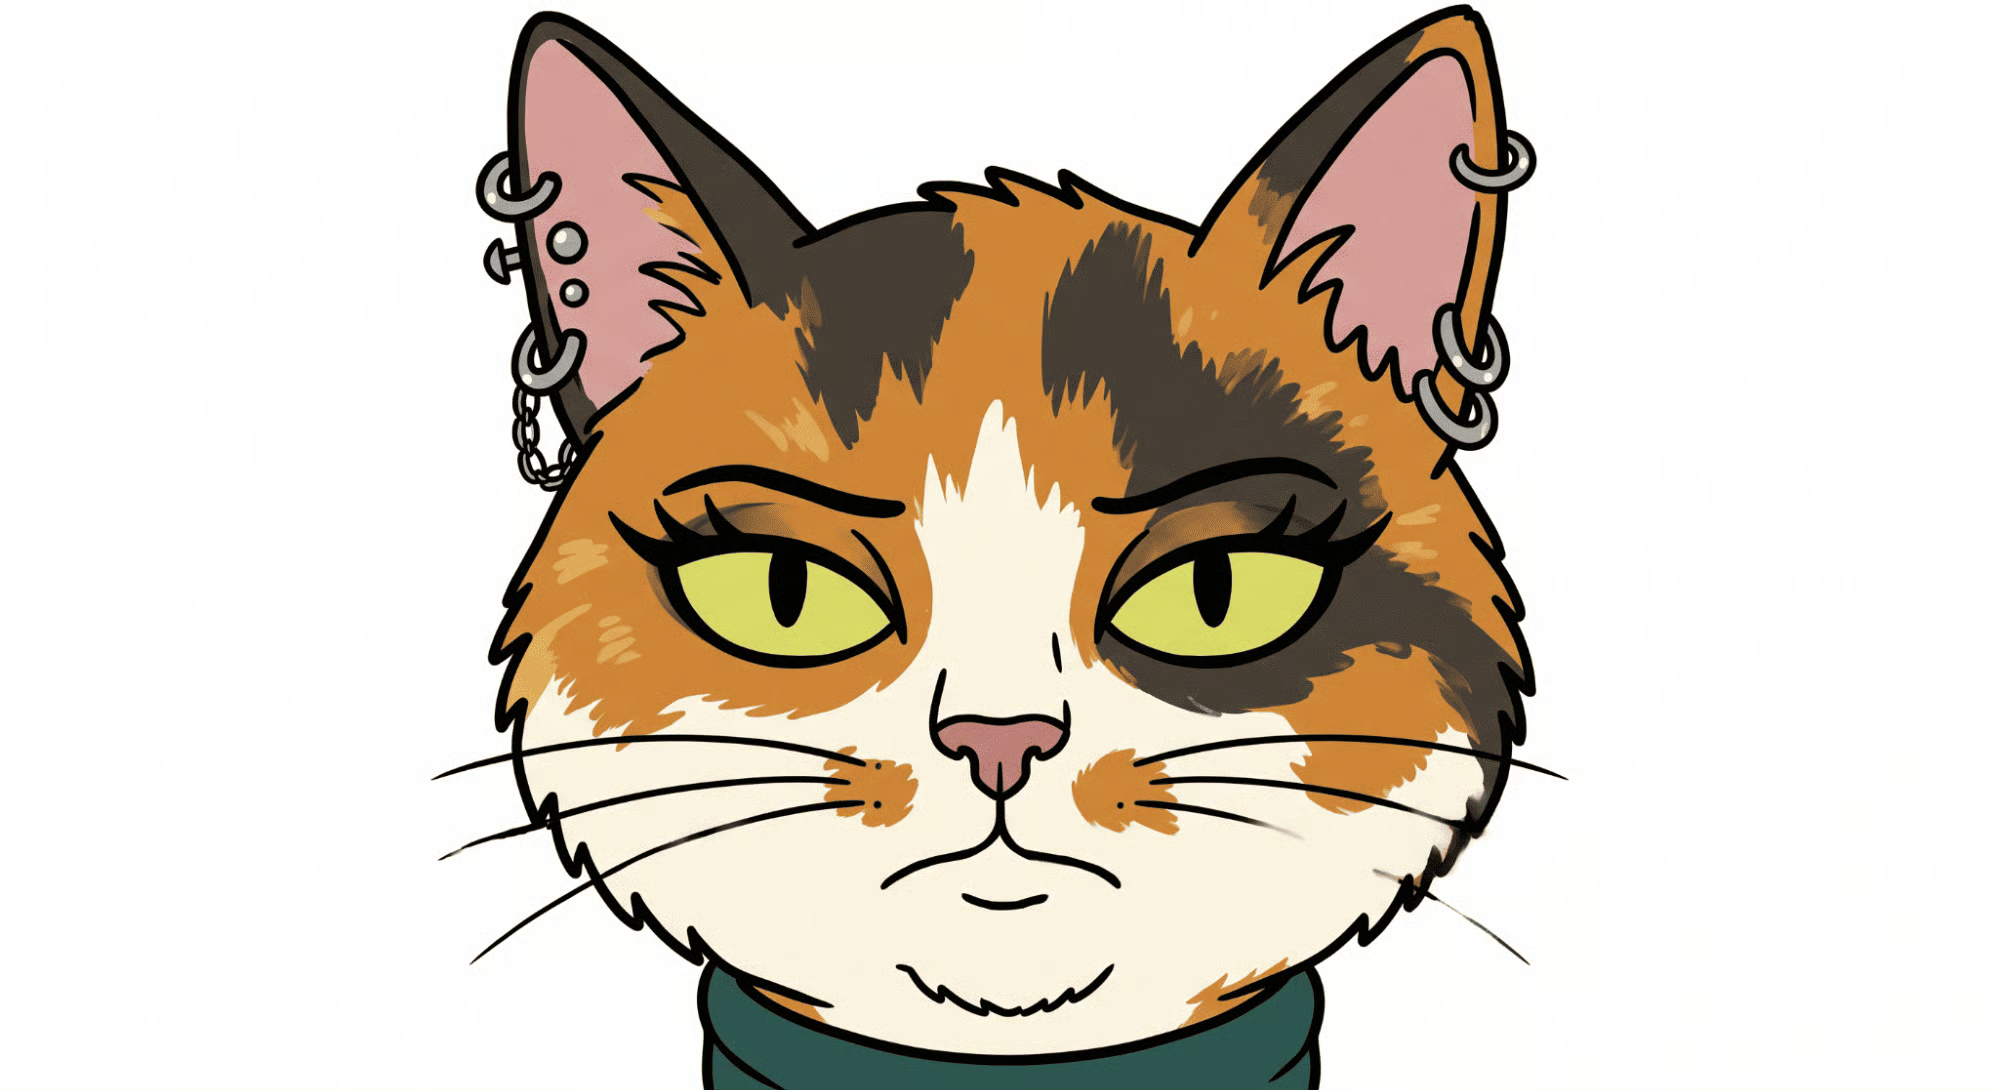
No áudio, eu queria algumas emoções distintas para ver se a Seedance 2 conseguiria identificá-las ao gerar o vídeo.
O Fish Audio AI permite especificar emoções usando [emotion] no prompt, então foi perfeito para a tarefa. Aqui está o prompt de áudio que usei:
[sighing] Nothing much is happening today. [surprised] Wait a minute... what are those on my ears?[laughing] Oh my gosh, I can't believe I got piercings last night! [angry] But hold on, I specifically told you not to let me do it!Para carregar o arquivo de áudio, escrevi esta função que adicionei ao utils.py:
def load_audio(file_path):
    if not os.path.exists(file_path):
        raise FileNotFoundError(f"Audio file not found at: {file_path}")

    # Guess the mime type (e.g., audio/mpeg for mp3, audio/wav for wav)
    mime_type, _ = mimetypes.guess_type(file_path)
    if mime_type is None:
        mime_type = "audio/mpeg" # Fallback to mp3 just in case

    with open(file_path, "rb") as audio_file:
        encoded_string = base64.b64encode(audio_file.read()).decode('utf-8')

    return f"data:{mime_type};base64,{encoded_string}"
Fornecer o áudio ao modelo funciona de forma muito semelhante às imagens.
Carregamos como data URI em base64 e enviamos ao modelo no parâmetro contents, assim:
response = client.content_generation.tasks.create(
    model="dreamina-seedance-2-0-260128",
    content=[
        {
            "type": "text",
            "text": prompt,
        },
        {
            "type": "image_url",
            "image_url": {
                "url": utils.load_image("./images/cat.png")
            },
            "role": "reference_image"
        },
        {
            "type": "audio_url",
            "audio_url": {
                "url": utils.load_audio("./audio/voice.mp3")
            },
            "role": "reference_audio"
        }
    ],
    ratio="16:9",
    duration=11,
    watermark=True,
    resolution="480p",
)
Este é o vídeo que a Seedance 2 gerou:
Principais cursos da DataCamp
Curso
Curso
Programa
blog
Dr Ana Rojo-Echeburúa
9 min
Tutorial
Abid Ali Awan
Tutorial
Moez Ali
12 min
Tutorial
Zoumana Keita
14 min
Tutorial
Nadia mhadhbi
15 min
Tutorial