Kursus
Konsep NoSQL
2 jam
19.3K
Selamat datang di dunia DynamoDB, tempat efisiensi dan skalabilitas tanpa batas bertemu dalam satu tabel. Dalam tutorial komprehensif ini, kita akan memulai perjalanan yang memberdayakan, mengungkap potensi sesungguhnya dari desain basis data NoSQL single table.
Temukan seni menyederhanakan model data yang kompleks sambil memanfaatkan sepenuhnya kekuatan struktur terpadu yang mampu mengakomodasi kebutuhan Anda yang terus berkembang dengan mudah.
Baik Anda pengembang berpengalaman yang sudah akrab dengan basis data NoSQL maupun baru memulai perjalanan data Anda, bersiaplah membuka level baru skalabilitas untuk aplikasi Anda dengan arsitektur data yang andal!
Sebelum memulai, penting untuk memahami perbedaan antara NoSQL dan basis data relasional, dalam skenario apa kita menggunakan masing-masing, serta mengapa teknologi ini diciptakan. Ini memerlukan tinjauan singkat terhadap sejarah pemrosesan data.
Anda dapat membaca lebih lanjut tentang pentingnya basis data NoSQL dalam data science di artikel blog terpisah.
Basis data relasional adalah teknologi yang dikenal luas dan telah digunakan sejak 1970-an. Dua masalah utama yang diatasi oleh basis data relasional adalah penyimpanan dan integritas referensial.
Data di"normalkan", biasanya hingga bentuk normal ke-3, yang mengurangi jejak ukuran data sekaligus memastikan setiap pembaruan data tetap konsisten dengan data lainnya.
Ukuran jejak data persisten dulunya sangat krusial karena secara historis komponen paling mahal di pusat data adalah hard drive. Kini tidak lagi: saat ini CPU adalah komponen paling mahal, dan biaya penyimpanan data telah turun drastis. Ini tidak berarti basis data relasional usang; ia tetap tepat digunakan untuk:
Tekanan data adalah kemampuan suatu sistem untuk memproses sejumlah data dalam batas biaya dan/atau waktu yang wajar.
Basis data NoSQL diciptakan pada akhir 1990-an untuk mengatasi masalah tekanan data yang memengaruhi kinerja basis data relasional akibat terus meningkatnya volume data aplikasi.
CPU dalam basis data relasional dapat dianggap sebagai salah satu hambatan utama saat server relasional berupaya keras mengambil dan menyatukan data ternormalisasi menjadi tampilan terdenormalisasi yang umumnya dikonsumsi aplikasi.
Hal ini dapat diatasi dengan menambahkan server replika baca, namun NoSQL mengambil pendekatan berbeda dengan menyimpan data aplikasi dalam bentuk terdenormalisasi yang siap dikonsumsi aplikasi. Artinya, jejak data menjadi lebih besar dibanding basis data relasional, tetapi beban CPU berkurang, sehingga server basis data pada dasarnya berfungsi sebagai router sederhana yang menggunakan algoritma hash untuk menunjuk ke lokasi pada hard disk di pusat data. Penggunaan khas untuk basis data NoSQL meliputi:
Banyak studi telah memberikan data objektif yang cukup tentang topik ini sehingga kita bisa menyajikan grafik yang merepresentasikan performa SQL vs NoSQL pada skala besar.
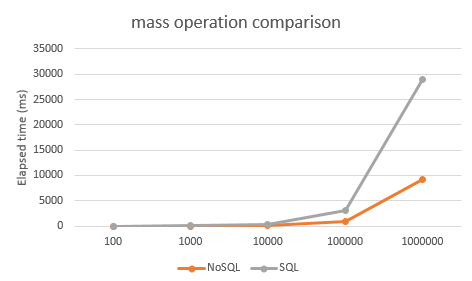
Poin terakhir yang perlu diluruskan adalah bahwa data yang disimpan di dalam basis data NoSQL tetap merupakan data relasional. Jika datanya tidak relasional, kita akan menyimpannya di filestore sederhana.
Kita tidak memodelkan basis data NoSQL dengan cara yang sama seperti memodelkan basis data relasional, sehingga merupakan anti-pola untuk menerjemahkan desain ternormalisasi secara langsung ke dalam basis data NoSQL menggunakan banyak tabel yang saling join karena NoSQL tidak memiliki operator join maupun integritas referensial.
Sebuah tabel dalam NoSQL setara dengan katalog dalam basis data relasional. Sebagai gantinya, modelkan data agar disimpan secara terdenormalisasi, siap dikonsumsi aplikasi.
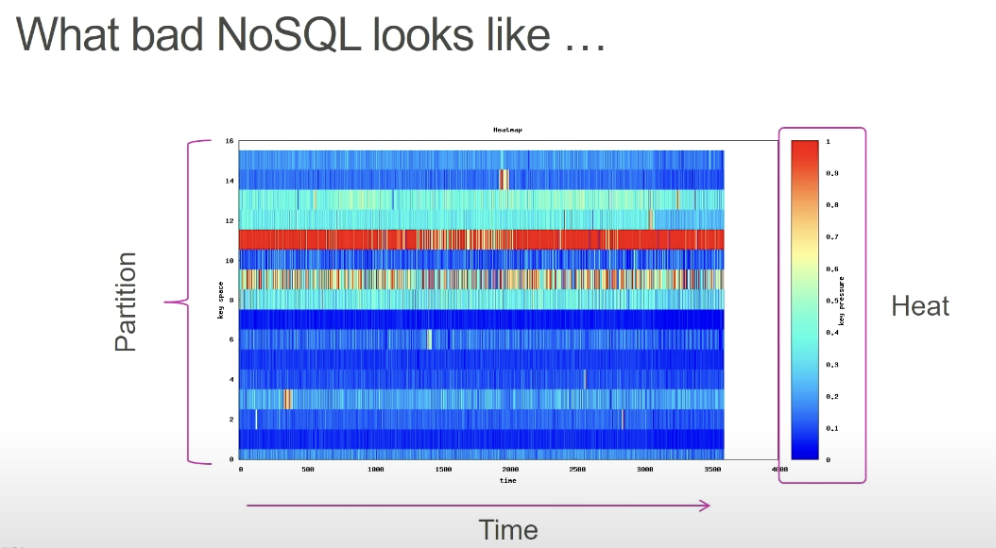
Anti-pola lain adalah Hot Keys. Ini berarti sebagian besar, jika tidak semua, permintaan akses menumbuk satu node penyimpanan, yang menunjukkan ruang kunci tidak dirancang dengan benar.
Peta panas akses akan tampak kurang lebih seperti berikut:
AWS DynamoDB adalah layanan penuh, tanpa server, penyimpanan nilai kunci kolom lebar yang berarti ia mendukung banyak item, atau baris, dalam sebuah tabel namun item-item tersebut tidak harus memiliki atribut yang sama. Tipe data yang didukung adalah sebagai berikut:
Seperti disebutkan sebelumnya, NoSQL sebaiknya digunakan saat pola akses aplikasi sudah dikenal, dan ada kebutuhan untuk mendukung jumlah TPS yang besar. DynamoDB dapat diskalakan untuk beban kerja apa pun dan akan memiliki waktu respons yang konsisten dan dapat diprediksi hingga 4 juta TPS dengan latensi rendah (10 - 20 ms).
Setiap item (atau baris) memiliki partition key yang secara unik mengidentifikasi item tersebut dan menentukan distribusi data di penyimpanan dasar.
Item secara opsional dapat memiliki sort key, yang menentukan urutan data disimpan di disk dalam sebuah partisi. Sort key memungkinkan kita melakukan kueri partisi dengan operasi rentang dan filter yang kompleks (meski operasi filter diterapkan di lapisan klien, bukan di basis data).
Partition key digunakan untuk membuat indeks hash, lalu setiap item diletakkan sesuai hash ini di ruang kunci virtual. Ruang kunci virtual ini dibagi menjadi segmen yang dipetakan ke perangkat penyimpanan fisik, yang dapat tumbuh dan menyusut secara dinamis tergantung pada volume data yang disimpan.
Inilah sebabnya DynamoDB cepat dan konsisten pada skala apa pun: karena mesin basis data bertindak sebagai layanan perutean dari kunci yang di-hash ke penyimpanan fisik.
Dalam tutorial ini, kita akan memodelkan toko online bernama Daintree.com.
(Fakta menarik: hutan hujan Daintree, yang terletak di Queensland, Australia, adalah salah satu hutan hujan tertua di Bumi, diperkirakan berusia sekitar 180 juta tahun!)
Pertama, mari buat diagram hubungan entitas (ERD) yang sangat disederhanakan agar kita dapat memvisualisasikan apa yang akan kita modelkan.
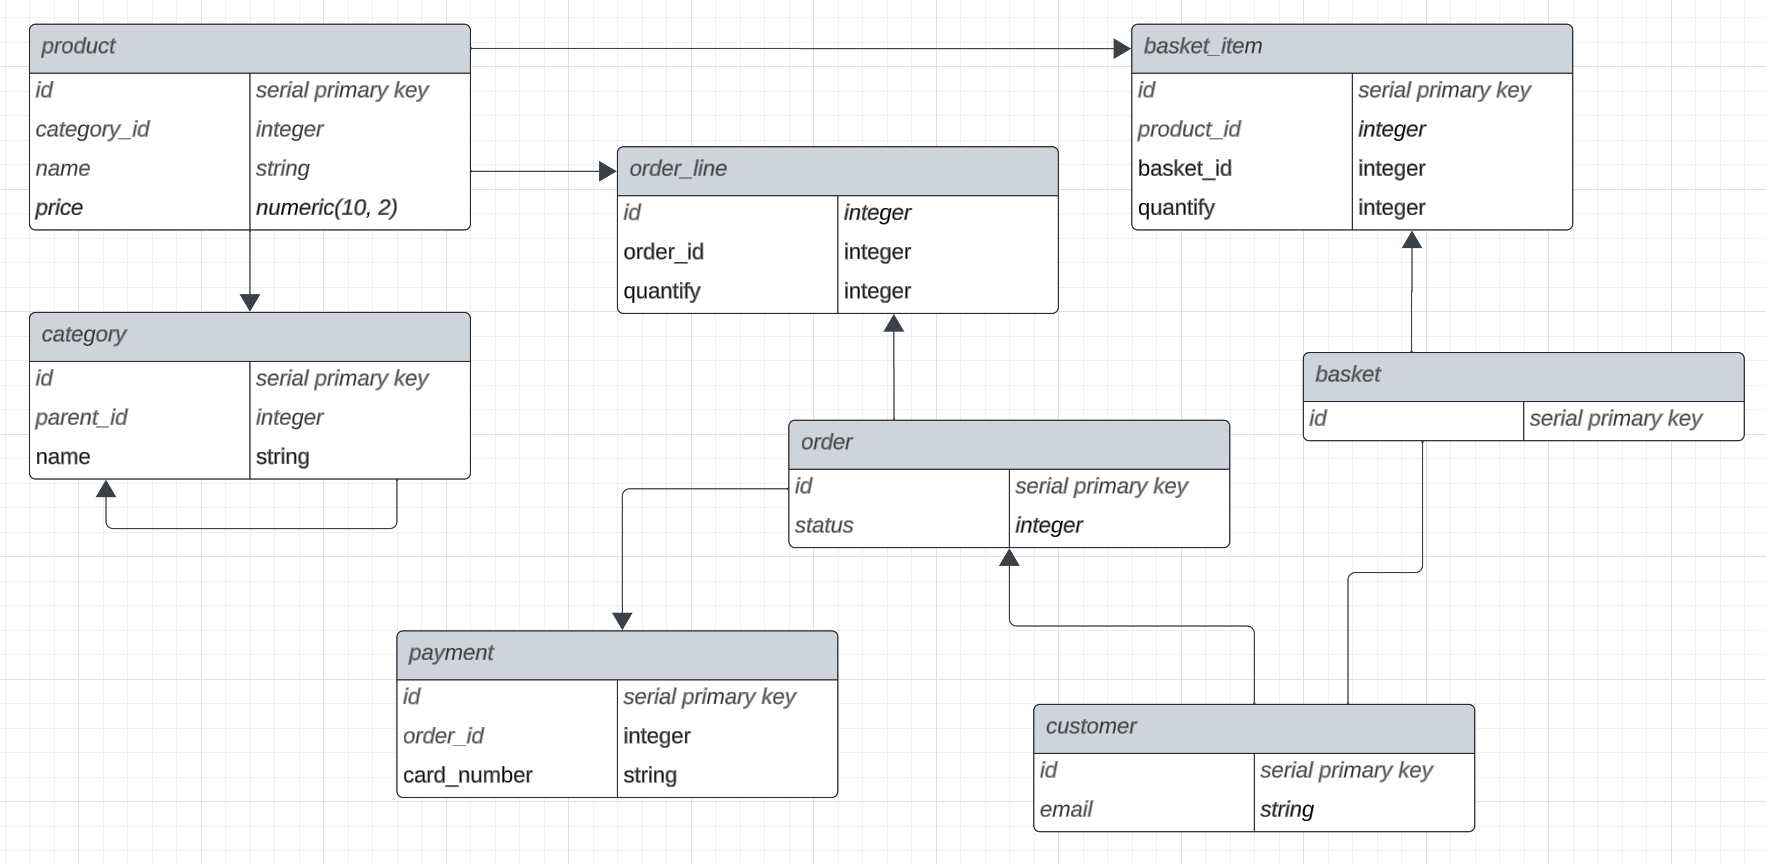
Dari sini, kita dapat menyimpulkan bahwa seorang pelanggan dapat membuat keranjang belanja dan menambahkan beberapa produk dengan kuantitas yang bervariasi.
Sebuah produk memiliki kategori, yang pada gilirannya dapat memiliki kategori induk.
Keranjang dapat menjadi pesanan yang bisa dipecah menjadi beberapa pembayaran.
Seperti telah disebutkan, ini adalah pandangan yang sangat disederhanakan tentang relasi dan atribut entitas yang membentuk aplikasi belanja online, namun ini cukup untuk tujuan tutorial ini.
Kita tidak perlu mengkhawatirkan langkah ini saat mengimplementasikan basis data relasional. SQL adalah bahasa yang sangat kuat yang, selama skema dirancang dengan benar, memberi kita fleksibilitas untuk mengkueri dan memanipulasi data sesuka kita. Ini tidak berlaku saat menggunakan pola desain single table di NoSQL karena kita perlu menyimpan data secara terdenormalisasi dan siap dikonsumsi langsung oleh aplikasi.
Berikut pola akses yang mungkin ingin kita dukung untuk aplikasi belanja online:
NoSQL workbench adalah alat gratis dari AWS untuk memodelkan tabel NoSQL untuk DynamoDB.
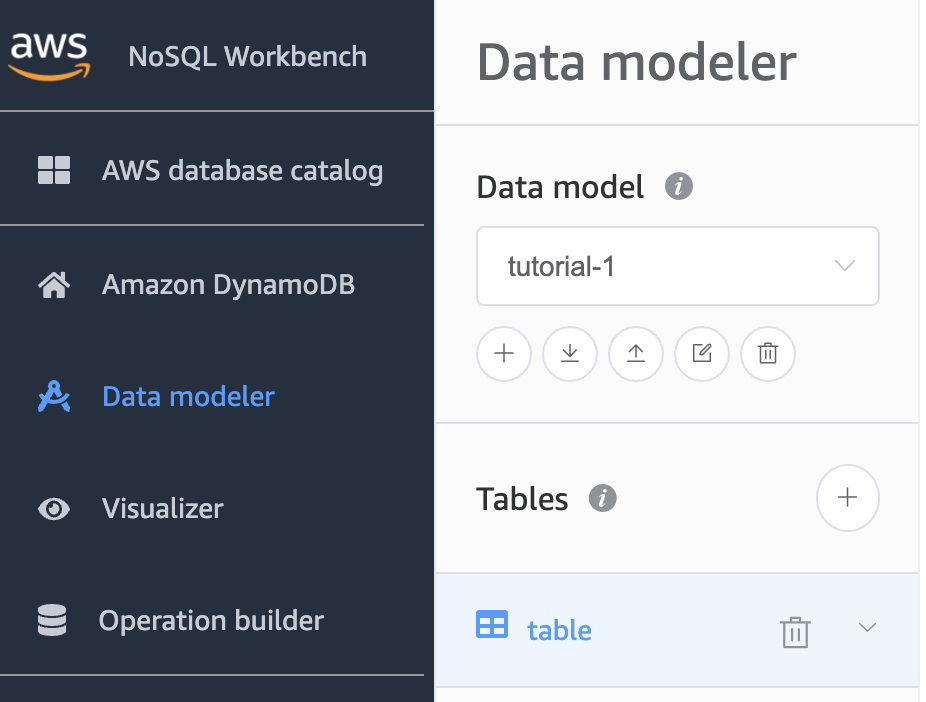
Masuk ke Data modeler dan buat model data baru dengan tabel baru:
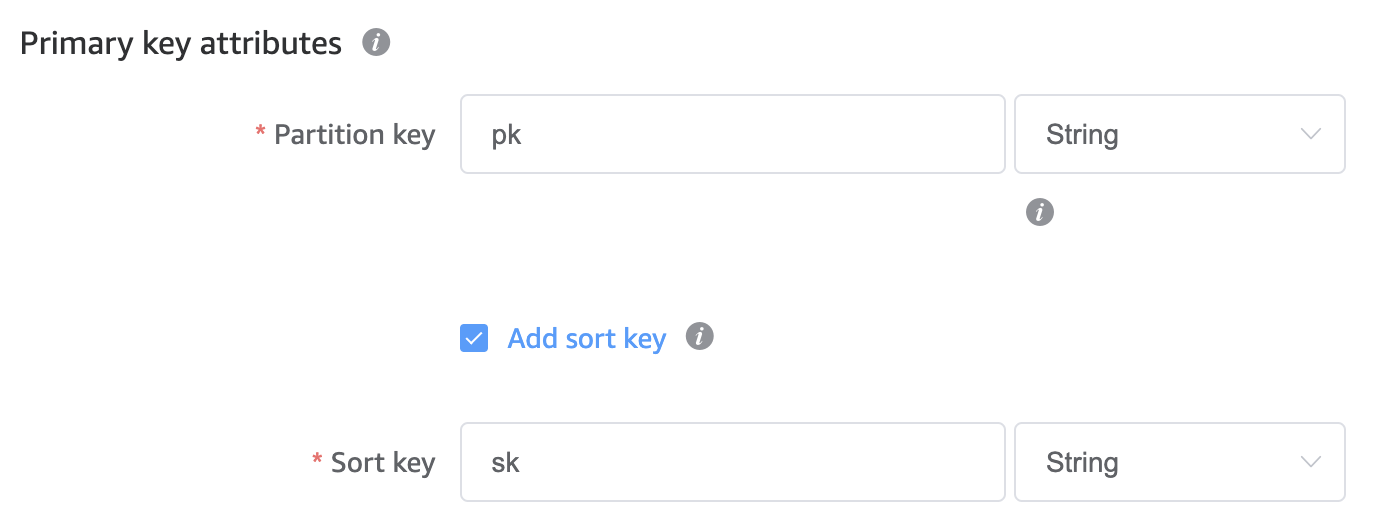
Kita akan mempertahankan atribut kunci primer sebagai string generik PK dan SK:
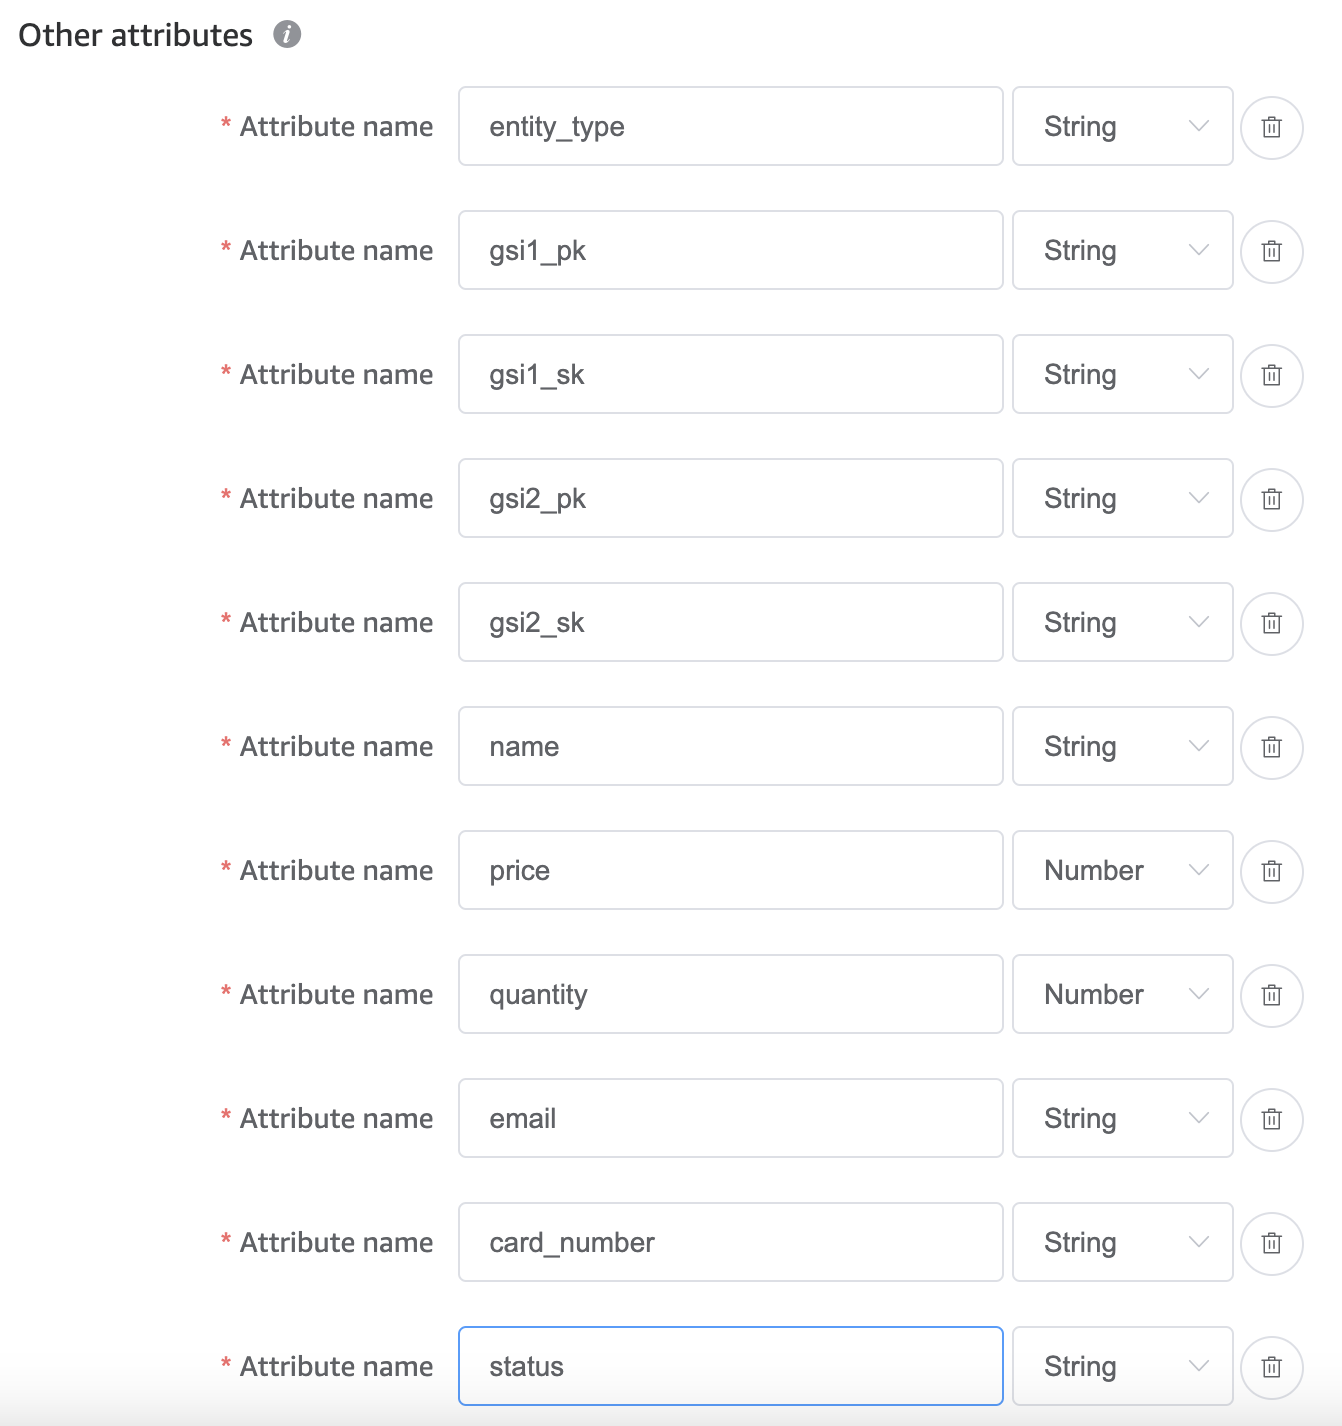
Untuk atribut tambahan, kita akan menyimpan entity_type beserta dua atribut kunci primer GSI PK dan SK.
GSI adalah global secondary index, yaitu salinan tabel Anda yang dijaga tetap sinkron oleh DynamoDB (secara asinkron!!) namun disimpan menggunakan pasangan atribut kunci primer alternatif. Ini adalah mekanisme kunci bagaimana satu tabel dapat mendukung banyak pola akses. Lebih lanjut tentang ini nanti; untuk sekarang, pahami bahwa kunci-kunci ini akan menyimpan kunci primer dari entitas terkait.
Atribut tambahan lainnya yang perlu kita tambahkan adalah semua atribut non-kunci dari data kita (catatan: langkah ini hanya diperlukan pada fase desain dan tidak akan didefinisikan secara eksplisit saat kita menyediakan tabel sebenarnya):
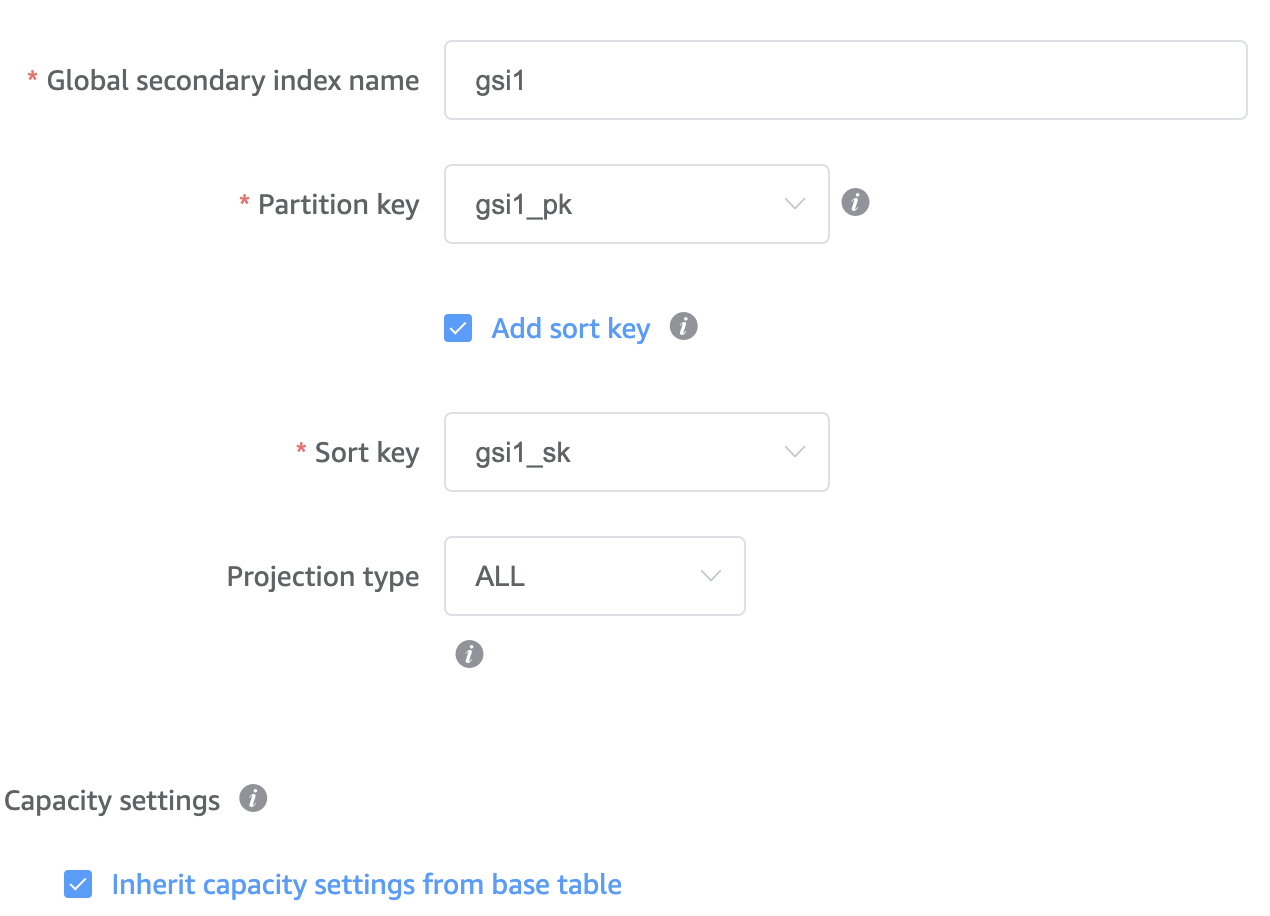
Selanjutnya, kita tambahkan dua GSI menggunakan kunci yang kita definisikan pada langkah sebelumnya:
Klik simpan lalu klik untuk memvisualisasikan model data. Anda sekarang seharusnya melihat tabel baru Anda yang masih kosong. Klik edit tabel, lalu di kanan atas, edit data; ini akan memungkinkan Anda menambahkan baris baru:
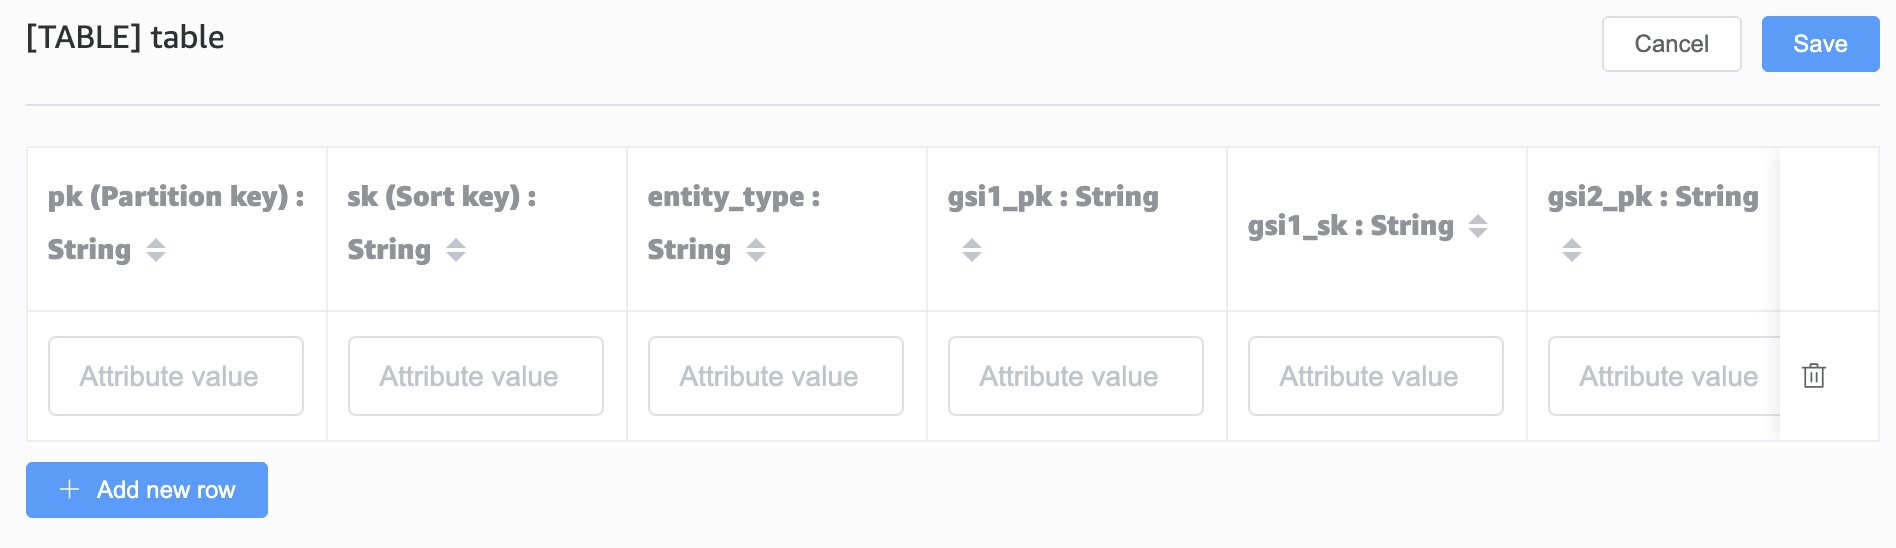
Sebelum mulai menambahkan data, kita perlu mendefinisikan prefiks kunci primer untuk setiap entitas:
|
produk |
p# |
|
kategori |
c# |
|
pelanggan (pengguna) |
u# |
|
keranjang |
b# |
|
item keranjang |
bi# |
|
pesanan |
o# |
|
baris pesanan |
ol# |
|
pembayaran |
py# |
|
faktur |
i# |
Mayoritas pola akses berpusat pada pelanggan, jadi untuk indeks primer, kita akan menggunakan ID pelanggan sebagai partisi utama, dengan rekam jejak pelanggan itu sendiri dapat diidentifikasi karena sort key-nya juga ID pelanggan.
Kita kemudian dapat dengan mudah menambahkan relasi pelanggan ke pesanan dan pelanggan ke keranjang dengan menggunakan partition key yang sama tetapi dengan sort key yang unik.
Tampilan agregat kita sekarang terlihat seperti ini:
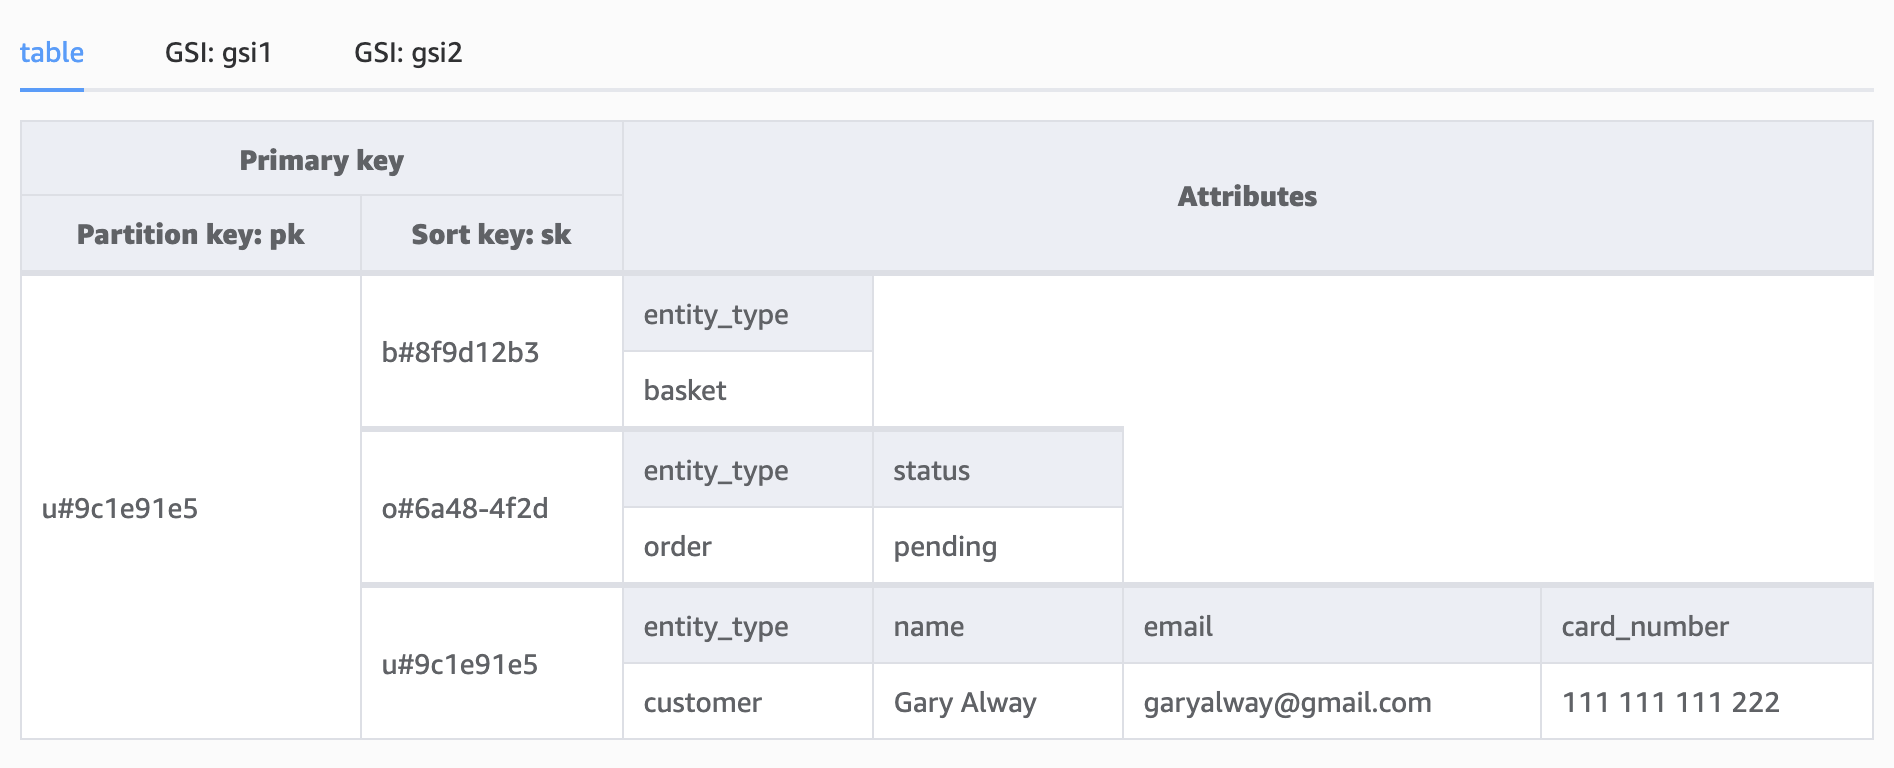
Sekarang kita dapat mengkueri ketiga rekaman tersebut dalam satu perintah, dengan menkueri seluruh partisi pelanggan itu:
export const getAllCustomerRecords = async (id: string) =>
  dynamoClient
    .query({
      TableName: TABLE_NAME,
      KeyConditionExpression: "pk=:pk",
      ExpressionAttributeValues: {
        ":pk": valueToAttributeValue(addPrefix(id, CUSTOMER_PREFIX)),
      },
    })
    .then((result) => result.Items);
Seiring bertambahnya ukuran tabel, kueri semacam ini mungkin tidak paling efisien karena akan mengembalikan setiap pesanan pelanggan yang pernah dibuat, bersama semua rekaman pelanggan lainnya seperti keranjang dan faktur, tetapi bagus untuk diketahui bahwa kita dapat mengakses semua data pelanggan dalam satu kueri bila diperlukan.
Sedikit penyesuaian pada expression attribute values untuk menyertakan kecocokan parsial (begins_with) pada sort key memungkinkan kita mengkueri:
Poin pentingnya adalah bagaimana kita dapat memodelkan relasi satu-ke-satu dan satu-ke-banyak di NoSQL.
Entitas-entitas ini mewakili relasi satu-ke-banyak lainnya di mana satu kategori dapat berisi banyak produk.
Kategori juga memiliki relasi hierarkis di mana sebuah kategori dapat memiliki banyak subkategori, sehingga produk dapat berada di mana saja dalam pohon hierarki kategori.
Mari modelkan ini dengan buku yang dibagi menjadi fiksi dan nonfiksi.
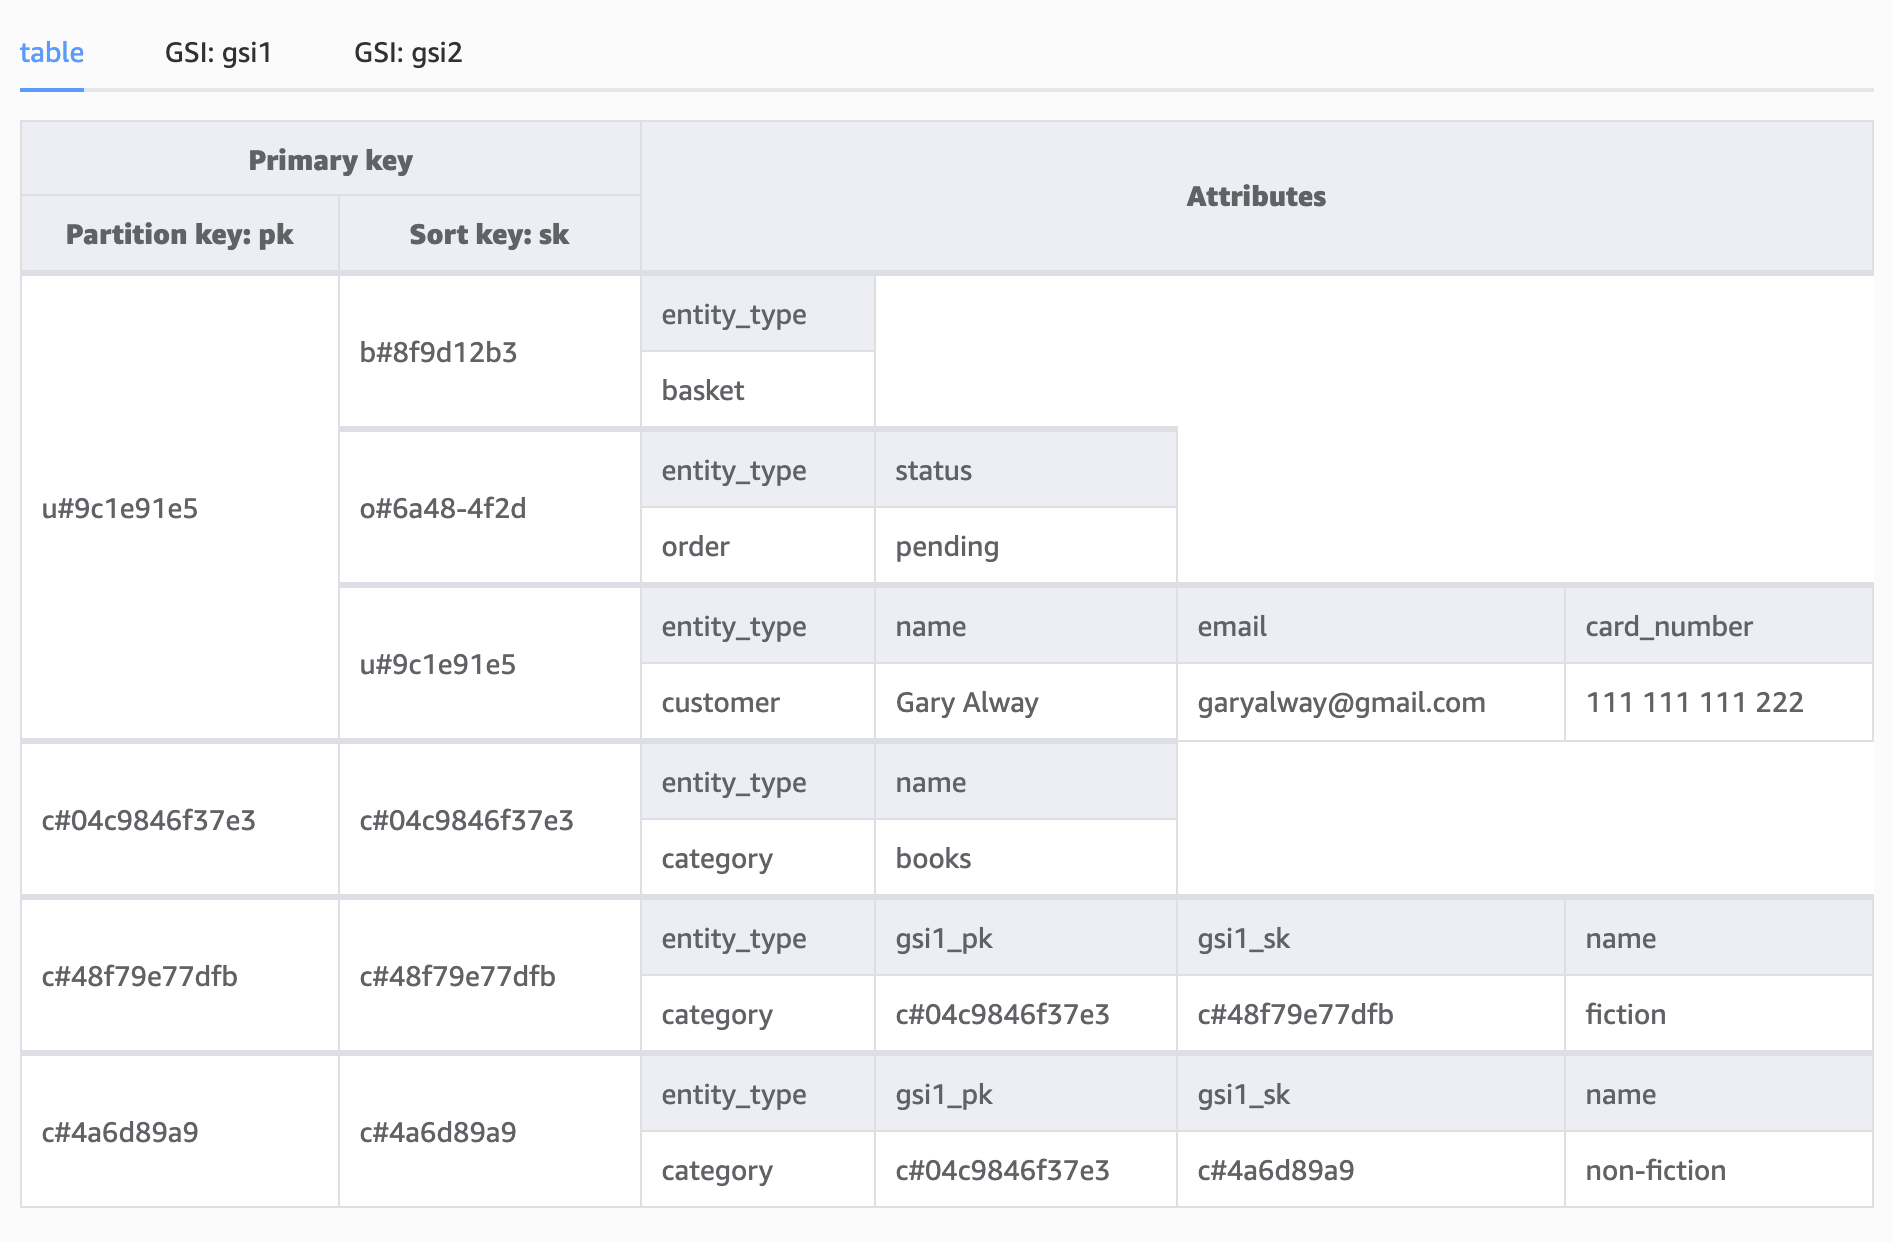
Perhatikan bagaimana kita mengisi kunci atribut GSI untuk subkategori, menetapkan GSI1_PK sebagai ID kategori induk dan GSI1_SK sebagai ID subkategori. Ini memungkinkan kita mengkueri semua subkategori berdasarkan kategori menggunakan GSI1:
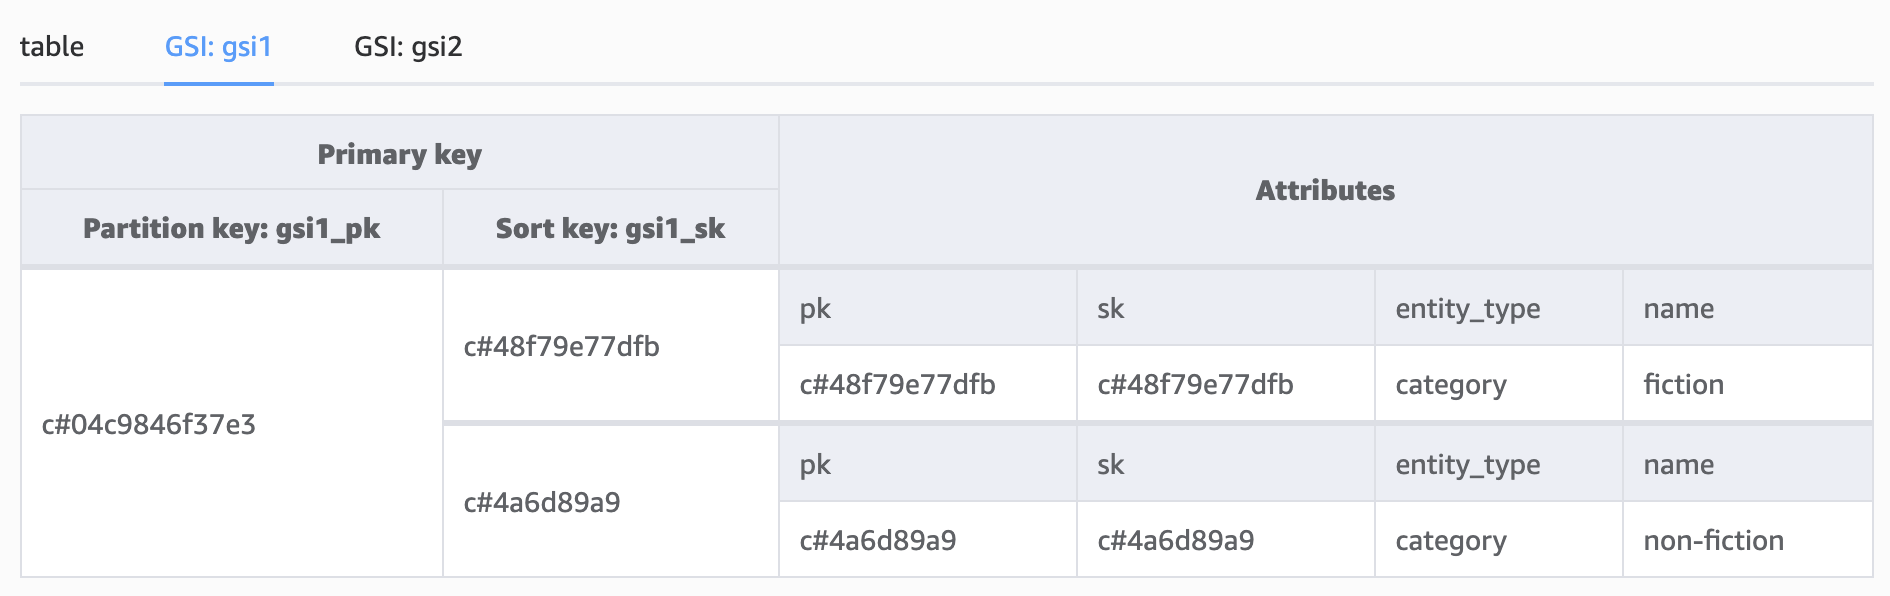
Indeks yang sama, GSI1, tidak hanya dapat digunakan untuk pemetaan relasi satu-ke-banyak. Misalnya kita ingin mencari pelanggan berdasarkan email; model saat ini tidak mendukungnya secara langsung kecuali kita membuat sedikit perubahan pada cara kita menyimpan data:
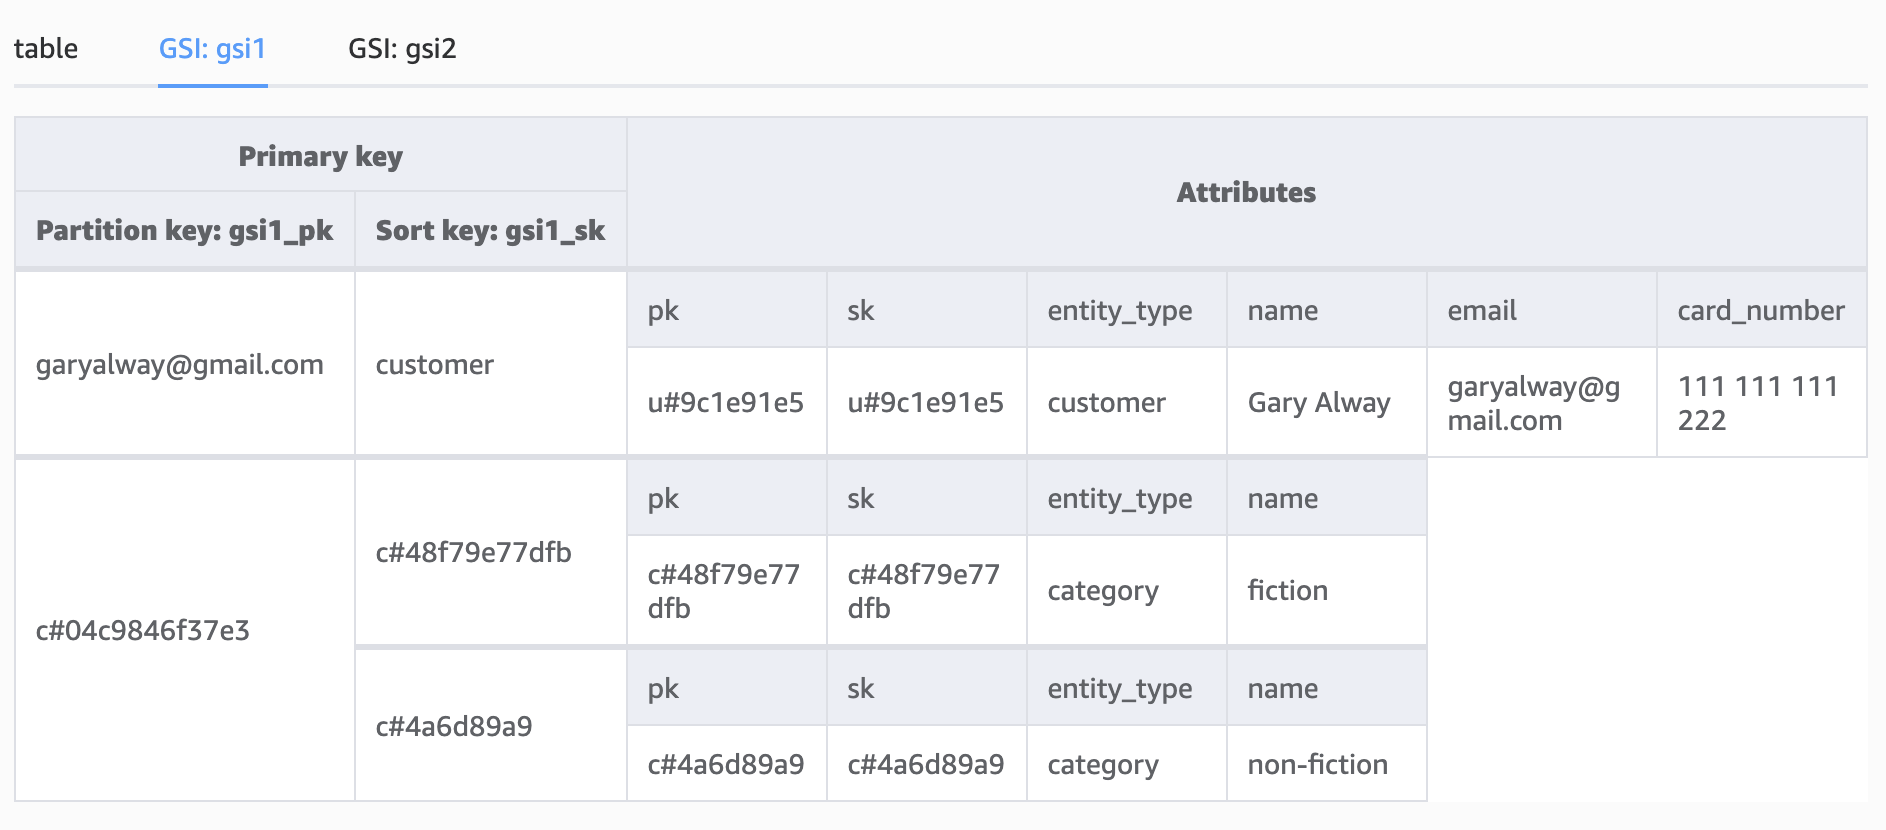
Menyimpan alamat email pelanggan dan tipe entitas sebagai GSI PK dan SK;
Untuk membantu distribusi data DynamoDB, kita bisa melangkah lebih jauh dengan menyimpan alamat email sebagai hash.
export const getCustomerByEmail = async (email: string) =>
  dynamoClient
    .query({
      TableName: TABLE_NAME,
      IndexName: "gsi1",
      KeyConditionExpression: "gsi1_pk = :email AND gsi1_sk = :entityType",
      ExpressionAttributeValues: {
        ":email": valueToAttributeValue(email),
        ":entityType": valueToAttributeValue(entityType),
      },
    })
    .then(({ Items }) => Items?.[0]);
Sampai di sini, Anda mungkin bertanya-tanya mengapa semua indeks memiliki nama generik dengan atribut kunci yang juga generik hanya PK dan SK. Jawabannya kini jelas: data yang kita simpan dan indeks yang kita pelihara bersifat fleksibel dan mampu mendukung berbagai pola akses tergantung pada tipe entitas.
Terraform untuk tabel yang kita gunakan sejauh ini adalah sebagai berikut:
resource "aws_dynamodb_table" "tutorial-1" {
  name = "tutorial-1"
  billing_mode = "PAY_PER_REQUEST"
  hash_key = "pk"
  range_key = "sk"


  attribute {
    name = "pk"
    type = "S"
  }


  attribute {
    name = "sk"
    type = "S"
  }


  attribute {
    name = "gsi1_pk"
    type = "S"
  }


  attribute {
    name = "gsi1_sk"
    type = "S"
  }


  attribute {
    name = "gsi2_pk"
    type = "S"
  }


  attribute {
    name = "gsi2_sk"
    type = "S"
  }


  global_secondary_index {
    name = "gsi1"
    hash_key = "gsi1_pk"
    range_key = "gsi1_sk"
    projection_type = "ALL"
  }


  global_secondary_index {
    name = "gsi2"
    hash_key = "gsi2_pk"
    range_key = "gsi2_sk"
    projection_type = "ALL"
  }
}
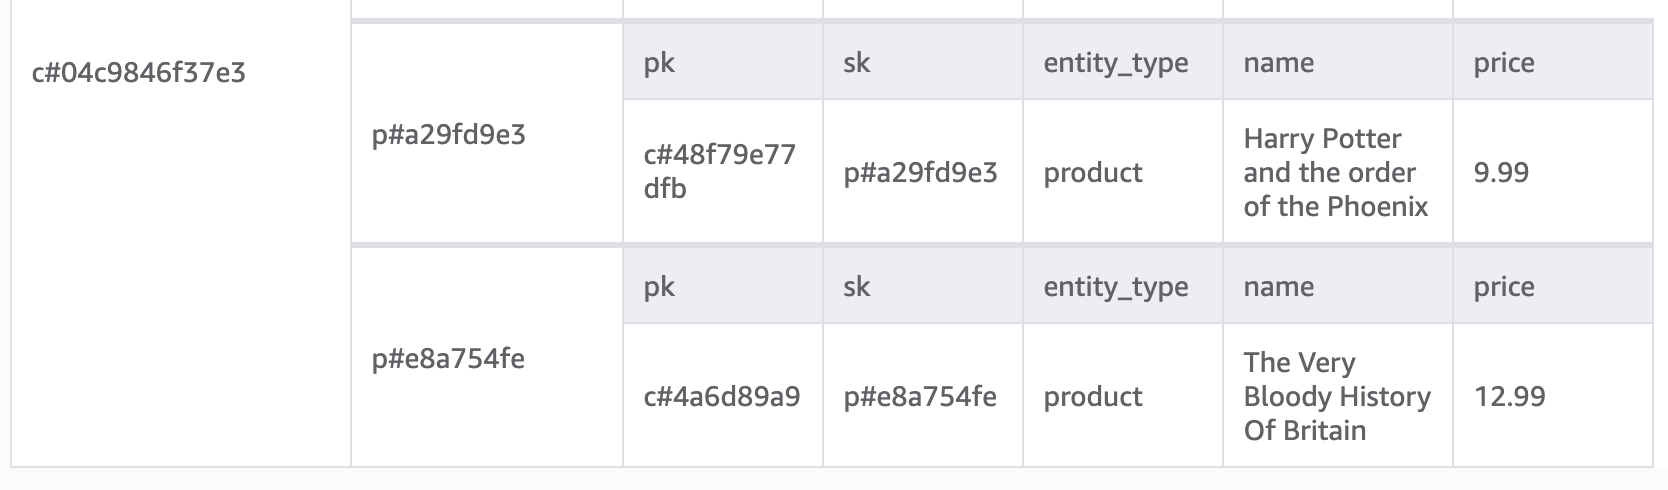
Penyimpanan produk mengikuti pola satu-ke-banyak yang sama di mana partition key adalah ID kategori dan sort key adalah ID produk:
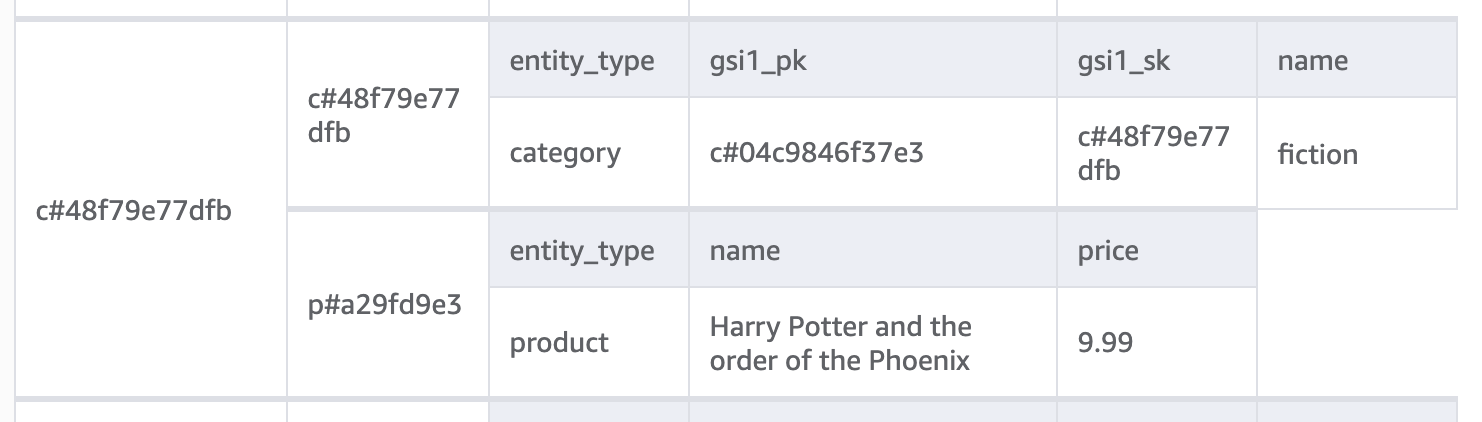
Menambahkan kategori induk ke GSI1 memungkinkan kita mengkueri semua buku dalam basis data kita:
Dalam aplikasi produksi, kita dapat menggunakan DynamoDB Streams untuk mendorong data ke klaster Elasticsearch sehingga kita bisa melakukan pencarian berdasarkan judul buku, namun bagaimana kita dapat menggunakan model yang ada untuk mengkueri berdasarkan judul produk?
Kita sudah menggunakan GSI1, jadi kita bisa menggunakan GSI2 untuk ini:
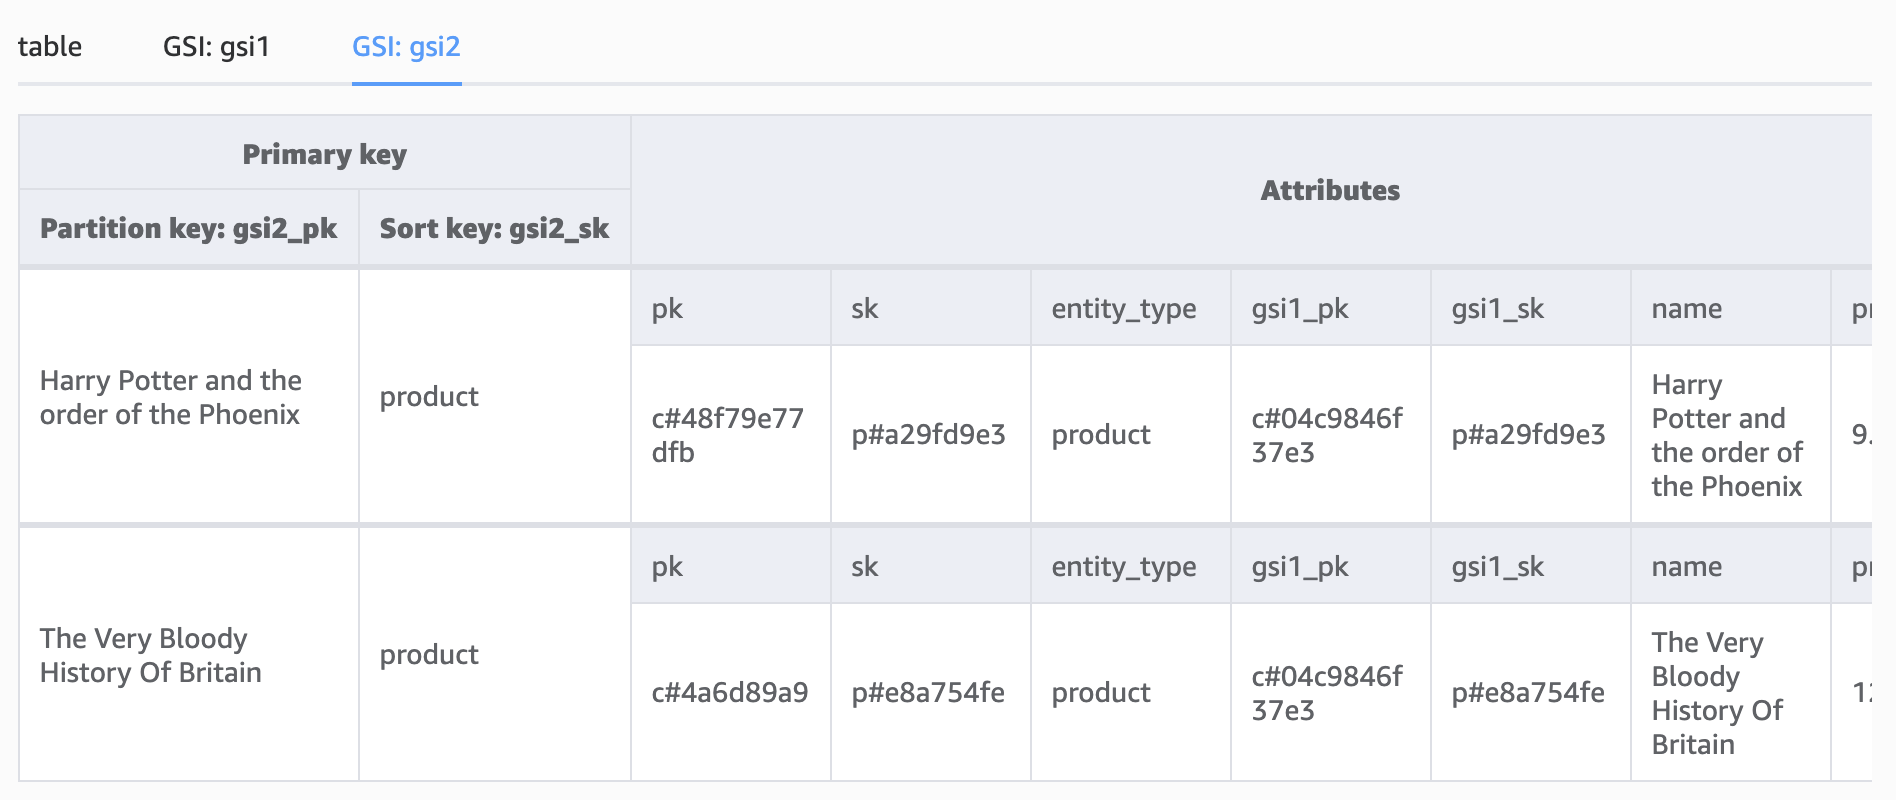
Ingat, saat mengkueri DynamoDB, Anda perlu menyediakan partition key yang persis lengkap, jadi meski implementasi ini mungkin bukan yang paling optimal, ini mengilustrasikan bagaimana tiga indeks dapat digunakan untuk pola akses yang berbeda.
Dalam tutorial saya berikutnya, saya akan menunjukkan bagaimana ini dapat dipecahkan dengan mengintegrasikannya dengan indeks pencarian.
Baik item keranjang maupun baris pesanan disimpan dalam partisi pelanggan; kita dapat menggunakan GSI untuk memungkinkan kita mengkueri semua produk dalam sebuah keranjang, semua produk dalam sebuah pesanan, dan semua produk yang pernah dipesan pelanggan.
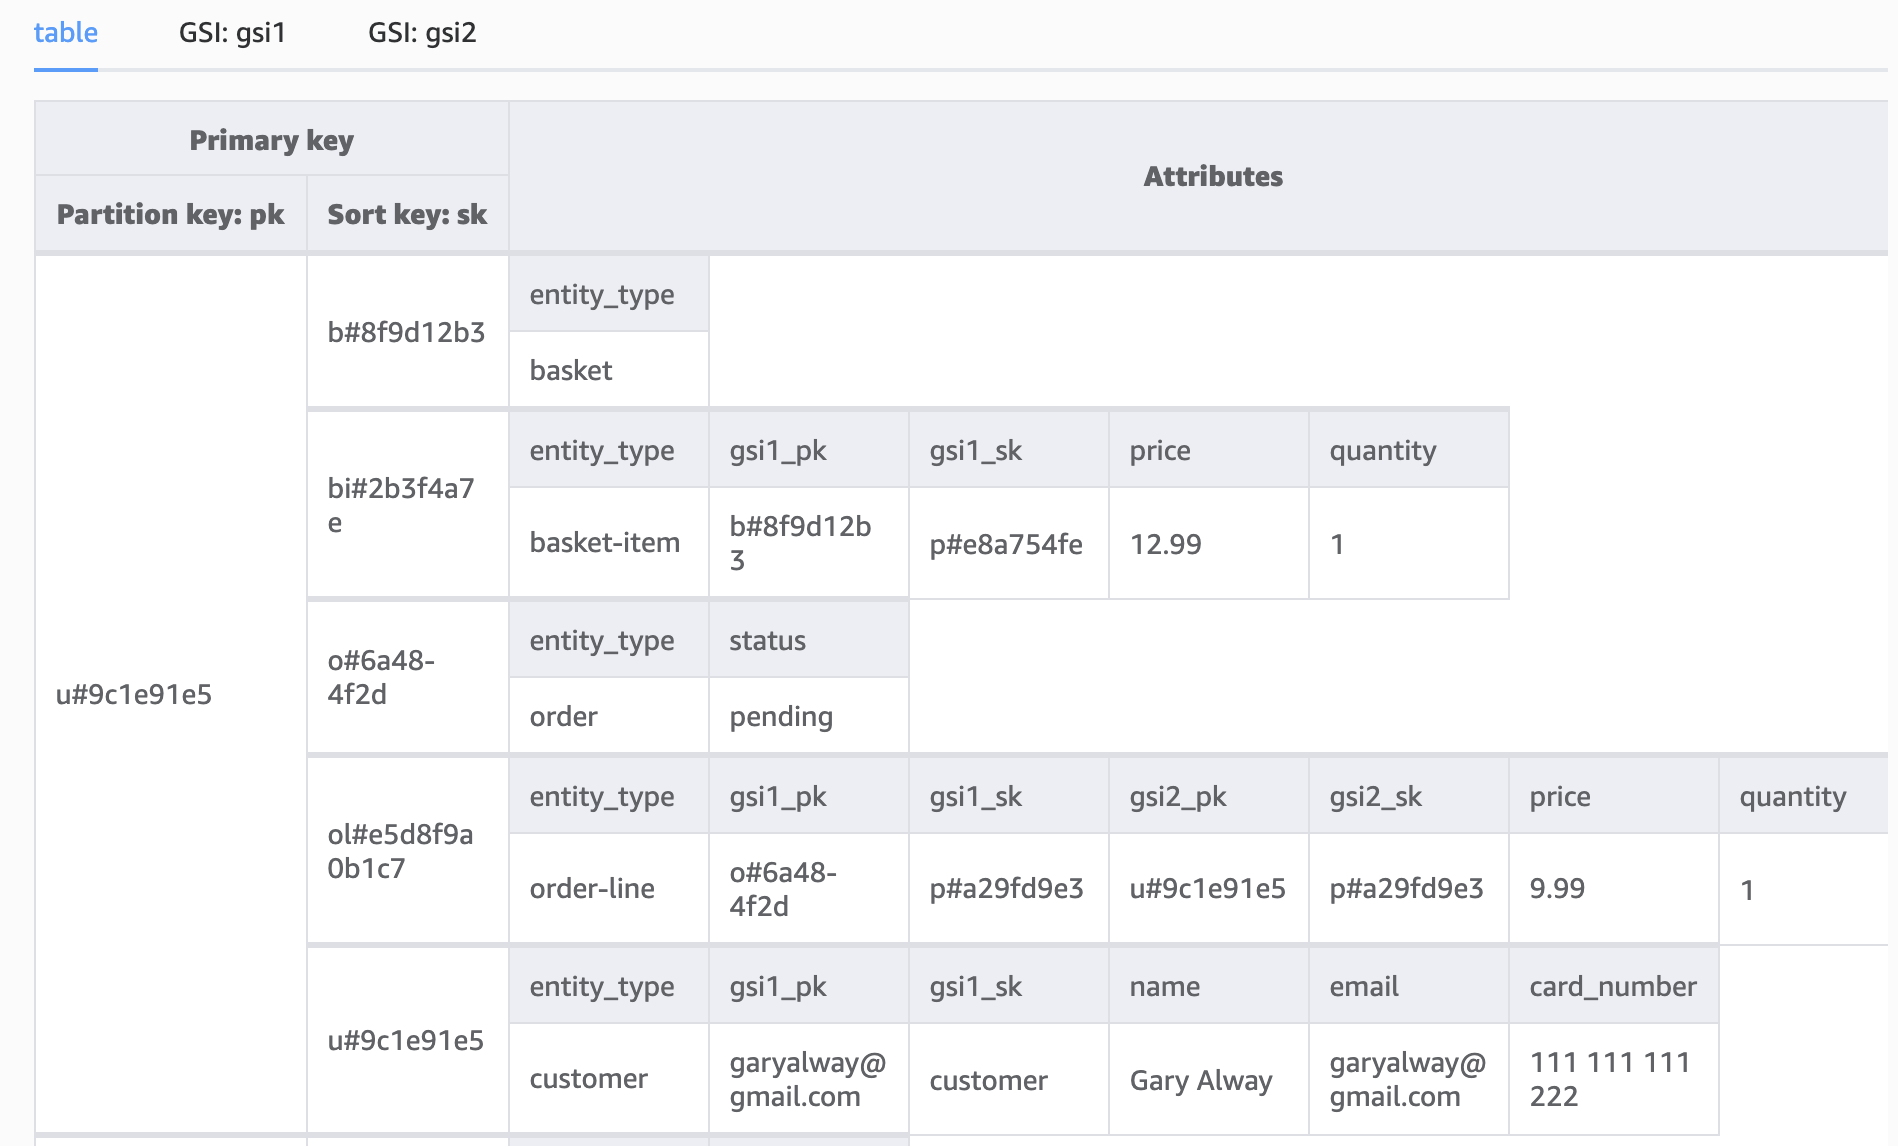
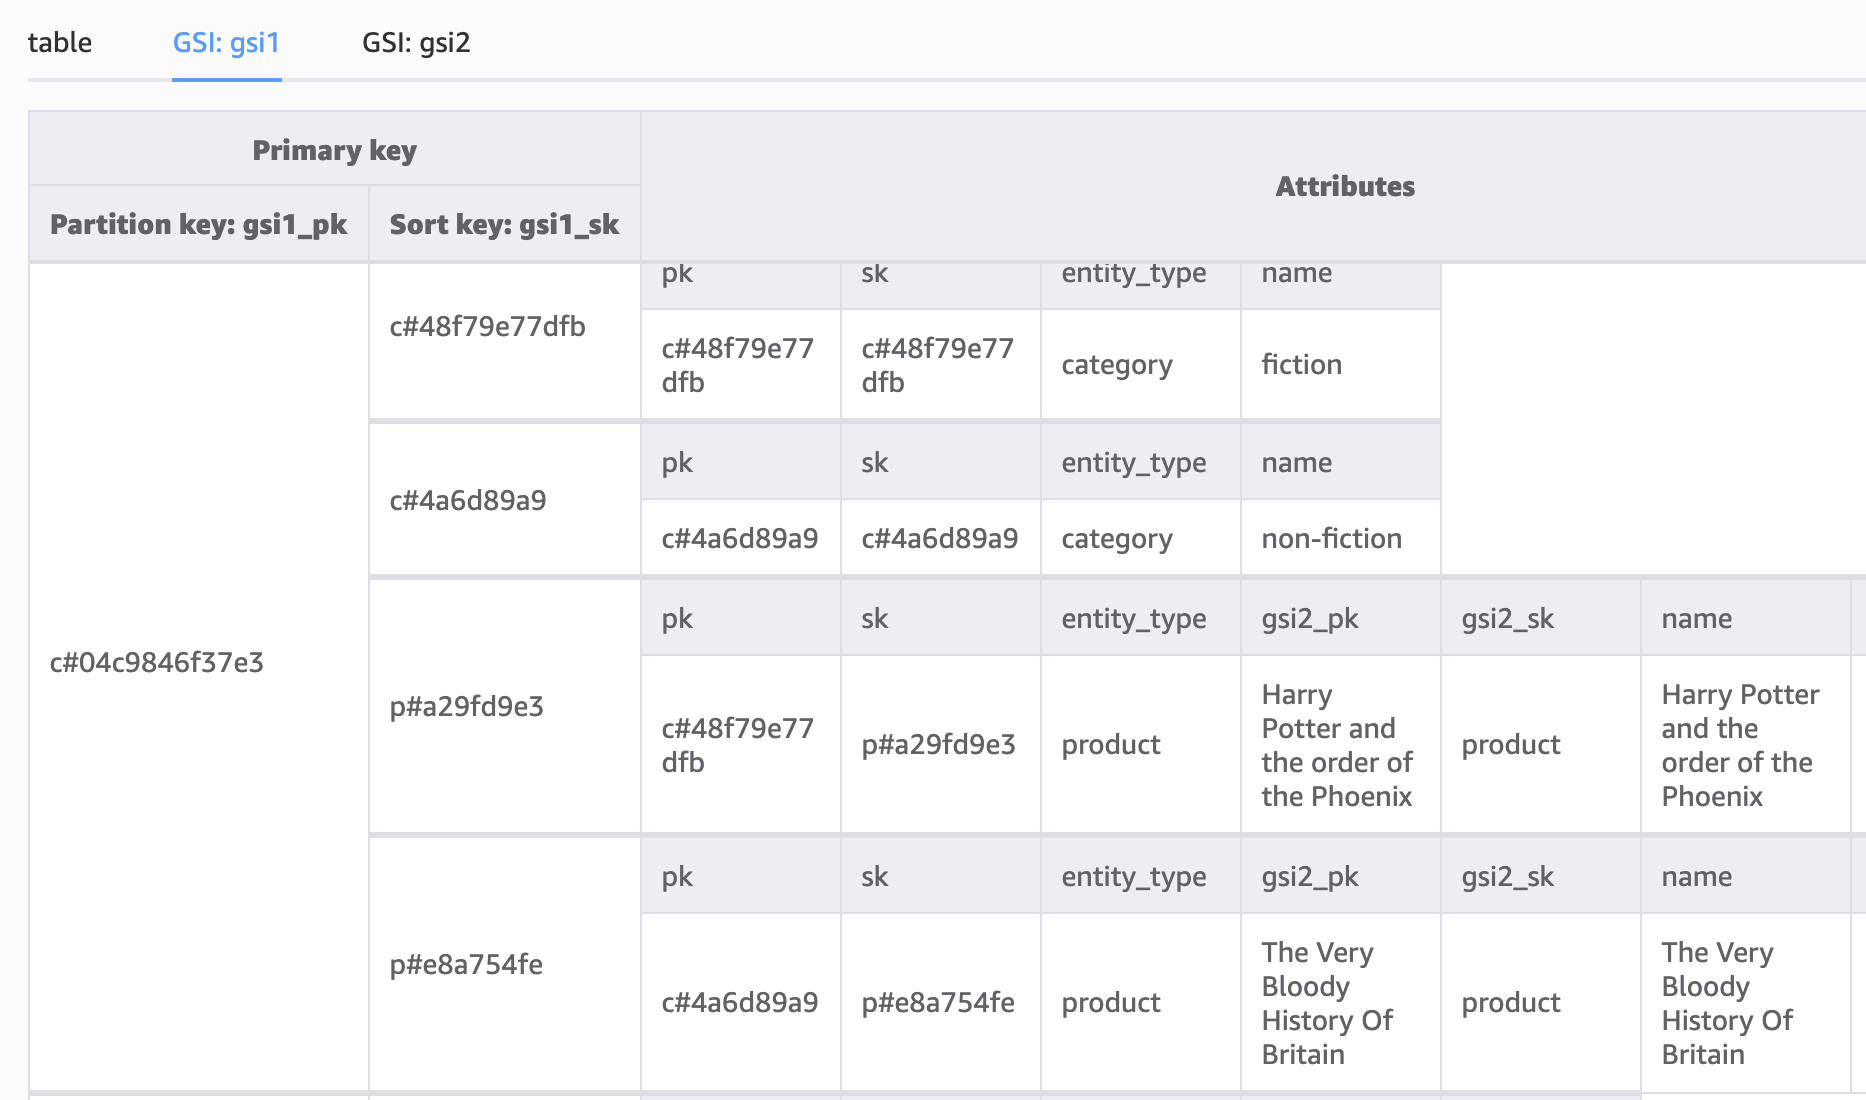
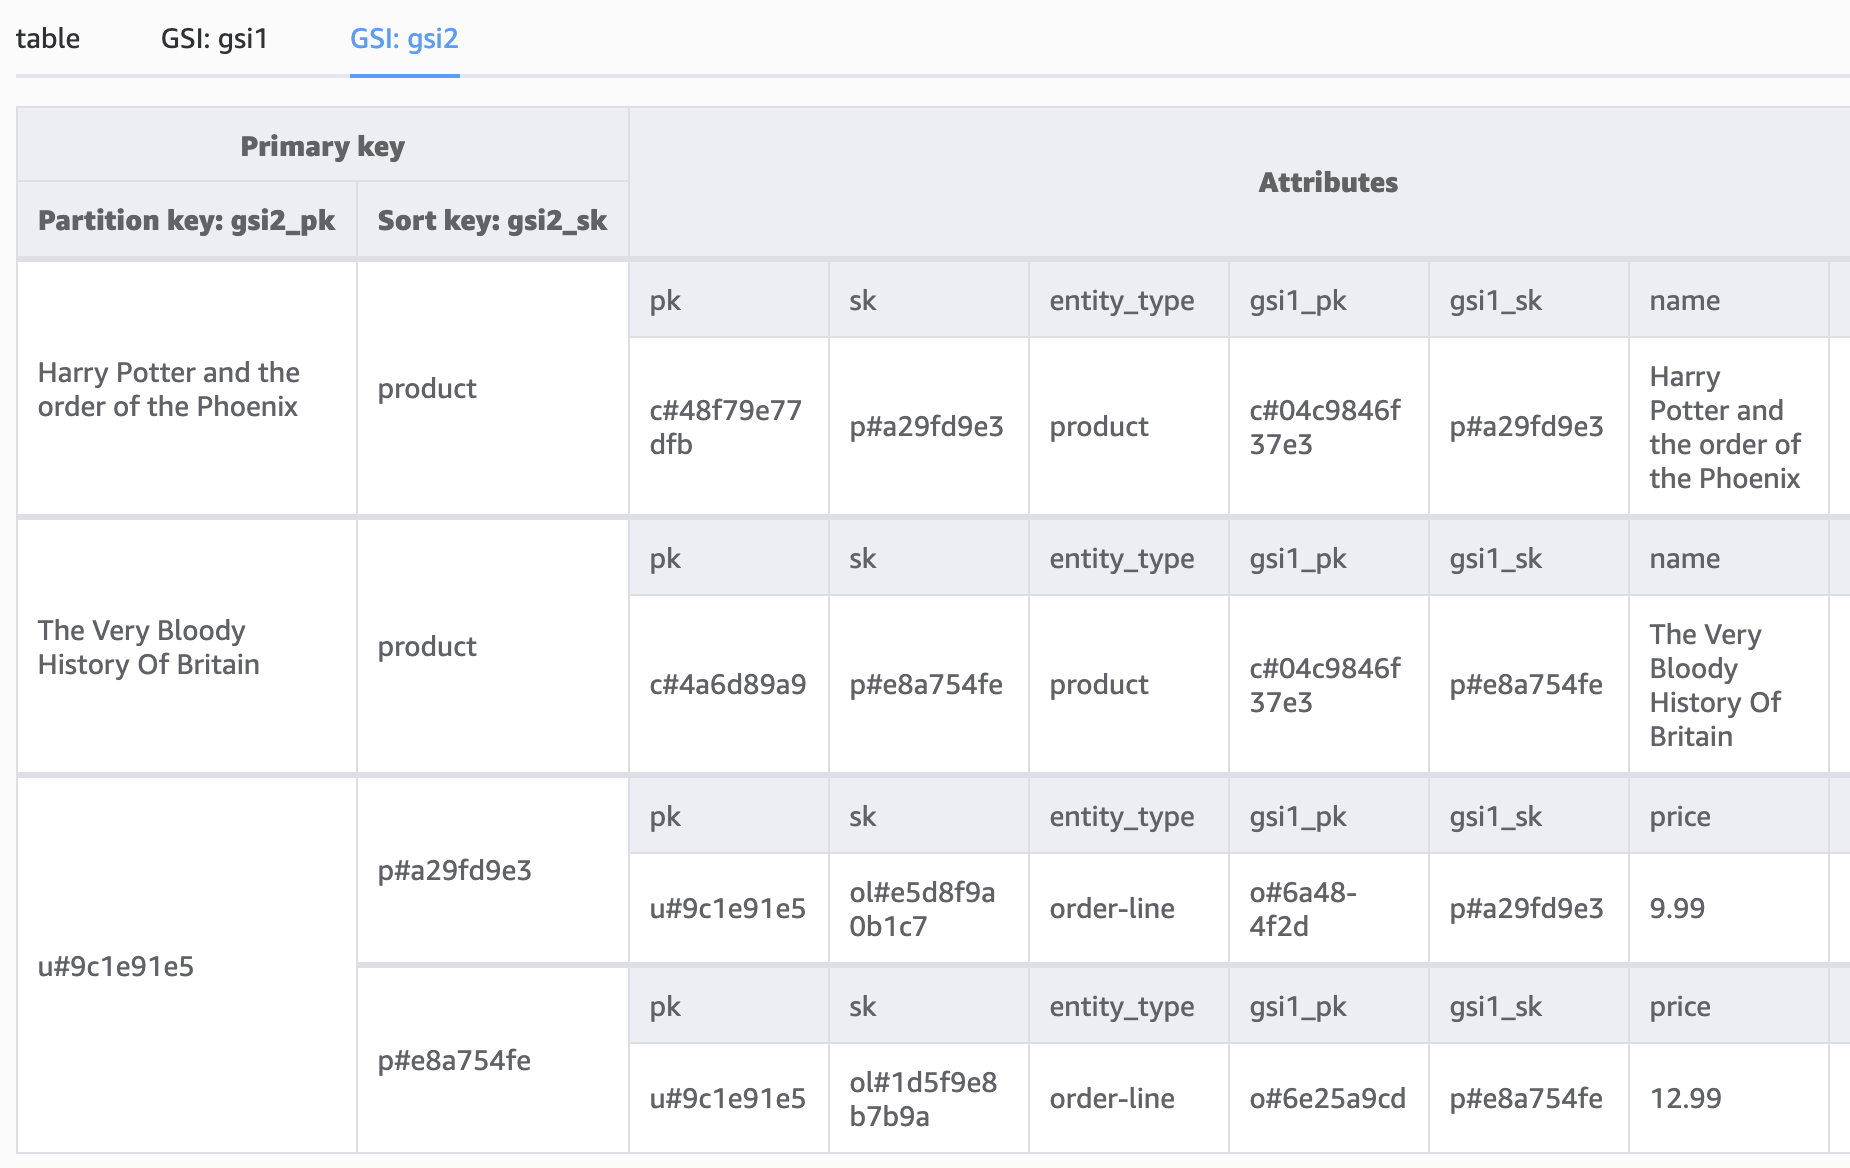
Contoh terakhir ini menunjukkan riwayat pesanan seorang pelanggan dengan dua produk yang dibuat dari dua ID pesanan berbeda.
Bagi yang tertarik bagaimana pemodelan data bekerja di basis data SQL, webinar Data Modeling in SQL kami menawarkan wawasan berharga yang dapat melengkapi pemahaman Anda tentang pemodelan data NoSQL.
Menggunakan desain single table dengan DynamoDB menawarkan banyak keuntungan, namun juga menghadirkan sejumlah tantangan dan pertimbangan:
Mengelola semua data Anda dalam satu tabel dapat menjadi kompleks, terutama saat aplikasi Anda tumbuh dan berkembang.
Anda harus merencanakan dan menyusun data dengan cermat untuk mengakomodasi berbagai pola kueri. Selain itu, efektivitas desain single table sangat terkait dengan logika aplikasi Anda; ia berperan penting dalam memastikan akses data yang lancar dan pemrosesan kueri yang efisien.
Pertimbangan cermat terhadap struktur data dan logika aplikasi sangat penting agar desain single table berjalan efektif.
Meskipun DynamoDB memungkinkan Global Secondary Index untuk mendukung pola kueri yang berbeda, Anda perlu menyediakan dan memelihara indeks-indeks ini, yang dapat meningkatkan biaya dan kompleksitas.
Memilih partition key yang tepat sangat krusial untuk distribusi data yang merata dan kinerja kueri. Memilih partition key yang tidak cocok dapat menyebabkan partisi panas dan hambatan kinerja.
Seiring bertambahnya volume data Anda, tabel tunggal Anda dapat tumbuh signifikan ukurannya. Ini dapat memengaruhi biaya penyimpanan serta biaya baca dan tulis data.
DynamoDB tidak mendukung pencarian teks penuh secara native, sehingga implementasi fungsi tersebut memerlukan integrasi dengan layanan lain seperti Elasticsearch.
Melakukan perubahan pada skema tabel dapat menjadi tantangan, terutama di sistem produksi. Anda mungkin perlu memigrasikan data yang ada atau memodifikasi logika aplikasi untuk menampung perubahan skema.
Bergantung pada pilihan konsistensi baca Anda (strong atau eventual), Anda mungkin perlu memperhitungkan potensi tantangan konsistensi data, dengan mengingat bahwa GSI direplikasi secara asinkron.
Kemampuan kueri DynamoDB kuat namun tidak seluwes kueri SQL.
Untuk lebih memahami cara mendesain basis data secara efektif dan menavigasi tantangan terkait, lihat kursus Database Design kami.
Saat bekerja dengan basis data NoSQL, penting untuk melepaskan diri dari pola desain basis data relasional yang sudah familiar; Anda harus "melupakan" apa yang telah Anda pelajari.
Memilih pola desain single table menawarkan janji basis data yang dapat diskalakan secara global, siap menangani lalu lintas besar dengan performa yang andal dan dapat diprediksi.
Namun, keunggulan performa ini tidak gratis; ia menuntut perencanaan yang cermat dan penerapan yang matang terhadap struktur basis data dan logika aplikasi Anda sejak awal.
Lengkapi pengetahuan Anda dengan kursus konsep NoSQL kami!
Mulai Perjalanan Data Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



