Khóa học
Các khái niệm NoSQL
2 giờ
19.3K
Chào mừng đến với thế giới của DynamoDB, nơi hiệu quả và khả năng mở rộng không giới hạn hội tụ trong một bảng duy nhất. Trong hướng dẫn toàn diện này, chúng ta sẽ bắt đầu một hành trình đầy cảm hứng, hé lộ tiềm năng thực sự của thiết kế cơ sở dữ liệu NoSQL với mô hình bảng đơn.
Khám phá nghệ thuật đơn giản hóa các mô hình dữ liệu phức tạp đồng thời khai thác toàn bộ sức mạnh của một cấu trúc thống nhất có thể dễ dàng đáp ứng nhu cầu ngày càng tăng của bạn.
Dù bạn là nhà phát triển dày dạn kinh nghiệm am hiểu cơ sở dữ liệu NoSQL hay chỉ mới bắt đầu hành trình với cơ sở dữ liệu, hãy sẵn sàng mở khóa một cấp độ mở rộng mới cho ứng dụng của bạn với kiến trúc dữ liệu mạnh mẽ!
Trước khi bắt đầu, điều quan trọng là hiểu sự khác biệt giữa NoSQL và cơ sở dữ liệu quan hệ, các kịch bản sử dụng từng loại và lý do các công nghệ này ra đời. Điều này đòi hỏi nhìn lại ngắn gọn lịch sử xử lý dữ liệu.
Bạn có thể đọc thêm về tầm quan trọng của cơ sở dữ liệu NoSQL trong khoa học dữ liệu trong một bài viết riêng.
Cơ sở dữ liệu quan hệ là công nghệ quen thuộc, được sử dụng rộng rãi từ những năm 1970. Hai vấn đề chính mà cơ sở dữ liệu quan hệ giải quyết là lưu trữ và tính toàn vẹn tham chiếu.
Dữ liệu được “chuẩn hóa”, thường đến dạng chuẩn 3, giúp giảm kích thước dấu chân dữ liệu đồng thời đảm bảo mọi cập nhật lên dữ liệu vẫn nhất quán với phần còn lại.
Kích thước dữ liệu lưu trữ lâu dài từng cực kỳ quan trọng vì trong lịch sử, thành phần đắt đỏ nhất trong trung tâm dữ liệu là ổ cứng. Ngày nay điều này không còn đúng: CPU mới là thành phần tốn kém nhất, và chi phí lưu trữ dữ liệu đã giảm mạnh. Điều này không có nghĩa cơ sở dữ liệu quan hệ lỗi thời; nó vẫn phù hợp cho:
Áp lực dữ liệu là khả năng của một hệ thống xử lý một lượng dữ liệu nhất định trong chi phí và/hoặc thời gian hợp lý.
Cơ sở dữ liệu NoSQL ra đời vào cuối những năm 1990 để giải quyết các vấn đề áp lực dữ liệu ảnh hưởng đến hiệu năng của cơ sở dữ liệu quan hệ do khối lượng dữ liệu ứng dụng tăng không ngừng.
CPU trong cơ sở dữ liệu quan hệ có thể được xem là một trong những nút thắt cổ chai chính khi máy chủ gắng sức lấy và ghép các dữ liệu đã chuẩn hóa thành các dạng khử chuẩn mà ứng dụng thường tiêu thụ.
Điều này có thể giảm nhẹ bằng cách thêm máy chủ bản sao đọc, nhưng NoSQL tiếp cận khác: lưu trữ dữ liệu ứng dụng ở dạng khử chuẩn, sẵn sàng cho ứng dụng tiêu thụ. Điều này khiến dấu chân dữ liệu lớn hơn so với cơ sở dữ liệu quan hệ nhưng giảm tải cho CPU, về cơ bản biến máy chủ cơ sở dữ liệu thành bộ định tuyến đơn giản dùng thuật toán băm để trỏ đến vị trí trên ổ đĩa trong trung tâm dữ liệu. Các trường hợp sử dụng điển hình cho NoSQL là:
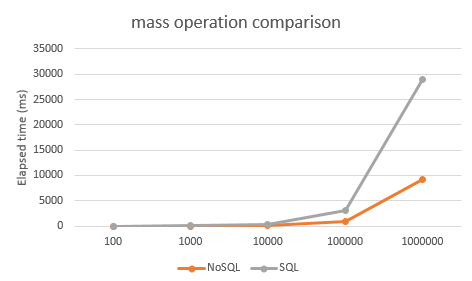
Nhiều nghiên cứu đã cung cấp đủ dữ liệu khách quan để minh họa biểu đồ hiệu năng của SQL so với NoSQL ở quy mô lớn.
Điểm cuối cùng cần làm rõ là dữ liệu lưu trong cơ sở dữ liệu NoSQL vẫn là dữ liệu quan hệ. Nếu dữ liệu không mang tính quan hệ, chúng ta sẽ lưu nó trong một kho tệp đơn giản.
Chúng ta không mô hình hóa cơ sở dữ liệu NoSQL theo cách mô hình hóa cơ sở dữ liệu quan hệ, nên việc chuyển trực tiếp thiết kế đã chuẩn hóa sang NoSQL bằng nhiều bảng có quan hệ join là một anti-pattern, vì NoSQL không có toán tử join, cũng không có tính toàn vẹn tham chiếu.
Một bảng trong NoSQL tương đương với một catalog trong cơ sở dữ liệu quan hệ. Thay vào đó, hãy mô hình dữ liệu được lưu ở dạng khử chuẩn, sẵn sàng cho ứng dụng tiêu thụ.
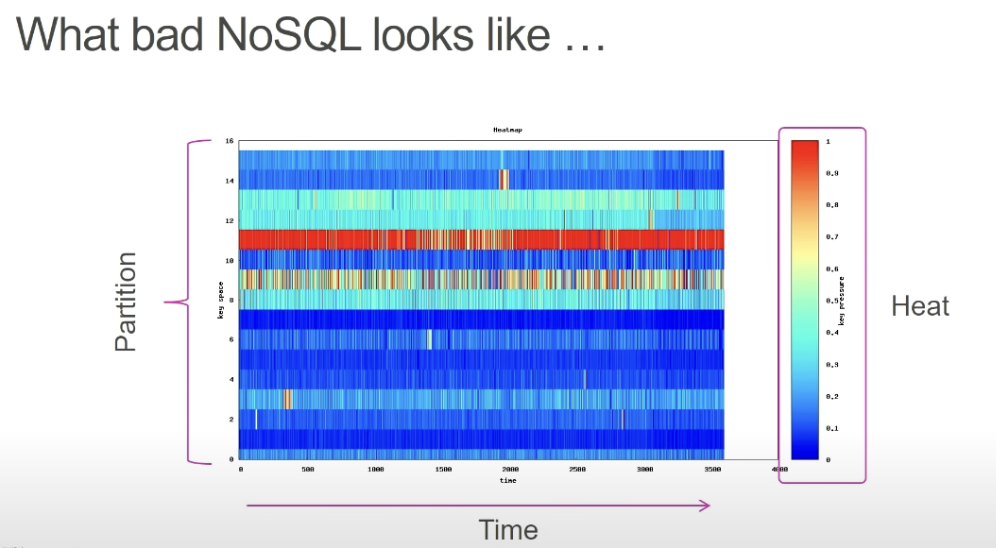
Một anti-pattern khác là Hot Keys. Nghĩa là phần lớn, nếu không muốn nói là tất cả, yêu cầu truy cập dồn vào một nút lưu trữ, cho thấy không gian khóa (key space) được thiết kế chưa đúng.
Bản đồ nhiệt truy cập sẽ trông như sau:
AWS DynamoDB là dịch vụ hoàn toàn được quản lý, không máy chủ, dạng kho khóa-giá trị cột rộng, nghĩa là nó hỗ trợ rất nhiều item (hay hàng) trong một bảng nhưng các item đó không nhất thiết có cùng thuộc tính. Các kiểu dữ liệu được hỗ trợ gồm:
Như đã đề cập, NoSQL nên dùng khi mẫu truy cập của ứng dụng đã biết rõ và cần hỗ trợ TPS lớn. DynamoDB có thể mở rộng cho mọi khối lượng công việc và cho thời gian phản hồi nhanh, ổn định có thể dự đoán được lên tới 4 triệu TPS với độ trễ thấp (10 - 20ms).
Mỗi item (hay hàng) có khóa phân vùng (partition key) dùng để định danh duy nhất item đó và quyết định cách phân phối dữ liệu trên lớp lưu trữ bên dưới.
Item có thể có thêm khóa sắp xếp (sort key) để quyết định thứ tự lưu dữ liệu trên đĩa trong một phân vùng. Sort key cho phép truy vấn phân vùng với các phép tìm kiếm phạm vi và lọc phức tạp (mặc dù thao tác lọc được áp dụng ở lớp client, không phải lớp cơ sở dữ liệu).
Khóa phân vùng được dùng để tạo chỉ mục băm, sau đó mỗi item được bố trí theo băm này trên một không gian khóa ảo. Không gian khóa ảo này được chia thành các phân đoạn ánh xạ đến thiết bị lưu trữ vật lý, có thể tăng giảm linh hoạt tùy theo lượng dữ liệu lưu trữ.
Đó là lý do DynamoDB nhanh và ổn định ở mọi quy mô: vì động cơ cơ sở dữ liệu đóng vai trò như dịch vụ định tuyến từ các khóa đã băm đến lưu trữ vật lý.
Trong hướng dẫn này, chúng ta sẽ mô hình một cửa hàng trực tuyến tên Daintree.com.
(Thông tin thú vị: rừng mưa nhiệt đới Daintree ở Queensland, Úc là một trong những khu rừng lâu đời nhất trên Trái Đất, ước tính khoảng 180 triệu năm tuổi!)
Trước tiên, hãy tạo một sơ đồ quan hệ thực thể (ERD) được giản lược cao để hình dung những gì chúng ta sẽ mô hình hóa.
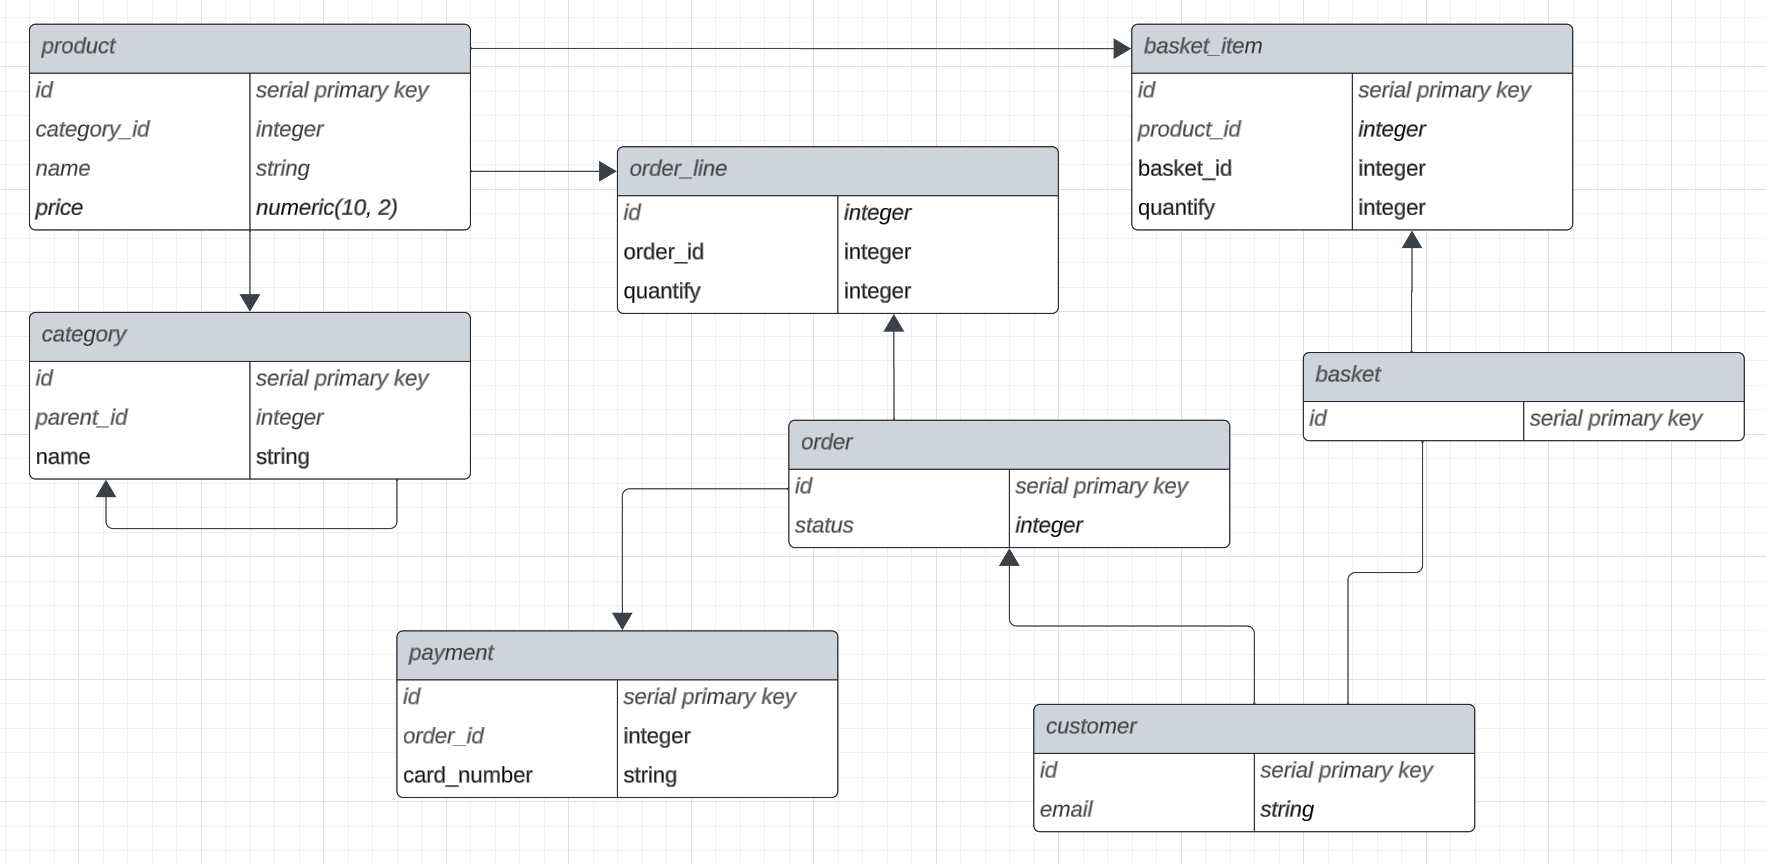
Từ đây, ta có thể suy ra rằng một khách hàng có thể tạo giỏ hàng và thêm nhiều sản phẩm với số lượng khác nhau.
Một sản phẩm có một danh mục, và danh mục đó có thể có danh mục cha.
Giỏ hàng có thể trở thành đơn hàng và đơn hàng có thể được chia thành nhiều khoản thanh toán.
Như đã nói, đây là cái nhìn rất giản lược về các mối quan hệ và thuộc tính của các thực thể tạo nên một ứng dụng mua sắm trực tuyến, nhưng đủ để phục vụ mục tiêu của hướng dẫn này.
Khi triển khai cơ sở dữ liệu quan hệ, chúng ta không cần lo bước này. SQL là một ngôn ngữ cực kỳ mạnh, miễn là schema được thiết kế đúng, cho phép ta linh hoạt truy vấn và thao tác dữ liệu theo bất kỳ cách nào mong muốn. Điều này không đúng khi dùng mô hình bảng đơn trong NoSQL, vì ta cần lưu dữ liệu ở dạng khử chuẩn và sẵn sàng cho ứng dụng tiêu thụ trực tiếp.
Dưới đây là các mẫu truy cập mà ta có thể muốn hỗ trợ cho ứng dụng mua sắm trực tuyến:
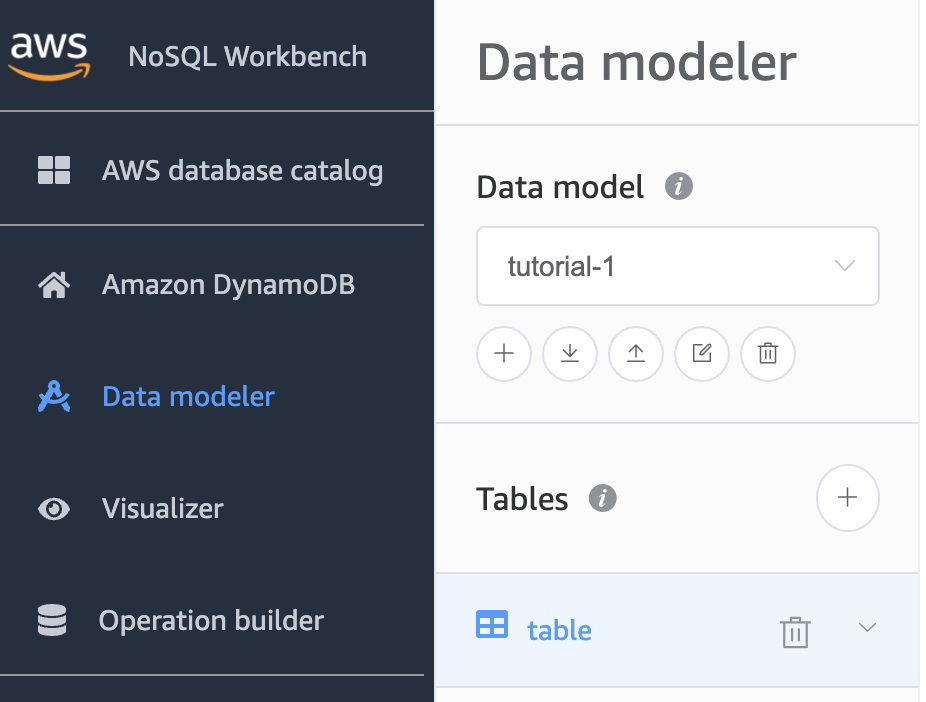
NoSQL workbench là công cụ miễn phí do AWS cung cấp để mô hình hóa bảng NoSQL cho DynamoDB.
Vào Data modeler và tạo một mô hình dữ liệu mới với một bảng mới:
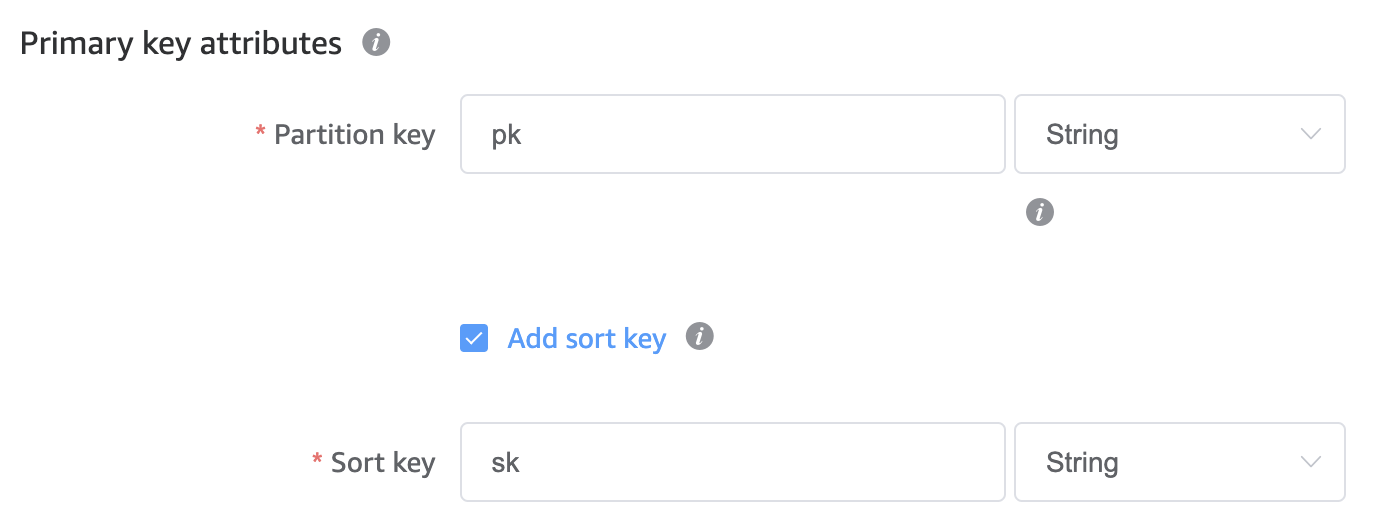
Chúng ta sẽ giữ thuộc tính khóa chính dạng chuỗi tổng quát là PK và SK:
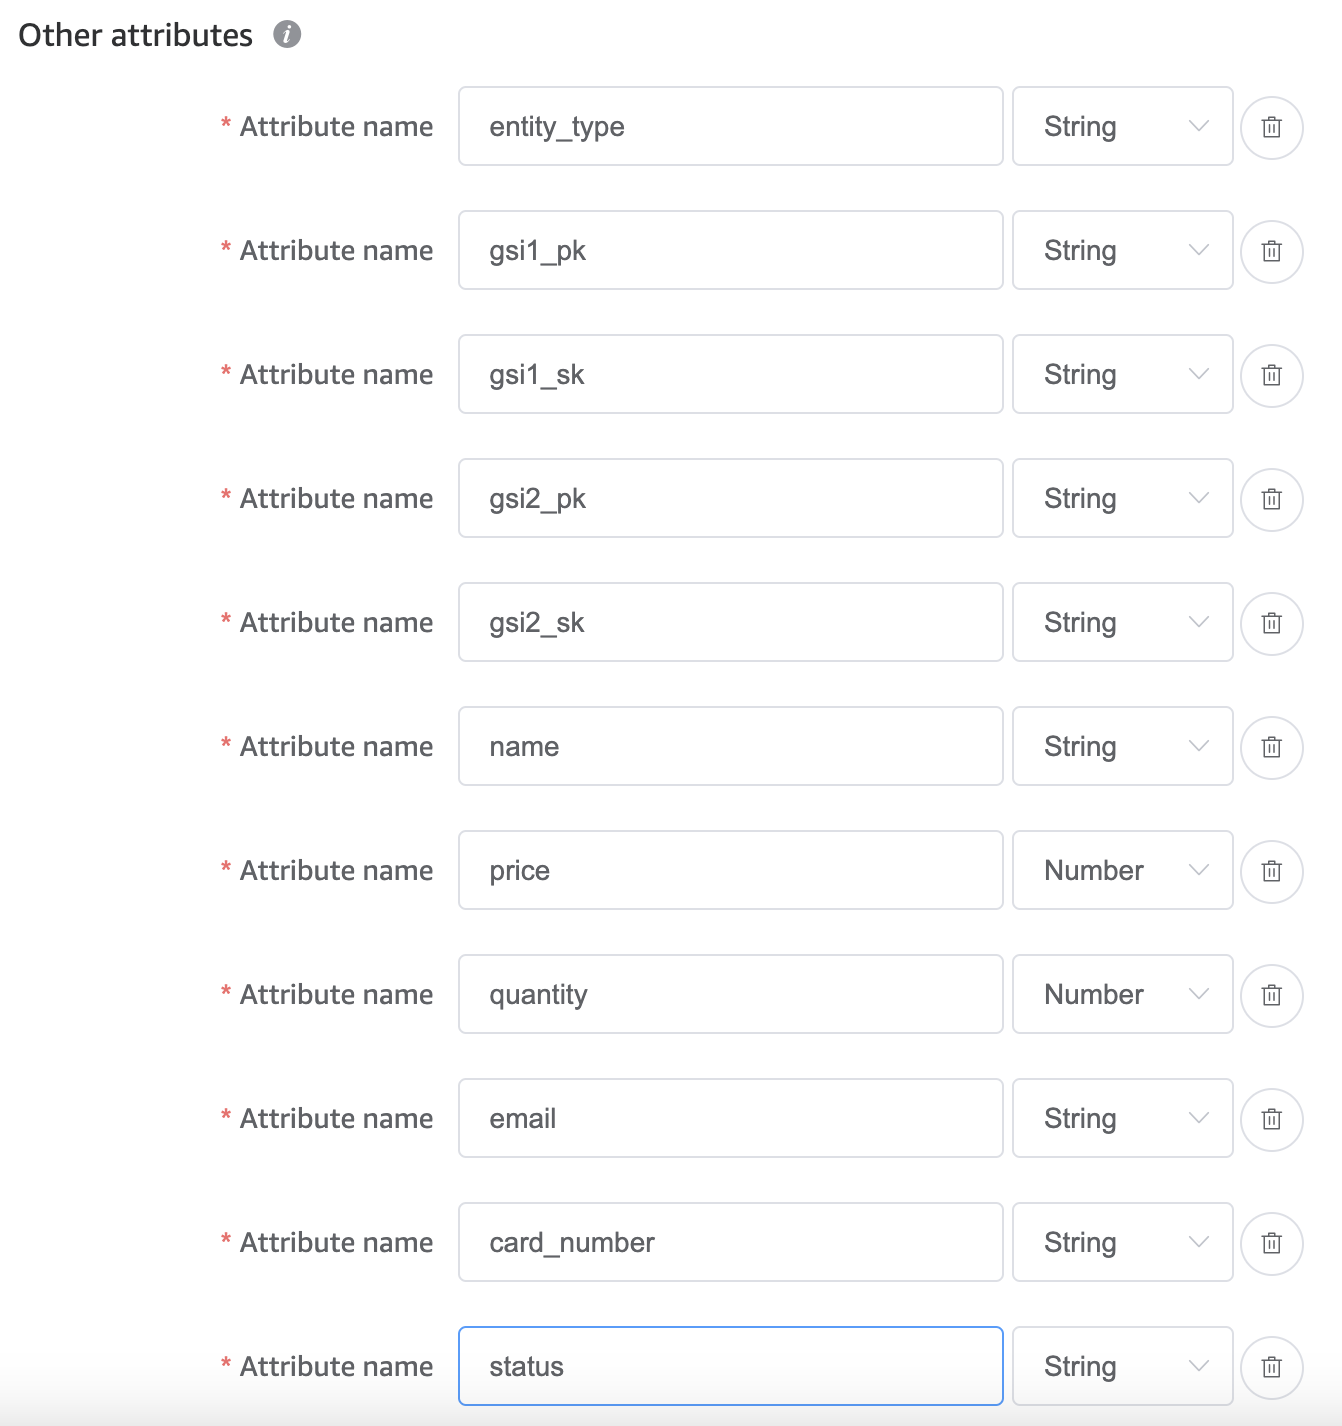
Với các thuộc tính bổ sung, chúng ta sẽ lưu entity_type cùng với hai thuộc tính khóa chính GSI PK và SK.
GSI là global secondary index (chỉ mục phụ toàn cục), tức là một bản sao của bảng mà DynamoDB giữ đồng bộ (không đồng bộ!!) nhưng được lưu bằng cặp thuộc tính khóa chính thay thế. Đây là cơ chế then chốt giúp một bảng đơn có thể hỗ trợ nhiều mẫu truy cập. Sẽ bàn kỹ hơn sau; hiện tại, chỉ cần hiểu rằng các khóa này sẽ lưu khóa chính của các thực thể liên quan.
Các thuộc tính bổ sung khác cần thêm là toàn bộ thuộc tính không phải khóa của dữ liệu (lưu ý bước này chỉ cần cho giai đoạn thiết kế và sẽ không được định nghĩa tường minh khi cấp phát bảng thực tế):
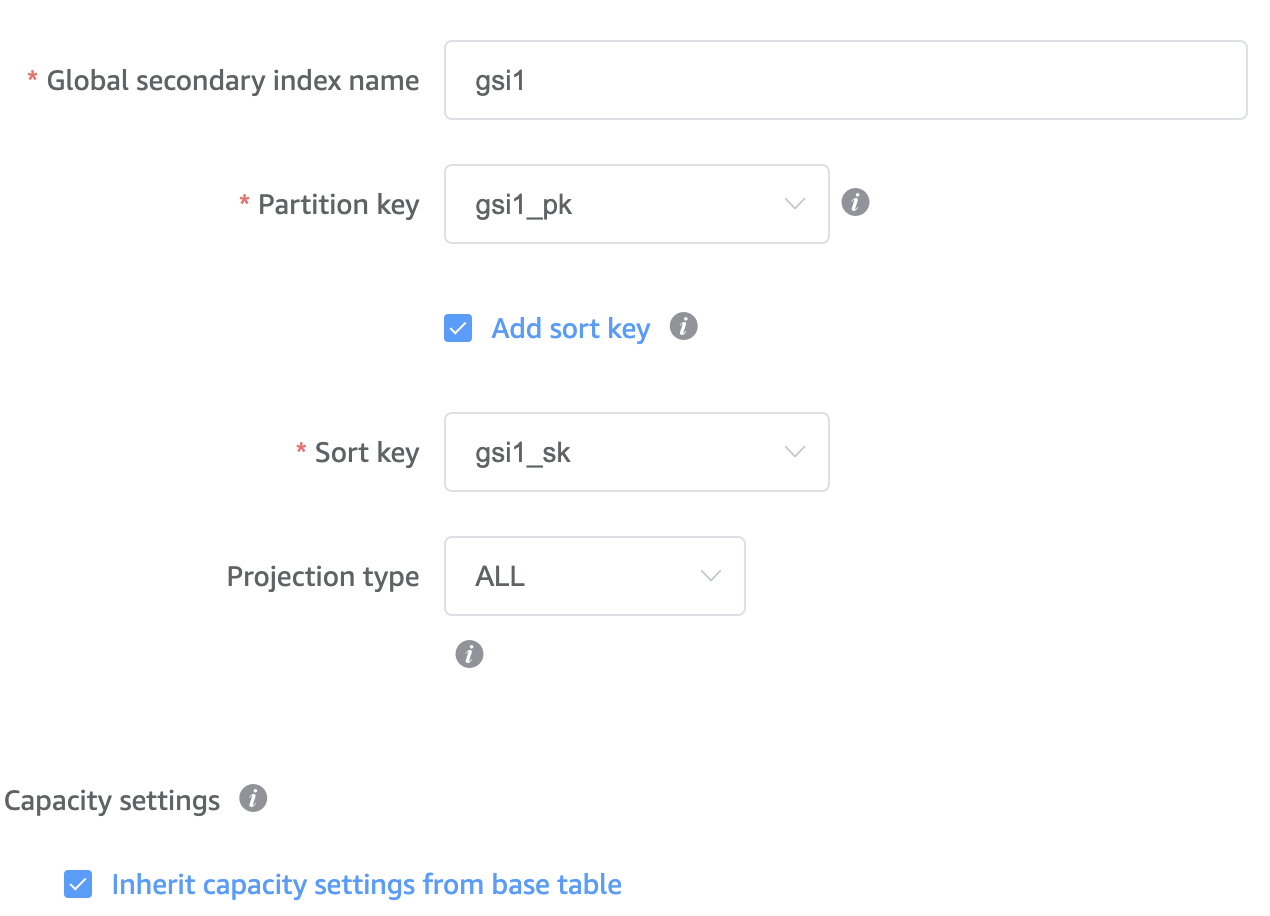
Tiếp theo, thêm hai GSI bằng các khóa đã định nghĩa ở bước trước:
Nhấn lưu rồi bấm visualize the data model. Bạn sẽ thấy bảng mới tạo nhưng trống. Bấm edit table, sau đó ở góc trên phải, chọn edit data; thao tác này cho phép bạn thêm hàng mới:
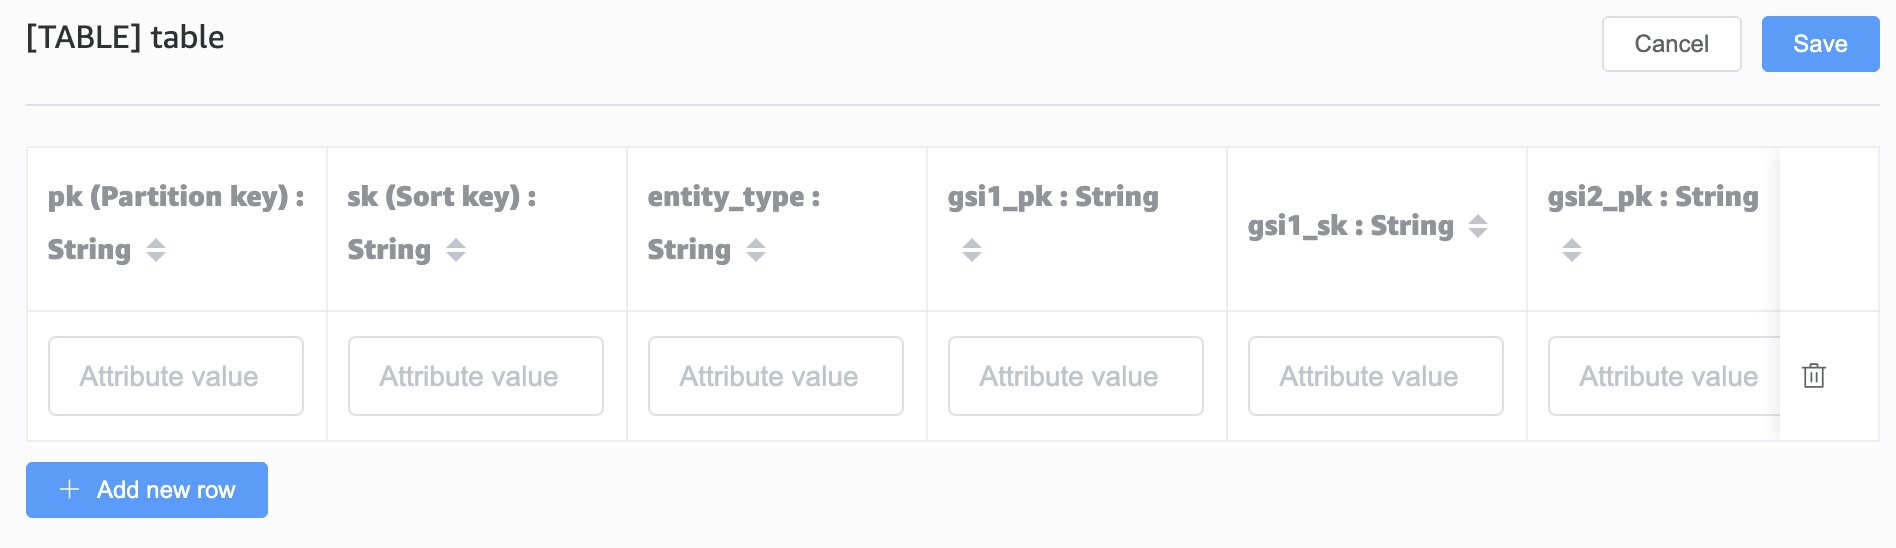
Trước khi bắt đầu thêm dữ liệu, ta cần định nghĩa tiền tố khóa chính cho từng thực thể:
|
product |
p# |
|
category |
c# |
|
customer (user) |
u# |
|
basket |
b# |
|
basket item |
bi# |
|
order |
o# |
|
order line |
ol# |
|
payment |
py# |
|
invoice |
i# |
Phần lớn các mẫu truy cập xoay quanh khách hàng, vì vậy với chỉ mục chính, chúng ta sẽ dùng ID khách hàng làm phân vùng chính, và bản ghi khách hàng thực tế sẽ được nhận diện bằng sort key cũng là ID khách hàng.
Sau đó chúng ta có thể dễ dàng thêm mối quan hệ từ khách hàng đến đơn hàng và đến giỏ hàng bằng cách dùng cùng khóa phân vùng nhưng với sort key duy nhất.
Tổng quan tổng hợp của chúng ta giờ trông như sau:
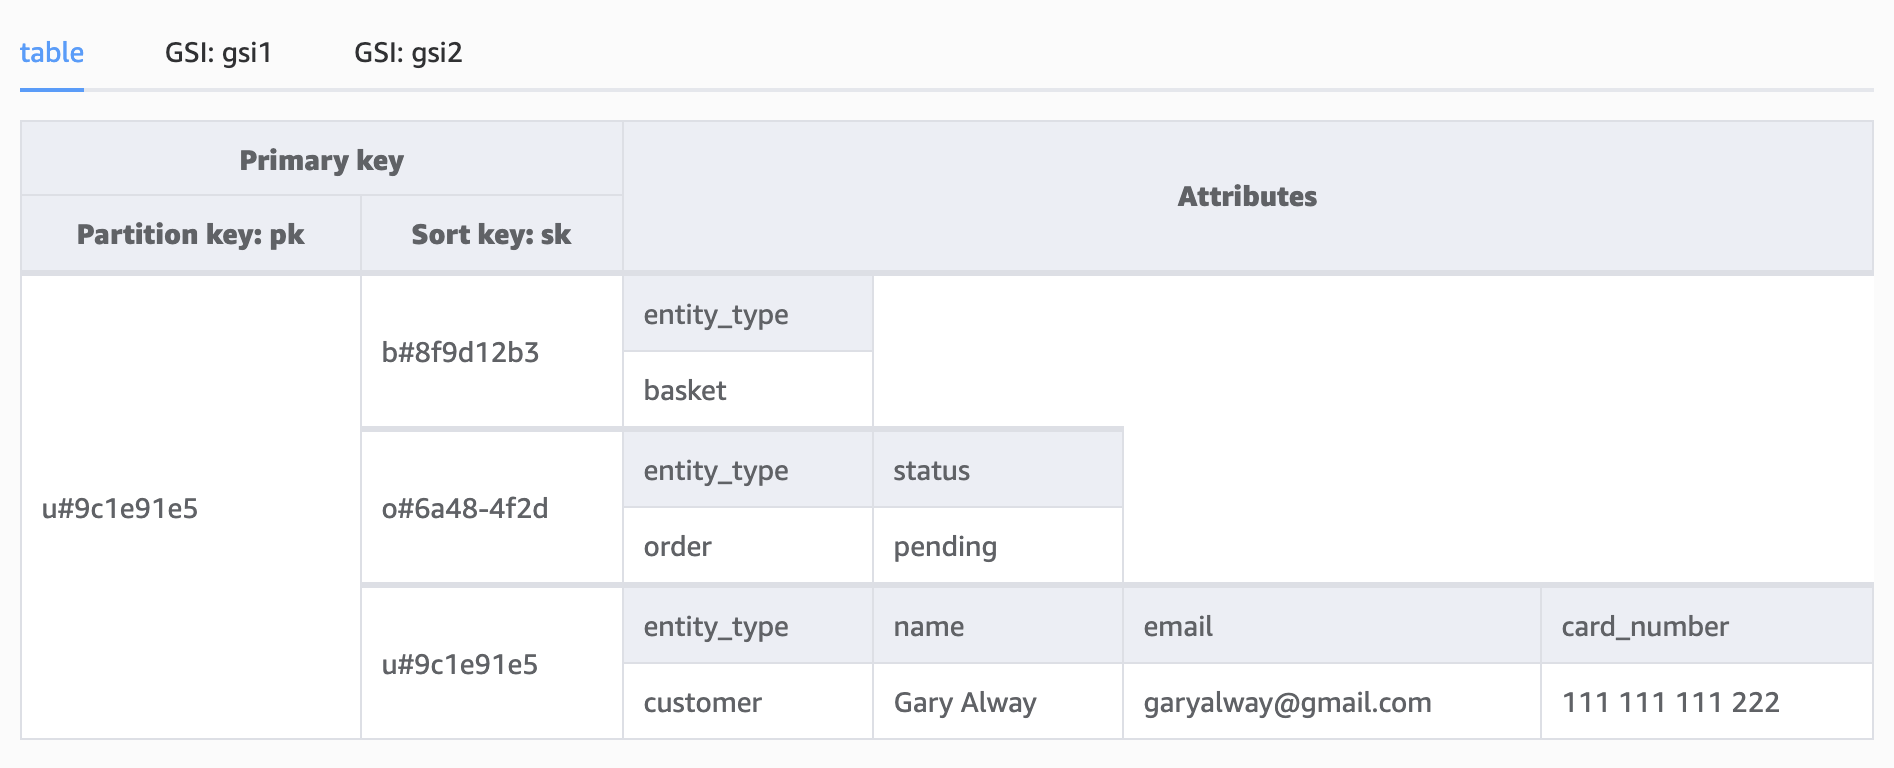
Giờ đây chúng ta có thể truy vấn cả ba bản ghi bằng một lệnh, truy vấn toàn bộ phân vùng của khách hàng đó:
export const getAllCustomerRecords = async (id: string) =>
  dynamoClient
    .query({
      TableName: TABLE_NAME,
      KeyConditionExpression: "pk=:pk",
      ExpressionAttributeValues: {
        ":pk": valueToAttributeValue(addPrefix(id, CUSTOMER_PREFIX)),
      },
    })
    .then((result) => result.Items);
Khi bảng lớn dần, kiểu truy vấn này có thể không tối ưu nhất vì nó sẽ trả về mọi đơn hàng khách hàng từng đặt, cùng với tất cả bản ghi khác như giỏ hàng và hóa đơn, nhưng điều quan trọng là biết rằng chúng ta có thể truy cập toàn bộ dữ liệu khách hàng trong một truy vấn khi cần.
Chỉnh nhẹ các giá trị thuộc tính biểu thức để bao gồm khớp một phần (begins_with) trên sort key sẽ cho phép truy vấn:
Điều quan trọng cần rút ra là cách chúng ta mô hình hóa quan hệ một-một và một-nhiều trong NoSQL.
Các thực thể này thể hiện một quan hệ một-nhiều khác, nơi một danh mục có thể chứa nhiều sản phẩm.
Danh mục cũng có quan hệ phân cấp, nơi một danh mục có thể có nhiều danh mục con, nghĩa là sản phẩm có thể tồn tại ở bất kỳ đâu trong cây phân cấp danh mục.
Hãy mô hình điều này với sách được chia thành hư cấu và phi hư cấu.
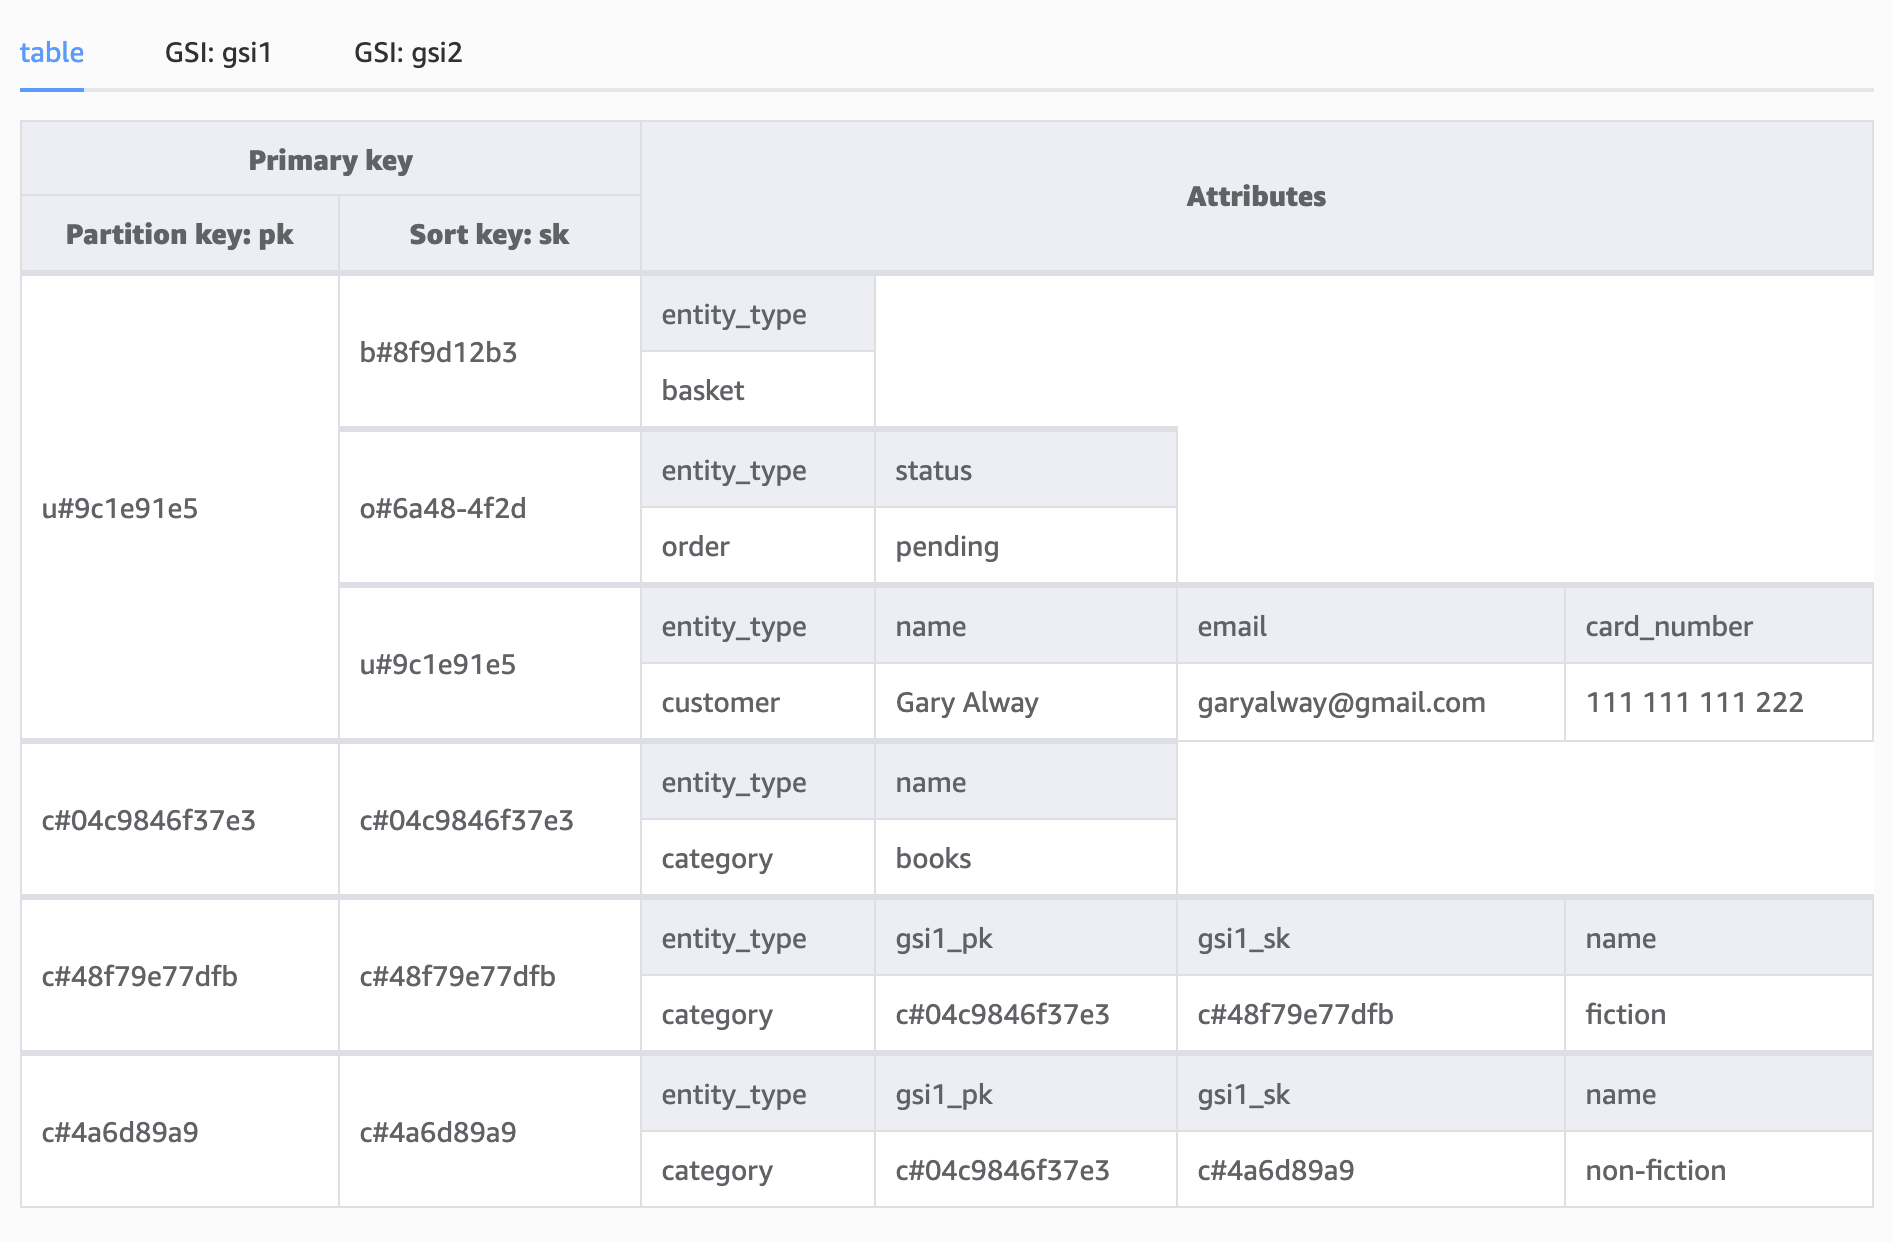
Lưu ý cách chúng ta điền các khóa thuộc tính GSI cho danh mục con, đặt GSI1_PK là ID danh mục cha và GSI1_SK là ID danh mục con. Điều này cho phép truy vấn tất cả danh mục con theo danh mục bằng GSI1:
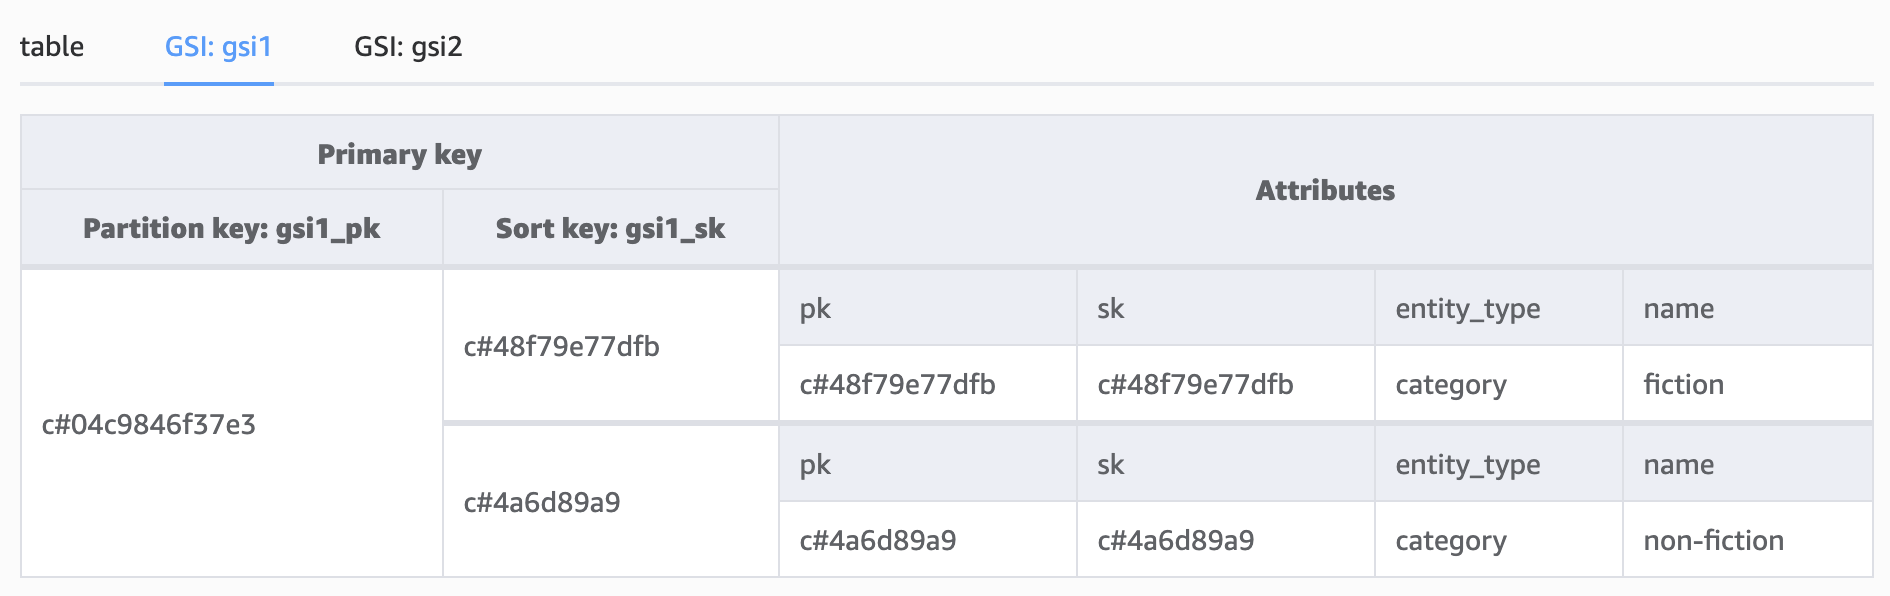
Chỉ mục GSI1 tương tự không chỉ dùng để ánh xạ quan hệ một-nhiều. Ví dụ, giả sử chúng ta muốn tra cứu khách hàng theo email; mô hình hiện tại không hỗ trợ trực tiếp trừ khi ta thay đổi nhẹ cách lưu dữ liệu:
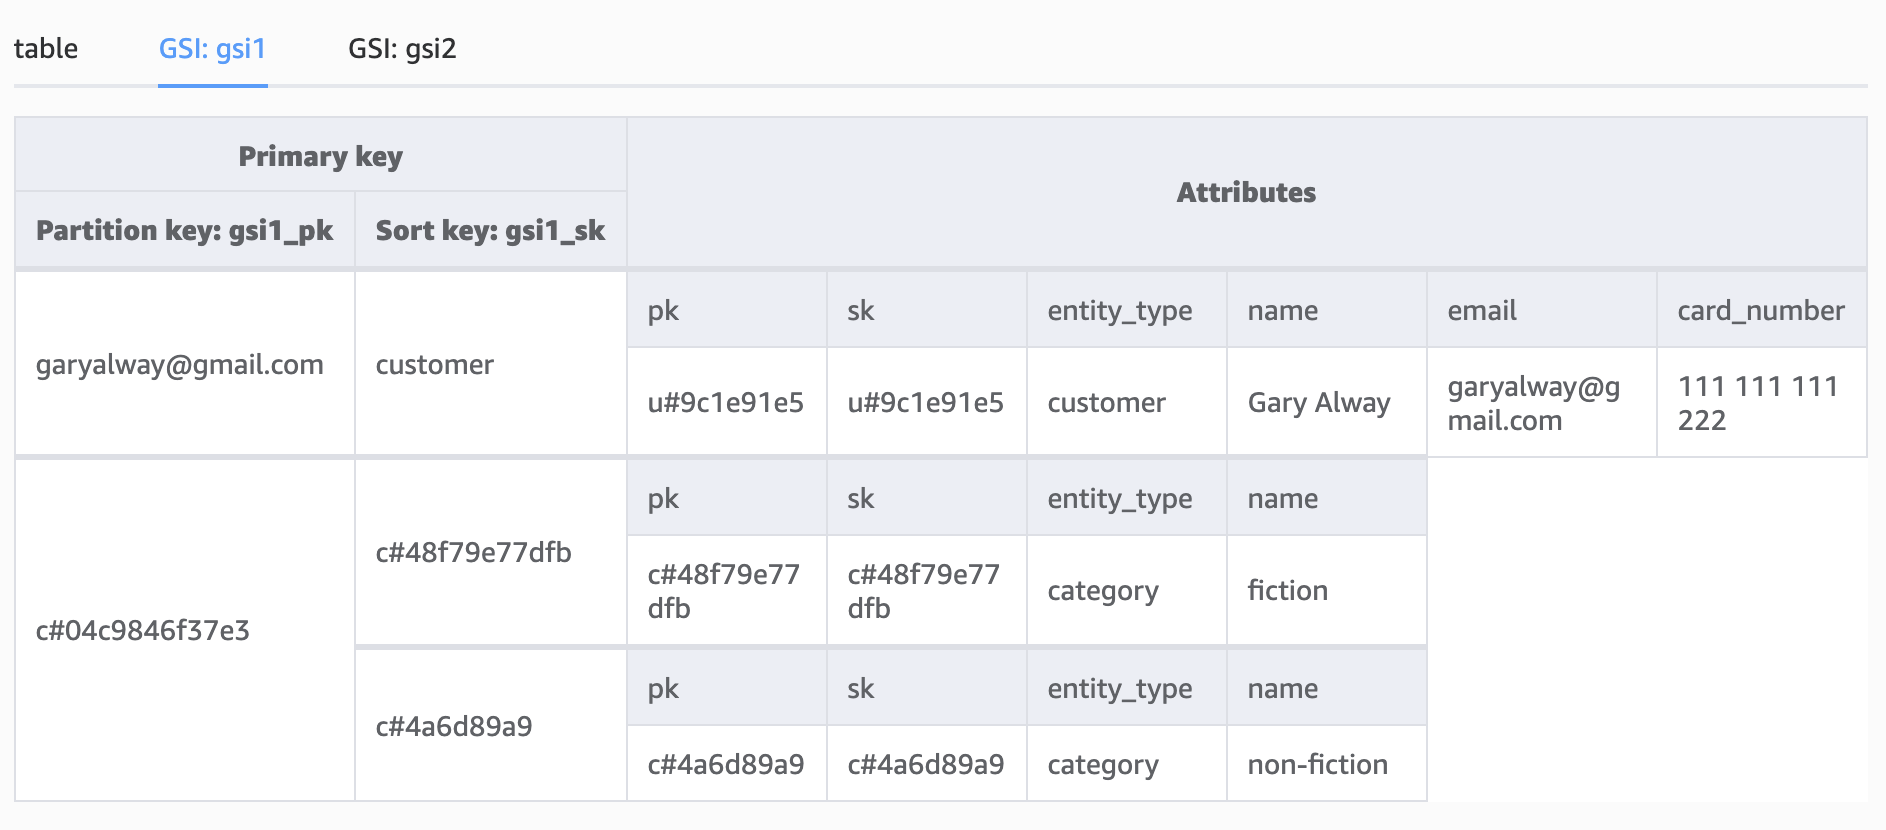
Lưu địa chỉ email khách hàng và kiểu thực thể làm GSI PK và SK;
Để hỗ trợ phân phối dữ liệu trong DynamoDB, ta có thể tiến thêm một bước bằng cách lưu địa chỉ email dưới dạng băm.
export const getCustomerByEmail = async (email: string) =>
  dynamoClient
    .query({
      TableName: TABLE_NAME,
      IndexName: "gsi1",
      KeyConditionExpression: "gsi1_pk = :email AND gsi1_sk = :entityType",
      ExpressionAttributeValues: {
        ":email": valueToAttributeValue(email),
        ":entityType": valueToAttributeValue(entityType),
      },
    })
    .then(({ Items }) => Items?.[0]);
Đến giờ, có thể bạn thắc mắc vì sao mọi chỉ mục đều có tên chung chung với các thuộc tính khóa đặt tên chung là PK và SK. Câu trả lời giờ đã rõ: dữ liệu chúng ta lưu và các chỉ mục chúng ta duy trì linh hoạt và có thể hỗ trợ nhiều mẫu truy cập tùy theo kiểu thực thể.
Terraform cho bảng mà chúng ta dùng đến giờ như sau:
resource "aws_dynamodb_table" "tutorial-1" {
  name = "tutorial-1"
  billing_mode = "PAY_PER_REQUEST"
  hash_key = "pk"
  range_key = "sk"


  attribute {
    name = "pk"
    type = "S"
  }


  attribute {
    name = "sk"
    type = "S"
  }


  attribute {
    name = "gsi1_pk"
    type = "S"
  }


  attribute {
    name = "gsi1_sk"
    type = "S"
  }


  attribute {
    name = "gsi2_pk"
    type = "S"
  }


  attribute {
    name = "gsi2_sk"
    type = "S"
  }


  global_secondary_index {
    name = "gsi1"
    hash_key = "gsi1_pk"
    range_key = "gsi1_sk"
    projection_type = "ALL"
  }


  global_secondary_index {
    name = "gsi2"
    hash_key = "gsi2_pk"
    range_key = "gsi2_sk"
    projection_type = "ALL"
  }
}
Lưu trữ sản phẩm theo mô hình một-nhiều tương tự, trong đó khóa phân vùng là ID danh mục và sort key là ID sản phẩm:
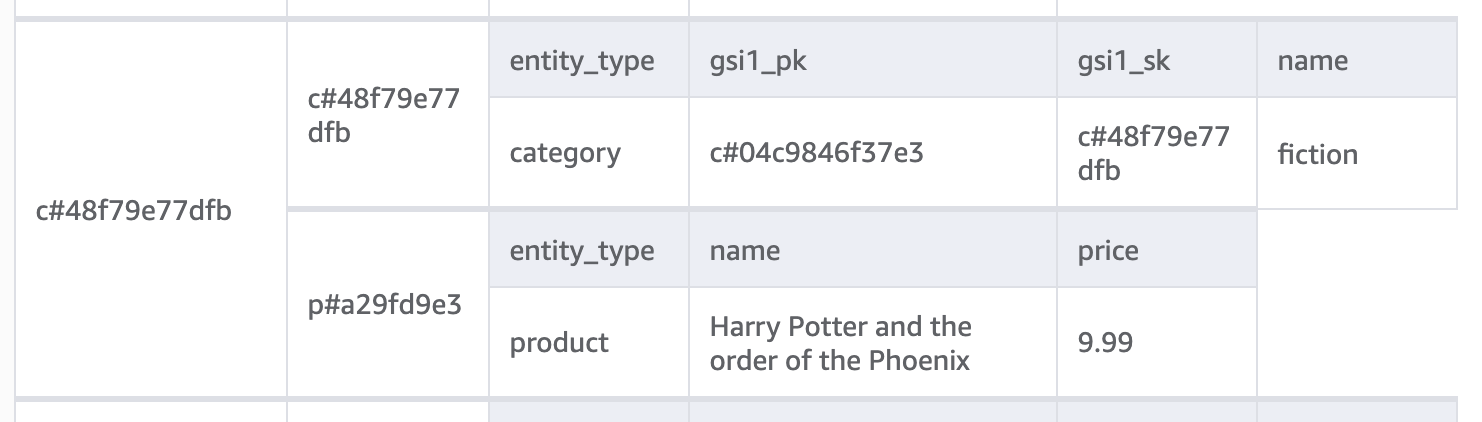
Thêm danh mục cha vào GSI1 cho phép chúng ta truy vấn tất cả sách trong cơ sở dữ liệu:
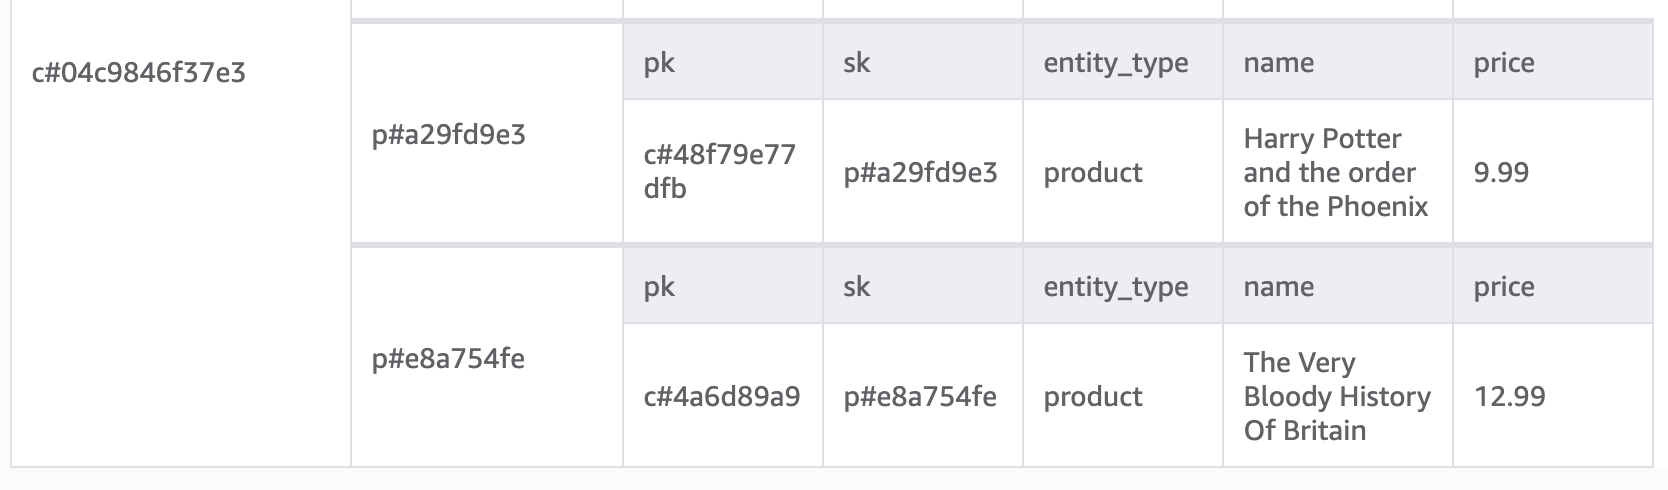
Trong ứng dụng sản xuất, chúng ta có thể dùng DynamoDB streams để đẩy dữ liệu sang cụm Elasticsearch, cho phép tìm kiếm theo tiêu đề sách, nhưng với mô hình hiện có, làm sao truy vấn theo tiêu đề sản phẩm?
Chúng ta đã dùng GSI1, vậy có thể dùng GSI2 cho việc này:
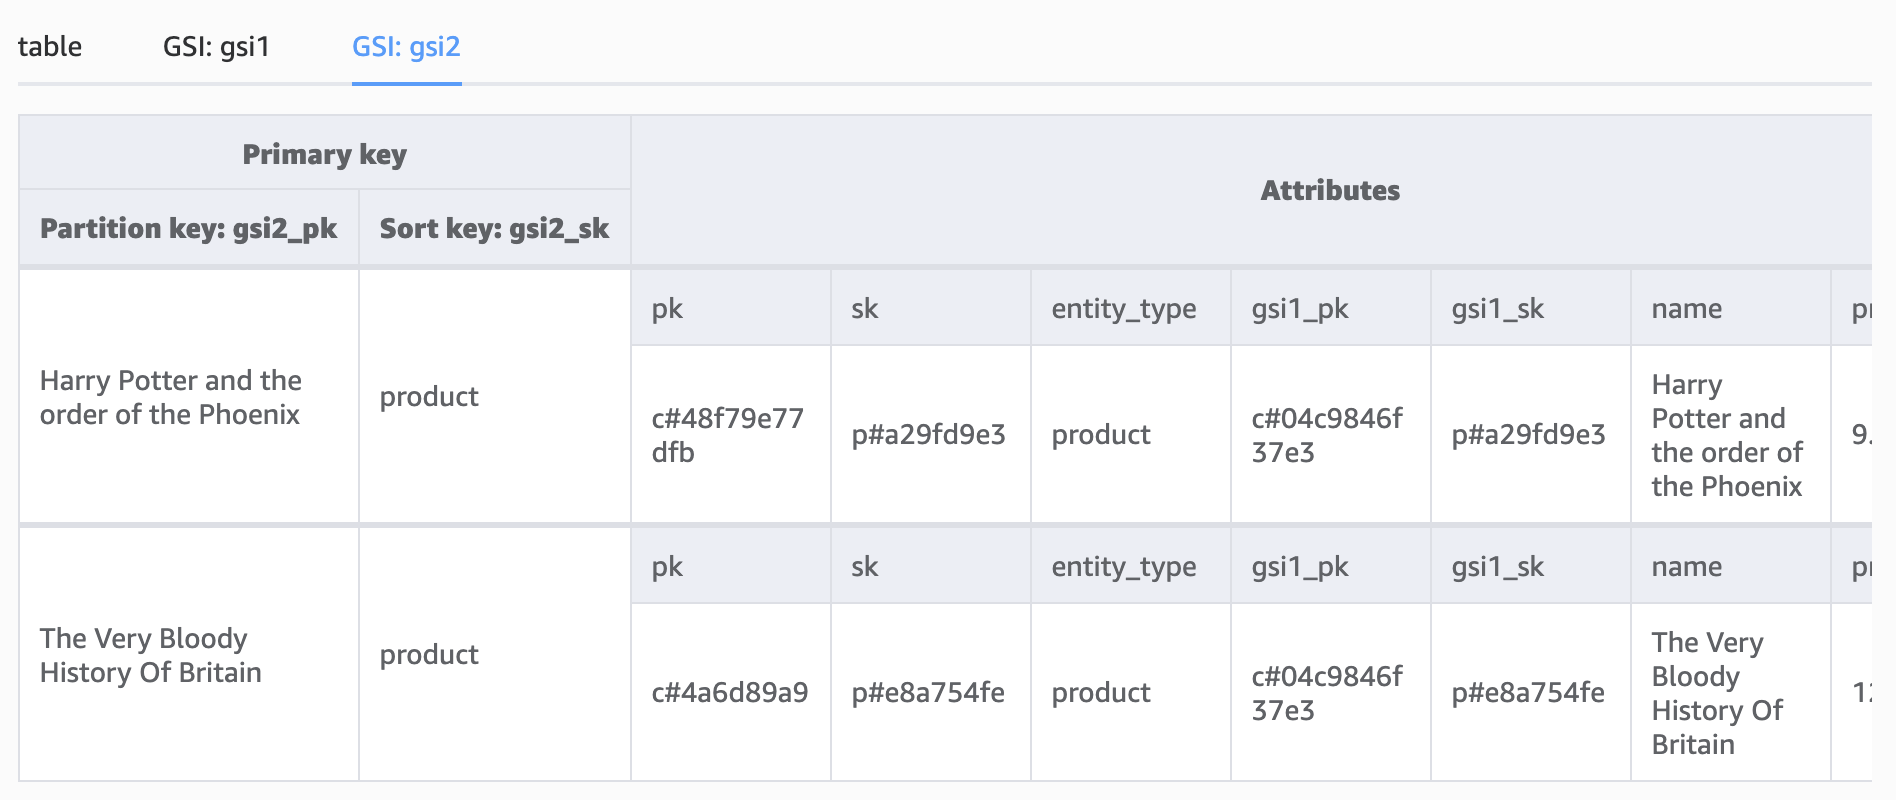
Hãy nhớ rằng khi truy vấn DynamoDB, bạn cần cung cấp đầy đủ khóa phân vùng chính xác; nên dù cách triển khai này có thể không tối ưu nhất, nó minh họa cách ba chỉ mục có thể được dùng cho các mẫu truy cập khác nhau.
Trong hướng dẫn tiếp theo, tôi sẽ minh họa cách giải quyết bằng cách tích hợp với chỉ mục tìm kiếm.
Cả mặt hàng trong giỏ và dòng đơn hàng đều được lưu trong phân vùng khách hàng; chúng ta có thể dùng GSI để truy vấn tất cả sản phẩm trong một giỏ, tất cả sản phẩm trong một đơn hàng và toàn bộ sản phẩm mà một khách hàng từng đặt.
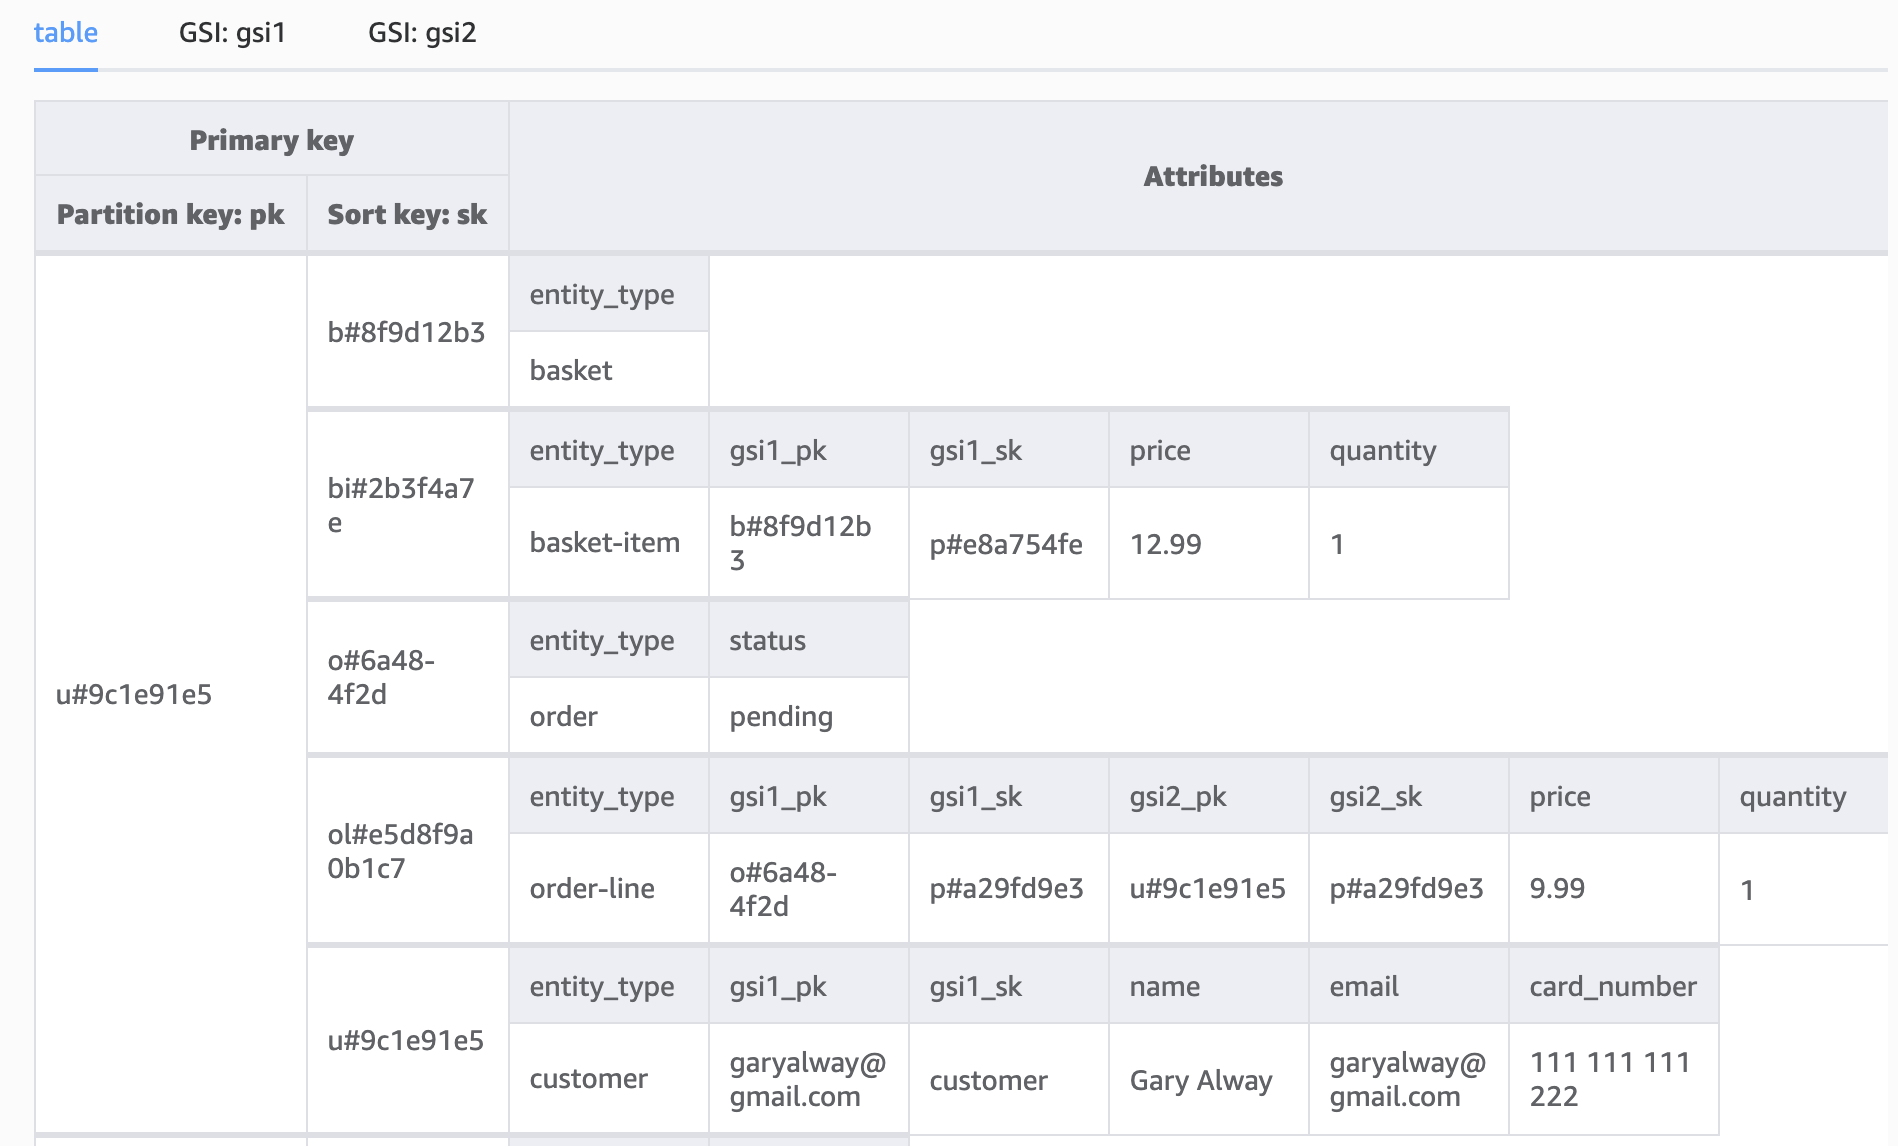
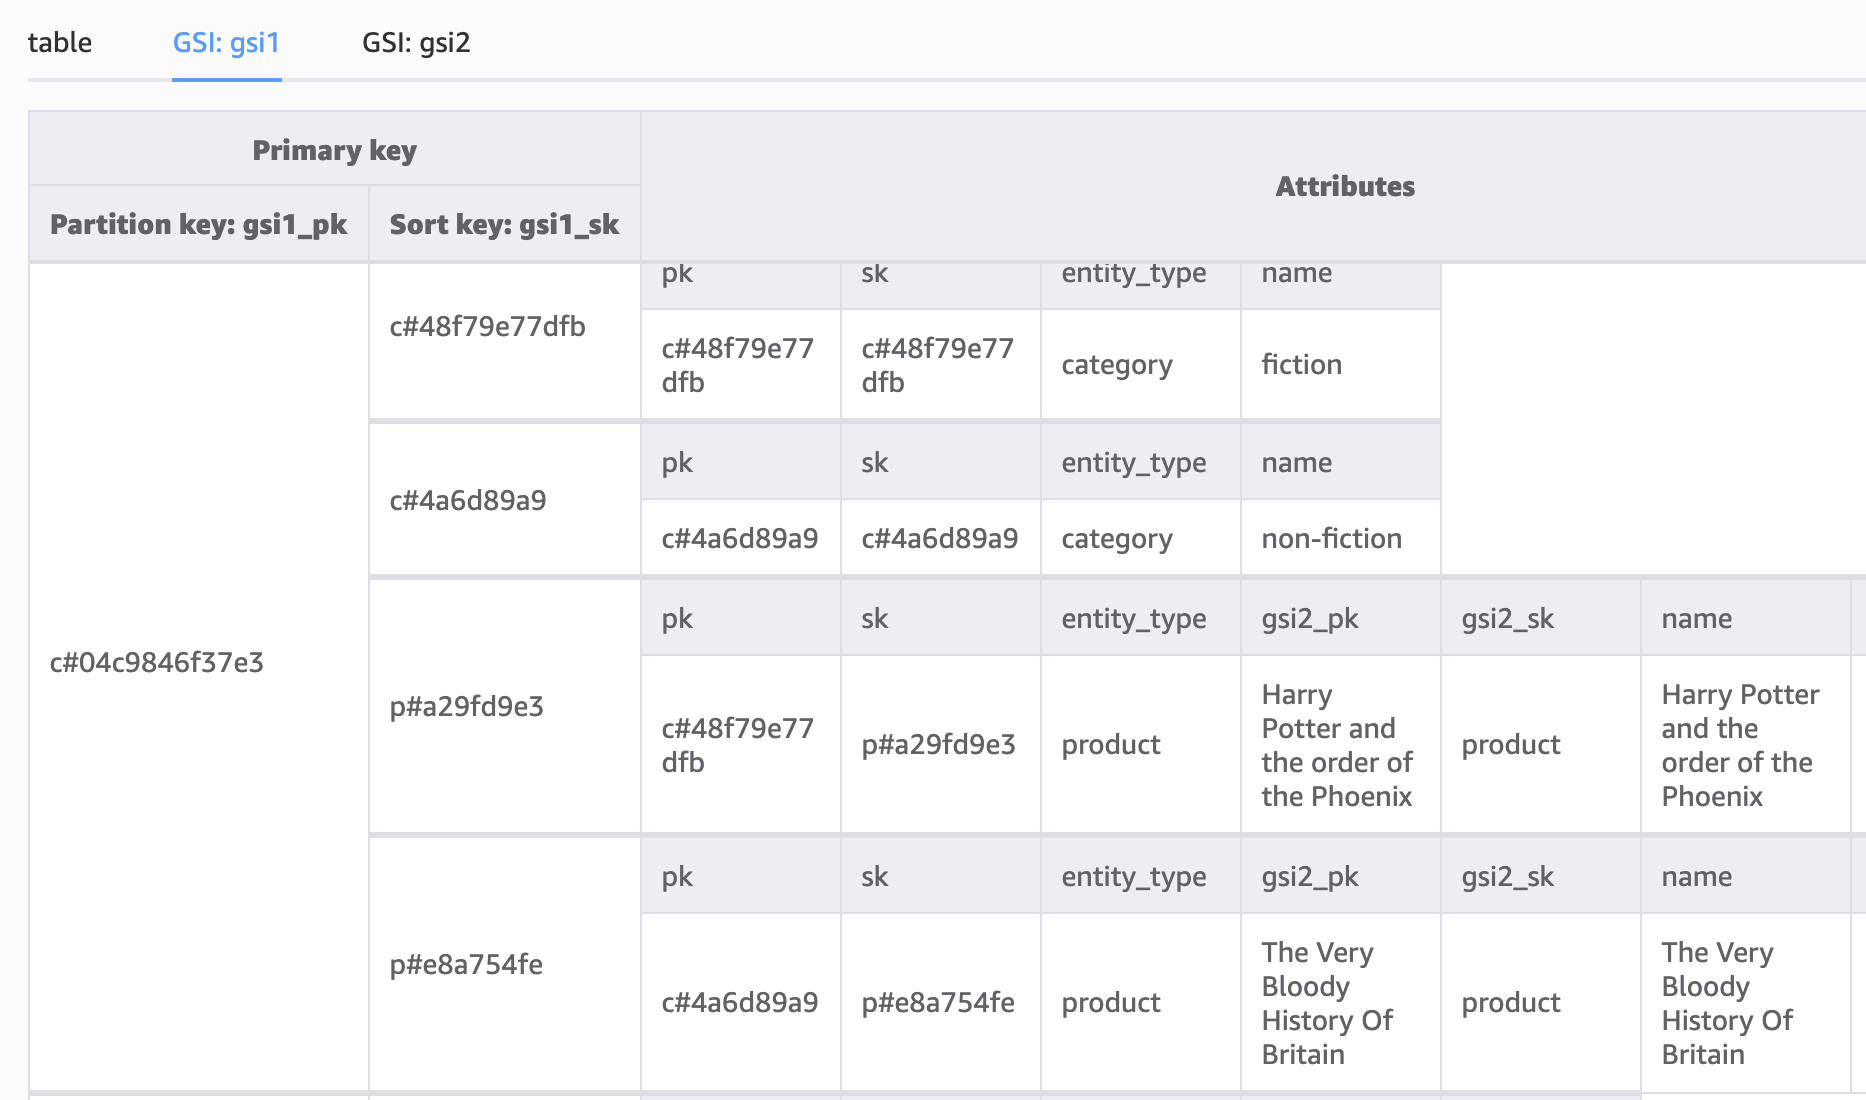
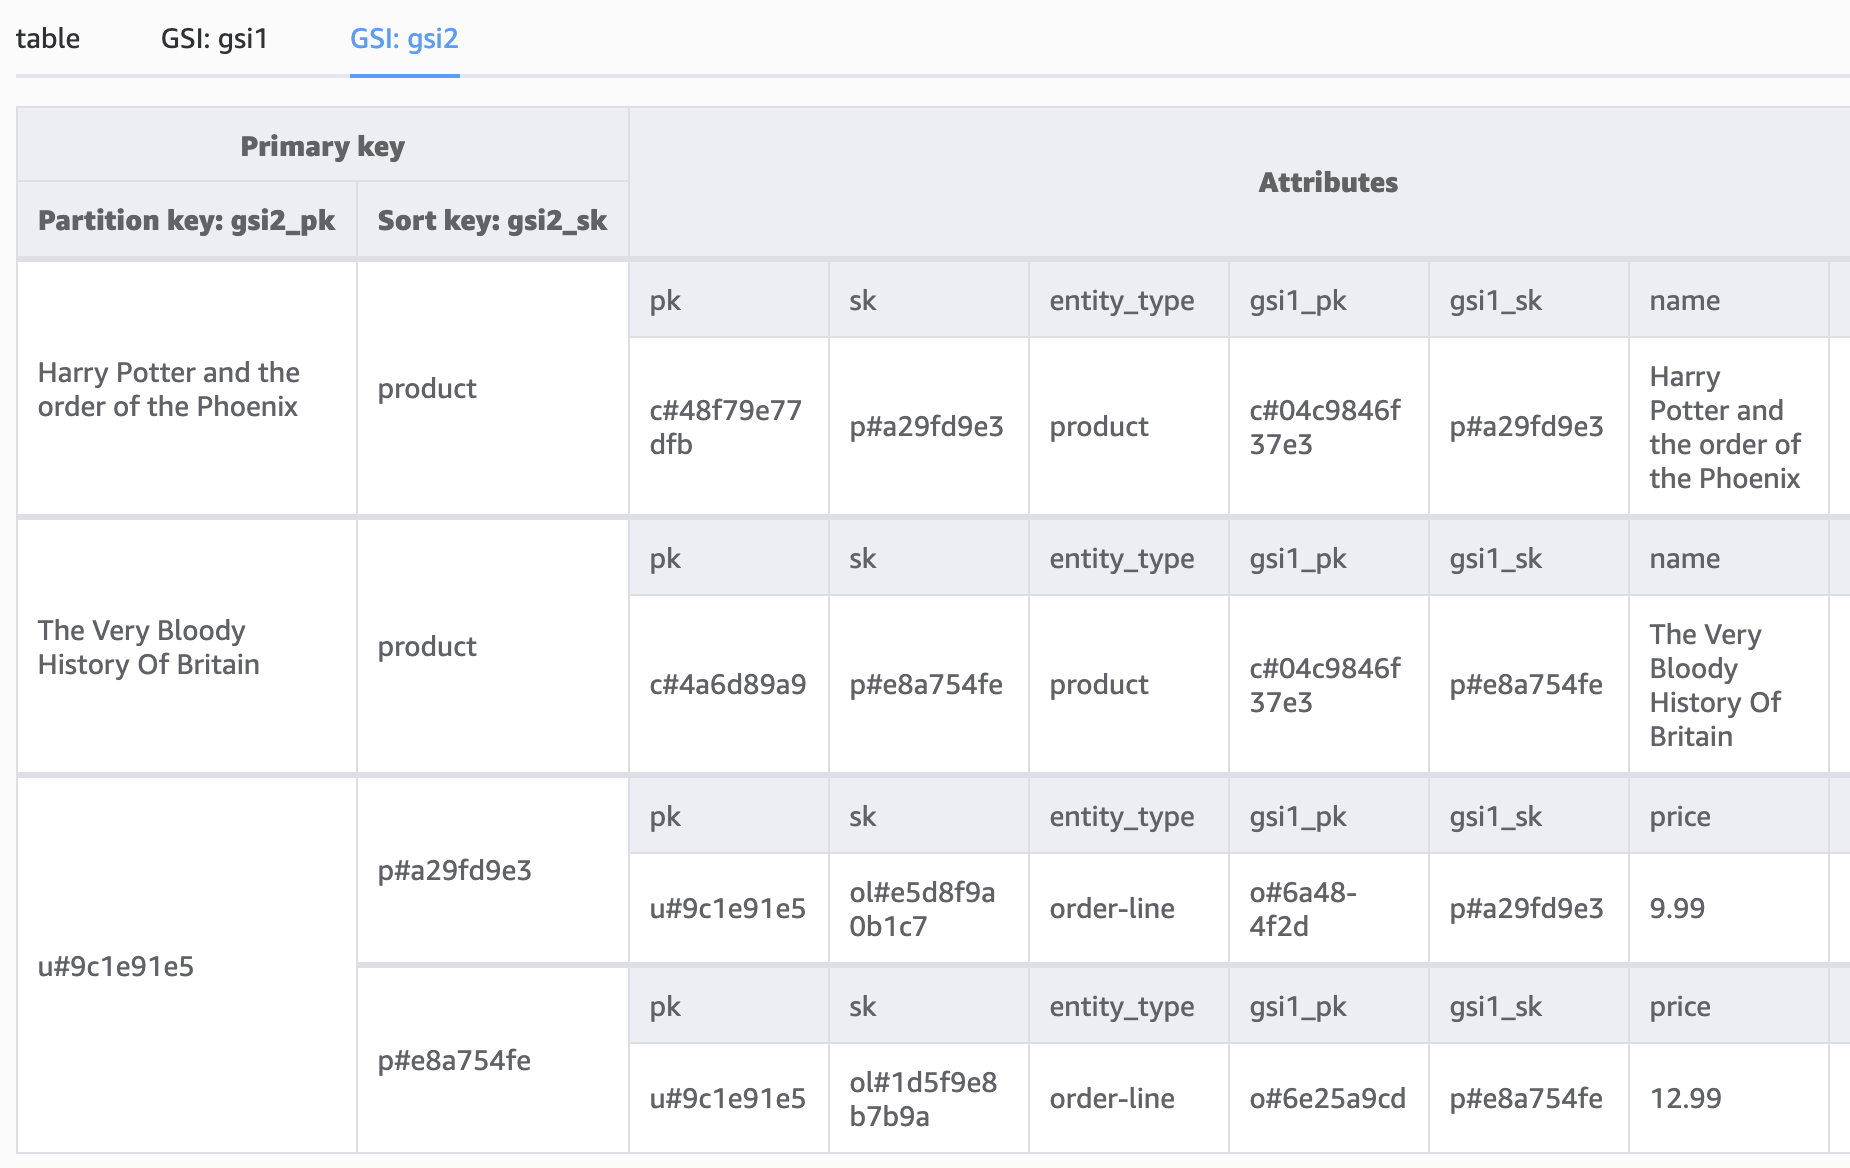
Ví dụ cuối cùng này hiển thị lịch sử đơn hàng của một khách với hai sản phẩm thuộc hai ID đơn hàng khác nhau.
Với những ai quan tâm cách mô hình hóa dữ liệu trong cơ sở dữ liệu SQL, hội thảo Data Modeling in SQL của chúng tôi mang đến các góc nhìn giá trị bổ trợ cho việc hiểu mô hình hóa dữ liệu NoSQL.
Dùng thiết kế bảng đơn với DynamoDB mang lại nhiều lợi thế, nhưng cũng đi kèm không ít thách thức và cân nhắc:
Quản lý toàn bộ dữ liệu trong một bảng có thể trở nên phức tạp, đặc biệt khi ứng dụng phát triển và thay đổi.
Bạn phải lên kế hoạch và cấu trúc dữ liệu cẩn thận để đáp ứng các mẫu truy vấn khác nhau. Bên cạnh đó, hiệu quả của thiết kế bảng đơn gắn chặt với logic ứng dụng; nó đóng vai trò then chốt để đảm bảo truy cập dữ liệu trơn tru và xử lý truy vấn hiệu quả.
Cân nhắc kỹ cả cấu trúc dữ liệu lẫn logic ứng dụng là điều thiết yếu để thiết kế bảng đơn hoạt động hiệu quả.
Dù DynamoDB cho phép Global Secondary Index để hỗ trợ các mẫu truy vấn khác nhau, bạn cần cấp phát và duy trì các chỉ mục này, có thể làm tăng chi phí và độ phức tạp.
Chọn đúng khóa phân vùng là tối quan trọng cho phân phối dữ liệu đồng đều và hiệu năng truy vấn. Lựa chọn khóa không phù hợp có thể dẫn đến phân vùng nóng và nghẽn hiệu năng.
Khi khối lượng dữ liệu tăng, bảng đơn của bạn có thể phình to đáng kể. Điều này ảnh hưởng đến cả chi phí lưu trữ và chi phí đọc/ghi dữ liệu.
DynamoDB không hỗ trợ tìm kiếm toàn văn một cách gốc, nên để triển khai chức năng này cần tích hợp với các dịch vụ khác như Elasticsearch.
Thay đổi schema bảng có thể khó khăn, đặc biệt trong hệ thống sản xuất. Bạn có thể cần di chuyển dữ liệu hiện có hoặc chỉnh sửa logic ứng dụng để đáp ứng thay đổi schema.
Tùy lựa chọn nhất quán đọc (mạnh hay cuối cùng), bạn có thể cần tính đến thách thức về tính nhất quán dữ liệu, lưu ý rằng GSI được sao chép không đồng bộ.
Khả năng truy vấn của DynamoDB mạnh mẽ nhưng không linh hoạt bằng truy vấn SQL.
Để hiểu rõ hơn cách thiết kế cơ sở dữ liệu hiệu quả và xử lý các thách thức liên quan, hãy xem khóa học Thiết kế Cơ sở dữ liệu của chúng tôi.
Khi làm việc với cơ sở dữ liệu NoSQL, điều tối quan trọng là thoát khỏi vùng quen thuộc của các mẫu thiết kế cơ sở dữ liệu quan hệ; bạn phải “học lại từ đầu”.
Chọn mô hình thiết kế bảng đơn hứa hẹn một cơ sở dữ liệu có thể mở rộng toàn cầu, sẵn sàng xử lý lưu lượng lớn với hiệu năng đáng tin cậy và có thể dự đoán.
Tuy nhiên, lợi thế hiệu năng này không miễn phí; nó đòi hỏi lập kế hoạch tỉ mỉ và triển khai thận trọng cấu trúc cơ sở dữ liệu và logic ứng dụng ngay từ đầu.
Tiếp tục nâng cao kiến thức với khóa học Các khái niệm NoSQL của chúng tôi!
Bắt đầu Hành trình Dữ liệu của bạn ngay hôm nay!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
