Kurs
NoSQL Kavramları
2 sa
19.3K
Verimlilik ve sınırsız ölçeklenebilirliğin tek bir tabloda birleştiği DynamoDB dünyasına hoş geldiniz. Bu kapsamlı eğitimde, NoSQL tek tabloluk veritabanı tasarımının gerçek potansiyelini ortaya çıkaracağımız güçlendirici bir yolculuğa çıkıyoruz.
Sürekli büyüyen ihtiyaçlarınızı zahmetsizce karşılayabilen birleşik bir yapının tüm gücünden yararlanırken, karmaşık veri modellerini sadeleştirme sanatını keşfedin.
İster NoSQL veritabanlarında deneyimli bir geliştirici olun ister veritabanı yolculuğunuza yeni başlıyor olun, güçlü bir veri mimarisi ile uygulamalarınız için yeni bir ölçeklenebilirlik seviyesinin kilidini açmaya hazır olun!
Başlamadan önce, NoSQL ile ilişkisel veritabanı arasındaki farkı, her birini hangi senaryolarda kullanacağımızı ve bu teknolojilerin neden icat edildiğini anlamak önemlidir. Bu da veri işleme tarihine kısa bir bakış gerektirir.
NoSQL veritabanlarının veri bilimindeki önemini ayrı bir blog yazısında daha detaylı okuyabilirsiniz.
İlişkisel veritabanı, 1970’lerden beri bilinen ve yaygın olarak kullanılan bir teknolojidir. Çözdüğü iki temel sorun depolama ve başvuru bütünlüğüdür.
Veriler tipik olarak 3. normal forma kadar “normalize edilir”; bu, veri ayak izinin boyutunu azaltırken aynı zamanda verilerde yapılan güncellemelerin geri kalan verilerle tutarlı kalmasını sağlar.
Kalıcı veri ayak izinin boyutu kritik öneme sahipti çünkü geçmişte veri merkezindeki en pahalı bileşen sabit diskti. Bugün artık durum böyle değil; artık en pahalı bileşen CPU ve veri depolama maliyeti dramatik biçimde azaldı. Bu, ilişkisel veritabanının modasının geçtiği anlamına gelmez; şu uygulamalar için hâlâ geçerli kullanım alanları vardır:
Veri baskısı, bir sistemin belirli bir veri miktarını makul maliyet ve/veya sürede işleyebilme yeteneğidir.
NoSQL veritabanları, uygulama verisi hacimlerinin durmaksızın artması nedeniyle ilişkisel veritabanı performansını etkileyen veri baskısı sorunlarını gidermek için 1990’ların sonlarında geliştirildi.
İlişkisel veritabanında CPU, uygulamaların genellikle tükettiği denormalize görünümleri elde etmek için normalize verileri getirme ve birleştirme çabası sırasında başlıca darboğazlardan biri olarak görülebilir.
Okuma kopyaları ekleyerek bu durum hafifletilebilir, ancak NoSQL farklı bir yaklaşım benimser ve uygulama verilerini, uygulamaların tüketime hazır olduğu denormalize biçimde saklar. Bu, veri ayak izinin ilişkisel veritabanına göre daha büyük olduğu, ancak CPU üzerindeki yükü azalttığı anlamına gelir; veritabanı sunucusunu, veri merkezindeki sabit diskteki bir konumu işaret etmek için bir karma algoritması kullanan basit bir yönlendiriciye dönüştürür. NoSQL veritabanlarının tipik kullanım alanları şunlardır:
Çok sayıda çalışma, ölçek düzeyinde SQL ve NoSQL performansını gösteren bir grafiği sunmamıza yetecek kadar nesnel veri sağlamıştır.
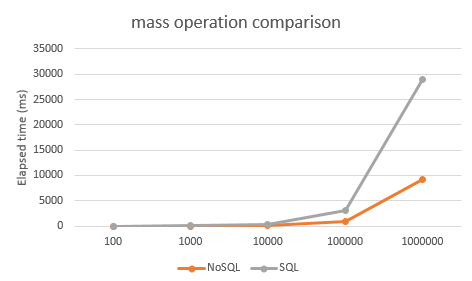
Altını çizmemiz gereken son nokta, NoSQL veritabanında depolanan verilerin hâlâ ilişkisel veriler olduğudur. Veriler ilişkisel olmasaydı, basit bir dosya deposunda saklardık.
Bir NoSQL veritabanını, ilişkisel veritabanını modellediğimiz şekilde modellemeyiz; bu nedenle, normalize bir tasarımı doğrudan birden çok tabloyu birleştirerek NoSQL’e aktarmak bir anti-pattern’dır; çünkü NoSQL’de join işleci ya da başvuru bütünlüğü yoktur.
NoSQL’de bir tablo, ilişkisel veritabanındaki bir katalogla eşdeğerdir. Bunun yerine, verileri denormalize şekilde, uygulamalar tarafından tüketime hazır olarak modelleyin.
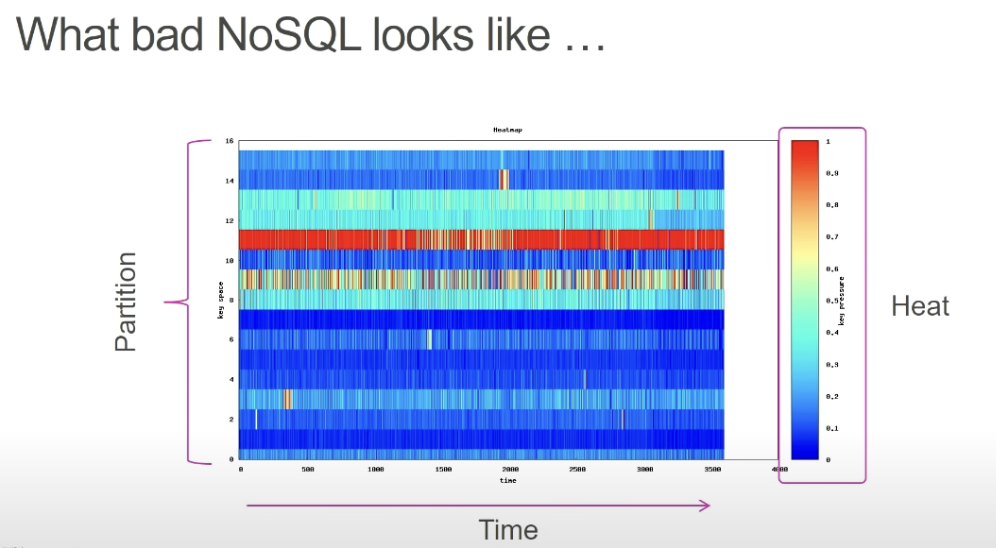
Bir diğer anti-pattern ise Sıcak Anahtarlar (Hot Keys)’dır. Bu, erişim isteklerinin çoğunun bir tek depolama düğümüne isabet etmesi, dolayısıyla anahtar alanının doğru tasarlanmamış olması anlamına gelir.
Erişim ısı haritası aşağıdakine benzer görünecektir:
AWS DynamoDB, tamamen yönetilen, sunucusuz, geniş sütunlu bir anahtar-değer deposudur; bu, bir tabloda çok sayıda öğeyi (veya satırı) desteklediği, ancak bu öğelerin aynı özniteliklere sahip olmak zorunda olmadığı anlamına gelir. Desteklenen veri türleri şunlardır:
Daha önce belirtildiği gibi, NoSQL uygulama erişim desenleri iyi biliniyorsa ve yüksek TPS ihtiyacı varsa kullanılmalıdır. DynamoDB her iş yüküne ölçeklenebilir ve düşük gecikmeyle (10 - 20 ms) 4 milyon TPS’ye kadar öngörülebilir şekilde hızlı ve tutarlı yanıt süresi sunar.
Her öğenin (veya satırın) o öğeyi benzersiz şekilde tanımlayan ve altta yatan depolama üzerindeki veri dağılımını belirleyen bir bölüm anahtarı vardır.
Öğelerin isteğe bağlı olarak, bir bölüm içinde diske hangi sırayla yazılacağını belirleyen bir sıralama anahtarı olabilir. Sıralama anahtarları, bölümleri karmaşık aralık ve filtre işlemleriyle sorgulamamıza olanak tanır (ancak filtre işlemleri veritabanı katmanında değil istemci katmanında uygulanır).
Bölüm anahtarı kullanılarak bir karma dizini oluşturulur ve ardından her öğe, bu karma değerine göre sanal bir anahtar alanına yerleştirilir. Bu sanal anahtar alanı, depolanan veri hacmine bağlı olarak dinamik biçimde büyüyüp küçülebilen fiziksel depolama aygıtlarına eşlenen segmentlere bölünür.
DynamoDB’nin her ölçekte hızlı ve tutarlı olmasının nedeni budur: veritabanı motoru, karma anahtarlardan fiziksel depolamaya yönlendirme hizmeti olarak davranır.
Bu eğitimde, Daintree.com adlı bir çevrim içi mağazayı modelleyeceğiz.
(Eğlenceli bilgi: Avustralya’nın Queensland eyaletinde bulunan Daintree yağmur ormanı, yaklaşık 180 milyon yaşında olduğu tahmin edilen, Dünya’nın en eski yağmur ormanlarından biridir!)
Önce, neyi modelleyeceğimizi görselleştirebilmek için aşırı sadeleştirilmiş bir varlık-ilişki diyagramı (ERD) oluşturalım.
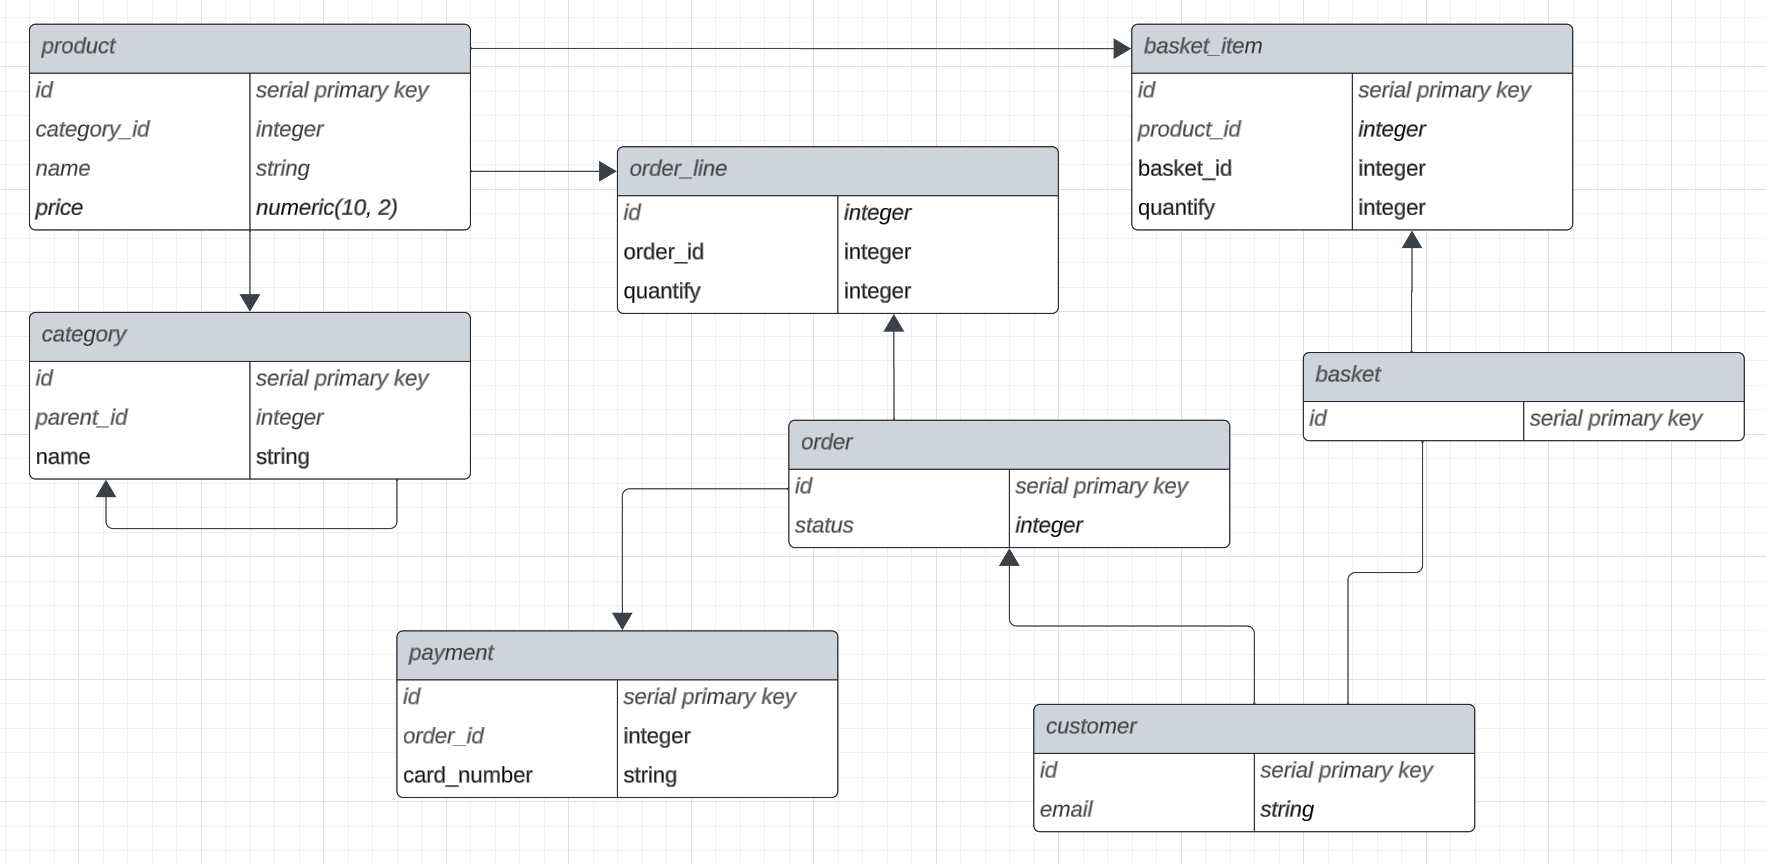
Buradan, bir müşterinin bir alışveriş sepeti oluşturabileceğini ve farklı miktarlarda birden çok ürün ekleyebileceğini çıkarabiliriz.
Bir ürünün bir kategorisi vardır ve bu kategorinin de üst kategorileri olabilir.
Sepetler, çoklu ödemelere bölünebilen siparişlere dönüşebilir.
Daha önce de belirtildiği gibi, bu, çevrim içi alışveriş uygulamasını oluşturan varlıkların ilişki ve özniteliklerine ilişkin aşırı sadeleştirilmiş bir görünümdür; ancak bu eğitim için amacımıza hizmet etmektedir.
İlişkisel bir veritabanı uygularken bu adım için endişelenmemize gerek yoktur. Şema doğru tasarlandığı sürece SQL son derece güçlü bir dildir ve verilerimizi dilediğimiz şekilde sorgulama ve işleme esnekliği sağlar. NoSQL’de tek tablo tasarım deseni kullanırken durum böyle değildir; çünkü verilerimizi denormalize ve uygulamamızın doğrudan tüketeceği şekilde saklamamız gerekir.
İşte çevrim içi alışveriş uygulamamız için desteklemek isteyebileceğimiz erişim desenleri:
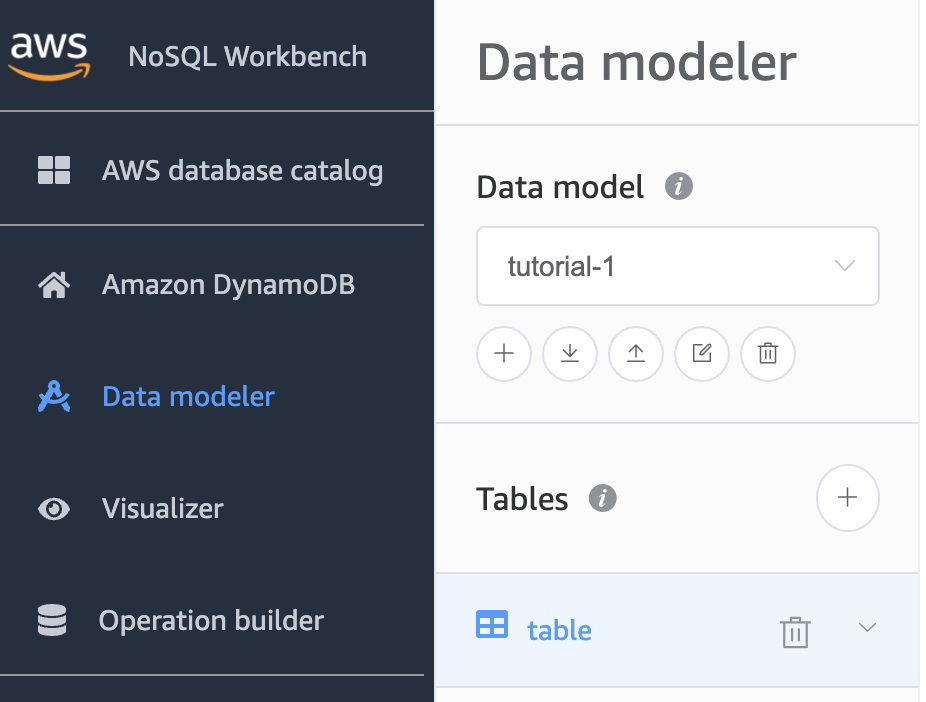
NoSQL workbench, DynamoDB için NoSQL tablolarını modellemek üzere AWS tarafından sağlanan ücretsiz bir araçtır.
Data modeler’a gidin ve yeni bir tabloyla yeni bir veri modeli oluşturun:
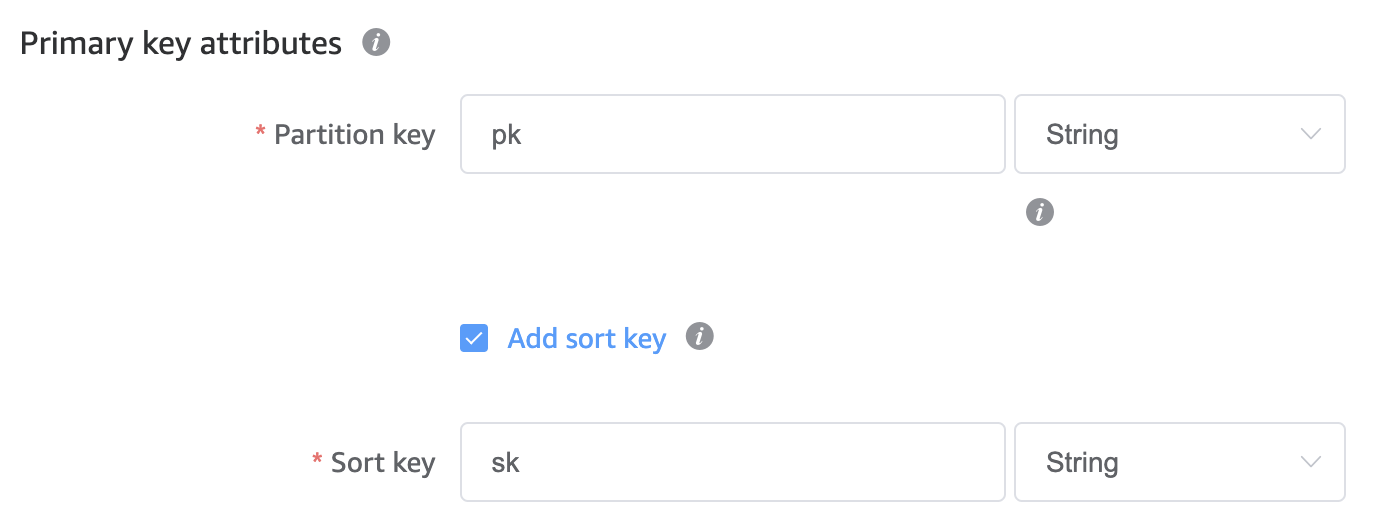
Birincil anahtar özniteliklerini PK ve SK adlı genel stringler olarak tutacağız:
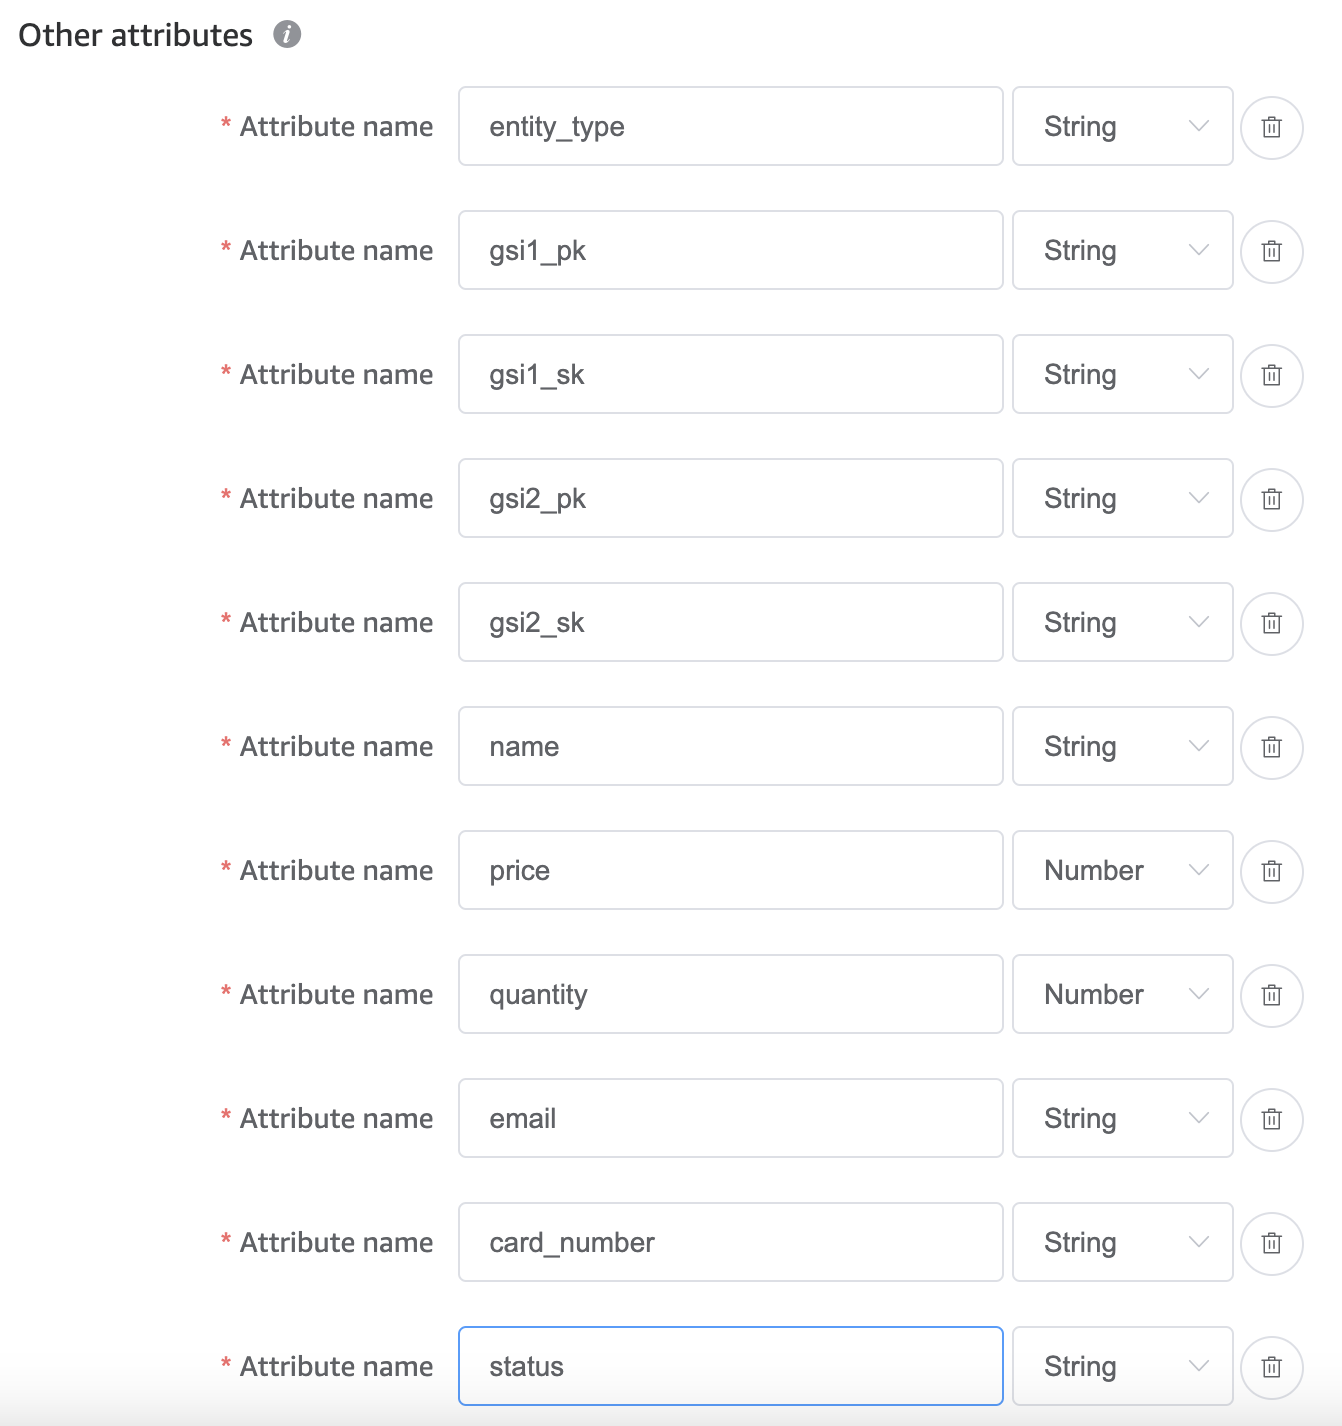
Ek öznitelikler için, entity_type’ı iki GSI PK ve SK birincil anahtar özniteliğiyle birlikte saklayacağız.
GSI, DynamoDB’nin eşzamanlı olmayan şekilde (!!) senkron tuttuğu, ancak alternatif birincil anahtar öznitelik çiftleriyle depolanan tablonuzun bir kopyası olan global ikincil indekstir. Bu, tek bir tablonun birden çok erişim desenini nasıl destekleyebildiğinin temel mekanizmasıdır. Bu konuya daha sonra döneceğiz; şimdilik bu anahtarların, ilişkili varlıkların birincil anahtarlarını saklayacağını anlamanız yeterli.
Eklememiz gereken diğer ek öznitelikler, verilerimizin tüm anahtar olmayan öznitelikleridir (bu adım yalnızca tasarım aşamasında gereklidir ve gerçek tabloyu sağlarken açıkça tanımlanmayacaktır):
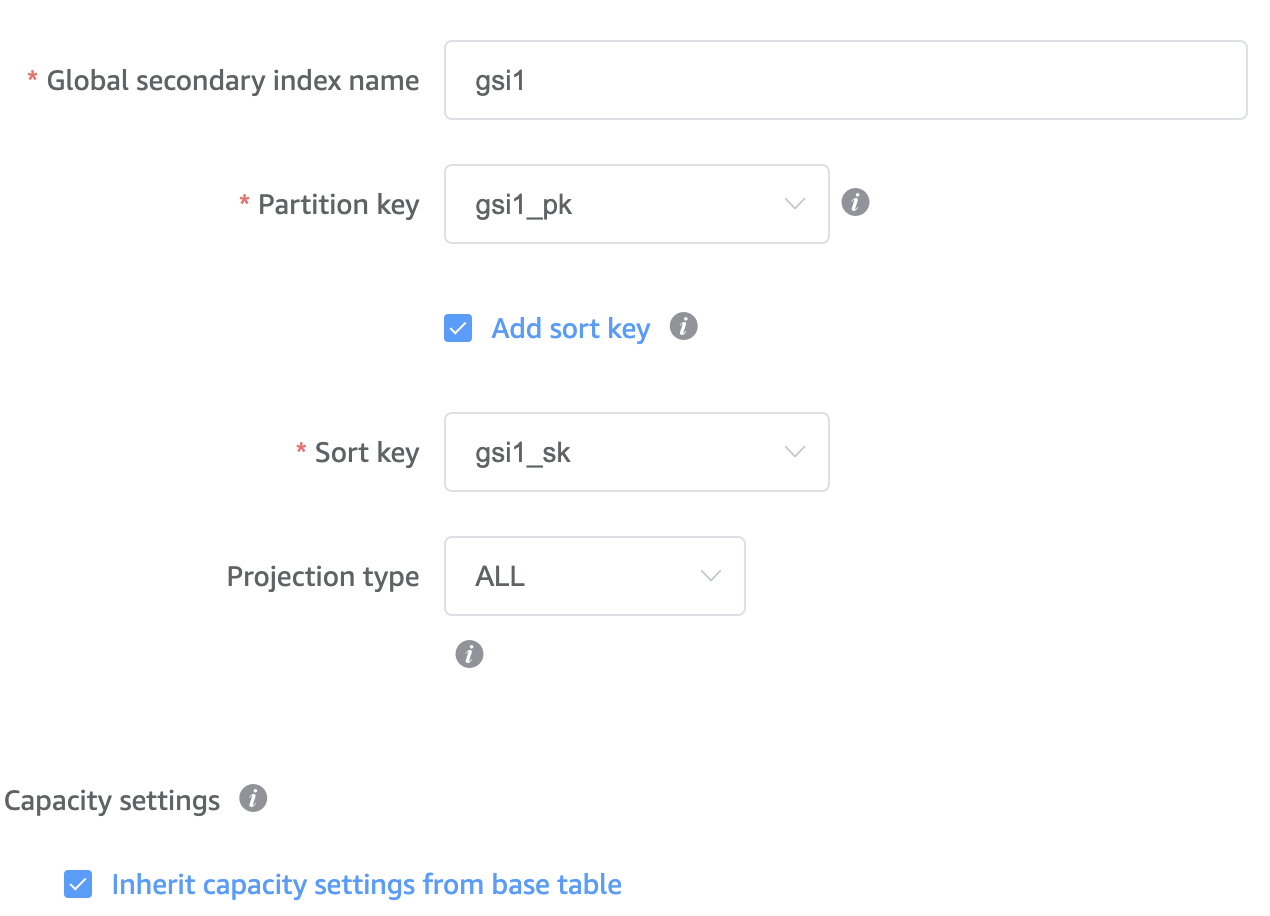
Ardından, önceki adımda tanımladığımız anahtarları kullanarak iki GSI’ı ekleriz:
Kaydedin ve ardından veri modelini görselleştire tıklayın. Artık yeni oluşturduğunuz ancak boş olan tabloyu görmelisiniz. Tabloyu düzenle’ye, sonra sağ üstten verileri düzenle’ye tıklayın; bu, yeni satırlar eklemenizi sağlar:
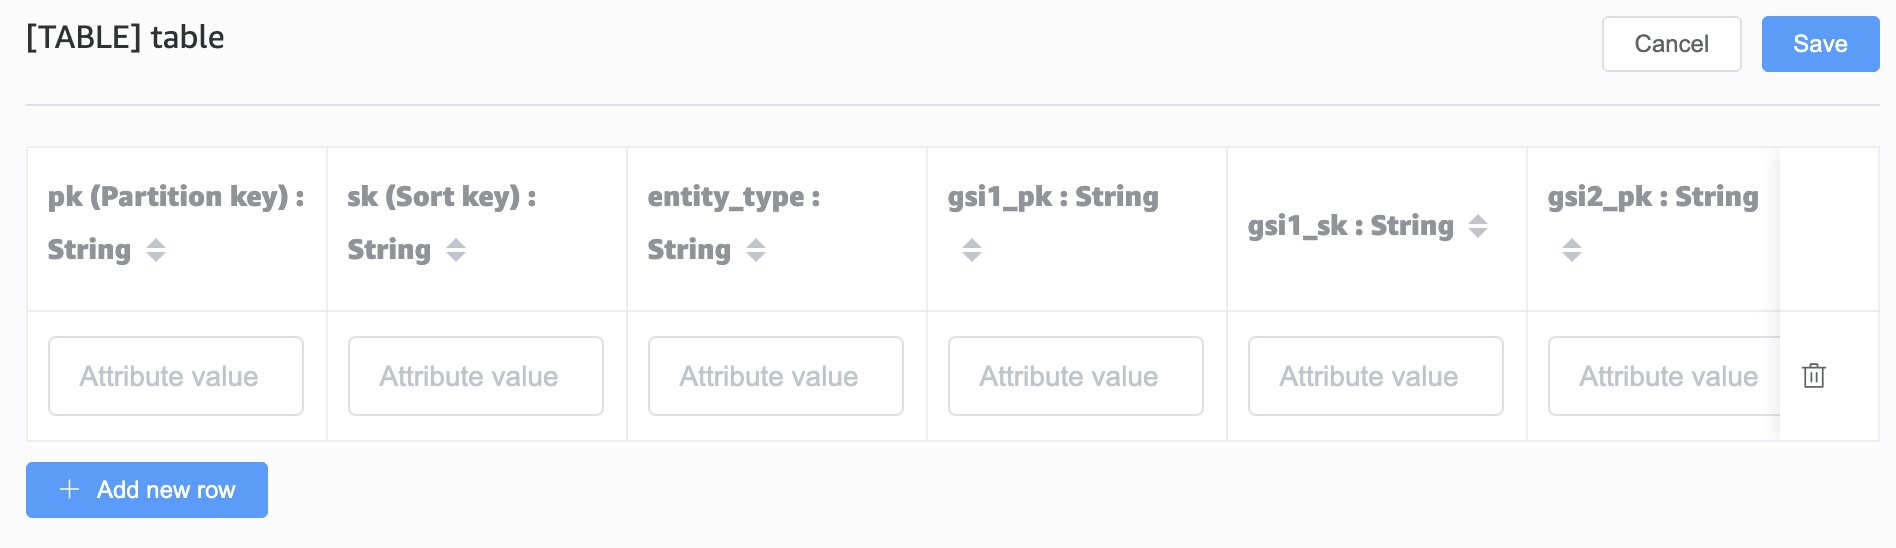
Veri eklemeye başlamadan önce, her varlık için birincil anahtar öneklerimizi tanımlamamız gerekir:
|
product |
p# |
|
category |
c# |
|
customer (user) |
u# |
|
basket |
b# |
|
basket item |
bi# |
|
order |
o# |
|
order line |
ol# |
|
payment |
py# |
|
invoice |
i# |
Erişim desenlerinin çoğu müşteri etrafında döner, bu nedenle birincil indeksimiz için ana bölüm olarak müşteri kimliğini kullanacağız; gerçek müşteri kaydı ise sıralama anahtarı yine müşteri kimliği olacak şekilde tanımlanacaktır.
Aynı bölüm anahtarını kullanıp benzersiz bir sıralama anahtarı belirleyerek, müşterilerden siparişlere ve müşterilerden sepetlere ilişkileri kolayca ekleyebiliriz.
Toplu görünümümüz artık şöyle görünüyor:
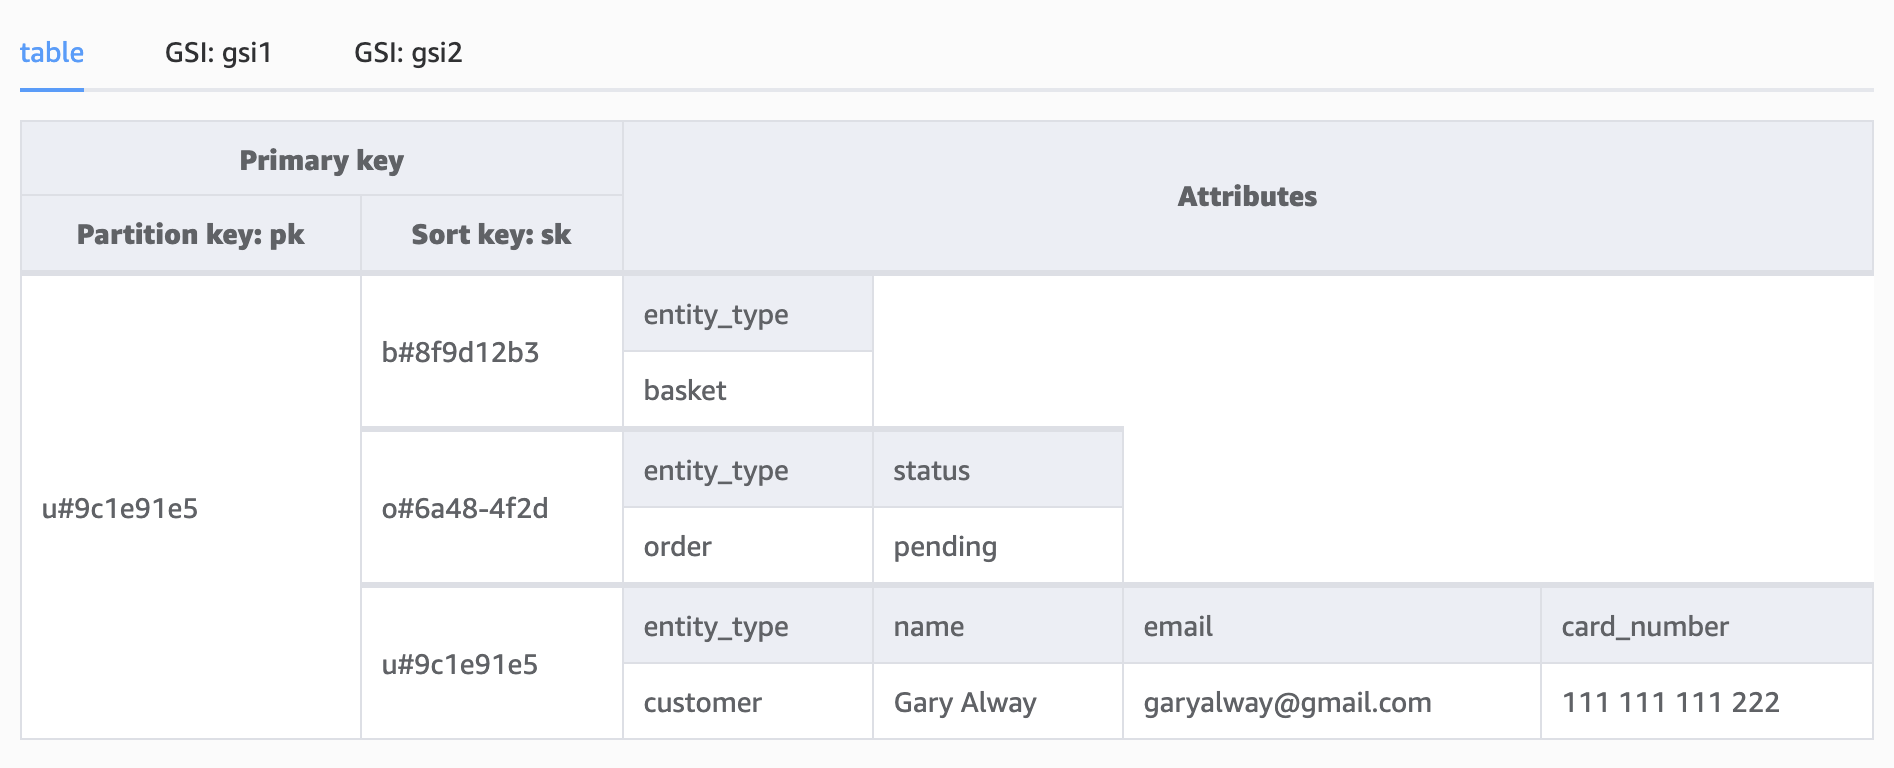
Artık tüm bu üç kaydı tek bir komutla, ilgili müşterinin tüm bölümünü sorgulayarak çekebiliriz:
export const getAllCustomerRecords = async (id: string) =>
  dynamoClient
    .query({
      TableName: TABLE_NAME,
      KeyConditionExpression: "pk=:pk",
      ExpressionAttributeValues: {
        ":pk": valueToAttributeValue(addPrefix(id, CUSTOMER_PREFIX)),
      },
    })
    .then((result) => result.Items);
Tablo büyüdükçe, bu tür bir sorgu, sepetler ve faturalar gibi diğer müşteri kayıtlarının yanı sıra müşterinin şimdiye kadar verdiği her siparişi döndüreceği için en verimli seçenek olmayabilir; ancak gerektiğinde tüm müşteri verilerine tek bir sorguyla erişebileceğimizi bilmek iyidir.
İfade öznitelik değerlerinde küçük bir ayarlama yaparak, sıralama anahtarı üzerinde kısmi eşleşme (begins_with) kullanmak bize şunları sorgulama imkânı verir:
Buradaki önemli çıkarım, NoSQL’de bire bir ve bire çok ilişkileri nasıl modelleyebileceğimizdir.
Bu varlıklar, bir kategorinin birden çok ürün içerebildiği bir başka bire çok ilişkiyi temsil eder.
Kategoriler ayrıca, bir kategorinin birden çok alt kategoriye sahip olabildiği hiyerarşik bir ilişkiye de sahiptir; bu da ürünlerin kategori hiyerarşi ağacının herhangi bir yerinde bulunabileceği anlamına gelir.
Bunu, kitapları kurgu ve kurgu dışı olarak ayrıştırarak modelleyelim.
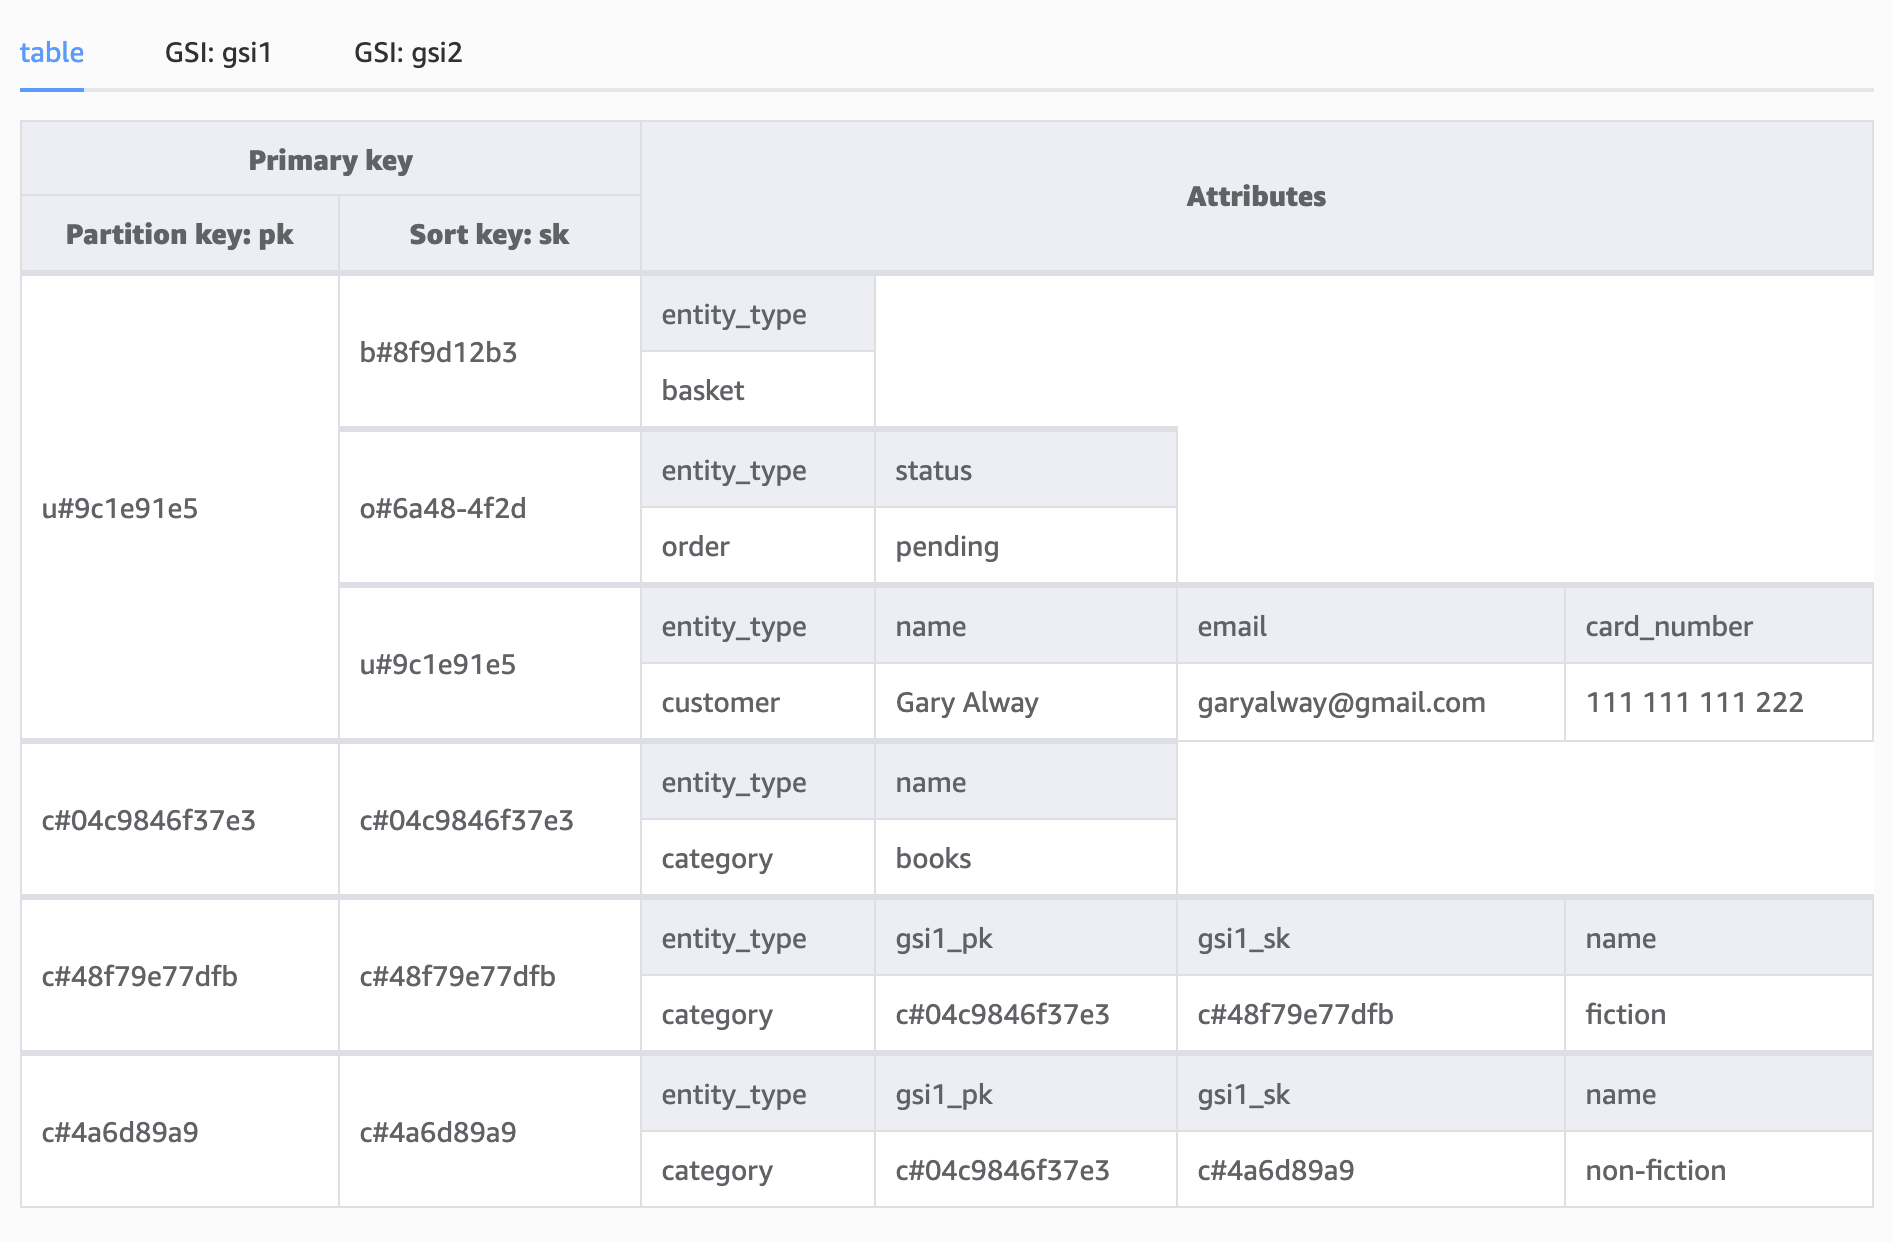
Alt kategoriler için GSI öznitelik anahtarlarını nasıl doldurduğumuza dikkat edin; GSI1_PK’yi üst kategori kimliği, GSI1_SK’yi ise alt kategori kimliği olarak ayarladık. Bu, GSI1 kullanarak bir kategoriye göre tüm alt kategorileri sorgulamamıza olanak tanır:
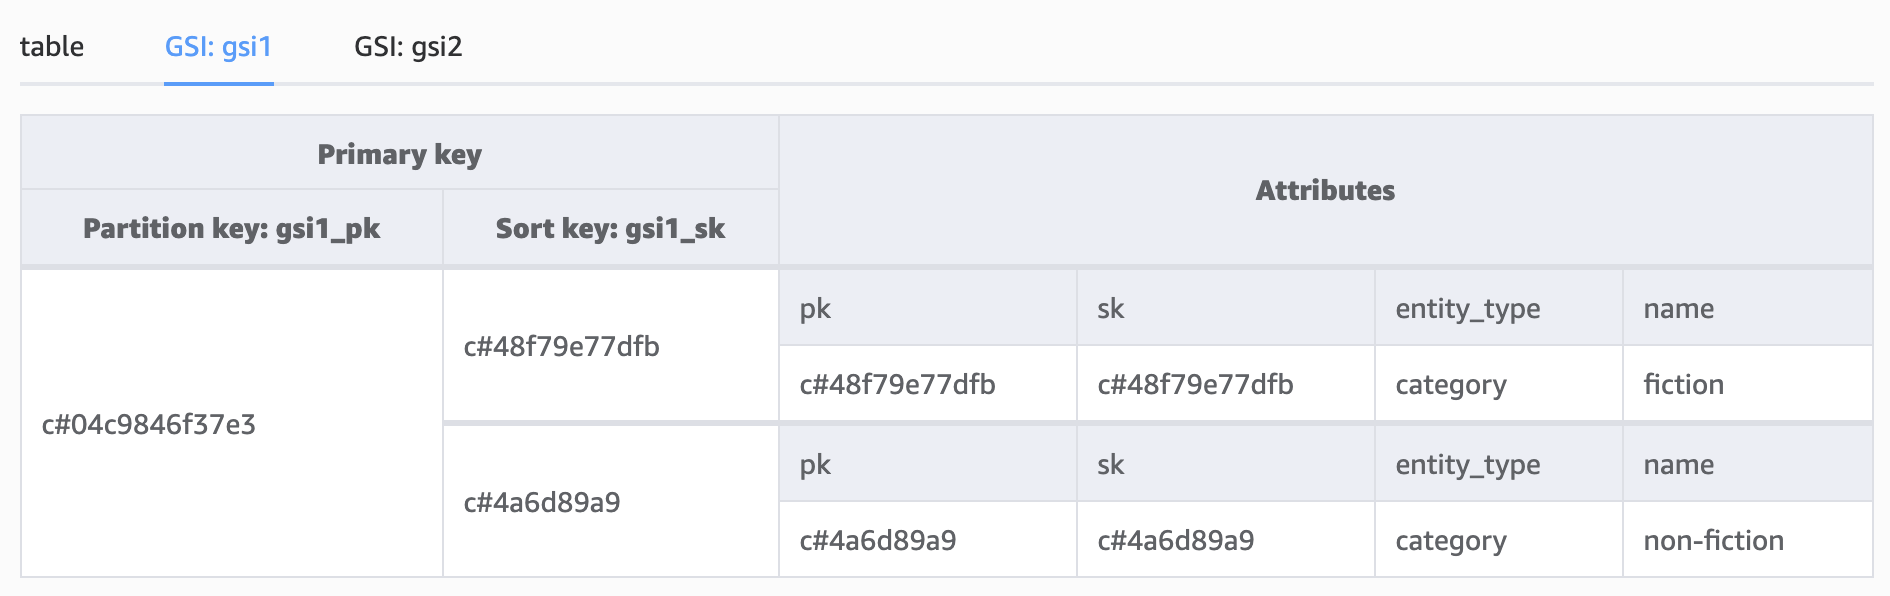
Aynı indeks, GSI1, yalnızca bire çok eşlemeler için kullanılmak zorunda değildir. Örneğin müşteriyi e-posta ile aramak istediğimizi düşünelim; mevcut model bunu doğrudan desteklemez, küçük bir veri kaydetme değişikliği yapmadıkça:
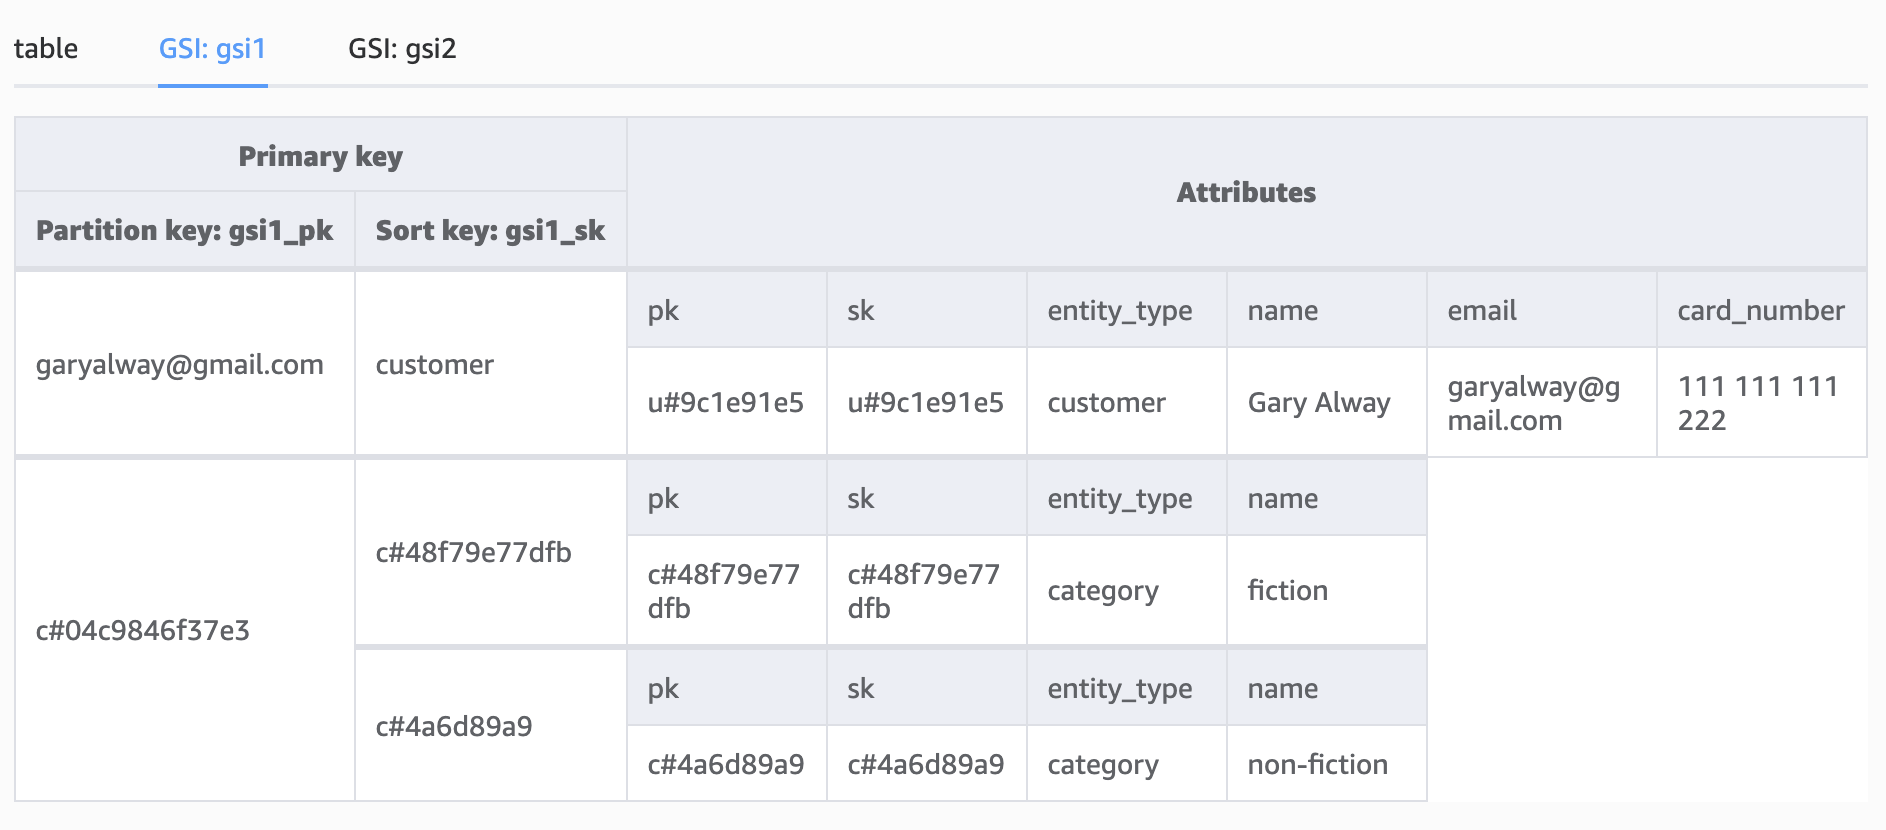
Müşteri e-posta adresini ve varlık türünü GSI PK ve SK olarak saklamak;
DynamoDB veri dağıtımına yardımcı olmak için, e-posta adresini bir karma değer olarak saklayarak bunu bir adım öteye taşıyabiliriz.
export const getCustomerByEmail = async (email: string) =>
  dynamoClient
    .query({
      TableName: TABLE_NAME,
      IndexName: "gsi1",
      KeyConditionExpression: "gsi1_pk = :email AND gsi1_sk = :entityType",
      ExpressionAttributeValues: {
        ":email": valueToAttributeValue(email),
        ":entityType": valueToAttributeValue(entityType),
      },
    })
    .then(({ Items }) => Items?.[0]);
Şu ana kadar, tüm indekslerin neden yalnızca PK ve SK gibi genel adlara sahip anahtar öznitelikleriyle genel adlara sahip olduğunu merak etmiş olabilirsiniz. Cevap artık net olmalı: Sakladığımız veriler ve tuttuğumuz indeksler esnektir ve varlık türüne bağlı olarak birden çok erişim desenini destekleyebilir.
Şimdiye kadar kullandığımız tablo için terraform şöyledir:
resource "aws_dynamodb_table" "tutorial-1" {
  name = "tutorial-1"
  billing_mode = "PAY_PER_REQUEST"
  hash_key = "pk"
  range_key = "sk"


  attribute {
    name = "pk"
    type = "S"
  }


  attribute {
    name = "sk"
    type = "S"
  }


  attribute {
    name = "gsi1_pk"
    type = "S"
  }


  attribute {
    name = "gsi1_sk"
    type = "S"
  }


  attribute {
    name = "gsi2_pk"
    type = "S"
  }


  attribute {
    name = "gsi2_sk"
    type = "S"
  }


  global_secondary_index {
    name = "gsi1"
    hash_key = "gsi1_pk"
    range_key = "gsi1_sk"
    projection_type = "ALL"
  }


  global_secondary_index {
    name = "gsi2"
    hash_key = "gsi2_pk"
    range_key = "gsi2_sk"
    projection_type = "ALL"
  }
}
Ürünlerin saklanması, bölüm anahtarının kategori kimliği ve sıralama anahtarının ürün kimliği olduğu aynı bire çok desenini izler:
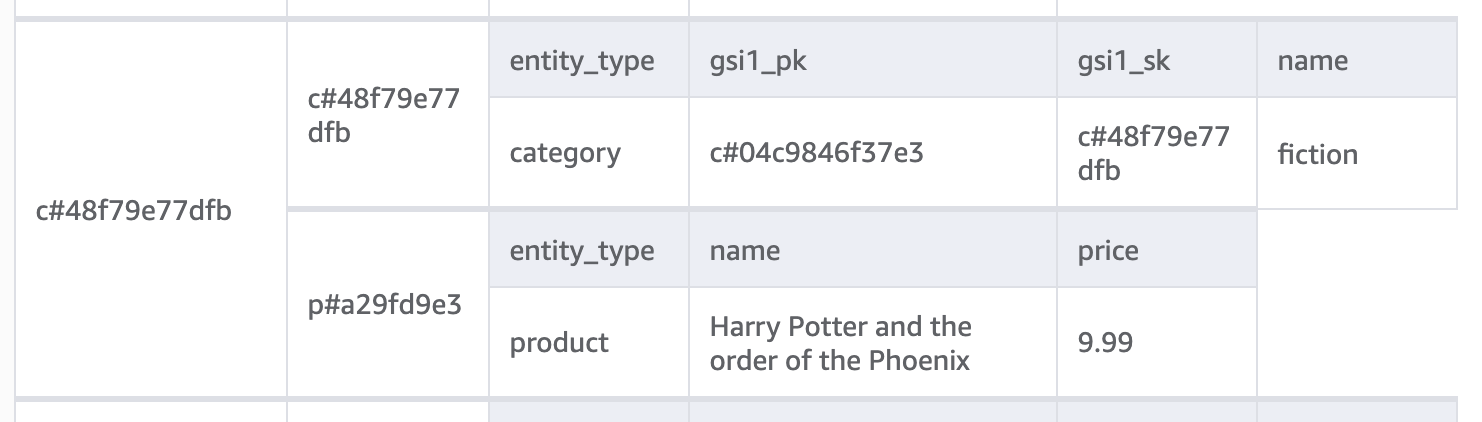
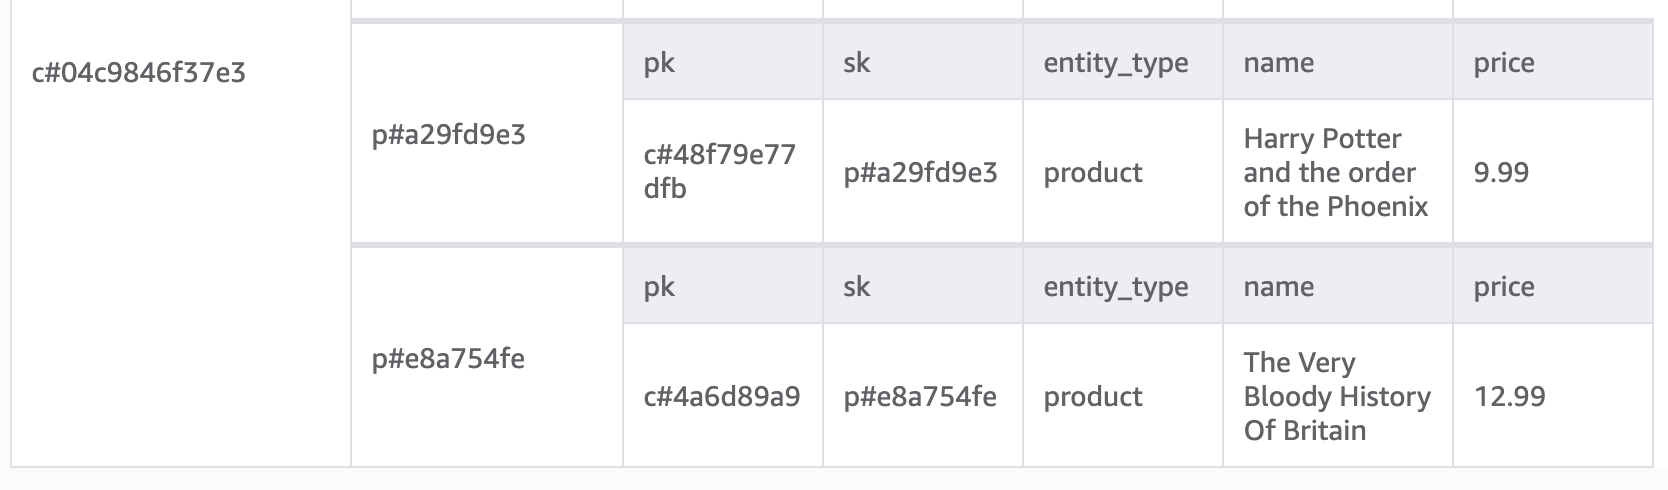
Üst kategoriyi GSI1’e eklemek, veritabanımızdaki tüm kitapları sorgulamamıza olanak tanır:
Canlı bir uygulamada, verileri bir Elasticsearch kümesine itmek için DynamoDB akışlarını kullanarak kitap adına göre arama yapma yeteneği kazanabiliriz; peki, mevcut modelimizi kullanarak ürün adına göre nasıl sorgulayabiliriz?
GSI1’i zaten kullandık, bu yüzden bunun için GSI2’yi kullanabiliriz:
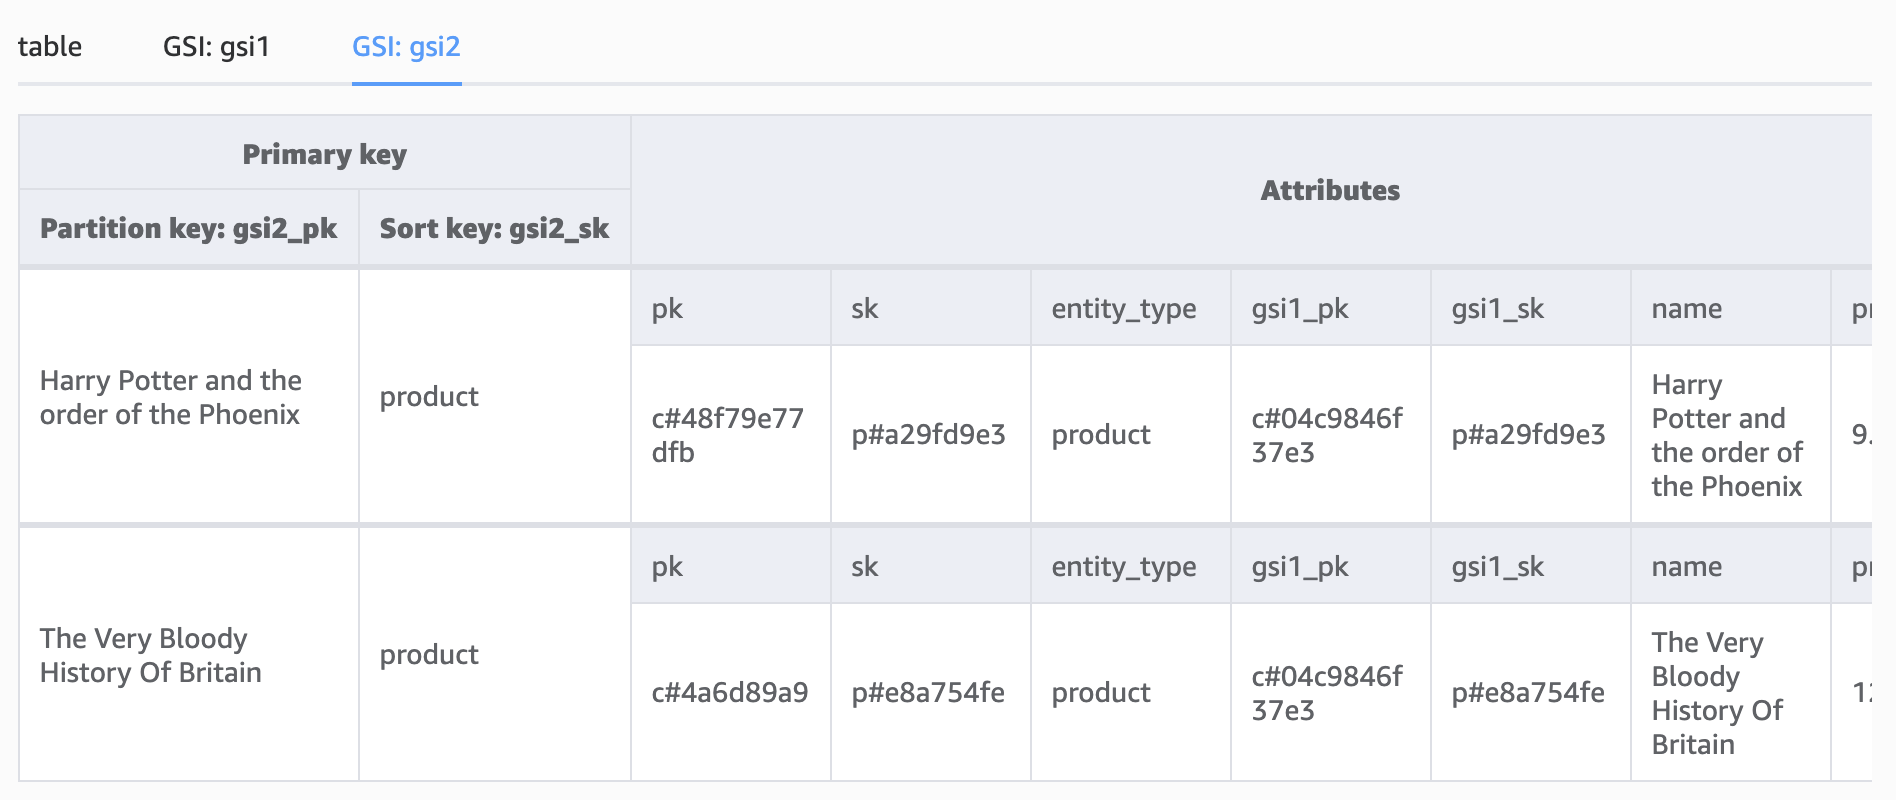
Unutmayın, DynamoDB’yi sorgularken tam ve eksiksiz bir bölüm anahtarı sağlamanız gerekir; bu uygulama en optimal olmayabilir, ancak üç indeksin farklı erişim desenleri için nasıl kullanılabileceğini göstermektedir.
Bir sonraki eğitimimde, bunu bir arama indeksi ile entegre ederek nasıl çözülebileceğini göstereceğim.
Hem sepet öğeleri hem de sipariş satırları müşteri bölümünde saklanır; GSI’ları kullanarak bir sepetteki tüm ürünleri, bir siparişteki tüm ürünleri ve bir müşterinin şimdiye kadar sipariş ettiği tüm ürünleri sorgulayabiliriz.
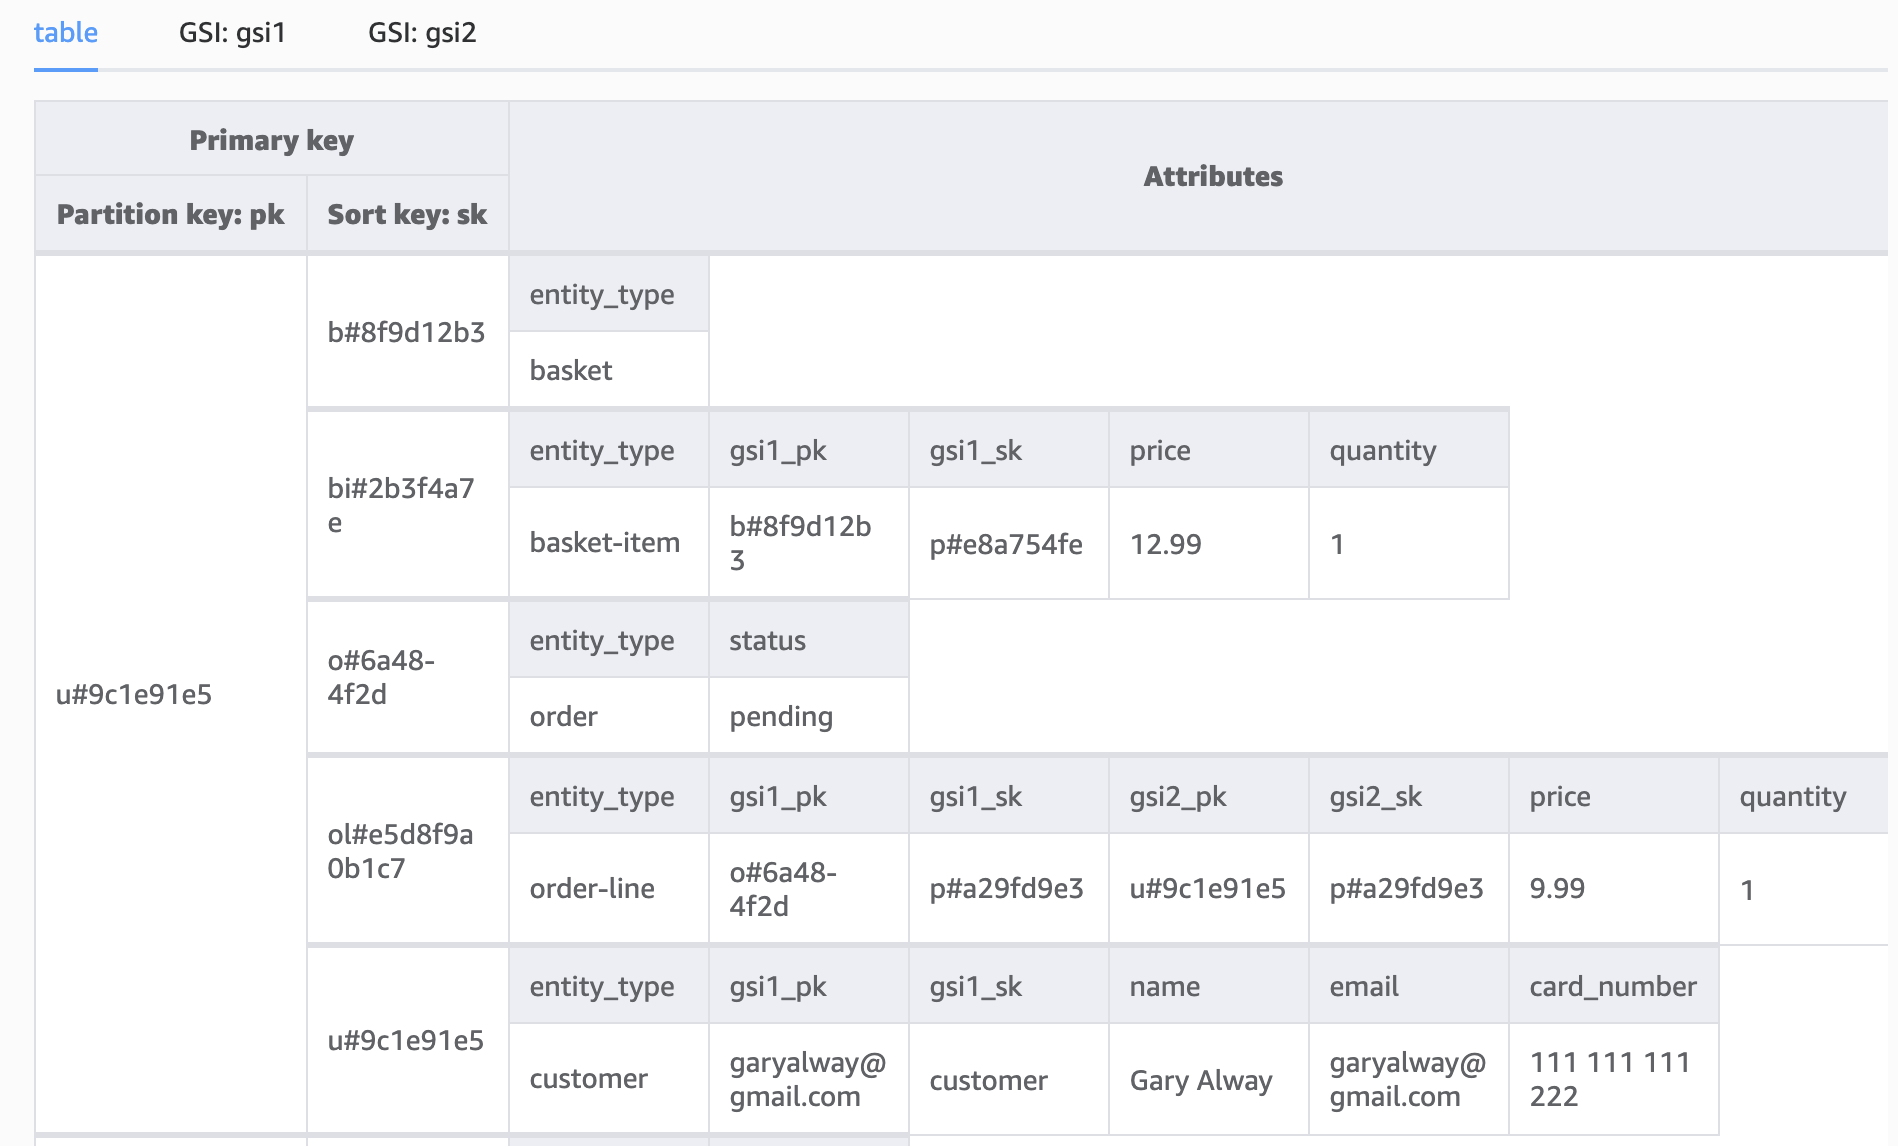
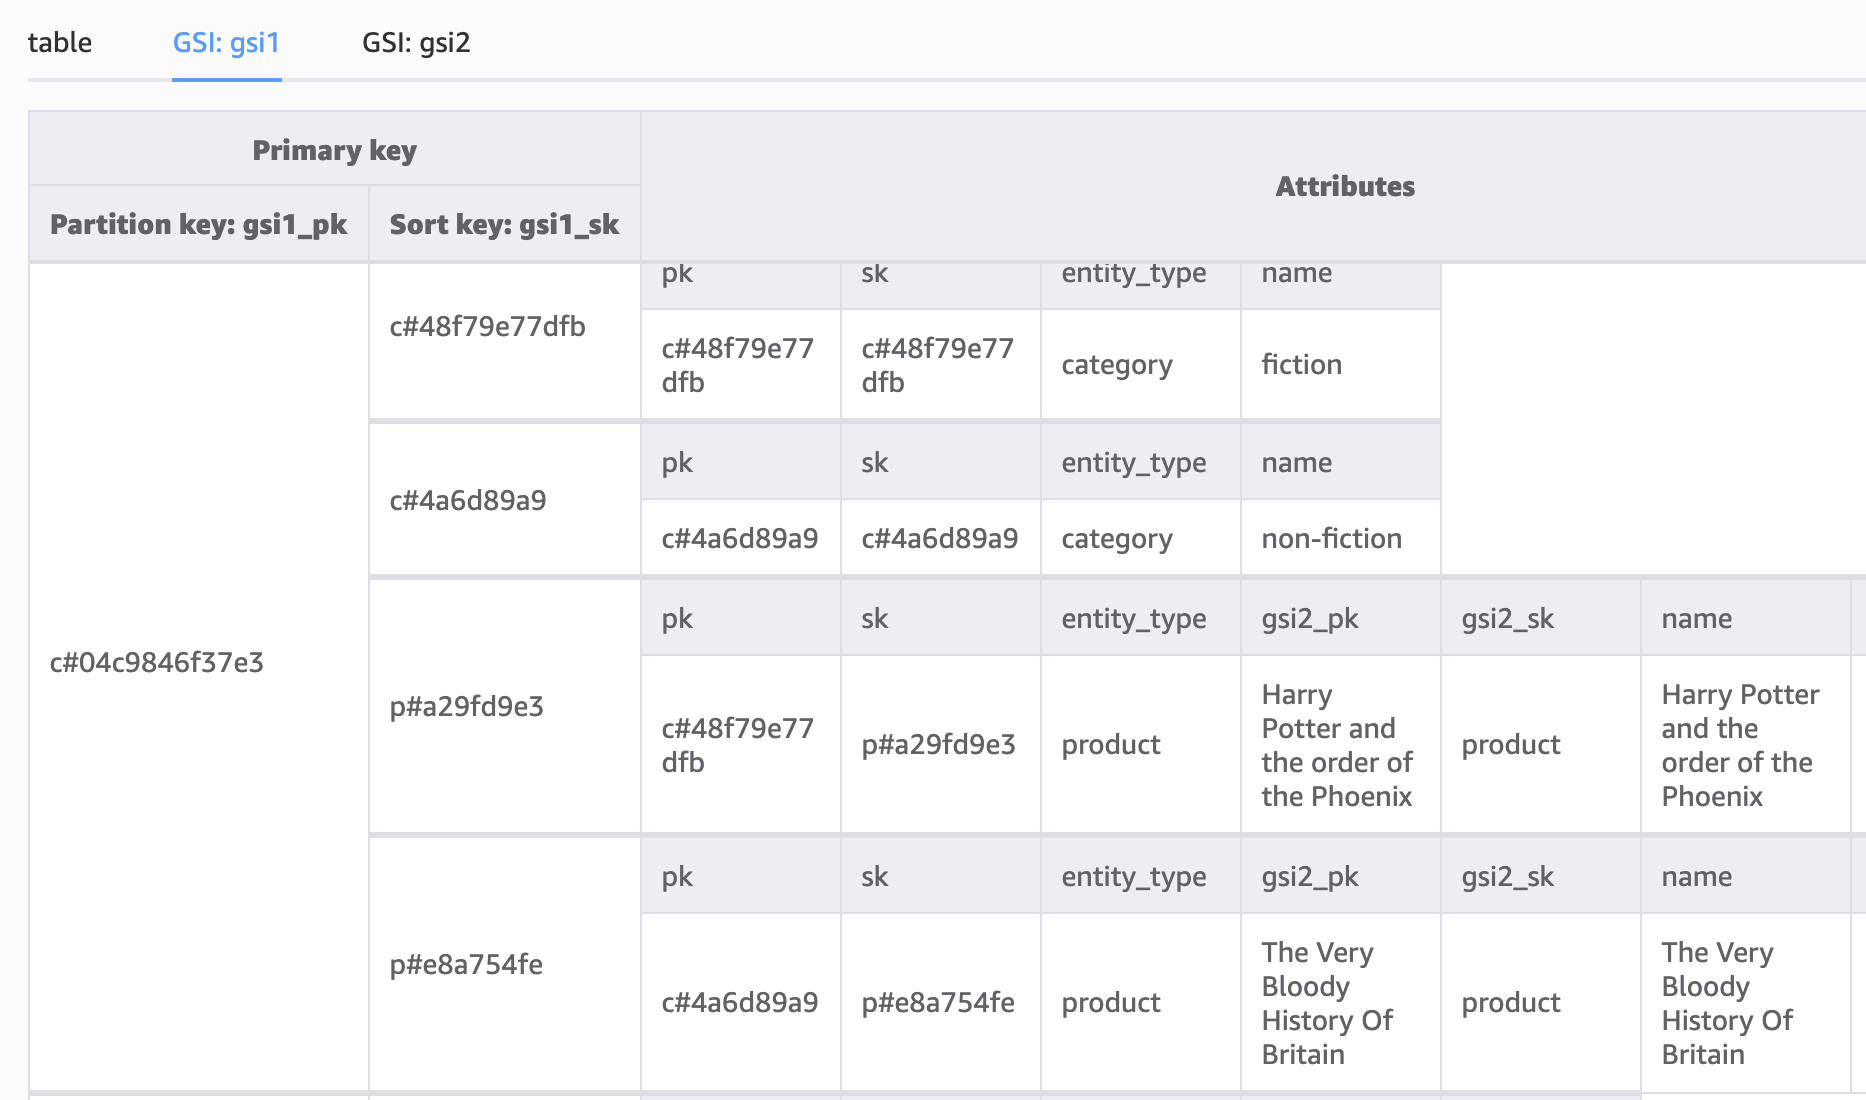
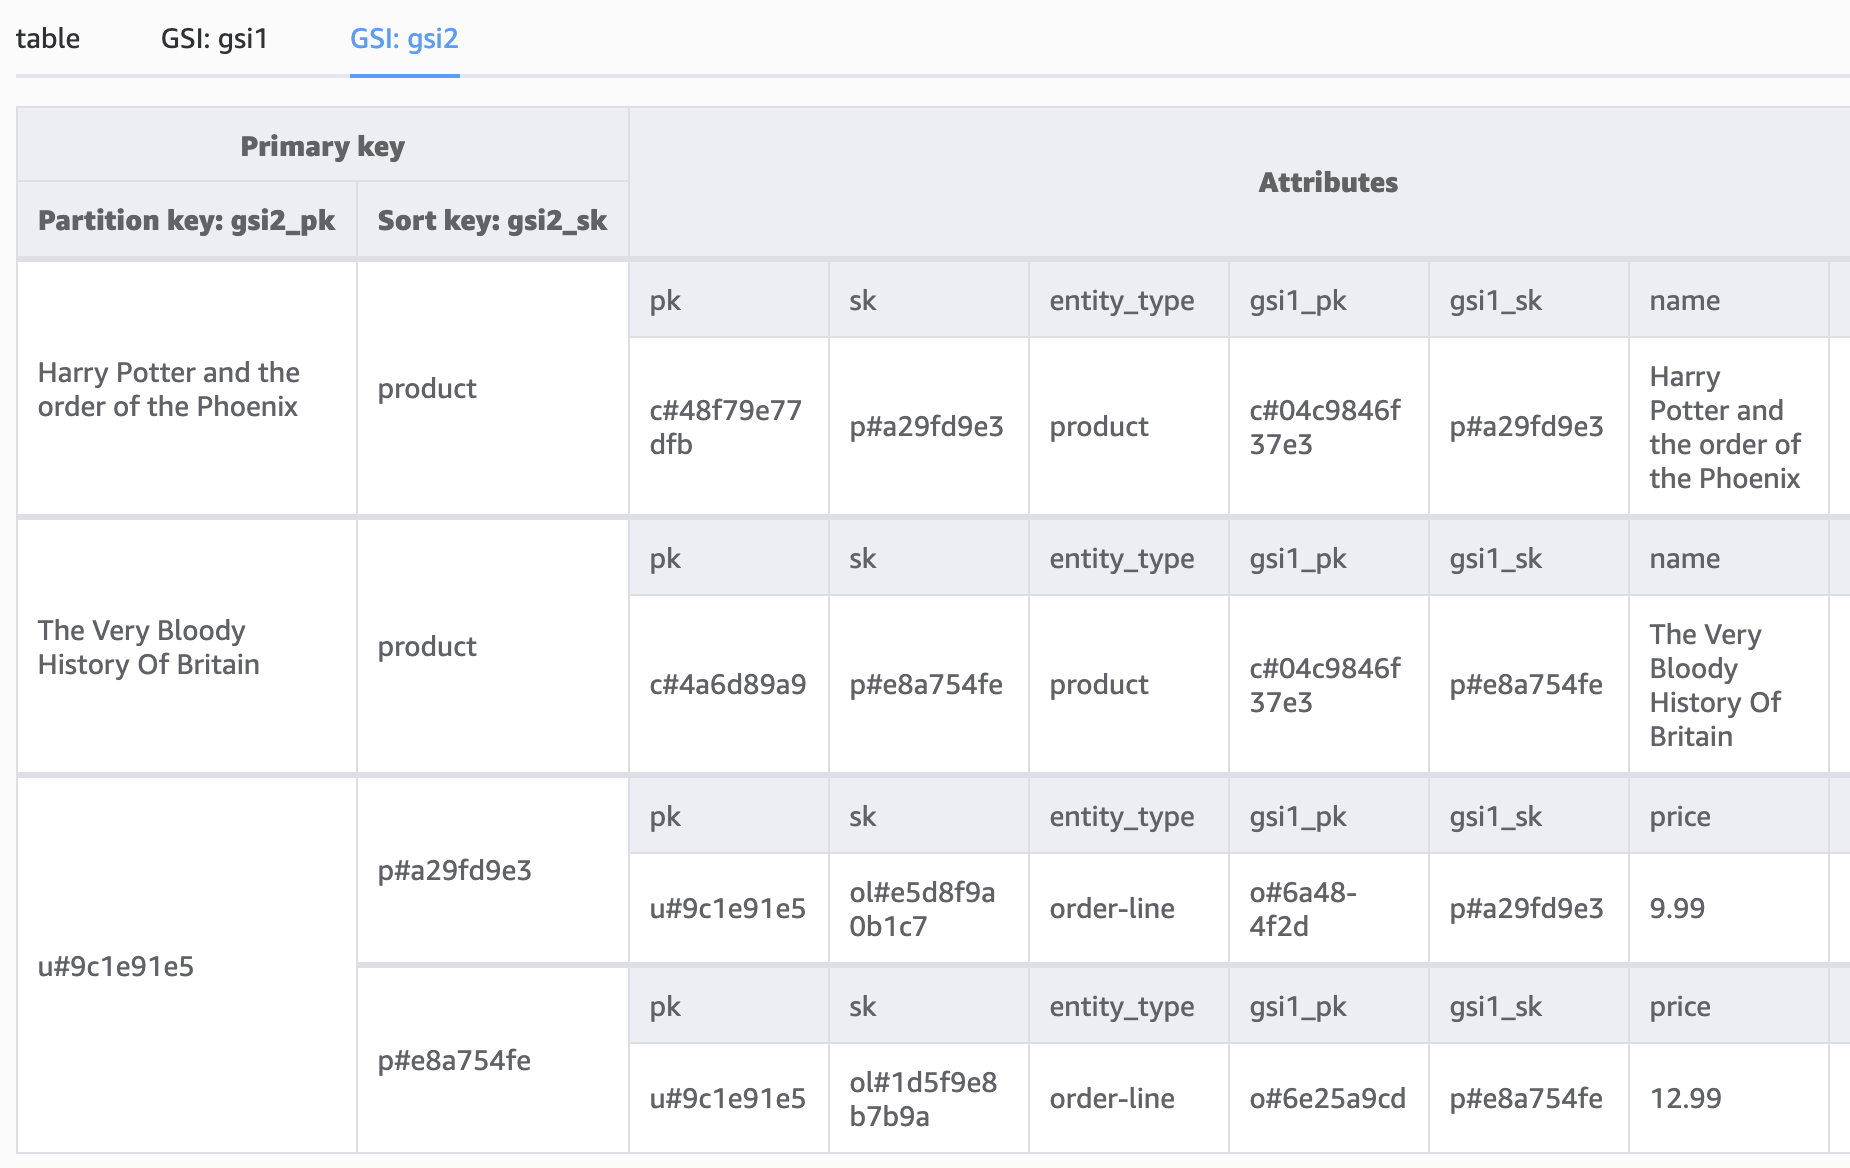
Bu son örnek, iki farklı sipariş kimliğinden iki ürün içeren bir müşterinin sipariş geçmişini gösterir.
SQL veritabanlarında veri modellemesinin nasıl çalıştığıyla ilgilenenler için, SQL’de Veri Modellemesi web seminerimiz, NoSQL veri modelleme anlayışınızı tamamlayabilecek değerli içgörüler sunar.
DynamoDB ile tek tablo tasarımı kullanmak birçok avantaj sunar, ancak çeşitli zorluklar ve dikkat edilmesi gereken hususlar da barındırır:
Tüm verilerinizi tek bir tabloda yönetmek, özellikle uygulamanız büyüyüp geliştikçe karmaşık hâle gelebilir.
Çeşitli sorgu desenlerini karşılayacak şekilde verilerinizi dikkatle planlamalı ve yapılandırmalısınız. Ek olarak, tek tablo tasarımının etkinliği uygulama mantığınızla yakından bağlantılıdır; sorunsuz veri erişimi ve verimli sorgu işlemeyi sağlamada kritik rol oynar.
Etkili bir tek tablo tasarımı için hem veri yapısını hem de uygulama mantığını dikkatle ele almak esastır.
DynamoDB, farklı sorgu desenlerini desteklemek için Global İkincil İndeksler’e izin verse de bu indeksleri sağlamak ve sürdürmek maliyeti ve karmaşıklığı artırabilir.
Doğru bölüm anahtarını seçmek, dengeli veri dağılımı ve sorgu performansı için kritiktir. Uygun olmayan bir bölüm anahtarı seçmek, sıcak bölümlere ve performans darboğazlarına yol açabilir.
Veri hacminiz arttıkça, tek tablonuzun boyutu önemli ölçüde büyüyebilir. Bu durum hem depolama maliyetini hem de okuma-yazma maliyetlerini etkileyebilir.
DynamoDB yerel olarak tam metin aramayı desteklemez; bu işlevselliği uygulamak için Elasticsearch gibi diğer hizmetlerle entegrasyon gerekir.
Tablo şemanızda değişiklik yapmak, özellikle üretim sistemlerinde zorlu olabilir. Mevcut verileri taşımanız veya şema değişikliklerine uyum sağlamak için uygulama mantığınızı değiştirmeniz gerekebilir.
Okuma tutarlılığı seçiminize (güçlü veya sonuçta tutarlı) bağlı olarak, verilerin tutarlılığına ilişkin olası zorlukları hesaba katmanız gerekebilir; GSI’ların eşzamanlı olmayan şekilde çoğaltıldığını unutmayın.
DynamoDB’nin sorgu yetenekleri güçlüdür, ancak SQL sorguları kadar esnek değildir.
Veritabanlarını etkin bir şekilde tasarlamayı ve ilgili zorluklarda yol almayı daha iyi anlamak için Veritabanı Tasarımı kursumuza göz atın.
Bir NoSQL veritabanı ile çalışırken, ilişkisel veritabanı tasarım kalıplarının alışıldık bölgesinden kopmak kritik öneme sahiptir; öğrendiklerinizi yeniden gözden geçirmeniz gerekir.
Tek tablo tasarım desenini seçmek, güvenilir ve öngörülebilir performansla yüksek trafik hacimlerini karşılamaya hazır, küresel ölçekte ölçeklenebilir bir veritabanı vaadi sunar.
Ancak bu performans avantajı bedelsiz değildir; veritabanı yapınızın ve uygulama mantığınızın en baştan titizlikle planlanmasını ve düşünceli bir şekilde uygulanmasını gerektirir.
Bilginizi NoSQL kavramları kursumuzla pekiştirin!
Veri Yolculuğunuza Bugün Başlayın!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




