Kursus
Memahami Machine Learning
2 jam
313.7K
Aljabar linear adalah salah satu alat matematika dasar yang kita perlukan dalam data science. Memahami konsep-konsep ini dapat meningkatkan pemahaman Anda tentang berbagai algoritme. Ini benar-benar merupakan landasan yang sangat baik untuk jalur data science/machine learning.
Tujuan tutorial ini adalah memasuki matematika untuk data science dengan melakukan pengkodean menggunakan Python/Numpy. Menurut saya, memiliki tutorial praktis tentang topik teoretis seperti aljabar linear bisa bermanfaat karena menulis dan membaca kode adalah cara yang baik untuk benar-benar memahami konsep matematika. Dan yang terpenting, ini bisa sangat menyenangkan!
Tidak ada prasyarat khusus, tetapi jika Anda belum yakin apa itu matriks atau bagaimana melakukan perkalian titik (dot product), tulisan pertama (1 hingga 4) dari seri saya tentang buku deep learning karya Ian Goodfellow adalah awal yang baik.
Dalam tutorial ini, kita akan membahas konsep penting untuk machine learning dan deep learning: norma. Norma digunakan secara ekstensif, misalnya, untuk mengevaluasi performa sebuah model. Di akhir tutorial ini, semoga Anda memiliki intuisi yang lebih baik tentang konsep ini dan mengapa hal ini sangat berharga dalam machine learning. Kita juga akan melihat bagaimana turunan dari norma digunakan untuk melatih algoritme machine learning.
Sebelum semuanya, kita akan menyiapkan pustaka yang akan kita gunakan:
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
Dan menambahkan pintasan Latex pada perintah bs untuk simbol tebal dan norm untuk simbol norma:
$$
\newcommand\bs[1]{\boldsymbol{#1}}
\newcommand\norm[1]{\left\lVert#1\right\rVert}
$$
$$ \newcommand\bs[1]{\boldsymbol{#1}} \newcommand\norm[1]{\left\lVert#1\right\rVert} $$
Hal terakhir yang perlu diatur adalah tampilan grafik yang akan kita buat:
# Plot parameters
sns.set()
%pylab inline
pylab.rcParams['figure.figsize'] = (4, 4)
plt.rcParams['xtick.major.size'] = 0
plt.rcParams['ytick.major.size'] = 0
Populating the interactive namespace from numpy and matplotlib
Mari mulai dengan contoh sederhana. Bayangkan Anda memiliki kumpulan data lagu yang berisi berbagai fitur. Sekarang misalkan Anda ingin membangun model yang memprediksi durasi sebuah lagu berdasarkan fitur lain seperti genre musik, instrumentasi, dan sebagainya. Anda telah melatih sebuah model, dan sekarang ingin mengevaluasinya dalam memprediksi durasi lagu baru. Salah satu caranya adalah mengambil data baru dan memprediksi durasi lagu dengan model Anda. Karena Anda mengetahui durasi sebenarnya dari setiap lagu untuk observasi ini, Anda dapat membandingkan durasi sebenarnya dan prediksi untuk tiap observasi. Anda memiliki hasil berikut dalam detik untuk 7 observasi:
errorModel1 = [22, -4, 2, 7, 6, -3, 12]
Perbedaan ini dapat dianggap sebagai galat (error) dari model. Model sempurna hanya akan memiliki nilai 0, sedangkan model yang sangat buruk akan memiliki nilai positif atau negatif yang sangat besar.
Sekarang bayangkan Anda mencoba model lain dan mendapatkan perbedaan berikut antara durasi lagu yang diprediksi dan yang sebenarnya:
errorModel2 = [14, 9, -13, 19, 8, -21, 4]
Apa yang dapat Anda lakukan jika ingin menemukan model terbaik? Cara yang alami adalah menjumlahkan nilai absolut dari galat-galat ini. Nilai absolut digunakan karena galat negatif (durasi sebenarnya lebih kecil daripada durasi prediksi) juga merupakan galat. Semakin kecil total galat sebuah model, semakin baik:
totalErrorModel1 = np.sum(np.abs(errorModel1))
totalErrorModel1
56
totalErrorModel2 = np.sum(np.abs(errorModel2))
totalErrorModel2
88
Tampaknya model 1 jauh lebih baik daripada model 2.
Selamat! Anda baru saja menghitung norma dari vektor galat untuk masing-masing model!
Anda dapat memandang norma sebagai panjang dari vektor. Untuk mendapatkan gambaran representasi grafisnya, mari ambil lagi contoh sebelumnya. Vektor galat bersifat multidimensi: ada satu dimensi per observasi. Pada contoh terakhir, 7 observasi menghasilkan 7 dimensi. Ini masih cukup sulit untuk direpresentasikan dalam 7 dimensi, jadi mari sederhanakan lagi contoh dan menyisakan hanya 2 observasi:
errorModel1 = [22, -4]
errorModel2 = [14, 9]
Sekarang kita dapat merepresentasikan vektor-vektor ini dengan menganggap bahwa elemen pertama array adalah koordinat x dan elemen kedua adalah koordinat y. Kita akan mulai dengan menulis fungsi untuk memplot vektor dengan mudah dan mendapatkan gambaran representasinya.
Kita menginginkan sebuah fungsi untuk membantu kita memplot vektor. Mari mulai dengan cara kita akan menggunakannya. Kita ingin memberikan daftar array yang sesuai dengan koordinat vektor-vektor dan mendapatkan plot dari vektor-vektor tersebut. Katakanlah kita juga dapat memberikan array warna untuk membedakan vektor pada plot. Singkatnya, kita ingin memanggil fungsi seperti ini:
plotVectors([vector1, vector2], ['red', 'blue'])
Mari kita tulis fungsi ini:
def plotVectors(vecs, cols, alpha=1):
    """
    Plot set of vectors.

    Parameters
    ----------
    vecs : array-like
        Coordinates of the vectors to plot. Each vector is in an array. For
        instance: [[1, 3], [2, 2]] can be used to plot 2 vectors.
    cols : array-like
        Colors of the vectors. For instance: ['red', 'blue'] will display the
        first vector in red and the second in blue.
    alpha : float
        Opacity of vectors

    Returns:

    fig : instance of matplotlib.figure.Figure
        The figure of the vectors
    """
    plt.axvline(x=0, color='#A9A9A9', zorder=0)
    plt.axhline(y=0, color='#A9A9A9', zorder=0)

    for i in range(len(vecs)):
        if (isinstance(alpha, list)):
            alpha_i = alpha[i]
        else:
            alpha_i = alpha
        if (len(vecs[i])==2):
            x = np.concatenate([[0,0],vecs[i]])
        elif (len(vecs[i])==4):
            x = vecs[i]
        plt.quiver([x[0]],
                   [x[1]],
                   [x[2]],
                   [x[3]],
                   angles='xy', scale_units='xy', scale=1, color=cols[i],
                  alpha=alpha_i)
Fungsi ini menerima array vektor untuk diplot (vecs) dan warnanya (cols) sebagai masukan. Jika hanya 2 dimensi yang ditentukan dalam vektor, maka vektor dimulai dari (0, 0). Di balik layar, kita melakukan iterasi pada array vektor ini dan menggunakan plt.quiver() untuk memplotnya.
Mari gunakan fungsi baru kita untuk memplot galat model 1 dan 2:
plotVectors([errorModel1, errorModel2], [sns.color_palette()[0], sns.color_palette()[1]])

plt.xlim(-1, 25)
plt.ylim(-5, 10)
plt.show()
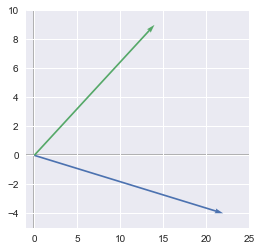
Catatan: kita tidak menyertakan plt.show() di dalam fungsi agar dapat menambahkan konfigurasi plot seperti penentuan batas seperti di sini.
Catatan 2: kita menggunakan warna dari seaborn secara manual dengan sns.color_palette()
Jadi kita memiliki satu vektor galat untuk setiap model. Model yang lebih baik adalah model yang sesuai dengan vektor yang lebih kecil. Salah satu cara untuk menghitung panjang vektor adalah menggunakan teorema Pythagoras: $\sqrt{x^2+y^2}$. Kita dapat menghitung panjang kedua vektor:
# Lenght of the vector errorModel1
np.sqrt(errorModel1[0]**2+errorModel1[1]**2)
22.360679774997898
# Lenght of the vector errorModel2
np.sqrt(errorModel2[0]**2+errorModel2[1]**2)
16.643316977093239
Selamat! Anda baru saja menghitung norma lain dari vektor galat. Panjang vektor galat model pertama adalah $22{,}36$ dan panjang vektor galat model kedua sekitar $16{,}64$. Dalam kasus ini, model kedua lebih baik, tetapi ingat bahwa kita hanya menggunakan dua nilai pertama.
Kita pertama-tama menghitung jumlah galat, tetapi kita juga dapat menggunakan teorema Pythagoras untuk menghitung norma sebuah vektor. Ini adalah dua norma yang berbeda, dan ini menunjukkan bahwa ada beberapa cara untuk menghitung norma.
Norma sebuah vektor dapat berupa fungsi apa pun yang memetakan sebuah vektor ke nilai positif. Berbagai fungsi dapat digunakan, dan kita akan melihat beberapa contohnya. Fungsi-fungsi ini dapat disebut norma jika dicirikan oleh sifat-sifat berikut:
Norma bernilai non-negatif. Jika Anda memandang norma sebagai panjang, Anda dapat dengan mudah melihat mengapa nilainya tidak bisa negatif.
Norma bernilai $0$ jika dan hanya jika vektor tersebut adalah vektor nol.
Norma memenuhi pertidaksamaan segitiga. Lihat di bawah.
$\norm{k\cdot \bs{u}}=\norm{k}\cdot\norm{\bs{u}}$. Di sini, $k$ adalah skalar dan $\bs{u}$ sebuah vektor. Norma dari vektor yang dikalikan dengan skalar sama dengan nilai absolut dari skalar tersebut dikalikan dengan norma vektornya.
Biasanya ditulis dengan dua garis vertikal ganda: $\norm{\bs{x}}$
Kita telah melihat di atas bahwa salah satu syarat agar sebuah fungsi disebut norma adalah memenuhi pertidaksamaan segitiga. Ini berarti bahwa norma dari penjumlahan beberapa vektor kurang dari atau sama dengan jumlah norma dari vektor-vektor tersebut:
Untuk menunjukkan artinya, kita akan mengambil dua vektor, masing-masing berisi dua elemen (sekali lagi, berguna untuk direpresentasikan sebagai koordinat x dan y). Vektor kita adalah:
u = np.array([1, 6])
u
array([1, 6])
dan
v = np.array([4, 2])
v
array([4, 2])
Mari bandingkan:
dan:
Kita akan melihat nanti berbagai jenis norma, tetapi untuk saat ini kita akan menggunakan yang klasik: Norma Euclidean ($L^2$). Norma $L^2$ dapat dihitung dengan fungsi Numpy np.linalg.norm() (lihat detail selengkapnya di dokumentasi).
Kita akan melihat nanti secara rinci apa itu norma $L^1$ atau $L^2$.
np.linalg.norm(u+v)
9.4339811320566032
dan
np.linalg.norm(u)+np.linalg.norm(v)
10.554898485297798
Kita dapat melihat bahwa pertidaksamaan segitiga terpenuhi karena:
Anda akan melihat bahwa representasi grafis dari teorema ini membuatnya cukup sepele. Kita akan memplot vektor $\bs{u}$, $\bs{v}$ dan $\bs{u}+\bs{v}$ menggunakan fungsi plotVectors kita dan menambahkan beberapa teks untuk mengidentifikasi vektor-vektor tersebut:
u = np.array([0,0,1,6])
v = np.array([0,0,4,2])
w = u+v

u_bis = [u[2], u[3], v[2], v[3]]

plotVectors([u, u_bis, w],
            [sns.color_palette()[0],
            sns.color_palette()[1],
            sns.color_palette()[2]])

plt.xlim(-2, 6)
plt.ylim(-2, 9)

plt.text(-1, 3.5, r'$||\vec{u}||$', color=sns.color_palette()[0], size=20)
plt.text(2.5, 7.5, r'$||\vec{v}||$', color=sns.color_palette()[1], size=20)
plt.text(2, 2, r'$||\vec{u}+\vec{v}||$', color=sns.color_palette()[2], size=20)

plt.show()
plt.close()
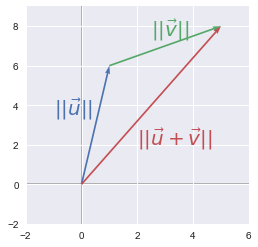
Panjang $\bs{u}$ ditambah panjang $\bs{v}$ lebih besar daripada panjang vektor $\bs{u}+\bs{b}$. Secara geometris, ini berarti bahwa lintasan terpendek antara dua titik adalah garis lurus!
Kita telah melihat syarat-syarat yang diperlukan agar sebuah fungsi disebut norma. Ini berarti ada banyak fungsi yang dapat digunakan sebagai norma. Kita akan melihat nanti kelebihan dan kekurangan dari berbagai norma ini. Kita menyebut $p$-norm untuk kategori fungsi berikut yang bergantung pada $p$:
Mari kita telusuri persamaan ini langkah demi langkah. Kita dapat melihat bahwa ada penjumlahan dari elemen-elemen sehingga kita dapat memikirkannya sebagai iterasi atas elemen $i$:
Ini akan menjadi jelas dengan contoh menggunakan $p$-norm yang banyak digunakan ini.
Jika $p=0$, rumusnya menjadi:
Mari lihat artinya. Menggunakan pangkat $0$ pada nilai absolut akan menghasilkan $1$ untuk setiap nilai selain $0$ dan $0$ untuk nilai $0$.
Oleh karena itu norma ini berkaitan dengan jumlah elemen tak-nol dalam vektor. Ini tidak benar-benar sebuah norma karena jika Anda mengalikan vektor dengan $\alpha$, jumlah ini tetap sama (aturan 4 di atas).
Jika $p=1$, kita cukup memiliki jumlah nilai absolut. Inilah yang kita gunakan secara intuitif di awal tutorial ini:

Norma Euclidean adalah $p$-norm dengan $p=2$. Ini mungkin norma yang paling sering digunakan bersama norma $L^2$ kuadrat (lihat di bawah).
Kita dapat mencatat bahwa nilai absolut tidak lagi diperlukan karena $x$ dikuadratkan. Inilah yang kita gunakan saat menghitung panjang vektor dengan teorema Pythagoras di atas.
Mari lihat contoh lain dari norma ini:
Secara grafis, norma Euclidean sesuai dengan panjang vektor dari titik asal ke titik yang diperoleh dengan kombinasi linear (teorema Pythagoras). Kita akan melihat contoh dalam 2 dimensi: vektor $\bs{u}$ memiliki dua nilai yang sesuai dengan koordinat $x$ dan koordinat $y$. Jika Anda memplot titik dengan koordinat ini dan menggambar vektor dari titik asal ke titik ini, maka norma $L^2$ adalah panjang vektor tersebut.
Contohnya:
Mari mulai dengan menghitung norma menggunakan rumus:

Jadi norma $L^2$ adalah $5$.
Ngomong-ngomong, ingat bahwa norma $L^2$ dapat dihitung dengan fungsi linalg.norm() dari Numpy:
np.linalg.norm([3, 4])
5.0
Berikut representasi grafis dari vektornya:
u = np.array([3, 4])

plt.ylim(-1, 5)
plt.xlim(-1, 5)
plotVectors([u], [sns.color_palette()[0]])
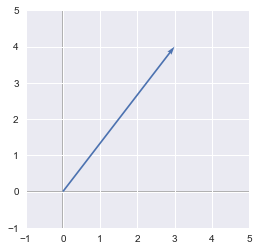
Kita dapat melihat bahwa vektor membentang dari titik asal (0, 0) ke (3, 4) dan panjangnya adalah 5.
Dalam kasus ini, vektor berada di ruang 2-dimensi, tetapi ini juga berlaku untuk lebih banyak dimensi.
Norma $L^2$ kuadrat nyaman karena menghilangkan akar kuadrat dan kita mendapatkan jumlah sederhana dari setiap nilai vektor yang dikuadratkan.
Norma Euclidean kuadrat banyak digunakan dalam machine learning, sebagian karena dapat dihitung dengan operasi vektor $\bs{x}^\text{T}\bs{x}$. Ada potensi keuntungan kinerja karena optimisasi. Lihat di sini dan di sini untuk detail lebih lanjut.
Kita akan melihat dalam contoh ini bahwa norma Euclidean kuadrat dapat dihitung dengan operasi tervektorisasi. Mari mulai dengan sebuah vektor $\bs{x}$:
Seperti biasa, kita akan menggunakan kode untuk memeriksa prosesnya. Pertama, mari buat vektor Numpy $\bs{x}$:
x = np.array([[2], [5], [3], [3]])
x
array([[2],
       [5],
       [3],
       [3]])
Sekarang mari ambil transpose dari vektor ini. Ini hanya akan mengubah vektor kolom awal menjadi vektor baris:
Kita dapat menghitung transpose $\bs{x}$ dengan metode T dari objek Numpy:
x.T
array([[2, 5, 3, 3]])
Perkalian titik dari $\bs{x}$ dan $\bs{x}^\text{T}$ (lihat di sini jika Anda perlu pengingat tentang perkalian titik) sebenarnya berkaitan dengan perkalian setiap elemen dengan dirinya sendiri:

Ini persis definisi dari norma Euclidean kuadrat!
Mari periksa dengan Numpy. Ingat (dan coba sendiri untuk meyakinkan) bahwa urutan vektor dalam perkalian titik itu penting:
euclideanNorm = x.T.dot(x)
euclideanNorm
array([[47]])
Ini seharusnya adalah norma Euclidean kuadrat kita! Mari hitung dari norma $L^2$ lalu kuadratkan untuk memeriksa bahwa ini benar:
np.linalg.norm(x)**2
47.0
Berhasil! Kemungkinan menggunakan operasi tervektorisasi adalah keunggulan besar dibanding norma lainnya.
Kita telah melihat bahwa norma dapat digunakan untuk mengevaluasi kualitas model dengan merangkum vektor galat.
Sekarang kita ingin melangkah lebih jauh dan mengetahui bagaimana kita dapat mengubah parameter model untuk mengurangi galat keseluruhan. Untuk melakukan itu kita dapat menggunakan fungsi biaya yang mengaitkan galat model sebagai fungsi dari nilai parameter. Algoritme gradient descent dapat digunakan untuk menemukan minimum fungsi ini. Gradient descent dilakukan dengan menghitung turunan terhadap setiap parameter (turunan parsial = gradien). Inilah mengapa sangat penting untuk dapat menghitung turunan secara efisien.
Memang, keuntungan besar dari norma $L^2$ kuadrat adalah turunan parsialnya mudah dihitung. Misalkan kita memiliki vektor berikut:
Kita telah melihat bahwa norma $L^2$ kuadratnya dihitung dengan:
Kemudian, untuk menghitung turunan parsial, kita menganggap semua variabel lain sebagai konstanta. Misalnya, turunan parsial terhadap $u_1$ adalah turunan dari $u_1^2+a$ ($a$ adalah konstanta yang sesuai dengan semua variabel lain). Untuk alasan ini, kita memiliki turunan parsial berikut:
Yang hebat dari gradien norma $L^2$ kuadrat adalah turunannya tidak bergantung pada variabel lain. Kita akan melihat bahwa hal ini tidak berlaku pada norma $L^2$.
Pada kasus norma $L^2$, turunannya lebih rumit dan mempertimbangkan setiap elemen vektor. Mari ambil vektor $\bs{u}$ terakhir sebagai contoh. Norma $L^2$ adalah:
Mari hitung turunannya terhadap $u_1$:

Kita dapat melihat bahwa turunan parsial dari $u_1$ masih mengandung $u_2...u_n$. Gradien lainnya mengikuti struktur yang sama:
Norma $L^2$ kuadrat memang bagus, tetapi satu masalahnya adalah norma ini sulit membedakan antara 0 dan nilai kecil karena fungsinya meningkat secara perlahan.
Kita dapat melihatnya dengan membandingkan secara grafis norma $L^2$ kuadrat dengan norma $L^2$. Sumbu $z$ berkaitan dengan nilai norma dan sumbu $x$ serta $y$ berkaitan dengan dua parameter. Hal yang sama berlaku untuk lebih dari 2 dimensi, tetapi akan sulit untuk memvisualisasikannya.
Norma $L^2$:
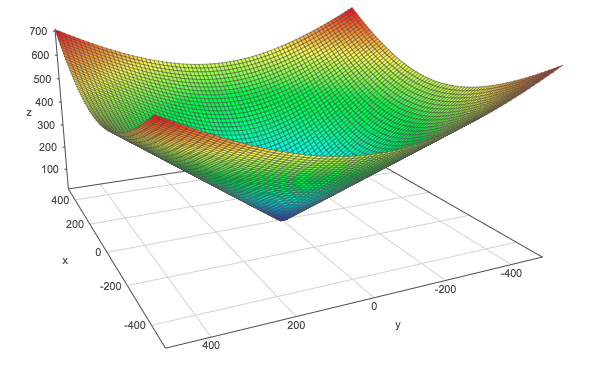
Norma $L^2$ kuadrat:
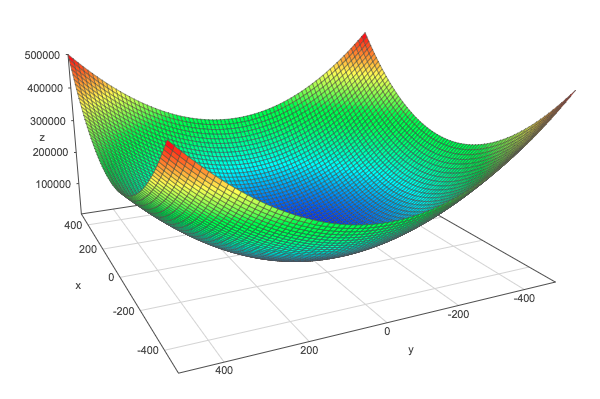
Untuk perbandingan, berikut norma $L^1$:
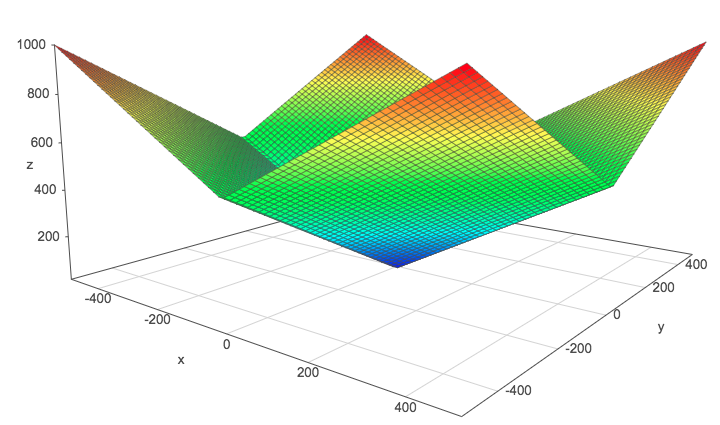
Plot-plot ini dibuat dengan bantuan situs web ini. Cobalah memplot norma-norma ini jika Anda perlu memutarnya untuk memahami bentuknya.
Ini adalah norma $L^\infty$ dan berkaitan dengan nilai absolut dari elemen terbesar dalam vektor.

Ini setara dengan mengambil norma $L^2$ dari matriks setelah diratakan (flattening).
Fungsi Numpy yang sama dapat digunakan:
A = np.array([[1, 2], [6, 4], [3, 2]])
A
array([[1, 2],
       [6, 4],
       [3, 2]])
np.linalg.norm(A)
8.3666002653407556
Perkalian titik antara vektor $\bs{x}$ dan $\bs{y}$ dapat diperoleh kembali dengan norma $L^2$ dari vektor-vektor tersebut. $\theta$ adalah sudut di antara kedua vektor.
Mari ambil dua vektor dalam 2 dimensi:
dan
Plot berikut menunjukkan representasi grafisnya:
x = [0,0,0,2]
y = [0,0,2,2]

plotVectors([x, y], [sns.color_palette()[0], sns.color_palette()[1]])

plt.xlim(-1, 3)
plt.ylim(-1, 3)

plt.text(-0.5, 1, r'$\vec{x}$', size=18, color=sns.color_palette()[0])
plt.text(1.5, 0.5, r'$\vec{y}$', size=18, color=sns.color_palette()[1])
<matplotlib.text.Text at 0x10a33b950>
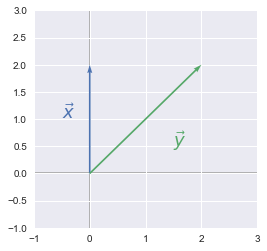
Kita mengambil contoh ini karena kesederhanaannya. Seperti yang dapat kita lihat, sudut $\theta$ sama dengan 45°.
Pertama, mari hitung perkalian titik dari vektor-vektor tersebut:
x = np.array([0, 2])
y = np.array([2, 2])

x.dot(y)
4
Dan sekarang mari hitung normanya:
dan
Jadi dengan rumus di atas, kita punya:
Ini sama hasilnya dengan perkalian titik. Berikut operasi-operasinya menggunakan numpy. Perlu dicatat bahwa kita menggunakan fungsi deg2rad dari Numpy karena np.cos menerima sudut dalam radian, jadi kita harus melakukan konversi.
# Note: np.cos take the angle in radian
np.cos(np.deg2rad(45))*2*np.sqrt(8)
4.0000000000000009
Norma $L^2$ (atau norma Frobenius dalam kasus matriks) dan norma $L^2$ kuadrat banyak digunakan dalam machine learning, deep learning, dan data science pada umumnya. Misalnya, norma dapat digunakan sebagai fungsi biaya. Misalkan Anda ingin mencocokkan sebuah garis ke sekumpulan titik data. Salah satu cara untuk menemukan garis yang lebih baik adalah memulai dengan parameter acak dan melakukan iterasi dengan meminimalkan fungsi biaya. Fungsi biaya adalah fungsi yang merepresentasikan galat model Anda, jadi Anda ingin galat ini sekecil mungkin. Norma berguna di sini karena memberikan cara untuk mengukur galat ini. Norma akan memetakan vektor yang berisi semua galat Anda menjadi sebuah skalar sederhana, dan fungsi biaya adalah skalar ini untuk satu set nilai parameter Anda.
Kita telah melihat bahwa norma tidak lebih dari array yang direduksi menjadi sebuah skalar. Kita juga melihat bahwa ada beberapa variasi bergantung pada fungsi yang kita gunakan untuk menghitungnya. Memilih norma mana yang akan digunakan sangat bergantung pada masalah yang akan dipecahkan karena ada kelebihan dan kekurangan dalam menerapkan satu atau lainnya. Misalnya, norma $L^1$ lebih tangguh daripada norma $L^2$. Ini berarti norma $L^2$ lebih sensitif terhadap pencilan karena nilai galat yang besar akan menghasilkan nilai galat kuadrat yang sangat besar.
Tutorial ini didasarkan pada artikel ini dari seri saya tentang bab aljabar linear dalam Deep Learning Book oleh Goodfellow dkk.
http://www.deeplearningbook.org/contents/linear_algebra.html
https://docs.scipy.org/doc/numpy-1.14.0/reference/generated/numpy.linalg.norm.html
https://hadrienj.github.io/deep-learning-book-series-home/
https://datascience.stackexchange.com/questions/10188/why-do-cost-functions-use-the-square-error
Pelajari lebih lanjut tentang Machine Learning
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



