Corso
Capire il Machine Learning
2 ore
313.7K
L'algebra lineare è uno degli strumenti matematici di base di cui abbiamo bisogno in data science. Avere un po' di dimestichezza con questi concetti può aumentare la comprensione di vari algoritmi. È davvero un'ottima base per un percorso in data science/machine learning.
L'obiettivo di questo tutorial è entrare nella matematica per la data science scrivendo codice con Python/Numpy. Penso che avere tutorial pratici su argomenti teorici come l'algebra lineare possa essere utile, perché scrivere e leggere codice è un buon modo per capire davvero i concetti matematici. E soprattutto, penso che possa essere molto divertente!
Non ci sono prerequisiti particolari, ma se non sei sicuro di cos'è una matrice o di come si fa il prodotto scalare, i primi post (da 1 a 4) della mia serie sul libro di deep learning di Ian Goodfellow sono un buon inizio.
In questo tutorial affronteremo un concetto importante per il machine learning e il deep learning: la norma. La norma è ampiamente usata, ad esempio per valutare la bontà di un modello. Alla fine di questo tutorial, auspicabilmente avrai un'intuizione migliore di questo concetto e del perché sia così prezioso nel machine learning. Vedremo anche come la derivata della norma viene usata per addestrare un algoritmo di machine learning.
Prima di tutto, configureremo le librerie che useremo:
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
E aggiungeremo alcune scorciatoie LaTeX ai comandi bs per i simboli in grassetto e norm per il simbolo della norma:
$$
\newcommand\bs[1]{\boldsymbol{#1}}
\newcommand\norm[1]{\left\lVert#1\right\rVert}
$$
$$ \newcommand\bs[1]{\boldsymbol{#1}} \newcommand\norm[1]{\left\lVert#1\right\rVert} $$
L'ultima cosa da impostare è l'aspetto dei grafici che creeremo:
# Plot parameters
sns.set()
%pylab inline
pylab.rcParams['figure.figsize'] = (4, 4)
plt.rcParams['xtick.major.size'] = 0
plt.rcParams['ytick.major.size'] = 0
Populating the interactive namespace from numpy and matplotlib
Partiamo da un esempio semplice. Immagina di avere un dataset di brani musicali con diverse caratteristiche. Diciamo ora che vuoi costruire un modello che predica la durata di un brano in base ad altre caratteristiche come il genere musicale, la strumentazione, ecc. Hai addestrato un modello e ora vuoi valutarlo nel prevedere la durata di un nuovo brano. Un modo per farlo è prendere dei nuovi dati e predire le durate dei brani con il tuo modello. Poiché per queste osservazioni conosci la durata reale di ogni brano, puoi confrontare durata reale e durata predetta per ciascuna osservazione. Hai i seguenti risultati in secondi per 7 osservazioni:
errorModel1 = [22, -4, 2, 7, 6, -3, 12]
Queste differenze possono essere considerate come l'errore del modello. Un modello perfetto avrebbe solo 0, mentre un modello molto scarso avrebbe valori positivi o negativi enormi.
Ora immagina di provare un altro modello e di ottenere le seguenti differenze tra durate predette e reali dei brani:
errorModel2 = [14, 9, -13, 19, 8, -21, 4]
Cosa puoi fare se vuoi trovare il modello migliore? Un modo naturale sarebbe sommare i valori assoluti di questi errori. Si usa il valore assoluto perché anche un errore negativo (durata reale più piccola della durata predetta) è un errore. Più piccolo è l'errore totale del modello, migliore è il modello:
totalErrorModel1 = np.sum(np.abs(errorModel1))
totalErrorModel1
56
totalErrorModel2 = np.sum(np.abs(errorModel2))
totalErrorModel2
88
Sembra che il modello 1 sia di gran lunga migliore del modello 2.
Congratulazioni! Hai appena calcolato la norma del vettore di errore per ciascun modello!
Puoi pensare alla norma come alla lunghezza del vettore. Per farti un'idea della rappresentazione grafica, riprendiamo il nostro esempio precedente. I vettori di errore sono multidimensionali: c'è una dimensione per osservazione. Nell'ultimo esempio, 7 osservazioni portavano a 7 dimensioni. È ancora piuttosto difficile rappresentare 7 dimensioni, quindi semplifichiamo di nuovo l'esempio e manteniamo solo 2 osservazioni:
errorModel1 = [22, -4]
errorModel2 = [14, 9]
Ora possiamo rappresentare questi vettori considerando che il primo elemento dell'array è la coordinata x e il secondo elemento è la coordinata y. Inizieremo scrivendo una funzione per tracciare i vettori facilmente e farci un'idea delle loro rappresentazioni.
Vogliamo una funzione che ci aiuti a tracciare i vettori. Partiamo dal modo in cui la useremmo. Vogliamo fornire un elenco di array corrispondenti alle coordinate dei vettori e ottenere un grafico di questi vettori. Diciamo che possiamo anche fornire un array di colori per poter differenziare i vettori nei grafici. In sintesi, vorremmo chiamare la funzione così:
plotVectors([vector1, vector2], ['red', 'blue'])
Scriviamo questa funzione:
def plotVectors(vecs, cols, alpha=1):
    """
    Plot set of vectors.

    Parameters
    ----------
    vecs : array-like
        Coordinates of the vectors to plot. Each vector is in an array. For
        instance: [[1, 3], [2, 2]] can be used to plot 2 vectors.
    cols : array-like
        Colors of the vectors. For instance: ['red', 'blue'] will display the
        first vector in red and the second in blue.
    alpha : float
        Opacity of vectors

    Returns:

    fig : instance of matplotlib.figure.Figure
        The figure of the vectors
    """
    plt.axvline(x=0, color='#A9A9A9', zorder=0)
    plt.axhline(y=0, color='#A9A9A9', zorder=0)

    for i in range(len(vecs)):
        if (isinstance(alpha, list)):
            alpha_i = alpha[i]
        else:
            alpha_i = alpha
        if (len(vecs[i])==2):
            x = np.concatenate([[0,0],vecs[i]])
        elif (len(vecs[i])==4):
            x = vecs[i]
        plt.quiver([x[0]],
                   [x[1]],
                   [x[2]],
                   [x[3]],
                   angles='xy', scale_units='xy', scale=1, color=cols[i],
                  alpha=alpha_i)
Prende in input un array di vettori da tracciare (vecs) e i loro colori (cols). Se nel vettore sono specificate solo 2 dimensioni, parte da (0, 0). Sotto il cofano, iteriamo su questo array di vettori e usiamo plt.quiver() per tracciarli.
Usiamo la nostra nuova funzione per tracciare gli errori dei modelli 1 e 2:
plotVectors([errorModel1, errorModel2], [sns.color_palette()[0], sns.color_palette()[1]])

plt.xlim(-1, 25)
plt.ylim(-5, 10)
plt.show()
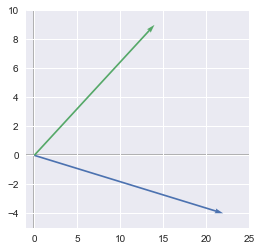
Nota: non abbiamo incluso plt.show() nella funzione per poter aggiungere configurazioni del grafico come qui con i limiti.
Nota 2: abbiamo usato manualmente i colori di seaborn con sns.color_palette()
Quindi abbiamo un vettore di errore per ciascun modello. Il modello migliore è semplicemente quello corrispondente al vettore più piccolo. Un modo per calcolare la lunghezza dei vettori è usare il teorema di Pitagora: $\sqrt{x^2+y^2}$. Possiamo calcolare la lunghezza dei due vettori:
# Length del vettore errorModel1
np.sqrt(errorModel1[0]**2+errorModel1[1]**2)
22.360679774997898
# Length del vettore errorModel2
np.sqrt(errorModel2[0]**2+errorModel2[1]**2)
16.643316977093239
Congratulazioni! Hai appena calcolato un'altra norma dei vettori di errore. La lunghezza del vettore di errore del primo modello è $22{,}36$ e quella del secondo modello è circa $16{,}64$. In questo caso, il secondo modello è migliore, ma ricorda che abbiamo usato solo i primi due valori.
Prima abbiamo calcolato la somma degli errori, ma possiamo anche usare il teorema di Pitagora per calcolare la norma di un vettore. Queste sono due norme diverse e mostra che ci sono più modi per calcolare le norme.
La norma di un vettore può essere qualsiasi funzione che mappa un vettore in un valore positivo. Si possono usare funzioni diverse e ne vedremo alcuni esempi. Queste funzioni possono essere chiamate norme se sono caratterizzate dalle seguenti proprietà:
Le norme sono valori non negativi. Se pensi alle norme come a una lunghezza, è facile capire perché non può essere negativa.
Le norme sono $0$ se e solo se il vettore è il vettore nullo.
Le norme rispettano la disuguaglianza triangolare. Vedi sotto.
$\norm{k\cdot \bs{u}}=\norm{k}\cdot\norm{\bs{u}}$. Qui, $k$ è uno scalare e $\bs{u}$ un vettore. La norma di un vettore moltiplicato per uno scalare è uguale al valore assoluto di questo scalare moltiplicato per la norma del vettore.
Di solito si scrive con due barre verticali: $\norm{\bs{x}}$
Abbiamo visto sopra che una condizione affinché una funzione sia una norma è che rispetti la disuguaglianza triangolare. Significa semplicemente che la norma della somma di alcuni vettori è minore o uguale alla somma delle norme di questi vettori:
Per mostrare cosa significa, prenderemo due vettori, ciascuno contenente due elementi (di nuovo, utile per essere rappresentati come coordinate x e y). I nostri vettori sono:
u = np.array([1, 6])
u
array([1, 6])
e
v = np.array([4, 2])
v
array([4, 2])
Confrontiamo:
e:
Vedremo più avanti diversi tipi di norma, ma per ora useremo una classica: la norma euclidea ($L^2$). La norma $L^2$ può essere calcolata con la funzione di Numpy np.linalg.norm() (vedi maggiori dettagli nella doc).
Vedremo più avanti nel dettaglio cosa sono le norme $L^1$ o $L^2$.
np.linalg.norm(u+v)
9.4339811320566032
e
np.linalg.norm(u)+np.linalg.norm(v)
10.554898485297798
Possiamo vedere che la disuguaglianza triangolare è rispettata poiché:
Vedrai che la rappresentazione grafica di questo teorema lo rende piuttosto banale. Tracceremo i vettori $\bs{u}$, $\bs{v}$ e $\bs{u}+\bs{v}$ usando la nostra funzione plotVectors e aggiungendo del testo per identificare i vettori:
u = np.array([0,0,1,6])
v = np.array([0,0,4,2])
w = u+v

u_bis = [u[2], u[3], v[2], v[3]]

plotVectors([u, u_bis, w],
            [sns.color_palette()[0],
            sns.color_palette()[1],
            sns.color_palette()[2]])

plt.xlim(-2, 6)
plt.ylim(-2, 9)

plt.text(-1, 3.5, r'$||\vec{u}||$', color=sns.color_palette()[0], size=20)
plt.text(2.5, 7.5, r'$||\vec{v}||$', color=sns.color_palette()[1], size=20)
plt.text(2, 2, r'$||\vec{u}+\vec{v}||$', color=sns.color_palette()[2], size=20)

plt.show()
plt.close()
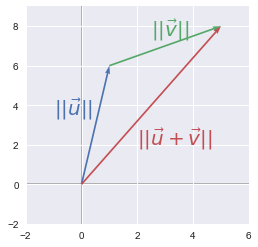
La lunghezza di $\bs{u}$ più la lunghezza di $\bs{v}$ è maggiore della lunghezza del vettore $\bs{u}+\bs{b}$. Geometricamente, significa semplicemente che il percorso più breve tra due punti è una linea!
Abbiamo visto le condizioni richieste alla funzione per essere chiamata norma. Questo significa che ci sono più funzioni che possono essere usate come norme. Vedremo più avanti pro e contro di queste diverse norme. Chiamiamo $p$-norma la seguente categoria di funzioni che dipendono da $p$:
Analizziamo questa equazione passo passo. Vediamo che c'è una somma di elementi, quindi possiamo pensarla come un'iterazione sugli elementi $i$:
Sarà tutto chiaro con esempi usando queste $p$-norme ampiamente utilizzate.
Se $p=0$, la formula diventa:
Vediamo cosa significa. Elevare alla potenza $0$ valori assoluti ti darà un $1$ per ogni valore diverso da $0$ e $0$ per $0$.
Quindi questa norma corrisponde al numero di elementi non nulli nel vettore. In realtà non è propriamente una norma perché se moltiplichi il vettore per $\alpha$, questo numero resta lo stesso (regola 4 sopra).
Se $p=1$, abbiamo semplicemente la somma dei valori assoluti. È ciò che abbiamo usato intuitivamente all'inizio di questo tutorial:

La norma euclidea è la $p$-norma con $p=2$. Questa è forse la norma più usata insieme alla norma $L^2$ al quadrato (vedi sotto).
Possiamo notare che il valore assoluto non è più necessario poiché $x$ è al quadrato. È ciò che avevamo usato quando abbiamo calcolato la lunghezza dei nostri vettori con il teorema di Pitagora sopra.
Vediamo un altro esempio di questa norma:
Graficamente, la norma euclidea corrisponde alla lunghezza del vettore dall'origine al punto ottenuto per combinazione lineare (teorema di Pitagora). Vedremo un esempio in 2 dimensioni: il vettore $\bs{u}$ ha due valori corrispondenti alla coordinata $x$ e alla coordinata $y$. Se tracci il punto con queste coordinate e disegni un vettore dall'origine a questo punto, la norma $L^2$ sarà la lunghezza di questo vettore.
Per esempio:
Iniziamo calcolando la norma con la formula:

Quindi la norma $L^2$ è $5$.
A proposito, ricorda che la norma $L^2$ può essere calcolata con la funzione linalg.norm() di Numpy:
np.linalg.norm([3, 4])
5.0
Ecco la rappresentazione grafica del vettore:
u = np.array([3, 4])

plt.ylim(-1, 5)
plt.xlim(-1, 5)
plotVectors([u], [sns.color_palette()[0]])
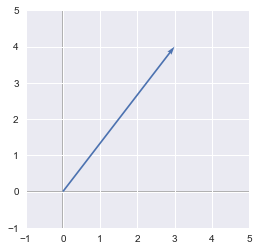
Vediamo che il vettore va dall'origine (0, 0) a (3, 4) e che la sua lunghezza è 5.
In questo caso il vettore è in uno spazio bidimensionale, ma questo vale anche per più dimensioni.
La norma $L^2$ al quadrato è comoda perché rimuove la radice quadrata e ci ritroviamo con la semplice somma di tutti i quadrati dei valori del vettore.
La norma euclidea al quadrato è ampiamente usata nel machine learning anche perché può essere calcolata con l'operazione vettoriale $\bs{x}^\text{T}\bs{x}$. Possono esserci guadagni prestazionali dovuti all'ottimizzazione. Vedi qui e qui per maggiori dettagli.
Vedremo in questo esempio che la norma euclidea al quadrato può essere calcolata con operazioni vettorializzate. Partiamo con un vettore $\bs{x}$:
Come al solito, useremo il codice per verificare il processo. Per prima cosa, creiamo il nostro vettore Numpy $\bs{x}$:
x = np.array([[2], [5], [3], [3]])
x
array([[2],
       [5],
       [3],
       [3]])
Ora prendiamo la trasposta di questo vettore. Questo convertirà semplicemente il vettore colonna iniziale in un vettore riga:
Possiamo calcolare la trasposta di $\bs{x}$ con il metodo T degli oggetti Numpy:
x.T
array([[2, 5, 3, 3]])
Il prodotto scalare di $\bs{x}$ e $\bs{x}^\text{T}$ (vedi qui se ti serve un ripasso sul prodotto scalare) corrisponde in realtà alla moltiplicazione di ciascun elemento per se stesso:

Questa è esattamente la definizione della norma euclidea al quadrato!
Verifichiamo con Numpy. Ricorda (e prova per convincerti) che l'ordine del vettore nel prodotto scalare conta:
euclideanNorm = x.T.dot(x)
euclideanNorm
array([[47]])
Dovrebbe essere la nostra norma euclidea al quadrato! Calcoliamola dalla norma $L^2$ e poi eleviamola al quadrato per verificare che sia corretta:
np.linalg.norm(x)**2
47.0
Funziona! La possibilità di usare un'operazione vettorializzata è un enorme vantaggio rispetto alle altre norme.
Abbiamo visto che le norme possono essere usate per valutare la bontà di un modello riassumendo i vettori di errori.
Ora vogliamo fare un passo avanti e sapere come possiamo cambiare i parametri del nostro modello per ridurre l'errore complessivo. Per farlo possiamo usare una funzione di costo che associa l'errore del modello in funzione dei valori dei parametri. L'algoritmo del gradiente discendente può essere usato per trovare il minimo di questa funzione. Il gradiente discendente si fa calcolando le derivate rispetto a ciascun parametro (derivate parziali = gradienti). Ecco perché è cruciale saper calcolare la derivata in modo efficiente.
In effetti, un grande vantaggio della norma $L^2$ al quadrato è che la sua derivata parziale è facilmente calcolabile. Consideriamo il seguente vettore:
Abbiamo visto che la sua norma $L^2$ al quadrato si calcola con:
Poi, per calcolare le derivate parziali, consideriamo tutte le altre variabili come costanti. Ad esempio, la derivata parziale rispetto a $u_1$ è la derivata di $u_1^2+a$ ($a$ è la costante corrispondente a tutte le altre variabili). Per questo motivo abbiamo le seguenti derivate parziali:
Ciò che è ottimo dei gradienti della norma $L^2$ al quadrato è che le derivate non dipendono dalle altre variabili. Vedremo che non è così con la norma $L^2$.
Nel caso della norma $L^2$, la derivata è più complicata e tiene conto di ogni elemento del vettore. Prendiamo come esempio l'ultimo vettore $\bs{u}$. La norma $L^2$ è:
Calcoliamo la derivata rispetto a $u_1$:

Possiamo vedere che la derivata parziale di $u_1$ contiene ancora $u_2...u_n$. Gli altri gradienti seguono la stessa struttura:
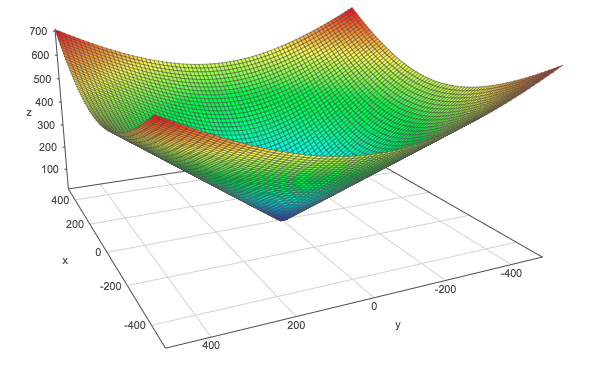
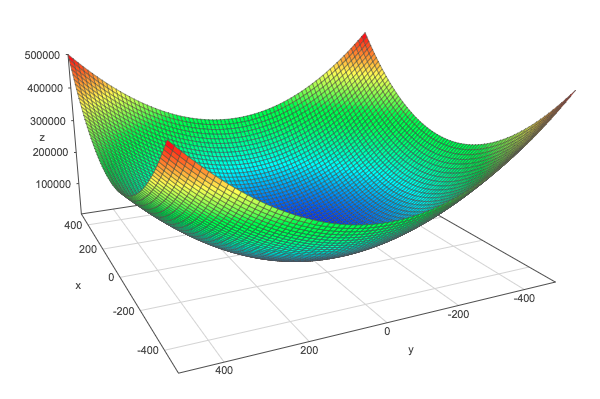
La norma $L^2$ al quadrato è ottima, ma un problema è che discrimina a fatica tra 0 e valori piccoli perché la funzione cresce lentamente.
Possiamo vederlo confrontando graficamente la norma $L^2$ al quadrato con la norma $L^2$. L'asse $z$ corrisponde al valore della norma e gli assi $x$ e $y$ corrispondono a due parametri. La stessa cosa vale con più di 2 dimensioni, ma sarebbe difficile da visualizzare.
Norma $L^2$:
Norma $L^2$ al quadrato:
Per confronto, ecco la norma $L^1$:
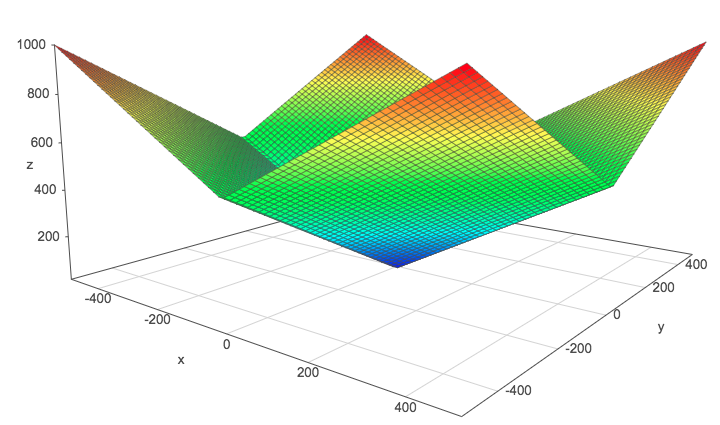
Questi grafici sono stati realizzati con l'aiuto di questo sito web. Vai a tracciare queste norme se hai bisogno di muoverle per coglierne la forma.
È la norma $L^\infty$ e corrisponde al valore assoluto dell'elemento più grande del vettore.

Questo equivale a prendere la norma $L^2$ della matrice dopo l'appiattimento.
Si può usare la stessa funzione Numpy:
A = np.array([[1, 2], [6, 4], [3, 2]])
A
array([[1, 2],
       [6, 4],
       [3, 2]])
np.linalg.norm(A)
8.3666002653407556
Il prodotto scalare tra i vettori $\bs{x}$ e $\bs{y}$ può essere ricavato con le norme $L^2$ di questi vettori. $\theta$ è l'angolo tra i due vettori.
Prendiamo due vettori in 2 dimensioni:
e
Il seguente grafico mostra la loro rappresentazione grafica:
x = [0,0,0,2]
y = [0,0,2,2]

plotVectors([x, y], [sns.color_palette()[0], sns.color_palette()[1]])

plt.xlim(-1, 3)
plt.ylim(-1, 3)

plt.text(-0.5, 1, r'$\vec{x}$', size=18, color=sns.color_palette()[0])
plt.text(1.5, 0.5, r'$\vec{y}$', size=18, color=sns.color_palette()[1])
<matplotlib.text.Text at 0x10a33b950>
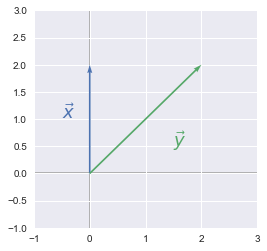
Abbiamo scelto questo esempio per la sua semplicità. Come possiamo vedere, l'angolo $\theta$ è pari a 45°.
Per prima cosa, calcoliamo il prodotto scalare dei vettori:
x = np.array([0, 2])
y = np.array([2, 2])

x.dot(y)
4
E ora calcoliamo le loro norme:
e
Quindi con la formula sopra, abbiamo:
È lo stesso risultato del prodotto scalare. Ecco le operazioni usando numpy. Nota solo che usiamo la funzione deg2rad di Numpy perché np.cos prende l'angolo in radianti, quindi dobbiamo fare la conversione.
# Nota: np.cos prende l'angolo in radianti
np.cos(np.deg2rad(45))*2*np.sqrt(8)
4.0000000000000009
La norma $L^2$ (o la norma di Frobenius nel caso di una matrice) e la norma $L^2$ al quadrato sono ampiamente usate nel machine learning, deep learning e nella data science in generale. Ad esempio, le norme possono essere usate come funzioni di costo. Diciamo che vuoi adattare una retta a un insieme di punti dati. Un modo per trovare la retta migliore è partire da parametri casuali e iterare minimizzando la funzione di costo. La funzione di costo è una funzione che rappresenta l'errore del tuo modello, quindi vuoi che questo errore sia il più piccolo possibile. Le norme sono utili qui perché ti danno un modo per misurare questo errore. La norma mapperà il vettore che contiene tutti i tuoi errori in uno scalare semplice, e la funzione di costo è questo scalare per un insieme di valori dei tuoi parametri.
Abbiamo visto che le norme non sono altro che un array ridotto a uno scalare. Abbiamo anche notato che ci sono alcune variazioni a seconda della funzione che possiamo usare per calcolarla. Scegliere quale norma usare dipende molto dal problema da risolvere, poiché ci sono pro e contro nell'applicarne una o un'altra. Ad esempio, la norma $L^1$ è più robusta della norma $L^2$. Ciò significa che la norma $L^2$ è più sensibile agli outlier, poiché valori di errore significativi daranno enormi valori di errore al quadrato.
Questo tutorial si basa su questo articolo della mia serie sul capitolo di algebra lineare nel Deep Learning Book di Goodfellow et al.
http://www.deeplearningbook.org/contents/linear_algebra.html
https://docs.scipy.org/doc/numpy-1.14.0/reference/generated/numpy.linalg.norm.html
https://hadrienj.github.io/deep-learning-book-series-home/
https://datascience.stackexchange.com/questions/10188/why-do-cost-functions-use-the-square-error
Approfondisci il Machine Learning
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



