Khóa học
Tìm hiểu Machine Learning
2 giờ
313.8K
Đại số tuyến tính là một trong những công cụ toán học cơ bản cần thiết trong khoa học dữ liệu. Hiểu được những khái niệm này sẽ giúp bạn nắm bắt tốt hơn nhiều thuật toán khác nhau. Đây thực sự là nền tảng tuyệt vời cho lộ trình khoa học dữ liệu/machine learning.
Mục tiêu của hướng dẫn này là bước vào toán học cho khoa học dữ liệu bằng cách viết mã với Python/Numpy. Tôi cho rằng các bài hướng dẫn thực hành về các chủ đề lý thuyết như đại số tuyến tính có ích, vì việc viết và đọc mã là cách tốt để thực sự hiểu các khái niệm toán học. Và trên hết, nó có thể rất thú vị!
Không có yêu cầu tiên quyết cụ thể, nhưng nếu bạn chưa chắc một ma trận là gì hoặc cách tính tích vô hướng, thì các bài đầu (1 đến 4) của series của tôi về cuốn sách deep learning của Ian Goodfellow là điểm khởi đầu tốt.
Trong hướng dẫn này, chúng ta sẽ tiếp cận một khái niệm quan trọng đối với machine learning và deep learning: norm (chuẩn). Norm được dùng rộng rãi, ví dụ, để đánh giá mức độ tốt của một mô hình. Cuối hướng dẫn, hi vọng bạn sẽ có trực giác tốt hơn về khái niệm này và vì sao nó rất giá trị trong machine learning. Chúng ta cũng sẽ xem đạo hàm của norm được dùng để huấn luyện thuật toán machine learning như thế nào.
Trước hết, chúng ta sẽ thiết lập các thư viện sẽ dùng:
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
Và thêm một số phím tắt Latex cho các lệnh bs để bôi đậm ký hiệu và norm cho ký hiệu norm:
$$
\newcommand\bs[1]{\boldsymbol{#1}}
\newcommand\norm[1]{\left\lVert#1\right\rVert}
$$
$$ \newcommand\bs[1]{\boldsymbol{#1}} \newcommand\norm[1]{\left\lVert#1\right\rVert} $$
Điều cuối cùng cần thiết lập là giao diện đồ họa mà chúng ta sẽ tạo:
# Plot parameters
sns.set()
%pylab inline
pylab.rcParams['figure.figsize'] = (4, 4)
plt.rcParams['xtick.major.size'] = 0
plt.rcParams['ytick.major.size'] = 0
Populating the interactive namespace from numpy and matplotlib
Hãy bắt đầu với một ví dụ đơn giản. Hình dung bạn có một tập dữ liệu các bài hát với nhiều đặc trưng khác nhau. Giờ giả sử bạn muốn xây dựng một mô hình dự đoán thời lượng bài hát dựa trên các đặc trưng khác như thể loại nhạc, phối khí, v.v. Bạn đã huấn luyện một mô hình và giờ muốn đánh giá khả năng dự đoán thời lượng của một bài hát mới. Một cách là lấy một số dữ liệu mới và dự đoán thời lượng bài hát bằng mô hình của bạn. Vì bạn biết thời lượng thực của mỗi bài hát cho các quan sát này, bạn có thể so sánh thời lượng thực và dự đoán cho từng quan sát. Bạn có các kết quả sau theo giây cho 7 quan sát:
errorModel1 = [22, -4, 2, 7, 6, -3, 12]
Những chênh lệch này có thể xem là lỗi của mô hình. Một mô hình hoàn hảo sẽ chỉ có toàn số 0 trong khi mô hình rất tệ sẽ có các giá trị dương hoặc âm rất lớn.
Giờ hình dung bạn thử một mô hình khác và thu được các chênh lệch sau giữa thời lượng dự đoán và thực:
errorModel2 = [14, 9, -13, 19, 8, -21, 4]
Bạn có thể làm gì nếu muốn tìm mô hình tốt nhất? Cách tự nhiên là lấy tổng giá trị tuyệt đối của các lỗi này. Dùng giá trị tuyệt đối vì lỗi âm (thời lượng thực nhỏ hơn thời lượng dự đoán) cũng là lỗi. Mô hình có tổng lỗi nhỏ hơn thì tốt hơn:
totalErrorModel1 = np.sum(np.abs(errorModel1))
totalErrorModel1
56
totalErrorModel2 = np.sum(np.abs(errorModel2))
totalErrorModel2
88
Có vẻ mô hình 1 tốt hơn hẳn mô hình 2.
Chúc mừng! Bạn vừa tính norm của vector lỗi cho mỗi mô hình!
Bạn có thể nghĩ norm như là độ dài của vector. Để hình dung đồ họa, hãy quay lại ví dụ trước. Các vector lỗi là đa chiều: có một chiều cho mỗi quan sát. Trong ví dụ, 7 quan sát dẫn đến 7 chiều. Vẫn khá khó để biểu diễn 7 chiều nên hãy đơn giản hóa và chỉ giữ 2 quan sát:
errorModel1 = [22, -4]
errorModel2 = [14, 9]
Giờ ta có thể biểu diễn các vector này với phần tử đầu tiên là tọa độ x và phần tử thứ hai là tọa độ y. Ta sẽ bắt đầu bằng cách viết một hàm để vẽ vector cho dễ và có cái nhìn về biểu diễn của chúng.
Ta muốn một hàm giúp vẽ các vector. Bắt đầu từ cách ta sẽ dùng nó. Ta muốn truyền một danh sách các mảng tương ứng với tọa độ của các vector và nhận về một biểu đồ các vector đó. Giả sử ta cũng có thể truyền một mảng màu để phân biệt các vector trên biểu đồ. Tóm lại, ta muốn gọi hàm như sau:
plotVectors([vector1, vector2], ['red', 'blue'])
Hãy viết hàm này:
def plotVectors(vecs, cols, alpha=1):
    """
    Plot set of vectors.

    Parameters
    ----------
    vecs : array-like
        Coordinates of the vectors to plot. Each vector is in an array. For
        instance: [[1, 3], [2, 2]] can be used to plot 2 vectors.
    cols : array-like
        Colors of the vectors. For instance: ['red', 'blue'] will display the
        first vector in red and the second in blue.
    alpha : float
        Opacity of vectors

    Returns:

    fig : instance of matplotlib.figure.Figure
        The figure of the vectors
    """
    plt.axvline(x=0, color='#A9A9A9', zorder=0)
    plt.axhline(y=0, color='#A9A9A9', zorder=0)

    for i in range(len(vecs)):
        if (isinstance(alpha, list)):
            alpha_i = alpha[i]
        else:
            alpha_i = alpha
        if (len(vecs[i])==2):
            x = np.concatenate([[0,0],vecs[i]])
        elif (len(vecs[i])==4):
            x = vecs[i]
        plt.quiver([x[0]],
                   [x[1]],
                   [x[2]],
                   [x[3]],
                   angles='xy', scale_units='xy', scale=1, color=cols[i],
                  alpha=alpha_i)
Hàm nhận một mảng các vector cần vẽ (vecs) và màu của chúng (cols) làm đầu vào. Nếu chỉ định 2 chiều trong vector, nó sẽ bắt đầu tại (0, 0). Bên trong, ta lặp qua mảng vector này và dùng plt.quiver() để vẽ.
Hãy dùng hàm mới để vẽ lỗi của mô hình 1 và 2:
plotVectors([errorModel1, errorModel2], [sns.color_palette()[0], sns.color_palette()[1]])

plt.xlim(-1, 25)
plt.ylim(-5, 10)
plt.show()
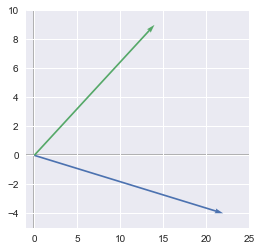
Lưu ý: chúng ta không đưa plt.show() vào trong hàm để có thể thêm cấu hình biểu đồ như giới hạn trục ở đây.
Lưu ý 2: ta đã dùng màu từ seaborn thủ công với sns.color_palette()
Vậy ta có một vector lỗi cho mỗi mô hình. Mô hình tốt hơn là mô hình tương ứng với vector ngắn hơn. Một cách để tính độ dài vector là dùng định lý Pythagoras: $\sqrt{x^2+y^2}$. Ta có thể tính độ dài hai vector:
# Lenght of the vector errorModel1
np.sqrt(errorModel1[0]**2+errorModel1[1]**2)
22.360679774997898
# Lenght of the vector errorModel2
np.sqrt(errorModel2[0]**2+errorModel2[1]**2)
16.643316977093239
Chúc mừng! Bạn vừa tính một norm khác của các vector lỗi. Độ dài vector lỗi của mô hình đầu tiên là $22.36$ và của mô hình thứ hai khoảng $16.64$. Trong trường hợp này, mô hình thứ hai tốt hơn, nhưng nhớ rằng ta chỉ dùng hai giá trị đầu tiên.
Ban đầu ta tính tổng lỗi, nhưng ta cũng có thể dùng định lý Pythagoras để tính norm của một vector. Đây là hai norm khác nhau, cho thấy có nhiều cách tính norm.
Norm của một vector có thể là bất kỳ hàm nào ánh xạ một vector sang một giá trị dương. Có thể dùng các hàm khác nhau và ta sẽ xem vài ví dụ. Những hàm này được gọi là norm nếu chúng thỏa mãn các tính chất sau:
Norm là các giá trị không âm. Nếu coi norm như độ dài, bạn dễ thấy vì sao nó không thể âm.
Norm bằng $0$ khi và chỉ khi vector là vector không.
Norm thỏa bất đẳng thức tam giác. Xem dưới đây.
$\norm{k\cdot \bs{u}}=\norm{k}\cdot\norm{\bs{u}}$. Ở đây, $k$ là một vô hướng và $\bs{u}$ là một vector. Norm của một vector nhân với một vô hướng bằng giá trị tuyệt đối của vô hướng đó nhân với norm của vector.
Thường được viết với hai thanh dọc: $\norm{\bs{x}}$
Ta đã thấy ở trên rằng một điều kiện để một hàm được gọi là norm là nó thỏa bất đẳng thức tam giác. Điều này đơn giản có nghĩa norm của tổng một số vector nhỏ hơn hoặc bằng tổng norm của các vector đó:
Để minh họa điều này, ta lấy hai vector, mỗi vector gồm hai phần tử (một lần nữa, hữu ích để biểu diễn như tọa độ x và y). Các vector của ta là:
u = np.array([1, 6])
u
array([1, 6])
và
v = np.array([4, 2])
v
array([4, 2])
Hãy so sánh:
và:
Chúng ta sẽ xem các loại norm khác nhau sau, nhưng hiện tại ta dùng một norm kinh điển: Euclidean Norm ($L^2$). Norm $L^2$ có thể tính bằng hàm Numpy np.linalg.norm() (xem chi tiết trong tài liệu).
Ta sẽ xem chi tiết sau $L^1$ hay $L^2$ là gì.
np.linalg.norm(u+v)
9.4339811320566032
và
np.linalg.norm(u)+np.linalg.norm(v)
10.554898485297798
Ta thấy bất đẳng thức tam giác được thỏa mãn vì:
Bạn sẽ thấy biểu diễn đồ họa của định lý này khiến nó trở nên khá hiển nhiên. Ta sẽ vẽ các vector $\bs{u}$, $\bs{v}$ và $\bs{u}+\bs{v}$ bằng hàm plotVectors và thêm một ít chữ để định danh các vector:
u = np.array([0,0,1,6])
v = np.array([0,0,4,2])
w = u+v

u_bis = [u[2], u[3], v[2], v[3]]

plotVectors([u, u_bis, w],
            [sns.color_palette()[0],
            sns.color_palette()[1],
            sns.color_palette()[2]])

plt.xlim(-2, 6)
plt.ylim(-2, 9)

plt.text(-1, 3.5, r'$||\vec{u}||$', color=sns.color_palette()[0], size=20)
plt.text(2.5, 7.5, r'$||\vec{v}||$', color=sns.color_palette()[1], size=20)
plt.text(2, 2, r'$||\vec{u}+\vec{v}||$', color=sns.color_palette()[2], size=20)

plt.show()
plt.close()
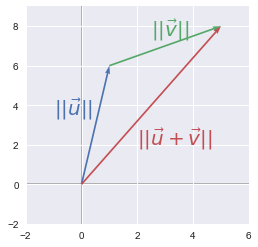
Độ dài của $\bs{u}$ cộng với độ dài của $\bs{v}$ lớn hơn độ dài của vector $\bs{u}+\bs{b}$. Về mặt hình học, điều này đơn giản có nghĩa là con đường ngắn nhất giữa hai điểm là một đường thẳng!
Ta đã thấy các điều kiện yêu cầu để một hàm được gọi là norm. Điều này có nghĩa là có nhiều hàm có thể dùng làm norm. Ta sẽ xem ưu/nhược điểm của các norm khác nhau sau. Ta gọi $p$-norm là hạng mục hàm sau phụ thuộc vào $p$:
Hãy đi từng bước qua công thức này. Ta thấy có tổng các phần tử nên có thể nghĩ là lặp qua các phần tử $i$:
Điều này sẽ rõ ràng hơn với các ví dụ dùng những $p$-norm phổ biến.
Nếu $p=0$, công thức trở thành:
Hãy xem ý nghĩa của nó. Dùng lũy thừa $0$ với giá trị tuyệt đối sẽ cho $1$ với mọi giá trị khác $0$ và $0$ với chính $0$.
Do đó norm này tương ứng với số phần tử khác không trong vector. Nó không thực sự là một norm vì nếu bạn nhân vector với $\alpha$, con số này vẫn vậy (quy tắc 4 ở trên).
Nếu $p=1$, ta đơn giản có tổng các giá trị tuyệt đối. Đây là điều ta đã dùng theo trực giác lúc đầu hướng dẫn:

Euclidean norm là $p$-norm với $p=2$. Đây có lẽ là norm được dùng nhiều nhất cùng với norm $L^2$ bình phương (xem dưới).
Ta có thể lưu ý rằng không cần giá trị tuyệt đối nữa vì $x$ được bình phương. Đây chính là điều ta đã dùng khi tính độ dài vector bằng định lý Pythagoras ở trên.
Hãy xem ví dụ khác về norm này:
Về đồ họa, Euclidean norm tương ứng với độ dài vector từ gốc tọa độ đến điểm thu được bằng tổ hợp tuyến tính (định lý Pythagoras). Ta sẽ xem ví dụ 2 chiều: vector $\bs{u}$ có hai giá trị tương ứng với tọa độ $x$ và tọa độ $y$. Nếu bạn vẽ điểm với các tọa độ này và kẻ một vector từ gốc đến điểm này, norm $L^2$ sẽ là độ dài của vector đó.
Chẳng hạn:
Bắt đầu bằng tính norm theo công thức:

Vậy norm $L^2$ là $5$.
Nhân tiện, nhớ rằng norm $L^2$ có thể tính bằng hàm linalg.norm() của Numpy:
np.linalg.norm([3, 4])
5.0
Đây là biểu diễn đồ họa của vector:
u = np.array([3, 4])

plt.ylim(-1, 5)
plt.xlim(-1, 5)
plotVectors([u], [sns.color_palette()[0]])
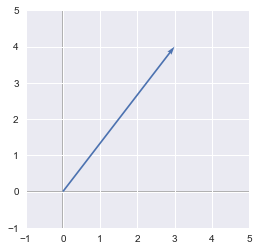
Ta thấy vector đi từ gốc (0, 0) đến (3, 4) và độ dài của nó là 5.
Trong trường hợp này, vector ở không gian 2 chiều, nhưng điều này cũng đúng cho nhiều chiều hơn.
Norm $L^2$ bình phương tiện lợi vì loại bỏ căn bậc hai và ta chỉ còn tổng các bình phương của từng giá trị trong vector.
Euclidean norm bình phương được dùng rộng rãi trong machine learning một phần vì nó có thể tính bằng phép toán vector $\bs{x}^\text{T}\bs{x}$. Có thể có lợi ích hiệu năng do tối ưu hóa. Xem ở đây và ở đây để biết thêm chi tiết.
Trong ví dụ này ta sẽ thấy Euclidean norm bình phương có thể tính bằng các phép toán vector hóa. Hãy bắt đầu với một vector $\bs{x}$:
Như thường lệ, ta sẽ dùng mã để kiểm tra quá trình. Trước hết, tạo vector Numpy $\bs{x}$:
x = np.array([[2], [5], [3], [3]])
x
array([[2],
       [5],
       [3],
       [3]])
Giờ lấy chuyển vị của vector này. Điều này chỉ chuyển vector cột ban đầu thành vector hàng:
Ta có thể tính chuyển vị của $\bs{x}$ với thuộc tính T của đối tượng Numpy:
x.T
array([[2, 5, 3, 3]])
Tích vô hướng của $\bs{x}$ và $\bs{x}^\text{T}$ (xem ở đây nếu bạn cần nhắc lại về tích vô hướng) thực chất tương ứng với việc nhân mỗi phần tử với chính nó:

Đây chính là định nghĩa của Euclidean norm bình phương!
Hãy kiểm tra với Numpy. Nhớ (và thử để tự thuyết phục) rằng thứ tự vector trong tích vô hướng là quan trọng:
euclideanNorm = x.T.dot(x)
euclideanNorm
array([[47]])
Đây phải là Euclidean norm bình phương của ta! Hãy tính từ norm $L^2$ và bình phương nó để kiểm tra:
np.linalg.norm(x)**2
47.0
Hoạt động rồi! Khả năng dùng phép toán vector hóa là lợi thế lớn so với các norm khác.
Ta đã thấy norm có thể dùng để đánh giá mức độ tốt của mô hình bằng cách tóm tắt các vector lỗi.
Giờ ta muốn tiến thêm bước nữa và biết cách thay đổi tham số mô hình để giảm lỗi tổng thể. Để làm điều đó ta có thể dùng một hàm chi phí gắn lỗi của mô hình theo giá trị các tham số. Thuật toán gradient descent có thể dùng để tìm cực tiểu của hàm này. Gradient descent được thực hiện bằng cách tính đạo hàm theo từng tham số (đạo hàm riêng = gradient). Đây là lý do tại sao việc tính đạo hàm hiệu quả là rất quan trọng.
Thật vậy, một lợi thế lớn của norm $L^2$ bình phương là đạo hàm riêng của nó được tính dễ dàng. Giả sử có vector sau:
Ta đã thấy norm $L^2$ bình phương của nó được tính bằng:
Sau đó, để tính đạo hàm riêng, ta coi các biến khác là hằng số. Chẳng hạn, đạo hàm riêng theo $u_1$ là đạo hàm của $u_1^2+a$ ($a$ là hằng ứng với các biến còn lại). Vì lý do này, ta có các đạo hàm riêng sau:
Điều tuyệt vời ở gradient của norm $L^2$ bình phương là các đạo hàm không phụ thuộc vào các biến khác. Ta sẽ thấy điều này không đúng với norm $L^2$.
Trong trường hợp norm $L^2$, đạo hàm phức tạp hơn và tính đến mọi phần tử của vector. Hãy lấy vector $\bs{u}$ ở trên làm ví dụ. Norm $L^2$ là:
Hãy tính đạo hàm của nó theo $u_1$:

Ta thấy đạo hàm riêng theo $u_1$ vẫn chứa $u_2...u_n$. Các gradient khác theo cùng cấu trúc:
Norm $L^2$ bình phương rất hay, nhưng một vấn đề là nó phân biệt kém giữa 0 và các giá trị nhỏ vì hàm tăng chậm.
Ta có thể thấy điều này bằng cách so sánh đồ họa norm $L^2$ bình phương với norm $L^2$. Trục $z$ tương ứng với giá trị của norm còn trục $x$ và $y$ tương ứng với hai tham số. Điều tương tự đúng với nhiều hơn 2 chiều, nhưng sẽ khó hình dung.
Norm $L^2$:
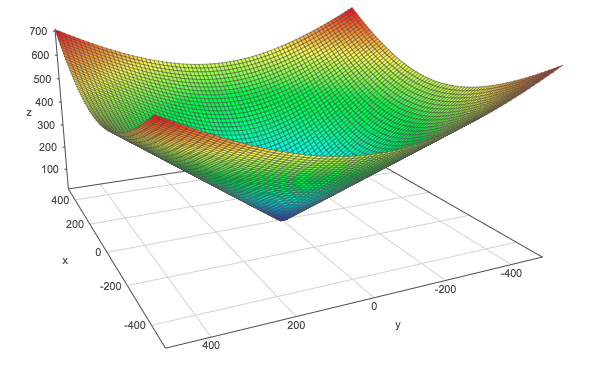
Norm $L^2$ bình phương:
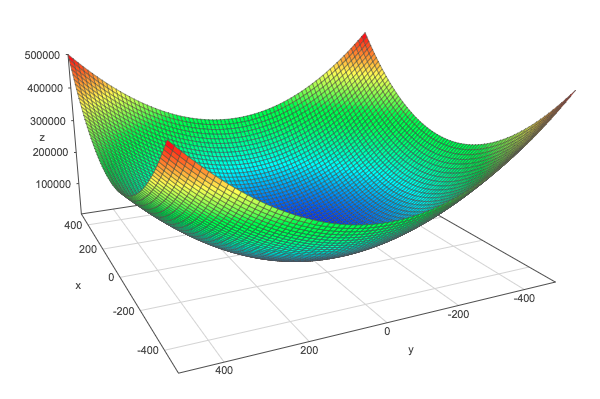
Để so sánh, đây là norm $L^1$:
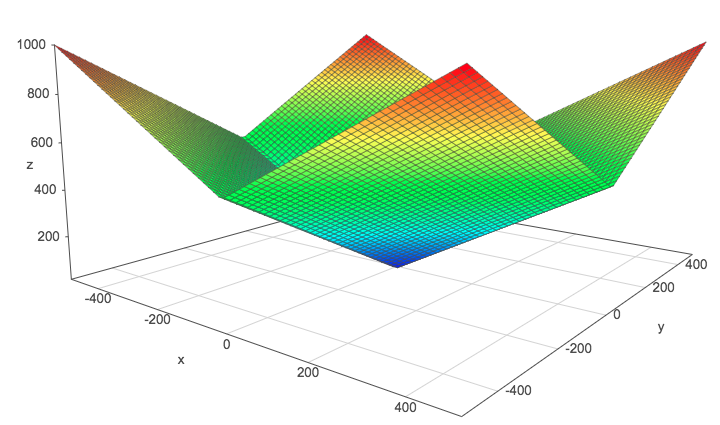
Những đồ thị này được thực hiện với sự trợ giúp của trang web này. Hãy vào và vẽ các norm này nếu bạn cần xoay chúng để nắm bắt hình dạng.
Đây là norm $L^\infty$ và tương ứng với giá trị tuyệt đối của phần tử lớn nhất trong vector.

Điều này tương đương với việc lấy norm $L^2$ của ma trận sau khi làm phẳng.
Có thể dùng cùng một hàm Numpy:
A = np.array([[1, 2], [6, 4], [3, 2]])
A
array([[1, 2],
       [6, 4],
       [3, 2]])
np.linalg.norm(A)
8.3666002653407556
Tích vô hướng giữa các vector $\bs{x}$ và $\bs{y}$ có thể được suy ra nhờ các norm $L^2$ của chúng. $\theta$ là góc giữa hai vector.
Hãy lấy hai vector trong không gian 2 chiều:
và
Biểu đồ sau cho thấy biểu diễn đồ họa của chúng:
x = [0,0,0,2]
y = [0,0,2,2]

plotVectors([x, y], [sns.color_palette()[0], sns.color_palette()[1]])

plt.xlim(-1, 3)
plt.ylim(-1, 3)

plt.text(-0.5, 1, r'$\vec{x}$', size=18, color=sns.color_palette()[0])
plt.text(1.5, 0.5, r'$\vec{y}$', size=18, color=sns.color_palette()[1])
<matplotlib.text.Text at 0x10a33b950>
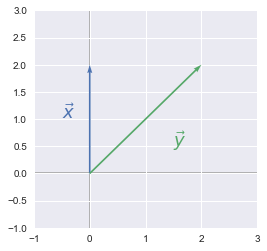
Ta chọn ví dụ này vì sự đơn giản của nó. Như ta thấy, góc $\theta$ bằng 45°.
Đầu tiên, hãy tính tích vô hướng của các vector:
x = np.array([0, 2])
y = np.array([2, 2])

x.dot(y)
4
Và giờ hãy tính các norm của chúng:
và
Vậy theo công thức trên, ta có:
Đây là cùng kết quả với tích vô hướng. Dưới đây là các phép tính dùng numpy. Lưu ý là ta dùng hàm deg2rad của Numpy vì np.cos nhận góc theo radian, nên ta phải chuyển đổi.
# Note: np.cos take the angle in radian
np.cos(np.deg2rad(45))*2*np.sqrt(8)
4.0000000000000009
Norm $L^2$ (hoặc Frobenius norm trong trường hợp ma trận) và norm $L^2$ bình phương được dùng rộng rãi trong machine learning, deep learning và khoa học dữ liệu nói chung. Ví dụ, norm có thể dùng làm hàm chi phí. Giả sử bạn muốn fit một đường thẳng cho một tập điểm dữ liệu. Một cách để tìm đường thẳng tốt hơn là bắt đầu với tham số ngẫu nhiên và lặp lại bằng cách tối thiểu hóa hàm chi phí. Hàm chi phí là một hàm biểu diễn lỗi của mô hình, nên bạn muốn lỗi này càng nhỏ càng tốt. Norm hữu ích ở đây vì nó cho bạn cách đo lỗi này. Norm sẽ ánh xạ vector chứa tất cả lỗi của bạn thành một số vô hướng đơn giản, và hàm chi phí chính là số vô hướng này cho một tập giá trị tham số của bạn.
Ta đã thấy norm chẳng qua là đưa một mảng về một số vô hướng. Ta cũng nhận thấy có vài biến thể theo hàm ta dùng để tính nó. Việc chọn dùng norm nào phụ thuộc rất nhiều vào bài toán cần giải vì áp dụng cái này hay cái kia đều có ưu/nhược. Ví dụ, norm $L^1$ bền vững hơn norm $L^2$. Điều này có nghĩa là norm $L^2$ nhạy cảm hơn với ngoại lệ vì các giá trị lỗi lớn sẽ cho ra giá trị lỗi bình phương rất lớn.
Hướng dẫn này dựa trên bài viết này từ series của tôi về chương đại số tuyến tính trong cuốn Deep Learning Book của Goodfellow và cộng sự.
http://www.deeplearningbook.org/contents/linear_algebra.html
https://docs.scipy.org/doc/numpy-1.14.0/reference/generated/numpy.linalg.norm.html
https://hadrienj.github.io/deep-learning-book-series-home/
https://datascience.stackexchange.com/questions/10188/why-do-cost-functions-use-the-square-error
Tìm hiểu thêm về Machine Learning
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
