Cours
Comprendre le Machine Learning
2 h
308.2K
L’algèbre linéaire fait partie des outils mathématiques incontournables en data science. Maîtriser ces notions renforce votre compréhension de nombreux algorithmes. C’est une base solide pour un parcours en data science et en machine learning.
L’objectif de ce tutoriel est d’entrer dans les mathématiques pour la data science en codant avec Python/Numpy. Des tutoriels pratiques sur des sujets théoriques comme l’algèbre linéaire sont précieux, car écrire et lire du code est une excellente façon d’assimiler réellement les concepts mathématiques. Et surtout, c’est très ludique !
Il n’y a pas de prérequis particuliers, mais si vous n’êtes pas certain·e de ce qu’est une matrice ou de la façon d’effectuer un produit scalaire, les premiers billets (1 à 4) de ma série sur le livre de deep learning d’Ian Goodfellow constituent un bon point de départ.
Dans ce tutoriel, nous allons aborder une notion essentielle pour le machine learning et le deep learning : la norme. La norme est largement utilisée, par exemple pour évaluer la qualité d’un modèle. À la fin de ce tutoriel, vous aurez, espérons-le, une meilleure intuition de ce concept et de pourquoi il est si précieux en machine learning. Nous verrons aussi comment la dérivée de la norme est utilisée pour entraîner un algorithme d’apprentissage.
Avant tout, configurons les bibliothèques dont nous aurons besoin :
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
Et ajoutons quelques raccourcis LaTeX pour les commandes bs (symboles en gras) et norm (symbole de la norme) :
$$
\newcommand\bs[1]{\boldsymbol{#1}}
\newcommand\norm[1]{\left\lVert#1\right\rVert}
$$
$$ \newcommand\bs[1]{\boldsymbol{#1}} \newcommand\norm[1]{\left\lVert#1\right\rVert} $$
Dernier point de configuration : l’apparence des graphiques que nous allons créer :
# Plot parameters
sns.set()
%pylab inline
pylab.rcParams['figure.figsize'] = (4, 4)
plt.rcParams['xtick.major.size'] = 0
plt.rcParams['ytick.major.size'] = 0
Populating the interactive namespace from numpy and matplotlib
Commençons par un exemple simple. Imaginez un jeu de données de morceaux de musique avec différentes caractéristiques. Supposons que vous vouliez bâtir un modèle qui prédit la durée d’un morceau en fonction d’autres variables comme le genre musical, l’instrumentation, etc. Vous avez entraîné un modèle et vous souhaitez maintenant l’évaluer sur la prédiction de la durée d’un nouveau morceau. Une façon de procéder est de prendre de nouvelles données et de prédire les durées avec votre modèle. Comme vous connaissez la durée réelle de chaque morceau pour ces observations, vous pouvez comparer la durée réelle et la durée prédite pour chacune. Vous obtenez les résultats suivants, en secondes, pour 7 observations :
errorModel1 = [22, -4, 2, 7, 6, -3, 12]
Ces écarts représentent l’erreur du modèle. Un modèle parfait n’aurait que des 0, tandis qu’un très mauvais modèle aurait de grandes valeurs positives ou négatives.
Imaginons maintenant que vous testiez un autre modèle et que vous obteniez les écarts suivants entre durées prédites et réelles :
errorModel2 = [14, 9, -13, 19, 8, -21, 4]
Comment choisir le meilleur modèle ? Une approche naturelle consiste à sommer les valeurs absolues de ces erreurs. On utilise la valeur absolue car une erreur négative (durée réelle inférieure à la durée prédite) reste une erreur. Plus la somme totale est faible, meilleur est le modèle :
totalErrorModel1 = np.sum(np.abs(errorModel1))
totalErrorModel1
56
totalErrorModel2 = np.sum(np.abs(errorModel2))
totalErrorModel2
88
Il semble que le modèle 1 soit nettement meilleur que le modèle 2.
Félicitations ! Vous venez de calculer la norme du vecteur d’erreurs pour chaque modèle !
Vous pouvez voir la norme comme la longueur d’un vecteur. Pour visualiser cela, reprenons l’exemple précédent. Les vecteurs d’erreurs sont multidimensionnels : une dimension par observation. Dans l’exemple, 7 observations donnent 7 dimensions. Comme il est difficile de représenter 7 dimensions, simplifions encore et gardons seulement 2 observations :
errorModel1 = [22, -4]
errorModel2 = [14, 9]
Nous pouvons représenter ces vecteurs en considérant que le premier élément du tableau est l’abscisse x et le second l’ordonnée y. Commençons par écrire une fonction pour tracer facilement les vecteurs et visualiser leur représentation.
Nous voulons une fonction qui nous aide à tracer les vecteurs. Voici comment nous aimerions l’utiliser : lui fournir une liste de tableaux correspondant aux coordonnées des vecteurs et obtenir le tracé. Disons aussi que nous pouvons passer un tableau de couleurs pour différencier les vecteurs sur les graphiques. En résumé, nous voudrions l’appeler ainsi :
plotVectors([vector1, vector2], ['red', 'blue'])
Écrivons cette fonction :
def plotVectors(vecs, cols, alpha=1):
    """
    Plot set of vectors.

    Parameters
    ----------
    vecs : array-like
        Coordinates of the vectors to plot. Each vector is in an array. For
        instance: [[1, 3], [2, 2]] can be used to plot 2 vectors.
    cols : array-like
        Colors of the vectors. For instance: ['red', 'blue'] will display the
        first vector in red and the second in blue.
    alpha : float
        Opacity of vectors

    Returns:

    fig : instance of matplotlib.figure.Figure
        The figure of the vectors
    """
    plt.axvline(x=0, color='#A9A9A9', zorder=0)
    plt.axhline(y=0, color='#A9A9A9', zorder=0)

    for i in range(len(vecs)):
        if (isinstance(alpha, list)):
            alpha_i = alpha[i]
        else:
            alpha_i = alpha
        if (len(vecs[i])==2):
            x = np.concatenate([[0,0],vecs[i]])
        elif (len(vecs[i])==4):
            x = vecs[i]
        plt.quiver([x[0]],
                   [x[1]],
                   [x[2]],
                   [x[3]],
                   angles='xy', scale_units='xy', scale=1, color=cols[i],
                  alpha=alpha_i)
Elle prend en entrée un tableau de vecteurs à tracer (vecs) et leurs couleurs (cols). Si seulement 2 dimensions sont spécifiées, le vecteur démarre en (0, 0). En interne, on itère sur ce tableau et on utilise plt.quiver() pour les tracer.
Utilisons notre fonction pour représenter les erreurs des modèles 1 et 2 :
plotVectors([errorModel1, errorModel2], [sns.color_palette()[0], sns.color_palette()[1]])

plt.xlim(-1, 25)
plt.ylim(-5, 10)
plt.show()
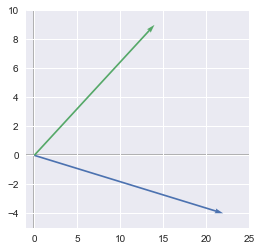
Remarque : nous n’avons pas inclus plt.show() dans la fonction afin de pouvoir ajouter des réglages comme ici les limites d’axes.
Remarque 2 : nous avons utilisé manuellement les couleurs de seaborn avec sns.color_palette()
Nous avons donc un vecteur d’erreur par modèle. Le meilleur modèle est celui associé au plus petit vecteur. Une façon de calculer la longueur des vecteurs est d’utiliser le théorème de Pythagore : $\sqrt{x^2+y^2}$. Calculons la longueur des deux vecteurs :
# Lenght of the vector errorModel1
np.sqrt(errorModel1[0]**2+errorModel1[1]**2)
22.360679774997898
# Lenght of the vector errorModel2
np.sqrt(errorModel2[0]**2+errorModel2[1]**2)
16.643316977093239
Félicitations ! Vous venez de calculer une autre norme des vecteurs d’erreur. La longueur du vecteur d’erreur du premier modèle est $22{,}36$ et celle du second est d’environ $16{,}64$. Dans ce cas, le deuxième modèle est meilleur, mais souvenez-vous que nous n’avons utilisé que les deux premières valeurs.
Nous avons d’abord calculé la somme des erreurs, mais on peut aussi utiliser Pythagore pour obtenir la norme d’un vecteur. Ce sont deux normes différentes, ce qui montre qu’il existe plusieurs façons de définir une norme.
La norme d’un vecteur est toute fonction qui associe à ce vecteur une valeur positive. Différentes fonctions existent, et nous allons en voir quelques-unes. Ces fonctions peuvent être appelées normes si elles vérifient les propriétés suivantes :
Les normes sont toujours non négatives. Si vous les voyez comme une longueur, il est évident qu’elles ne peuvent pas être négatives.
La norme vaut $0$ si et seulement si le vecteur est le vecteur nul.
Les normes respectent l’inégalité triangulaire. Voir ci-dessous.
$\norm{k\cdot \bs{u}}=\norm{k}\cdot\norm{\bs{u}}$. Ici, $k$ est un scalaire et $\bs{u}$ un vecteur. La norme d’un vecteur multiplié par un scalaire est égale à la valeur absolue de ce scalaire multipliée par la norme du vecteur.
On la note généralement avec deux barres verticales : $\norm{\bs{x}}$
Nous avons vu qu’une condition pour qu’une fonction soit une norme est qu’elle respecte l’inégalité triangulaire. Cela signifie que la norme de la somme de vecteurs est inférieure ou égale à la somme des normes de ces vecteurs :
Pour illustrer, prenons deux vecteurs à deux composantes (pratiques à représenter en coordonnées x et y). Nos vecteurs sont :
u = np.array([1, 6])
u
array([1, 6])
et
v = np.array([4, 2])
v
array([4, 2])
Comparons :
et :
Nous verrons plus loin différents types de normes, mais pour l’instant utilisons la plus classique : la norme euclidienne ($L^2$). La norme $L^2$ se calcule avec la fonction Numpy np.linalg.norm() (voir la documentation).
Nous verrons ensuite en détail ce que sont les normes $L^1$ et $L^2$.
np.linalg.norm(u+v)
9.4339811320566032
et
np.linalg.norm(u)+np.linalg.norm(v)
10.554898485297798
On constate que l’inégalité triangulaire est respectée puisque :
La représentation graphique rend ce théorème assez évident. Traçons les vecteurs $\bs{u}$, $\bs{v}$ et $\bs{u}+\bs{v}$ avec notre fonction plotVectors et ajoutons du texte pour les identifier :
u = np.array([0,0,1,6])
v = np.array([0,0,4,2])
w = u+v

u_bis = [u[2], u[3], v[2], v[3]]

plotVectors([u, u_bis, w],
            [sns.color_palette()[0],
            sns.color_palette()[1],
            sns.color_palette()[2]])

plt.xlim(-2, 6)
plt.ylim(-2, 9)

plt.text(-1, 3.5, r'$||\vec{u}||$', color=sns.color_palette()[0], size=20)
plt.text(2.5, 7.5, r'$||\vec{v}||$', color=sns.color_palette()[1], size=20)
plt.text(2, 2, r'$||\vec{u}+\vec{v}||$', color=sns.color_palette()[2], size=20)

plt.show()
plt.close()
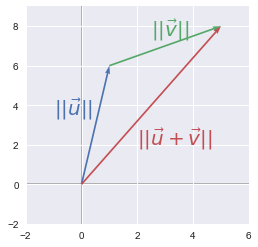
La longueur de $\bs{u}$ plus la longueur de $\bs{v}$ est supérieure à la longueur du vecteur $\bs{u}+\bs{v}$. Géométriquement, cela signifie simplement que le plus court chemin entre deux points est la ligne droite !
Nous avons vu les conditions requises pour qu’une fonction soit une norme. Il existe donc plusieurs fonctions utilisables comme normes. Nous verrons plus loin les avantages et limites de chacune. On appelle $p$-norme la catégorie de fonctions dépendant de $p$ suivante :
Décomposons cette équation. On y voit une somme d’éléments, donc une itération sur les $i$ composantes :
Ce sera clair avec des exemples des $p$-normes les plus utilisées.
Si $p=0$, la formule devient :
Voyons ce que cela implique. Élever à la puissance $0$ donne $1$ pour chaque valeur non nulle et $0$ pour les zéros.
Cette « norme » correspond donc au nombre de composantes non nulles du vecteur. Ce n’est pas vraiment une norme car si vous multipliez le vecteur par $\alpha$, ce nombre reste inchangé (voir la règle 4 ci-dessus).
Si $p=1$, on obtient simplement la somme des valeurs absolues. C’est ce que nous avons utilisé intuitivement au début du tutoriel :

La norme euclidienne est la $p$-norme avec $p=2$. C’est probablement la plus utilisée, avec sa version au carré (voir ci-dessous).
On note que la valeur absolue n’est plus nécessaire puisque $x$ est au carré. C’est ce que nous avons appliqué via le théorème de Pythagore ci-dessus.
Voyons un autre exemple de cette norme :
Graphiquement, la norme euclidienne correspond à la longueur du vecteur depuis l’origine jusqu’au point obtenu par combinaison linéaire (théorème de Pythagore). En 2D : le vecteur $\bs{u}$ a deux valeurs, l’abscisse et l’ordonnée. Si vous tracez le point de coordonnées (x, y) et le vecteur depuis l’origine vers ce point, la norme $L^2$ est la longueur de ce vecteur.
Par exemple :
Calculons la norme avec la formule :

La norme $L^2$ est donc $5$.
Rappelons que la norme $L^2$ se calcule avec la fonction linalg.norm() de Numpy :
np.linalg.norm([3, 4])
5.0
Voici la représentation graphique du vecteur :
u = np.array([3, 4])

plt.ylim(-1, 5)
plt.xlim(-1, 5)
plotVectors([u], [sns.color_palette()[0]])
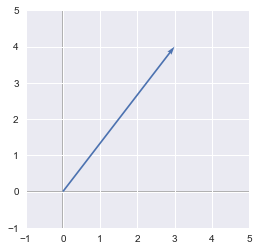
On voit que le vecteur part de l’origine (0, 0) vers (3, 4) et que sa longueur est 5.
Ici, le vecteur est dans un espace à 2 dimensions, mais cela s’étend naturellement à davantage de dimensions.
La norme $L^2$ au carré est pratique car elle supprime la racine carrée : on obtient simplement la somme des carrés des composantes.
Elle est très utilisée en machine learning, notamment parce qu’on peut la calculer via l’opération vectorielle $\bs{x}^\text{T}\bs{x}$. Il peut y avoir des gains de performance grâce aux optimisations. Voir ici et ici pour plus de détails.
Nous allons voir que la norme euclidienne au carré se calcule avec des opérations vectorisées. Partons d’un vecteur $\bs{x}$ :
Comme d’habitude, utilisons du code pour valider le processus. Créons d’abord le vecteur Numpy $\bs{x}$ :
x = np.array([[2], [5], [3], [3]])
x
array([[2],
       [5],
       [3],
       [3]])
Prenons maintenant la transposée de ce vecteur. Cela convertit simplement le vecteur colonne initial en vecteur ligne :
On peut calculer la transposée de $\bs{x}$ avec l’attribut T des objets Numpy :
x.T
array([[2, 5, 3, 3]])
Le produit scalaire de $\bs{x}$ et $\bs{x}^\text{T}$ (voir ici pour un rappel sur le produit scalaire) correspond en fait à la multiplication de chaque élément par lui-même :

C’est exactement la définition de la norme euclidienne au carré !
Vérifions avec Numpy. Rappelez-vous (et testez-le pour vous en convaincre) que l’ordre des vecteurs dans le produit scalaire compte :
euclideanNorm = x.T.dot(x)
euclideanNorm
array([[47]])
Cela devrait être notre norme euclidienne au carré ! Calculons-la à partir de la norme $L^2$ puis élevons au carré pour vérifier :
np.linalg.norm(x)**2
47.0
Ça marche ! La possibilité d’utiliser une opération vectorisée est un atout majeur par rapport aux autres normes.
Nous avons vu que les normes peuvent servir à évaluer la qualité d’un modèle en résumant ses vecteurs d’erreurs.
Allons plus loin : comment ajuster les paramètres du modèle pour réduire l’erreur globale ? Pour cela, on utilise une fonction de coût qui associe l’erreur du modèle aux valeurs des paramètres. L’algorithme de descente de gradient permet de trouver le minimum de cette fonction. La descente de gradient s’appuie sur le calcul des dérivées partielles par rapport à chaque paramètre (les gradients). D’où l’importance de pouvoir calculer la dérivée efficacement.
Un grand avantage de la norme $L^2$ au carré est que ses dérivées partielles se calculent très simplement. Considérons le vecteur suivant :
Nous avons vu que sa norme $L^2$ au carré est :
Pour calculer les dérivées partielles, on considère les autres variables comme constantes. Par exemple, la dérivée partielle par rapport à $u_1$ est la dérivée de $u_1^2+a$ ($a$ représentant la constante due aux autres variables). Ainsi, on obtient :
L’intérêt des gradients de la norme $L^2$ au carré est que chaque dérivée ne dépend pas des autres variables. Nous verrons que ce n’est pas le cas avec la norme $L^2$.
Pour la norme $L^2$, la dérivée est plus complexe et dépend de toutes les composantes du vecteur. Reprenons le vecteur $\bs{u}$. La norme $L^2$ est :
Calculons sa dérivée par rapport à $u_1$ :

On voit que la dérivée partielle selon $u_1$ contient encore $u_2...u_n$. Les autres gradients suivent la même structure :
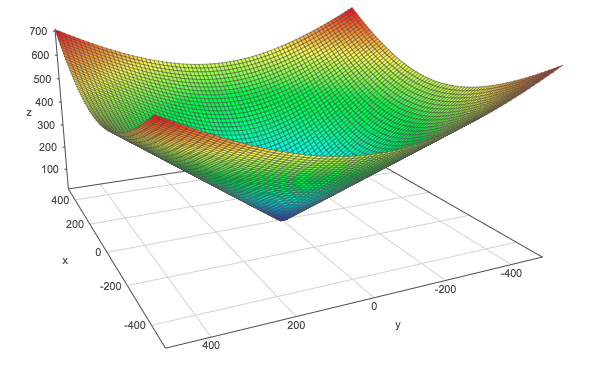
La norme $L^2$ au carré est intéressante, mais elle distingue mal 0 des petites valeurs car la fonction croît lentement au voisinage de 0.
On peut le voir en comparant graphiquement la norme $L^2$ et sa version au carré. L’axe $z$ correspond à la valeur de la norme et les axes $x$ et $y$ à deux paramètres. Le même raisonnement vaut au-delà de 2 dimensions, mais la visualisation devient difficile.
Norme $L^2$ :
Norme $L^2$ au carré :
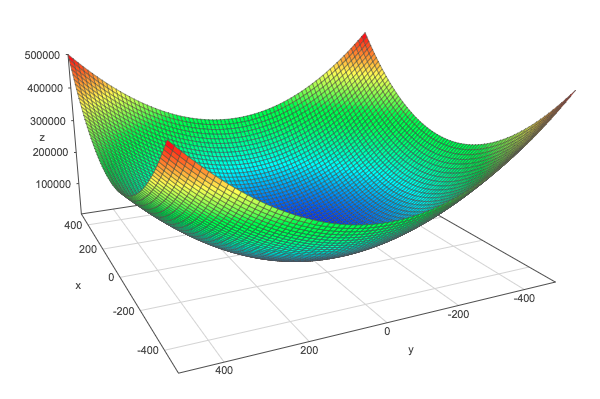
Pour comparaison, voici la norme $L^1$ :
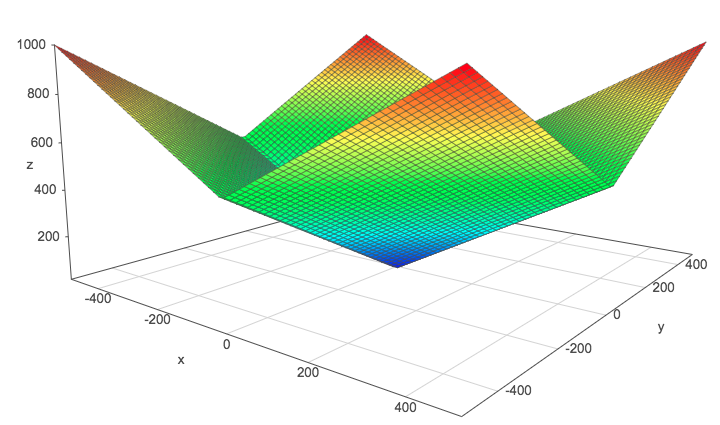
Ces tracés ont été réalisés grâce à ce site. N’hésitez pas à y manipuler les surfaces pour bien en saisir la forme.
C’est la norme $L^\infty$ et elle correspond à la valeur absolue de la plus grande composante du vecteur.

Elle équivaut à prendre la norme $L^2$ de la matrice « aplatie ».
La même fonction Numpy peut être utilisée :
A = np.array([[1, 2], [6, 4], [3, 2]])
A
array([[1, 2],
       [6, 4],
       [3, 2]])
np.linalg.norm(A)
8.3666002653407556
Le produit scalaire entre les vecteurs $\bs{x}$ et $\bs{y}$ peut être exprimé à partir de leurs normes $L^2$. $\theta$ est l’angle entre les deux vecteurs.
Considérons deux vecteurs en dimension 2 :
et
Le graphique suivant montre leur représentation :
x = [0,0,0,2]
y = [0,0,2,2]

plotVectors([x, y], [sns.color_palette()[0], sns.color_palette()[1]])

plt.xlim(-1, 3)
plt.ylim(-1, 3)

plt.text(-0.5, 1, r'$\vec{x}$', size=18, color=sns.color_palette()[0])
plt.text(1.5, 0.5, r'$\vec{y}$', size=18, color=sns.color_palette()[1])
<matplotlib.text.Text at 0x10a33b950>
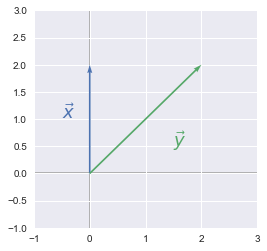
Nous avons choisi cet exemple pour sa simplicité. Comme on le voit, l’angle $\theta$ vaut 45°.
Calculons d’abord le produit scalaire des vecteurs :
x = np.array([0, 2])
y = np.array([2, 2])

x.dot(y)
4
Calculons maintenant leurs normes :
et
Avec la formule ci-dessus, on obtient :
On retrouve le même résultat que par le produit scalaire. Voici les opérations avec numpy. Notez que nous utilisons la fonction deg2rad de Numpy car np.cos prend un angle en radians, il faut donc convertir.
# Note: np.cos take the angle in radian
np.cos(np.deg2rad(45))*2*np.sqrt(8)
4.0000000000000009
La norme $L^2$ (ou norme de Frobenius pour une matrice) et la norme $L^2$ au carré sont omniprésentes en machine learning, deep learning et data science en général. Par exemple, les normes servent de fonctions de coût. Si vous voulez ajuster une droite à un nuage de points, une méthode consiste à partir de paramètres aléatoires et à itérer en minimisant la fonction de coût. Cette fonction représente l’erreur de votre modèle, que vous souhaitez rendre la plus faible possible. Les normes sont utiles ici car elles offrent un moyen de mesurer cette erreur : la norme transforme le vecteur de toutes vos erreurs en un simple scalaire, et la fonction de coût est ce scalaire pour un jeu de paramètres donné.
Nous avons vu que les normes ne sont rien d’autre qu’un tableau réduit à un scalaire. Nous avons également noté qu’il existe des variantes selon la fonction utilisée pour les calculer. Le choix de la norme dépend fortement du problème à résoudre, car chacune a ses avantages et ses limites. Par exemple, la norme $L^1$ est plus robuste que la $L^2$ : la norme $L^2$ est plus sensible aux valeurs aberrantes, car des erreurs importantes donnent des erreurs au carré gigantesques.
Ce tutoriel s’appuie sur cet article de ma série consacrée au chapitre d’algèbre linéaire du Deep Learning Book de Goodfellow et al.
http://www.deeplearningbook.org/contents/linear_algebra.html
https://docs.scipy.org/doc/numpy-1.14.0/reference/generated/numpy.linalg.norm.html
https://hadrienj.github.io/deep-learning-book-series-home/
https://datascience.stackexchange.com/questions/10188/why-do-cost-functions-use-the-square-error
Approfondissez vos connaissances en machine learning
Cours
Cours
Cours