Cursus
Inzicht in Machine Learning
2 uur
313.7K
Lineaire algebra is een van de basisgereedschappen uit de wiskunde die we nodig hebben in data science. Als je deze concepten begrijpt, vergroot dat je inzicht in verschillende algoritmen. Het is echt een uitstekende basis voor een data science-/machine learning-pad.
Het doel van deze tutorial is om wiskunde voor data science te benaderen door te coderen met Python/Numpy. Ik denk dat praktische tutorials over theoretische onderwerpen zoals lineaire algebra nuttig kunnen zijn, omdat schrijven en lezen van code een goede manier is om wiskundige concepten echt te begrijpen. En bovenal: het kan ook gewoon heel leuk zijn!
Er zijn geen specifieke vereisten, maar als je niet zeker weet wat een matrix is of hoe je het inproduct berekent, zijn de eerste posts (1 tot 4) van mijn serie over het deep learning-boek van Ian Goodfellow een goed begin.
In deze tutorial behandelen we een belangrijk concept voor machine learning en deep learning: de norm. De norm wordt veel gebruikt, bijvoorbeeld om de kwaliteit van een model te evalueren. Aan het eind van deze tutorial heb je hopelijk een betere intuïtie voor dit concept en waarom het zo waardevol is in machine learning. We bekijken ook hoe de afgeleide van de norm wordt gebruikt om een machinelearning-algoritme te trainen.
Allereerst zetten we de libraries klaar die we gaan gebruiken:
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
En we voegen wat LaTeX-snelkoppelingen toe aan de commando's bs voor vette symbolen en norm voor het normsymbool:
$$
\newcommand\bs[1]{\boldsymbol{#1}}
\newcommand\norm[1]{\left\lVert#1\right\rVert}
$$
$$ \newcommand\bs[1]{\boldsymbol{#1}} \newcommand\norm[1]{\left\lVert#1\right\rVert} $$
Het laatste wat we instellen is de weergave van de grafieken die we gaan maken:
# Plot parameters
sns.set()
%pylab inline
pylab.rcParams['figure.figsize'] = (4, 4)
plt.rcParams['xtick.major.size'] = 0
plt.rcParams['ytick.major.size'] = 0
Populating the interactive namespace from numpy and matplotlib
Laten we beginnen met een eenvoudig voorbeeld. Stel dat je een dataset met liedjes hebt met verschillende kenmerken. Je wilt nu een model bouwen dat de duur van een nummer voorspelt op basis van andere kenmerken zoals het genre, de instrumentatie, enzovoort. Je hebt een model getraind en wilt het nu evalueren op het voorspellen van de duur van een nieuw nummer. Een manier om dat te doen is door nieuwe data te nemen en met je model de songduur te voorspellen. Omdat je voor deze waarnemingen de echte duur van elk nummer kent, kun je de echte en voorspelde duur per observatie vergelijken. Je hebt de volgende resultaten in seconden voor 7 observaties:
errorModel1 = [22, -4, 2, 7, 6, -3, 12]
Je kunt deze verschillen zien als de fout van het model. Een perfect model zou alleen maar 0’s hebben, terwijl een heel slecht model enorme positieve of negatieve waarden zou hebben.
Stel nu dat je een ander model probeert en je uitkomt op de volgende verschillen tussen voorspelde en echte songduur:
errorModel2 = [14, 9, -13, 19, 8, -21, 4]
Wat kun je doen als je het beste model wilt vinden? Een logische manier is de som te nemen van de absolute waarden van deze fouten. De absolute waarde wordt gebruikt omdat een negatieve fout (echte duur kleiner dan voorspelde duur) ook een fout is. Hoe kleiner de totale fout van het model, hoe beter:
totalErrorModel1 = np.sum(np.abs(errorModel1))
totalErrorModel1
56
totalErrorModel2 = np.sum(np.abs(errorModel2))
totalErrorModel2
88
Het lijkt erop dat model 1 veel beter is dan model 2.
Gefeliciteerd! Je hebt zojuist de norm van de foutvector voor elk model berekend!
Je kunt de norm zien als de lengte van de vector. Om een idee te krijgen van de grafische weergave hiervan, pakken we ons vorige voorbeeld er weer bij. De foutvectoren zijn multidimensionaal: er is één dimensie per observatie. In het laatste voorbeeld leidden 7 observaties tot 7 dimensies. Het blijft nogal lastig om 7 dimensies weer te geven, dus laten we het voorbeeld opnieuw vereenvoudigen en slechts 2 observaties houden:
errorModel1 = [22, -4]
errorModel2 = [14, 9]
Nu kunnen we deze vectoren weergeven door te beschouwen dat het eerste element van de array de x-coördinaat is en het tweede element de y-coördinaat. We beginnen met een functie te schrijven om de vectoren eenvoudig te plotten en een idee te krijgen van hun representaties.
We willen een functie die ons helpt de vectoren te plotten. Laten we beginnen met hoe we die zouden gebruiken. We willen een lijst met arrays meegeven die overeenkomen met de coördinaten van de vectoren en een plot van deze vectoren terugkrijgen. Laten we zeggen dat we ook een array met kleuren kunnen meegeven om de vectoren in de grafieken te onderscheiden. Samengevat willen we de functie zo kunnen aanroepen:
plotVectors([vector1, vector2], ['red', 'blue'])
Laten we deze functie schrijven:
def plotVectors(vecs, cols, alpha=1):
    """
    Plot set of vectors.

    Parameters
    ----------
    vecs : array-like
        Coordinates of the vectors to plot. Each vector is in an array. For
        instance: [[1, 3], [2, 2]] can be used to plot 2 vectors.
    cols : array-like
        Colors of the vectors. For instance: ['red', 'blue'] will display the
        first vector in red and the second in blue.
    alpha : float
        Opacity of vectors

    Returns:

    fig : instance of matplotlib.figure.Figure
        The figure of the vectors
    """
    plt.axvline(x=0, color='#A9A9A9', zorder=0)
    plt.axhline(y=0, color='#A9A9A9', zorder=0)

    for i in range(len(vecs)):
        if (isinstance(alpha, list)):
            alpha_i = alpha[i]
        else:
            alpha_i = alpha
        if (len(vecs[i])==2):
            x = np.concatenate([[0,0],vecs[i]])
        elif (len(vecs[i])==4):
            x = vecs[i]
        plt.quiver([x[0]],
                   [x[1]],
                   [x[2]],
                   [x[3]],
                   angles='xy', scale_units='xy', scale=1, color=cols[i],
                  alpha=alpha_i)
Hij neemt een array met te plotten vectoren (vecs) en hun kleuren (cols) als invoer. Als er slechts 2 dimensies zijn opgegeven in de vector, begint hij op (0, 0). Onder de motorkap lopen we over deze array met vectoren en gebruiken we plt.quiver() om ze te plotten.
Laten we onze nieuwe functie gebruiken om de fouten van model 1 en 2 te plotten:
plotVectors([errorModel1, errorModel2], [sns.color_palette()[0], sns.color_palette()[1]])

plt.xlim(-1, 25)
plt.ylim(-5, 10)
plt.show()
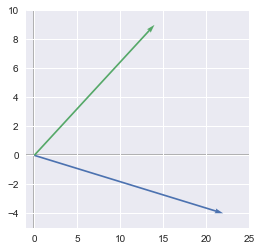
Opmerking: we hebben plt.show() niet in de functie opgenomen om extra ploteigenschappen te kunnen toevoegen, zoals hier de limieten.
Opmerking 2: we hebben de kleuren van seaborn handmatig gebruikt met sns.color_palette()
We hebben dus één foutvector per model. Het betere model is simpelweg het model dat hoort bij de kleinere vector. Een manier om de lengte van de vectoren te berekenen is met de stelling van Pythagoras: $\sqrt{x^2+y^2}$. We kunnen de lengte van de twee vectoren berekenen:
# Lengte van de vector errorModel1
np.sqrt(errorModel1[0]**2+errorModel1[1]**2)
22.360679774997898
# Lengte van de vector errorModel2
np.sqrt(errorModel2[0]**2+errorModel2[1]**2)
16.643316977093239
Gefeliciteerd! Je hebt zojuist nog een andere norm van de foutvectoren berekend. De lengte van de foutvector van het eerste model is $22{,}36$ en die van het tweede model is ongeveer $16{,}64$. In dit geval is het tweede model beter, maar onthoud dat we alleen de eerste twee waarden hebben gebruikt.
Eerst hadden we de som van de fouten berekend, maar we kunnen ook de stelling van Pythagoras gebruiken om de norm van een vector te berekenen. Dit zijn twee verschillende normen en dat laat zien dat er meerdere manieren zijn om normen te berekenen.
De norm van een vector kan elke functie zijn die een vector naar een positieve waarde afbeeldt. Er kunnen verschillende functies worden gebruikt en we bekijken een paar voorbeelden. Deze functies mogen normen worden genoemd als ze worden gekenmerkt door de volgende eigenschappen:
Normen zijn niet-negatieve waarden. Als je normen als een lengte ziet, wordt meteen duidelijk waarom die niet negatief kan zijn.
Normen zijn $0$ dan en alleen dan als de vector de nulvector is.
Normen respecteren de driehoeksongelijkheid. Zie hieronder.
$\norm{k\cdot \bs{u}}=\norm{k}\cdot\norm{\bs{u}}$. Hier is $k$ een scalair en $\bs{u}$ een vector. De norm van een vector vermenigvuldigd met een scalair is gelijk aan de absolute waarde van die scalair vermenigvuldigd met de norm van de vector.
Het wordt meestal geschreven met twee verticale staven: $\norm{\bs{x}}$
We zagen hierboven dat een voorwaarde voor een functie om een norm te zijn is dat ze de driehoeksongelijkheid respecteert. Dit betekent simpelweg dat de norm van de som van enkele vectoren kleiner is dan of gelijk aan de som van de normen van deze vectoren:
Om te laten zien wat dit betekent, nemen we twee vectoren die elk twee elementen bevatten (opnieuw handig om als x- en y-coördinaten weer te geven). Onze vectoren zijn:
u = np.array([1, 6])
u
array([1, 6])
en
v = np.array([4, 2])
v
array([4, 2])
Laten we vergelijken:
en:
We zien later verschillende soorten normen, maar voorlopig gebruiken we een klassieke: de Euclidische norm ($L^2$). De $L^2$-norm kan worden berekend met de Numpy-functie np.linalg.norm() (zie meer details in de documentatie).
We zullen later in detail bekijken wat de $L^1$- of $L^2$-normen zijn.
np.linalg.norm(u+v)
9.4339811320566032
en
np.linalg.norm(u)+np.linalg.norm(v)
10.554898485297798
We zien dat de driehoeksongelijkheid gerespecteerd wordt, aangezien:
Je zult zien dat de grafische weergave van deze stelling het vrij vanzelfsprekend maakt. We plotten de vectoren $\bs{u}$, $\bs{v}$ en $\bs{u}+\bs{v}$ met onze plotVectors-functie en voegen wat tekst toe om de vectoren te identificeren:
u = np.array([0,0,1,6])
v = np.array([0,0,4,2])
w = u+v

u_bis = [u[2], u[3], v[2], v[3]]

plotVectors([u, u_bis, w],
            [sns.color_palette()[0],
            sns.color_palette()[1],
            sns.color_palette()[2]])

plt.xlim(-2, 6)
plt.ylim(-2, 9)

plt.text(-1, 3.5, r'$||\vec{u}||$', color=sns.color_palette()[0], size=20)
plt.text(2.5, 7.5, r'$||\vec{v}||$', color=sns.color_palette()[1], size=20)
plt.text(2, 2, r'$||\vec{u}+\vec{v}||$', color=sns.color_palette()[2], size=20)

plt.show()
plt.close()
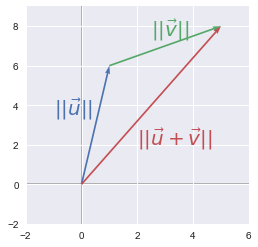
De lengte van $\bs{u}$ plus de lengte van $\bs{v}$ is groter dan de lengte van de vector $\bs{u}+\bs{b}$. Geometrisch betekent dit simpelweg dat het kortste pad tussen twee punten een rechte lijn is!
We hebben de voorwaarden gezien die nodig zijn om de functie een norm te mogen noemen. Dit betekent dat er meerdere functies zijn die als norm kunnen worden gebruikt. We bekijken later de voor- en nadelen van deze verschillende normen. We noemen $p$-norm de volgende categorie functies die afhangen van $p$:
Laten we deze vergelijking stap voor stap doornemen. We zien dat er een som van elementen is, dus we kunnen het zien als een iteratie over de $i$-elementen:
Dit wordt duidelijk met voorbeelden met deze veelgebruikte $p$-normen.
Als $p=0$, wordt de formule:
Laten we bekijken wat dit betekent. Door macht $0$ te nemen van absolute waarden krijg je een $1$ voor elke niet-$0$ waarde en een $0$ voor $0$.
Deze norm komt dus overeen met het aantal niet-nul elementen in de vector. Het is niet echt een norm, want als je de vector met $\alpha$ vermenigvuldigt, blijft dit aantal hetzelfde (regel 4 hierboven).
Als $p=1$, hebben we simpelweg de som van de absolute waarden. Dat is wat we aan het begin van deze tutorial intuïtief hebben gebruikt:

De Euclidische norm is de $p$-norm met $p=2$. Dit is wellicht de meest gebruikte norm, samen met de gekwadrateerde $L^2$-norm (zie hieronder).
We kunnen opmerken dat de absolute waarde niet meer nodig is, omdat $x$ gekwadrateerd wordt. Dit is wat we gebruikten toen we de lengte van onze vectoren met de stelling van Pythagoras hierboven berekenden.
Laten we nog een voorbeeld van deze norm bekijken:
Grafisch komt de Euclidische norm overeen met de lengte van de vector van de oorsprong naar het punt dat wordt verkregen door lineaire combinatie (stelling van Pythagoras). We zien een voorbeeld in 2 dimensies: de vector $\bs{u}$ heeft twee waarden die overeenkomen met de $x$- en $y$-coördinaat. Als je het punt met deze coördinaten plot en een vector tekent van de oorsprong naar dit punt, dan is de $L^2$-norm de lengte van deze vector.
Bijvoorbeeld:
Laten we beginnen met de norm uit de formule te berekenen:

De $L^2$-norm is dus $5$.
Overigens: onthoud dat de $L^2$-norm kan worden berekend met de functie linalg.norm() uit Numpy:
np.linalg.norm([3, 4])
5.0
Hier is de grafische weergave van de vector:
u = np.array([3, 4])

plt.ylim(-1, 5)
plt.xlim(-1, 5)
plotVectors([u], [sns.color_palette()[0]])
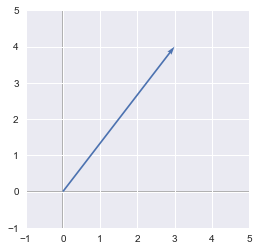
We zien dat de vector van de oorsprong (0, 0) naar (3, 4) loopt en dat de lengte 5 is.
In dit geval ligt de vector in een 2-dimensionale ruimte, maar dit geldt ook voor meer dimensies.
De gekwadrateerde $L^2$-norm is handig omdat de wortel wegvalt en we uitkomen op de eenvoudige som van alle gekwadrateerde waarden van de vector.
De gekwadrateerde Euclidische norm wordt veel gebruikt in machine learning, deels omdat die kan worden berekend met de vectoroperatie $\bs{x}^\text{T}\bs{x}$. Er kan sprake zijn van prestatiewinst door optimalisatie. Zie hier en hier voor meer details.
We zullen in dit voorbeeld zien dat de gekwadrateerde Euclidische norm kan worden berekend met gevectoriseerde operaties. Laten we beginnen met een vector $\bs{x}$:
Zoals gebruikelijk gebruiken we code om het proces te controleren. Laten we eerst onze Numpy-vector $\bs{x}$ maken:
x = np.array([[2], [5], [3], [3]])
x
array([[2],
       [5],
       [3],
       [3]])
Laten we nu de getransponeerde van deze vector nemen. Dit zet de oorspronkelijke kolomvector simpelweg om in een rijvector:
We kunnen de transponering van $\bs{x}$ berekenen met de methode T van Numpy-objecten:
x.T
array([[2, 5, 3, 3]])
Het inproduct van $\bs{x}$ en $\bs{x}^\text{T}$ (zie hier als je een opfrisser nodig hebt over het inproduct) komt eigenlijk overeen met het vermenigvuldigen van elk element met zichzelf:

Dit is precies de definitie van de gekwadrateerde Euclidische norm!
Laten we dit checken met Numpy. Onthoud (en probeer het om jezelf te overtuigen) dat de volgorde van de vector in het inproduct uitmaakt:
euclideanNorm = x.T.dot(x)
euclideanNorm
array([[47]])
Dit zou onze gekwadrateerde Euclidische norm moeten zijn! Laten we hem uit de $L^2$-norm berekenen en kwadrateren om te controleren of dit klopt:
np.linalg.norm(x)**2
47.0
Werkt! De mogelijkheid om een gevectoriseerde operatie te gebruiken is een groot voordeel ten opzichte van andere normen.
We hebben gezien dat normen kunnen worden gebruikt om de kwaliteit van een model te evalueren door de foutvectoren samen te vatten.
Nu willen we een stap verder gaan en weten hoe we de parameters van ons model kunnen veranderen om de totale fout te verkleinen. Om dat te doen kunnen we een kostenfunctie gebruiken die de fout van het model weergeeft als functie van de parameterwaarden. Het gradient descent-algoritme kan worden gebruikt om het minimum van deze functie te vinden. Gradient descent gebeurt door de afgeleiden te berekenen ten opzichte van elke parameter (partiële afgeleiden = gradiënten). Daarom is het cruciaal om de afgeleide efficiënt te kunnen berekenen.
Een groot voordeel van de gekwadrateerde $L^2$-norm is inderdaad dat de partiële afgeleide eenvoudig te berekenen is. Neem de volgende vector:
We hebben gezien dat de gekwadrateerde $L^2$-norm wordt berekend met:
Vervolgens, om de partiële afgeleiden te berekenen, beschouwen we alle andere variabelen als constant. De partiële afgeleide naar $u_1$ is bijvoorbeeld de afgeleide van $u_1^2+a$ (waarbij $a$ de constante is die hoort bij alle andere variabelen). Om deze reden hebben we de volgende partiële afgeleiden:
Wat fijn is aan de gradiënten van de gekwadrateerde $L^2$-norm is dat de afgeleiden niet van de andere variabelen afhangen. We zullen zien dat dit niet het geval is bij de $L^2$-norm.
In het geval van de $L^2$-norm is de afgeleide ingewikkelder en hangt die af van elk element van de vector. Neem de laatste vector $\bs{u}$ als voorbeeld. De $L^2$-norm is:
Laten we de afgeleide ervan berekenen naar $u_1$:

We zien dat de partiële afgeleide naar $u_1$ nog steeds $u_2...u_n$ bevat. De andere gradiënten volgen dezelfde structuur:
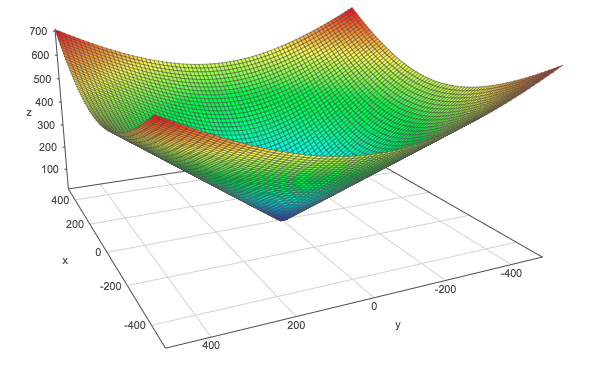
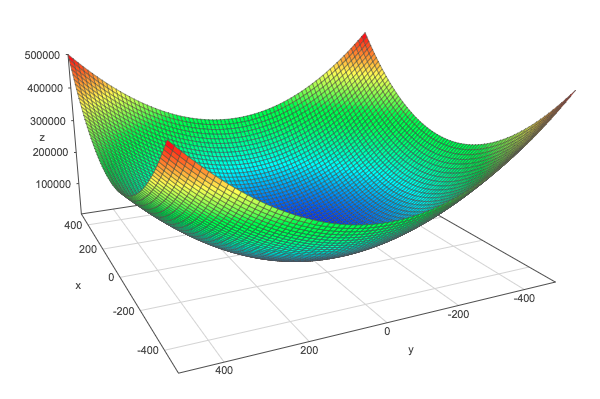
De gekwadrateerde $L^2$-norm is geweldig, maar een probleem is dat hij nauwelijks onderscheid maakt tussen 0 en kleine waarden omdat de functie langzaam toeneemt.
We kunnen dit zien door de gekwadrateerde $L^2$-norm grafisch te vergelijken met de $L^2$-norm. De z-as komt overeen met de waarde van de norm en de x- en y-as komen overeen met twee parameters. Hetzelfde geldt voor meer dan 2 dimensies, maar dat zou moeilijk te visualiseren zijn.
$L^2$-norm:
Gekwadrateerde $L^2$-norm:
Ter vergelijking: hier is de $L^1$-norm:
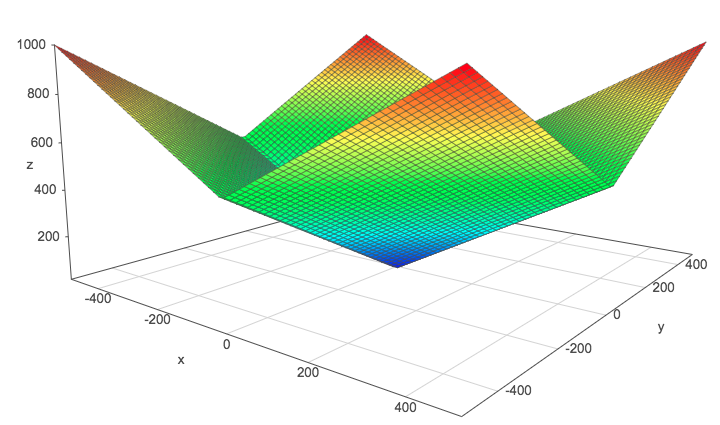
Deze plots zijn gemaakt met behulp van deze website. Ga ze plotten als je ze wilt draaien om hun vorm te begrijpen.
Dit is de $L^\infty$-norm en komt overeen met de absolute waarde van het grootste element van de vector.

Dit is gelijk aan het nemen van de $L^2$-norm van de matrix na flattening.
Dezelfde Numpy-functie kan worden gebruikt:
A = np.array([[1, 2], [6, 4], [3, 2]])
A
array([[1, 2],
       [6, 4],
       [3, 2]])
np.linalg.norm(A)
8.3666002653407556
Het inproduct tussen de vectoren $\bs{x}$ en $\bs{y}$ kan worden teruggevonden met de $L^2$-normen van deze vectoren. $\theta$ is de hoek tussen de twee vectoren.
Laten we twee vectoren in 2 dimensies nemen:
en
De volgende plot toont hun grafische weergave:
x = [0,0,0,2]
y = [0,0,2,2]

plotVectors([x, y], [sns.color_palette()[0], sns.color_palette()[1]])

plt.xlim(-1, 3)
plt.ylim(-1, 3)

plt.text(-0.5, 1, r'$\vec{x}$', size=18, color=sns.color_palette()[0])
plt.text(1.5, 0.5, r'$\vec{y}$', size=18, color=sns.color_palette()[1])
<matplotlib.text.Text at 0x10a33b950>
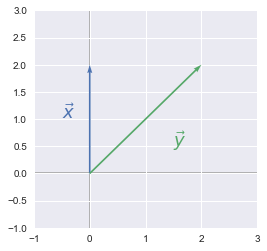
We kozen dit voorbeeld om zijn eenvoud. Zoals we zien, is de hoek $\theta$ gelijk aan 45°.
Laten we eerst het inproduct van de vectoren berekenen:
x = np.array([0, 2])
y = np.array([2, 2])

x.dot(y)
4
En nu hun normen:
en
Dus met de bovenstaande formule hebben we:
Dit is hetzelfde resultaat als met het inproduct. Hier zijn de bewerkingen met numpy. Let er wel op dat we de functie deg2rad uit Numpy gebruiken omdat np.cos de hoek in radialen neemt, dus we moeten omrekenen.
# Note: np.cos take the angle in radian
np.cos(np.deg2rad(45))*2*np.sqrt(8)
4.0000000000000009
De $L^2$-norm (of de Frobeniusnorm in het geval van een matrix) en de gekwadrateerde $L^2$-norm worden veel gebruikt in machine learning, deep learning en data science in het algemeen. Zo kunnen normen worden gebruikt als kostenfuncties. Stel dat je een lijn wilt fitten op een set datapunten. Een manier om de beste lijn te vinden is te beginnen met willekeurige parameters en te itereren door de kostenfunctie te minimaliseren. De kostenfunctie is een functie die de fout van je model weergeeft, dus je wilt dat deze fout zo klein mogelijk is. Normen zijn hier handig omdat ze je een manier geven om deze fout te meten. De norm zet de vector met al je fouten om in een eenvoudige scalair, en de kostenfunctie is deze scalair voor een set waarden van je parameters.
We hebben gezien dat normen niets meer zijn dan een array die wordt teruggebracht tot een scalair. We hebben ook gemerkt dat er variaties zijn afhankelijk van de functie die we gebruiken om ze te berekenen. Welke norm je gebruikt, hangt sterk af van het op te lossen probleem, omdat er voor- en nadelen zijn om de ene of de andere toe te passen. Zo is de $L^1$-norm robuuster dan de $L^2$-norm. Dit betekent dat de $L^2$-norm gevoeliger is voor uitschieters, omdat grote foutwaarden enorme gekwadrateerde foutwaarden opleveren.
Deze tutorial is gebaseerd op dit artikel uit mijn serie over het hoofdstuk lineaire algebra in het Deep Learning Book van Goodfellow et al.
http://www.deeplearningbook.org/contents/linear_algebra.html
https://docs.scipy.org/doc/numpy-1.14.0/reference/generated/numpy.linalg.norm.html
https://hadrienj.github.io/deep-learning-book-series-home/
https://datascience.stackexchange.com/questions/10188/why-do-cost-functions-use-the-square-error
Leer meer over Machine Learning
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

