
Kursus
Prapemrosesan untuk Machine Learning di Python
4 jam
69K
Metode ensemble adalah teknik yang kuat dalam machine learning yang menggabungkan beberapa model untuk meningkatkan akurasi prediksi keseluruhan dan stabilitas model. Bootstrap Aggregating, yang lebih dikenal sebagai Bagging, menonjol sebagai metode ensemble yang populer dan banyak diimplementasikan.
Dalam tutorial ini, kita akan menyelami lebih dalam bagging, cara kerjanya, dan kapan teknik ini unggul. Kita akan membandingkannya dengan metode ensemble lain (Boosting) dan melihat contoh bagging di Python. Pada akhirnya, Anda akan memiliki pemahaman yang kuat tentang bagging, termasuk praktik terbaiknya.
Ensemble Modeling adalah teknik yang menggabungkan beberapa model machine learning untuk meningkatkan kinerja prediktif secara keseluruhan. Gagasan dasarnya adalah sekelompok weak learner dapat bersatu membentuk satu strong learner.
Sebuah model ensemble biasanya terdiri dari dua langkah:
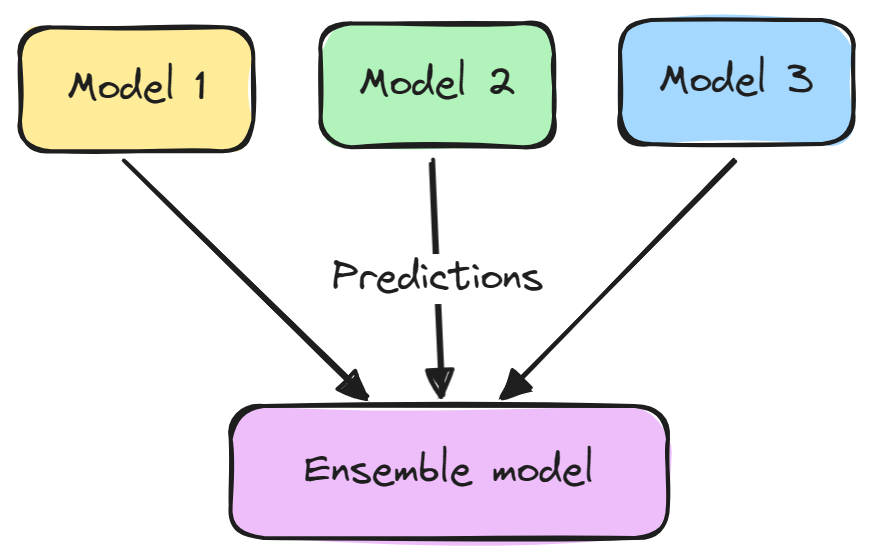
Ensemble cenderung menghasilkan hasil yang lebih baik karena model yang berbeda saling melengkapi dan mengatasi kelemahan masing-masing. Teknik ini juga mengurangi varians dan mencegah overfitting.
Beberapa metode ensemble yang populer adalah bagging, boosting, dan stacking. Ensemble learning banyak digunakan di berbagai tugas machine learning seperti klasifikasi, regresi, dan klastering untuk meningkatkan akurasi dan ketangguhan.
Bagging (bootstrap aggregating) adalah metode ensemble yang melibatkan pelatihan beberapa model secara independen pada subset acak data, lalu menggabungkan prediksinya melalui voting atau rata-rata.
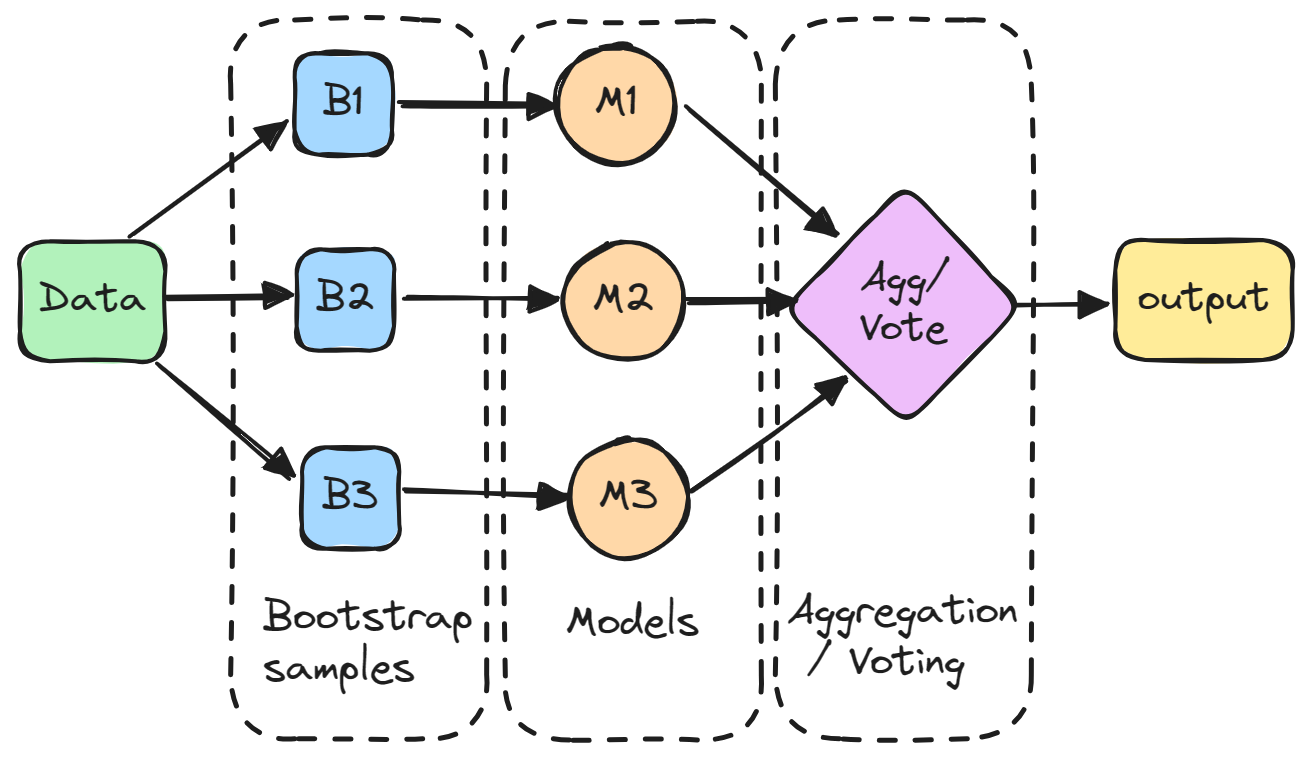
Secara rinci, setiap model dilatih pada subset acak data yang diambil dengan pengembalian (with replacement), artinya satu titik data bisa terpilih lebih dari sekali. Subset acak ini dikenal sebagai sampel bootstrap. Dengan melatih model pada berbagai bootstrap, bagging mengurangi varians model individual. Teknik ini juga menghindari overfitting dengan mengekspos model penyusunnya pada bagian-bagian berbeda dari dataset.
Prediksi dari semua model sampel kemudian digabungkan melalui rata-rata sederhana untuk membuat prediksi keseluruhan. Dengan cara ini, model teragregasi menggabungkan kekuatan masing-masing model dan menetralkan kesalahannya.
Bagging sangat efektif dalam mengurangi varians dan overfitting, sehingga membuat model lebih tangguh dan akurat, terutama ketika model individual rentan terhadap variabilitas tinggi.
Boosting adalah metode ensemble populer lainnya yang sering dibandingkan dengan Bagging. Perbedaan utama terletak pada bagaimana model penyusunnya dilatih.
Pada bagging, model dilatih secara independen dan paralel pada subset acak data yang berbeda. Sedangkan pada boosting, model dilatih secara berurutan, di mana setiap model belajar dari kesalahan model sebelumnya. Selain itu, bagging biasanya melibatkan perataan sederhana antar model, sementara boosting memberikan bobot berdasarkan akurasi.
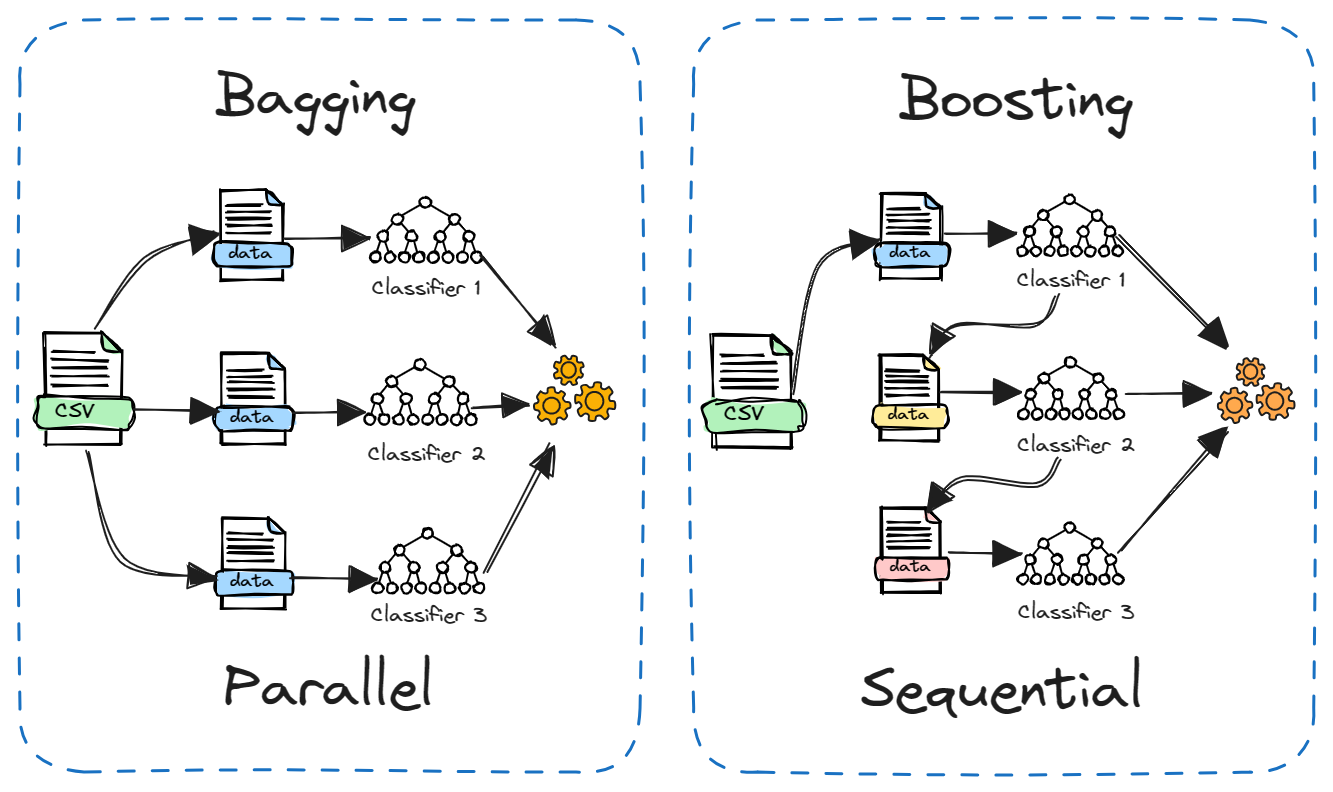
Bagging mengurangi varians sementara boosting mengurangi bias. Bagging dapat digunakan dengan model yang tidak stabil seperti decision tree, sedangkan boosting bekerja lebih baik untuk model yang stabil seperti regresi linear.
Kedua metode memiliki kelebihan dan kekurangannya. Bagging lebih sederhana dijalankan secara paralel, sementara boosting bisa lebih kuat dan akurat. Dalam praktiknya, sebaiknya uji keduanya pada masalah baru untuk melihat mana yang berkinerja lebih baik.
Berikut beberapa keunggulan utama bagging:
Dalam tutorial Python ini, kita akan melatih model klasifikasi decision tree pada dataset churn pelanggan telekomunikasi dan menggunakan metode ensemble bagging untuk meningkatkan kinerjanya. Kita akan menggunakan DataLab untuk mendapatkan dataset dan menjalankan kode. Kodenya juga tersedia di workbook DataLab ini, yang dapat Anda salin untuk dijalankan di browser tanpa menginstal apa pun.
Dataset telecom customer churn berasal dari sebuah perusahaan telekomunikasi Iran. Setiap baris dalam dataset mewakili aktivitas pelanggan selama satu tahun, termasuk informasi tentang kegagalan panggilan, lama berlangganan, dan label churn yang menunjukkan apakah pelanggan telah meninggalkan layanan.
Pertama, kita akan memuat dataset dan melihat 5 baris teratas.
import pandas as pd

customer = pd.read_csv("data/customer_churn.csv")
customer.head()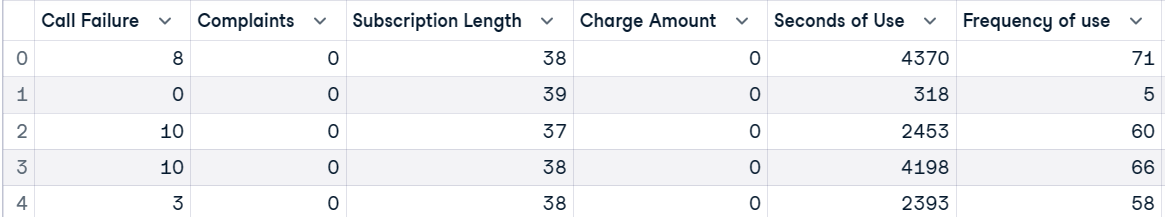
Setelah itu, kita akan membuat variabel independen (X) dan dependen (y). Lalu, kita akan membagi dataset menjadi subset pelatihan dan pengujian.
X = customer.drop("Churn", axis=1)
y = customer.Churn

# Split into train and test
from sklearn.model_selection import train_test_split, cross_val_score
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=1)Kita akan membuat pipeline machine learning sederhana dan melatihnya pada dataset pelatihan. Pipeline akan menormalkan data sebelum memasukkan input ke classifier decision tree.
from sklearn.tree import DecisionTreeClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline

pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', DecisionTreeClassifier(random_state=42))
])

pipeline.fit(X_train, y_train)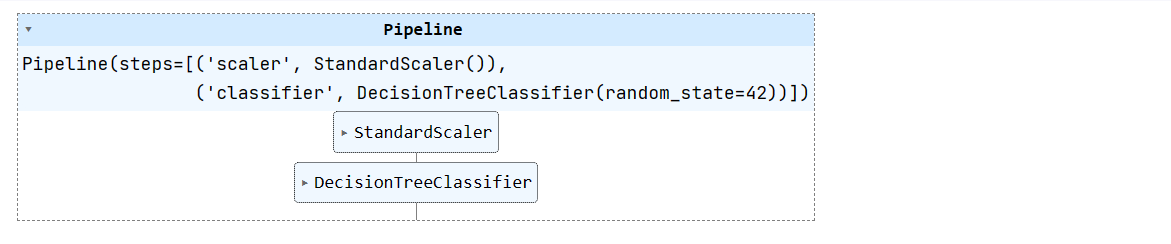
Ikuti kursus Machine Learning with Tree-Based Models di Python untuk mempelajari cara menggunakan model berbasis pohon dan ensemble untuk regresi dan klasifikasi dengan scikit-learn.
Kita akan mengevaluasi model decision tree agar dapat membandingkannya dengan model ensemble.
Kita akan menghasilkan classification report dengan membuat prediksi pada lembar data pengujian.
from sklearn.metrics import classification_report

# Make prediction on the testing data
y_pred = pipeline.predict(X_test)

# Classification Report
print(classification_report(y_pred, y_test))
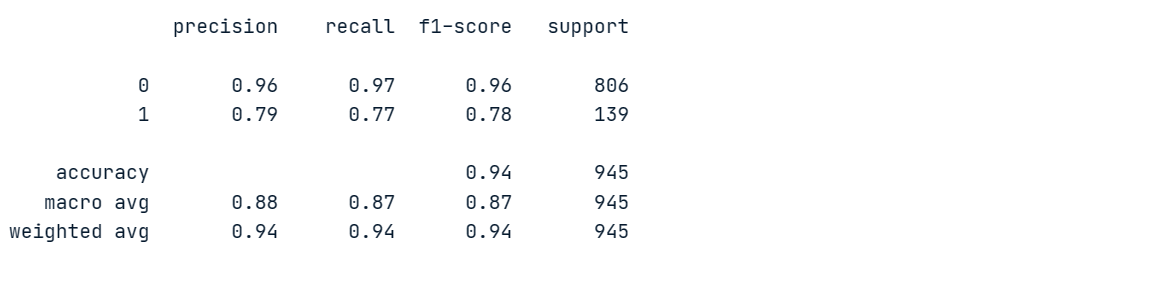
Model kita mencapai presisi 96% dan recall 97% pada kelas mayoritas “0”, namun berkinerja buruk pada kelas minoritas “1”.
Untuk mendapatkan pemahaman yang lebih baik tentang kinerja model, kita akan melakukan cross-validation dan menghitung skor yang sesuai.
# Evaluate the classifier using cross-validation
cv_scores = cross_val_score(pipeline, X, y, cv=5)

print(f"Cross-validation scores: {cv_scores}")
print(f"Mean CV accuracy: {np.mean(cv_scores):.2f}")
Variasi skor cukup tinggi, dengan nilai tertinggi 95% dan terendah 92%.
Cross-validation scores: [0.95079365 0.94126984 0.93492063 0.94285714 0.92222222]
Mean CV accuracy: 0.94Sekarang, mari buat bagging classifier dengan base estimator berupa pipeline kita (scaler + decision tree classifier) dan latih pada dataset pelatihan.
Kita dapat meningkatkan kinerja model dengan menaikkan n_estimators, tetapi 50 sudah cukup untuk hasil dasar.
from sklearn.ensemble import BaggingClassifier

# Create a bagging classifier with the decision tree pipeline
bagging_classifier = BaggingClassifier(base_estimator=pipeline, n_estimators=50, random_state=42)

# Train the bagging classifier on the training data
bagging_classifier.fit(X_train, y_train)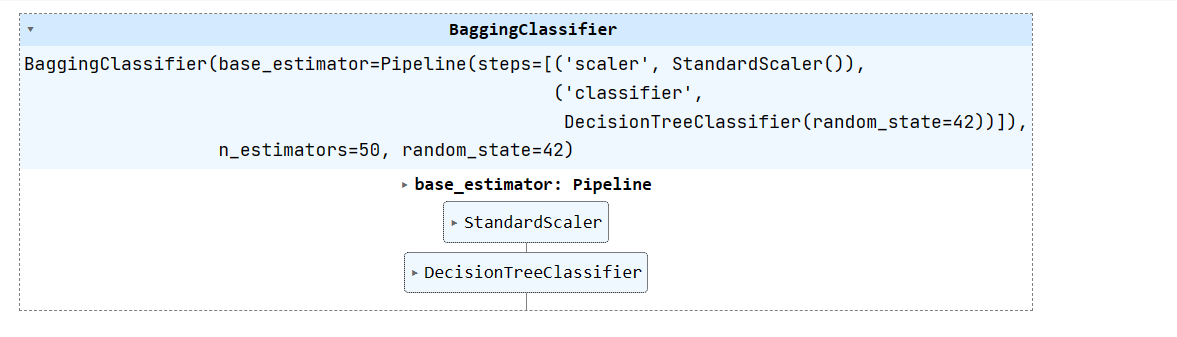
Mari evaluasi hasil model ensemble dan bandingkan dengan kinerja model tunggal. Untuk itu, kita akan menghasilkan classification report pada dataset pengujian.
# Make prediction on the testing data
y_pred = bagging_classifier.predict(X_test)

# Classification Report
print(classification_report(y_pred, y_test))
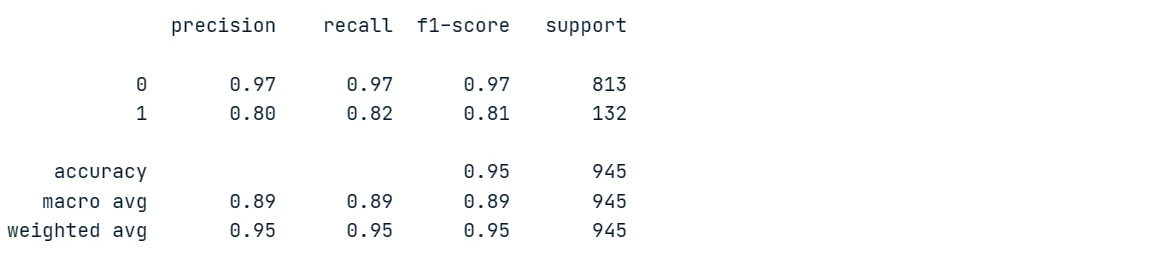
Seperti yang Anda lihat, kinerja model meningkat secara relatif. Presisi dan recall untuk kelas minoritas sama-sama meningkat dari 79% menjadi 80% dan dari 77% menjadi 82%. Ini merupakan peningkatan yang signifikan.
Sekarang mari hitung skor cross-validation.
# Evaluate the classifier using cross-validation
cv_scores = cross_val_score(bagging_classifier, X, y, cv=5)

print(f"Cross-validation scores: {cv_scores}")
print(f"Mean CV accuracy: {np.mean(cv_scores):.2f}")
Skor cross-validation kita memiliki varians rendah, berkisar antara 94% hingga 96%. Akurasi keseluruhan model juga meningkat dari 94% menjadi 95%.
Cross-validation scores: [0.95396825 0.95714286 0.94126984 0.96190476 0.95714286]
Mean CV accuracy: 0.95
Teknik bagging adalah alat yang berguna dalam aplikasi machine learning untuk meningkatkan akurasi dan stabilitas model.
Pelajari teknik ensemble seperti bagging, boosting, dan stacking untuk membangun model machine learning yang canggih dan efektif di Python dengan kursus Ensemble Methods in Python.
Saat menggunakan bagging dalam machine learning, mengikuti praktik terbaik dan tips berikut dapat memaksimalkan efektivitasnya:
n_estimators lebih tinggi seperti 100–200 saat bagging untuk mendapatkan manfaat maksimal.n_jobs. Terapkan di banyak CPU/mesin untuk pelatihan yang lebih cepat.GridSearchCV. Kinerja baik pada model individual biasanya berujung pada kinerja ensemble yang lebih baik.Baca Praktik Terbaik MLOps (Machine Learning Operations) untuk mempelajari praktik MLOps yang sukses demi penerapan sistem machine learning yang andal dan terukur.
Dalam tutorial ini, kita mengeksplorasi bagging, sebuah teknik ensemble machine learning yang kuat. Bagging mengagregasi beberapa model untuk meningkatkan kinerja prediktif secara keseluruhan. Kita telah membandingkannya dengan boosting dan mempelajari keunggulannya dibanding menggunakan satu model.
Pada akhirnya, kita mengimplementasikan bagging classifier di Python pada dataset churn telekomunikasi. Ensemble decision tree yang dibagging meningkatkan akurasi dan kinerja kelas minoritas dibanding decision tree tunggal. Selain itu, kita mempelajari tips dan trik berharga untuk memaksimalkan efektivitas bagging dalam machine learning.
Jika Anda ingin berkarier sebagai machine learning engineer profesional, mulailah dengan mendaftar jalur karier Machine Learning Scientist with Python. Anda akan mempelajari cara melatih model supervised, unsupervised, dan deep learning menggunakan bahasa pemrograman Python.
Mulai Perjalanan Machine Learning Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



