
Khóa học
Tiền xử lý cho Machine Learning bằng Python
4 giờ
69K
Các phương pháp ensemble là những kỹ thuật mạnh mẽ trong machine learning, kết hợp nhiều mô hình để cải thiện độ chính xác dự đoán tổng thể và tính ổn định của mô hình. Bootstrap Aggregating, thường được biết đến là Bagging, nổi bật như một phương pháp ensemble phổ biến và được triển khai rộng rãi.
Trong hướng dẫn này, chúng ta sẽ đi sâu vào bagging, cách hoạt động và điểm mạnh của nó. Chúng ta sẽ so sánh với một phương pháp ensemble khác (Boosting) và xem một ví dụ bagging trong Python. Kết thúc, bạn sẽ nắm vững bagging, bao gồm cả các thực hành tốt nhất.
Ensemble Modeling là kỹ thuật kết hợp nhiều mô hình machine learning để cải thiện hiệu năng dự đoán tổng thể. Ý tưởng cơ bản là một nhóm các bộ học yếu có thể kết hợp thành một bộ học mạnh.
Một mô hình ensemble thường gồm hai bước:
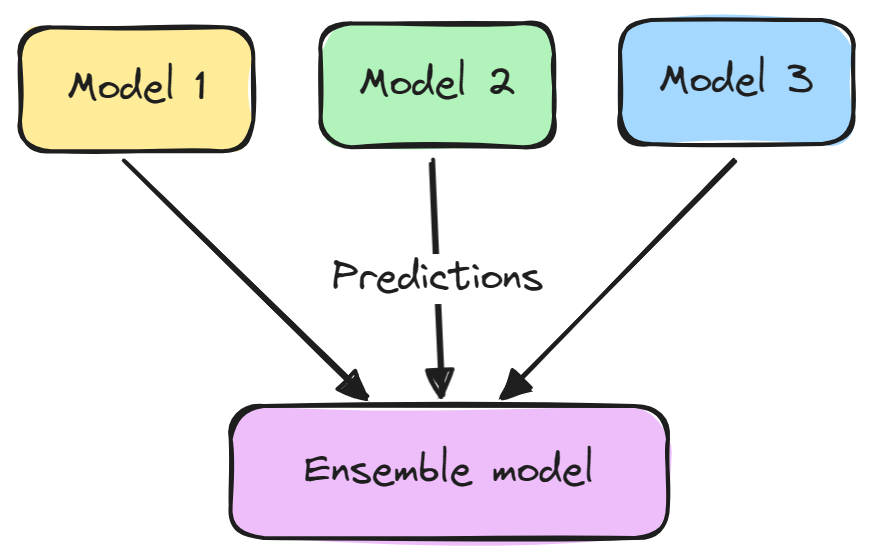
Ensemble thường cho kết quả tốt hơn vì các mô hình khác nhau bổ trợ lẫn nhau và khắc phục các điểm yếu riêng lẻ. Chúng cũng giảm phương sai và ngăn overfitting.
Một số phương pháp ensemble phổ biến là bagging, boosting và stacking. Ensemble learning được dùng rộng rãi trong các tác vụ machine learning như phân loại, hồi quy và phân cụm để tăng độ chính xác và khả năng chống chịu.
Bagging (bootstrap aggregating) là một phương pháp ensemble liên quan đến việc huấn luyện nhiều mô hình độc lập trên các tập con ngẫu nhiên của dữ liệu và tổng hợp dự đoán của chúng thông qua bỏ phiếu hoặc lấy trung bình.
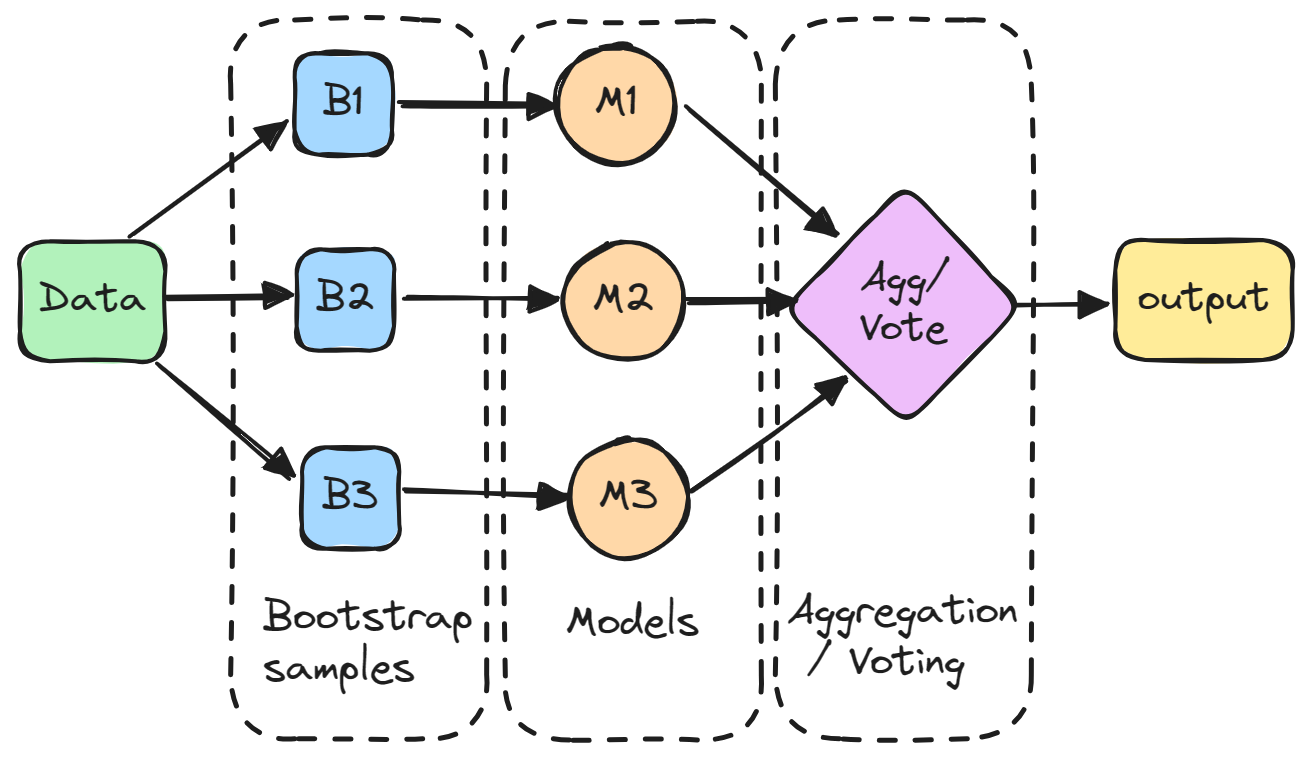
Cụ thể, mỗi mô hình được huấn luyện trên một tập con ngẫu nhiên của dữ liệu được lấy mẫu có hoàn lại, nghĩa là một điểm dữ liệu có thể được chọn nhiều hơn một lần. Tập con ngẫu nhiên này được gọi là mẫu bootstrap. Bằng cách huấn luyện các mô hình trên những bootstrap khác nhau, bagging giảm phương sai của từng mô hình riêng lẻ. Nó cũng tránh overfitting bằng cách cho các mô hình thành phần tiếp xúc với các phần khác nhau của tập dữ liệu.
Các dự đoán từ tất cả mô hình được lấy mẫu sau đó được kết hợp thông qua phép lấy trung bình đơn giản để đưa ra dự đoán tổng thể. Bằng cách này, mô hình tổng hợp tận dụng điểm mạnh của từng mô hình và triệt tiêu lỗi của chúng.
Bagging đặc biệt hiệu quả trong việc giảm phương sai và overfitting, giúp mô hình vững vàng và chính xác hơn, nhất là trong các trường hợp các mô hình riêng lẻ dễ biến động cao.
Boosting là một phương pháp ensemble phổ biến khác thường được so sánh với Bagging. Khác biệt chính nằm ở cách huấn luyện các mô hình thành phần.
Trong bagging, các mô hình được huấn luyện độc lập song song trên những tập con ngẫu nhiên của dữ liệu. Trong khi đó, ở boosting, các mô hình được huấn luyện tuần tự, với mỗi mô hình học từ lỗi của mô hình trước đó. Ngoài ra, bagging thường lấy trung bình đơn giản các mô hình, còn boosting gán trọng số dựa trên độ chính xác.
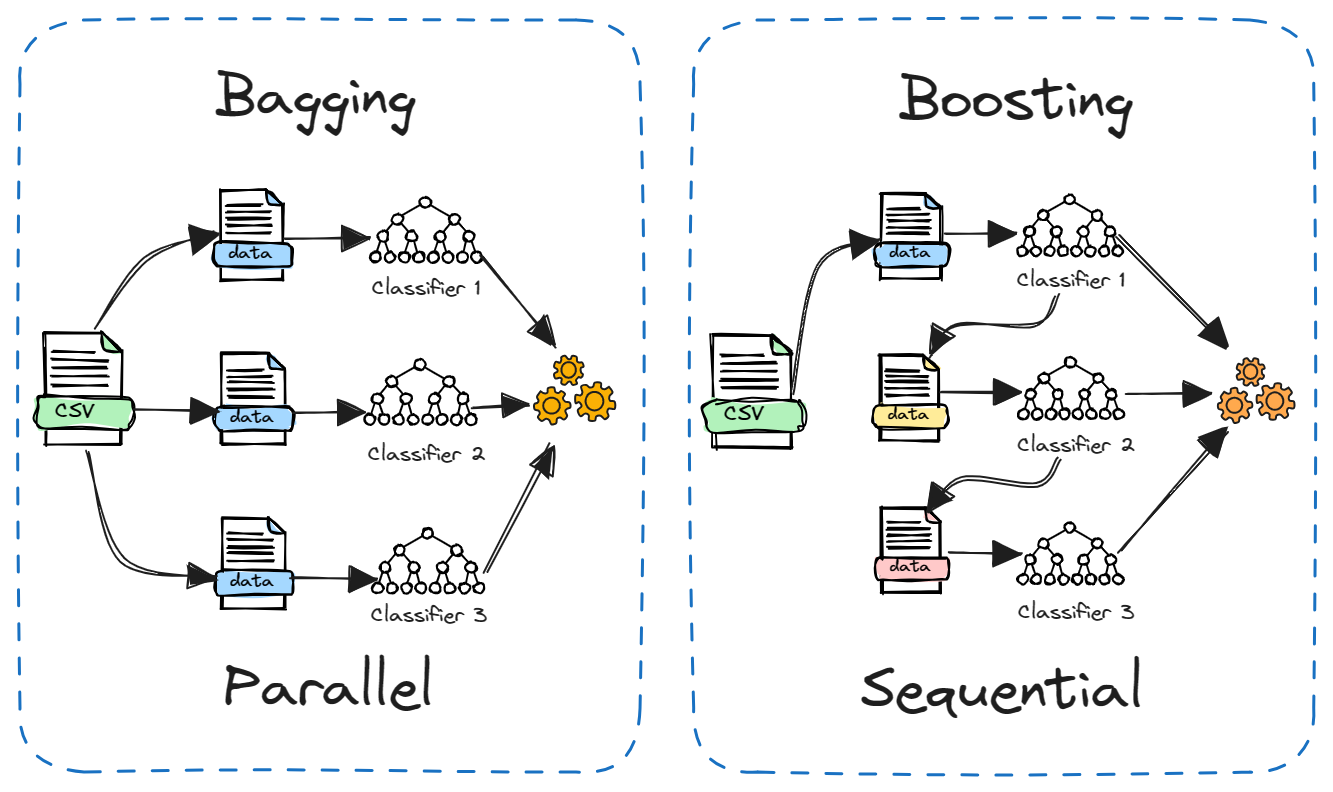
Bagging giảm phương sai trong khi boosting giảm sai lệch (bias). Bagging có thể dùng với các mô hình không ổn định như cây quyết định, còn boosting hoạt động tốt hơn với các mô hình ổn định như hồi quy tuyến tính.
Cả hai phương pháp đều có điểm mạnh và yếu. Bagging dễ chạy song song hơn, trong khi boosting có thể mạnh mẽ và chính xác hơn. Trên thực tế, nên thử cả hai trên một bài toán mới để xem phương pháp nào hiệu quả hơn.
Dưới đây là một số ưu điểm chính của bagging:
Trong hướng dẫn Python này, chúng ta sẽ huấn luyện một mô hình phân loại cây quyết định trên tập dữ liệu rời bỏ dịch vụ của khách hàng viễn thông và sử dụng phương pháp ensemble bagging để cải thiện hiệu năng. Chúng ta sẽ dùng DataLab để lấy dữ liệu và chạy mã. Mã cũng có sẵn trong sổ tay DataLab này, bạn có thể sao chép để chạy trên trình duyệt mà không cần cài đặt gì.
Tập dữ liệu về rời bỏ dịch vụ của khách hàng viễn thông đến từ một công ty viễn thông Iran. Mỗi hàng trong tập dữ liệu tương ứng với hoạt động của một khách hàng trong suốt một năm, bao gồm thông tin về lỗi cuộc gọi, thời gian đăng ký và nhãn rời bỏ cho biết liệu khách hàng có rời bỏ dịch vụ hay không.
Đầu tiên, chúng ta sẽ tải tập dữ liệu và xem 5 hàng đầu tiên.
import pandas as pd

customer = pd.read_csv("data/customer_churn.csv")
customer.head()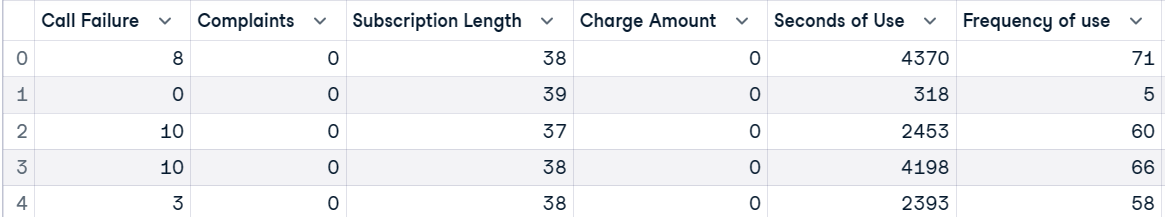
Sau đó, chúng ta sẽ tạo biến độc lập (X) và phụ thuộc (y). Tiếp theo, chúng ta sẽ chia tập dữ liệu thành các tập huấn luyện và kiểm tra.
X = customer.drop("Churn", axis=1)
y = customer.Churn

# Split into train and test
from sklearn.model_selection import train_test_split, cross_val_score
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=1)Chúng ta sẽ tạo một pipeline machine learning đơn giản và fit tập dữ liệu huấn luyện vào đó. Pipeline sẽ chuẩn hóa dữ liệu trước khi đưa đầu vào cho bộ phân loại cây quyết định.
from sklearn.tree import DecisionTreeClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline

pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', DecisionTreeClassifier(random_state=42))
])

pipeline.fit(X_train, y_train)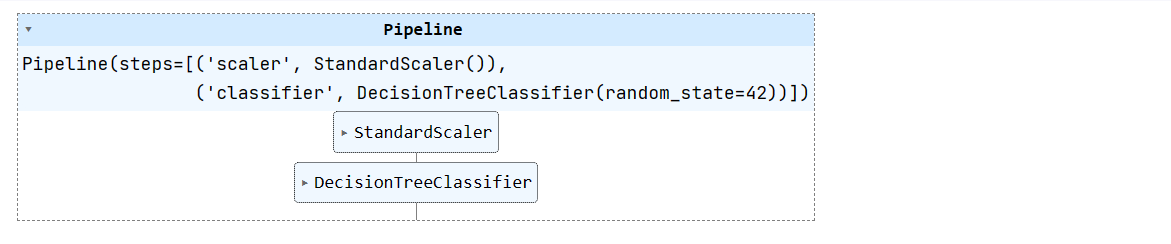
Học khóa Machine Learning với các mô hình dựa trên cây trong Python để học cách dùng mô hình cây và ensemble cho hồi quy và phân loại với scikit-learn.
Chúng ta sẽ đánh giá mô hình cây quyết định để có thể so sánh với mô hình ensemble.
Chúng ta sẽ tạo báo cáo phân loại bằng cách dự đoán trên tập dữ liệu kiểm tra.
from sklearn.metrics import classification_report

# Make prediction on the testing data
y_pred = pipeline.predict(X_test)

# Classification Report
print(classification_report(y_pred, y_test))
Mô hình của chúng ta đạt 96% precision và 97% recall trên lớp đa số “0”, nhưng hoạt động kém trên lớp thiểu số “1”.
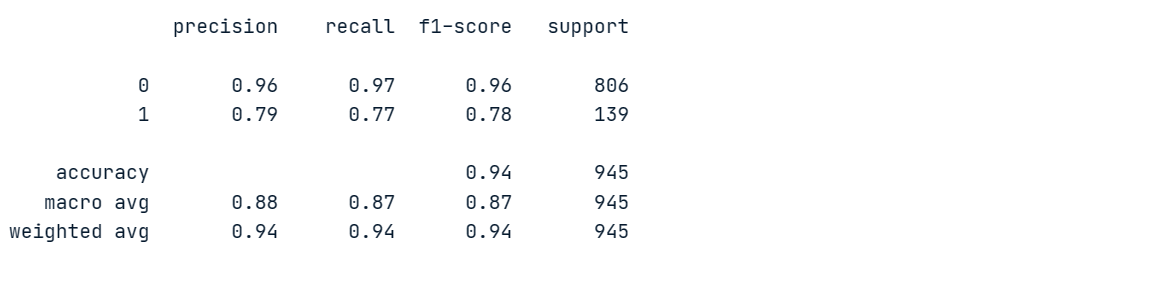
Để hiểu rõ hơn về hiệu năng của mô hình, chúng ta sẽ thực hiện cross-validation và tính các điểm số tương ứng.
# Evaluate the classifier using cross-validation
cv_scores = cross_val_score(pipeline, X, y, cv=5)

print(f"Cross-validation scores: {cv_scores}")
print(f"Mean CV accuracy: {np.mean(cv_scores):.2f}")
Có sự biến thiên lớn trong điểm số, cao nhất 95% và thấp nhất 92%.
Cross-validation scores: [0.95079365 0.94126984 0.93492063 0.94285714 0.92222222]
Mean CV accuracy: 0.94Giờ hãy tạo một bộ phân loại bagging sử dụng bộ ước lượng cơ sở là pipeline của chúng ta (chuẩn hóa + bộ phân loại cây quyết định) và huấn luyện nó trên tập huấn luyện.
Chúng ta có thể cải thiện hiệu năng mô hình bằng cách tăng n_estimators, nhưng 50 là đủ cho kết quả nền tảng.
from sklearn.ensemble import BaggingClassifier

# Create a bagging classifier with the decision tree pipeline
bagging_classifier = BaggingClassifier(base_estimator=pipeline, n_estimators=50, random_state=42)

# Train the bagging classifier on the training data
bagging_classifier.fit(X_train, y_train)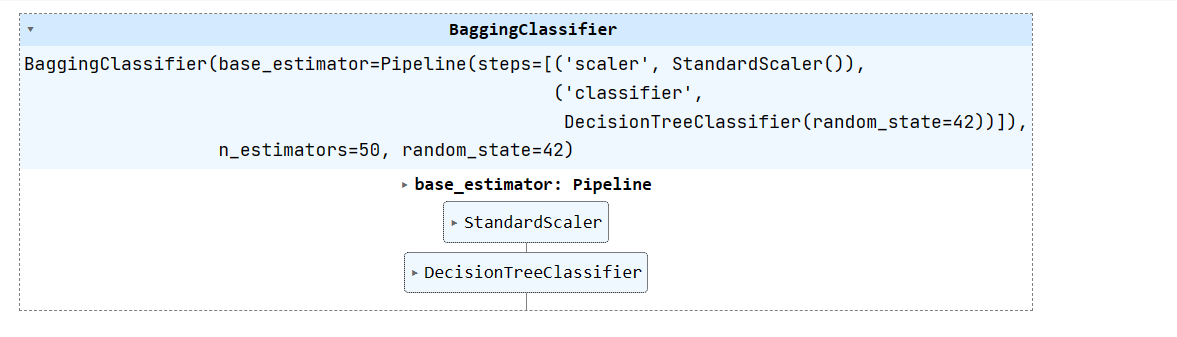
Hãy đánh giá kết quả mô hình ensemble và so sánh với hiệu năng của mô hình đơn lẻ. Để làm vậy, chúng ta sẽ tạo báo cáo phân loại trên tập kiểm tra.
# Make prediction on the testing data
y_pred = bagging_classifier.predict(X_test)

# Classification Report
print(classification_report(y_pred, y_test))
Như bạn thấy, hiệu năng mô hình đã được cải thiện tương đối. Precision và recall cho lớp thiểu số đều tăng, từ 79% lên 80% và từ 77% lên 82%, tương ứng. Đây là một cải thiện đáng kể.
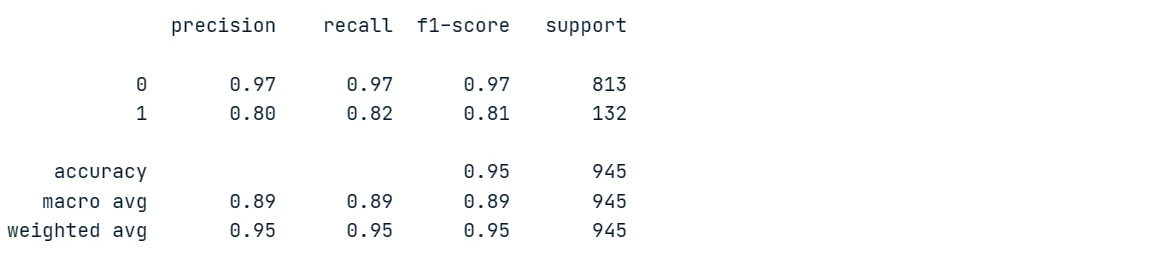
Giờ hãy tính điểm cross-validation.
# Evaluate the classifier using cross-validation
cv_scores = cross_val_score(bagging_classifier, X, y, cv=5)

print(f"Cross-validation scores: {cv_scores}")
print(f"Mean CV accuracy: {np.mean(cv_scores):.2f}")
Điểm cross-validation của chúng ta có phương sai thấp, dao động từ 94% đến 96%. Độ chính xác tổng thể của mô hình cũng tăng từ 94% lên 95%.
Cross-validation scores: [0.95396825 0.95714286 0.94126984 0.96190476 0.95714286]
Mean CV accuracy: 0.95
Kỹ thuật bagging là một công cụ hữu ích trong các ứng dụng machine learning để cải thiện độ chính xác và tính ổn định của mô hình.
Học các kỹ thuật ensemble như bagging, boosting và stacking để xây dựng những mô hình machine learning nâng cao và hiệu quả trong Python với khóa học Ensemble Methods in Python.
Khi dùng bagging trong machine learning, tuân thủ các thực hành tốt và mẹo sau có thể tối đa hóa hiệu quả của nó:
n_estimators cao hơn như 100–200 khi bagging để thu được lợi ích tối đa.n_jobs. Triển khai trên nhiều CPU/máy để huấn luyện nhanh hơn.GridSearchCV. Hiệu năng tốt của từng mô hình thường chuyển hóa thành hiệu năng tốt hơn của ensemble.Đọc Thực hành tốt MLOps (Vận hành Machine Learning) để tìm hiểu các thực hành MLOps thành công cho triển khai hệ thống machine learning đáng tin cậy và có khả năng mở rộng.
Trong hướng dẫn này, chúng ta đã khám phá bagging, một kỹ thuật ensemble machine learning mạnh mẽ. Bagging tổng hợp nhiều mô hình để cải thiện hiệu năng dự đoán tổng thể. Chúng ta đã so sánh nó với boosting và tìm hiểu các ưu điểm so với dùng một mô hình đơn lẻ.
Cuối cùng, chúng ta đã triển khai một bộ phân loại bagging trong Python trên tập dữ liệu rời bỏ dịch vụ viễn thông. Ensemble các cây quyết định theo bagging đã cải thiện độ chính xác và hiệu năng trên lớp thiểu số so với một cây quyết định đơn lẻ. Hơn nữa, chúng ta đã học các mẹo và thủ thuật hữu ích để tối đa hóa hiệu quả của bagging trong machine learning.
Nếu bạn muốn theo đuổi sự nghiệp kỹ sư machine learning chuyên nghiệp, hãy bắt đầu bằng cách ghi danh vào lộ trình nghề nghiệp Machine Learning Scientist with Python. Bạn sẽ học cách huấn luyện các mô hình học có giám sát, không giám sát và học sâu bằng ngôn ngữ Python.
Bắt đầu hành trình Machine Learning của bạn ngay hôm nay!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
