Last chance! 50% off DataCamp Premium
Sale ends in
Ho seguito i lanci di prodotto di Mistral AI dalla famiglia di modelli Mistral 3 a Le Chat fino a Vibe 2.0. Mistral Forge, se ti stai mettendo in pari, non è un rilascio di un modello. È la mossa di Mistral sull’infrastruttura enterprise.
Nvidia GTC ha annunciato il 17 marzo 2026 che Forge consente alle imprese di costruire modelli di AI addestrati interamente su dati interni. Non un semplice fine-tuning su modelli pubblici. Ma un addestramento da zero su decenni di documentazione ingegneristica, codebase proprietarie, framework di conformità e log operativi.
In questo articolo, vedremo cos’è Mistral Forge, come funziona, quando ha senso l’addestramento personalizzato rispetto all’uso di API e quanto costa. Userò esempi di early adopter come ASML ed Ericsson per mostrare dove si inserisce Forge.
Mistral Forge è una piattaforma enterprise per costruire modelli di AI usando i dati proprietari della tua organizzazione. A differenza dei servizi basati su API, dove invii prompt al modello di qualcun altro, Forge ti dà controllo sull’intera pipeline di addestramento.
API di AI tradizionali (OpenAI, Anthropic):
Mistral Forge:
Il problema che continuo a vedere: i modelli generici addestrati su dati pubblici del web non comprendono la conoscenza istituzionale della tua azienda. Allucinano la terminologia specifica di dominio. Non conoscono i tuoi standard ingegneristici, le policy di conformità o le procedure operative. Forge risolve questo permettendoti di costruire modelli che interiorizzano la conoscenza della tua organizzazione dalle fondamenta.
Gli early adopter includono ASML (produzione di semiconduttori), Ericsson (telecomunicazioni), l’Agenzia Spaziale Europea e i DSO National Laboratories di Singapore. Non sono aziende che sperimentano con chatbot. Stanno costruendo AI per operazioni mission-critical, dove i modelli generici non bastano.
Ecco il workflow completo, dall’ingestione dei dati al deployment:
Si parte scegliendo un’architettura base tra i modelli open-weight di Mistral: Mistral Large 3 per ragionamento complesso, Mistral Small 4 per inferenza più rapida e costi inferiori, oppure configurazioni MoE (Mixture-of-Experts) personalizzate che bilanciano prestazioni ed efficienza.
La scelta tra modelli densi e MoE incide sui costi operativi. I modelli densi offrono una forte capacità generale. I modelli MoE possono eguagliare le prestazioni riducendo latenza e costi di calcolo: pensa a risultati comparabili con il 40-60% della spesa infrastrutturale.
Qui entrano in gioco i tuoi dati proprietari. Forge supporta testo non strutturato (documentazione, report, email), codebase con la struttura dei repository preservata, dati strutturati (database, fogli di calcolo) e input multimodali (testo più immagini dove rilevante).
Per i settori regolamentati dove non sempre si possono usare dati reali, Forge include la generazione di dati sintetici. Puoi creare esempi di addestramento conformi alle policy, scenari limite e casi rari che non compaiono spesso nei dati reali ma sono importanti in produzione.
Questa è la parte costosa in cui la conoscenza istituzionale viene incorporata nei pesi neurali. Il pre-training da zero costa milioni in compute, motivo per cui molte organizzazioni lo evitano. Ma è ciò che fa davvero comprendere al modello il tuo dominio.
Il pre-training su grandi dataset interni può richiedere settimane su cluster GPU enterprise. Aziende come ASML ed Ericsson pianificano mesi per i primi run di addestramento, con costi di milioni a seconda del volume dei dati e della dimensione del modello. Non è qualcosa che si esegue su una macchina locale.
Dopo il pre-training, affini il modello per compiti specifici tramite supervised fine-tuning (SFT). Questo comporta l’addestramento su coppie istruzione-risposta specifiche del tuo dominio, ad esempio esaminare richieste di modifica ingegneristiche per violazioni di conformità o analizzare strumenti finanziari secondo la tua tassonomia di rischio interna.
Per carichi agentici, in cui i modelli devono usare strumenti, prendere decisioni e completare task multi-step, il Reinforcement Learning (RL) è il modo per ottimizzare il completamento reale dei compiti, non solo generare testo plausibile. Secondo i report degli early adopter, i modelli addestrati con RL che gestivano escalation clienti hanno superato l’85% di tasso di completamento dei task.
Forge include framework di valutazione allineati ai KPI enterprise, non solo benchmark generici. Definisci metriche personalizzate come accuratezza di conformità, copertura del vocabolario di dominio e soglie di latenza. Durante tutto il processo, Forge traccia tutto: modelli, dataset, run di addestramento, configurazioni. Il version control è di prima classe. Quando i regolatori chiedono "come ha preso questa decisione il modello", hai una lineage completa.
|
Aspetto |
Mistral Forge |
API OpenAI/Anthropic |
RAG + API |
|
Profondità di training |
Pre-training completo sui tuoi dati |
Fine-tuning su modelli pubblici |
Nessun training, solo retrieval |
|
Conoscenza di dominio |
Incorporata nei pesi del modello |
Sottile layer su fondamenta generiche |
Contesto esterno in inferenza |
|
Privacy dei dati |
Deployment on-premises, nessun accesso esterno |
Dati inviati ai server OpenAI/Anthropic |
Documenti archiviati esternamente |
|
Personalizzazione |
Controllo completo (architettura, training, RL) |
Limitata (coppie di istruzioni, esempi) |
Minima (selezione dei documenti) |
|
Complessità di setup |
Molto alta (mesi, team ML richiesto) |
Bassa (chiave API, giorni) |
Media (vector DB, settimane) |
|
Costo |
$2-5M+ per training + inferenza continuativa |
$10-50K/mese tipicamente |
$5-20K/mese tipicamente |
|
Vincolo al fornitore |
Basso (possedi i pesi del modello) |
Alto (dipendenza da API) |
Medio (puoi cambiare LLM) |
Ho parlato con abbastanza team data da riconoscere lo schema: le aziende implementano l’AI, ottengono demo impressionanti, poi vanno a sbattere quando i modelli incontrano terminologia specifica di dominio o devono operare entro vincoli di conformità stringenti.
RAG aiuta. Il fine-tuning aiuta. Ma nessuno dei due risolve il problema di fondo: i modelli generici non sono stati addestrati sulla conoscenza della tua organizzazione.
Mistral scommette che, man mano che l’AI passa da “demo figa” a “infrastruttura core”, le imprese avranno bisogno di modelli che comprendano il loro dominio a livello fondativo. Ecco perché:
Ma ecco la visione controcorrente: la maggior parte delle aziende non ha bisogno di modelli personalizzati. L’automazione del customer service, la Q&A documentale di base e il riassunto delle riunioni funzionano bene con modelli generici e buoni prompt. Forge si rivolge a organizzazioni in cui la specificità di dominio è un vero vantaggio competitivo, non un nice-to-have.
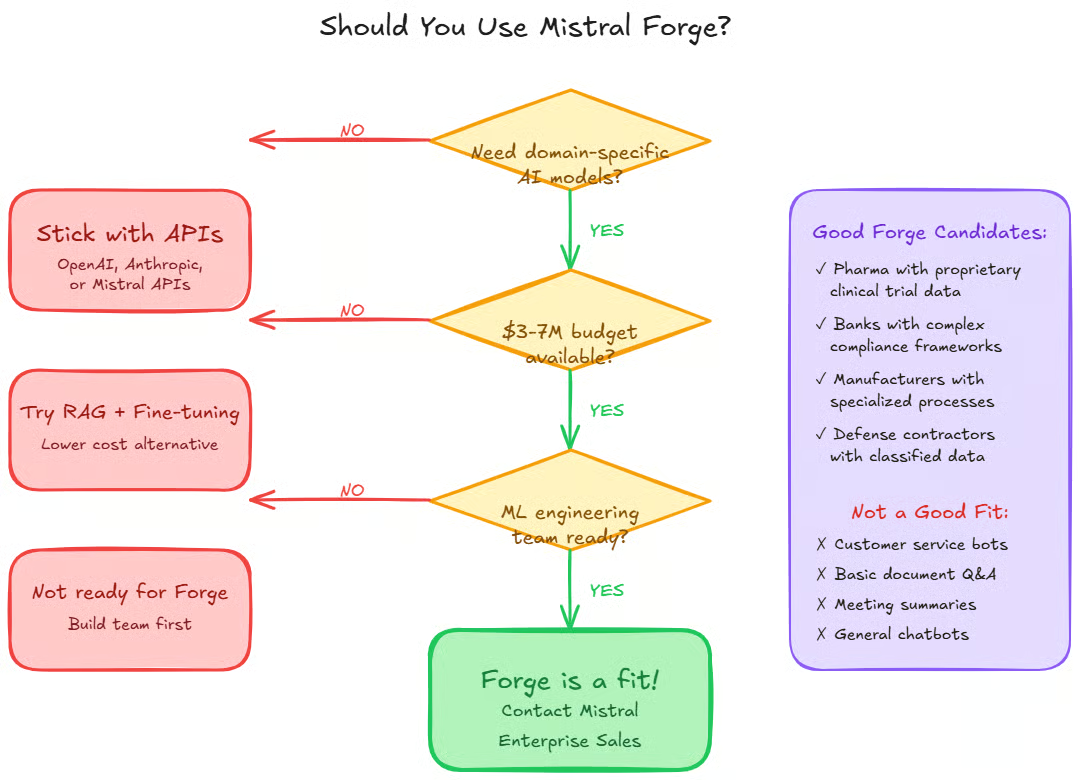
Il primo playbook dell’AI in azienda era comprare accesso API, assumere prompt engineer e aggiungere RAG. Funziona finché non funziona più. Man mano che l’AI diventa infrastruttura e non una feature, le aziende vorranno la proprietà dei loro modelli così come la vogliono per i database. Non tutti. Ma abbastanza da rendere il training personalizzato un mercato sostenibile.
Gli agenti enterprise devono fare più che generare risposte. Devono navigare i sistemi interni, usare correttamente gli strumenti e prendere decisioni entro i vincoli organizzativi. I modelli personalizzati lo rendono possibile. Lo sto già vedendo con Vibe 2.0. Gli agenti che funzionano meglio sono costruiti su modelli addestrati sulle codebase in cui operano.
Le imprese affrontano sempre più requisiti di conformità che rendono insostenibile ospitare dati proprietari in sistemi di terze parti. EU AI Act. GDPR. Regolamenti settoriali in finanza e sanità. Le piattaforme che offrono training on-premises con isolamento completo dei dati hanno un vantaggio strutturale.
Mistral ha annunciato Forge al Nvidia GTC per un motivo. NVIDIA sta costruendo infrastruttura AI enterprise con GPU più economiche, migliori strumenti di training distribuito e inferenza ottimizzata. Con la riduzione dei costi di training, i modelli personalizzati diventano praticabili per una gamma più ampia di casi d’uso.
Ma il controargomento: la maggior parte delle imprese non ha ancora bisogno di questa complessità. L’automazione del customer service non richiede modelli personalizzati. Né l’elaborazione documentale di base. Il mercato si dividerà — la maggior parte resterà sulle API, un segmento più piccolo costruirà infrastrutture personalizzate. Questo segmento più piccolo include alcune delle aziende più grandi e redditizie al mondo. È la scommessa di Mistral.
Prima di contattare il team sales enterprise di Mistral, ti servono una quantità significativa di testo o codice proprietario (i deployment enterprise tipicamente gestiscono terabyte di dati specifici di dominio), un framework di data governance (chi può accedere a cosa, policy di retention, gestione dei dati personali) e criteri di valutazione chiari specifici di dominio.
Per l’infrastruttura: o un cluster GPU (consigliati 8-64 H100 per il training) oppure la disponibilità a usare l’infrastruttura gestita di Mistral. Servono anche ML engineer esperti di training distribuito, esperti di dominio in grado di valutare gli output del modello e una revisione legale/compliance per l’uso dei dati.
Forge non è self-serve. Si passa tramite il team enterprise di Mistral, si discutono i casi d’uso, i requisiti dei dati e i vincoli di deployment. Parti in piccolo — non provare ad addestrare subito su tutti i tuoi dati. Scegli un caso d’uso ad alto valore come l’analisi di documenti di conformità o l’automazione del code review.
La preparazione dei dati richiede più tempo di quanto pensi. Pulizia, formattazione, rimozione dei dati personali, organizzazione per dominio: metti a budget 2-3 mesi qui. Prima di addestrare qualsiasi cosa, prova il prompt engineering con Mistral Large 3 per assicurarti prestazioni accettabili. Potrebbe non servirti alcun training personalizzato.
Inizia con il fine-tuning supervisionato, non con il pre-training completo. È più economico e veloce. Verifica se un tuning specifico per il task su un modello base ti porta all’80% del risultato. Se il fine-tuning non basta, passa al pre-training. Ma sappi che stai impegnando risorse di calcolo e tempo significativi.
Garbage in, garbage out. Se la tua documentazione interna è incoerente, obsoleta o mal strutturata, il modello apprenderà quei pattern. Il training personalizzato non risolve magicamente i problemi dell’AI. Se il tuo caso d’uso non richiede conoscenza specifica di dominio, stai sprecando risorse. Gestire una tua infrastruttura di training è difficile. A meno che tu non abbia una forte capacità di ML engineering, resta sull’offerta gestita di Mistral.
Una grande banca d’investimento aveva bisogno di modelli che comprendessero framework di rischio proprietari — sistemi di rating interni, procedure di conformità, interpretazioni normative specifiche del business. I modelli generici non riuscivano a distinguere tra strumenti finanziari simili nel nome ma con profili di rischio molto diversi, come definiti dal sistema di classificazione interno della banca.
Hanno fatto pre-training su decenni di documentazione sul rischio interna, memo di conformità e filing regolatori. Il modello ha interiorizzato la tassonomia di rischio della banca. Risultato: 94% di accuratezza nei task di revisione di conformità, da 3 giorni di revisione umana a 2 ore di analisi automatizzata con verifica umana.
ASML costruisce le macchine che producono i chip. La loro documentazione ingegneristica copre decenni, più lingue e una terminologia altamente specializzata. Gli ingegneri passavano ore a cercare tra i documenti per capire perché fossero state prese certe decisioni di design.
Hanno addestrato su documenti di design proprietari, file CAD, log di produzione e richieste di modifica ingegneristica. Ora gli ingegneri possono interrogare il modello in linguaggio naturale e ottenere risposte contestualmente rilevanti che citano sezioni specifiche della documentazione. Non è conoscenza pubblica — è intelligenza istituzionale accumulata in decenni.
Una società Fortune 500 doveva migrare una enorme codebase C++ a framework moderni. Decenni di librerie custom, astrazioni interne, dipendenze non documentate. I modelli di codice generici suggerivano modifiche che violavano convenzioni interne o standard architetturali.
Hanno addestrato sull’intera storia del codice dell’azienda — commit, code review, record delle decisioni architetturali, style guide. Il modello ora genera suggerimenti di refactoring che rispettano i pattern interni. In modo analogo a come Mistral Vibe 2.0 funziona meglio quando comprende la struttura del tuo repository.
I prezzi di Forge non sono pubblici. In base a conversazioni enterprise:
Forge non è per tutti. Serve un caso d’uso in cui l’accuratezza di dominio valga milioni. Per la maggior parte delle aziende non è così.
Mistral Forge scambia facilità d’uso con piena proprietà del modello e profonda personalizzazione di dominio. Per la maggior parte delle imprese, penserei ancora che la risposta sia più semplice: resta sulle API. E i modelli generalisti con buoni prompt o RAG funzionano ancora bene per le cose comuni: customer service, elaborazione documentale e riassunto delle riunioni.
Ma per le organizzazioni in cui la specificità di dominio è un vero vantaggio competitivo (penso alla ricerca farmaceutica che analizza dati proprietari sui composti, ai produttori di semiconduttori che ottimizzano i processi di fabbricazione e alle istituzioni finanziarie con i propri framework regolatori), Forge può avere senso. La domanda non è se il training personalizzato sia migliore in teoria, ma se il miglioramento giustifica milioni di costi di training.
Se stai valutando Forge, prova questa progressione: inizia con il prompt engineering usando Mistral Large 3. Aggiungi RAG se serve. Prova il fine-tuning via API. Pensa a ciò che offre Mistral Forge solo se questi approcci falliscono.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min