कोर्स
Understanding Artificial Intelligence
2 घंटा
427K
मैंने Mistral AI के प्रोडक्ट लॉन्च को करीब से फॉलो किया है—Mistral 3 मॉडल फैमिली से लेकर Le Chat और Vibe 2.0 तक। Mistral Forge, अगर आप अपडेट ले रहे हैं, कोई मॉडल रिलीज़ नहीं है। यह Mistral का एंटरप्राइज़ इन्फ्रास्ट्रक्चर की ओर दांव है।
Nvidia GTC ने 17 मार्च, 2026 को घोषणा की थी कि Forge एंटरप्राइज़ेज़ को पूरी तरह आंतरिक डेटा पर प्रशिक्षित AI मॉडल बनाने देता है। पब्लिक मॉडल्स पर सिर्फ फाइन-ट्यून नहीं। सचमुच शुरुआत से ट्रेनिंग—इंजीनियरिंग डॉक्यूमेंट्स के दशकों के आर्काइव, स्वामित्व वाले कोडबेस, कंप्लायंस फ्रेमवर्क, और ऑपरेशनल लॉग्स पर।
इस लेख में, मैं बताऊंगा कि Mistral Forge क्या है, यह कैसे काम करता है, कब कस्टम मॉडल ट्रेनिंग APIs की तुलना में समझदारी है, और इसकी लागत क्या है। मैं ASML और Ericsson जैसे शुरुआती अपनाने वालों के उदाहरणों से दिखाऊंगा कि Forge कहाँ फिट बैठता है।
Mistral Forge आपकी संस्था के स्वामित्व वाले डेटा का उपयोग कर AI मॉडल बनाने के लिए एक एंटरप्राइज़ प्लेटफ़ॉर्म है। API-आधारित सेवाओं के विपरीत जहाँ आप किसी और के मॉडल को प्रॉम्प्ट भेजते हैं, Forge आपको पूरे ट्रेनिंग पाइपलाइन पर नियंत्रण देता है।
पारंपरिक AI APIs (OpenAI, Anthropic):
Mistral Forge:
समस्या जो मैं बार-बार देखता हूँ: सार्वजनिक वेब डेटा पर प्रशिक्षित जनरल मॉडल आपकी कंपनी के संस्थागत ज्ञान को नहीं समझते। वे डोमेन-विशिष्ट टर्मिनोलॉजी पर भ्रमित जवाब देते हैं। उन्हें आपके इंजीनियरिंग मानक, कंप्लायंस नीतियाँ, या ऑपरेशनल प्रक्रियाएँ पता नहीं होतीं। Forge इसका हल देता है—ऐसे मॉडल बनाने देकर जो आपकी संस्था के ज्ञान को बुनियादी स्तर पर आत्मसात कर लेते हैं।
शुरुआती अपनाने वालों में ASML (सेमीकंडक्टर मैन्युफैक्चरिंग), Ericsson (टेलीकम्युनिकेशंस), European Space Agency, और सिंगापुर की DSO National Laboratories शामिल हैं। ये चैटबॉट के साथ प्रयोग करने वाली कंपनियाँ नहीं हैं। ये मिशन-क्रिटिकल ऑपरेशंस के लिए AI बना रही हैं जहाँ जनरल मॉडल पर्याप्त नहीं होते।
यहाँ डेटा इन्गेशन से लेकर डिप्लॉयमेंट तक पूरा वर्कफ़्लो है:
आप Mistral के ओपन-वेट मॉडल्स में से एक बेस आर्किटेक्चर चुनकर शुरू करते हैं: Mistral Large 3 जटिल तर्क के लिए, Mistral Small 4 तेज इन्फ़रेंस और कम लागत के लिए, या कस्टम MoE (Mixture-of-Experts) कॉन्फ़िगरेशन जो परफॉर्मेंस और एफिशिएंसी का संतुलन करते हैं।
घने (dense) और MoE मॉडल के बीच चुनाव ऑपरेशनल लागतों के लिए मायने रखता है। Dense मॉडल मजबूत जनरल क्षमता देते हैं। MoE मॉडल समान परफॉर्मेंस देते हुए लेटेंसी और कंप्यूट लागत घटा सकते हैं—यानि तुलनीय नतीजे, इन्फ्रास्ट्रक्चर खर्च के लगभग 40–60% पर।
यहीं आपका स्वामित्व वाला डेटा काम आता है। Forge असंरचित पाठ (डॉक्यूमेंटेशन, रिपोर्ट, ईमेल), रेपो संरचना सुरक्षित रखते हुए कोडबेस, संरचित डेटा (डेटाबेस, स्प्रेडशीट), और मल्टीमोडल इनपुट (जहाँ प्रासंगिक हो वहाँ पाठ + छवियाँ) को सपोर्ट करता है।
वे विनियमित उद्योग जहाँ वास्तविक डेटा हमेशा उपयोग नहीं किया जा सकता, उनके लिए Forge में सिंथेटिक डेटा जनरेशन शामिल है। आप नीतिपालन-उपयुक्त ट्रेनिंग उदाहरण, एज-केस परिदृश्य, और लंबे-पूंछ वाली स्थितियाँ बना सकते हैं जो वास्तविक डेटा में अक्सर नहीं मिलतीं लेकिन प्रोडक्शन में मायने रखती हैं।
यही महंगा हिस्सा है जहाँ संस्थागत ज्ञान न्यूरल वेट्स में समाहित होता है। शुरुआत से प्री-ट्रेनिंग में भारी कंप्यूट लागत आती है, इसलिए अधिकतर संस्थाएँ इसे छोड़ देती हैं। लेकिन यही मॉडल को सचमुच आपका डोमेन समझने लायक बनाता है।
बड़े आंतरिक डेटासेट्स पर प्री-ट्रेनिंग एंटरप्राइज़ GPU क्लस्टर्स पर हफ्तों लग सकती है। ASML और Ericsson जैसी कंपनियाँ शुरुआती ट्रेनिंग रन के लिए महीनों का समय निर्धारित करती हैं, जिनकी लागत डेटा वॉल्यूम और मॉडल आकार पर निर्भर करते हुए लाखों तक जा सकती है। यह ऐसा नहीं है जो आप लोकल मशीन पर चलाएँ।
प्री-ट्रेनिंग के बाद, आप सुपरवाइज़्ड फाइन-ट्यूनिंग (SFT) से विशेष कार्यों के लिए मॉडल को परिष्कृत करते हैं। इसमें आपके डोमेन-विशिष्ट निर्देश-प्रतिक्रिया जोड़ों पर ट्रेनिंग शामिल होती है—जैसे इंजीनियरिंग चेंज रिक्वेस्ट की कंप्लायंस उल्लंघनों के लिए समीक्षा करना या आपके आंतरिक जोखिम टैक्सोनॉमी के अनुसार वित्तीय साधनों का विश्लेषण करना।
ऐजेंटिक वर्कलोड्स—जहाँ मॉडलों को टूल्स का उपयोग करना, निर्णय लेना, और बहु-चरणीय कार्य पूरे करना होता है—के लिए रिइनफोर्समेंट लर्निंग (RL) वह तरीका है जिससे आप केवल विश्वसनीय टेक्स्ट जनरेट करने के बजाय वास्तविक टास्क कम्प्लीशन के लिए ऑप्टिमाइज़ करते हैं। शुरुआती अपनाने वालों की रिपोर्ट के अनुसार, ग्राहक एस्केलेशन संभालने वाले RL-ट्रेन्ड मॉडल 85% से अधिक टास्क कम्प्लीशन रेट तक पहुँचे।
Forge में एंटरप्राइज़ KPI के अनुरूप इवैल्यूएशन फ़्रेमवर्क शामिल हैं, सिर्फ़ जनरल बेंचमार्क नहीं। आप कस्टम मैट्रिक्स परिभाषित करते हैं—कंप्लायंस एक्यूरेसी, डोमेन शब्दावली कवरेज, और लेटेंसी थ्रेशोल्ड। पूरे प्रोसेस में Forge सब कुछ ट्रैक करता है: मॉडल, डेटासेट्स, ट्रेनिंग रन, कॉन्फ़िग्स। वर्ज़न कंट्रोल प्राथमिकता पर है। जब रेगुलेटर पूछें "मॉडल ने यह निर्णय कैसे लिया," तो आपके पास पूरी वंशावली (lineage) होती है।
|
पहलू |
Mistral Forge |
OpenAI/Anthropic APIs |
RAG + API |
|
ट्रेनिंग गहराई |
आपके डेटा पर पूर्ण प्री-ट्रेनिंग |
पब्लिक मॉडल्स पर फाइन-ट्यूनिंग |
कोई ट्रेनिंग नहीं, केवल रिट्रीवल |
|
डोमेन नॉलेज |
मॉडल वेट्स में समाहित |
जनरल फ़ाउंडेशन पर पतली परत |
इन्फ़रेंस समय पर बाहरी संदर्भ |
|
डेटा प्राइवेसी |
ऑन-प्रिमाइसेज़ डिप्लॉयमेंट, शून्य बाहरी एक्सेस |
डेटा OpenAI/Anthropic सर्वर्स को भेजा जाता है |
दस्तावेज़ बाहरी रूप से संग्रहीत |
|
कस्टमाइज़ेशन |
पूर्ण नियंत्रण (आर्किटेक्चर, ट्रेनिंग, RL) |
सीमित (इंस्ट्रक्शन पेयर्स, उदाहरण) |
न्यूनतम (दस्तावेज़ चयन) |
|
सेटअप जटिलता |
बहुत अधिक (महीने, ML टीम आवश्यक) |
कम (API कुंजी, कुछ दिन) |
मध्यम (वेक्टर DB, कुछ हफ्ते) |
|
लागत |
$2–5M+ ट्रेनिंग के लिए + जारी इन्फ़रेंस |
आम तौर पर $10–50K/माह |
आम तौर पर $5–20K/माह |
|
वेंडर लॉक-इन |
कम (आप मॉडल वेट्स के मालिक हैं) |
उच्च (API पर निर्भरता) |
मध्यम (LLMs बदले जा सकते हैं) |
मैंने पर्याप्त डेटा टीमों से बात की है और पैटर्न स्पष्ट है: कंपनियाँ AI डिप्लॉय करती हैं, डेमो प्रभावशाली लगते हैं, फिर दीवार से टकराती हैं जब मॉडल डोमेन-विशिष्ट शब्दावली या कड़े कंप्लायंस प्रतिबंधों के भीतर काम करना पड़ता है।
RAG मदद करता है। फाइन-ट्यूनिंग भी। लेकिन दोनों मूल समस्या हल नहीं करते: जनरल मॉडल आपकी संस्था के ज्ञान पर प्रशिक्षित नहीं थे।
Mistral का दांव है कि जैसे-जैसे AI "कूल डेमो" से "कोर इन्फ्रास्ट्रक्चर" बनता जाएगा, एंटरप्राइज़ेज़ को ऐसे मॉडल चाहिए होंगे जो उनके डोमेन को बुनियादी स्तर पर समझें। वजहें ये हैं:
लेकिन एक विपरीत राय: ज़्यादातर कंपनियों को कस्टम मॉडल की ज़रूरत नहीं। कस्टमर सर्विस ऑटोमेशन, बेसिक डॉक्यूमेंट Q&A, और मीटिंग समरी—ये सब जनरल-परपज़ मॉडल्स और अच्छे प्रॉम्प्टिंग से ठीक चलते हैं। Forge उन संगठनों को लक्षित करता है जहाँ डोमेन-विशिष्टता वास्तव में प्रतिस्पर्धी बढ़त है, महज़ अच्छा-सा ऐड-ऑन नहीं।
एंटरप्राइज़ AI का शुरुआती प्लेबुक था: API एक्सेस खरीदो, प्रॉम्प्ट इंजीनियर्स हायर करो, और RAG जोड़ो। यह तब तक काम करता है जब तक नहीं करता। जैसे-जैसे AI फ़ीचर से इन्फ्रास्ट्रक्चर बनता है, कंपनियाँ अपने मॉडल्स की ओनरशिप वैसे ही चाहेंगी जैसे वे अपने डेटाबेसेज़ की चाहती हैं। सब नहीं। पर इतने तो होंगे कि कस्टम ट्रेनिंग एक व्यवहार्य बाज़ार बने।
एंटरप्राइज़ एजेंट्स को केवल जवाब जनरेट करने से अधिक करना होगा। उन्हें आंतरिक सिस्टम्स नेविगेट करने, टूल्स सही तरीके से इस्तेमाल करने, और संगठनात्मक सीमाओं में निर्णय लेने होंगे। कस्टम मॉडल यह संभव बनाते हैं। मैं यह पहले से Vibe 2.0 के साथ देख रहा हूँ। जो एजेंट सबसे अच्छा काम करते हैं वे उन्हीं मॉडल्स पर बने होते हैं जो उस कोडबेस पर प्रशिक्षित हैं जिसमें वे काम कर रहे हैं।
एंटरप्राइज़ेज़ पर बढ़ते कंप्लायंस दबाव हैं जो स्वामित्व वाले बिज़नेस डेटा को थर्ड-पार्टी सिस्टम्स में होस्ट करना अव्यावहारिक बनाते हैं। EU AI Act। GDPR। फाइनेंस और हेल्थकेयर में उद्योग-विशिष्ट नियम। ऑन-प्रिमाइसेज़ ट्रेनिंग और पूर्ण डेटा आइसोलेशन देने वाले प्लेटफ़ॉर्म्स को संरचनात्मक बढ़त मिलती है।
Mistral ने Forge की घोषणा Nvidia GTC पर किसी वजह से की। NVIDIA सस्ता GPU, बेहतर डिस्ट्रिब्यूटेड ट्रेनिंग टूल्स, और ऑप्टिमाइज़्ड इन्फ़रेंस के साथ एंटरप्राइज़ AI इन्फ्रास्ट्रक्चर बना रहा है। जैसे-जैसे ट्रेनिंग लागत घटेंगी, कस्टम मॉडल और अधिक उपयोग-केस के लिए व्यावहारिक बनेंगे।
पर पलट तर्क यह है: अधिकांश एंटरप्राइज़ेज़ को अभी इतनी जटिलता की ज़रूरत नहीं। कस्टमर सर्विस ऑटोमेशन के लिए कस्टम मॉडल नहीं चाहिए। न ही बेसिक डॉक्यूमेंट प्रोसेसिंग के लिए। बाज़ार बँटेगा—ज़्यादातर कंपनियाँ APIs पर रहेंगी, छोटा-सा वर्ग कस्टम इन्फ्रास्ट्रक्चर बनाएगा। यह छोटा वर्ग दुनिया की कुछ सबसे बड़ी और सबसे लाभदायक कंपनियों को शामिल करता है। यही Mistral का दांव है।
Mistral की एंटरप्राइज़ सेल्स टीम से संपर्क करने से पहले, आपके पास पर्याप्त डोमेन-विशिष्ट पाठ या कोड होना चाहिए (एंटरप्राइज़ डिप्लॉयमेंट आमतौर पर टेराबाइट्स के डोमेन-विशिष्ट डेटा संभालते हैं), एक डेटा गवर्नेंस फ्रेमवर्क (कौन क्या एक्सेस कर सकता है, रिटेंशन नीतियाँ, PII हैंडलिंग), और स्पष्ट डोमेन-विशिष्ट इवैल्यूएशन मानदंड।
इन्फ्रास्ट्रक्चर के लिए: या तो GPU क्लस्टर (ट्रेनिंग के लिए 8–64 H100 की सिफ़ारिश) या Mistral की मैनेज्ड इन्फ्रास्ट्रक्चर का उपयोग करने की तत्परता। आपको डिस्ट्रिब्यूटेड ट्रेनिंग से परिचित ML इंजीनियर्स, डोमेन विशेषज्ञ जो मॉडल आउटपुट का मूल्यांकन कर सकें, और डेटा उपयोग के लिए लीगल/कंप्लायंस समीक्षा भी चाहिए।
Forge सेल्फ-सर्व नहीं है। आप Mistral की एंटरप्राइज़ टीम के साथ गुजरते हैं, उपयोग-केस, डेटा आवश्यकताएँ, और डिप्लॉयमेंट बाधाएँ पर चर्चा करते हैं। दायरा सीमित रखें—तुरंत अपने सारे डेटा पर ट्रेन करने की कोशिश न करें। एक उच्च-मूल्य उपयोग-केस चुनें, जैसे कंप्लायंस डॉक्यूमेंट विश्लेषण या कोड रिव्यू ऑटोमेशन।
डेटा तैयारी आपके अनुमान से अधिक समय लेती है। क्लीनिंग, फॉर्मैटिंग, PII हटाना, डोमेन के अनुसार व्यवस्थित करना—यहाँ 2–3 महीने का बजट रखें। कुछ भी ट्रेन करने से पहले, Mistral Large 3 के साथ प्रॉम्प्ट इंजीनियरिंग टेस्ट करें ताकि स्वीकार्य परफॉर्मेंस सुनिश्चित हो। संभव है आपको कस्टम ट्रेनिंग की ज़रूरत ही न हो।
पूर्ण प्री-ट्रेनिंग से नहीं, सुपरवाइज़्ड फाइन-ट्यूनिंग से शुरू करें। यह सस्ता और तेज़ है। देखें कि बेस मॉडल पर टास्क-विशिष्ट ट्यूनिंग आपको 80% रास्ता तय करा देती है या नहीं। यदि फाइन-ट्यूनिंग पर्याप्त नहीं है, तब प्री-ट्रेनिंग की ओर जाएँ। लेकिन समझ लें कि आप भारी कंप्यूट संसाधन और समय समर्पित कर रहे हैं।
जैसा इनपुट, वैसा आउटपुट। यदि आपके आंतरिक दस्तावेज़ असंगत, पुराने, या ख़राब संरचित हैं, तो मॉडल वही पैटर्न सीखेगा। कस्टम ट्रेनिंग जादुई रूप से AI समस्याएँ हल नहीं करती। यदि आपके उपयोग-केस को डोमेन-विशिष्ट ज्ञान की ज़रूरत नहीं, तो आप संसाधन बर्बाद कर रहे हैं। अपना ट्रेनिंग इन्फ्रास्ट्रक्चर चलाना कठिन है। जब तक आपके पास गंभीर ML इंजीनियरिंग क्षमता न हो, Mistral की मैनेज्ड पेशकश के साथ रहें।
एक बड़े इन्वेस्टमेंट बैंक को ऐसे मॉडल चाहिए थे जो स्वामित्व वाले जोखिम फ्रेमवर्क—आंतरिक रेटिंग सिस्टम्स, कंप्लायंस प्रक्रियाएँ, उनके व्यवसाय-विशिष्ट रेगुलेटरी व्याख्याएँ—समझें। जनरल मॉडल्स समान सुनाई देने वाले वित्तीय उपकरणों में अंतर नहीं कर पाते थे, जबकि बैंक की आंतरिक वर्गीकरण प्रणाली के अनुसार उनके जोखिम प्रोफाइल बहुत अलग थे।
उन्होंने दशकों के आंतरिक जोखिम दस्तावेज़, कंप्लायंस मेमो, और रेगुलेटरी फाइलिंग पर प्री-ट्रेनिंग की। मॉडल ने बैंक की जोखिम टैक्सोनॉमी आत्मसात कर ली। नतीजा: कंप्लायंस रिव्यू टास्क पर 94% सटीकता, मानव समीक्षा 3 दिन से घटकर मानव सत्यापन के साथ 2 घंटे की स्वचालित विश्लेषण।
ASML वे मशीनें बनाता है जो कंप्यूटर चिप्स बनाती हैं। उनका इंजीनियरिंग डॉक्यूमेंटेशन दशकों तक फैला है, कई भाषाओं में है, और अत्यंत विशिष्ट शब्दावली है। इंजीनियर कई घंटे दस्तावेज़ों में खोजने में लगाते थे कि कुछ डिज़ाइन निर्णय क्यों लिए गए थे।
उन्होंने स्वामित्व वाले डिज़ाइन डॉक्यूमेंट्स, CAD फ़ाइलें, मैन्युफैक्चरिंग लॉग्स, और इंजीनियरिंग चेंज रिक्वेस्ट्स पर ट्रेनिंग की। अब इंजीनियर प्राकृतिक भाषा में मॉडल से प्रश्न कर सकते हैं और विशिष्ट दस्तावेज़ अनुभागों का हवाला देते हुए संदर्भानुकूल उत्तर पाते हैं। यह सार्वजनिक ज्ञान नहीं—यह दशकों में संचित संस्थागत बुद्धिमत्ता है।
एक Fortune 500 कंपनी को एक विशाल C++ कोडबेस को आधुनिक फ़्रेमवर्क्स में माइग्रेट करना था। दशकों के कस्टम लाइब्रेरीज़, आंतरिक एब्स्ट्रैक्शंस, बिना डॉक्यूमेंटेड डिपेंडेंसीज़। जनरल कोड मॉडल्स ऐसे बदलाव सुझाते थे जो आंतरिक परंपराएँ तोड़ देते या आर्किटेक्चरल मानकों का उल्लंघन करते।
उन्होंने कंपनी के पूरे कोड इतिहास—कमिट्स, कोड रिव्यूज़, आर्किटेक्चरल निर्णय अभिलेख, स्टाइल गाइड्स—पर ट्रेनिंग की। अब मॉडल ऐसे रिफैक्टरिंग सुझाव जनरेट करता है जो आंतरिक पैटर्न का सम्मान करते हैं। ठीक वैसे ही जैसे Mistral Vibe 2.0 तब बेहतर काम करता है जब उसे आपके रेपो की संरचना समझ आती है।
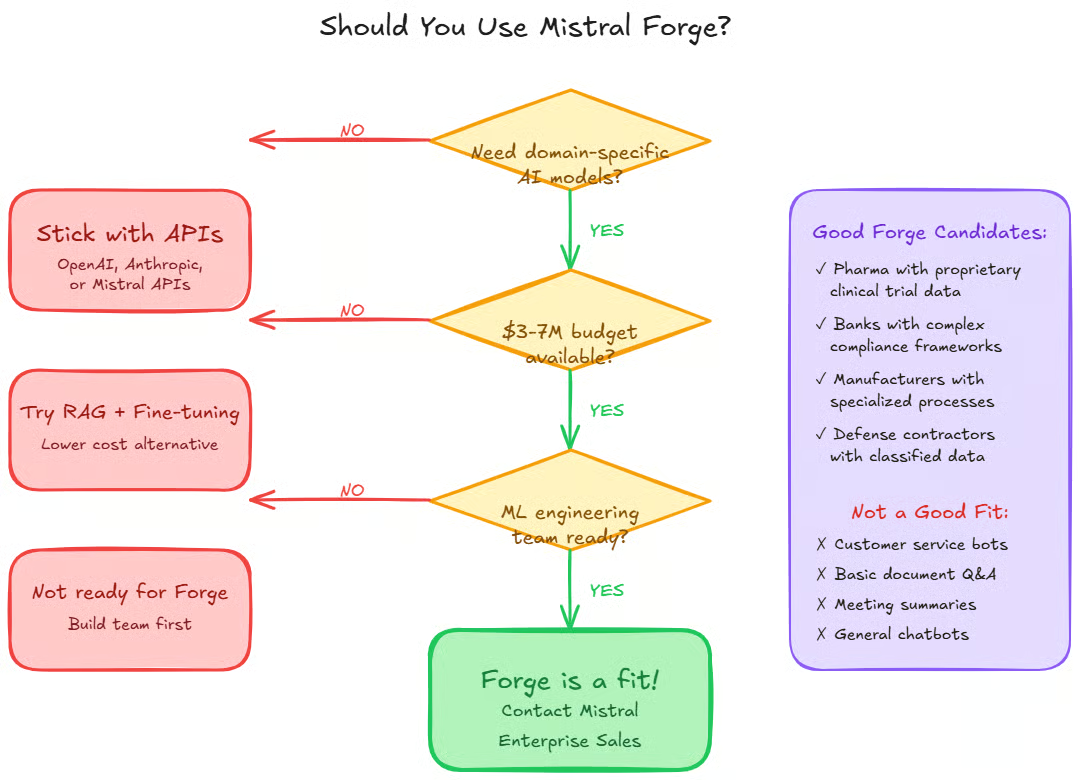
Forge की कीमतें सार्वजनिक रूप से सूचीबद्ध नहीं हैं। एंटरप्राइज़ सेल्स बातचीत के आधार पर:
Forge सबके लिए नहीं है। आपको ऐसा उपयोग-केस चाहिए जहाँ डोमेन सटीकता की कीमत लाखों में जायज़ हो। अधिकांश कंपनियों के लिए ऐसा नहीं है।
Mistral Forge उपयोग में सरलता के बदले पूर्ण मॉडल ओनरशिप और गहरी डोमेन कस्टमाइज़ेशन देता है। अधिकांश एंटरप्राइज़ेज़ के लिए, मेरा मानना अब भी सरल है: APIs के साथ बने रहें। और जनरल-परपज़ मॉडल्स, प्रभावी प्रॉम्प्टिंग या RAG के साथ, आम ज़रूरतों—कस्टमर सर्विस, डॉक्यूमेंट प्रोसेसिंग, और मीटिंग समरी—के लिए अच्छी तरह काम करते हैं।
पर जिन संगठनों के लिए डोमेन-विशिष्टता वास्तविक प्रतिस्पर्धी बढ़त है (जैसे स्वामित्व वाले कम्पाउंड डेटा का विश्लेषण करने वाला फ़ार्मास्यूटिकल रिसर्च, फ़ैब्रिकेशन प्रक्रियाओं का अनुकूलन करने वाले सेमीकंडक्टर निर्माता, और अपनी रेगुलेटरी फ़्रेमवर्क्स वाले वित्तीय संस्थान), उनके लिए Forge समझ में आ सकता है। प्रश्न यह नहीं कि सिद्धांत में कस्टम ट्रेनिंग बेहतर है या नहीं, बल्कि यह कि क्या सुधार ट्रेनिंग की लाखों की लागत को न्यायोचित ठहराता है।
यदि आप Forge का मूल्यांकन कर रहे हैं, तो यह क्रम आज़माएँ: Mistral Large 3 से प्रॉम्प्ट इंजीनियरिंग शुरू करें। ज़रूरत हो तो RAG जोड़ें। API-आधारित फाइन-ट्यूनिंग आज़माएँ। केवल तब सोचें कि Mistral Forge क्या ऑफ़र करता है जब ये तरीक़े विफल हों।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स