Curso
Entendendo a inteligência artificial
2 h
421.5K
Tenho acompanhado os lançamentos de produto da Mistral AI, da família de modelos Mistral 3 ao Le Chat e ao Vibe 2.0. O Mistral Forge, se você está se atualizando agora, não é um novo modelo. É a aposta da Mistral em infraestrutura para empresas.
Nvidia GTC anunciou em 17 de março de 2026: o Forge permite que empresas construam modelos de IA treinados inteiramente com dados internos. Não é apenas ajuste fino em cima de modelos públicos. É treinamento do zero com décadas de documentos de engenharia, bases de código proprietárias, frameworks de compliance e logs operacionais.
Neste artigo, vou explicar o que é o Mistral Forge, como funciona, quando faz sentido treinar modelos customizados em vez de usar APIs e quanto custa. Vou usar exemplos de early adopters como ASML e Ericsson para mostrar onde o Forge se encaixa.
Mistral Forge é uma plataforma corporativa para construir modelos de IA usando os dados proprietários da sua organização. Diferente de serviços baseados em API, nos quais você envia prompts para o modelo de outra empresa, o Forge dá controle sobre todo o pipeline de treinamento.
APIs de IA tradicionais (OpenAI, Anthropic):
Mistral Forge:
O problema que vejo o tempo todo: modelos genéricos treinados com dados públicos não entendem o conhecimento institucional da sua empresa. Eles alucinam termos específicos do seu domínio. Não conhecem seus padrões de engenharia, políticas de compliance ou procedimentos operacionais. O Forge resolve isso permitindo construir modelos que internalizam o conhecimento da sua organização desde a base.
Os primeiros adotantes incluem ASML (fabricação de semicondutores), Ericsson (telecom), a Agência Espacial Europeia e o DSO National Laboratories de Singapura. Não são empresas testando chatbots. Estão construindo IA para operações de missão crítica, onde modelos genéricos não dão conta.
Aqui está o fluxo completo, da ingestão de dados ao deploy:
Você começa escolhendo uma arquitetura base entre os modelos de pesos abertos da Mistral: Mistral Large 3 para raciocínio complexo, Mistral Small 4 para inferência mais rápida e menores custos, ou configurações MoE (Mixture-of-Experts) customizadas que equilibram desempenho e eficiência.
A escolha entre modelos densos e MoE impacta os custos operacionais. Modelos densos oferecem boa capacidade geral. Modelos MoE podem igualar o desempenho reduzindo latência e custo de computação — pense em resultados comparáveis com 40–60% do gasto em infraestrutura.
É aqui que entram seus dados proprietários. O Forge suporta texto não estruturado (documentação, relatórios, e-mails), bases de código preservando a estrutura dos repositórios, dados estruturados (bancos de dados, planilhas) e entradas multimodais (texto e imagens quando relevante).
Para setores regulados, em que nem sempre é possível usar dados reais, o Forge inclui geração de dados sintéticos. Você pode criar exemplos de treinamento em conformidade com políticas, cenários de borda e situações de cauda longa que são raras nos dados reais, mas críticas em produção.
Esta é a parte cara, onde o conhecimento institucional é gravado nos pesos da rede neural. Pré-treinar do zero custa milhões em computação — por isso a maioria das organizações pula essa etapa. Mas é o que faz o modelo realmente entender seu domínio.
Pré-treinar em grandes conjuntos internos pode levar semanas em clusters corporativos de GPU. Empresas como ASML e Ericsson reservam cronogramas de meses para as primeiras rodadas, com custos de milhões dependendo do volume de dados e do tamanho do modelo. Não é algo para rodar em uma máquina local.
Após o pré-treinamento, você refina o modelo para tarefas específicas via fine-tuning supervisionado (SFT). Envolve treinar com pares instrução-resposta do seu domínio, como revisar solicitações de mudança de engenharia por violações de compliance ou analisar instrumentos financeiros segundo sua taxonomia interna de risco.
Para cargas agentic — modelos que precisam usar ferramentas, tomar decisões e concluir tarefas em múltiplas etapas — o Reinforcement Learning (RL) é como você otimiza para conclusão real da tarefa, não apenas para texto plausível. Segundo relatos de early adopters, modelos treinados com RL para lidar com escalonamentos de clientes alcançaram taxas de conclusão acima de 85%.
O Forge inclui frameworks de avaliação alinhados a KPIs corporativos, não apenas benchmarks genéricos. Você define métricas customizadas como acurácia de compliance, cobertura de vocabulário do domínio e limites de latência. Ao longo do processo, o Forge rastreia tudo: modelos, datasets, execuções de treino, configs. Controle de versão é nativo. Quando reguladores perguntam "como o modelo tomou esta decisão", você tem toda a linhagem.
|
Aspecto |
Mistral Forge |
APIs OpenAI/Anthropic |
RAG + API |
|
Profundidade do treinamento |
Pré-treinamento completo nos seus dados |
Ajuste fino em cima de modelos públicos |
Sem treinamento, apenas recuperação |
|
Conhecimento de domínio |
Incorporado nos pesos do modelo |
Camada fina sobre uma base genérica |
Contexto externo na inferência |
|
Privacidade de dados |
Deploy on-premises, zero acesso externo |
Dados enviados aos servidores da OpenAI/Anthropic |
Documentos armazenados externamente |
|
Customização |
Controle total (arquitetura, treinamento, RL) |
Limitada (pares de instrução, exemplos) |
Mínima (seleção de documentos) |
|
Complexidade de setup |
Muito alta (meses, time de ML necessário) |
Baixa (chave de API, dias) |
Média (banco vetorial, semanas) |
|
Custo |
US$ 2–5M+ para treinamento + inferência contínua |
US$ 10–50K/mês, em geral |
US$ 5–20K/mês, em geral |
|
Dependência de fornecedor |
Baixa (você possui os pesos) |
Alta (dependência da API) |
Média (pode trocar de LLM) |
Conversei com times de dados suficientes para reconhecer o padrão: as empresas implementam IA, fazem demos impressionantes e esbarram em um muro quando os modelos encaram terminologia de nicho ou precisam operar sob regras rígidas de compliance.
RAG ajuda. Fine-tuning ajuda. Mas nenhum resolve o problema de base: modelos genéricos não foram treinados com o conhecimento da sua organização.
A Mistral aposta que, à medida que a IA deixa de ser “demo legal” e vira “infraestrutura”, as empresas vão precisar de modelos que entendam seu domínio de forma fundamental. Eis o porquê:
Mas aqui vai a visão contrária: a maioria das empresas não precisa de modelos customizados. Automação de atendimento, Q&A básico de documentos e resumo de reuniões funcionam bem com modelos generalistas e bom prompting. O Forge mira organizações em que a especificidade do domínio é uma vantagem competitiva real, não um “nice to have”.
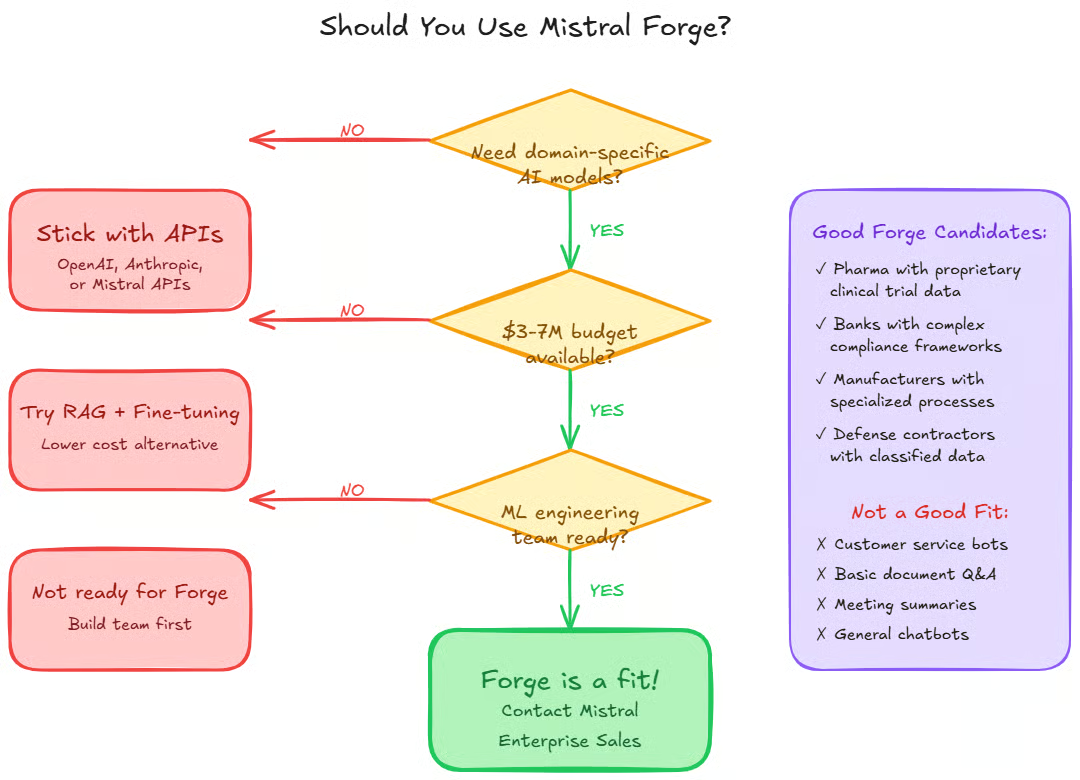
O playbook inicial de IA corporativa era: comprar acesso via API, contratar prompt engineers e usar RAG. Funciona — até deixar de funcionar. Conforme a IA vira infraestrutura, as empresas vão querer propriedade dos seus modelos do mesmo jeito que querem propriedade de seus bancos de dados. Não todas. Mas o suficiente para tornar o treinamento customizado um mercado viável.
Agentes corporativos precisam fazer mais do que gerar respostas. Eles têm que navegar sistemas internos, usar ferramentas corretamente e decidir dentro das restrições da organização. Modelos customizados tornam isso possível. Já vejo isso no Vibe 2.0. Os agentes que melhor performam são construídos sobre modelos treinados nas bases de código onde vão operar.
As empresas enfrentam cada vez mais requisitos de compliance que tornam inviável hospedar dados proprietários em sistemas de terceiros. EU AI Act. GDPR. Regulamentações setoriais em finanças e saúde. Plataformas que oferecem treinamento on-premises com isolamento total de dados têm vantagem estrutural.
A Mistral anunciou o Forge na Nvidia GTC por um motivo. A NVIDIA está construindo infraestrutura de IA corporativa com GPUs mais baratas, melhores ferramentas de treinamento distribuído e inferência otimizada. À medida que os custos caem, modelos customizados se tornam viáveis para mais casos de uso.
Mas o contraponto: a maioria das empresas ainda não precisa dessa complexidade. Automação de atendimento não requer modelo customizado. Processamento documental básico também não. O mercado vai se dividir — a maioria fica com APIs; um segmento menor constrói infraestrutura própria. Esse segmento menor inclui algumas das maiores e mais lucrativas empresas do mundo. É nessa aposta que a Mistral está.
Antes de falar com o time de vendas enterprise da Mistral, você precisa de um volume significativo de texto ou código proprietário (deployments corporativos normalmente lidam com terabytes de dados específicos do domínio), um framework de governança de dados (quem acessa o quê, políticas de retenção, tratamento de PII) e critérios claros de avaliação específicos do domínio.
De infraestrutura: ou um cluster de GPUs (recomendado 8–64 H100s para treinamento) ou disposição para usar a infraestrutura gerenciada da Mistral. Você também precisa de engenheiros de ML com experiência em treinamento distribuído, especialistas de domínio para avaliar saídas do modelo e revisão jurídica/compliance para uso dos dados.
O Forge não é self-service. Você passa pelo time enterprise da Mistral, discute casos de uso, requisitos de dados e restrições de deploy. Comece enxuto — não tente treinar com todos os seus dados de cara. Escolha um caso de alto valor, como análise de documentos de compliance ou automação de code review.
A preparação de dados leva mais tempo do que você imagina. Limpeza, formatação, remoção de PII, organização por domínio — reserve 2–3 meses. Antes de treinar qualquer coisa, teste prompting com o Mistral Large 3 para garantir performance aceitável. Pode ser que você nem precise de treinamento customizado.
Comece com fine-tuning supervisionado, não com pré-treinamento completo. É mais barato e rápido. Veja se o ajuste específico de tarefa em um modelo base leva você a 80% do objetivo. Se não bastar, avance para o pré-treinamento. Mas entenda: você estará comprometendo recursos computacionais e tempo significativos.
Lixo entra, lixo sai. Se seus documentos internos são inconsistentes, desatualizados ou mal estruturados, o modelo vai aprender esses padrões. Treinamento customizado não faz mágica. Se seu caso não exige conhecimento específico do domínio, você está desperdiçando recursos. Operar sua própria infraestrutura de treinamento é difícil. A não ser que você tenha uma capacidade forte de engenharia de ML, prefira a oferta gerenciada da Mistral.
Um grande banco de investimento precisava de modelos que entendessem frameworks de risco proprietários — sistemas de rating internos, procedimentos de compliance, interpretações regulatórias específicas do negócio. Modelos genéricos não distinguiam instrumentos financeiros de nomes parecidos, mas com perfis de risco muito diferentes conforme a classificação interna do banco.
Eles pré-treinaram com décadas de documentação de risco interna, memorandos de compliance e registros regulatórios. O modelo internalizou a taxonomia de risco do banco. Resultado: 94% de acurácia em tarefas de revisão de compliance, reduzindo de 3 dias de revisão humana para 2 horas de análise automatizada com verificação humana.
A ASML constrói as máquinas que fabricam chips. Sua documentação de engenharia abrange décadas, vários idiomas e uma terminologia altamente especializada. Engenheiros gastavam horas procurando por documentos para entender por que certas decisões de design foram tomadas.
Eles treinaram com documentos proprietários de design, arquivos CAD, logs de manufatura e solicitações de mudança de engenharia. Agora, engenheiros consultam o modelo em linguagem natural e recebem respostas contextuais citando seções específicas da documentação. Não é conhecimento público — é inteligência institucional acumulada em décadas.
Uma empresa da Fortune 500 precisava migrar uma enorme base de código C++ para frameworks modernos. Décadas de bibliotecas customizadas, abstrações internas, dependências sem documentação. Modelos de código genéricos sugeriam mudanças que quebravam convenções internas ou violavam padrões arquiteturais.
Eles treinaram com todo o histórico de código da empresa — commits, code reviews, registros de decisões arquiteturais, guias de estilo. O modelo agora gera sugestões de refatoração que respeitam padrões internos. Similar a como o Mistral Vibe 2.0 funciona melhor quando entende a estrutura do seu repositório.
Os preços do Forge não são divulgados publicamente. Com base em conversas enterprise:
O Forge não é para todo mundo. Você precisa de um caso em que a precisão no domínio valha milhões. A maioria das empresas não se encaixa nisso.
O Mistral Forge troca facilidade de uso por total propriedade do modelo e customização profunda de domínio. Para a maioria das empresas, eu ainda diria algo mais simples: fique com as APIs. E modelos generalistas com prompting eficaz ou RAG ainda funcionam muito bem para o básico: atendimento, processamento de documentos e resumo de reuniões.
Mas para organizações em que a especificidade do domínio é uma vantagem competitiva real (penso em pesquisa farmacêutica analisando dados proprietários de compostos, fabricantes de semicondutores otimizando processos de fabricação e instituições financeiras com seus arcabouços regulatórios), o Forge pode fazer sentido. A questão não é se o treinamento customizado é melhor na teoria, mas se a melhoria compensa milhões em custos de treinamento.
Se você for avaliar o Forge, siga esta sequência: comece com engenharia de prompts usando o Mistral Large 3. Adicione RAG se necessário. Tente o fine-tuning via API. Só pense no que o Mistral Forge tem a oferecer se essas abordagens não derem certo.
Aprenda com a DataCamp
Curso
Curso
Curso
blog
Natassha Selvaraj
15 min
blog
Adel Nehme
15 min
blog
Abid Ali Awan
11 min
Tutorial
Zoumana Keita
8 min
Tutorial
Josep Ferrer
11 min
Tutorial
Zoumana Keita
14 min