Curso
Comprender la inteligencia artificial
2 h
421.5K
He seguido de cerca los lanzamientos de producto de Mistral AI, desde la familia de modelos Mistral 3 hasta Le Chat y Vibe 2.0. Mistral Forge, si te estás poniendo al día, no es un nuevo modelo. Es la apuesta de Mistral por la infraestructura para empresas.
Nvidia GTC anunció el 17 de marzo de 2026 que Forge permite a las empresas construir modelos de IA entrenados íntegramente con datos internos. No es un simple ajuste fino sobre modelos públicos. Es entrenamiento real desde cero con décadas de documentación de ingeniería, bases de código propietarias, marcos de cumplimiento y registros operativos.
En este artículo, te cuento qué es Mistral Forge, cómo funciona, cuándo tiene sentido entrenar modelos a medida frente a usar APIs y cuánto cuesta. Usaré ejemplos de pioneros como ASML y Ericsson para mostrar dónde encaja Forge.
Mistral Forge es una plataforma empresarial para crear modelos de IA utilizando los datos propietarios de tu organización. A diferencia de los servicios basados en API en los que envías indicaciones al modelo de otro, Forge te da el control de toda la cadena de entrenamiento.
APIs de IA tradicionales (OpenAI, Anthropic):
Mistral Forge:
El problema que veo una y otra vez: los modelos genéricos entrenados con datos públicos no captan el conocimiento institucional de tu empresa. Alucinan con la terminología específica del dominio. No conocen tus estándares de ingeniería, políticas de cumplimiento ni procedimientos operativos. Forge lo soluciona permitiéndote construir modelos que interiorizan el conocimiento de tu organización desde la base.
Los primeros en adoptarlo incluyen ASML (fabricación de semiconductores), Ericsson (telecomunicaciones), la Agencia Espacial Europea y los DSO National Laboratories de Singapur. No están jugando con chatbots. Están construyendo IA para operaciones críticas, donde los modelos genéricos no dan la talla.
Este es el flujo completo, desde la ingesta de datos hasta el despliegue:
Empiezas eligiendo una arquitectura base de los modelos de pesos abiertos de Mistral: Mistral Large 3 para razonamiento complejo, Mistral Small 4 para inferencia más rápida y menor coste, o configuraciones MoE (Mixture-of-Experts) a medida que equilibran rendimiento y eficiencia.
La elección entre modelos densos y MoE afecta a los costes operativos. Los densos ofrecen gran capacidad generalista. Los MoE pueden igualar el rendimiento reduciendo latencia y coste de cómputo; piensa en resultados comparables con un 40-60% del gasto en infraestructura.
Aquí entran tus datos propietarios. Forge admite texto no estructurado (documentación, informes, emails), bases de código manteniendo la estructura de repositorios, datos estructurados (bases de datos, hojas de cálculo) y entradas multimodales (texto e imágenes cuando proceda).
Para sectores regulados donde no siempre se puede usar el dato real, Forge incluye generación de datos sintéticos. Puedes crear ejemplos de entrenamiento conformes a políticas, escenarios de esquina y casos de cola larga que rara vez aparecen en los datos reales pero son críticos en producción.
Esta es la parte costosa en la que el conocimiento institucional se incrusta en los pesos neuronales. El preentrenamiento desde cero cuesta millones en cómputo, por eso la mayoría lo evita. Pero es lo que hace que el modelo entienda de verdad tu dominio.
El preentrenamiento sobre grandes conjuntos internos puede llevar semanas en clústeres GPU empresariales. Empresas como ASML y Ericsson asignan meses para las ejecuciones iniciales, con costes de millones según volumen de datos y tamaño del modelo. Esto no se ejecuta en tu portátil.
Tras el preentrenamiento, perfeccionas el modelo para tareas concretas mediante ajuste fino supervisado (SFT). Se entrena con pares instrucción-respuesta específicos de tu dominio, como revisar solicitudes de cambio de ingeniería en busca de incumplimientos o analizar instrumentos financieros según tu taxonomía interna de riesgos.
Para cargas de trabajo agénticas, en las que los modelos deben usar herramientas, tomar decisiones y completar tareas de varios pasos, el aprendizaje por refuerzo (RL) optimiza la finalización real de tareas, no solo generar texto verosímil. Según informes de primeros usuarios, los modelos entrenados con RL para gestionar escalados de clientes superaron el 85% de tasa de resolución.
Forge incluye marcos de evaluación alineados con KPIs empresariales, no solo benchmarks genéricos. Defines métricas a medida como precisión en cumplimiento, cobertura de vocabulario de dominio y umbrales de latencia. Durante todo el proceso, Forge lo registra todo: modelos, datos, ejecuciones de entrenamiento, configuraciones. El control de versiones es nativo. Cuando los reguladores pregunten «¿cómo tomó el modelo esta decisión?», tendrás el linaje completo.
|
Aspecto |
Mistral Forge |
APIs de OpenAI/Anthropic |
RAG + API |
|
Profundidad de entrenamiento |
Preentrenamiento completo con tus datos |
Ajuste fino sobre modelos públicos |
Sin entrenamiento, solo recuperación |
|
Conocimiento de dominio |
Incrustado en los pesos del modelo |
Capa fina sobre una base genérica |
Contexto externo en inferencia |
|
Privacidad de datos |
Despliegue on-premises, sin acceso externo |
Datos enviados a servidores de OpenAI/Anthropic |
Documentos almacenados externamente |
|
Personalización |
Control total (arquitectura, entrenamiento, RL) |
Limitada (pares de instrucciones, ejemplos) |
Mínima (selección de documentos) |
|
Complejidad de puesta en marcha |
Muy alta (meses, equipo de ML necesario) |
Baja (clave de API, días) |
Media (BD vectorial, semanas) |
|
Coste |
$2-5M+ por entrenamiento + inferencia continua |
$10-50K/mes normalmente |
$5-20K/mes normalmente |
|
Dependencia del proveedor |
Baja (posees los pesos del modelo) |
Alta (dependencia de API) |
Media (puedes cambiar de LLM) |
He hablado con suficientes equipos de datos para ver el patrón: las empresas despliegan IA, hacen demos espectaculares, y luego se estrellan cuando los modelos se topan con terminología específica del dominio o con límites estrictos de cumplimiento.
RAG ayuda. El ajuste fino también. Pero ninguno resuelve el problema de fondo: los modelos genéricos no se entrenaron con el conocimiento de tu organización.
Mistral apuesta a que, a medida que la IA pase de «demo chula» a «infraestructura esencial», las empresas necesitarán modelos que entiendan su dominio a nivel fundacional. He aquí por qué:
Ahora, la visión contraria: la mayoría de empresas no necesitan modelos a medida. La automatización de atención al cliente, el Q&A básico de documentos y el resumen de reuniones funcionan bien con modelos generalistas y buen prompting. Forge va dirigido a organizaciones donde la especificidad de dominio es una verdadera ventaja competitiva, no un «nice to have».
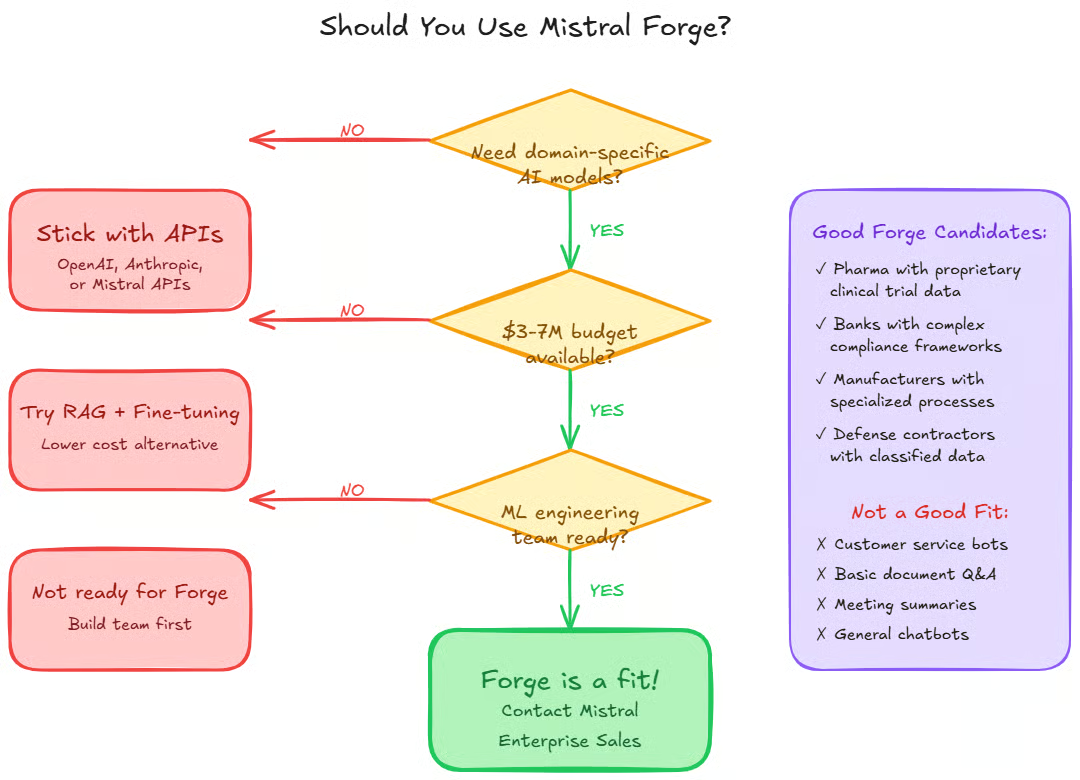
El playbook inicial de IA empresarial fue comprar acceso a APIs, contratar prompt engineers y añadir RAG. Funciona hasta que deja de hacerlo. A medida que la IA se convierte en infraestructura y no en una funcionalidad, las empresas querrán la propiedad de sus modelos igual que la de sus bases de datos. No todas. Pero suficientes como para que el entrenamiento a medida sea un mercado viable.
Los agentes empresariales deben hacer más que generar respuestas. Tienen que moverse por sistemas internos, usar herramientas correctamente y decidir dentro de los límites de la organización. Los modelos personalizados lo hacen posible. Ya lo estoy viendo con Vibe 2.0: los agentes que mejor funcionan se construyen sobre modelos entrenados con los repositorios en los que operan.
Cada vez más, las empresas afrontan requisitos de cumplimiento que hacen inviable alojar datos de negocio en sistemas de terceros. EU AI Act. RGPD. Regulaciones sectoriales en finanzas y salud. Las plataformas que ofrecen entrenamiento on-premises con aislamiento total de datos tienen una ventaja estructural.
Mistral anunció Forge en Nvidia GTC por un motivo. NVIDIA está construyendo infraestructura de IA empresarial con GPUs más baratas, mejores herramientas de entrenamiento distribuido y una inferencia optimizada. A medida que bajan los costes de entrenamiento, los modelos a medida se vuelven viables para más casos.
La contrapartida: la mayoría de empresas aún no necesitan esta complejidad. La automatización del servicio al cliente no requiere modelos a medida. Tampoco el procesamiento básico de documentos. El mercado se dividirá: la mayoría seguirá con APIs; un segmento menor construirá infraestructura propia. Ese segmento menor incluye a algunas de las compañías más grandes y rentables del mundo. Esa es la apuesta de Mistral.
Antes de contactar con el equipo de ventas enterprise de Mistral, necesitas una cantidad significativa de texto o código propio (los despliegues empresariales suelen manejar terabytes de datos específicos de dominio), un marco de gobernanza de datos (quién accede a qué, políticas de retención, tratamiento de PII) y criterios de evaluación claros y específicos del dominio.
En infraestructura: o bien un clúster GPU (se recomiendan 8-64 H100 para entrenamiento) o la disposición a usar la infraestructura gestionada de Mistral. También necesitas ingenieros de ML con experiencia en entrenamiento distribuido, expertos de dominio que evalúen salidas del modelo y revisión legal/de cumplimiento para el uso de datos.
Forge no es autoservicio. Pasas por el equipo enterprise de Mistral, revisas casos de uso, requisitos de datos y restricciones de despliegue. Empieza acotando el alcance: no intentes entrenarlo con todos tus datos desde el inicio. Elige un caso de alto valor, como análisis de documentos de cumplimiento o automatización de revisión de código.
La preparación de datos lleva más de lo que crees: limpieza, formateo, eliminación de PII, organización por dominios; reserva 2-3 meses para esto. Antes de entrenar nada, prueba el prompt engineering con Mistral Large 3 para confirmar que el rendimiento es aceptable. Puede que no necesites entrenamiento a medida.
Empieza con ajuste fino supervisado, no con preentrenamiento completo. Es más barato y rápido. Comprueba si el ajuste específico de tarea sobre un modelo base te lleva al 80% del objetivo. Si no basta, pasa al preentrenamiento. Pero entiende que comprometes recursos de cómputo y tiempo significativos.
Basura que entra, basura que sale. Si tu documentación interna es inconsistente, obsoleta o mal estructurada, el modelo aprenderá esos patrones. El entrenamiento a medida no resuelve mágicamente los problemas de IA. Si tu caso de uso no requiere conocimiento específico de dominio, estarás malgastando recursos. Operar tu propia infraestructura de entrenamiento es difícil. A menos que tengas una capacidad seria de ingeniería de ML, quédate con la oferta gestionada de Mistral.
Un gran banco de inversión necesitaba modelos que entendieran marcos de riesgo propietarios: sistemas de calificación internos, procedimientos de cumplimiento e interpretaciones regulatorias específicas de su negocio. Los modelos genéricos no distinguían entre instrumentos financieros de nombre similar con perfiles de riesgo muy distintos según su clasificación interna.
Preentrenaron con décadas de documentación de riesgo interna, notas de cumplimiento y presentaciones regulatorias. El modelo interiorizó la taxonomía de riesgo del banco. Resultado: 94% de precisión en tareas de revisión de cumplimiento, pasando de 3 días de revisión humana a 2 horas de análisis automatizado con verificación humana.
ASML fabrica las máquinas con las que se hacen los chips. Su documentación de ingeniería abarca décadas, varios idiomas y terminología muy especializada. Sus ingenieros perdían horas buscando documentación para entender por qué se tomaron ciertas decisiones de diseño.
Entrenaron con documentación de diseño propietaria, archivos CAD, registros de fabricación y solicitudes de cambio de ingeniería. Ahora los ingenieros pueden consultar al modelo en lenguaje natural y obtener respuestas contextuales citando secciones concretas de la documentación. No es conocimiento público: es inteligencia institucional acumulada durante décadas.
Una empresa del Fortune 500 necesitaba migrar una enorme base de C++ a marcos modernos. Décadas de librerías personalizadas, abstracciones internas y dependencias sin documentar. Los modelos genéricos de código sugerían cambios que rompían convenciones internas o violaban estándares arquitectónicos.
Entrenaron con todo el historial de código de la compañía: commits, revisiones, actas de decisiones arquitectónicas y guías de estilo. El modelo ahora genera sugerencias de refactorización que respetan los patrones internos. Igual que Mistral Vibe 2.0 funciona mejor cuando entiende la estructura de tu repositorio.
El precio de Forge no es público. Según conversaciones comerciales enterprise:
Forge no es para todo el mundo. Necesitas un caso donde la precisión de dominio valga millones. La mayoría no lo tiene.
Mistral Forge sacrifica facilidad de uso a cambio de propiedad total del modelo y personalización profunda del dominio. Para la mayoría de las empresas, sigo pensando que la respuesta es más sencilla: quédate con las APIs. Y los modelos generalistas con buen prompting o RAG siguen funcionando muy bien para lo común: atención al cliente, procesamiento de documentos y resúmenes de reuniones.
Pero para organizaciones donde la especificidad de dominio es una verdadera ventaja competitiva (pienso en investigación farmacéutica analizando datos de compuestos propietarios, fabricantes de semiconductores optimizando procesos de fabricación y entidades financieras con sus marcos regulatorios), Forge puede tener sentido. La cuestión no es si el entrenamiento a medida es mejor en teoría, sino si la mejora justifica millones en costes de entrenamiento.
Si estás evaluando Forge, sigue esta progresión: empieza con prompt engineering usando Mistral Large 3. Añade RAG si hace falta. Prueba el ajuste fino vía API. Solo piensa en lo que ofrece Mistral Forge si esos enfoques no funcionan.
Aprende con DataCamp
Curso
Curso
Curso
blog
Natassha Selvaraj
15 min
blog
Ryan Ong
8 min
blog
Adel Nehme
15 min
blog
Abid Ali Awan
10 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
8 min