Kurs
Künstliche Intelligenz verstehen
2 Std.
421.5K
Ich verfolge Mistral AIs Produktreleases schon eine Weile – von der Mistral 3-Modellfamilie über Le Chat bis zu Vibe 2.0. Mistral Forge ist, falls du gerade aufholst, kein neues Modell. Es ist Mistrals Wette auf Enterprise-Infrastruktur.
Nvidia GTC kündigte am 17. März 2026 an: Mit Forge können Unternehmen KI-Modelle vollständig auf internen Daten aufbauen. Nicht nur Feintuning auf öffentlichen Modellen, sondern echtes Training von Grund auf – auf Jahrzehnten an Engineering-Dokumentation, proprietären Codebasen, Compliance-Frameworks und Betriebsprotokollen.
In diesem Artikel erkläre ich, was Mistral Forge ist, wie es funktioniert, wann individuelles Modelltraining sinnvoller ist als APIs zu nutzen und was es kostet. Ich greife Beispiele von Early Adoptern wie ASML und Ericsson auf, um zu zeigen, wo Forge passt.
Mistral Forge ist eine Enterprise-Plattform zum Aufbau von KI-Modellen mit den proprietären Daten deiner Organisation. Anders als API-Services, bei denen du Prompts an fremde Modelle schickst, gibt dir Forge die Kontrolle über die gesamte Trainingspipeline.
Traditionelle KI-APIs (OpenAI, Anthropic):
Mistral Forge:
Das Grundproblem sehe ich immer wieder: Generische Modelle, die auf Webdaten trainiert wurden, begreifen euer institutionelles Wissen nicht. Sie halluzinieren fachspezifische Begriffe. Sie kennen eure Engineering-Standards, Compliance-Richtlinien oder Betriebsabläufe nicht. Forge löst das, indem ihr Modelle baut, die das Wissen eurer Organisation von Grund auf internalisieren.
Zu den frühen Anwendern zählen ASML (Halbleiterfertigung), Ericsson (Telekommunikation), die Europäische Weltraumorganisation und die DSO National Laboratories Singapurs. Das sind keine Unternehmen, die nur mit Chatbots experimentieren. Sie bauen KI für geschäftskritische Abläufe, wo generische Modelle nicht ausreichen.
Hier ist der vollständige Workflow – von der Datenaufnahme bis zum Deployment:
Du startest mit einer Basisarchitektur aus Mistrals Open-Weight-Modellen: Mistral Large 3 für komplexes Reasoning, Mistral Small 4 für schnellere Inferenz und geringere Kosten oder kundenspezifische MoE-Konfigurationen (Mixture-of-Experts), die Leistung und Effizienz ausbalancieren.
Die Wahl zwischen dichten Modellen und MoE wirkt sich auf die Betriebskosten aus. Dichte Modelle bieten starke Allround-Fähigkeiten. MoE-Modelle können ähnliche Performance liefern und gleichzeitig Latenz und Rechenkosten senken – vergleichbare Ergebnisse bei 40–60% der Infrastrukturkosten.
Hier kommen deine proprietären Daten ins Spiel. Forge unterstützt unstrukturierten Text (Dokumentationen, Berichte, E-Mails), Codebasen bei erhaltener Repositoriumsstruktur, strukturierte Daten (Datenbanken, Tabellen) und multimodale Eingaben (Text plus Bilder, wo relevant).
Für regulierte Branchen, in denen echte Daten nicht immer genutzt werden dürfen, bietet Forge die Erzeugung synthetischer Daten. So erstellst du richtlinienkonforme Trainingsbeispiele, Edge-Cases und Long-Tail-Szenarien, die in echten Daten selten vorkommen, in der Produktion aber zählen.
Das ist der teure Teil, in dem institutionelles Wissen in die Gewichte des Netzes eingebettet wird. Pre-Training von Grund auf kostet Millionen an Compute – deshalb überspringen es die meisten. Aber genau das lässt das Modell dein Fachgebiet wirklich verstehen.
Pre-Training auf großen internen Datensätzen dauert auf Enterprise-GPU-Clustern Wochen. Unternehmen wie ASML und Ericsson planen für erste Trainingsläufe mehrere Monate ein; die Kosten gehen – je nach Datenvolumen und Modellgröße – in die Millionen. Das läuft nicht auf einem lokalen Rechner.
Nach dem Pre-Training verfeinerst du das Modell für konkrete Aufgaben per Supervised Fine-Tuning (SFT). Dafür trainierst du auf Instruktions-Antwort-Paaren aus deinem Fachgebiet – etwa das Prüfen von Engineering-Change-Requests auf Compliance-Verstöße oder die Analyse von Finanzinstrumenten gemäß eurer internen Risikoklassifikation.
Für agentische Workloads – Modelle, die Tools nutzen, Entscheidungen treffen und mehrstufige Aufgaben erledigen müssen – optimierst du mit Reinforcement Learning (RL) auf tatsächliche Aufgabenerledigung, nicht nur auf plausiblen Text. Laut Berichten früher Anwender erzielten RL-trainierte Modelle bei der Bearbeitung von Kundeneskalationen Abschlussraten von über 85%.
Forge enthält Evaluations-Frameworks, die auf Enterprise-KPIs ausgerichtet sind – nicht nur auf generische Benchmarks. Du definierst eigene Metriken wie Compliance-Genauigkeit, Abdeckung der Fachvokabeln und Latenzschwellen. Währenddessen trackt Forge alles: Modelle, Datensätze, Trainingsläufe, Konfigurationen. Versionskontrolle ist erstklassig. Wenn Aufsichtsbehörden fragen „Wie kam das Modell zu dieser Entscheidung?“, hast du die vollständige Linie.
|
Aspekt |
Mistral Forge |
OpenAI/Anthropic APIs |
RAG + API |
|
Trainingstiefe |
Vollständiges Pre-Training auf deinen Daten |
Feintuning auf öffentlichen Modellen |
Kein Training, nur Retrieval |
|
Domänenwissen |
In Modellgewichten verankert |
Dünne Schicht auf generischer Basis |
Externer Kontext zur Inferenzzeit |
|
Datenschutz |
On-Premises-Deployment, kein externer Zugriff |
Daten werden an OpenAI-/Anthropic-Server gesendet |
Dokumente extern gespeichert |
|
Individualisierung |
Volle Kontrolle (Architektur, Training, RL) |
Begrenzt (Instruktionspaare, Beispiele) |
Minimal (Dokumentauswahl) |
|
Einrichtungsaufwand |
Sehr hoch (Monate, ML-Team erforderlich) |
Niedrig (API-Key, Tage) |
Mittel (Vektor-DB, Wochen) |
|
Kosten |
2–5 Mio. US$+ fürs Training + laufende Inferenz |
Typisch 10–50 Tsd. US$/Monat |
Typisch 5–20 Tsd. US$/Monat |
|
Vendor-Lock-in |
Gering (du besitzt die Modellgewichte) |
Hoch (API-Abhängigkeit) |
Mittel (LLMs austauschbar) |
Ich habe mit genug Datenteams gesprochen, um das Muster zu kennen: Unternehmen rollen KI aus, die Demos beeindrucken – und dann kommt der Einbruch, sobald Modelle auf fachspezifische Terminologie stoßen oder innerhalb strenger Compliance-Vorgaben agieren müssen.
RAG hilft. Feintuning hilft. Aber beides löst nicht das Grundproblem: Generische Modelle wurden nicht auf dem Wissen deiner Organisation trainiert.
Mistral wettet darauf, dass Unternehmen, wenn KI vom „coolen Demo“ zur „Kerninfrastruktur“ wird, Modelle brauchen, die ihr Fachgebiet auf Basisniveau verstehen. Warum:
Aber die Gegenposition: Die meisten Unternehmen brauchen keine individuellen Modelle. Kundenservice-Automatisierung, grundlegendes Dokumenten-Q&A und Meeting-Zusammenfassungen laufen mit General-Purpose-Modellen und gutem Prompting völlig okay. Forge zielt auf Organisationen, bei denen Domänenspezifik echte Wettbewerbsvorteile bringt – nicht nur „nice to have“ ist.
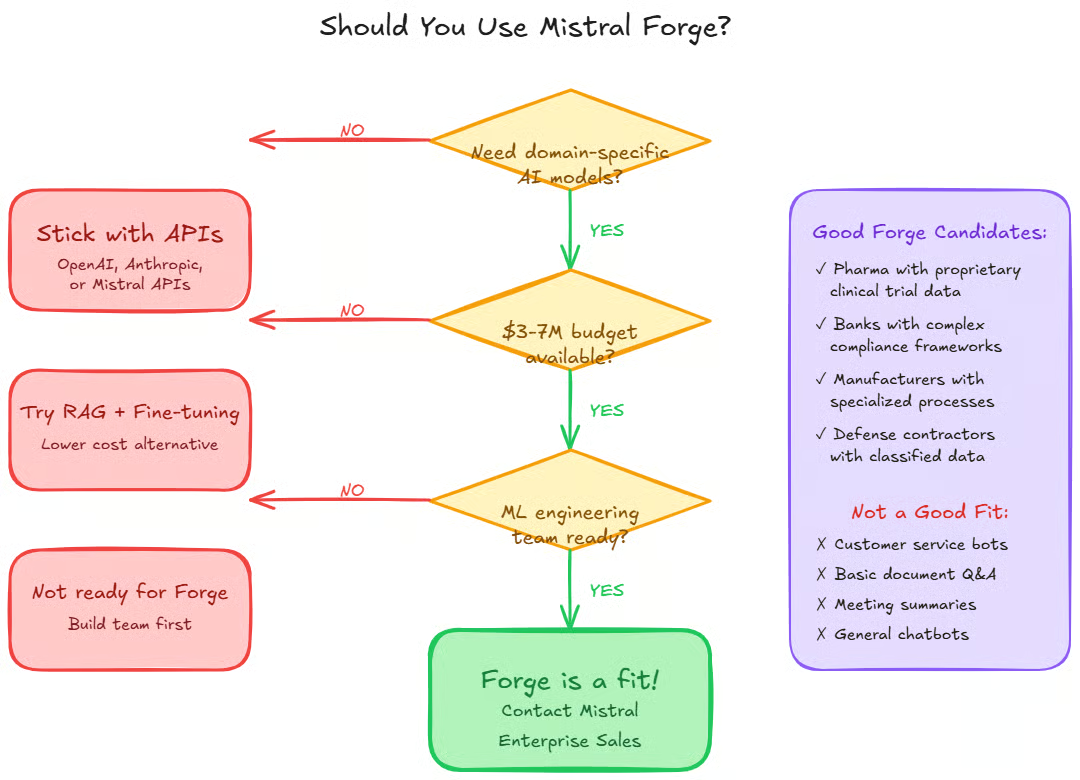
Das frühe Enterprise-KI-Playbook lautete: API-Zugang kaufen, Prompt Engineers einstellen und RAG aufsetzen. Das funktioniert – bis es nicht mehr reicht. Wenn KI zur Infrastruktur wird statt zu einem Feature, wollen Unternehmen Modelle besitzen – so wie sie ihre Datenbanken besitzen. Nicht alle. Aber genug, um individuelles Training zu einem tragfähigen Markt zu machen.
Enterprise-Agenten müssen mehr können als Antworten generieren. Sie müssen interne Systeme navigieren, Tools korrekt nutzen und Entscheidungen innerhalb organisatorischer Leitplanken treffen. Individuelle Modelle machen das möglich. Ich sehe das bereits bei Vibe 2.0: Am besten funktionieren Agenten, deren Modelle auf den Codebasen trainiert sind, in denen sie arbeiten.
Unternehmen sehen sich zunehmend Compliance-Vorgaben gegenüber, die das Hosten proprietärer Geschäftsdaten in Drittsystemen untragbar machen. EU AI Act. DSGVO. Branchenspezifische Regulierung in Finanzwesen und Gesundheitssektor. Plattformen mit On-Premises-Training und vollständiger Datenisolation haben strukturelle Vorteile.
Mistral hat Forge nicht ohne Grund auf der Nvidia GTC angekündigt. NVIDIA baut Enterprise-KI-Infrastruktur mit günstigeren GPUs, besseren Tools für verteiltes Training und optimierter Inferenz. Sinkende Trainingskosten machen individuelle Modelle für mehr Use Cases wirtschaftlich.
Die Gegenargumente bleiben: Die meisten Unternehmen brauchen diese Komplexität noch nicht. Kundenservice-Automatisierung benötigt keine individuellen Modelle. Auch einfache Dokumentenverarbeitung nicht. Der Markt teilt sich – die meisten bleiben bei APIs, ein kleinerer Teil baut eigene Infrastruktur. Dieser kleinere Teil umfasst einige der größten und profitabelsten Unternehmen der Welt. Darauf setzt Mistral.
Bevor du Mistrals Enterprise-Sales kontaktierst, brauchst du umfangreiche proprietäre Texte oder Code (Enterprise-Deployments verarbeiten typischerweise Terabytes an domänenspezifischen Daten), ein Data-Governance-Framework (wer darf was, Aufbewahrungsrichtlinien, Umgang mit personenbezogenen Daten) und klare, domänenspezifische Evaluationskriterien.
Zur Infrastruktur: Entweder ein GPU-Cluster (empfohlen 8–64 H100s für Training) oder die Bereitschaft, Mistrals Managed Infrastructure zu nutzen. Außerdem brauchst du ML Engineers mit Erfahrung im verteilten Training, Fachexperten zur Bewertung der Modellausgaben und eine juristische/Compliance-Prüfung zur Datennutzung.
Forge ist kein Self-Service. Du gehst über Mistrals Enterprise-Team, besprichst Use Cases, Datenanforderungen und Deployment-Einschränkungen. Starte fokussiert – versuche nicht, direkt auf allen Daten zu trainieren. Wähle einen klar abgegrenzten, wertvollen Use Case, etwa Compliance-Dokumentanalyse oder Code-Review-Automatisierung.
Die Datenaufbereitung dauert länger als gedacht. Bereinigen, formatieren, personenbezogene Daten entfernen, nach Domänen organisieren – plane hier 2–3 Monate ein. Bevor du trainierst, teste Prompt Engineering mit Mistral Large 3, um sicherzustellen, dass die Performance passt. Eventuell brauchst du gar kein individuelles Training.
Starte mit überwachten Feintuning statt vollem Pre-Training. Es ist günstiger und schneller. Prüfe, ob aufgabenspezifisches Tuning auf einem Basismodell dich schon 80% des Weges bringt. Wenn Feintuning nicht reicht, wechsle zum Pre-Training – in dem Wissen, dass du erhebliche Compute-Ressourcen und Zeit bindest.
Garbage in, Garbage out. Sind eure internen Dokus uneinheitlich, veraltet oder schlecht strukturiert, lernt das Modell genau diese Muster. Individuelles Training löst KI-Probleme nicht magisch. Wenn dein Use Case kein domänenspezifisches Wissen braucht, verbrennst du Ressourcen. Eigenes Training zu betreiben ist hart. Ohne starke ML-Engineering-Kapazitäten bleib besser bei Mistrals Managed-Angebot.
Eine große Investmentbank benötigte Modelle, die proprietäre Risikorahmen verstehen – interne Ratingsysteme, Compliance-Prozesse, regulatorische Auslegungen, die ihrem Geschäft eigen sind. Generische Modelle konnten ähnlich klingende Finanzinstrumente nicht entlang der internen Klassifikation mit sehr unterschiedlichen Risikoprofilen unterscheiden.
Sie trainierten auf Jahrzehnten interner Risikodokumente, Compliance-Memos und regulatorischer Einreichungen. Das Modell internalisierte die Risikotaxonomie der Bank. Ergebnis: 94% Genauigkeit bei Compliance-Reviews; von 3 Tagen manueller Prüfung auf 2 Stunden automatisierte Analyse mit menschlicher Verifizierung reduziert.
ASML baut die Maschinen, mit denen Computerchips hergestellt werden. Ihre Engineering-Dokumentation umfasst Jahrzehnte, mehrere Sprachen und hochspezialisierte Terminologie. Ingenieurinnen und Ingenieure verbrachten Stunden mit der Suche in Dokus, um frühere Designentscheidungen zu verstehen.
Sie trainierten auf proprietären Designdokumenten, CAD-Dateien, Fertigungslogs und Engineering-Change-Requests. Jetzt können Ingenieurteams das Modell in natürlicher Sprache befragen und erhalten kontextrelevante Antworten mit Verweisen auf konkrete Dokumentstellen. Das ist kein öffentliches Wissen – sondern institutionelle Intelligenz, aufgebaut über Jahrzehnte.
Ein Fortune-500-Unternehmen musste eine massive C++-Codebasis auf moderne Frameworks migrieren. Jahrzehnte an Custom Libraries, internen Abstraktionen, undokumentierten Abhängigkeiten. Generische Code-Modelle schlugen Änderungen vor, die interne Konventionen brachen oder Architekturstandards verletzten.
Sie trainierten auf der gesamten Codehistorie des Unternehmens – Commits, Code-Reviews, Architekturentscheidungen, Styleguides. Das Modell generiert nun Refactoring-Vorschläge, die interne Muster respektieren. Ähnlich wie Mistral Vibe 2.0 besser funktioniert, wenn es eure Repositoriumsstruktur versteht.
Die Preise von Forge sind nicht öffentlich. Basierend auf Enterprise-Gesprächen gilt:
Forge ist nicht für alle. Du brauchst einen Use Case, bei dem Domänenpräzision Millionen wert ist. Die meisten haben den nicht.
Mistral Forge tauscht einfache Nutzung gegen vollständiges Modelleigentum und tiefe Domänenanpassung. Für die meisten Unternehmen denke ich trotzdem, die Antwort ist einfacher: Bleib bei APIs. Und General-Purpose-Modelle mit effektivem Prompting oder RAG funktionieren für gängige Aufgaben weiterhin gut: Kundenservice, Dokumentenverarbeitung und Meeting-Zusammenfassungen.
Aber für Organisationen, bei denen Domänenspezifik ein echter Wettbewerbsvorteil ist (etwa Pharmaforschung mit proprietären Wirkstoffdaten, Halbleiterhersteller bei der Optimierung der Fertigung oder Finanzinstitute mit ihren Regulierungsrahmen), kann Forge sinnvoll sein. Die Frage ist nicht, ob individuelles Training theoretisch besser ist, sondern ob der Mehrwert Millionen an Trainingskosten rechtfertigt.
Wenn du Forge evaluierst, probiere diese Reihenfolge: Starte mit Prompt Engineering mit Mistral Large 3. Füge bei Bedarf RAG hinzu. Teste API-basiertes Feintuning. Erst wenn all das nicht reicht, lohnt sich der Blick auf das, was Mistral Forge bietet.
Lerne mit DataCamp
Kurs
Kurs
Kurs