Cours
Comprendre l'intelligence artificielle
2 h
421.5K
Je suis de près les lancements produits de Mistral AI : de la famille de modèles Mistral 3 à Le Chat jusqu'à Vibe 2.0. Mistral Forge, si vous prenez le train en marche, n’est pas un nouveau modèle. C’est l’offre d’infrastructure pour les entreprises de Mistral.
Nvidia GTC a annoncé le 17 mars 2026 que Forge permet aux entreprises de construire des modèles d’IA entraînés entièrement sur leurs données internes. Pas un simple affinement de modèles publics : un entraînement à partir de zéro sur des dizaines d’années de documentation d’ingénierie, de bases de code propriétaires, de cadres de conformité et de journaux opérationnels.
Dans cet article, je présente ce qu’est Mistral Forge, son fonctionnement, quand l’entraînement de modèles sur mesure a du sens par rapport à l’usage d’APIs, et combien cela coûte. Je m’appuie sur des exemples de pionniers comme ASML et Ericsson pour montrer où Forge s’insère.
Mistral Forge est une plateforme d’entreprise pour construire des modèles d’IA à partir des données propriétaires de votre organisation. Contrairement aux services basés sur des APIs, où vous envoyez des invites à un modèle tiers, Forge vous donne la maîtrise de toute la chaîne d’entraînement.
APIs d’IA traditionnelles (OpenAI, Anthropic) :
Mistral Forge :
Le problème que je vois sans cesse : des modèles génériques entraînés sur des données publiques ne comprennent pas votre capital connaissance. Ils hallucinent sur la terminologie métier. Ils ignorent vos normes d’ingénierie, vos politiques de conformité ou vos procédures opérationnelles. Forge résout cela en vous permettant de bâtir des modèles qui internalisent le savoir de votre organisation dès la base.
Parmi les premiers adopteurs : ASML (fabrication de semi-conducteurs), Ericsson (télécommunications), l’Agence spatiale européenne et les DSO National Laboratories de Singapour. Ce ne sont pas des entreprises qui testent des chatbots : elles conçoivent de l’IA pour des opérations critiques, où les modèles génériques ne suffisent pas.
Voici le flux complet, de l’ingestion des données au déploiement :
Vous commencez par choisir une architecture de base parmi les modèles à poids ouverts de Mistral : Mistral Large 3 pour le raisonnement complexe, Mistral Small 4 pour une inférence plus rapide et des coûts réduits, ou des configurations MoE (Mixture-of-Experts) sur mesure qui équilibrent performance et efficience.
Le choix entre modèles denses et MoE influe sur les coûts opérationnels. Les modèles denses offrent de bonnes capacités générales. Les modèles MoE peuvent atteindre des performances comparables tout en réduisant la latence et les coûts de calcul : des résultats similaires pour 40 à 60 % de la dépense d’infrastructure.
C’est là que vos données propriétaires entrent en jeu. Forge prend en charge le texte non structuré (documentation, rapports, e-mails), des bases de code en conservant la structure des dépôts, les données structurées (bases de données, tableurs) et des entrées multimodales (texte plus images si pertinent).
Pour les secteurs réglementés où les données réelles ne peuvent pas toujours être utilisées, Forge inclut la génération de données synthétiques. Vous pouvez créer des exemples d’entraînement conformes aux politiques, des scénarios de bord et des cas rares qui apparaissent peu dans les données réelles mais comptent en production.
C’est la partie coûteuse, là où le savoir institutionnel s’inscrit dans les poids neuronaux. Le pré-entraînement à partir de zéro coûte des millions en calcul, raison pour laquelle la plupart des organisations y renoncent. Mais c’est ce qui permet au modèle de vraiment comprendre votre domaine.
Le pré-entraînement sur de grands jeux de données internes peut durer des semaines sur des grappes de GPU d’entreprise. Des sociétés comme ASML et Ericsson prévoient plusieurs mois pour les premiers runs, avec des coûts de plusieurs millions selon le volume de données et la taille du modèle. Ce n’est pas quelque chose qui tourne en local.
Après le pré-entraînement, vous spécialisez le modèle pour des tâches précises via l’affinage supervisé (SFT). Il s’agit d’entraîner sur des paires instruction‑réponse propres à votre domaine, par exemple la revue de demandes de modifications techniques pour détecter des violations de conformité, ou l’analyse d’instruments financiers selon votre taxonomie interne du risque.
Pour des charges agentiques où les modèles doivent utiliser des outils, prendre des décisions et réaliser des tâches en plusieurs étapes, l’apprentissage par renforcement (RL) permet d’optimiser la réussite réelle des tâches, et pas seulement la génération d’un texte plausible. D’après les premiers retours, des modèles entraînés en RL pour gérer des escalades clients ont dépassé 85 % de taux de complétion.
Forge inclut des cadres d’évaluation alignés sur des KPI d’entreprise, pas seulement des benchmarks génériques. Vous définissez des métriques sur mesure : précision de conformité, couverture du vocabulaire métier, seuils de latence. Tout au long du processus, Forge trace tout : modèles, jeux de données, runs d’entraînement, configurations. Le versioning est natif. Quand un régulateur demande « comment le modèle a pris cette décision ? », vous disposez d’une lignée complète.
|
Aspect |
Mistral Forge |
APIs OpenAI/Anthropic |
RAG + API |
|
Profondeur d’entraînement |
Pré-entraînement complet sur vos données |
Affinage sur des modèles publics |
Aucun entraînement, simple recherche |
|
Connaissance métier |
Intégrée dans les poids du modèle |
Fine couche sur une base générique |
Contexte externe à l’inférence |
|
Confidentialité des données |
Déploiement on-premises, aucun accès externe |
Données envoyées aux serveurs OpenAI/Anthropic |
Documents stockés à l’extérieur |
|
Personnalisation |
Contrôle total (architecture, entraînement, RL) |
Limitée (paires d’instructions, exemples) |
Minimale (sélection de documents) |
|
Complexité de mise en place |
Très élevée (mois, équipe ML requise) |
Faible (clé API, quelques jours) |
Moyenne (base vectorielle, semaines) |
|
Coût |
2 à 5 M$+ pour l’entraînement + inférence continue |
10 à 50 k$ / mois typiquement |
5 à 20 k$ / mois typiquement |
|
Dépendance fournisseur |
Faible (vous possédez les poids) |
Forte (dépendance API) |
Moyenne (LLM interchangeable) |
J’ai parlé avec assez d’équipes data pour reconnaître le schéma : on déploie de l’IA, les démos sont bluffantes, puis tout se grippe quand les modèles rencontrent une terminologie métier spécifique ou des exigences de conformité strictes.
Le RAG aide. L’affinage aide. Mais aucun ne résout le problème fondamental : les modèles génériques n’ont pas été entraînés sur le savoir de votre organisation.
Mistral parie qu’à mesure que l’IA passe de « démo sympa » à « infrastructure critique », les entreprises auront besoin de modèles qui comprennent leur domaine de façon fondamentale. Voici pourquoi :
Mais voici le contrepoint : la plupart des entreprises n’ont pas besoin de modèles sur mesure. L’automatisation du service client, le Q&R documentaire de base et le résumé de réunions fonctionnent très bien avec des modèles généralistes et un bon prompting. Forge vise les organisations où la spécificité métier est un véritable avantage compétitif, pas un « nice-to-have ».
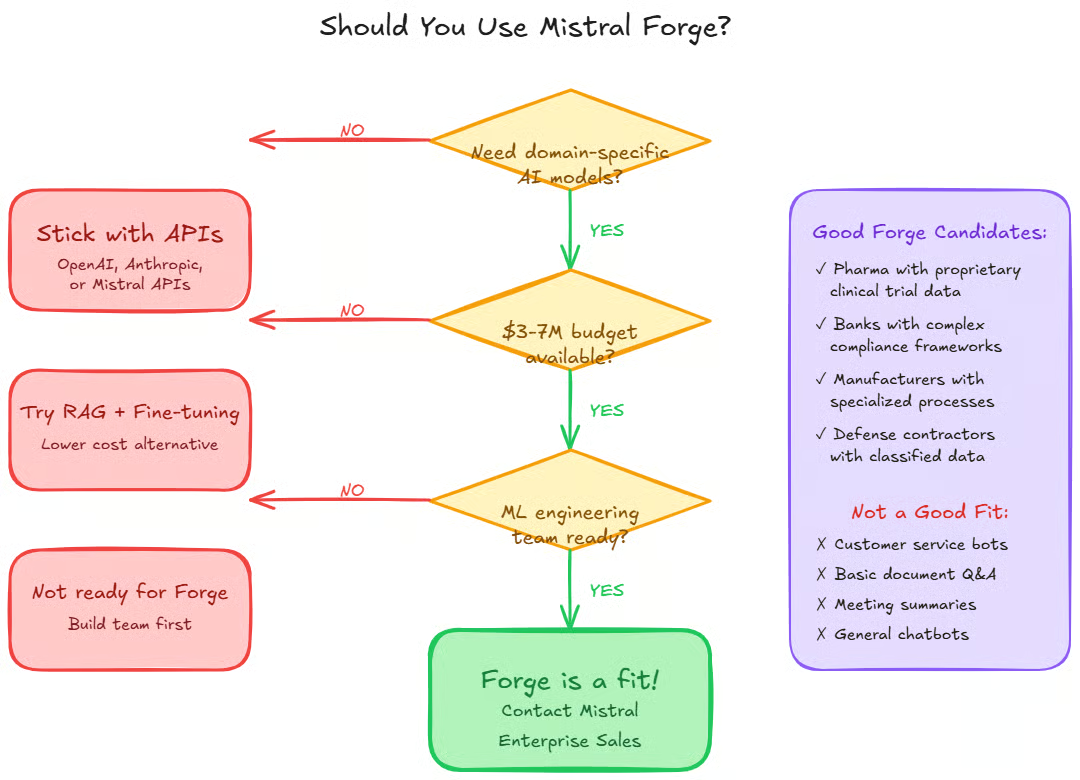
Le premier playbook de l’IA en entreprise était : acheter un accès API, recruter des prompt engineers et ajouter du RAG. Cela fonctionne … jusqu’à ce que ça coince. À mesure que l’IA devient une infrastructure et non plus une fonctionnalité, les entreprises voudront posséder leurs modèles comme elles possèdent leurs bases de données. Pas toutes. Mais suffisamment pour faire du sur-mesure un marché viable.
Les agents d’entreprise doivent faire plus que générer des réponses. Ils doivent naviguer dans les systèmes internes, utiliser correctement les outils et décider dans les contraintes de l’organisation. Les modèles personnalisés rendent cela possible. Je le constate déjà avec Vibe 2.0 : les agents les plus efficaces reposent sur des modèles entraînés sur les codebases dans lesquelles ils opèrent.
Les entreprises sont de plus en plus confrontées à des obligations de conformité qui rendent inenvisageable l’hébergement de données métier sensibles chez des tiers. AI Act européen. RGPD. Réglementations sectorielles en finance et en santé. Les plateformes offrant un entraînement on-premises avec isolement complet des données ont un avantage structurel.
Mistral a annoncé Forge au Nvidia GTC pour une raison. NVIDIA construit l’infrastructure IA d’entreprise avec des GPU moins chers, de meilleurs outils d’entraînement distribué et une inférence optimisée. À mesure que les coûts baissent, les modèles sur mesure deviennent viables pour davantage de cas d’usage.
Contre-argument : la plupart des entreprises n’ont pas encore besoin de cette complexité. Le service client automatisé ne nécessite pas de modèles personnalisés. Le traitement documentaire de base non plus. Le marché va se segmenter : la majorité restera sur des APIs, une fraction construira son infrastructure. Cette fraction regroupe certaines des entreprises les plus grandes et rentables au monde. C’est le pari de Mistral.
Avant de contacter l’équipe commerciale entreprise de Mistral, prévoyez un volume important de texte ou de code spécifique à votre domaine (les déploiements entreprise traitent généralement des téraoctets de données), un cadre de gouvernance des données (droits d’accès, politiques de rétention, gestion des DPI), et des critères d’évaluation métier clairs.
Côté infrastructure : soit un cluster de GPU (8 à 64 H100 recommandés pour l’entraînement), soit l’utilisation de l’infrastructure managée de Mistral. Il vous faut aussi des ingénieurs ML familiers de l’entraînement distribué, des experts métier pour évaluer les sorties du modèle, et une validation juridique/conformité sur l’usage des données.
Forge n’est pas en self-service. Vous passez par l’équipe entreprise de Mistral, discutez cas d’usage, besoins de données et contraintes de déploiement. Commencez petit : n’essayez pas d’entraîner sur toutes vos données d’emblée. Choisissez un cas à forte valeur, comme l’analyse de documents de conformité ou l’automatisation de la revue de code.
La préparation des données prend plus de temps que prévu : nettoyage, formatage, suppression des DPI, organisation par domaines — prévoyez 2 à 3 mois. Avant tout entraînement, testez le prompt engineering avec Mistral Large 3 pour vérifier que les performances sont acceptables. Il se peut que vous n’ayez pas besoin de sur-mesure.
Débutez par l’affinage supervisé, pas par le pré-entraînement complet. C’est moins cher et plus rapide. Visez 80 % de l’objectif avec un affinage spécifique à la tâche sur un modèle de base. Si cela ne suffit pas, passez au pré-entraînement. Mais sachez que vous engagez des ressources de calcul et du temps significatifs.
Garbage in, garbage out. Si vos documents internes sont incohérents, obsolètes ou mal structurés, le modèle apprendra ces travers. Le sur-mesure ne résout pas magiquement les problèmes de l’IA. Si votre cas d’usage n’exige pas une connaissance métier pointue, vous gaspillez des ressources. Faire tourner sa propre infrastructure d’entraînement est difficile : sauf à disposer d’une forte capacité ML, préférez l’offre managée de Mistral.
Une grande banque d’investissement avait besoin de modèles comprenant ses cadres de risque propriétaires : systèmes de notation internes, procédures de conformité, interprétations réglementaires propres à son activité. Les modèles génériques n’arrivaient pas à distinguer des instruments financiers aux noms proches mais aux profils de risque très différents, selon la classification interne de la banque.
Ils ont pré-entraîné sur des décennies de documentation risque interne, de notes de conformité et de déclarations réglementaires. Le modèle a internalisé la taxonomie de risque de la banque. Résultat : 94 % de précision sur les tâches de revue de conformité, le délai passant de 3 jours de revue humaine à 2 heures d’analyse automatisée avec vérification humaine.
ASML conçoit les machines qui fabriquent les puces. Leur documentation d’ingénierie s’étend sur des décennies, plusieurs langues et une terminologie très pointue. Les ingénieurs passaient des heures à chercher des informations pour comprendre certaines décisions de conception.
Ils ont entraîné sur des documents de conception propriétaires, des fichiers CAD, des journaux de fabrication et des demandes de modifications d’ingénierie. Désormais, les ingénieurs interrogent le modèle en langage naturel et obtiennent des réponses contextuelles citant des sections précises de la documentation. Ce n’est pas un savoir public : c’est une intelligence institutionnelle accumulée sur des décennies.
Une entreprise du Fortune 500 devait migrer une immense base C++ vers des frameworks modernes. Des décennies de bibliothèques maison, d’abstractions internes, de dépendances non documentées. Les modèles de code génériques proposaient des changements qui brisaient les conventions internes ou violaient les standards d’architecture.
Ils ont entraîné sur tout l’historiques de code de l’entreprise : commits, revues de code, dossiers de décisions d’architecture, guides de style. Le modèle génère désormais des suggestions de refactoring conformes aux patterns internes. Comme Mistral Vibe 2.0 qui fonctionne mieux lorsqu’il comprend la structure de votre référentiel.
Les tarifs de Forge ne sont pas publics. D’après des discussions enterprise :
Forge ne convient pas à tout le monde. Il faut un cas d’usage où la précision métier justifie des millions d’investissement. Ce n’est pas la majorité.
Mistral Forge troque la simplicité d’usage contre la pleine propriété du modèle et une personnalisation métier en profondeur. Pour la plupart des entreprises, je pense que la réponse reste plus simple : restez sur des APIs. Et les modèles généralistes avec du prompting efficace ou du RAG couvrent encore très bien les usages courants : service client, traitement de documents, résumés de réunions.
Mais pour les organisations où la spécificité métier est un véritable avantage compétitif (par exemple la recherche pharmaceutique analysant des données de composés propriétaires, les fabricants de semi-conducteurs optimisant les processus de fabrication, ou les institutions financières avec leurs cadres réglementaires), Forge peut avoir du sens. La question n’est pas de savoir si le sur-mesure est meilleur en théorie, mais si le gain justifie des millions de coûts d’entraînement.
Si vous évaluez Forge, suivez cette progression : commencez par le prompt engineering avec Mistral Large 3. Ajoutez du RAG si besoin. Testez l’affinage via API. Ne pensez à ce que Mistral Forge peut apporter que si ces approches échouent.
Apprenez avec DataCamp
Cours
Cours
Cours