
Onderdelen van een dataproduct
Achter elk succesvol dataproduct schuilt een robuuste structuur die ervoor zorgt dat het effectief werkt. In dit onderdeel bekijken we de kritieke elementen die dataproducten laten functioneren.
Databronnen
Dataproducten zijn afhankelijk van verschillende bronnen om de benodigde informatie te verzamelen voor verwerking, zoals:
- Interne systemen: Databases, ERP-systemen, CRM-tools.
- Externe API’s: Financiële marktdata, sentiment op sociale media, weerdiensten.
- Realtime datastromen: Sensoren, IoT-apparaten, eventtracking-systemen.
De diversiteit en rijkdom van deze databronnen beïnvloeden rechtstreeks de kwaliteit en bruikbaarheid van het product.
Een dataproduct bij een retailbedrijf kan bijvoorbeeld data ophalen uit kassasystemen, klantdatabases en tools voor sentimentanalyse op sociale media. Door verkoopdata, klantgedrag en externe markttrends te combineren, ontstaat een completer beeld voor zakelijke besluitvorming.
Datapijplijnen
Datapijplijnen zijn de processen waarmee ruwe data wordt verzameld, opgeschoond, getransformeerd en geladen in een gestructureerd formaat dat het dataproduct kan gebruiken. Deze datapijplijnen kunnen de volgende stappen en technologieën omvatten:
- Ingestie: Data vastleggen uit bronnen met tools zoals Apache Kafka, AWS Kinesis of batch-jobs.
- Transformatie: Data opschonen en herschikken met ETL-tools zoals dbt of Apache Spark.
- Opslag: Data organiseren in datawarehouses (bijv. Snowflake, BigQuery) of lakes (bijv. Amazon S3).
Neem bijvoorbeeld ritdeel-apps zoals Lyft en Uber. In zulke apps verzamelen datapijplijnen realtime data van de locaties van chauffeurs en passagiers, schonen de data op om onnauwkeurigheden te verwijderen en transformeren die naar een bruikbaar formaat. Zo kan het systeem optimale routes en geschatte aankomsttijden berekenen.
Gebruikersinterface (UI)
In sommige dataproducten maakt een gebruiksvriendelijke interface het gebruikers zonder technische achtergrond gemakkelijk om met het systeem te werken. Gebruikers zouden geen technische expertise nodig moeten hebben om inzichten te krijgen, rapporten te draaien of taken te automatiseren. In plaats van met complexe code te werken of databases te bevragen, kunnen ze simpelweg velden slepen en neerzetten, visualisaties maken en met een paar klikken rapporten genereren.
Voorbeeld: tools zoals Tableau of Power BI bieden gebruiksvriendelijke interfaces waarmee gebruikers trends kunnen visualiseren en met minimale inspanning rapporten kunnen genereren.
Machinelearning-modellen
Machinelearning-modellen worden gebruikt om patronen te herkennen en voorspellingen te doen voor geavanceerde dataproducten. Deze modellen leren continu van nieuwe data, waardoor ze in de loop van de tijd nauwkeuriger worden.
Zo gebruikt een creditscoringsysteem machinelearning-modellen om de kredietwaardigheid van aanvragers te beoordelen door hun financiële geschiedenis, bestedingspatronen en andere variabelen te analyseren. Het model helpt vervolgens de kans op wanbetaling te voorspellen, waardoor kredietverstrekkers beter geïnformeerde beslissingen kunnen nemen over het al dan niet toekennen van een lening.
API’s voor data-toegang
Application Programming Interfaces (API’s) stellen externe systemen en gebruikers in staat om programmatisch toegang te krijgen tot het dataproduct. Met name maken API’s integratie met andere tools en diensten mogelijk door een gestandaardiseerde manier te bieden om met het product te communiceren.
Zo biedt een financieel dataproduct een API die realtime beursdata levert, waaronder prijzen, trends en handelsvolumes. Ontwikkelaars kunnen deze API integreren in handelsplatforms, beleggingsapps of analysetools. Bedrijven in sectoren zoals fintech of portefeuillebeheer kunnen deze data gebruiken om geïnformeerde beleggingsbeslissingen te nemen en handelsstrategieën te automatiseren op basis van marktbewegingen. Een voorbeeld hiervan is Polygon.io.
Best practices voor het bouwen van effectieve dataproducten
Effectieve dataproducten bouwen vraagt om meer dan technische expertise; het vereist een strategische aanpak die de eindgebruiker altijd centraal stelt.
Focus op de eindgebruiker
Stel: een marketinganalist moet het succes van meerdere advertentiecampagnes evalueren. Als het dataproduct informatie op een complexe manier presenteert, kan de analist moeite hebben om inzichten te halen, wat leidt tot gemiste optimalisatiemogelijkheden.
Als het product daarentegen een gebruiksvriendelijk dashboard biedt dat statistieken duidelijk en beknopt uitlicht, kan de analist snel de prestaties beoordelen en weloverwogen aanpassingen doen.
Een van de beste manieren om de focus op de eindgebruiker te houden, is door hen vroeg in het ontwerpproces te betrekken. Ontwikkelaars moeten feedback vragen aan eindgebruikers om zeker te weten dat het product echt aan hun behoeften voldoet.
Datakwaliteit en -governance
De ruggengraat van elk effectief dataproduct is data van hoge kwaliteit. Zonder nauwkeurige en betrouwbare data kunnen inzichten misleidend zijn en beslissingen gebrekkig.
Stel je een analyticsplatform voor de zorg voor dat patiëntdata uit diverse bronnen aggregeert. Als de data inconsistent is of slecht wordt beheerd, kunnen artsen tegenstrijdige informatie ontvangen over de geschiedenis van een patiënt, met mogelijke gevolgen voor de zorg.
Daarom is het opzetten van sterke data governance-praktijken belangrijk om te zorgen dat de data accuraat, consistent en veilig is. Investeren in datakwaliteit helpt de betrouwbaarheid van inzichten te vergroten, wat leidt tot betere uitkomsten.
Schaalbaarheid en prestaties
Denk aan een e-commerceplatform dat zich voorbereidt op een grote uitverkoop. Als het dataproduct niet is ontworpen om te schalen, kan het crashen of vertragen tijdens piekverkeer, met gemiste verkopen en gefrustreerde klanten tot gevolg.
Gebruik van robuuste architecturen zoals cloudoplossingen maakt het product geschikt om verhoogde gebruikersactiviteit op te vangen. Als schaalbaarheid in het ontwerp is ingebouwd, kun je pieken in datavolume en engagement met vertrouwen aan, wat de gebruikerservaring verbetert en verder gebruik stimuleert.
Continue monitoring en verbetering
Een succesvol dataproduct creëren is geen eenmalige inspanning; het vereist voortdurende monitoring en verbetering.
Stel een business intelligence-tool voor die door een directieteam wordt gebruikt. Als de tool niet meegroeit met veranderingen in het bedrijf of de sector, wordt die achterhaald en levert hij geen relevante inzichten meer.
Gebruikersfeedback verzamelen is belangrijk om te begrijpen wat goed werkt en wat niet. Als gebruikers vaak om nieuwe features of aanpassingen vragen, kunnen deze inzichten toekomstige updates sturen.
Voorbeelden van succesvolle dataproducten
Verschillende bedrijven hebben innovatieve dataproducten gecreëerd die veel waarde leveren aan het grote publiek. In dit onderdeel licht ik een paar opvallende voorbeelden uit.
Het aanbevelingssysteem van Netflix
Het aanbevelingssysteem van Netflix is een schoolvoorbeeld van een succesvol dataproduct. Het analyseert kijkgedrag om gepersonaliseerde content aan te bevelen. Concreet bouwt Netflix gedetailleerde gebruikersprofielen op door bij te houden wat gebruikers kijken, wanneer en hoe ze series en films beoordelen.
Deze data voedt het algoritme, waardoor Netflix titels kan aanbevelen die aansluiten bij individuele voorkeuren. Als een kijker bijvoorbeeld houdt van actiefilms met sterke vrouwelijke hoofdrollen, zal het systeem soortgelijke films prioriteren in de aanbevelingen. Deze gepersonaliseerde ervaring houdt kijkers betrokken en verlaagt churn, wat Netflix helpt zijn concurrentiepositie in de streamingmarkt te behouden.
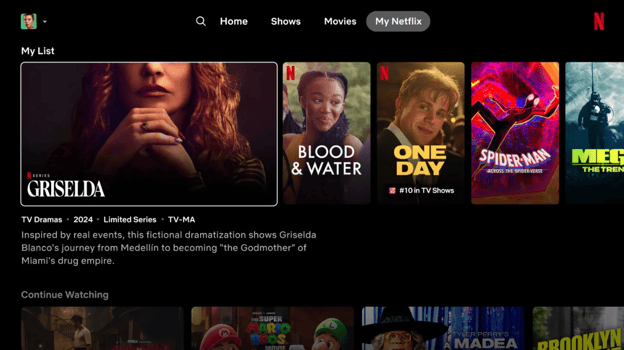
De Netflix-homepage. Beeldbron: The Verge
Google Analytics
Google Analytics is een ander krachtig dataproduct dat bedrijven helpt hun online aanwezigheid te begrijpen. Het volgt het gedrag van websitegebruikers en biedt inzicht in verkeersbronnen, gebruikersbetrokkenheid en conversiepercentages.
Een kleine online retailer kan met Google Analytics bijvoorbeeld zien welke marketingcampagnes het meeste verkeer naar de site leiden. Ze kunnen ook details identificeren zoals best presterende zoekwoorden, demografie van gebruikers en pagina’s die het beste converteren. Deze data stelt de retailer in staat om marketingstrategieën te optimaliseren en de website-indeling te verbeteren voor betere gebruikerservaringen die de verkoopgroei stimuleren.
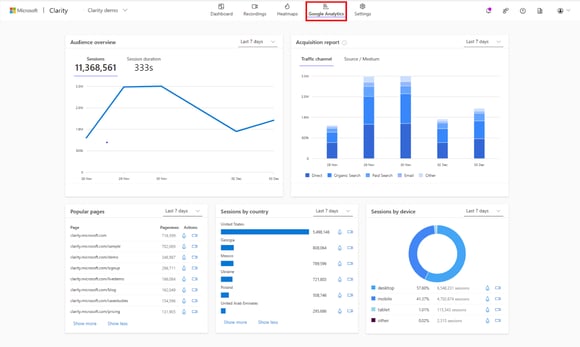
Het Google Analytics (GA)-dashboard. Beeldbron: Microsoft Learn
Spotify Discover Weekly
Elke week stelt Spotify een gepersonaliseerde afspeellijst samen voor elke gebruiker op basis van diens luistergedrag en voorkeuren. Het algoritme analyseert enorme hoeveelheden data om een selectie te maken die gebruikers verrast en blij maakt. Deze functie houdt gebruikers betrokken bij het platform door hen aan te moedigen nieuwe muziek te ontdekken en favoriete vondsten te delen met vrienden, wat uiteindelijk zorgt voor behoud van abonnementen en groei.
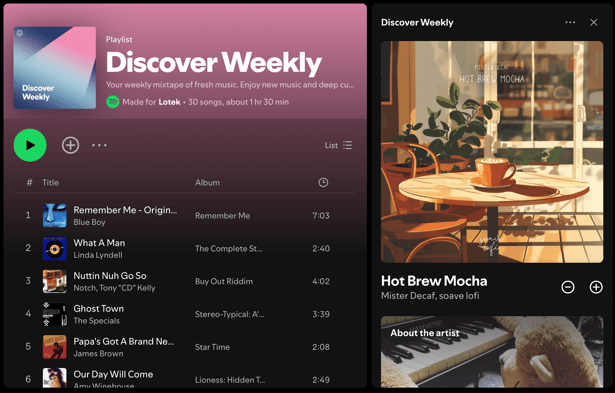
De Spotify Discover Weekly-UI
De toekomst van dataproducten
In de nabije toekomst zullen dataproducten nog intelligenter, persoonlijker en meer geïntegreerd worden in onze dagelijkse workflows. Opkomende trends zoals kunstmatige intelligentie, machine learning en realtime analytics zullen bepalen hoe we data gebruiken om meer voorspellende en geautomatiseerde inzichten te krijgen.
AI-gedreven dataproducten
Kunstmatige intelligentie (AI) is nu al een revolutie in hoe dataproducten werken, en die invloed zal alleen maar toenemen. AI-gedreven dataproducten maken geavanceerdere analyses mogelijk, zodat bedrijven trends beter kunnen voorspellen, besluitvorming kunnen automatiseren en hun operaties in realtime kunnen optimaliseren.
In sectoren zoals de zorg kunnen door AI aangedreven dataproducten gezondheidsuitkomsten van patiënten voorspellen, wat proactievere behandelingen en beter middelenbeheer mogelijk maakt. In de financiële sector kunnen deze producten frauduleuze transacties met hoge precisie detecteren, wat de beveiliging en het vertrouwen in digitale platforms vergroot.
Meer focus op personalisatie
Naarmate dataproducten evolueren, zal personalisatie een grote rol spelen. In plaats van generieke inzichten zullen toekomstige dataproducten hun output afstemmen op individuele gebruikersbehoeften.
Zo kan een e-commerceplatform meer geavanceerde aanbevelingssystemen gebruiken om gepersonaliseerde productaanbevelingen te doen op basis van browsegedrag, aankoopgeschiedenis en zelfs trends in klantvoorkeuren. Dergelijke personalisatie integreren kan de betrokkenheid vergroten en meer omzet genereren door betere klantervaringen.
Conclusie
In deze blogpost hebben we besproken wat dataproducten zijn, waarom ze belangrijk zijn, hun belangrijkste onderdelen en hoe ze waarde creëren voor bedrijven. We keken ook naar praktijkvoorbeelden en de toekomst van dataproducten.
We genereren elke dag enorm veel data! Maar ruwe data is op zichzelf niet nuttig. Dataproducten zetten deze data om in inzichten die betere beslissingen aansturen.
Met het juiste dataproduct kunnen gebruikers snel en vol vertrouwen handelen, zonder technische skills nodig te hebben. Bedrijven die investeren in het bouwen van sterke dataproducten, zijn beter voorbereid om te innoveren en te groeien in een digitale wereld.
Het begrijpen en bouwen van dataproducten vereist een solide basis in kernconcepten rond data. Wil je je kennis verdiepen? Overweeg dan deze resources:
- Understanding Modern Data Architecture: Leer hoe je data effectief structureert en beheert.
- Data Governance Concepts: Ontdek hoe je datakwaliteit, beveiliging en compliance waarborgt.
- Understanding Data Engineering: Ontdek de principes achter het ontwerpen en onderhouden van datapijplijnen.
- Introduction to Data Quality: Krijg inzicht in het waarborgen van nauwkeurigheid en betrouwbaarheid van data, een cruciaal aspect van elk dataproduct.
FAQs
Hoe verschilt een dataproduct van reguliere datatools?
Algemene datatools bieden meestal toegang tot ruwe data of helpen bij basisanalyses, terwijl dataproducten zijn ontworpen om specifieke zakelijke problemen op te lossen. Dat betekent dat ze kant-en-klare oplossingen bieden voor eindgebruikers, zoals voorspellingen, geautomatiseerde rapportages of aanbevelingen, zonder dat diepgaande technische kennis nodig is.
Welke sectoren gebruiken vaak dataproducten?
Dataproducten worden gebruikt in een breed scala aan sectoren. Zo gebruiken e-commercebedrijven dataproducten om klantgedrag te voorspellen, terwijl zorgorganisaties ze inzetten voor diagnostiek en behandeladviezen voor patiënten.
Wat zijn de belangrijkste aandachtspunten bij het ontwerpen van een dataproduct?
Het ontwerpen van een effectief dataproduct vereist een sterke focus op gebruikerservaring, datakwaliteit, schaalbaarheid en prestaties.
Wat zijn de typische kosten voor het ontwikkelen van een dataproduct?
De kosten voor het ontwikkelen van een dataproduct kunnen sterk variëren, afhankelijk van de complexiteit, de gebruikte technologiestack en de hoeveelheid data. Typische uitgaven zijn onder meer het opzetten van datainfrastructuur, softwarelicenties, cloudopslag en -verwerking, ontwikkel- en engineeringuren en doorlopend onderhoud en updates. De langetermijn-ROI rechtvaardigt deze kosten meestal door waardevolle inzichten te leveren die groei en efficiëntie stimuleren.



Elke zakelijke interactie genereert data, maar ruwe data is vaak versnipperd en onbruikbaar.
Een dataproduct is een tool of systeem dat deze data ordent en omzet in heldere, bruikbare inzichten. In plaats van eindeloos door spreadsheets te ploegen, kunnen gebruikers eenvoudig trends herkennen, uitkomsten voorspellen of processen automatiseren—waardoor ruwe data verandert in beslissingen die tijd besparen en groei stimuleren.
In dit artikel definieer ik dataproducten en verken ik hun typen en onderdelen. Ook geef ik praktijkvoorbeelden en toekomstige trends. Laten we beginnen!
Wil je meer leren? Bekijk dan ons webinar, Implementing A Culture To Create Data Products.
Wat is een dataproduct?
Een dataproduct is een resultaat dat data gebruikt om een probleem op te lossen of een behoefte te vervullen. Zie het als een slimme tool die is gebouwd om grote hoeveelheden data begrijpelijk te maken, zoals de kaart op een smartphone.
Aan de oppervlakte toont het alleen de snelste routes, maar achter de schermen haalt het realtime verkeersdata op, reviews van andere gebruikers en updates over wegafsluitingen. Al deze complexe data wordt omgezet in een simpele, gebruiksvriendelijke oplossing die je brengt waar je moet zijn, zonder dat je zelf hoeft te rekenen.
Op dezelfde manier neemt een dataproduct in de zakelijke wereld ruwe data, verwerkt die en levert inzichten in een gemakkelijk te gebruiken formaat. In plaats van uren te besteden aan het doornemen van verkooprapporten, kan een dataproduct een CEO automatisch laten zien welke producten het beste presteren, toekomstige verkooptrends voorspellen of zelfs strategische aanpassingen aanbevelen.
De term "dataproduct" ontstond toen bedrijven het belang inzagen van het omzetten van ruwe data in bruikbare tools. Het won aan terrein in de vroege jaren 2010, gedreven door:
Frameworks zoals data mesh, die data behandelen als een product beheerd door gedecentraliseerde teams, verstevigden het concept verder.
Kernkenmerken van een dataproduct zijn:
De vier kenmerken van een goed dataproduct. Afbeelding door de auteur.
Typen dataproducten
Dataproducten bestaan in verschillende vormen. In dit onderdeel verkennen we de meest voorkomende typen, zodat je een beter beeld krijgt van wat ik bedoel.
Analytische producten
Analytische producten richten zich op het leveren van inzichten door historische en realtime data te interpreteren. Deze producten komen vaak in de vorm van dashboards, rapporten en visualisaties waarmee gebruikers sleutelstatistieken kunnen volgen, trends herkennen en weloverwogen beslissingen nemen.
Predictieve producten
Predictieve dataproducten maken gebruik van statistische modellen of machinelearning-algoritmen om toekomstige uitkomsten te voorspellen op basis van historische data. Deze producten helpen organisaties te anticiperen op wat er komt (bijv. marktvraag, klantgedrag, operationele issues, enz.).
Data-as-a-Service (DaaS)
DaaS-producten bieden gebruikers on-demand toegang tot data, vaak via API’s. Deze producten stellen bedrijven in staat om rijke datasets te gebruiken zonder opslag of infrastructuur te beheren.
Aanbevelingssystemen
Aanbevelingssystemen analyseren gebruikersgedrag om gepersonaliseerde content, producten of diensten voor te stellen. Ze verbeteren hun suggesties continu door te leren van interacties van gebruikers.
Automatiseringstools
Automatiseringstools gebruiken data om vooraf gedefinieerde acties of processen te triggeren. Dit vermindert handmatig werk en stroomlijnt workflows. Zulke dataproducten kunnen de operationele efficiëntie aanzienlijk verhogen.