
Cursus
ETL en ELT in Python
4 uur
40.5K
Oefen en volg je voortgang.
Ga Verder Met GoogleTraditioneel moesten data engineers zich richten op ETL (extract, transform, load): data uit meerdere bronnen halen, omzetten naar een geschikt formaat en laden in een datawarehouse. Maar de noodzaak om deze data te operationaliseren—zodat ze toegankelijk en nuttig is voor gangbare bedrijfsapplicaties—heeft geleid tot de ontwikkeling van reverse ETL.
In dit artikel bekijken we de definitie van reverse ETL, hoe het verschilt van traditionele ETL en de tools die beschikbaar zijn voor implementatie. We behandelen ook praktische use-cases om het belang te laten zien. Ben je nieuw met dit onderwerp, bekijk dan onze cursussen ETL and ELT in Python en Introduction to Data Engineering op DataCamp om te beginnen. Onze Getting Started with Data Pipelines code-along is ook een heel handige bron.
Reverse ETL is het proces waarbij data uit een datawarehouse wordt gehaald, getransformeerd om te voldoen aan de eisen van operationele systemen en vervolgens in die systemen wordt geladen. Deze aanpak staat tegenover traditionele ETL, waarbij data uit operationele systemen wordt gehaald, getransformeerd en in een datawarehouse wordt geladen.
Historisch gezien evolueerde datamanagement van ETL naar ELT (extract, load, transform) om te voldoen aan de groeiende behoefte aan real-time dataverwerking. Reverse ETL is de nieuwste stap in die evolutie. Terwijl ETL en ELT zich richten op het centraliseren van data, wil Reverse ETL deze data operationaliseren door haar bruikbaar te maken binnen systemen van derden zoals CRM’s, marketingplatforms en andere operationele tools.
We zeiden al dat reverse ETL een integratieproces is dat inzichten vanuit een datawarehouse of analyticsplatform naar operationele systemen verplaatst. Met andere woorden: het keert het traditionele ETL-proces om. Laten we nu elk onderdeel wat beter bekijken.
Het proces begint met het kiezen van de meest relevante informatie uit een datawarehouse of analyticsplatform. Dit kan klantgegevens, verkoopcijfers of iets anders omvatten. Als we weten wat we uit opslag nodig hebben, moeten we de data mogelijk nog filteren, aggregeren of op een andere manier transformeren om aan onze behoeften te voldoen.
Vervolgens wordt data uit het bronsysteem gemapt naar de overeenkomstige velden in het doelsysteem. Optionele verrijking kan hier plaatsvinden door velden toe te voegen uit externe bronnen, zoals demografische gegevens aan klantprofielen. Waarschijnlijk is er aanvullende transformatie nodig zodat de data voldoet aan de eisen van het doelsysteem, zoals het converteren van datatypen of het afhandelen van datumformaten.
Tot slot wordt de getransformeerde data via de API van het doelsysteem geladen, met real-time of batchupdates. Mechanismen voor foutafhandeling, waaronder retry-logica en herstelprocedures, voorkomen problemen tijdens het laden. Er zal een proces zijn dat de integriteit van de data na het laden verifieert.
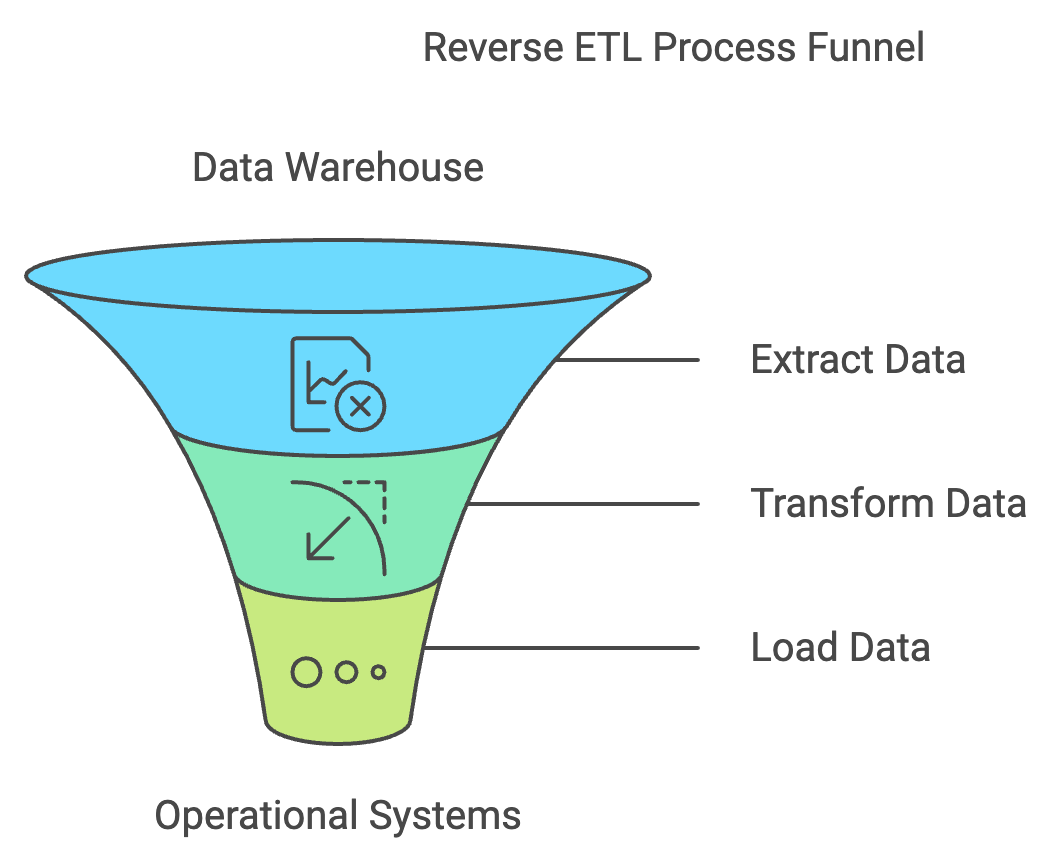
Basisillustratie van reverse ETL. Bron: napkin.ai
Stel een marketingteam voor dat een datawarehouse gebruikt om klantgedrag te analyseren. Reverse ETL kan klantsegmenten op basis van aankoopgeschiedenis en demografie extraheren en deze data laden in een marketingautomatiseringsplatform. Zo kan het team gerichte campagnes maken en klantinteracties personaliseren.
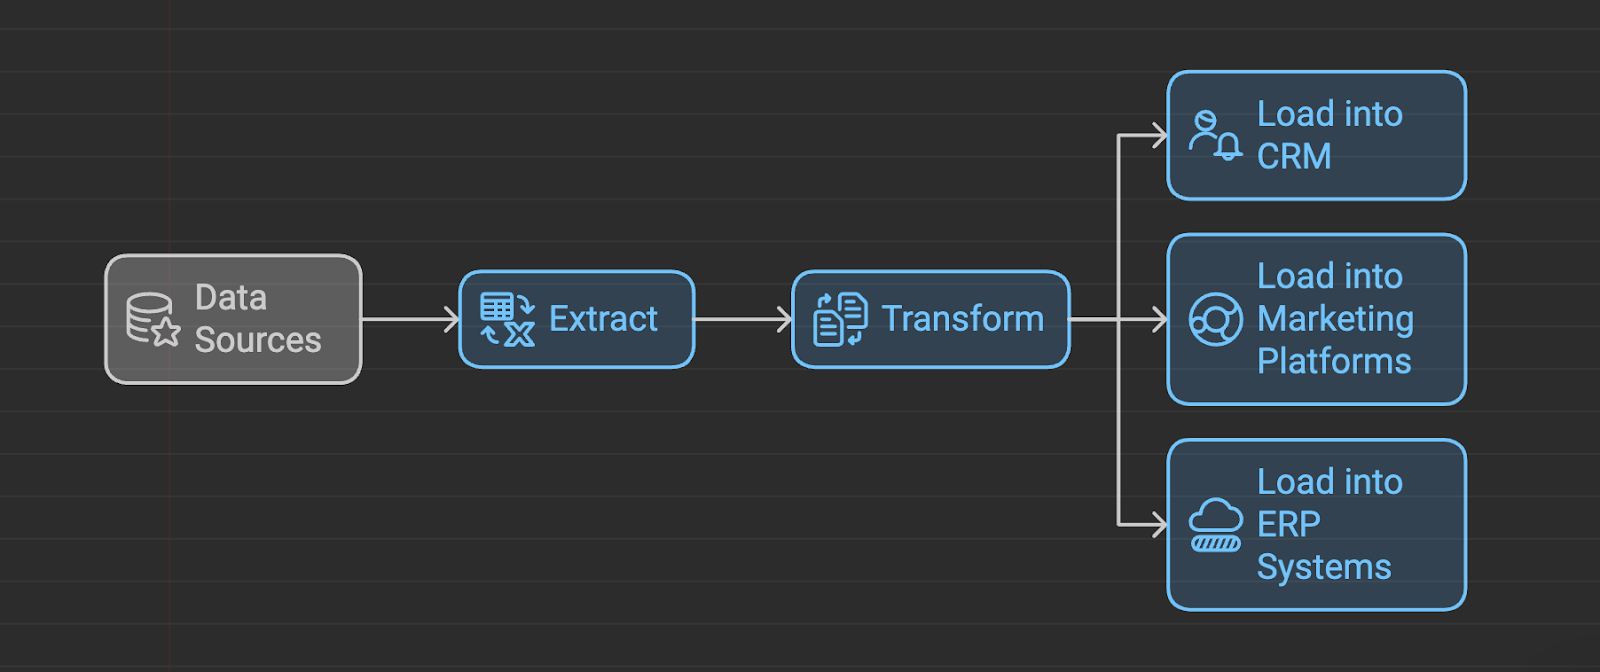
Reverse ETL-proces. Bron: napkin.ai
Hoe veelbelovend ook, reverse ETL is niet perfect. Het kan voor data engineers lastig zijn om ervoor te zorgen dat alle data klopt en hun weg te vinden in verschillende en soms onbekende systemen. Een van de grootste uitdagingen is het waarborgen van datakwaliteit. Inconsistente data kan tot slechte beslissingen leiden, dus rigoureuze validatie- en opschoningsprocessen zijn belangrijk.
Ook het datavolume en -tempo kunnen overweldigend zijn. Grote datasets efficiënt verwerken vereist strategieën zoals incrementele updates en change data capture. Deze technieken richten zich op het verwerken van alleen de nodige data, wat prestaties optimaliseert en de systeemlast verlaagt. Een andere hobbel is API-complexiteit. Systemen verschillen in API-mogelijkheden. Effectief API-beheer en standaardisatie kunnen helpen.
ETL is een traditionele aanpak voor dataintegratie waarbij data uit diverse bronnen wordt gehaald, getransformeerd naar een geschikt formaat en vervolgens geladen in een datawarehouse. Dit proces vereist aanzienlijke opschoning en transformatie vooraf en is daardoor arbeidsintensief en tijdrovend.
ELT daarentegen geeft prioriteit aan snelheid en flexibiliteit. Data wordt uit bronnen gehaald en in rauwe vorm direct in een datawarehouse geladen. Transformaties vinden plaats binnen het datawarehouse, vaak met krachtige query-engines. Deze aanpak benut de rekenkracht van moderne datawarehouses en biedt meer wendbaarheid bij data-exploratie en -analyse.
Terwijl ETL en ELT zich richten op het naar een datawarehouse verplaatsen van data, pakt reverse ETL het anders aan. Het haalt getransformeerde data uit het datawarehouse en stuurt die naar operationele systemen, zoals CRM, marketingautomatiseringsplatforms en klantenservicetools. Zo kunnen organisaties inzichten uit data-analyse benutten om real-time acties te sturen en bedrijfsprocessen te verbeteren. De verschuiving van ETL naar ELT wordt vooral gedreven door de volgende factoren:
Kortom, de evolutie van datamanagement is een reis naar meer efficiëntie, flexibiliteit en actiegerichte inzichten. ETL legde de basis, ELT versnelde data-inname en -transformatie, en reverse ETL sloot de cirkel door inzichten naar operationele workflows te brengen.
ETL en ELT zijn allebei methoden om data van het ene systeem naar het andere te verplaatsen. Hoewel ze vergelijkbaar klinken, zijn er cruciale verschillen in hoe ze met transformatie omgaan. Hier is een momentopname; voor een echt gedetailleerde uitleg, lees onze blogpost ETL vs. ELT.
| Kenmerk | ETL | ELT |
|---|---|---|
| Datatransformatie | Voor het laden | Na het laden |
| Datakwaliteit | Grote nadruk op opschonen | Minder nadruk op opschoning vooraf |
| Verwerkingstijd | Langer door transformatie | Sneller door parallelle verwerking |
| Datavolume | Geschikter voor kleinere datasets | Verwerkt grote datasets efficiënt |
| Flexibiliteit | Minder flexibiliteit | Meer flexibiliteit door beschikbaarheid van ruwe data |
Reverse ETL is een krachtig middel dat de kloof overbrugt tussen data-inzichten en operationele uitvoering. Door waardevolle data uit je datawarehouse naar operationele systemen over te zetten, kun je een wereld aan mogelijkheden ontsluiten.
Reverse ETL is meer dan een datatransfertool. Het is een strategisch middel dat je bedrijf vooruit kan helpen. Dit zijn enkele van de belangrijke ideeën die voor mij het zwaarst wegen.
Zoek je extra inzichten van leiders uit het vak, dan deelt Liya Aizenberg, Director of Data Engineering bij Away, waardevolle tips over hoe je data-engineeringinitiatieven het best afstemt op bedrijfsdoelen.
Er zijn verschillende tools en platforms beschikbaar om reverse ETL te implementeren, elk met unieke functies en mogelijkheden. De onderstaande tabel toont enkele populaire opties:
Houd bij het kiezen van een reverse ETL-tool rekening met de volgende factoren:
Door deze factoren en de specifieke behoeften van je organisatie zorgvuldig te beoordelen, kun je de meest geschikte reverse ETL-tool kiezen om het volle potentieel van je data te benutten.
Hopelijk zie je nu het belang van reverse ETL. Het is veel meer dan zomaar een technische procedure. Bedrijven met de juiste middelen, waaronder data engineers met ervaring in reverse ETL, kunnen transformeren van stroperig naar dynamisch: ze gebruiken realtime data om te groeien, de omzet te verhogen en snel op marktveranderingen te reageren.
Ben je serieus met data engineering bezig, schrijf je dan in voor onze uitgebreide carrièreroute Data Engineer in Python, die zich richt op de rol van Python bij het automatiseren en optimaliseren van dataprocessen. Als je eerst meer ervaring met SQL wilt opdoen, probeer dan onze carrièreroute Associate Data Engineer in SQL, die zowel ETL- als ELT-processen in detail verkent, naast hun relatie tot PostgreSQL.
Leer met DataCamp
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

