पारंपरिक रूप से, डेटा इंजीनियरों का ध्यान ETL (extract, transform, and load) कार्यों पर रहा है, जिसमें कई स्रोतों से डेटा निकालना, उसे उपयुक्त फॉर्मेट में बदलना, और उसे डेटा वेयरहाउस में लोड करना शामिल है। हालांकि, इस डेटा को ऑपरेशनल बनाना—ताकि वह सामान्य व्यावसायिक ऐप्लिकेशनों के लिए सुलभ और उपयोगी हो सके—की आवश्यकता ने reverse ETL के विकास को जन्म दिया।
इस लेख में, हम reverse ETL की परिभाषा, यह पारंपरिक ETL से कैसे अलग है, और इसे लागू करने के लिए उपलब्ध टूल्स की पड़ताल करेंगे। हम इसके महत्व को दिखाने के लिए व्यावहारिक उपयोग मामलों पर भी नज़र डालेंगे। यदि आप इस विषय में नए हैं, तो शुरुआत करने के लिए हमारा ETL and ELT in Python कोर्स और DataCamp पर हमारा Introduction to Data Engineering कोर्स अवश्य देखें। हमारा Getting Started with Data Pipelines कोड-अलॉन्ग भी एक अत्यंत सहायक संसाधन है।
Reverse ETL क्या है?
Reverse ETL वह प्रक्रिया है जिसमें डेटा वेयरहाउस से डेटा निकाला जाता है, उसे ऑपरेशनल सिस्टम्स की आवश्यकताओं के अनुरूप बदला जाता है, और फिर उन सिस्टम्स में लोड किया जाता है। यह दृष्टिकोण पारंपरिक ETL के विपरीत है, जहाँ डेटा ऑपरेशनल सिस्टम्स से निकाला जाता है, बदला जाता है, और डेटा वेयरहाउस में लोड किया जाता है।
ऐतिहासिक रूप से, रियल-टाइम डेटा प्रोसेसिंग की बढ़ती ज़रूरतों को पूरा करने के लिए डेटा मैनेजमेंट ETL से ELT (extract, load, transform) तक विकसित हुआ। Reverse ETL इस विकास का नवीनतम चरण है। जहाँ ETL और ELT का केंद्र डेटा का केंद्रीकरण है, वहीं Reverse ETL का लक्ष्य इस डेटा को ऑपरेशनल बनाना है ताकि वह CRMs, मार्केटिंग प्लेटफॉर्म्स और अन्य ऑपरेशनल टूल्स जैसे थर्ड-पार्टी सिस्टम्स में कार्रवाई योग्य बन सके।
Reverse ETL कैसे काम करता है
हमने कहा कि reverse ETL एक डेटा इंटीग्रेशन प्रक्रिया है जो डेटा वेयरहाउस या एनालिटिक्स प्लेटफॉर्म से इनसाइट्स को ऑपरेशनल सिस्टम्स में पहुँचाती है। दूसरे शब्दों में, यह पारंपरिक ETL प्रक्रिया को उलट देता है। अब प्रत्येक चरण को थोड़ा विस्तार से देखते हैं।
1. डेटा एक्सट्रैक्शन
प्रक्रिया डेटा वेयरहाउस या एनालिटिक्स प्लेटफॉर्म से सबसे प्रासंगिक जानकारी चुनने से शुरू होती है। इसमें ग्राहक डेटा, बिक्री मेट्रिक्स, या कुछ और शामिल हो सकता है। स्टोरेज से क्या चाहिए यह तय करने के बाद भी, ज़रूरत के अनुसार डेटा को फ़िल्टर करना, एग्रीगेट करना, या किसी तरह ट्रांसफॉर्म करना पड़ सकता है।
2. डेटा ट्रांसफॉर्मेशन
अगले चरण में, स्रोत सिस्टम का डेटा लक्ष्य सिस्टम के अनुरूप फील्ड्स पर मैप किया जाता है। इस चरण में वैकल्पिक डेटा एनरिचमेंट भी किया जा सकता है, जैसे बाहरी स्रोतों से फील्ड्स जोड़ना—उदाहरण के लिए ग्राहकों की प्रोफाइल में जनसांख्यिकीय डेटा। आमतौर पर अतिरिक्त ट्रांसफॉर्मेशन भी किए जाते हैं ताकि डेटा लक्ष्य सिस्टम की आवश्यकताओं से मेल खाए, जैसे डेटा टाइप्स को बदलना या तारीख़ के फॉर्मैट्स को संभालना।
3. डेटा लोडिंग
अंत में, बदला हुआ डेटा लक्ष्य सिस्टम में उसकी API के माध्यम से या तो रियल-टाइम में या बैच अपडेट्स के रूप में लोड किया जाता है। एरर-हैंडलिंग तंत्र, जिनमें रिट्राई लॉजिक और रिकवरी प्रक्रियाएँ शामिल हैं, लोडिंग के दौरान समस्याओं को रोकते हैं। लोडिंग के बाद डेटा की अखंडता को सत्यापित करने की एक प्रक्रिया होगी।
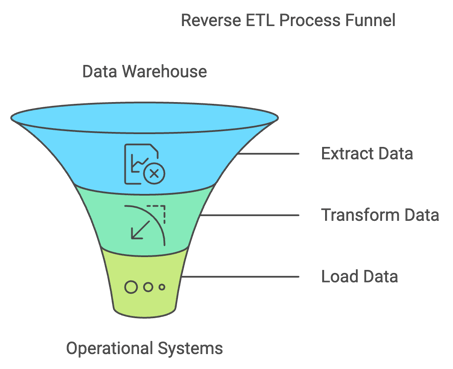
Reverse ETL का बुनियादी चित्रण। स्रोत: napkin.ai
वास्तविक-जीवन उदाहरण
उदाहरण के लिए, किसी मार्केटिंग टीम को लें जो ग्राहक व्यवहार का विश्लेषण करने के लिए डेटा वेयरहाउस का उपयोग करती है। Reverse ETL खरीद इतिहास और जनसांख्यिकी के आधार पर ग्राहक सेगमेंट्स निकाल सकता है और इस डेटा को किसी मार्केटिंग ऑटोमेशन प्लेटफ़ॉर्म में लोड कर सकता है। इससे टीम लक्षित कैंपेन बना सकती है और ग्राहकों के साथ इंटरैक्शन को व्यक्तिगत बना सकती है।
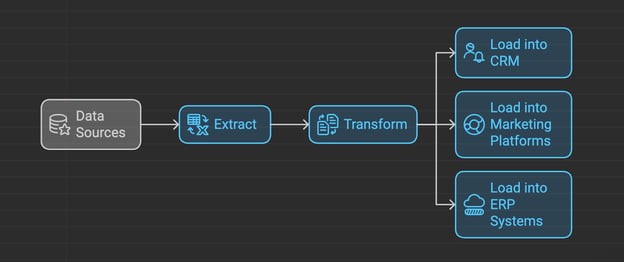
Reverse ETL प्रक्रिया। स्रोत: napkin.ai
Reverse ETL में तकनीकी चुनौतियाँ और समाधान
उम्मीदें तो बड़ी हैं, पर reverse ETL पूर्ण नहीं है। डेटा इंजीनियरों के लिए सुनिश्चित करना कि सारा डेटा सटीक हो और विभिन्न और कभी-कभी अपरिचित सिस्टम्स के बीच रास्ता बनाना चुनौतीपूर्ण हो सकता है। सबसे बड़ी चुनौतियों में से एक डेटा गुणवत्ता बनाए रखना है। असंगत डेटा गलत निर्णयों की ओर ले जा सकता है, इसलिए कठोर डेटा वैलिडेशन और क्लीनिंग प्रक्रियाएँ महत्वपूर्ण हैं।
डेटा की मात्रा और गति भी भारी पड़ सकती है। बड़े डेटासेट्स को कुशलता से संभालने के लिए इंक्रीमेंटल अपडेट्स और चेंज डेटा कैप्चर जैसी रणनीतियाँ चाहिए। ये तकनीकें केवल आवश्यक डेटा को प्रोसेस करने पर ध्यान देती हैं, प्रदर्शन को अनुकूलित करती हैं, और सिस्टम लोड को कम करती हैं। एक और बाधा API की जटिलता है। अलग-अलग सिस्टम्स की API क्षमताएँ भिन्न होती हैं। प्रभावी API प्रबंधन और मानकीकरण मददगार हो सकते हैं।
ETL बनाम Reverse ETL: बड़े अंतर
ETL एक पारंपरिक डेटा इंटीग्रेशन दृष्टिकोण है जिसमें डेटा विभिन्न स्रोतों से निकाला जाता है, उपयुक्त फॉर्मेट में बदला जाता है, और फिर डेटा वेयरहाउस में लोड किया जाता है। इस प्रक्रिया में शुरू से ही व्यापक डेटा क्लीनिंग और ट्रांसफॉर्मेशन शामिल होता है, जिससे यह संसाधन-गहन और समय लेने वाली बन जाती है।
दूसरी ओर, ELT गति और लचीलापन को प्राथमिकता देता है। डेटा स्रोतों से निकालकर सीधे अपने कच्चे रूप में डेटा वेयरहाउस में लोड किया जाता है। ट्रांसफॉर्मेशन डेटा वेयरहाउस के भीतर, अक्सर शक्तिशाली क्वेरी इंजनों का उपयोग करके किए जाते हैं। यह दृष्टिकोण आधुनिक डेटा वेयरहाउस की कम्प्यूटिंग क्षमता का लाभ उठाता है और डेटा एक्सप्लोरेशन और विश्लेषण में अधिक फुर्ती प्रदान करता है।
Reverse ETL का उभार
जहाँ ETL और ELT का ध्यान डेटा को डेटा वेयरहाउस में ले जाने पर है, reverse ETL एक अलग राह लेता है। यह डेटा वेयरहाउस से बदला हुआ डेटा निकालकर उसे ऑपरेशनल सिस्टम्स—जैसे CRM, मार्केटिंग ऑटोमेशन प्लेटफॉर्म्स, और कस्टमर सपोर्ट टूल्स—तक पहुँचाता है। इससे संगठन डेटा विश्लेषण से निकले इनसाइट्स का उपयोग रियल-टाइम कार्रवाइयों के लिए कर सकते हैं और व्यावसायिक प्रक्रियाओं में सुधार ला सकते हैं। ETL से ELT की ओर बदलाव मुख्यतः निम्न कारकों से प्रेरित रहा है:
- डेटा वॉल्यूम और वेग में वृद्धि: पारंपरिक ETL प्रक्रियाएँ आधुनिक ऐप्लिकेशनों और IoT डिवाइसेज़ द्वारा उत्पन्न विशाल डेटा को संभालने में संघर्ष करती थीं।
- क्लाउड कंप्यूटिंग और डेटा वेयरहाउसिंग में प्रगति: क्लाउड-आधारित डेटा वेयरहाउस और डेटा लेक्स ELT के लिए आवश्यक स्केलेबिलिटी और प्रोसेसिंग पावर प्रदान करते हैं।
- डेटा फुर्ती और अन्वेषण पर जोर: ELT तेज़ प्रयोग और आवर्ती डेटा विश्लेषण की अनुमति देता है।
मूल रूप से, डेटा मैनेजमेंट का विकास अधिक दक्षता, लचीलापन, और कार्रवाई योग्य इनसाइट्स की ओर एक यात्रा रहा है। ETL ने नींव रखी, ELT ने डेटा इनजेशन और ट्रांसफॉर्मेशन को तेज़ किया, और reverse ETL ने इनसाइट्स को ऑपरेशनल वर्कफ़्लोज़ में वापस लाकर इस चक्र को पूरा किया।
ETL और ELT के बीच मुख्य अंतर
ETL और ELT दोनों ही तरीक़े हैं जो डेटा को एक सिस्टम से दूसरे सिस्टम में ले जाते हैं। सुनने में समान लगने पर भी, इनमें महत्वपूर्ण अंतर है कि यह डेटा ट्रांसफॉर्मेशन को कैसे संभालते हैं। यहाँ एक झलक दी गई है; विस्तृत विश्लेषण के लिए हमारा ETL vs. ELT ब्लॉग पोस्ट पढ़ें।
| विशेषता | ETL | ELT |
|---|
| डेटा ट्रांसफॉर्मेशन | लोडिंग से पहले | लोडिंग के बाद |
| डेटा गुणवत्ता | डेटा क्लीनिंग पर उच्च जोर | शुरुआती क्लीनिंग पर कम जोर |
| प्रोसेसिंग समय | ट्रांसफॉर्मेशन के कारण अधिक समय | पैरेलल प्रोसेसिंग के कारण तेज़ |
| डेटा वॉल्यूम | छोटे डेटासेट्स के लिए अधिक उपयुक्त | बड़े डेटासेट्स को कुशलता से संभालता है |
| लचीलापन | कम लचीलापन | कच्चे डेटा की उपलब्धता के कारण अधिक लचीलापन |
Reverse ETL के वास्तविक उपयोग
Reverse ETL एक शक्तिशाली साधन है जो डेटा इनसाइट्स और ऑपरेशनल निष्पादन के बीच की खाई को पाटता है। अपने डेटा वेयरहाउस से मूल्यवान डेटा को ऑपरेशनल सिस्टम्स में स्थानांतरित करके आप संभावनाओं की दुनिया खोल सकते हैं।
- सेल्स ट्रांसफॉर्मेशन: कोई SaaS कंपनी अपने डेटा वेयरहाउस से डेटा को CRM में सिंक करके अपनी सेल्स टीम को रियल-टाइम ग्राहक इनसाइट्स से लैस कर सकती है।
- मार्केटिंग ऑप्टिमाइज़ेशन: कोई ई-कॉमर्स कंपनी अपने मार्केटिंग ऑटोमेशन प्लेटफ़ॉर्म में कैंपेन परफॉर्मेंस मेट्रिक्स वापस भेजकर अधिक प्रभावी कैंपेन चलाने की कोशिश कर सकती है। इस तरह वे बेहतर ROI के लिए A/B परीक्षण कर सकते हैं।
- ग्राहक-केंद्रित सपोर्ट: कोई टेलीकॉम प्रदाता ग्राहक डेटा को अपने कस्टमर सपोर्ट टूल्स में सिंक करके ग्राहक संतुष्टि बढ़ाने की कोशिश कर सकता है।
- वित्तीय फुर्ती: कोई निर्माता रिपोर्टिंग और फ़ोरकास्टिंग में सुधार के लिए वित्तीय डेटा को अपने ERP सिस्टम में पुश करके वित्तीय प्रक्रियाओं में गति ला सकता है।
- उत्पाद नवाचार: कोई स्ट्रीमिंग प्लेटफ़ॉर्म उपयोग मेट्रिक्स को अन्य प्रोडक्ट मैनेजमेंट टूल्स से जोड़कर वास्तविक उपयोगकर्ता डेटा के आधार पर प्रोडक्ट डेवलपमेंट को दिशा दे सकता है और नए फीचर्स बनाने के तरीक़े समझ सकता है।
रणनीतिक महत्व: Reverse ETL क्यों मायने रखता है
Reverse ETL सिर्फ़ डेटा ट्रांसफर टूल से भी बढ़कर है। यह एक रणनीतिक संपत्ति है जो आपके व्यवसाय को आगे बढ़ा सकती है। यहाँ कुछ महत्वपूर्ण विचार हैं जो मुझे सबसे अहम लगते हैं।
- निर्णय लेने में सुधार: जहाँ निर्णय लिए जाते हैं वहाँ डेटा को सुलभ बनाकर reverse ETL टीमों का आत्मविश्वास बढ़ाता है।
- ऑपरेशनल दक्षता में वृद्धि: सिस्टम्स के बीच डेटा फ्लो को ऑटोमेट करने से मैनुअल डेटा एंट्री खत्म होती है, जो एक बड़ा लाभ है।
- अपने व्यवसाय को भविष्य के लिए तैयार करना: Reverse ETL आधुनिक डेटा स्टैक्स का एक महत्वपूर्ण घटक है और आगे भी विकसित होता रहेगा। Reverse ETL को जल्दी अपनाकर संगठन बढ़त बनाए रख सकते हैं और प्रतिस्पर्धात्मक लाभ हासिल कर सकते हैं।
यदि आप उद्योग विशेषज्ञों से अतिरिक्त जानकारी चाहते हैं, तो Away की Director of Data Engineering, Liya Aizenberg बताती हैं कि डेटा इंजीनियरिंग पहलों को व्यावसायिक लक्ष्यों के साथ सबसे बेहतर ढंग से कैसे संरेखित किया जाए।
टूल्स और प्लेटफ़ॉर्म/लोकप्रिय Reverse ETL टूल्स
Reverse ETL को लागू करने के लिए कई टूल्स और प्लेटफ़ॉर्म उपलब्ध हैं, जिनमें प्रत्येक की अपनी विशेष खूबियाँ और क्षमताएँ हैं। निम्न तालिका कुछ लोकप्रिय विकल्प दिखाती है:
| टूल्स और प्लेटफ़ॉर्म | लोकप्रिय Reverse ETL टूल्स | मुख्य विशेषताएँ |
|---|
| Census | Snowflake, Redshift और BigQuery जैसे क्लाउड डेटा वेयरहाउस के साथ मज़बूत इंटीग्रेशन | CRMs, मार्केटिंग ऑटोमेशन प्लेटफ़ॉर्म्स और कस्टमर सपोर्ट टूल्स में डेटा सिंक करने में उत्कृष्ट। सशक्त डेटा मॉडलिंग और ट्रांसफॉर्मेशन क्षमताएँ। |
| Hightouch | उपयोगकर्ता-अनुकूल इंटरफ़ेस | मार्केटिंग और सेल्स टीमों पर गहन फोकस। Salesforce, HubSpot और Marketo के साथ सहज इंटीग्रेशन। लक्षित ग्राहक सेगमेंट और व्यक्तिगत कैंपेन बनाने में प्रभावी। |
| Fivetran | व्यापक डेटा कनेक्टर्स | विश्वसनीय डेटा पाइपलाइन्स। एकीकृत डेटा इंटीग्रेशन समाधान। |
| Segment | इंटीग्रेशन का विशाल इकोसिस्टम | डेटा गोपनीयता पर फोकस। उन कंपनियों के लिए उपयुक्त जो डेटा गवर्नेंस को प्राथमिकता देती हैं। |
| Airbyte | ओपन-सोर्स लचीलापन और कस्टमाइज़ेशन | तकनीकी विशेषज्ञता वाले संगठनों के लिए आदर्श। मज़बूत सामुदायिक समर्थन। |
Reverse ETL टूल चुनते समय निम्नलिखित कारकों पर विचार करें:
- डेटा वॉल्यूम और वेग: आपको जितनी मात्रा और गति से डेटा सिंक करना है, वही आपका चयन प्रभावित करेगी।
- इंटीग्रेशन आवश्यकताएँ: सुनिश्चित करें कि टूल आपके मौजूदा डेटा स्टैक और ऑपरेशनल सिस्टम्स के साथ इंटीग्रेट होता है।
- उपयोग में आसानी: टूल के यूज़र इंटरफ़ेस और डेटा पाइपलाइन्स सेटअप करने की जटिलता का मूल्यांकन करें।
- स्केलेबिलिटी: बढ़ती डेटा मात्रा और उपयोगकर्ता मांगों को संभालने की टूल की क्षमता पर विचार करें।
- प्राइसिंग और सपोर्ट: टूल की लागत और प्रदत्त सपोर्ट के स्तर का आकलन करें।
इन कारकों और आपके संगठन की विशिष्ट ज़रूरतों का सावधानीपूर्वक मूल्यांकन करके, आप सबसे उपयुक्त reverse ETL टूल चुन सकते हैं और अपने डेटा की पूरी क्षमता को खोल सकते हैं।
निष्कर्ष
आशा है कि आप reverse ETL के महत्व को देख और सराह पाएँगे। यह केवल एक तकनीकी प्रक्रिया नहीं है। जिन कंपनियों के पास सही संसाधन हैं—जिनमें reverse ETL में अनुभवी डेटा इंजीनियर शामिल हैं—वे जड़ सोच से निकलकर गतिशील बन सकती हैं, रियल-टाइम डेटा का उपयोग करके विकास कर सकती हैं, बिक्री बढ़ा सकती हैं, और बाज़ार में बदलावों पर तेजी से प्रतिक्रिया दे सकती हैं।
यदि आप डेटा इंजीनियरिंग को लेकर गंभीर हैं, तो हमारा व्यापक Data Engineer in Python करियर ट्रैक जॉइन करें, जो Python की भूमिका पर केंद्रित है, जो डेटा प्रक्रियाओं को स्वचालित और अनुकूलित करता है। यदि आपको पहले SQL में अधिक अनुभव की आवश्यकता लगती है, तो पहले हमारा Associate Data Engineer in SQL करियर ट्रैक आज़माएँ, जो ETL और ELT प्रक्रियाओं की विस्तार से पड़ताल करता है और उनके PostgreSQL से संबंध को भी समझाता है।


पारंपरिक रूप से, डेटा इंजीनियरों का ध्यान ETL (extract, transform, and load) कार्यों पर रहा है, जिसमें कई स्रोतों से डेटा निकालना, उसे उपयुक्त फॉर्मेट में बदलना, और उसे डेटा वेयरहाउस में लोड करना शामिल है। हालांकि, इस डेटा को ऑपरेशनल बनाना—ताकि वह सामान्य व्यावसायिक ऐप्लिकेशनों के लिए सुलभ और उपयोगी हो सके—की आवश्यकता ने reverse ETL के विकास को जन्म दिया।
इस लेख में, हम reverse ETL की परिभाषा, यह पारंपरिक ETL से कैसे अलग है, और इसे लागू करने के लिए उपलब्ध टूल्स की पड़ताल करेंगे। हम इसके महत्व को दिखाने के लिए व्यावहारिक उपयोग मामलों पर भी नज़र डालेंगे। यदि आप इस विषय में नए हैं, तो शुरुआत करने के लिए हमारा ETL and ELT in Python कोर्स और DataCamp पर हमारा Introduction to Data Engineering कोर्स अवश्य देखें। हमारा Getting Started with Data Pipelines कोड-अलॉन्ग भी एक अत्यंत सहायक संसाधन है।
Reverse ETL क्या है?
Reverse ETL वह प्रक्रिया है जिसमें डेटा वेयरहाउस से डेटा निकाला जाता है, उसे ऑपरेशनल सिस्टम्स की आवश्यकताओं के अनुरूप बदला जाता है, और फिर उन सिस्टम्स में लोड किया जाता है। यह दृष्टिकोण पारंपरिक ETL के विपरीत है, जहाँ डेटा ऑपरेशनल सिस्टम्स से निकाला जाता है, बदला जाता है, और डेटा वेयरहाउस में लोड किया जाता है।
ऐतिहासिक रूप से, रियल-टाइम डेटा प्रोसेसिंग की बढ़ती ज़रूरतों को पूरा करने के लिए डेटा मैनेजमेंट ETL से ELT (extract, load, transform) तक विकसित हुआ। Reverse ETL इस विकास का नवीनतम चरण है। जहाँ ETL और ELT का केंद्र डेटा का केंद्रीकरण है, वहीं Reverse ETL का लक्ष्य इस डेटा को ऑपरेशनल बनाना है ताकि वह CRMs, मार्केटिंग प्लेटफॉर्म्स और अन्य ऑपरेशनल टूल्स जैसे थर्ड-पार्टी सिस्टम्स में कार्रवाई योग्य बन सके।
Reverse ETL कैसे काम करता है
हमने कहा कि reverse ETL एक डेटा इंटीग्रेशन प्रक्रिया है जो डेटा वेयरहाउस या एनालिटिक्स प्लेटफॉर्म से इनसाइट्स को ऑपरेशनल सिस्टम्स में पहुँचाती है। दूसरे शब्दों में, यह पारंपरिक ETL प्रक्रिया को उलट देता है। अब प्रत्येक चरण को थोड़ा विस्तार से देखते हैं।
1. डेटा एक्सट्रैक्शन
प्रक्रिया डेटा वेयरहाउस या एनालिटिक्स प्लेटफॉर्म से सबसे प्रासंगिक जानकारी चुनने से शुरू होती है। इसमें ग्राहक डेटा, बिक्री मेट्रिक्स, या कुछ और शामिल हो सकता है। स्टोरेज से क्या चाहिए यह तय करने के बाद भी, ज़रूरत के अनुसार डेटा को फ़िल्टर करना, एग्रीगेट करना, या किसी तरह ट्रांसफॉर्म करना पड़ सकता है।
2. डेटा ट्रांसफॉर्मेशन
अगले चरण में, स्रोत सिस्टम का डेटा लक्ष्य सिस्टम के अनुरूप फील्ड्स पर मैप किया जाता है। इस चरण में वैकल्पिक डेटा एनरिचमेंट भी किया जा सकता है, जैसे बाहरी स्रोतों से फील्ड्स जोड़ना—उदाहरण के लिए ग्राहकों की प्रोफाइल में जनसांख्यिकीय डेटा। आमतौर पर अतिरिक्त ट्रांसफॉर्मेशन भी किए जाते हैं ताकि डेटा लक्ष्य सिस्टम की आवश्यकताओं से मेल खाए, जैसे डेटा टाइप्स को बदलना या तारीख़ के फॉर्मैट्स को संभालना।
3. डेटा लोडिंग
अंत में, बदला हुआ डेटा लक्ष्य सिस्टम में उसकी API के माध्यम से या तो रियल-टाइम में या बैच अपडेट्स के रूप में लोड किया जाता है। एरर-हैंडलिंग तंत्र, जिनमें रिट्राई लॉजिक और रिकवरी प्रक्रियाएँ शामिल हैं, लोडिंग के दौरान समस्याओं को रोकते हैं। लोडिंग के बाद डेटा की अखंडता को सत्यापित करने की एक प्रक्रिया होगी।
Reverse ETL का बुनियादी चित्रण। स्रोत: napkin.ai
वास्तविक-जीवन उदाहरण
उदाहरण के लिए, किसी मार्केटिंग टीम को लें जो ग्राहक व्यवहार का विश्लेषण करने के लिए डेटा वेयरहाउस का उपयोग करती है। Reverse ETL खरीद इतिहास और जनसांख्यिकी के आधार पर ग्राहक सेगमेंट्स निकाल सकता है और इस डेटा को किसी मार्केटिंग ऑटोमेशन प्लेटफ़ॉर्म में लोड कर सकता है। इससे टीम लक्षित कैंपेन बना सकती है और ग्राहकों के साथ इंटरैक्शन को व्यक्तिगत बना सकती है।
Reverse ETL प्रक्रिया। स्रोत: napkin.ai
Reverse ETL में तकनीकी चुनौतियाँ और समाधान
उम्मीदें तो बड़ी हैं, पर reverse ETL पूर्ण नहीं है। डेटा इंजीनियरों के लिए सुनिश्चित करना कि सारा डेटा सटीक हो और विभिन्न और कभी-कभी अपरिचित सिस्टम्स के बीच रास्ता बनाना चुनौतीपूर्ण हो सकता है। सबसे बड़ी चुनौतियों में से एक डेटा गुणवत्ता बनाए रखना है। असंगत डेटा गलत निर्णयों की ओर ले जा सकता है, इसलिए कठोर डेटा वैलिडेशन और क्लीनिंग प्रक्रियाएँ महत्वपूर्ण हैं।
डेटा की मात्रा और गति भी भारी पड़ सकती है। बड़े डेटासेट्स को कुशलता से संभालने के लिए इंक्रीमेंटल अपडेट्स और चेंज डेटा कैप्चर जैसी रणनीतियाँ चाहिए। ये तकनीकें केवल आवश्यक डेटा को प्रोसेस करने पर ध्यान देती हैं, प्रदर्शन को अनुकूलित करती हैं, और सिस्टम लोड को कम करती हैं। एक और बाधा API की जटिलता है। अलग-अलग सिस्टम्स की API क्षमताएँ भिन्न होती हैं। प्रभावी API प्रबंधन और मानकीकरण मददगार हो सकते हैं।
ETL बनाम Reverse ETL: बड़े अंतर
ETL एक पारंपरिक डेटा इंटीग्रेशन दृष्टिकोण है जिसमें डेटा विभिन्न स्रोतों से निकाला जाता है, उपयुक्त फॉर्मेट में बदला जाता है, और फिर डेटा वेयरहाउस में लोड किया जाता है। इस प्रक्रिया में शुरू से ही व्यापक डेटा क्लीनिंग और ट्रांसफॉर्मेशन शामिल होता है, जिससे यह संसाधन-गहन और समय लेने वाली बन जाती है।
दूसरी ओर, ELT गति और लचीलापन को प्राथमिकता देता है। डेटा स्रोतों से निकालकर सीधे अपने कच्चे रूप में डेटा वेयरहाउस में लोड किया जाता है। ट्रांसफॉर्मेशन डेटा वेयरहाउस के भीतर, अक्सर शक्तिशाली क्वेरी इंजनों का उपयोग करके किए जाते हैं। यह दृष्टिकोण आधुनिक डेटा वेयरहाउस की कम्प्यूटिंग क्षमता का लाभ उठाता है और डेटा एक्सप्लोरेशन और विश्लेषण में अधिक फुर्ती प्रदान करता है।
Reverse ETL का उभार
जहाँ ETL और ELT का ध्यान डेटा को डेटा वेयरहाउस में ले जाने पर है, reverse ETL एक अलग राह लेता है। यह डेटा वेयरहाउस से बदला हुआ डेटा निकालकर उसे ऑपरेशनल सिस्टम्स—जैसे CRM, मार्केटिंग ऑटोमेशन प्लेटफॉर्म्स, और कस्टमर सपोर्ट टूल्स—तक पहुँचाता है। इससे संगठन डेटा विश्लेषण से निकले इनसाइट्स का उपयोग रियल-टाइम कार्रवाइयों के लिए कर सकते हैं और व्यावसायिक प्रक्रियाओं में सुधार ला सकते हैं। ETL से ELT की ओर बदलाव मुख्यतः निम्न कारकों से प्रेरित रहा है:
मूल रूप से, डेटा मैनेजमेंट का विकास अधिक दक्षता, लचीलापन, और कार्रवाई योग्य इनसाइट्स की ओर एक यात्रा रहा है। ETL ने नींव रखी, ELT ने डेटा इनजेशन और ट्रांसफॉर्मेशन को तेज़ किया, और reverse ETL ने इनसाइट्स को ऑपरेशनल वर्कफ़्लोज़ में वापस लाकर इस चक्र को पूरा किया।
ETL और ELT के बीच मुख्य अंतर
ETL और ELT दोनों ही तरीक़े हैं जो डेटा को एक सिस्टम से दूसरे सिस्टम में ले जाते हैं। सुनने में समान लगने पर भी, इनमें महत्वपूर्ण अंतर है कि यह डेटा ट्रांसफॉर्मेशन को कैसे संभालते हैं। यहाँ एक झलक दी गई है; विस्तृत विश्लेषण के लिए हमारा ETL vs. ELT ब्लॉग पोस्ट पढ़ें।
Reverse ETL के वास्तविक उपयोग
Reverse ETL एक शक्तिशाली साधन है जो डेटा इनसाइट्स और ऑपरेशनल निष्पादन के बीच की खाई को पाटता है। अपने डेटा वेयरहाउस से मूल्यवान डेटा को ऑपरेशनल सिस्टम्स में स्थानांतरित करके आप संभावनाओं की दुनिया खोल सकते हैं।
रणनीतिक महत्व: Reverse ETL क्यों मायने रखता है
Reverse ETL सिर्फ़ डेटा ट्रांसफर टूल से भी बढ़कर है। यह एक रणनीतिक संपत्ति है जो आपके व्यवसाय को आगे बढ़ा सकती है। यहाँ कुछ महत्वपूर्ण विचार हैं जो मुझे सबसे अहम लगते हैं।
यदि आप उद्योग विशेषज्ञों से अतिरिक्त जानकारी चाहते हैं, तो Away की Director of Data Engineering, Liya Aizenberg बताती हैं कि डेटा इंजीनियरिंग पहलों को व्यावसायिक लक्ष्यों के साथ सबसे बेहतर ढंग से कैसे संरेखित किया जाए।
टूल्स और प्लेटफ़ॉर्म/लोकप्रिय Reverse ETL टूल्स
Reverse ETL को लागू करने के लिए कई टूल्स और प्लेटफ़ॉर्म उपलब्ध हैं, जिनमें प्रत्येक की अपनी विशेष खूबियाँ और क्षमताएँ हैं। निम्न तालिका कुछ लोकप्रिय विकल्प दिखाती है:
Reverse ETL टूल चुनते समय निम्नलिखित कारकों पर विचार करें:
इन कारकों और आपके संगठन की विशिष्ट ज़रूरतों का सावधानीपूर्वक मूल्यांकन करके, आप सबसे उपयुक्त reverse ETL टूल चुन सकते हैं और अपने डेटा की पूरी क्षमता को खोल सकते हैं।
निष्कर्ष
आशा है कि आप reverse ETL के महत्व को देख और सराह पाएँगे। यह केवल एक तकनीकी प्रक्रिया नहीं है। जिन कंपनियों के पास सही संसाधन हैं—जिनमें reverse ETL में अनुभवी डेटा इंजीनियर शामिल हैं—वे जड़ सोच से निकलकर गतिशील बन सकती हैं, रियल-टाइम डेटा का उपयोग करके विकास कर सकती हैं, बिक्री बढ़ा सकती हैं, और बाज़ार में बदलावों पर तेजी से प्रतिक्रिया दे सकती हैं।
यदि आप डेटा इंजीनियरिंग को लेकर गंभीर हैं, तो हमारा व्यापक Data Engineer in Python करियर ट्रैक जॉइन करें, जो Python की भूमिका पर केंद्रित है, जो डेटा प्रक्रियाओं को स्वचालित और अनुकूलित करता है। यदि आपको पहले SQL में अधिक अनुभव की आवश्यकता लगती है, तो पहले हमारा Associate Data Engineer in SQL करियर ट्रैक आज़माएँ, जो ETL और ELT प्रक्रियाओं की विस्तार से पड़ताल करता है और उनके PostgreSQL से संबंध को भी समझाता है।