
Khóa học
ETL và ELT với Python
4 giờ
40.5K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleTruyền thống, kỹ sư dữ liệu tập trung vào các thao tác ETL (trích xuất, biến đổi, nạp), tức là trích xuất dữ liệu từ nhiều nguồn, chuyển đổi về định dạng phù hợp và nạp vào kho dữ liệu. Tuy nhiên, nhu cầu đưa dữ liệu này vào vận hành—để dữ liệu có thể truy cập và hữu ích cho các ứng dụng kinh doanh phổ biến—đã dẫn đến sự ra đời của reverse ETL.
Trong bài viết này, chúng ta sẽ tìm hiểu định nghĩa reverse ETL, cách nó khác với ETL truyền thống và các công cụ có thể dùng để triển khai. Chúng ta cũng sẽ xem xét các trường hợp sử dụng thực tiễn để thấy tầm quan trọng của nó. Nếu bạn mới tìm hiểu chủ đề này, hãy xem khóa học ETL và ELT bằng Python và khóa học Giới thiệu về Kỹ thuật Dữ liệu trên DataCamp để bắt đầu. Ngoài ra, code-along Bắt đầu với Data Pipelines cũng là một tài nguyên rất hữu ích.
Reverse ETL là quy trình trích xuất dữ liệu từ kho dữ liệu, biến đổi để phù hợp với yêu cầu của các hệ thống vận hành, rồi nạp vào những hệ thống đó. Cách tiếp cận này đối lập với ETL truyền thống, nơi dữ liệu được trích xuất từ các hệ thống vận hành, biến đổi và nạp vào kho dữ liệu.
Trong lịch sử, quản trị dữ liệu đã tiến hóa từ ETL sang ELT (extract, load, transform) để đáp ứng nhu cầu xử lý dữ liệu theo thời gian thực ngày càng cao. Reverse ETL đại diện cho bước tiến mới nhất trong quá trình này. Nếu ETL và ELT tập trung vào việc tập trung hóa dữ liệu, thì Reverse ETL hướng tới đưa dữ liệu vào vận hành bằng cách khiến dữ liệu có thể hành động được trong các hệ thống bên thứ ba như CRM, nền tảng tiếp thị và các công cụ vận hành khác.
Chúng ta đã nói reverse ETL là một quy trình tích hợp dữ liệu đưa các insight từ kho dữ liệu hoặc nền tảng phân tích vào các hệ thống vận hành. Nói cách khác, nó đảo ngược quy trình ETL truyền thống. Hãy xem chi tiết từng bước.
Quy trình bắt đầu bằng việc chọn ra thông tin liên quan nhất từ kho dữ liệu hoặc nền tảng phân tích. Điều này có thể bao gồm dữ liệu khách hàng, chỉ số bán hàng, hoặc dữ liệu khác. Sau khi biết cần gì từ nơi lưu trữ, bạn có thể vẫn cần lọc, tổng hợp, hoặc biến đổi dữ liệu theo một cách nào đó để đáp ứng nhu cầu.
Tiếp theo, dữ liệu từ hệ thống nguồn được ánh xạ sang các trường tương ứng trong hệ thống đích. Có thể thực hiện bước làm giàu dữ liệu tùy chọn bằng cách thêm trường từ nguồn bên ngoài, ví dụ thêm dữ liệu nhân khẩu học vào hồ sơ khách hàng. Nhiều khả năng sẽ có thêm biến đổi để dữ liệu khớp với yêu cầu của hệ thống đích, như chuyển đổi kiểu dữ liệu hoặc xử lý định dạng ngày tháng.
Cuối cùng, dữ liệu đã biến đổi được nạp vào hệ thống đích bằng API của hệ thống, dưới dạng cập nhật theo thời gian thực hoặc theo lô. Các cơ chế xử lý lỗi, bao gồm logic thử lại và thủ tục khôi phục, giúp ngăn sự cố khi nạp. Sẽ có một quy trình xác minh tính toàn vẹn của dữ liệu sau khi nạp.
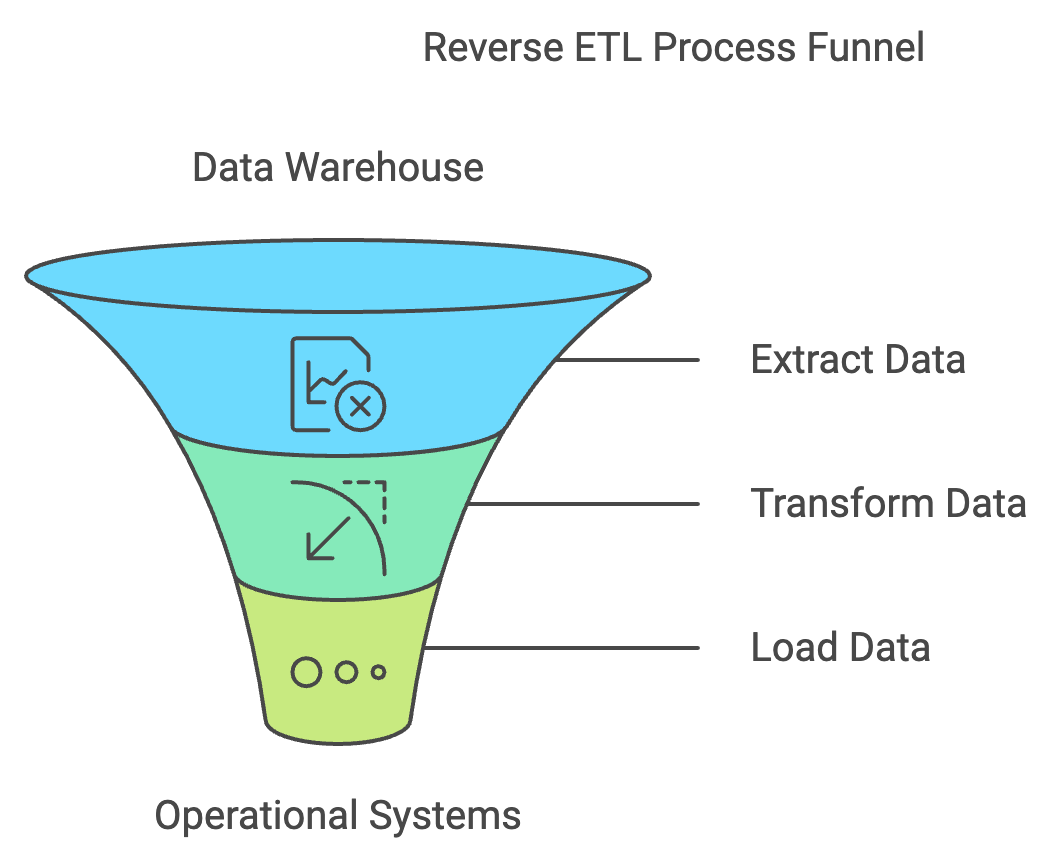
Minh họa cơ bản về reverse ETL. Nguồn: napkin.ai
Chẳng hạn, một nhóm tiếp thị sử dụng kho dữ liệu để phân tích hành vi khách hàng. Reverse ETL có thể trích xuất các phân khúc khách hàng dựa trên lịch sử mua hàng và nhân khẩu học, rồi nạp dữ liệu này vào nền tảng tự động hóa tiếp thị. Điều đó cho phép họ tạo các chiến dịch nhắm mục tiêu và cá nhân hóa tương tác với khách hàng.
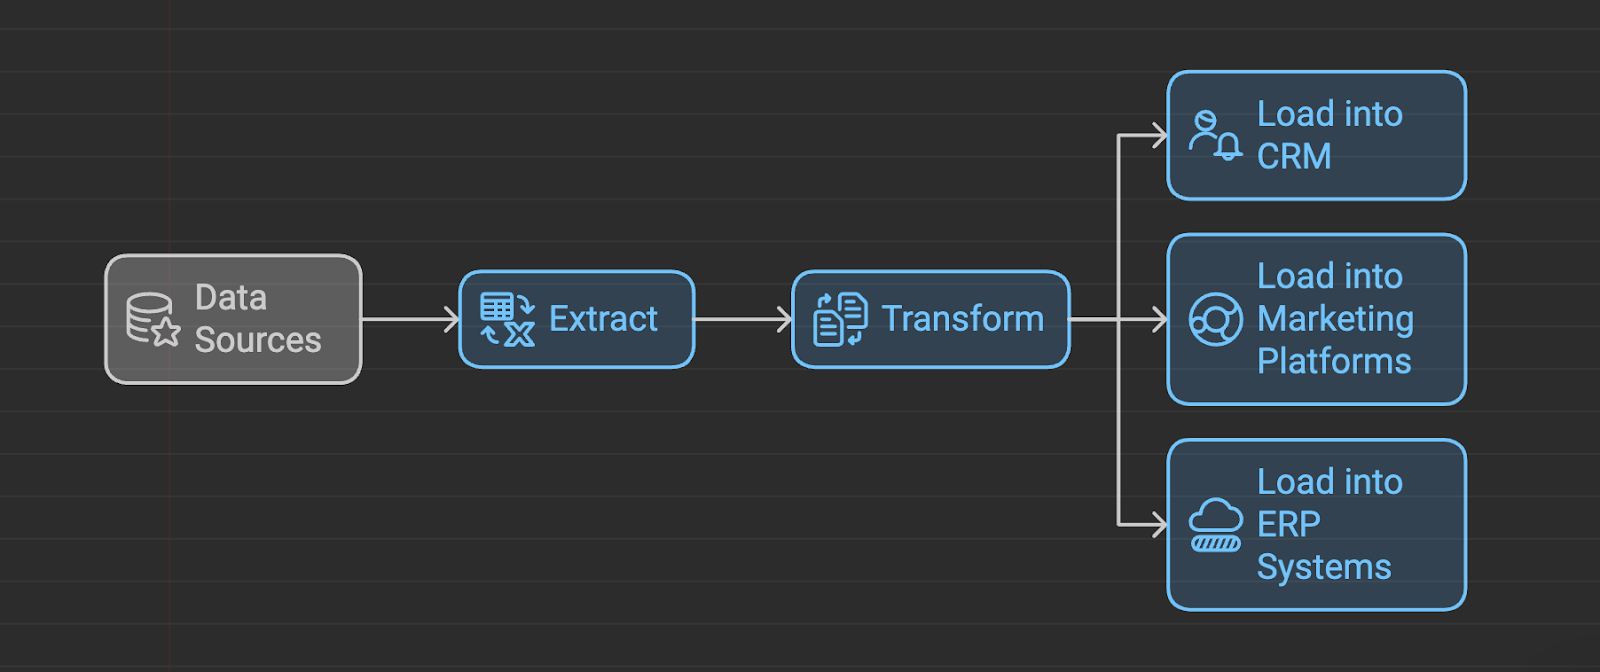
Quy trình Reverse ETL. Nguồn: napkin.ai
Dù hứa hẹn, reverse ETL không phải hoàn hảo. Thách thức đối với kỹ sư dữ liệu là đảm bảo tất cả dữ liệu đều chính xác và xoay xở giữa các hệ thống khác nhau và đôi khi còn xa lạ. Một trong những thách thức lớn nhất là duy trì chất lượng dữ liệu. Dữ liệu không nhất quán có thể dẫn đến quyết định sai, vì vậy các quy trình kiểm định và làm sạch dữ liệu nghiêm ngặt là quan trọng.
Khối lượng và tốc độ dữ liệu cũng có thể gây quá tải. Xử lý hiệu quả tập dữ liệu lớn đòi hỏi các chiến lược như cập nhật gia tăng và ghi nhận thay đổi dữ liệu (CDC). Những kỹ thuật này tập trung chỉ xử lý dữ liệu cần thiết, tối ưu hiệu năng và giảm tải hệ thống. Một rào cản khác là độ phức tạp của API. Mỗi hệ thống có khả năng API khác nhau. Quản lý API hiệu quả và tiêu chuẩn hóa có thể giúp ích.
ETL là cách tiếp cận tích hợp dữ liệu truyền thống, nơi dữ liệu được trích xuất từ nhiều nguồn, biến đổi sang định dạng phù hợp, rồi nạp vào kho dữ liệu. Quy trình này đòi hỏi làm sạch và biến đổi dữ liệu đáng kể từ đầu, nên tốn nhiều tài nguyên và thời gian.
Ngược lại, ELT ưu tiên tốc độ và linh hoạt. Dữ liệu được trích xuất từ các nguồn và nạp trực tiếp vào kho dữ liệu ở dạng thô. Việc biến đổi diễn ra trong kho dữ liệu, thường dùng các engine truy vấn mạnh. Cách tiếp cận này tận dụng sức mạnh tính toán của các kho dữ liệu hiện đại và cung cấp sự linh hoạt cao hơn trong khám phá và phân tích dữ liệu.
Trong khi ETL và ELT tập trung đưa dữ liệu vào kho dữ liệu, reverse ETL đi theo hướng khác. Nó trích xuất dữ liệu đã biến đổi từ kho dữ liệu và gửi tới các hệ thống vận hành như CRM, nền tảng tự động hóa tiếp thị và công cụ hỗ trợ khách hàng. Điều này cho phép tổ chức tận dụng insight rút ra từ phân tích dữ liệu để thúc đẩy hành động thời gian thực và cải thiện quy trình kinh doanh. Sự chuyển dịch từ ETL sang ELT chủ yếu được thúc đẩy bởi các yếu tố sau:
Tóm lại, tiến hóa của quản trị dữ liệu là hành trình hướng tới hiệu quả, linh hoạt và insight có thể hành động. ETL đặt nền móng, ELT tăng tốc nạp và biến đổi dữ liệu, và reverse ETL khép vòng bằng cách đưa insight vào quy trình vận hành.
ETL và ELT đều là phương thức di chuyển dữ liệu giữa các hệ thống. Dù nghe có vẻ giống nhau, chúng khác nhau căn bản ở cách xử lý biến đổi dữ liệu. Dưới đây là ảnh chụp nhanh; để xem phân tích chi tiết, hãy đọc bài ETL vs. ELT của chúng tôi.
| Tính năng | ETL | ELT |
|---|---|---|
| Biến đổi dữ liệu | Trước khi nạp | Sau khi nạp |
| Chất lượng dữ liệu | Nhấn mạnh mạnh mẽ vào làm sạch dữ liệu | Ít nhấn mạnh khâu làm sạch ban đầu |
| Thời gian xử lý | Lâu hơn do biến đổi | Nhanh hơn nhờ xử lý song song |
| Khối lượng dữ liệu | Phù hợp hơn với bộ dữ liệu nhỏ | Xử lý hiệu quả bộ dữ liệu lớn |
| Tính linh hoạt | Kém linh hoạt hơn | Linh hoạt hơn nhờ dữ liệu thô sẵn có |
Reverse ETL là công cụ mạnh mẽ bắc cầu giữa insight dữ liệu và vận hành thực thi. Bằng cách chuyển dữ liệu giá trị từ kho dữ liệu sang các hệ thống vận hành, bạn có thể mở khóa vô vàn khả năng.
Reverse ETL còn hơn cả công cụ truyền dữ liệu. Đây là tài sản chiến lược có thể đưa doanh nghiệp bạn tiến lên. Dưới đây là một số ý quan trọng nhất theo tôi.
Nếu bạn muốn có thêm góc nhìn từ các lãnh đạo trong ngành, Liya Aizenberg, Giám đốc Kỹ thuật Dữ liệu tại Away, chia sẻ nhiều insight hay về cách căn chỉnh tốt nhất các sáng kiến kỹ thuật dữ liệu với mục tiêu kinh doanh.
Có nhiều công cụ và nền tảng để triển khai reverse ETL, mỗi loại có tính năng và năng lực riêng. Bảng sau liệt kê một số lựa chọn phổ biến:
Khi chọn công cụ reverse ETL, hãy cân nhắc các yếu tố sau:
Bằng cách đánh giá cẩn thận các yếu tố này và nhu cầu cụ thể của tổ chức, bạn có thể chọn công cụ reverse ETL phù hợp nhất để khai mở toàn bộ tiềm năng dữ liệu.
Hy vọng bạn có thể thấy và trân trọng tầm quan trọng của reverse ETL. Nó hơn hẳn một thủ tục kỹ thuật. Các công ty có nguồn lực phù hợp, bao gồm kỹ sư dữ liệu có kinh nghiệm về reverse ETL, có thể chuyển mình từ cứng nhắc thành năng động, sử dụng dữ liệu thời gian thực để tăng trưởng, tăng doanh số và phản ứng nhanh với biến động thị trường.
Nếu bạn nghiêm túc với kỹ thuật dữ liệu, hãy đăng ký lộ trình nghề nghiệp toàn diện Data Engineer in Python của chúng tôi, tập trung vào vai trò của Python trong tự động hóa và tối ưu hóa quy trình dữ liệu. Nếu bạn cảm thấy cần thêm kinh nghiệm SQL trước, hãy thử lộ trình Associate Data Engineer in SQL trước, đi sâu vào cả ETL và ELT, cùng mối liên hệ của chúng với PostgreSQL.
Học cùng DataCamp
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
