
Corso
ETL and ELT in Python
4 ore
40.5K
Pratica and corso your progress.
Continua Con GoogleTradizionalmente, i data engineer si sono concentrati sulle operazioni ETL (extract, transform, load), che prevedono l'estrazione dei dati da più fonti, la loro conversione in un formato appropriato e il caricamento in un data warehouse. Tuttavia, l'esigenza di operazionalizzare questi dati—renderli accessibili e utili per le applicazioni aziendali comuni—ha portato allo sviluppo del reverse ETL.
In questo articolo esploreremo la definizione di reverse ETL, in cosa differisce dall'ETL tradizionale e gli strumenti disponibili per implementarlo. Esamineremo anche casi d'uso pratici per mostrarne l'importanza. Se sei nuovo all'argomento, dai un'occhiata al nostro corso ETL and ELT in Python e al corso Introduction to Data Engineering su DataCamp per iniziare. Anche il nostro code-along Getting Started with Data Pipelines è una risorsa molto utile.
Il Reverse ETL è il processo di estrazione dei dati da un data warehouse, la loro trasformazione per adattarli ai requisiti dei sistemi operativi e il successivo caricamento in tali sistemi. Questo approccio contrasta con l'ETL tradizionale, in cui i dati vengono estratti dai sistemi operativi, trasformati e caricati in un data warehouse.
Storicamente, la gestione dei dati è passata da ETL a ELT (extract, load, transform) per rispondere alla crescente necessità di elaborazione in tempo reale. Il Reverse ETL rappresenta l'ultimo passo di questa evoluzione. Mentre ETL ed ELT si concentrano sulla centralizzazione dei dati, il Reverse ETL punta a operazionalizzarli, rendendoli azionabili all'interno di sistemi di terze parti come CRM, piattaforme di marketing e altri strumenti operativi.
Abbiamo detto che il reverse ETL è un processo di integrazione dei dati che sposta gli insight da un data warehouse o da una piattaforma di analytics verso i sistemi operativi. In altre parole, inverte il processo ETL tradizionale. Vediamo ora più da vicino ciascun passaggio.
Il processo inizia selezionando le informazioni più rilevanti da un data warehouse o da una piattaforma di analytics. Questo può includere dati dei clienti, metriche di vendita o altro. Una volta stabilito cosa vogliamo dall'archivio, potremmo comunque dover filtrare, aggregare o in qualche modo trasformare i dati per soddisfare le nostre esigenze.
Come passo successivo, i dati dal sistema sorgente vengono mappati ai campi corrispondenti nel sistema di destinazione. In questa fase è possibile effettuare un arricchimento opzionale dei dati aggiungendo campi da fonti esterne, ad esempio inserendo dati demografici nei profili cliente. Probabilmente avverranno ulteriori trasformazioni affinché i dati rispettino i requisiti del sistema di destinazione, come la conversione dei tipi di dato o la gestione dei formati delle date.
Infine, i dati trasformati vengono caricati nel sistema di destinazione usando la sua API, con aggiornamenti in tempo reale o in batch. Meccanismi di gestione degli errori, tra cui logica di retry e procedure di ripristino, evitano problemi durante il caricamento. Sarà presente un processo che verifica l'integrità dei dati al momento del caricamento.
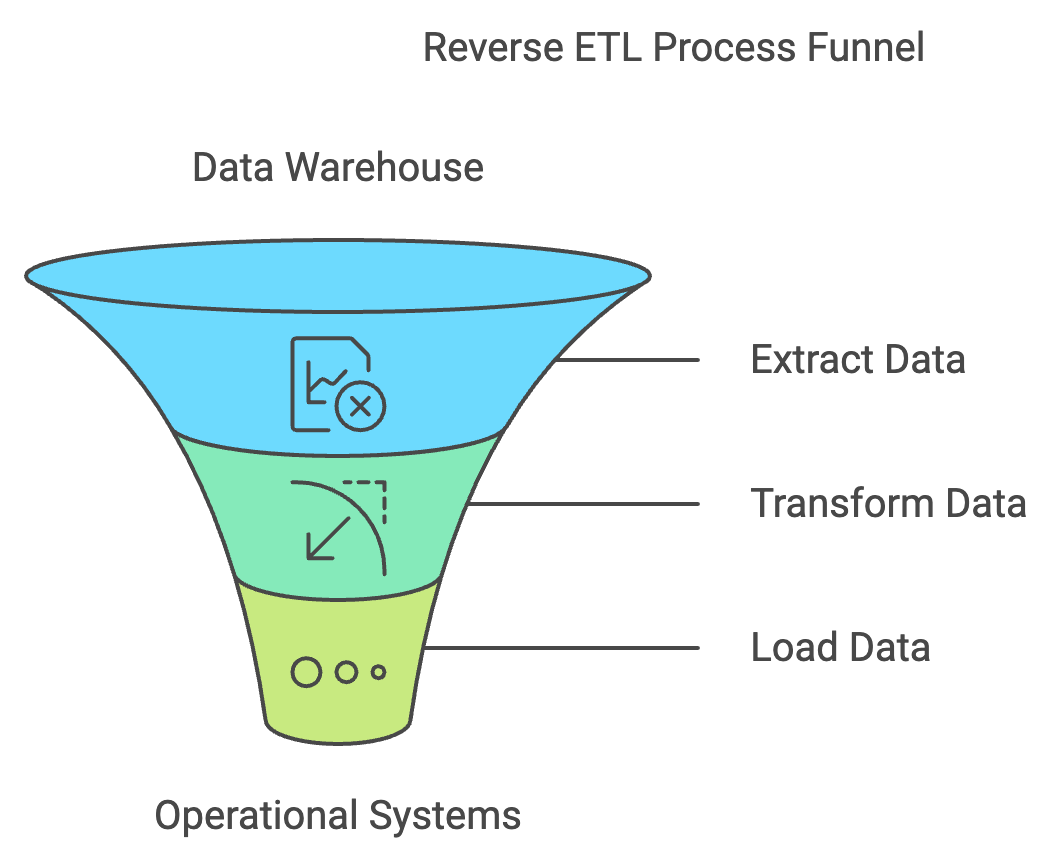
Illustrazione di base del reverse ETL. Fonte: napkin.ai
Per illustrare, considera un team marketing che usa un data warehouse per analizzare il comportamento dei clienti. Il Reverse ETL può estrarre segmenti di clientela basati sulla cronologia degli acquisti e sui dati demografici e caricare queste informazioni in una piattaforma di marketing automation. Questo consente al team di creare campagne mirate e personalizzare le interazioni con i clienti.
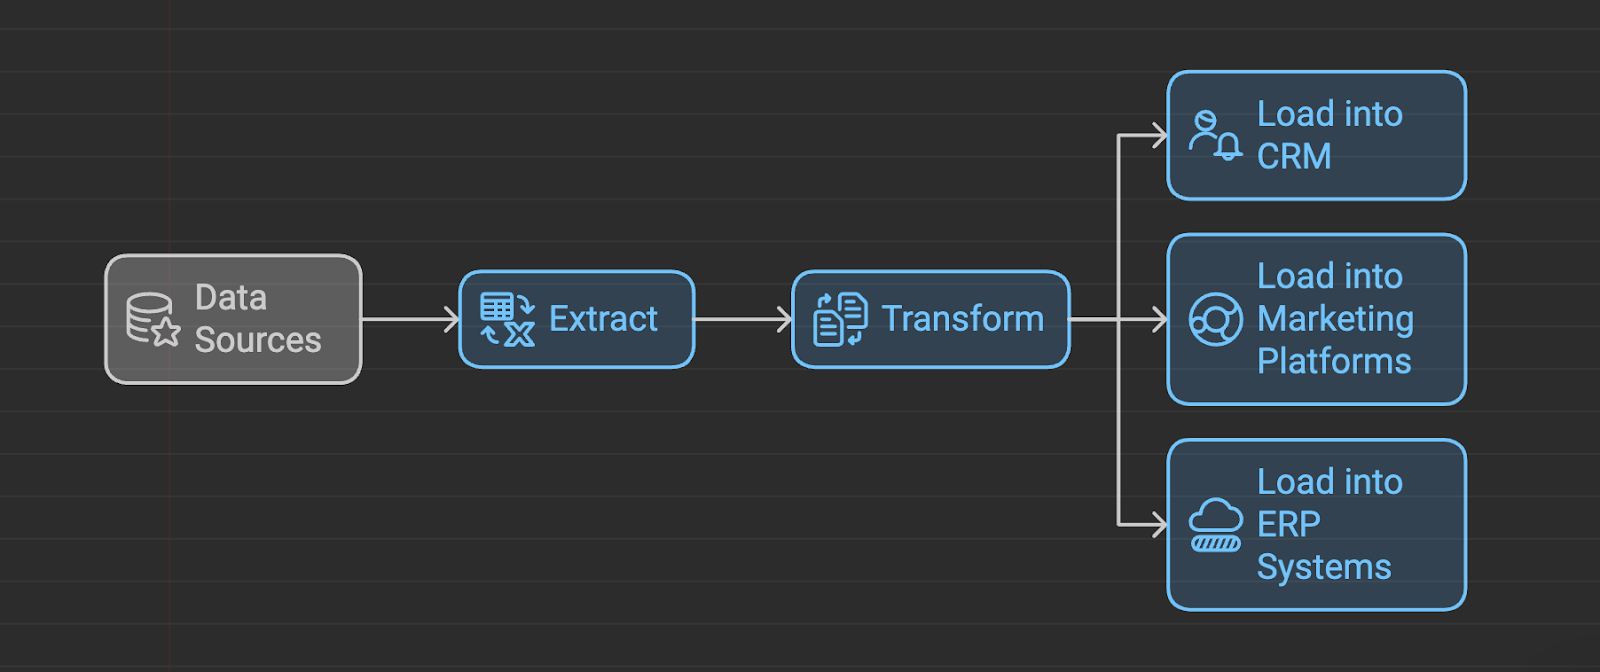
Processo di Reverse ETL. Fonte: napkin.ai
Per quanto promettente, il reverse ETL non è perfetto. Può essere difficile per i data engineer assicurarsi che tutti i dati siano accurati e orientarsi tra sistemi diversi e talvolta poco familiari. Una delle sfide maggiori è mantenere la qualità dei dati. Dati incoerenti possono portare a decisioni sbagliate, quindi sono importanti rigorosi processi di validazione e pulizia.
Anche volume e velocità dei dati possono essere opprimenti. Gestire in modo efficiente dataset di grandi dimensioni richiede strategie come aggiornamenti incrementali e change data capture. Queste tecniche si concentrano sull'elaborazione dei soli dati necessari, ottimizzando le prestazioni e riducendo il carico di sistema. Un altro ostacolo è la complessità delle API. I diversi sistemi hanno capacità API variabili. Una gestione e una standardizzazione efficaci delle API possono aiutare.
L'ETL è un approccio tradizionale all'integrazione dei dati in cui i dati vengono estratti da varie fonti, trasformati in un formato idoneo e poi caricati in un data warehouse. Questo processo comporta una significativa pulizia e trasformazione a monte, rendendolo intensivo in termini di risorse e dispendioso in tempo.
L'ELT, invece, privilegia velocità e flessibilità. I dati vengono estratti dalle fonti e caricati direttamente nel data warehouse nel loro formato grezzo. Le trasformazioni avvengono all'interno del data warehouse, spesso usando potenti motori di query. Questo approccio sfrutta la potenza computazionale dei moderni data warehouse e offre maggiore agilità nell'esplorazione e nell'analisi dei dati.
Mentre ETL ed ELT si concentrano sul trasferimento dei dati in un data warehouse, il reverse ETL adotta un approccio diverso. Estrae i dati trasformati dal data warehouse e li invia ai sistemi operativi, come CRM, piattaforme di marketing automation e strumenti di supporto clienti. Questo consente alle organizzazioni di sfruttare gli insight derivati dall'analisi dei dati per guidare azioni in tempo reale e migliorare i processi aziendali. Il passaggio da ETL a ELT è guidato principalmente dai seguenti fattori:
In sostanza, l'evoluzione della gestione dei dati è stata un percorso verso maggiore efficienza, flessibilità e insight azionabili. L'ETL ha posto le basi, l'ELT ha accelerato ingestione e trasformazione, e il reverse ETL ha chiuso il cerchio portando gli insight nei flussi di lavoro operativi.
ETL ed ELT sono entrambi metodi per spostare dati da un sistema a un altro. Pur sembrando simili, presentano differenze critiche nel modo in cui gestiscono la trasformazione dei dati. Ecco un'istantanea; per un'analisi davvero dettagliata, leggi il nostro post sul blog ETL vs. ELT.
| Caratteristica | ETL | ELT |
|---|---|---|
| Trasformazione dei dati | Prima del caricamento | Dopo il caricamento |
| Qualità dei dati | Forte enfasi sulla pulizia dei dati | Minore enfasi sulla pulizia a monte |
| Tempi di elaborazione | Più lunghi a causa della trasformazione | Più rapidi grazie all'elaborazione parallela |
| Volume dei dati | Più adatto a dataset più piccoli | Gestisce in modo efficiente dataset di grandi dimensioni |
| Flessibilità | Minore flessibilità | Maggiore flessibilità grazie ai dati grezzi disponibili |
Il Reverse ETL è uno strumento potente che colma il divario tra insight sui dati ed esecuzione operativa. Trasferendo dati di valore dal tuo data warehouse ai sistemi operativi, puoi sbloccare un mondo di possibilità.
Il Reverse ETL è più di un semplice strumento di trasferimento dati. È un asset strategico che può spingere il tuo business in avanti. Ecco alcune delle idee che ritengo più importanti.
Se cerchi ulteriori spunti da leader del settore, Liya Aizenberg, Director of Data Engineering presso Away, condivide ottime indicazioni su come allineare al meglio le iniziative di data engineering agli obiettivi di business.
Sono disponibili diversi strumenti e piattaforme per implementare il reverse ETL, ciascuno con caratteristiche e funzionalità uniche. La seguente tabella mostra alcune opzioni popolari:
Quando scegli uno strumento di reverse ETL, considera i seguenti fattori:
Valutando attentamente questi fattori e le esigenze specifiche della tua organizzazione, potrai selezionare lo strumento di reverse ETL più adatto per sbloccare tutto il potenziale dei tuoi dati.
Spero che tu possa vedere e apprezzare l'importanza del reverse ETL. È molto più di una semplice procedura tecnica. Le aziende che hanno le risorse giuste, compresi data engineer esperti di reverse ETL, possono trasformarsi da realtà ingessate in organizzazioni dinamiche che usano dati in tempo reale per crescere, aumentare le vendite e rispondere rapidamente ai cambiamenti del mercato.
Se fai sul serio con il data engineering, iscriviti al nostro percorso professionale completo Data Engineer in Python, che si concentra sul ruolo di Python nell'automatizzare e ottimizzare i processi sui dati. Se pensi di aver bisogno prima di più esperienza con SQL, prova il nostro percorso professionale Associate Data Engineer in SQL, che esplora in dettaglio sia i processi ETL sia quelli ELT, oltre alla loro relazione con PostgreSQL.
Impara con DataCamp
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



