Cours
ETL et ELT en Python
4 h
39.5K
Traditionnellement, les data engineers se concentraient sur les opérations ETL (extract, transform, load) : extraire des données de multiples sources, les convertir dans un format adapté, puis les charger dans un entrepôt de données. Cependant, la nécessité d'opérationnaliser ces données — les rendre accessibles et utiles aux applications métier courantes — a conduit à l'émergence du reverse ETL.
Dans cet article, nous verrons ce qu'est le reverse ETL, en quoi il diffère de l'ETL classique et quels outils permettent de le mettre en œuvre. Nous passerons aussi en revue des cas d'usage concrets pour illustrer son importance. Si vous débutez sur le sujet, découvrez nos cours ETL and ELT in Python et Introduction to Data Engineering sur DataCamp pour vous lancer. Notre code-along Getting Started with Data Pipelines est une autre ressource très utile.
Le reverse ETL consiste à extraire des données d'un entrepôt de données, à les transformer pour répondre aux exigences des systèmes opérationnels, puis à les y charger. Cette approche contraste avec l'ETL traditionnel, où l'on extrait les données des systèmes opérationnels, on les transforme, puis on les charge dans un entrepôt.
Historiquement, la gestion des données a évolué de l'ETL vers l'ELT (extract, load, transform) pour répondre au besoin croissant de traitement en temps réel. Le reverse ETL représente la dernière étape de cette évolution. Tandis que l'ETL et l'ELT visent à centraliser les données, le reverse ETL a pour objectif de les opérationnaliser en les rendant actionnables au sein de systèmes tiers tels que les CRM, les plateformes marketing et autres outils opérationnels.
Nous avons dit que le reverse ETL est un processus d'intégration des données qui déplace des insights depuis un entrepôt ou une plateforme analytique vers des systèmes opérationnels. Autrement dit, il inverse le processus ETL traditionnel. Examinons maintenant chaque étape de plus près.
Le processus commence par la sélection des informations les plus pertinentes depuis un entrepôt de données ou une plateforme analytique. Il peut s'agir de données clients, d'indicateurs de ventes, ou d'autres éléments. Une fois le besoin défini, il est souvent nécessaire de filtrer, d'agréger ou de transformer les données pour répondre aux objectifs.
Ensuite, les données issues de la source sont mappées vers les champs correspondants du système cible. Un enrichissement optionnel peut être réalisé à ce stade en ajoutant des champs provenant de sources externes, par exemple des données démographiques dans les profils clients. D'autres transformations sont généralement nécessaires pour respecter les exigences du système cible, comme la conversion de types de données ou le traitement des formats de date.
Enfin, les données transformées sont chargées dans le système cible via son API, en mise à jour temps réel ou par lots. Des mécanismes de gestion des erreurs, incluant des stratégies de retry et des procédures de reprise, limitent les incidents lors du chargement. Un processus de vérification assure l'intégrité des données une fois chargées.
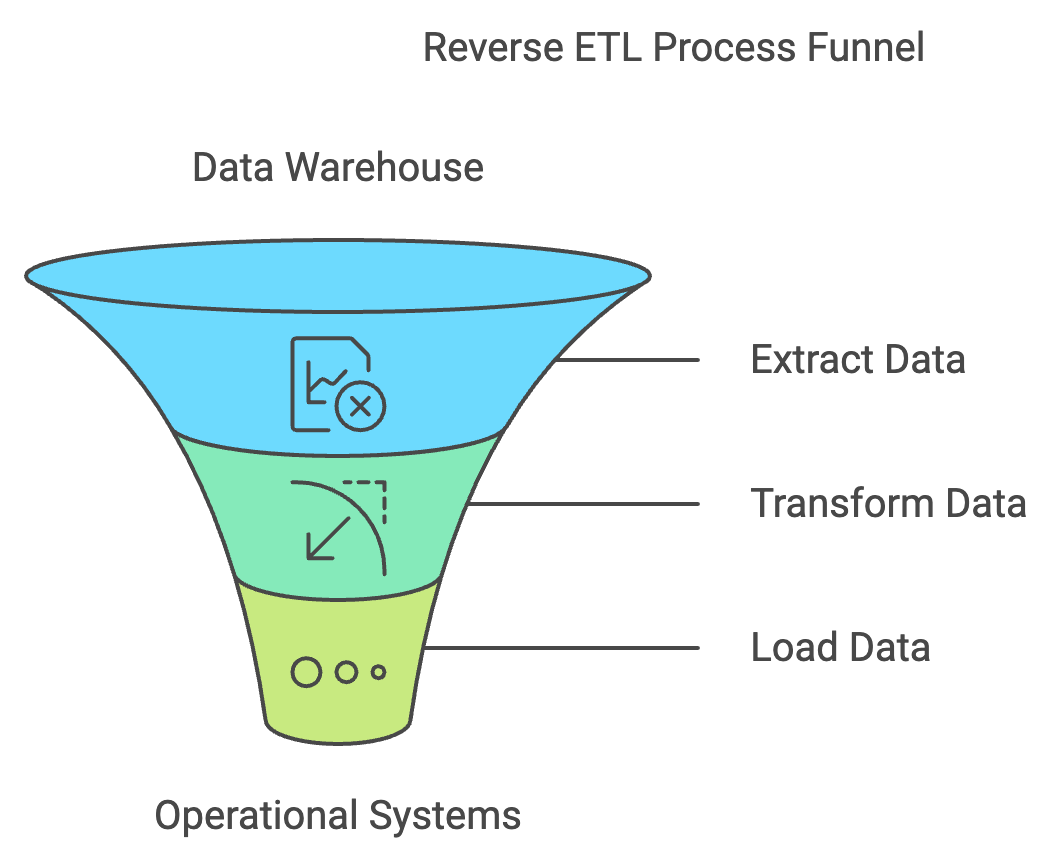
Illustration simple du reverse ETL. Source : napkin.ai
Prenons une équipe marketing qui analyse le comportement client dans un entrepôt de données. Le reverse ETL peut extraire des segments clients basés sur l'historique d'achats et des données démographiques, puis charger ces segments dans une plateforme d'automatisation marketing. L'équipe peut ainsi créer des campagnes ciblées et personnaliser les interactions.
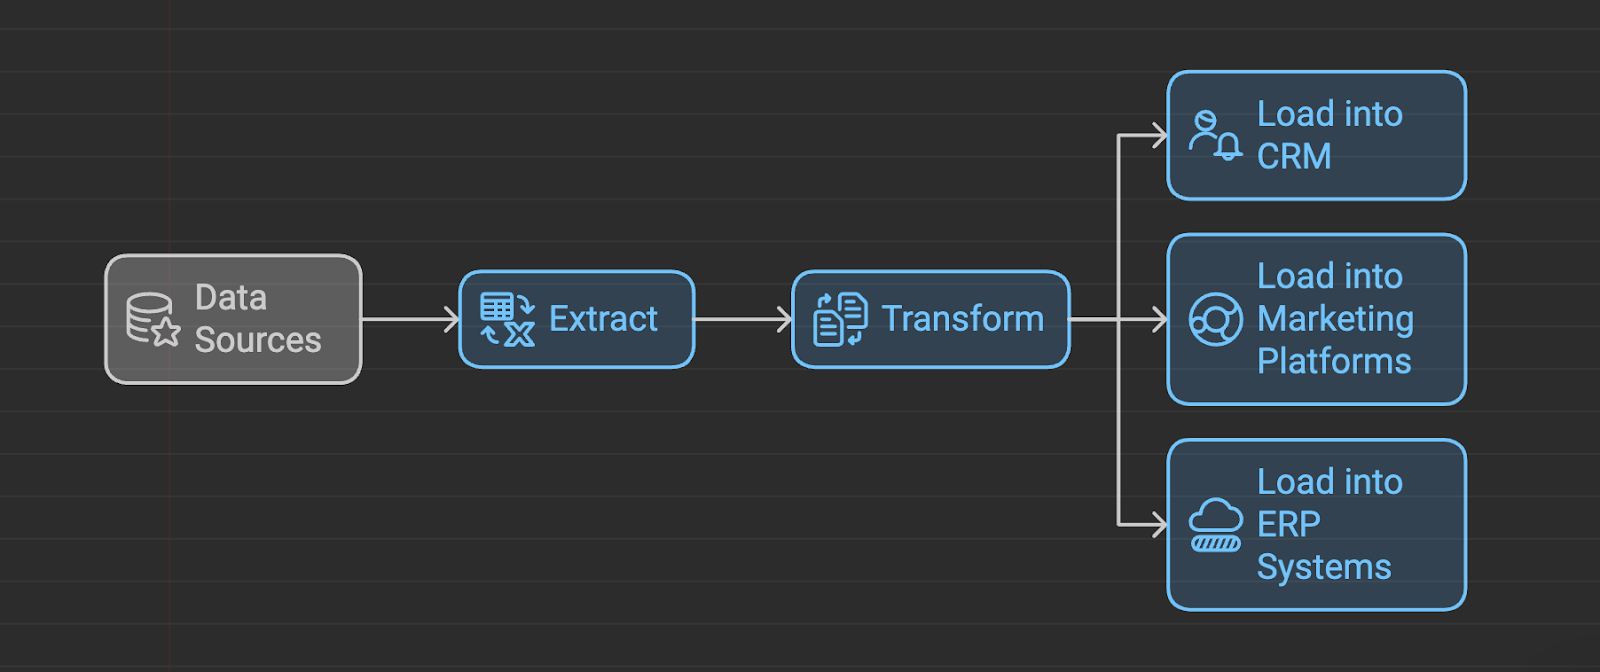
Processus de reverse ETL. Source : napkin.ai
Aussi prometteur soit-il, le reverse ETL n'est pas exempt de difficultés. Il peut être compliqué pour les data engineers de garantir l'exactitude des données et de naviguer entre des systèmes différents, parfois peu familiers. Le plus grand défi réside souvent dans le maintien de la qualité des données. Des incohérences mènent à de mauvaises décisions, d'où l'importance de processus rigoureux de validation et de nettoyage.
Le volume et la vélocité des données peuvent également être difficiles à gérer. Traiter efficacement de grands jeux de données nécessite des stratégies comme les mises à jour incrémentales et la capture de données de changement (CDC). Ces techniques ciblent uniquement les données nécessaires, optimisent les performances et réduisent la charge des systèmes. Dernier écueil : la complexité des API, dont les capacités varient d'un système à l'autre. Une gestion et une standardisation efficaces des API aident à y faire face.
L'ETL est une approche d'intégration des données où l'on extrait des données de diverses sources, on les transforme dans un format approprié, puis on les charge dans un entrepôt. Ce processus implique un nettoyage et des transformations en amont importants, ce qui le rend gourmand en ressources et chronophage.
L'ELT, à l'inverse, privilégie la rapidité et la flexibilité. Les données sont extraites des sources et chargées directement, en brut, dans l'entrepôt. Les transformations ont lieu dans l'entrepôt, souvent via des moteurs de requêtes puissants. Cette approche tire parti de la puissance de calcul des entrepôts modernes et offre une plus grande agilité pour l'exploration et l'analyse.
Alors que l'ETL et l'ELT visent à faire entrer les données dans l'entrepôt, le reverse ETL adopte une logique opposée. Il extrait des données transformées de l'entrepôt et les envoie vers les systèmes opérationnels, comme les CRM, les plateformes d'automatisation marketing et les outils de support client. Les organisations peuvent ainsi exploiter les insights issus de l'analyse pour déclencher des actions en temps réel et améliorer leurs processus métier. Le passage de l'ETL à l'ELT s'explique principalement par :
En somme, l'évolution de la gestion des données vise plus d'efficacité, de flexibilité et d'insights actionnables. L'ETL a posé les bases, l'ELT a accéléré l'ingestion et la transformation, et le reverse ETL a bouclé la boucle en réinjectant les insights dans les workflows opérationnels.
L'ETL et l'ELT sont deux méthodes pour déplacer des données d'un système à un autre. Bien que proches en apparence, elles présentent des différences essentielles dans la façon de gérer la transformation. Voici un aperçu. Pour une analyse détaillée, lisez notre article ETL vs. ELT.
| Critère | ETL | ELT |
|---|---|---|
| Transformation des données | Avant le chargement | Après le chargement |
| Qualité des données | Forte exigence de nettoyage en amont | Moins d'efforts de nettoyage en amont |
| Temps de traitement | Plus long à cause des transformations | Plus rapide grâce au traitement parallèle |
| Volume de données | Plus adapté aux jeux de données modestes | Gère efficacement de grands volumes |
| Flexibilité | Moins flexible | Plus flexible grâce aux données brutes |
Le reverse ETL comble le fossé entre insights et exécution opérationnelle. En transférant des données à forte valeur depuis votre entrepôt vers vos systèmes, vous ouvrez le champ des possibles.
Le reverse ETL n'est pas qu'un outil de transfert. C'est un atout stratégique qui peut accélérer votre croissance. Voici, selon moi, les points clés.
Si vous souhaitez des perspectives d'experts du secteur, Liya Aizenberg, Director of Data Engineering chez Away, partage d'excellents conseils pour mieux aligner les initiatives de data engineering sur les objectifs business.
Plusieurs outils et plateformes permettent de mettre en œuvre le reverse ETL, chacun avec ses spécificités. Le tableau ci-dessous présente quelques options connues :
Pour choisir un outil de reverse ETL, tenez compte des facteurs suivants :
En évaluant soigneusement ces éléments au regard de vos besoins, vous pourrez sélectionner l'outil de reverse ETL le mieux adapté pour libérer tout le potentiel de vos données.
Vous percevez désormais l'importance du reverse ETL. Ce n'est pas qu'une procédure technique. Avec les bons moyens — notamment des data engineers expérimentés en reverse ETL — une entreprise peut passer d'un fonctionnement rigide à une organisation dynamique, portée par des données en temps réel pour croître, augmenter ses ventes et réagir vite aux évolutions du marché.
Si vous souhaitez approfondir le data engineering, inscrivez-vous à notre parcours Data Engineer in Python, qui met l'accent sur le rôle de Python dans l'automatisation et l'optimisation des processus data. Si vous préférez renforcer d'abord votre expérience en SQL, commencez par notre parcours Associate Data Engineer in SQL, qui explore en détail ETL et ELT et leur lien avec PostgreSQL.
Apprenez avec DataCamp
Cours
Cours
Cours