Wat is big data?
Big data is een van de buzzy termen in de dataruimte. Maar hoe groot is ‘big’ eigenlijk? Je kunt erover nadenken in termen van volume, oftewel de hoeveelheid data die je hebt. Op basis van volume kunnen we big data definiëren als data die veel meer is dan je op een moderne laptop of harde schijf kunt opslaan. Het moet daarom over clusters van computers worden verdeeld om ermee te werken, te verzenden en te analyseren. We kunnen deze definitie van big data uitbreiden naar de drie V’s: volume, snelheid en verscheidenheid.
- Volume: De hoeveelheid data
- Velocity: Hoe snel je data kunt verplaatsen en analyseren
- Variety: De verschillende soorten data die je hebt
Is big data het einde van theorie?
In 2008 schreef Chris Anderson een prikkelend artikel in Wired met de titel The End of Theory, The Data Deluge Makes the Scientific Method Obsolete. De stelling was dat we genoeg data hadden om bevredigende voorspellingen over de wereld te doen, waardoor we geen theorie meer nodig hadden om de wereld te begrijpen. De aanleiding voor zulke argumenten was deels wat we bij Google zagen gebeuren—ze konden met enorme hoeveelheden data werken en vervolgens voorspellende modellen leveren in de vorm van dataprodukten voor programmatische advertentieaankoop. Bovendien konden ze dat doen met voldoende geavanceerde voorspellende analyses, zonder het systeem dat werd bestudeerd te hoeven begrijpen of theoretiseren.
Het ging er allemaal om menselijk gedrag vast te leggen om betere producten en diensten te bouwen. Google maakte het voor wie een advertentie wilde kopen eenvoudig om er een te kopen op Google AdWords, en het model achter AdWords leunde niet op een theorie over of iemand wel of niet zou klikken. Google had simpelweg genoeg data om een ‘goed genoeg’ voorspelling te doen. Chris Andersons provocerende hypothese is dat big data zó veel informatie bevat dat we de wereld niet meer hoeven te modelleren, en dat we de theorie erachter of wat er feitelijk gebeurt niet meer hoeven te begrijpen.
Heeft big data zijn beloften aan ons eigenlijk waargemaakt? Een manier om hierover na te denken is via de Gartner Hype Cycle.
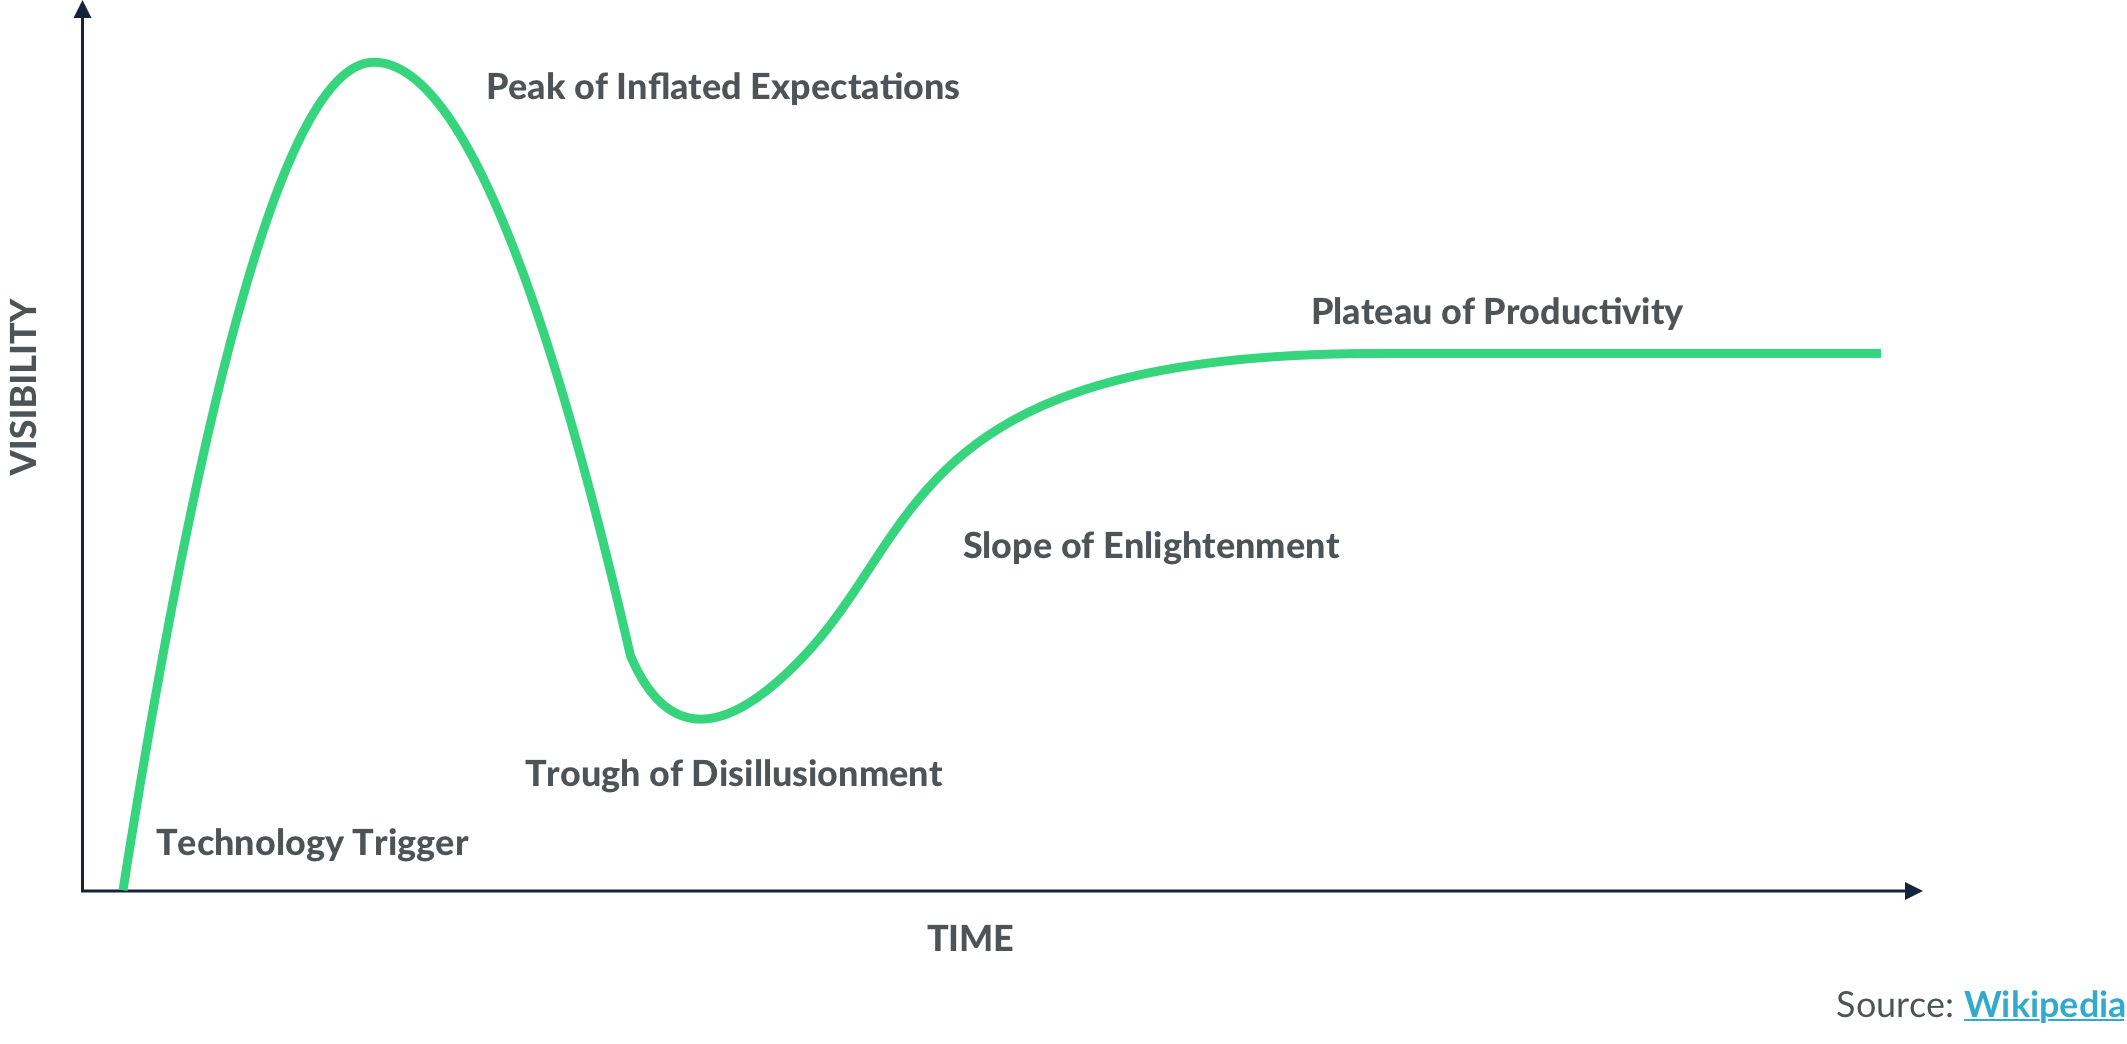
De Gartner Hype Cycle vertelt ons over een technologische innovatie en de verwachtingen eromheen als functie van tijd. We beginnen met een Innovation Trigger, wat in het geval van big data het vermogen was om grote hoeveelheden data op te slaan, te verzenden en te analyseren. Vervolgens raken mensen erdoor gehypet, wat leidt tot opgeblazen verwachtingen (Peak of Inflated Expectations). Daarna zien we de waarde niet geleverd worden tegenover de verwachtingen, waardoor we in de Trough of Disillusionment belanden. Pas daarna zien we de daadwerkelijke, echte waarde geleverd worden in verschillende sectoren—en betreden we de Slope of Enlightenment.
Waar bevindt big data zich momenteel in de Gartner Hype Cycle? Een manier om over verwachtingen na te denken is te kijken waar mensen in de loop der tijd op hebben gezocht in Google. Hieronder staan de Google-trends voor ‘big data’ sinds 2004. Je ziet dat Chris Anderson zijn tijd vooruit was—maar hij had ongelijk dat big data het einde van theorie zou zijn, vanwege het belang van small data en thick data.
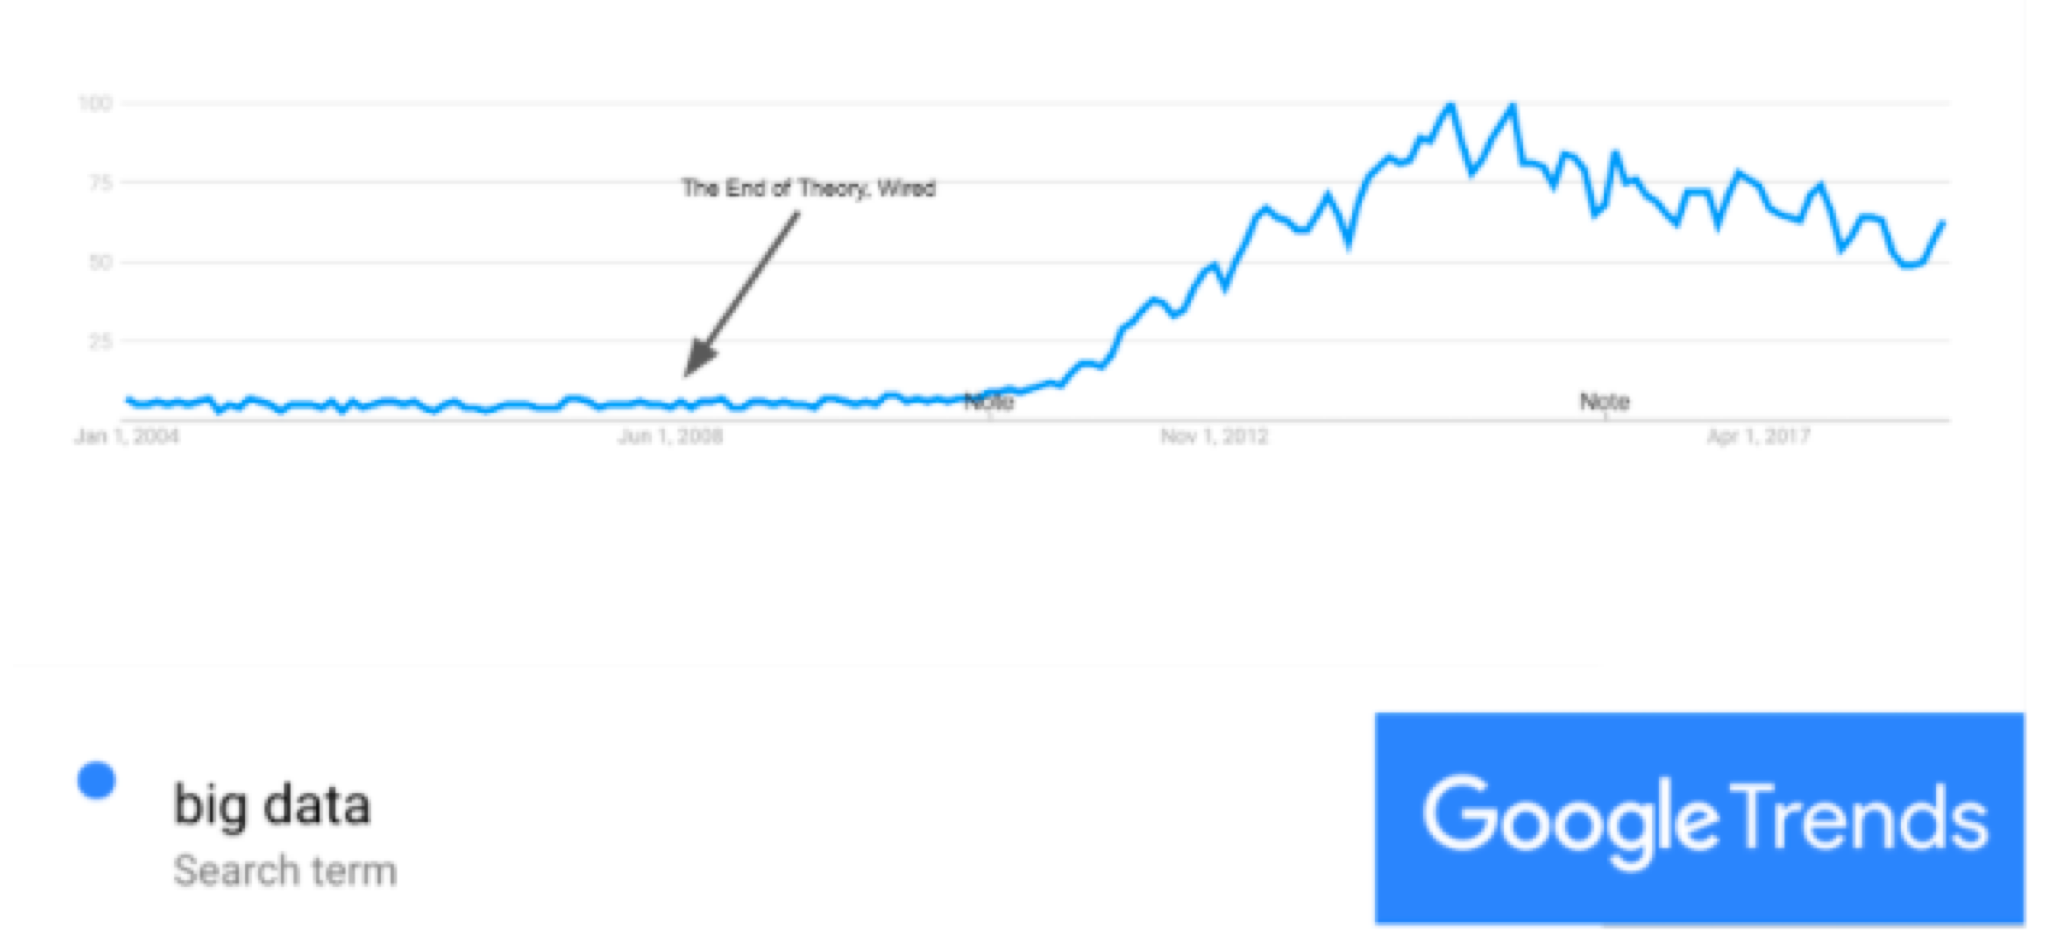
Als we de Gartner Hype Cycle accepteren als een geldig model om over big data na te denken, en als we Google-trends accepteren als een proxy voor verwachtingen, dan zien we dat de Peak of Inflated Expectations rond 2014 lag en dat we de Trough of Disillusionment nog niet per se hebben bereikt.
Small data is ook krachtig
Hoewel veel recente innovaties in data science draaien om ons vermogen om steeds grotere datavolumes efficiënt te verwerken, is het belangrijk te erkennen dat het overgrote deel van de data die in de echte wereld wordt geanalyseerd gewoon in het geheugen van een moderne laptop past. Als leidinggevende doe je er goed aan de behoeften van je dataorganisatie zorgvuldig te overwegen voordat je beslist welke tools en architecturen je adopteert.
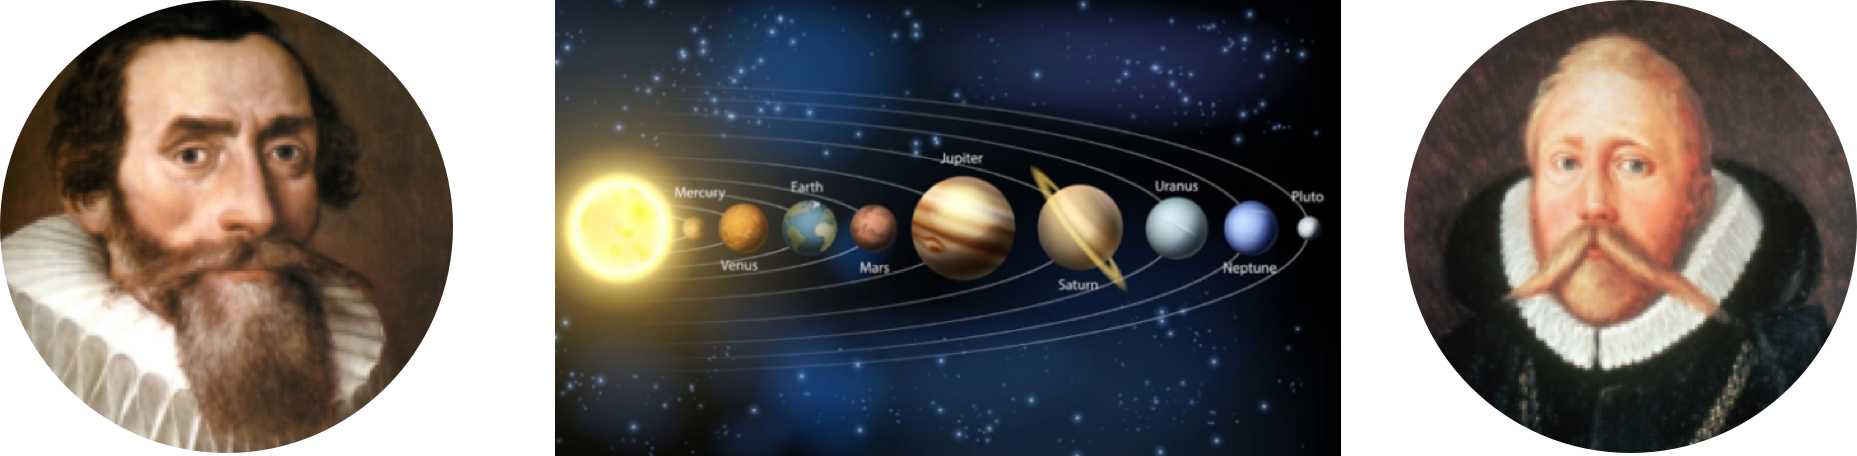
Ik neem je graag mee terug in de tijd naar Johannes Kepler, die drie wetten van de planeetbeweging ontdekte, en Tycho Brahe, een Deense astronoom die de data verzamelde die Kepler uiteindelijk analyseerde om zijn drie bewegingswetten op te stellen, die vervolgens Newtons zwaartekrachttheorie informeerden. We hebben een enorme hoeveelheid wetenschappelijke kennis ontwikkeld op basis van de data die Brahe verzamelde, die bestond uit slechts zo’n 2.000 datapunten. Dat is een minuscuul dataset vergeleken met de datasets waar we het tegenwoordig over hebben, die soms honderden miljoenen datapunten bevatten. Maar de data die Brahe verzamelde was van hoge kwaliteit. Als je goede, zorgvuldig verzamelde data hebt, sterke analytische en principieel onderbouwde theoretische modellen, en een manier om statistisch te modelleren, kun je enorm veel uit je data halen.
Laten we een ander voorbeeld bekijken dat Andrew Gelman bespreekt in het artikel How can a poll of only 1,004 Americans represent 260 million people with only a 3 percent margin of error? Gelman neemt je mee door de wiskunde en laat zien dat wanneer je de hoeveelheid data vergroot, je sterk afnemende meeropbrengsten krijgt op de verkleining van de foutmarge. Disclaimer: Dit resultaat geldt alleen als je een vorm van representatieve steekproef van je populatie hebt, wat bij peilingen zeker niet altijd het geval is. Maar statistici beschikken nu over geavanceerde correctiemethoden voor niet-representatieve steekproeven, waarmee ze kunnen leren over de stemvoorkeuren van een grotere populatie.
Opnieuw zien we een significant resultaat uit een kleine hoeveelheid data, en het vertelt ons iets over de aard van menselijk gedrag en voorkeuren. Hetzelfde principe geldt voor bedrijven—het draait om begrijpen en kunnen voorspellen van toekomstig menselijk gedrag, vooral dat van je stakeholders. Waarom hebben we het dan zo vaak over big data als het niet per se nodig is? Een primaire reden is dat het tegenwoordig zo toegankelijk en dus zo goed te verwerken is.
De kern is het punt uit Harvard Business Review in Sometimes “Small Data” Is Enough to Create Smart Products: “it’s not about mountains of data, it’s about small, high precision data.”
De kracht van thick data
Nu we de kracht van small data hebben besproken, wil ik doorgaan naar een ander type data: thick data, ofwel kwalitatieve data. Dunne data draait om getallen en tabellen, terwijl thick data, een term uit de sociologie en antropologie, meer kwalitatief en beschrijvend is. Een adviesbureau genaamd ReD Associates heeft fantastisch werk gedaan met thick data om mensen te helpen analytische modellen en machinelearningmodellen te bouwen.
Een voorbeeld dat ik wil noemen is hun werk rond het detecteren van creditcardfraude. Dit is een enorme uitdaging, en machine learning is in het verleden gebruikt om creditcardfraude op te sporen met kenmerken zoals het transactiebedrag, het tijdstip, de locatie, enzovoort. ReD Associates probeerde thick data te verzamelen om dit probleem op te lossen, met een sociologische benadering.
Daarvoor ging ReD Associates in gesprek met creditcardfraudeurs om te achterhalen wat ze precies doen en hoe hun processen eruitzien. Ze vonden een community van creditcardfraudeurs op het dark web en ontmoetten hen in het echt om te leren over hun werkwijzen en gewoonten.
Ze ontdekten dat het moment waarop creditcardfraudeurs de grootste kans hebben om gepakt te worden, is wanneer ze iets in de echte wereld moeten doen—zoals het ophalen van pakketjes. Online zijn ze technisch vaardig genoeg om zelden detecteerbaar te zijn. En fraudeurs zijn ook voorzichtig in de fysieke wereld—ze sturen pakketten doorgaans niet naar hun eigen adres, werkadres of dat van vrienden. In plaats daarvan sturen ze leveringen naar adressen van panden die verlaten zijn of op de huizenmarkt staan.
Gewapend met deze kennis bouwde ReD Associates een model voor het detecteren van creditcardfraude, waarbij de locatie waarheen het pakket werd verzonden als kenmerk werd gebruikt, gecombineerd met openbaar beschikbare data over verlaten huizen en huizen die te koop staan. Ze zagen dat dit model, gebaseerd op kwalitatieve data, een significante verbetering in nauwkeurigheid opleverde vergeleken met meer traditionele modellen voor frauduleuze transacties. Dit is een prachtig voorbeeld van het belang van thick data en hoe een sociologische benadering extra waarde kan opleveren. Ik raad deze twee artikelen aan om verder te verkennen waarom goede kwaliteitsdata belangrijker is dan big data: The Power of 'Thick' Data en Big Data Is Only Half the Data Marketers Need.
Thick data benutten in je analyses
Kies een databron die waardevol is voor je bedrijf en denk na over hoeveel van deze data je echt nodig hebt om beslissingen te onderbouwen. Een manier om dit in te schatten is door te kijken naar de meerwaarde van een toename met 2X, 5X en 10X, met name in verhouding tot de investering in het verzamelen, opslaan en analyseren ervan. Beantwoord daarna deze vraag: Welke thick data kun je gebruiken om de kwaliteit van deze databron te verhogen?
Lees meer over best practices om data te benutten in The Definitive Guide to Machine Learning for Business Leaders.


