Qu'est-ce que le big data ?
Le big data est l'un des termes les plus en vogue dans l'univers des données. Mais jusqu'où va le « big » ? On peut l'aborder sous l'angle du volume, c'est-à-dire la quantité de données dont vous disposez. Sur cette base, on peut définir le big data comme un volume de données bien supérieur à ce qu'un ordinateur portable moderne ou un disque dur peuvent stocker. Elles doivent donc être réparties sur des grappes de machines pour être exploitées, transmises et analysées. On étend généralement cette définition aux trois V : volume, vélocité et variété.
- Volume : la quantité de données
- Vélocité : la rapidité avec laquelle on peut déplacer et analyser les données
- Variété : la diversité des types de données disponibles
Le big data signe-t-il la fin des théories ?
En 2008, Chris Anderson publiait dans Wired un article provocateur intitulé The End of Theory, The Data Deluge Makes the Scientific Method Obsolete. Sa thèse : nous disposons désormais de suffisamment de données pour faire des prédictions satisfaisantes sur le monde, au point de pouvoir se passer de théories pour le comprendre. Cet argument s’appuyait en partie sur l’exemple de Google : l’entreprise exploitait d’immenses volumes de données pour fournir des modèles prédictifs sous forme de produits data au service de l'achat programmatique d’annonces. Autrement dit, grâce à des analyses prédictives avancées, elle parvenait à des résultats sans forcément modéliser ni théoriser en profondeur le système étudié.
Il s’agissait d’exploiter les comportements humains observés pour concevoir de meilleurs produits et services. Google a permis à quiconque souhaitant acheter une annonce de le faire facilement via Google AdWords, et le modèle derrière AdWords ne reposait pas sur une théorie expliquant si quelqu’un cliquerait ou non. Google disposait simplement d'assez de données pour produire une prédiction « suffisamment bonne ». L’hypothèse provocatrice de Chris Anderson est que le big data contient tant d’information que nous n’aurions plus besoin de modéliser le monde, ni de comprendre la théorie sous-jacente ou ce qui se passe réellement.
Le big data a-t-il réellement tenu ses promesses ? Une façon d’aborder la question consiste à la projeter sur le cycle de hype de Gartner.
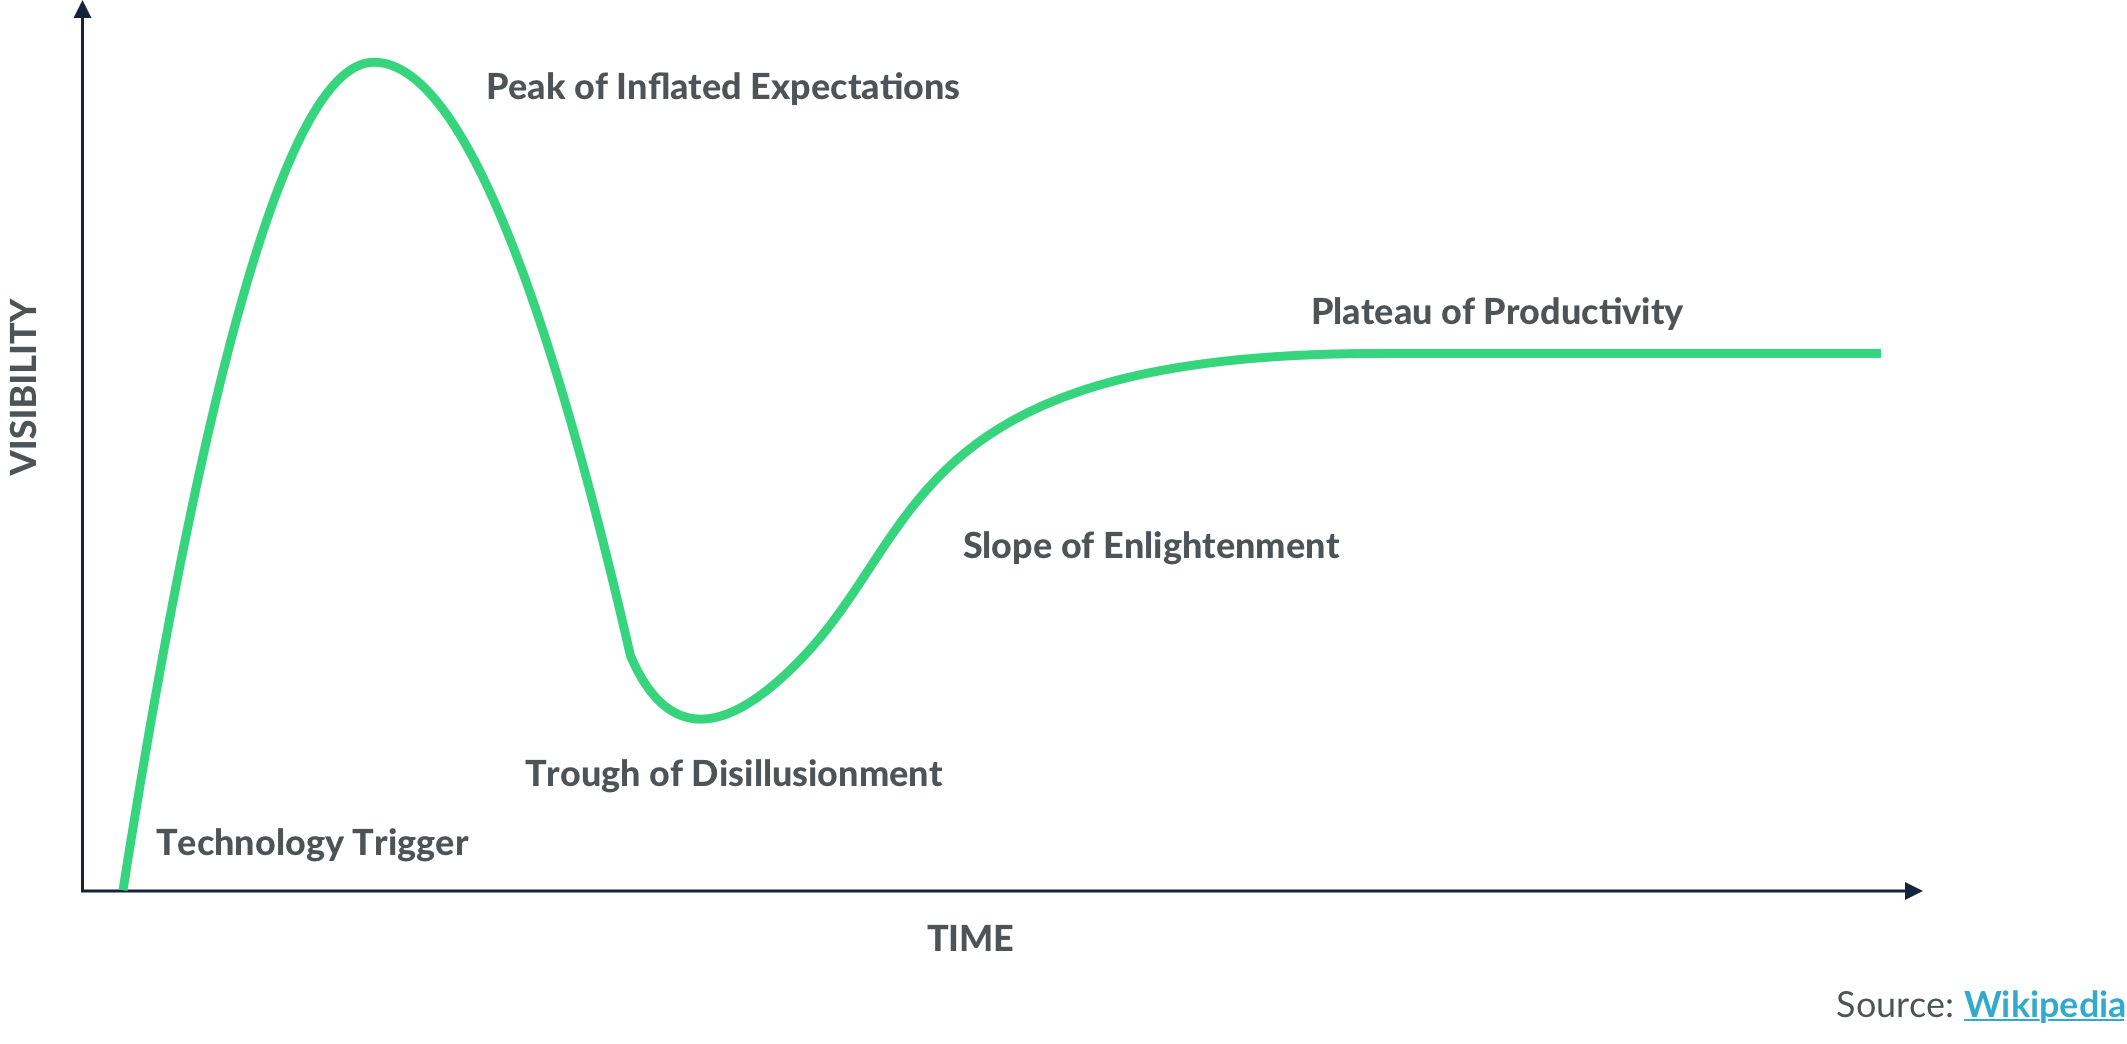
Le cycle de hype de Gartner décrit l’évolution d’une innovation technologique et des attentes qui l’entourent en fonction du temps. On commence par un déclencheur d’innovation : pour le big data, la capacité de stocker, transmettre et analyser de grandes quantités de données. Puis l’emballement médiatique crée des attentes démesurées. Ensuite, la valeur perçue ne suit pas ces attentes, et l’on entre dans le creux de la désillusion. Ce n’est qu’après cette phase que la valeur réelle commence à se matérialiser dans plusieurs secteurs : on gravit alors la pente de l’illumination.
Où en est le big data aujourd’hui sur ce cycle ? Pour évaluer les attentes, on peut observer l’évolution des recherches Google dans le temps. Ci-dessous, les tendances Google pour « big data » depuis 2004. On voit que Chris Anderson était en avance sur son temps — mais il avait tort sur l’idée que le big data signe la fin des théories, tant l’importance des small data et des thick data est manifeste.
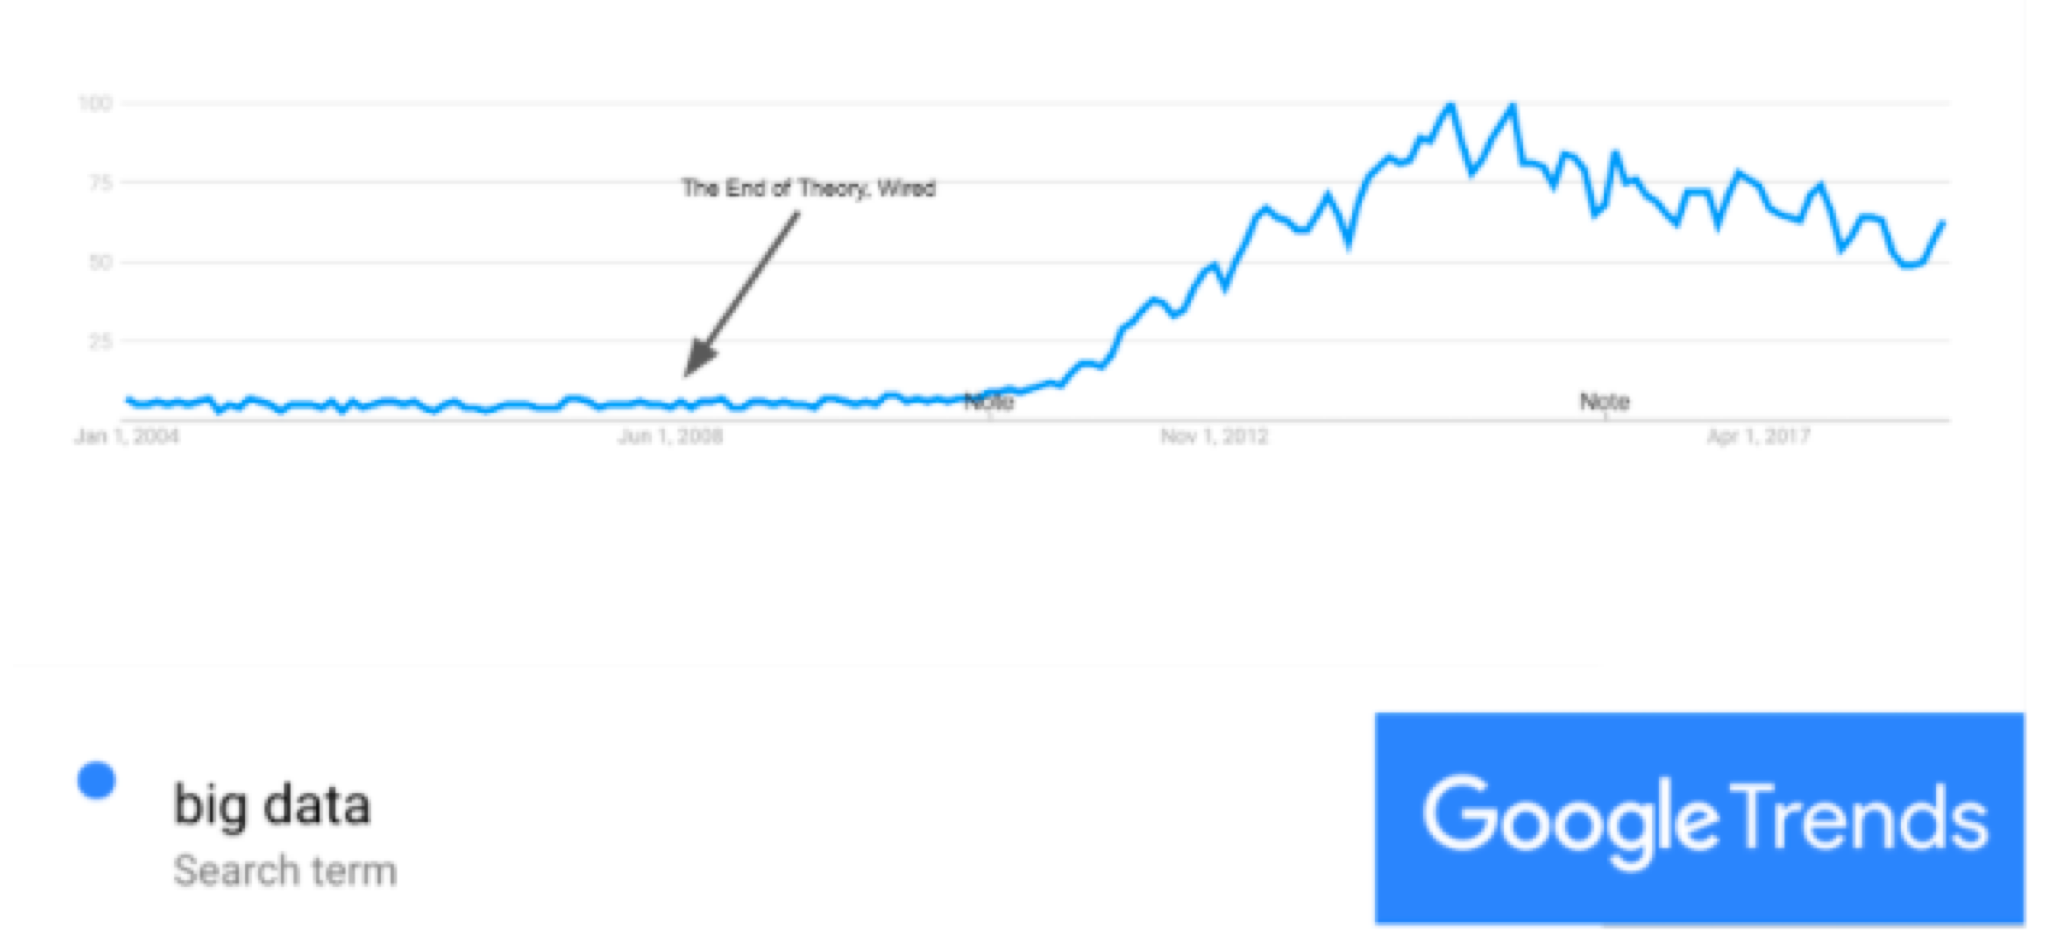
Si l’on admet le cycle de hype de Gartner comme un cadre pertinent pour penser le big data, et si l’on considère les tendances Google comme un proxy des attentes, on constate que le pic des attentes gonflées se situe autour de 2014 et que nous n’avons pas encore nécessairement atteint le creux de la désillusion.
Les small data sont aussi puissantes
Bien que nombre d’innovations récentes en data science portent sur notre capacité à gérer efficacement des volumes de données toujours plus importants, il faut garder à l’esprit que la très grande majorité des données analysées dans le monde réel tient en mémoire sur un ordinateur portable moderne. En tant que dirigeant, vous devez examiner avec soin les besoins de votre organisation data avant de choisir vos outils et vos architectures.
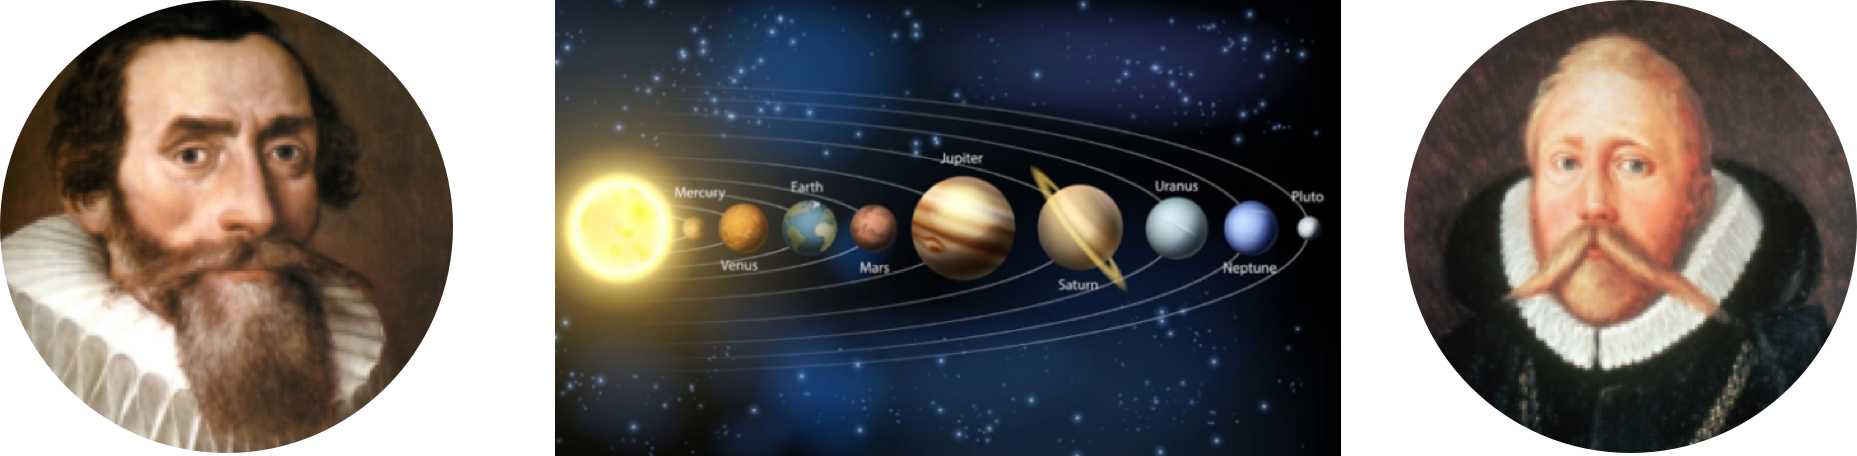
Revenons un instant à Johannes Kepler, qui a découvert les trois lois du mouvement planétaire, et à Tycho Brahe, astronome danois qui a collecté les données qu’a ensuite analysées Kepler pour établir ces lois, lesquelles ont inspiré la théorie de la gravitation de Newton. Une immense part du savoir scientifique découle des données recueillies par Brahe : environ 2 000 points de données. Infime, comparé aux jeux de données actuels qui peuvent compter des centaines de millions d’observations. Mais les données de Brahe étaient de grande qualité. Avec des données bien collectées, de solides modèles analytiques et théoriques, et une approche statistique rigoureuse, on peut tirer un maximum d’enseignements de données modestes.
Voyons un autre exemple évoqué par Andrew Gelman dans How can a poll of only 1,004 Americans represent 260 million people with only a 3 percent margin of error?. Gelman y montre mathématiquement que l’augmentation de la taille de l’échantillon produit des rendements fortement décroissants sur la réduction de la marge d’erreur. Avertissement : ce résultat suppose un échantillonnage représentatif de la population, ce qui est loin d’être toujours le cas dans les sondages. Mais les statisticiens disposent aujourd’hui de méthodes de correction sophistiquées pour des échantillons non représentatifs, afin d’estimer les préférences de vote d’une population plus large.
On obtient ainsi des résultats significatifs à partir de peu de données, qui éclairent la nature des comportements et préférences humains. En entreprise, le principe est le même : comprendre et anticiper les comportements futurs, notamment ceux de vos parties prenantes. Alors, pourquoi parle-t-on autant de big data alors que ce n’est pas toujours nécessaire ? Principalement parce qu’il est aujourd’hui facile d’y accéder et de le traiter.
En résumé, comme le souligne la Harvard Business Review dans Sometimes “Small Data” Is Enough to Create Smart Products, « l’enjeu n’est pas d’avoir des montagnes de données, mais des données à petite échelle et de haute précision ».
La puissance des thick data
Après les small data, abordons un autre type : les thick data, ou données qualitatives. Les données « fines » relèvent des chiffres et des tableaux, tandis que les thick data, concept issu de la sociologie et de l’anthropologie, sont plus qualitatives et descriptives. Le cabinet ReD Associates a réalisé un travail remarquable en mobilisant les thick data pour améliorer des modèles analytiques et des modèles de machine learning.
Un exemple parlant : leur travail sur la détection de la fraude à la carte bancaire. C’est un défi majeur où le machine learning est utilisé de longue date, avec des variables comme le montant, l’heure, la localisation, etc. ReD Associates a choisi d’adopter une approche sociologique en collectant des thick data pour s’attaquer au problème.
Ils se sont entretenus avec des fraudeurs à la carte bancaire pour comprendre concrètement leurs méthodes et leurs processus. Ils ont identifié une communauté de fraudeurs sur le dark web et les ont rencontrés dans la vraie vie pour observer leurs pratiques.
Ils ont découvert que le moment où les fraudeurs ont le plus de chances d’être pris est celui où ils doivent agir dans le monde réel — par exemple, récupérer des colis. Ils sont suffisamment aguerris technologiquement pour rester rarement détectables en ligne. Et ils sont prudents dans le monde physique : ils n’envoient généralement pas de colis chez eux, au travail, ni chez des proches. Ils privilégient des adresses de biens abandonnés ou mis en vente.
Forts de ces enseignements, ReD Associates a intégré, comme caractéristique du modèle de détection de fraude, la destination des colis, recoupée avec des données publiques sur les logements vacants et les biens sur le marché. Ils ont observé qu’un tel modèle, nourri de données qualitatives, améliorait nettement la précision par rapport aux modèles plus classiques de détection de transactions frauduleuses. C’est une excellente illustration de l’apport des thick data : une approche sociologique peut créer de la valeur supplémentaire. Pour approfondir, consultez : The Power of 'Thick' Data et Big Data Is Only Half the Data Marketers Need.
Intégrer les thick data dans vos analyses
Choisissez une source de données précieuse pour votre activité et interrogez-vous : de quelle quantité de ces données avez-vous réellement besoin pour éclairer vos décisions ? Pour l’estimer, évaluez la valeur ajoutée d’un volume multiplié par 2, 5 et 10, en regard des investissements de collecte, de stockage et d’analyse. Puis répondez à cette question : quelles thick data pourriez-vous mobiliser pour améliorer la qualité de cette source ?
Découvrez les meilleures pratiques pour tirer parti des données dans The Definitive Guide to Machine Learning for Business Leaders.
