¿Qué es el big data?
Big data es uno de los términos más de moda en el mundo de los datos. Pero ¿cuán grande es realmente? Una forma de pensarlo es en términos de volumen, es decir, la cantidad de datos que tienes. Según el volumen, podemos definir big data como datos que superan con creces lo que puedes almacenar en un portátil o disco duro moderno. Por tanto, es necesario distribuirlos en clústeres de ordenadores para poder trabajarlos, transmitirlos y analizarlos. Podemos ampliar esta definición de big data con las tres V: volumen, velocidad y variedad.
- Volumen: La cantidad de datos
- Velocidad: La rapidez con la que puedes mover y analizar datos
- Variedad: Los distintos tipos de datos que tienes
¿Es el big data el fin de la teoría?
En 2008, Chris Anderson escribió un artículo provocador en Wired titulado The End of Theory, The Data Deluge Makes the Scientific Method Obsolete. La premisa era que ya teníamos suficientes datos como para hacer predicciones satisfactorias sobre el mundo sin necesidad de teoría para comprenderlo. Parte del impulso de estos argumentos venía de lo que veíamos en Google: eran capaces de operar con cantidades ingentes de datos y ofrecer modelos predictivos en forma de productos de datos para la compra programática de anuncios. Además, lo hacían con analítica predictiva suficientemente avanzada sin necesidad de entender o teorizar sobre el sistema en estudio.
Todo se centraba en aprovechar el comportamiento humano observado para crear mejores productos y servicios. Google facilitó a quien quisiera comprar un anuncio hacerlo en Google AdWords, y el modelo detrás de AdWords no dependía de una teoría sobre si alguien haría clic o no. Google tenía suficientes datos para hacer una predicción “lo bastante buena”. La hipótesis provocadora de Chris Anderson es que el big data contiene tanta información que ya no necesitamos modelizar el mundo ni entender la teoría que hay detrás ni lo que realmente sucede.
¿Ha cumplido el big data sus promesas? Una forma de pensarlo es usando el ciclo de sobreexpectación de Gartner.
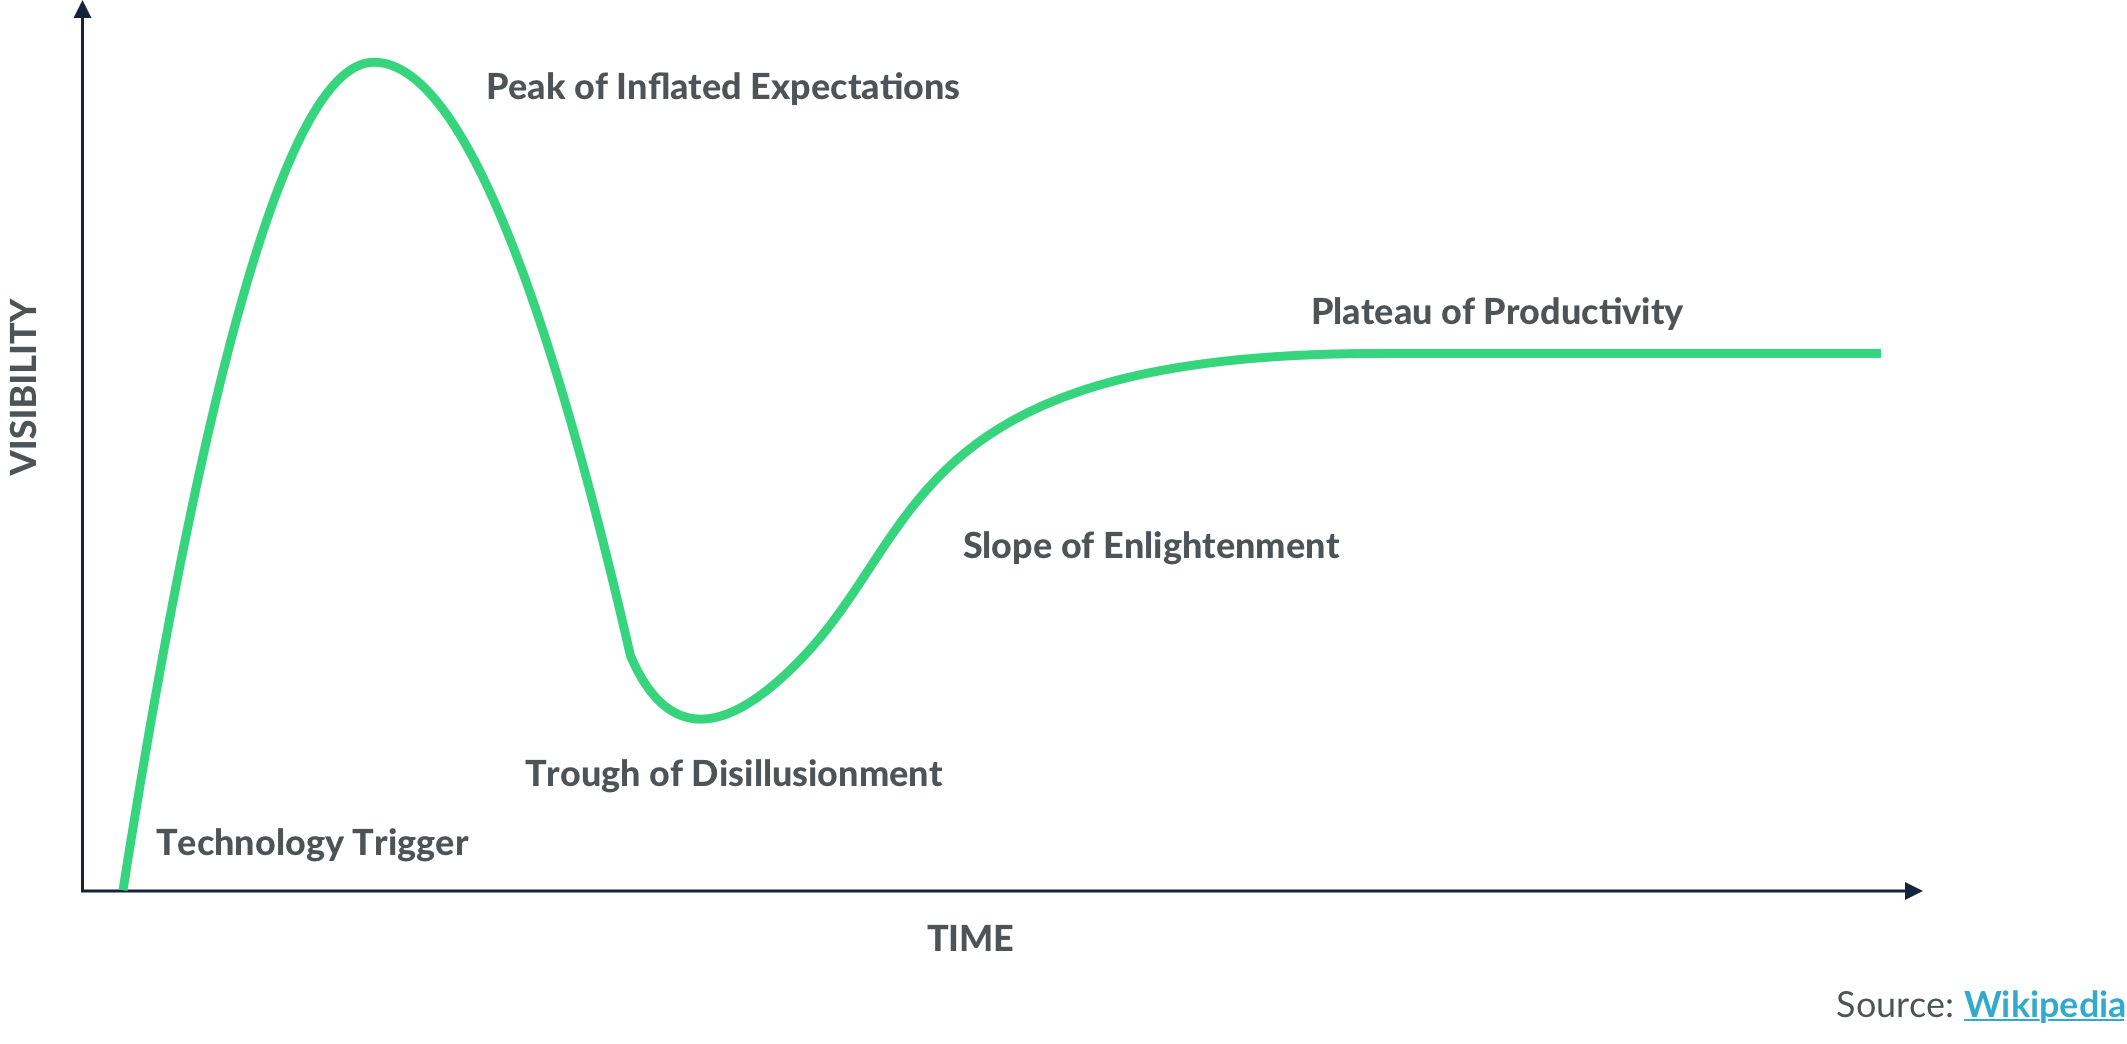
El Hype Cycle de Gartner describe una innovación tecnológica y las expectativas que genera en función del tiempo. Empezamos con el disparador de la innovación, que en el caso del big data fue la capacidad de almacenar, transmitir y analizar grandes volúmenes de datos. Luego llega el bombo, que conduce al pico de expectativas infladas. Después, no vemos el valor entregado frente a esas expectativas, así que entramos en la fase de desilusión. Solo entonces empieza a materializarse el valor real en distintos sectores y entramos en la pendiente de la iluminación.
¿En qué punto está ahora el big data dentro del Hype Cycle de Gartner? Una forma de medir las expectativas es ver qué ha buscado la gente en Google a lo largo del tiempo. Abajo están las tendencias de Google para “big data” desde 2004. Se ve que Chris Anderson se adelantó a su tiempo, pero se equivocó al afirmar que el big data suponía el fin de la teoría, por la importancia de los datos pequeños y del thick data.
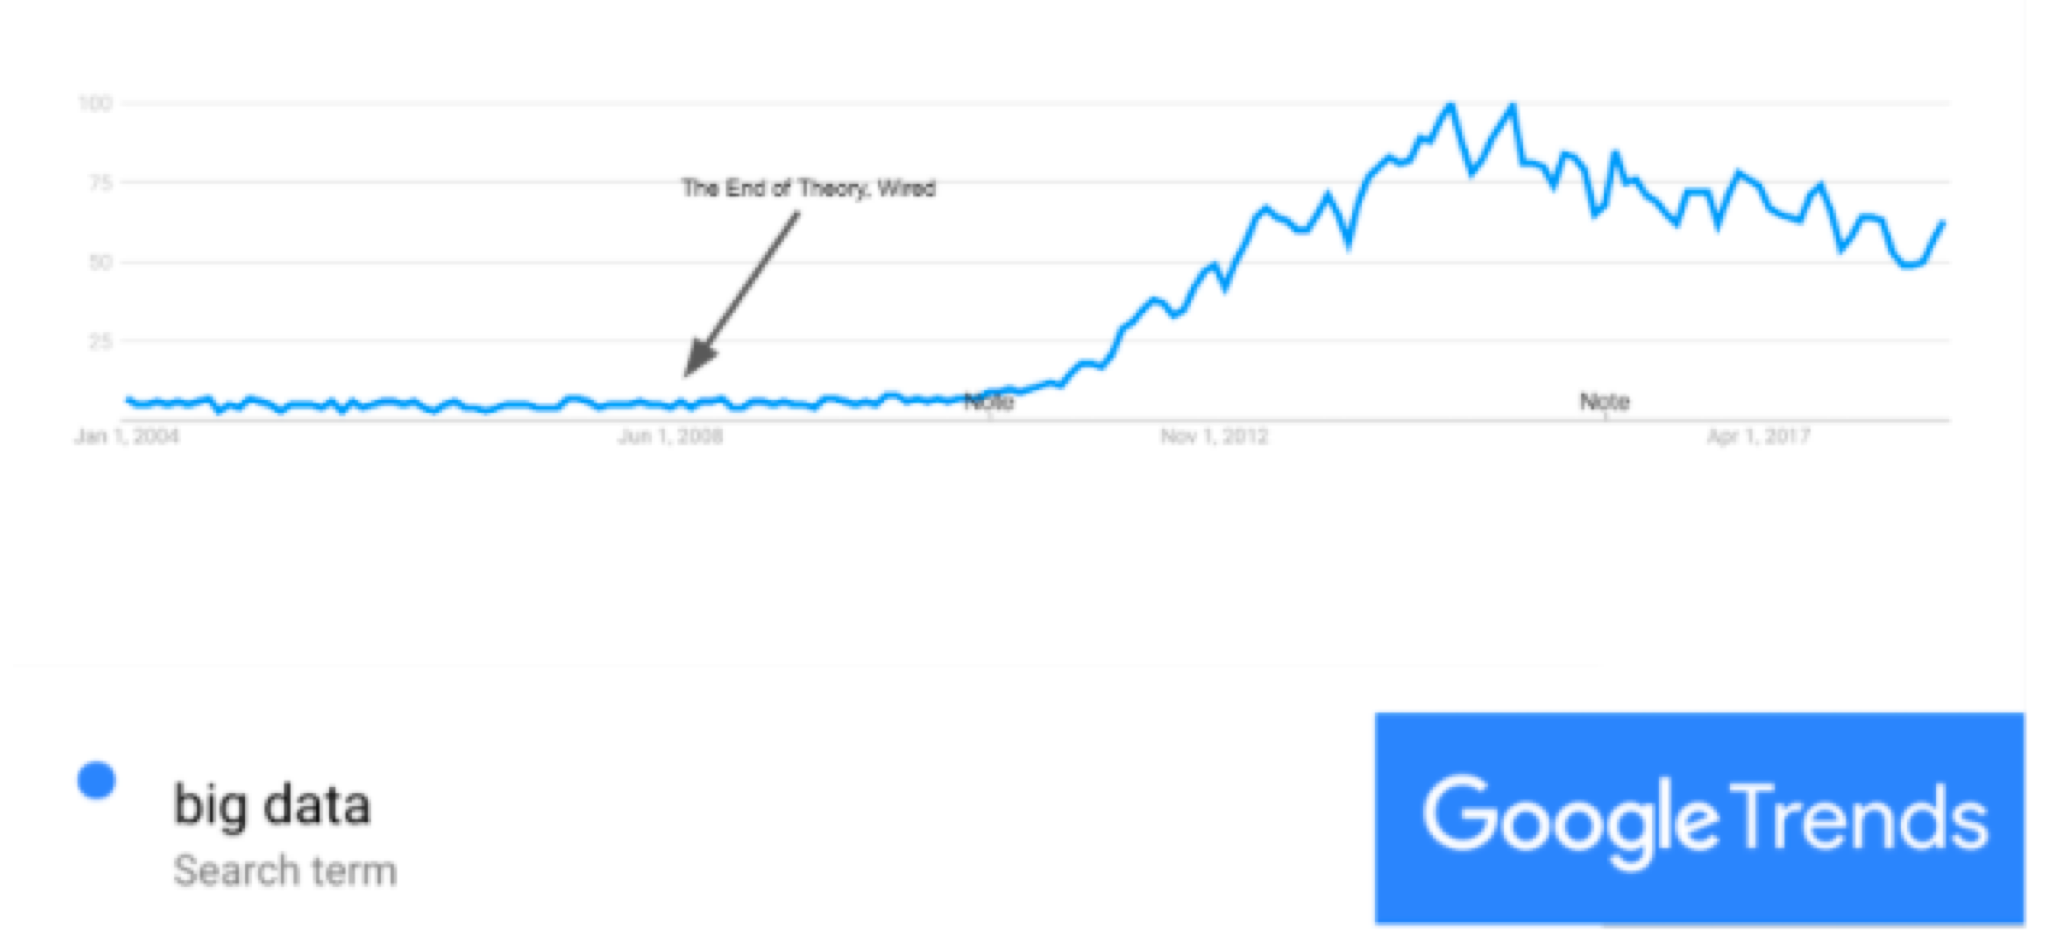
Si aceptamos el Hype Cycle de Gartner como un modelo válido para pensar en el big data, y aceptamos las tendencias de Google como un proxy de las expectativas, podemos ver que el pico de expectativas infladas estuvo alrededor de 2014 y que quizá aún no hemos llegado del todo a la fase de desilusión.
El small data también es potente
Aunque muchas innovaciones recientes en ciencia de datos se han centrado en nuestra capacidad para manejar de forma eficiente volúmenes cada vez mayores de datos, es importante reconocer que la gran mayoría de los datos que se analizan en el mundo real caben en la memoria de un portátil moderno. Como líder de negocio, deberías evaluar con cuidado las necesidades de tu organización de datos antes de decidir qué herramientas y arquitecturas adoptar.
Quiero llevarte atrás en el tiempo, a Johannes Kepler, que descubrió las tres leyes del movimiento planetario, y a Tycho Brahe, astrónomo danés que recopiló los datos que Kepler analizó para formular esas leyes, que después sirvieron de base para la teoría de la gravitación de Newton. Tenemos una enorme cantidad de conocimiento científico desarrollado a partir de los datos que recopiló Brahe, que sumaban apenas unos 2.000 puntos de datos. Es un conjunto diminuto comparado con los de hoy, que a veces contienen cientos de millones. Pero los datos de Brahe eran de alta calidad. Si cuentas con datos buenos y bien recogidos, modelos analíticos y teóricos sólidos y una forma rigurosa de modelización estadística, puedes exprimir muchísimo valor de tus datos.
Veamos otro ejemplo que analiza Andrew Gelman en su artículo How can a poll of only 1,004 Americans represent 260 million people with only a 3 percent margin of error? Gelman explica con matemáticas que, a medida que aumentas la cantidad de datos, los rendimientos en la reducción del margen de error decrecen de forma notable. Aviso: este resultado solo es cierto si dispones de un muestreo representativo de tu población, algo que en las encuestas no siempre ocurre. Pero los estadísticos ya cuentan con métodos sofisticados de corrección para muestras no representativas, con los que pueden inferir las preferencias de voto de una población mayor.
De nuevo, vemos resultados significativos con pocos datos que nos hablan de la naturaleza del comportamiento y las preferencias humanas. Lo mismo ocurre en los negocios: se trata de comprender y poder predecir el comportamiento futuro de las personas, especialmente de tus grupos de interés. Entonces, ¿por qué hablamos tanto de big data cuando no siempre es necesario? Una razón de peso es que hoy es muy accesible y computable.
La conclusión coincide con lo que señala Harvard Business Review en Sometimes “Small Data” Is Enough to Create Smart Products: “no se trata de montañas de datos, sino de datos pequeños y de alta precisión”.
El poder del thick data
Ahora que hemos hablado del valor del small data, pasemos a otro tipo: el thick data, o datos cualitativos. Los datos “finos” son números y tablas, mientras que el thick data, un término de la sociología y la antropología, es más cualitativo y descriptivo. Un grupo de consultoría llamado ReD Associates ha hecho un trabajo fantástico usando thick data para ayudar a crear modelos analíticos y de machine learning.
Un ejemplo que quiero mencionar es su trabajo en detección de fraude con tarjetas de crédito. Es un gran desafío, y el machine learning se ha usado para detectarlo empleando variables como el importe, la hora, la ubicación, etc. ReD Associates intentó recopilar thick data para abordar este problema desde un enfoque sociológico.
Para ello, ReD Associates se sentó con estafadores de tarjetas de crédito para averiguar qué hacen realmente y cómo son sus procesos. Encontraron una comunidad de estafadores en la dark web y se reunieron con ellos en la vida real para conocer sus métodos y hábitos.
Descubrieron que el momento en que los estafadores de tarjetas tienen más probabilidades de ser atrapados es cuando necesitan hacer algo en el mundo físico, como recoger entregas. Son lo bastante expertos en tecnología como para ser rara vez detectables en línea. Y también son cautos en el plano físico: normalmente no envían paquetes a su propia dirección, al trabajo o a la de sus amigos. En su lugar, los envían a direcciones de propiedades abandonadas o en el mercado inmobiliario.
Con este conocimiento, ReD Associates construyó un modelo de detección de fraude usando como variable la dirección a la que se enviaba el paquete, y lo combinó con datos públicos sobre casas abandonadas y viviendas en venta. Observaron que este modelo basado en datos cualitativos lograba una mejora significativa en precisión frente a modelos más tradicionales de transacciones fraudulentas. Es un gran ejemplo de la importancia del thick data y de cómo un enfoque sociológico puede aportar más valor. Te recomiendo estos dos artículos para profundizar en por qué la calidad de los datos es más importante que su tamaño: The Power of 'Thick' Data y Big Data Is Only Half the Data Marketers Need.
Cómo usar thick data en tus análisis
Elige una fuente de datos valiosa para tu negocio y piensa cuántos de esos datos necesitas realmente para tomar decisiones. Una forma de estimarlo es valorar el retorno incremental de aumentar el volumen 2X, 5X y 10X, especialmente en relación con la inversión en recopilar, almacenar y analizar. Después, responde: ¿qué thick data podrías incorporar para mejorar la calidad de esa fuente?
Descubre más sobre buenas prácticas para aprovechar los datos en The Definitive Guide to Machine Learning for Business Leaders.