Was ist Big Data?
Big Data ist eines der Schlagwörter in der Datenwelt. Aber wie groß ist „big“ eigentlich? Eine Möglichkeit ist, in Volumen zu denken, also in der Menge der vorhandenen Daten. Nach Volumen betrachtet ist Big Data so viel, dass es nicht mehr auf einem modernen Laptop oder einer Festplatte gespeichert werden kann. Es muss über Computercluster verteilt werden, um damit zu arbeiten, es zu übertragen und zu analysieren. Diese Definition von Big Data lässt sich über die drei Vs erweitern: Volume, Velocity und Variety.
- Volume: Die Datenmenge
- Velocity: Wie schnell sich Daten bewegen und analysieren lassen
- Variety: Die unterschiedlichen Datentypen
Ist Big Data das Ende der Theorie?
2008 schrieb Chris Anderson einen provokanten Artikel in Wired mit dem Titel The End of Theory, The Data Deluge Makes the Scientific Method Obsolete. Die These: Wir hätten genug Daten, um die Welt hinreichend genau vorherzusagen, ohne Theorie zu brauchen, um sie zu verstehen. Auslöser solcher Argumente war unter anderem, was wir bei Google sahen—sie konnten mit riesigen Datenmengen arbeiten und prädiktive Modelle als Datenprodukte für programmatic Ad Buying bereitstellen. Und das mit so fortgeschrittener prädiktiver Analytik, dass ein tiefes Verständnis oder eine Theorie des untersuchten Systems nicht nötig schien.
Es ging darum, erfasstes menschliches Verhalten zu nutzen, um bessere Produkte und Services zu bauen. Google machte es Werbetreibenden leicht, über Google AdWords Anzeigen zu kaufen, und das Modell hinter AdWords basierte nicht auf einer Theorie darüber, ob jemand klickt oder nicht. Google hatte schlicht genug Daten für eine „gut genug“-Prognose. Chris Andersons steile These lautete: Big Data enthält so viele Informationen, dass wir die Welt nicht mehr modellieren müssen—und weder die zugrunde liegende Theorie noch das eigentliche Geschehen verstehen müssen.
Hat Big Data diese Versprechen eingelöst? Eine Möglichkeit, darüber nachzudenken, ist der Gartner Hype Cycle.
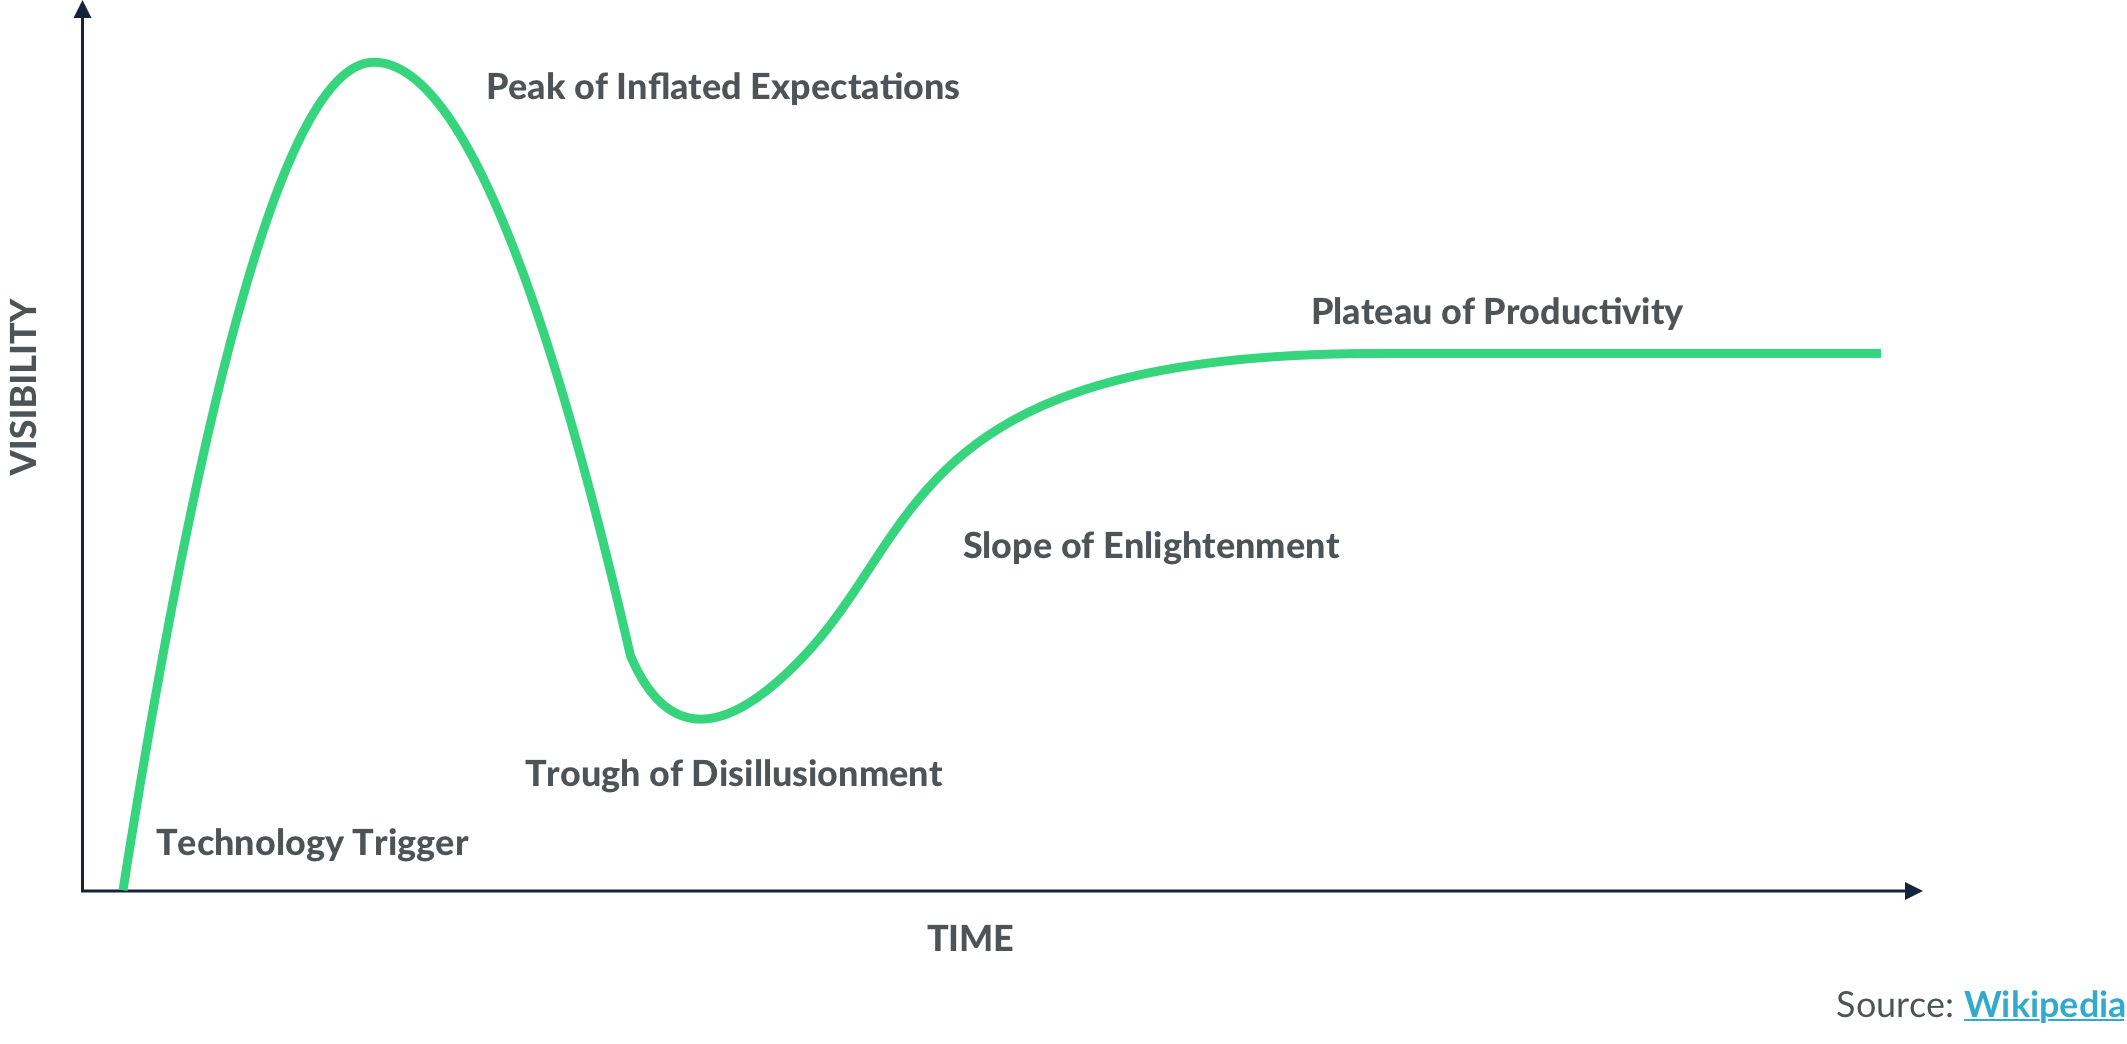
Der Gartner Hype Cycle beschreibt technologische Innovationen und die Erwartungen daran im Zeitverlauf. Er beginnt mit einem Innovation Trigger, bei Big Data war das die Fähigkeit, große Datenmengen zu speichern, zu übertragen und zu analysieren. Dann steigt die Aufregung und führt zu überhöhten Erwartungen. Danach bleibt der erwartete Nutzen aus, und wir rutschen in das Tal der Enttäuschungen. Erst anschließend zeigt sich der reale Mehrwert in mehreren Branchen—wir gelangen auf den Pfad der Erleuchtung.
Wo steht Big Data aktuell im Gartner Hype Cycle? Ein Blick auf die Erwartungen lässt sich über Google-Suchtrends im Zeitverlauf gewinnen. Unten siehst du die Google-Trends für „big data“ seit 2004. Man erkennt: Chris Anderson war seiner Zeit voraus—aber er lag falsch mit der Idee, Big Data sei das Ende der Theorie, denn Small Data und Thick Data sind entscheidend.
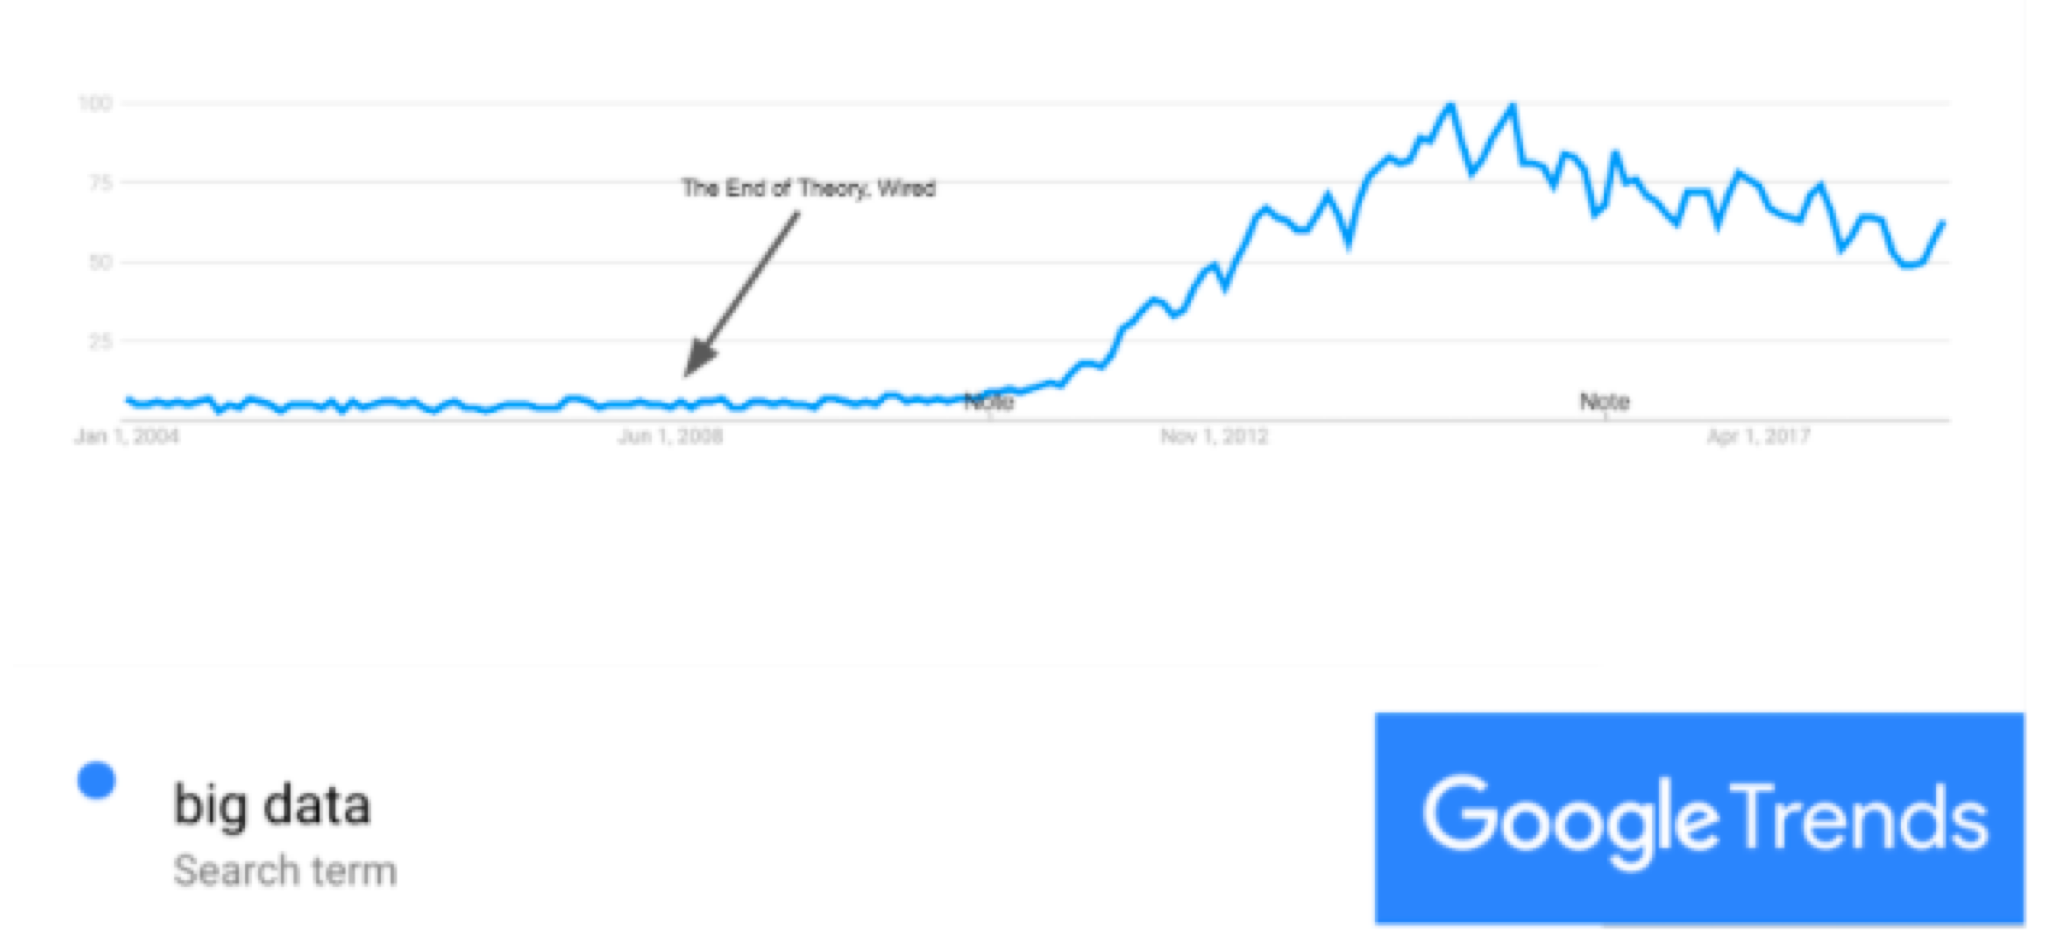
Nimmt man den Gartner Hype Cycle als valides Modell und Google-Trends als Stellvertreter für Erwartungen, dann lag der Gipfel der überzogenen Erwartungen etwa 2014—und wir haben das Tal der Enttäuschungen noch nicht zwingend erreicht.
Small Data hat es in sich
Viele der jüngsten Innovationen in der Data Science drehen sich darum, immer größere Datenmengen effizient zu verarbeiten. Trotzdem passt der Großteil der in der Praxis analysierten Daten in den Arbeitsspeicher eines modernen Laptops. Als Business-Verantwortliche:r solltest du genau prüfen, was deine Datenorganisation braucht, bevor du Tools und Architekturen auswählst.
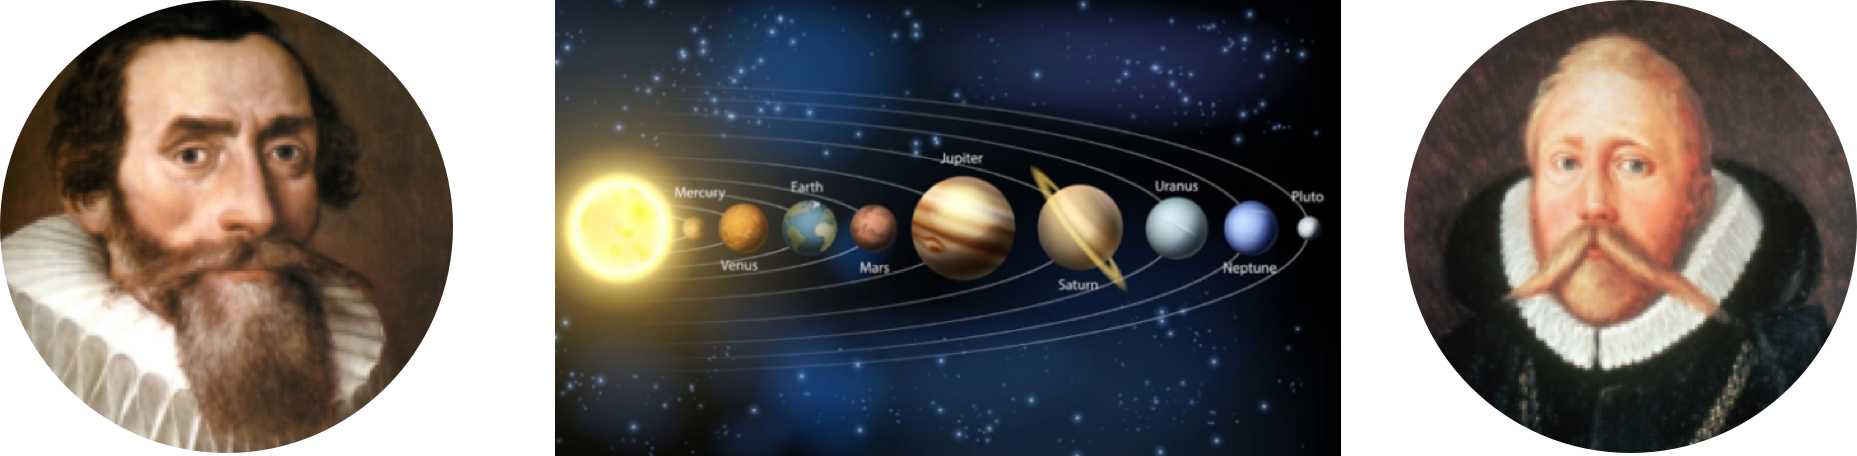
Zurück in die Vergangenheit: Johannes Kepler entdeckte die drei Keplerschen Gesetze der Planetenbewegung, basierend auf Daten des dänischen Astronomen Tycho Brahe. Aus diesen Daten entwickelte Kepler seine Gesetze, die wiederum Newtons Gravitationstheorie beeinflussten. Ein riesiger Wissensschatz entstand aus Brahes Datensatz von rund 2.000 Messpunkten. Winzig im Vergleich zu heutigen Datensätzen mit Hunderten Millionen Punkten—aber von hoher Qualität. Mit guten, sauber erhobenen Daten, soliden analytischen und theoretischen Modellen sowie statistischem Handwerkszeug kannst du enorm viel aus Daten herausholen.
Ein weiteres Beispiel bespricht Andrew Gelman in How can a poll of only 1,004 Americans represent 260 million people with only a 3 percent margin of error?. Gelman zeigt rechnerisch: Je mehr Daten du hinzufügst, desto stärker nehmen die Ertragszuwächse bei der Fehlermarge ab. Hinweis: Das gilt nur bei einer gewissen Repräsentativität der Stichprobe, was bei Umfragen oft nicht gegeben ist. Doch Statistiker:innen verfügen heute über ausgefeilte Korrekturverfahren für nicht-repräsentative Stichproben, um etwa Wahlpräferenzen einer größeren Population zu erschließen.
Auch hier liefert eine kleine Datenmenge aussagekräftige Ergebnisse über menschliches Verhalten und Präferenzen. Im Business ist es ähnlich—es geht darum, zukünftiges Verhalten von Stakeholdern zu verstehen und vorherzusagen. Warum reden wir dann so viel über Big Data, wenn es oft nicht nötig ist? Vor allem, weil große Datenmengen heute leicht verfügbar und gut berechenbar sind.
Das Fazit bringt die Harvard Business Review in Sometimes „Small Data“ Is Enough to Create Smart Products auf den Punkt: „Es geht nicht um Datenberge, sondern um kleine, hochpräzise Daten.“
Die Kraft von Thick Data
Nachdem wir über die Stärke von Small Data gesprochen haben, geht es nun um Thick Data, also qualitative Daten. Dünne Daten sind Zahlen und Tabellen; Thick Data, ein Begriff aus Soziologie und Anthropologie, ist qualitativer und beschreibender. Die Beratung ReD Associates hat eindrucksvoll gezeigt, wie sich mit Thick Data Analyse- und Machine-Learning-Modelle verbessern lassen.
Ein Beispiel ist ihre Arbeit zur Erkennung von Kreditkartenbetrug. Ein großes Problemfeld, in dem Machine Learning traditionell Merkmale wie Transaktionsbetrag, -zeit, Ort usw. nutzt. ReD Associates sammelte Thick Data und wählte dafür einen soziologischen Ansatz.
Dazu sprachen sie direkt mit Kreditkartenbetrüger:innen, um deren Arbeitsweisen zu verstehen. Sie fanden Communities im Darknet und trafen sich mit Mitgliedern persönlich, um Prozesse und Gewohnheiten zu lernen.
Sie entdeckten: Das größte Entdeckungsrisiko entsteht, wenn Betrüger:innen in der physischen Welt handeln müssen—zum Beispiel bei der Abholung von Lieferungen. Online sind sie meist so versiert, dass sie kaum auffallen. Auch offline agieren sie vorsichtig: Pakete gehen selten an die eigene Adresse, die Arbeit oder Freund:innen. Stattdessen wählen sie Adressen leerstehender oder zum Verkauf stehender Immobilien.
Mit diesem Wissen baute ReD Associates ein Betrugserkennungsmodell, das die Lieferadresse als Merkmal nutzte und diese mit öffentlichen Daten zu leerstehenden und am Markt befindlichen Häusern verknüpfte. Das qualitativ informierte Modell steigerte die Genauigkeit im Vergleich zu herkömmlichen Modellen für Betrugstransaktionen deutlich. Ein starkes Beispiel für den Wert von Thick Data und dafür, wie ein soziologischer Blick messbaren Mehrwert schafft. Empfehlenswert dazu: The Power of 'Thick' Data und Big Data Is Only Half the Data Marketers Need.
Thick Data in deinen Analysen nutzen
Wähle eine Datenquelle, die für dein Geschäft wertvoll ist, und überlege, wie viel davon du wirklich für Entscheidungen brauchst. Ein Ansatz: Schätze den Zusatznutzen ab, wenn du die Datenmenge um das 2-, 5- und 10-Fache erhöhst—insbesondere im Verhältnis zu Aufwand für Erhebung, Speicherung und Analyse. Beantworte dann die Frage: Welche Thick Data könntest du nutzen, um die Qualität dieser Datenquelle zu steigern?
Mehr Best Practices zum Einsatz von Daten findest du im The Definitive Guide to Machine Learning for Business Leaders.




