बिग डेटा क्या है?
डेटा क्षेत्र में बिग डेटा सबसे चर्चा में रहने वाले शब्दों में से एक है। लेकिन आखिर कितना बड़ा है “बिग”? इसे समझने का एक तरीका मात्रा के संदर्भ में सोचना है—यानी आपके पास कितना डेटा है। मात्रा के आधार पर, हम बिग डेटा को उस डेटा के रूप में परिभाषित कर सकते हैं जो आधुनिक लैपटॉप या हार्ड ड्राइव पर संग्रहीत करने की क्षमता से बहुत अधिक हो। इसलिए, इसके साथ काम करने, प्रसारित करने और विश्लेषण करने के लिए इसे कंप्यूटरों के क्लस्टरों में वितरित करना पड़ता है। हम बिग डेटा की इस परिभाषा को तीन V तक बढ़ा सकते हैं: वॉल्यूम, वेलोसिटी, और वराइटी।
- वॉल्यूम: डेटा की मात्रा
- वेलोसिटी: डेटा को कितनी तेजी से स्थानांतरित और विश्लेषित किया जा सकता है
- वराइटी: आपके पास मौजूद डेटा के विभिन्न प्रकार
क्या बिग डेटा सिद्धांत का अंत है?
2008 में, क्रिस एंडरसन ने Wired में एक उत्तेजक लेख लिखा, The End of Theory, The Data Deluge Makes the Scientific Method Obsolete। उनका तर्क था कि हमारे पास दुनिया के बारे में पर्याप्त भविष्यवाणियाँ करने लायक इतना डेटा है कि दुनिया को समझने के लिए सिद्धांत की आवश्यकता नहीं रहती। ऐसे तर्कों के पीछे आंशिक प्रेरणा Google के साथ हो रही प्रगति थी—वे विशाल मात्रा में डेटा पर काम करके प्रोग्रामैटिक ऐड बाइंग के लिए डेटा प्रोडक्ट्स के रूप में भविष्यसूचक मॉडल प्रदान कर पा रहे थे। इसके अलावा, वे अध्ययनाधीन सिस्टम को समझे या उसके बारे में सिद्धांत गढ़े बिना ही पर्याप्त उन्नत भविष्यवाणी विश्लेषिकी से यह कर रहे थे।
यह सब बेहतर उत्पादों और सेवाओं के निर्माण के लिए कैप्चर किए गए मानवीय व्यवहार के उपयोग के बारे में था। Google ने उन लोगों को जो विज्ञापन खरीदना चाहते थे, Google AdWords पर आसानी से विज्ञापन खरीदने में सक्षम बनाया, और AdWords के पीछे का मॉडल इस सिद्धांत पर निर्भर नहीं था कि कोई क्लिक करेगा या नहीं। Google के पास “काफी अच्छा” अनुमान लगाने के लिए बस इतना डेटा था। क्रिस एंडरसन का उकसाने वाला अनुमान यह था कि बिग डेटा में इतना ज्यादा जानकारी होती है कि अब हमें दुनिया का मॉडल बनाने की जरूरत नहीं, और न ही इसके पीछे के सिद्धांत या वास्तविकता में क्या हो रहा है, यह समझने की।
क्या बिग डेटा ने वास्तव में हमें किए गए वादे पूरे कर दिए हैं? इसे समझने का एक तरीका Gartner Hype Cycle पर इसे मॉडल करना है।
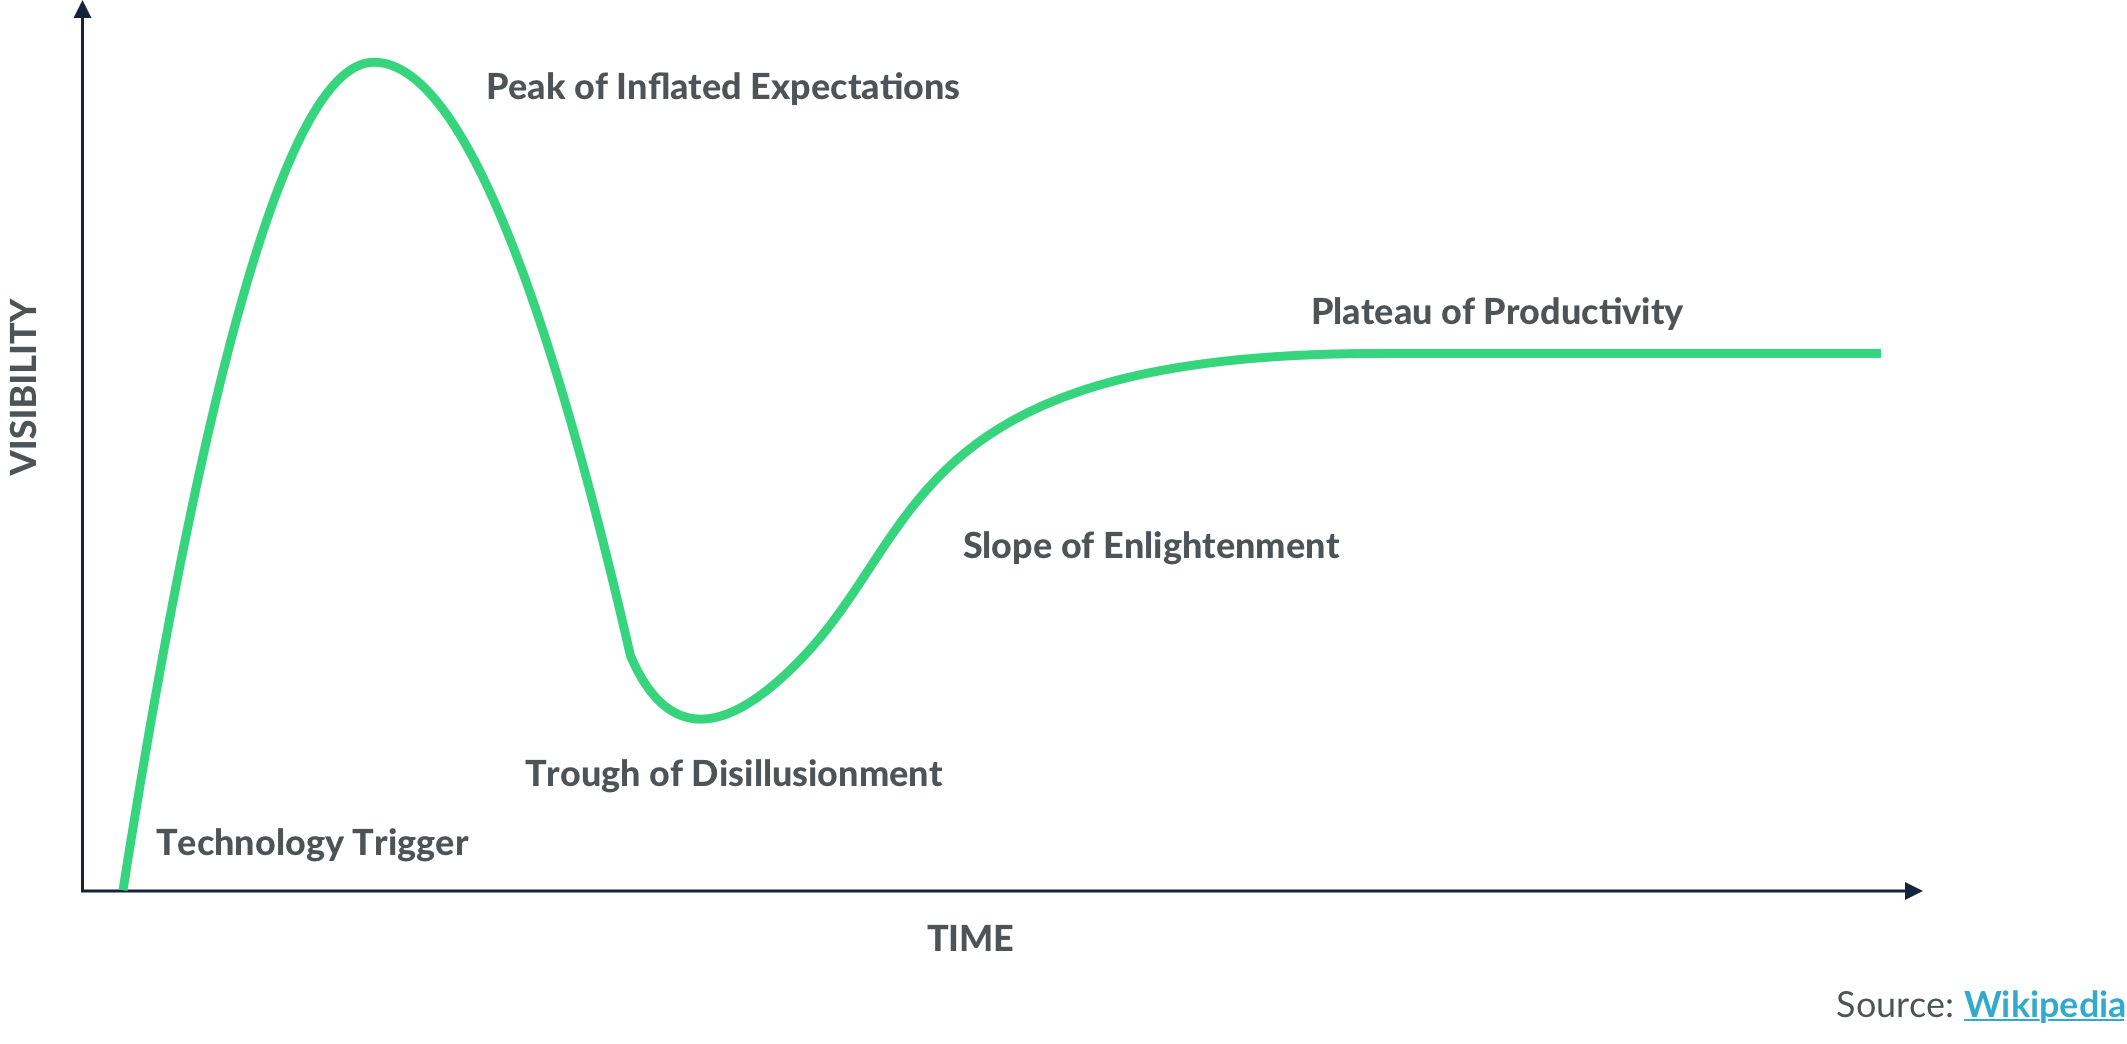
Gartner Hype Cycle हमें किसी तकनीकी नवाचार और समय के साथ उससे जुड़ी अपेक्षाओं के बारे में बताता है। हम Innovation Trigger से शुरू करते हैं, जो बिग डेटा के मामले में बड़े पैमाने पर डेटा को संग्रहीत, प्रसारित और विश्लेषित करने की क्षमता थी। फिर लोग इसके बारे में उत्साहित हो जाते हैं, जिससे Inflated Expectations पैदा होती हैं। उसके बाद, अपेक्षाओं के अनुरूप मूल्य नहीं दिखता, तो हम Trough of Disillusionment में प्रवेश करते हैं। और केवल इसके बाद हम देखते हैं कि वास्तविक मूल्य अलग-अलग क्षेत्रों में देना शुरू होता है—और हम Slope of Enlightenment में प्रवेश करते हैं।
Gartner Hype Cycle में बिग डेटा अभी कहाँ है? अपेक्षाओं के बारे में सोचने का एक तरीका यह देखना है कि समय के साथ लोग Google पर क्या खोज रहे हैं। नीचे 2004 से “big data” के लिए Google ट्रेंड्स हैं। आप देख सकते हैं कि क्रिस एंडरसन अपने समय से आगे थे—लेकिन छोटे डेटा और थिक डेटा के महत्व के कारण बिग डेटा को सिद्धांत का अंत मानने में वे गलत थे।
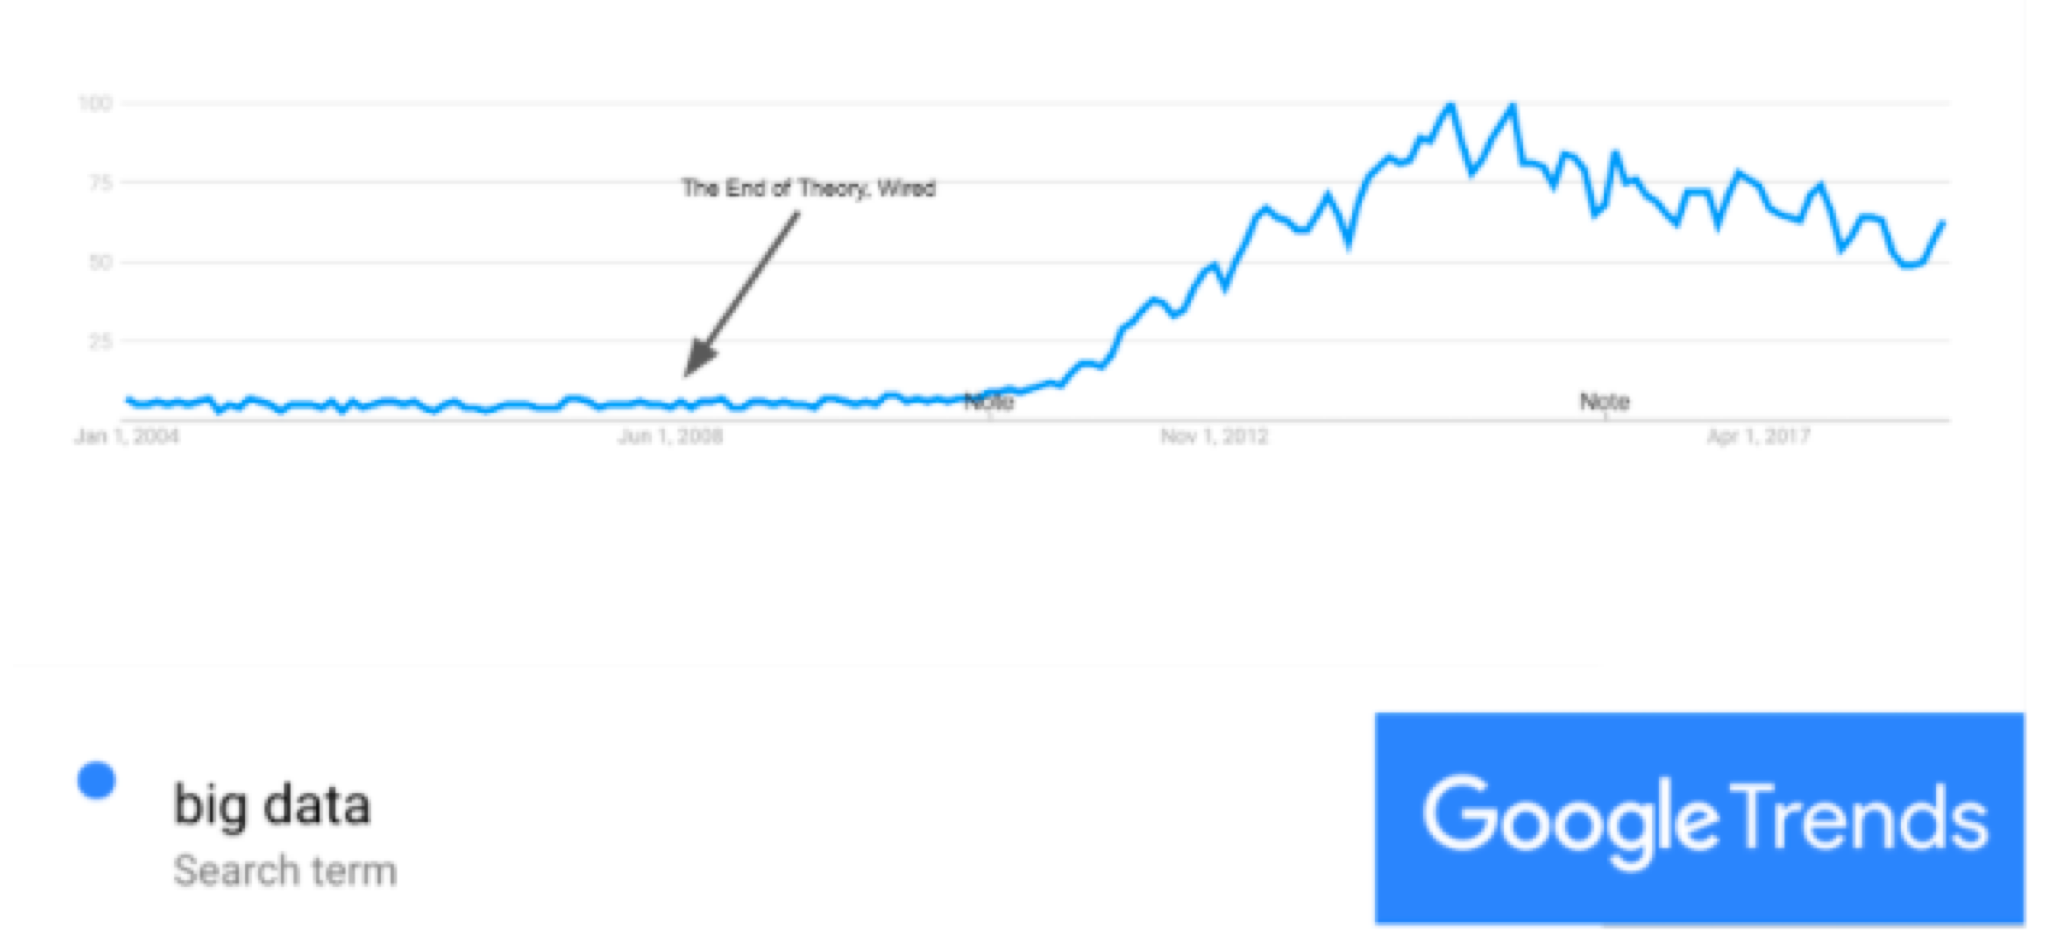
यदि हम बिग डेटा के बारे में सोचने के लिए Gartner Hype Cycle को एक वैध मॉडल मानते हैं, और यदि हम Google ट्रेंड्स को अपेक्षाओं का प्रॉक्सी मानते हैं, तो हम देख सकते हैं कि Peak of Inflated Expectations लगभग 2014 के आसपास था और हम अभी जरूरी नहीं कि Trough of Disillusionment तक पहुँचे हों।
छोटा डेटा भी शक्तिशाली है
हाल के डेटा साइंस नवाचारों का बड़ा हिस्सा हमारी यह क्षमता केंद्रित रहा है कि हम तेजी से बढ़ती डेटा मात्राओं को कुशलता से संभाल सकें, लेकिन यह पहचानना महत्वपूर्ण है कि वास्तविक दुनिया में विश्लेषित किया जाने वाला अधिकांश डेटा आधुनिक लैपटॉप की मेमोरी में समा जाता है। एक व्यवसायिक नेता के रूप में, आपको यह तय करने से पहले कि किन उपकरणों और आर्किटेक्चर्स को अपनाना है, अपनी डेटा संगठन की आवश्यकताओं पर सावधानी से विचार करना चाहिए।
मैं आपको समय में पीछे ले जाना चाहता हूँ—जोहान्स केपलर, जिन्होंने ग्रहों की गति के तीन नियम खोजे, और टाइको ब्राहे, एक डेनिश खगोलशास्त्री जिन्होंने वह डेटा एकत्र किया जिसे केपलर ने अपने तीन गति नियम स्थापित करने के लिए विश्लेषित किया, जो आगे चलकर न्यूटन के गुरुत्वाकर्षण सिद्धांत का आधार बने। हमारे पास ब्राहे द्वारा एकत्र किए गए डेटा से विकसित वैज्ञानिक ज्ञान की भारी मात्रा है, जो कुल मिलाकर लगभग 2,000 डेटा बिंदुओं का था। यह आज की उन डाटासेट्स की तुलना में बहुत छोटा है जिनमें कभी-कभी सैकड़ों मिलियन डेटा बिंदु होते हैं। लेकिन ब्राहे द्वारा एकत्र किया गया डेटा उच्च गुणवत्ता का था। यदि आपके पास अच्छा, व्यवस्थित रूप से एकत्र किया गया डेटा है, सशक्त विश्लेषणात्मक और सिद्धांत-आधारित मॉडल हैं, और सांख्यिकीय मॉडलिंग का पक्का तरीका है, तो आप अपने डेटा से अत्यधिक मूल्य निकाल सकते हैं।
आइए एक और उदाहरण देखें, जिसे एंड्रू गेलमैन के लेख How can a poll of only 1,004 Americans represent 260 million people with only a 3 percent margin of error? में खोजा गया है। गेलमैन गणित के माध्यम से दिखाते हैं कि जब आप डेटा की मात्रा बढ़ाते हैं, तो त्रुटि-सीमा में कमी पर लाभ तेजी से घटते जाते हैं। अस्वीकरण: यह परिणाम तभी सही है जब आपके पास अपनी जनसंख्या का किसी प्रकार का प्रतिनिधिक सैम्पलिंग हो, जो सर्वेक्षणों में निश्चित रूप से हमेशा नहीं होता। लेकिन आँकड़ाशास्त्रियों के पास अब गैर-प्रतिनिधिक नमूनों के लिए परिष्कृत सुधार विधियाँ हैं, जिनका उपयोग वे बड़े जनसमुदाय की मतदान वरीयताओं को समझने के लिए कर सकते हैं।
फिर से, हम कम डेटा से एक उल्लेखनीय परिणाम देखते हैं, जो हमें मानवीय व्यवहार और प्राथमिकताओं की प्रकृति के बारे में बताता है। यही सिद्धांत व्यवसाय पर भी लागू होता है—यह आपके हितधारकों के संदर्भ में विशेष रूप से भविष्य के मानवीय व्यवहार को समझने और उसका पूर्वानुमान लगाने के बारे में है। तो जब यह आवश्यक नहीं है, तब भी हम बिग डेटा के बारे में इतना क्यों बात करते हैं? एक प्रमुख कारण यह है कि आजकल यह आसानी से सुलभ और इसीलिए कम्प्यूटेबल हो गया है।
निष्कर्ष वही है जो Harvard Business Review ने Sometimes “Small Data” Is Enough to Create Smart Products में कहा—“मुद्दा डेटा के पहाड़ नहीं, बल्कि छोटे, उच्च-प्रेसिजन डेटा का है।”
थिक डेटा की ताकत
अब जब हमने छोटे डेटा की शक्ति पर बात कर ली है, तो मैं एक और प्रकार के डेटा पर आना चाहता हूँ जिसे थिक डेटा या गुणात्मक डेटा कहा जाता है। थिन डेटा में संख्याएँ और तालिकाएँ शामिल होती हैं, जबकि थिक डेटा—जो समाजशास्त्र और नृविज्ञान से आया शब्द है—अधिक गुणात्मक और वर्णनात्मक होता है। ReD Associates नामक एक कंसल्टिंग समूह ने थिक डेटा का उपयोग करके विश्लेषणात्मक मॉडल और मशीन लर्निंग मॉडल बनाने में लोगों की मदद करने का बेहतरीन काम किया है।
एक उदाहरण जो मैं उल्लेख करना चाहता हूँ वह है उनका क्रेडिट कार्ड धोखाधड़ी का पता लगाने में किया गया काम। यह एक बहुत बड़ी चुनौती है और अतीत में लेनदेन की राशि, समय, स्थान आदि जैसे फीचर्स का उपयोग करके मशीन लर्निंग से क्रेडिट कार्ड धोखाधड़ी का पता लगाया गया है। ReD Associates ने इस समस्या को हल करने के लिए समाजशास्त्रीय दृष्टिकोण अपनाते हुए थिक डेटा एकत्र करने का प्रयास किया।
इसके लिए, ReD Associates ने क्रेडिट कार्ड धोखेबाजों से मिलकर समझा कि वे वास्तव में क्या करते हैं और उनके प्रोसेस कैसे होते हैं। उन्होंने डार्क वेब पर क्रेडिट कार्ड धोखेबाजों का एक समुदाय पाया और उनकी प्रक्रियाओं और आदतों के बारे में जानने के लिए वास्तविक जीवन में उनसे मुलाकात की।
उन्होंने पाया कि वह बिंदु जब क्रेडिट कार्ड धोखेबाजों के पकड़े जाने की संभावना सबसे अधिक होती है, वह है जब उन्हें वास्तविक दुनिया में कुछ करना पड़ता है—जैसे डिलीवरी उठाना। वे ऑनलाइन इतनी तकनीक-सक्षम होते हैं कि शायद ही कभी पकड़ में आते हैं। और धोखेबाज भौतिक दुनिया में भी सावधान रहते हैं—वे आम तौर पर पार्सल अपने पते, अपने कार्यस्थल के पते, या अपने मित्रों के पते पर नहीं भिजवाते। इसके बजाय, वे डिलीवरी ऐसे पते पर भेजते हैं जहाँ की संपत्तियाँ खाली पड़ी हों या रियल एस्टेट बाजार में हों।
इस ज्ञान से लैस होकर, ReD Associates ने एक क्रेडिट कार्ड धोखाधड़ी पहचान मॉडल बनाया जिसमें फीचर के रूप में उस स्थान को शामिल किया गया जहाँ पार्सल भेजा जा रहा था, और इसे परित्यक्त घरों और बाजार में उपलब्ध घरों के बारे में सार्वजनिक रूप से उपलब्ध डेटा से जोड़ा। उन्होंने देखा कि इस गुणात्मक डेटा पर आधारित मॉडल ने धोखाधड़ी वाले लेनदेन के पारंपरिक मॉडलों की तुलना में सटीकता में उल्लेखनीय बढ़त हासिल की। यह थिक डेटा के महत्व और इस बात का बेहतरीन उदाहरण है कि समाजशास्त्रीय दृष्टिकोण अपनाने से कैसे अतिरिक्त मूल्य मिल सकता है। मैं इन दो लेखों की सिफारिश करता हूँ ताकि आप विस्तार से जान सकें कि अच्छे गुणवत्ता वाले डेटा का महत्व बिग डेटा से अधिक क्यों है: The Power of 'Thick' Data और Big Data Is Only Half the Data Marketers Need।
अपनी विश्लेषण में थिक डेटा का उपयोग
अपने व्यवसाय के लिए मूल्यवान किसी डेटा स्रोत को चुनें और सोचें कि निर्णय लेने में सूचित करने के लिए आपको वास्तव में इस डेटा की कितनी आवश्यकता है। इसका आकलन करने का एक तरीका यह है कि संग्रह, संग्रहण और विश्लेषण में निवेश के संदर्भ में मात्रा को 2X, 5X और 10X बढ़ाने से मिलने वाले अतिरिक्त मूल्य पर विचार करें। फिर यह प्रश्न उत्तर दें: इस डेटा स्रोत की गुणवत्ता बढ़ाने के लिए आप कौन सा थिक डेटा उपयोग कर सकते हैं?
डेटा का लाभ उठाने के सर्वोत्तम तरीकों के बारे में और जानें: The Definitive Guide to Machine Learning for Business Leaders।
