
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Toen ik net met SQL Server begon te werken, merkte ik dat niet alle trage queries hetzelfde waren. Sommige waren traag door slecht ontwerp, andere waren gewoon inefficiënt. Maar één ontdekking veranderde voorgoed mijn aanpak van databaseprestaties: indexes. Stel je voor dat je in een enorm studieboek een specifiek hoofdstuk moet vinden zonder index; je zou door honderden pagina’s bladeren en kostbare tijd verspillen. Dat is precies wat er in databases gebeurt zonder goede indexering.
In dit artikel leg ik uit waarom SQL Server-indexes belangrijk zijn, hoe ze werken en hoe je ze kunt inzetten om de prestaties van je databases te maximaliseren. Wil je je SQL-vaardigheden in SQL Server verder ontwikkelen? Bekijk dan onze cursussen Introduction to SQL Server en Intermediate SQL Server om T-SQL te leren voor datamanipulatie en -analyse.
Met SQL Server-indexes kun je tabellen efficiënt bevragen zonder complete datasets te hoeven scannen. Hieronder vind je de definitie van SQL Server-indexes en hun belang in databasebeheer.
Indexes zijn gespecialiseerde datastructuren waarmee SQL Server rijen efficiënter kan lokaliseren en ophalen, wat tijd en rekenkracht bespaart. Indexes organiseren data zó dat zoeken sneller gaat. In plaats van de hele tabel rij voor rij te scannen (een zogeheten table scan), kan SQL Server de index gebruiken om de benodigde rijen veel sneller te vinden dan wanneer elke tabelinvoer apart moet worden doorzocht.
Er zijn twee fundamentele typen indexes in SQL Server:
Geclusterde indexes: Een geclusterde index bepaalt de fysieke volgorde van data in een tabel. Als je een geclusterde index op een tabel maakt, worden de rijen op schijf opgeslagen in de volgorde van de geïndexeerde kolom. Dit is vooral gunstig voor bereikqueries, omdat het sequentiële toegang tot rijen efficiënt maakt.
Niet-geclusterde indexes: Niet-geclusterde indexes beïnvloeden de fysieke volgorde van de data niet. Ze creëren in plaats daarvan een aparte structuur met verwijzingen naar de daadwerkelijke datarijen. Niet-geclusterde indexes zijn handig om de prestaties te verbeteren van queries die filteren of sorteren op kolommen die niet in de geclusterde index zitten.
Bekijk onze SQL Server Tutorial om het gebruik van SQL Server van basis tot gevorderd in databeheer te begrijpen.
Indexes zijn belangrijk om queryprestaties en de algehele database-efficiëntie te verbeteren. Dit zijn enkele belangrijke voordelen:
Snellere query-uitvoering: Indexes verkorten de tijd die nodig is om data te vinden en op te halen. Zoek je bijvoorbeeld alle orders van een specifieke klant in een tabel met miljoenen rijen, dan kan een index op de klantkolom SQL Server die rijen bijna direct laten vinden.
Efficiënt gebruik van resources: Met indexes kan SQL Server taken afronden met minder CPU- en geheugengebruik. Die efficiëntie vertaalt zich in betere systeemprestaties, vooral bij zware werkbelasting.
Verbeterd sorteren en groeperen: Indexes kunnen bewerkingen versnellen waarbij sorteren (ORDER BY) en groeperen (GROUP BY) komt kijken. Doordat indexes gesorteerde data bijhouden, kan SQL Server snel resultaten ophalen zonder extra sorteeroverhead.
Denk aan deze usecase voor indexering. Stel je een groot e-commerceplatform voor waar gebruikers vaak op productnaam zoeken. Door een niet-geclusterde index op de kolom met productnaam te maken, worden die zoekopdrachten vrijwel direct, wat de gebruikerservaring verbetert en de serverbelasting verlaagt.
Ik raad aan om de skill track SQL Server Fundamentals van DatCamp te bekijken om te leren over sorteren, groeperen en joinen van tabellen voor data-analyse.
Er zijn verschillende typen SQL Server-indexes, elk met unieke kenmerken en toepassingen. Laten we de meest voorkomende typen bespreken.
De twee primaire typen indexes in SQL Server zijn geclusterde en niet-geclusterde indexes.
Een geclusterde index bepaalt de fysieke volgorde van rijen in een tabel en sorteert de tabel effectief op de indexkolom(men). Omdat data fysiek maar op één manier geordend kan zijn, kan een tabel slechts één geclusterde index hebben. Een geclusterde index is ideaal voor queries die een waardenbereik retourneren of data op de geïndexeerde kolom moeten sorteren.
Zo kan een verkoopstabel die is gesorteerd op OrderDate profiteren van een geclusterde index op de kolom OrderDate. Queries die alle orders binnen een datumbereik ophalen, worden dan veel sneller uitgevoerd.
Een niet-geclusterde index maakt een aparte structuur die verwijst naar de daadwerkelijke rijen in de tabel. Een tabel kan meerdere niet-geclusterde indexes hebben, elk bruikbaar voor een ander querypatroon. Niet-geclusterde indexes bevatten een verwijzing (rijlocator) naar de daadwerkelijke data, bijvoorbeeld een rij-ID of een sleutel uit de geclusterde index. Dit type index pas je toe op kolommen die vaak in zoekcondities of joins worden gebruikt (bijv. EmailAddress, ProductName).
Een niet-geclusterde index op de kolom ProductName van een voorraadtabel versnelt bijvoorbeeld het zoeken naar specifieke producten zonder de structuur van de tabel te wijzigen.
SQL Server ondersteunt ook unieke en samengestelde indexes, elk met een specifiek doel.
Een unieke index zorgt ervoor dat alle waarden in de geïndexeerde kolom(men) verschillend zijn. Dit handhaaft dataintegriteit door dubbele waarden te voorkomen en wordt vaak toegepast op kolommen met natuurlijke uniciteit, zoals e-mailadressen of gebruikersnamen. Een unieke index op de kolom Email van een gebruikers tabel voorkomt bijvoorbeeld dat twee gebruikers hetzelfde e-mailadres hebben.
Een samengestelde index beslaat meerdere kolommen en optimaliseert queries die filteren of sorteren op een combinatie van die kolommen. De kolomvolgorde in de samengestelde index is belangrijk; SQL Server verwerkt eerst de meest linkse kolom. Samengestelde indexes ondersteunen complexe queries met meerdere voorwaarden. Een samengestelde index op LastName en FirstName in een klantentabel versnelt bijvoorbeeld het zoeken naar klanten op hun volledige naam.
We gebruiken SQL Server Management Studio (SSMS) om een index in SQL Server te maken. Voordat ik verder ga, lees onze blog om de verschillen tussen de dialecten SQL Server, PostgreSQL en MySQL te begrijpen. Ik behandel de stappen voor het maken en beheren van SQL Server-indexes.
Hieronder vind je een stapsgewijze handleiding voor het maken van indexes met zowel SQL Server Management Studio (SSMS) als SQL-code.
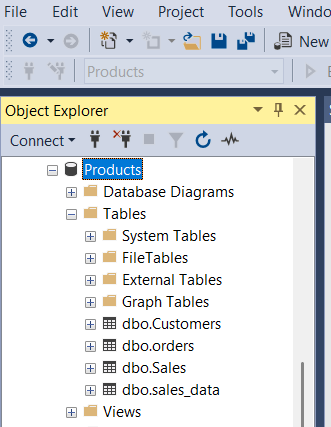
Open Object Explorer en navigeer naar de tabel om de index te maken. Afbeelding door de auteur.
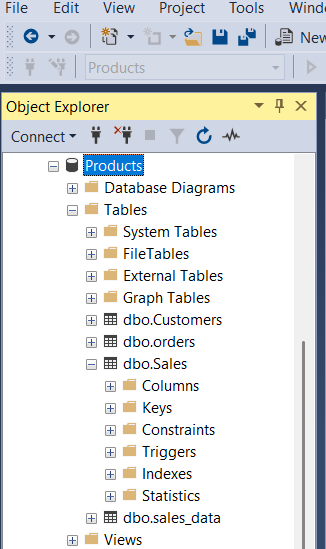
Zoek de tabel om de index te maken en vouw deze uit. Afbeelding door de auteur.
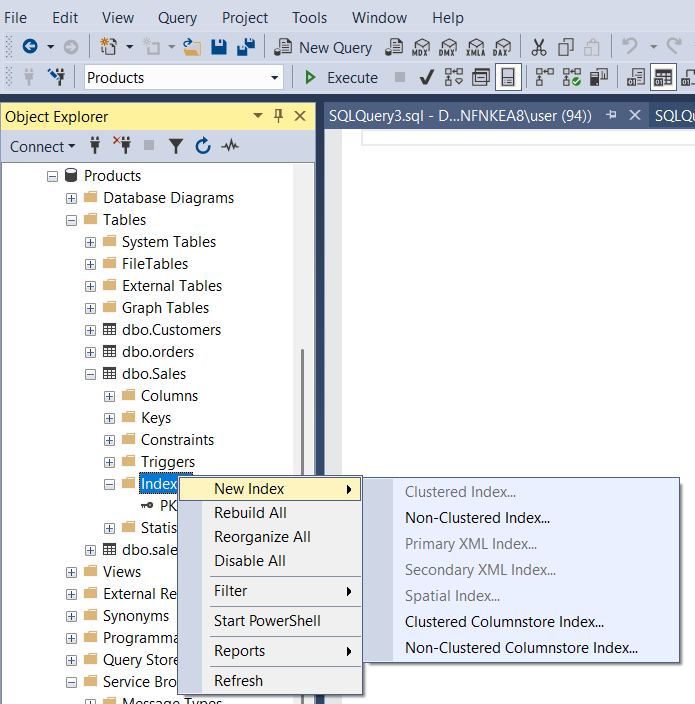
Open de map Indexes en klik met de rechtermuisknop om een nieuwe index te maken. Afbeelding door de auteur.
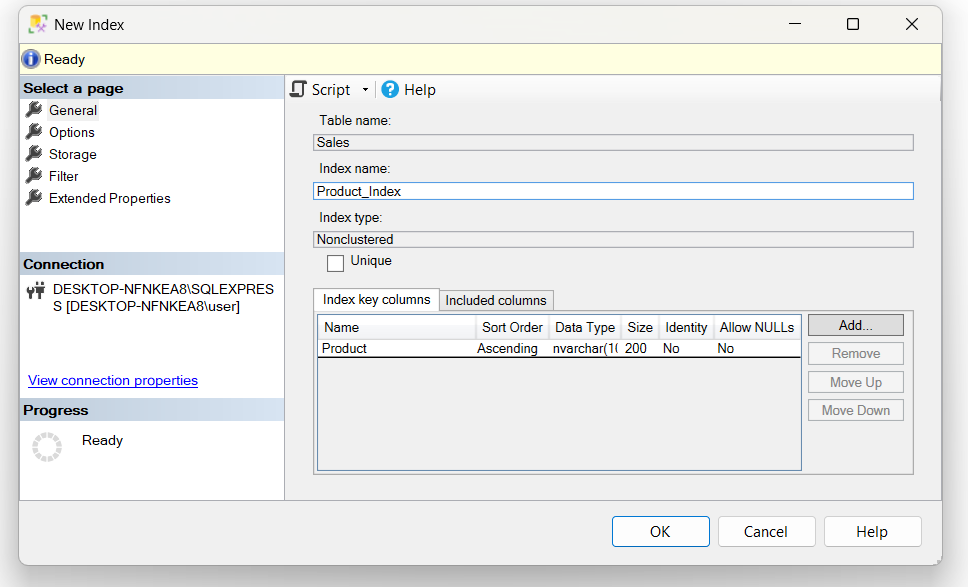
Kies het indextype en definieer de eigenschappen. Afbeelding door de auteur.
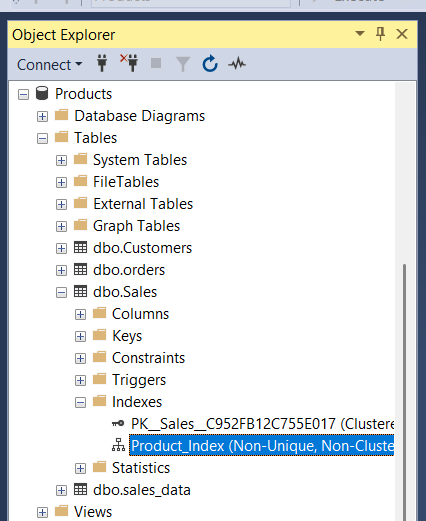
Maak de index door op OK te klikken. Afbeelding door de auteur.
Je kunt indexes ook rechtstreeks aanmaken met T-SQL-opdrachten. Hieronder staan voorbeelden van het maken van verschillende typen indexes met queries:
-- Create a non-clustered index on the Product column
CREATE NONCLUSTERED INDEX IX_Sales_Product
ON Sales (Product);

-- Create a unique index on the combination of CustomerName and OrderDate
CREATE UNIQUE NONCLUSTERED INDEX IX_Sales_CustomerName_OrderDate
ON Sales (CustomerName, OrderDate);

-- Create a clustered index on the OrderDate column
CREATE CLUSTERED INDEX IX_Sales_OrderDate
ON Sales (OrderDate);Je kunt een index op een eenvoudige manier verwijderen. Wees voorzichtig, want het weghalen van een index kan invloed hebben op de queryprestaties.
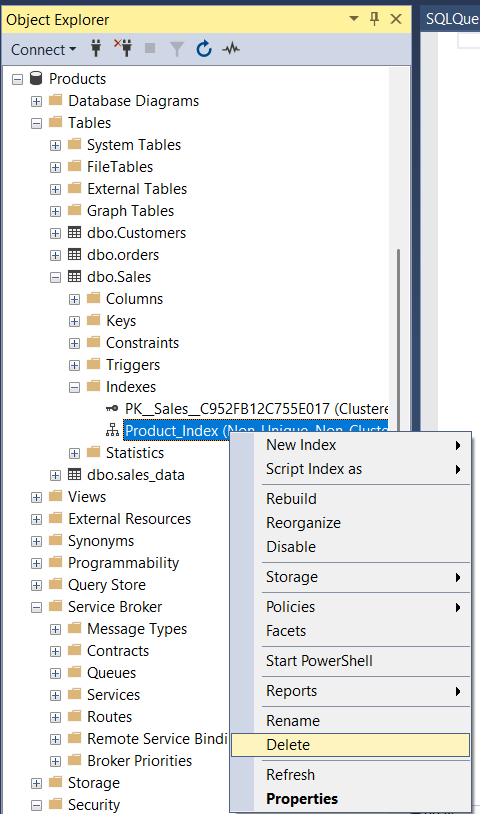
Navigeer naar de index die je wilt verwijderen. Afbeelding door de auteur.
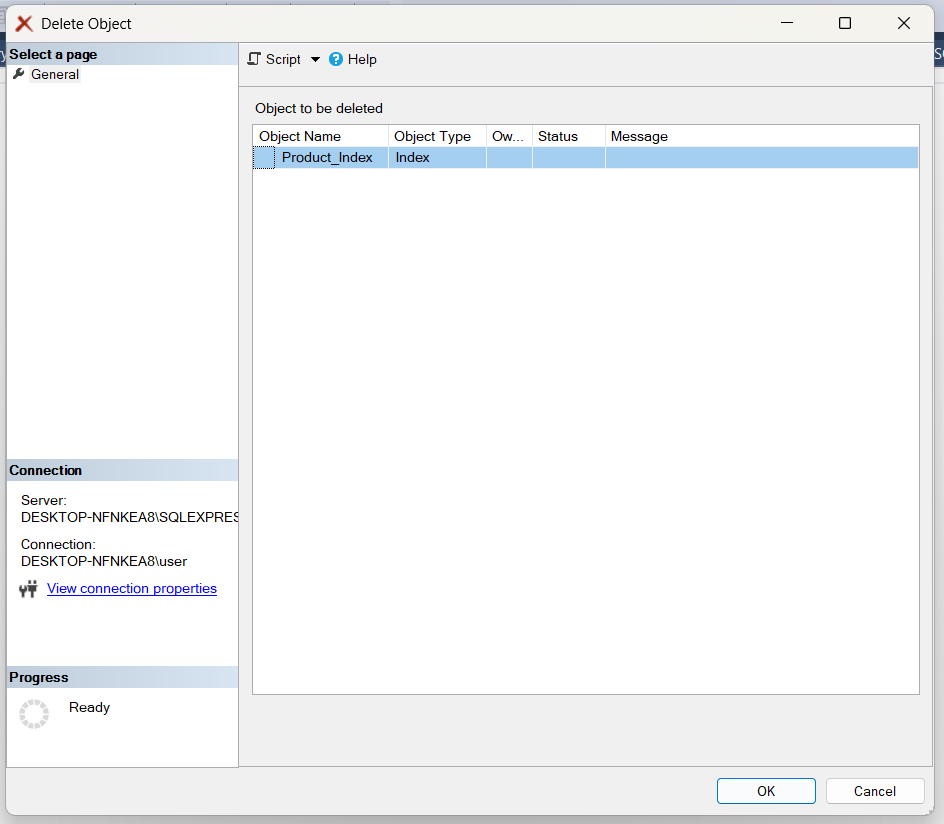
Bevestig de verwijdering in het dialoogvenster en klik op OK. Afbeelding door de auteur.
Je kunt de volgende opdrachten gebruiken om bestaande indexes van een tabel in SQL Server te verwijderen.
-- Drop a non-clustered index
DROP INDEX IX_Sales_Product ON Sales;

-- Drop a clustered index
DROP INDEX IX_Sales_OrderDate ON Sales;Het reorganiseren van een index defragmenteert de leaflevel-pagina’s van de index en verbetert de prestaties zonder een volledige heropbouw.
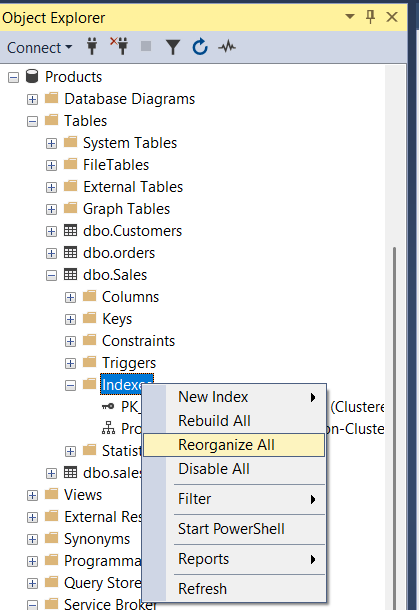
Klik met de rechtermuisknop op Indexes en kies Reorganize All. Afbeelding door de auteur.
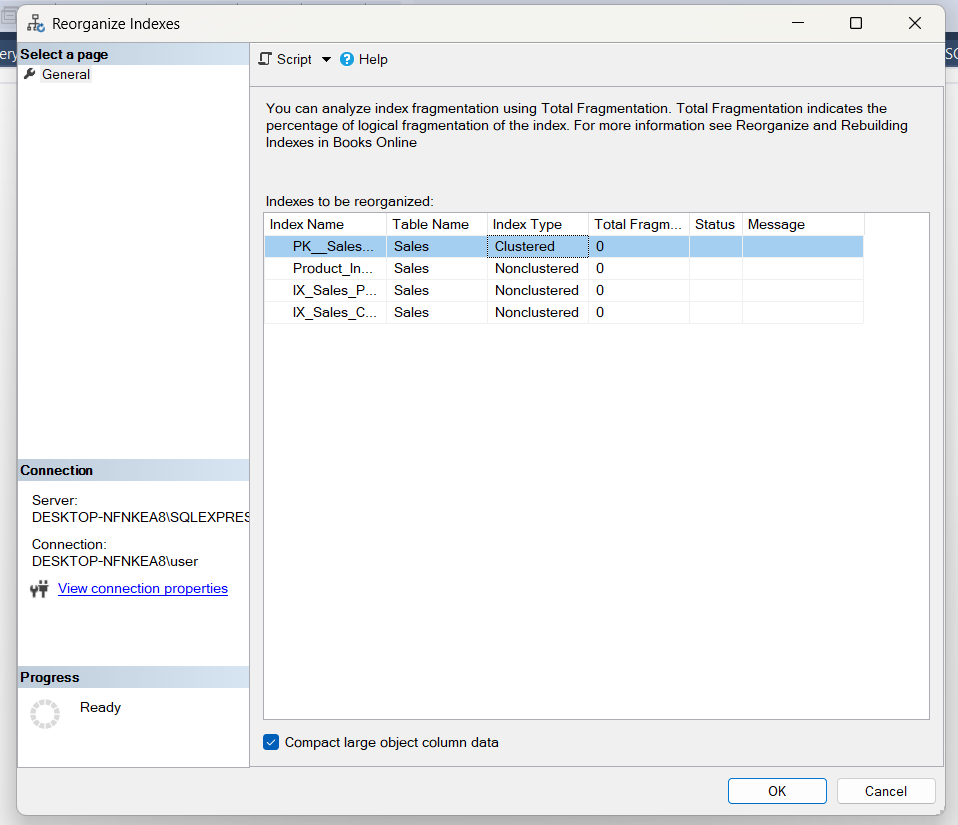
Selecteer de te reorganiseren indexes en bevestig. Afbeelding door de auteur.
Je kunt ook de volgende queries gebruiken om indexes in SQL Server te reorganiseren.
-- Reorganize a single index
ALTER INDEX IX_Sales_Product
ON Sales
REORGANIZE;

-- Reorganize all indexes on the table
ALTER INDEX ALL
ON Sales
REORGANIZE;Het opnieuw opbouwen van een index maakt deze volledig opnieuw aan, verwijdert fragmentatie en optimaliseert opslag.
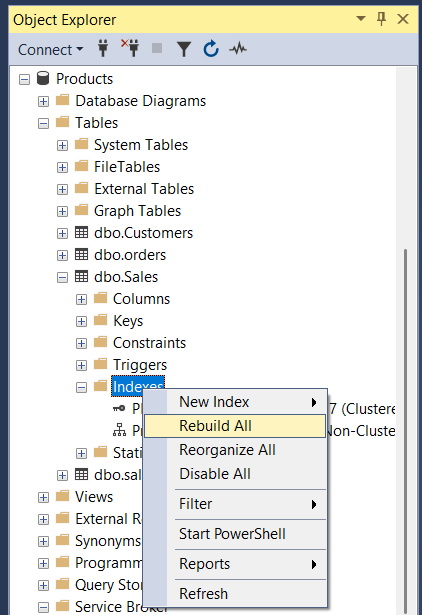
Klik met de rechtermuisknop op de index en kies Rebuild All. Afbeelding door de auteur
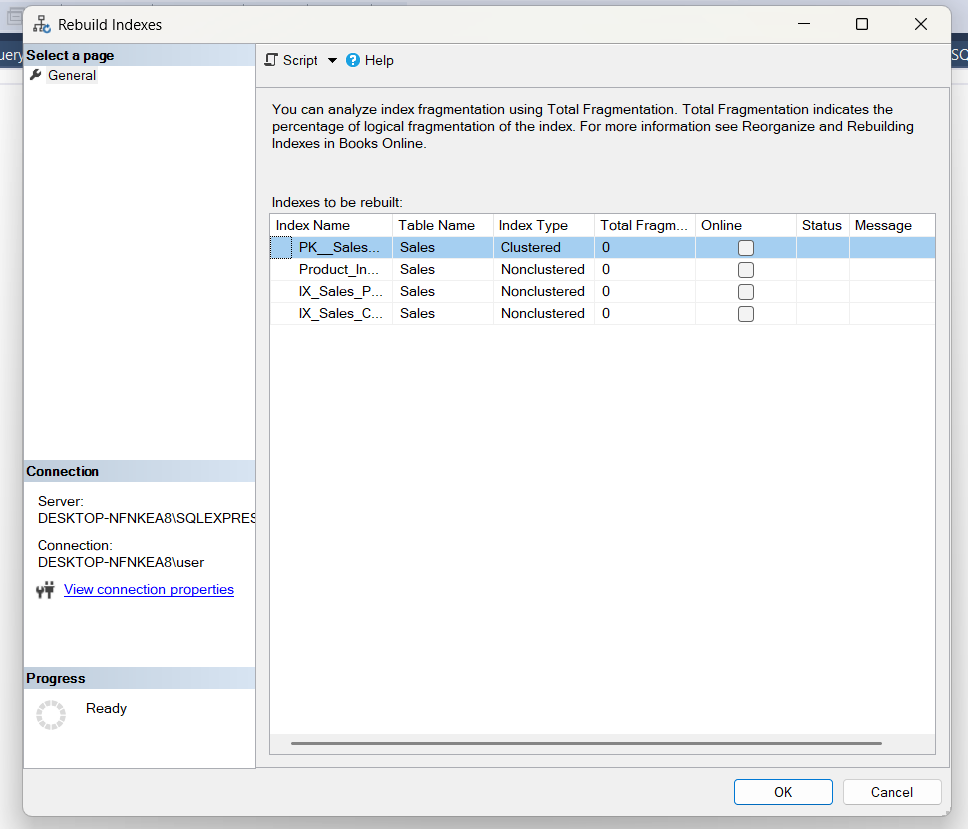
Selecteer de indexes die je opnieuw wilt opbouwen en bevestig. Afbeelding door de auteur
De volgende query bouwt de indexes op de tabel opnieuw op.
-- Rebuild a single index
ALTER INDEX IX_Sales_Product
ON Sales
REBUILD;

-- Rebuild all indexes on the table
ALTER INDEX ALL
ON Sales
REBUILD;Het onderhouden en optimaliseren van SQL Server-indexes is belangrijk om topprestaties van je database te garanderen. Dit zijn tips voor effectief indexbeheer.
Voer regelmatig indexonderhoud uit: Reorganiseer of bouw je index regelmatig opnieuw op om fragmentatie te verminderen, wat prestaties na verloop van tijd kan verslechteren. Gebruik onderhoudsscripts of tools zoals SQL Server Maintenance Plans om deze taken te automatiseren.
Analyseer indexgebruik: Gebruik Dynamic Management Views (DMV’s), zoals sys.dm_db_index_usage_stats, om ongebruikte of onderbenutte indexes te identificeren. Verwijder indexes die geen significante prestatiewinst opleveren om onnodige overhead te vermijden.
Vermijd over-indexering: Te veel indexes kunnen schrijfbewerkingen (INSERT, UPDATE, DELETE) vertragen omdat alle relevante indexes moeten worden bijgewerkt. Richt je op kolommen die vaak in SELECT-queries, joins of filtercondities worden gebruikt.
Monitor fragmentatieniveaus: Gebruik sys.dm_db_index_physical_stats om zwaar gefragmenteerde indexes te identificeren. Reorganiseer indexes bij fragmentatie onder 30% en bouw ze opnieuw op bij fragmentatie boven 30%.
Maak gebruik van gefilterde indexes: Gebruik gefilterde indexes om queries te optimaliseren die op een subset van de data werken, zoals actieve gebruikers of specifieke datumbereiken.
Let ook goed op het volgende om veelvoorkomende valkuilen bij indexbeheer te vermijden:
Over-indexering: Maak niet voor elke query een index; dit heeft impact op schrijfbewerkingen en opslag.
Onderhoud verwaarlozen: Als je indexes niet heropbouwt of reorganiseert, neemt de fragmentatie toe.
Indexering bij writes negeren: Indexes versnellen reads, maar kunnen writes aanzienlijk vertragen.
Samengestelde indexes niet testen: Een onjuiste kolomvolgorde in samengestelde indexes kan ze ineffectief maken.
Bekijk DataCamp’s skill track SQL Server for Database Administrators om meer te leren over transacties en foutafhandeling in SQL Server om queryprestaties te verbeteren.
Indexes zijn nuttig om databaseprestaties te optimaliseren, maar brengen ook afwegingen met zich mee. Het is cruciaal om hun impact te begrijpen en ze effectief te beheren om een goed presterend databasesysteem te behouden.
Indexes hebben grote invloed op query-uitvoerplannen en prestaties door de tijd die nodig is om data op te halen te verkorten. Ze stellen SQL Server in staat rijen snel te lokaliseren, waardoor kostbare volledige tabelscans minder nodig zijn. Uitvoerplannen tonen vaak bewerkingen zoals Index Seek in plaats van Table Scan als er effectieve indexes aanwezig zijn.
De tools om indexprestaties te meten zijn onder andere:
sys.dm_db_index_usage_stats houdt bij hoe indexes door queries worden gebruikt.
sys.dm_db_index_operational_stats geeft operationele metrics zoals page reads en writes.
Query Store analyseert queryprestaties en identificeert inefficiënties door ontbrekende of ongebruikte indexes.
De volgende query haalt bijvoorbeeld statistieken op over hoe indexes in door de gebruiker gedefinieerde tabellen worden gebruikt, inclusief details over seeks, scans, lookups en updates, om hun effectiviteit en prestaties te beoordelen.
-- Retrieve index usage statistics for user tables
SELECT
    OBJECT_NAME(IXS.OBJECT_ID) AS TableName,
    I.name AS IndexName,
    IXS.user_seeks AS Seeks,
    IXS.user_scans AS Scans,
    IXS.user_lookups AS Lookups,
    IXS.user_updates AS Updates
-- DMV providing index usage stats
FROM
    sys.dm_db_index_usage_stats IXS
JOIN
    sys.indexes I ON I.OBJECT_ID = IXS.OBJECT_ID
                 AND I.index_id = IXS.index_id
WHERE
OBJECTPROPERTY(IXS.OBJECT_ID, 'IsUserTable') = 1;Hoewel indexes de databaseprestaties verbeteren, brengen ze ook opslagkosten met zich mee, omdat ze schijfruimte gebruiken, zeker bij grote datasets. Het is belangrijk om deze factoren te balanceren bij het implementeren van indexes. Meer indexes kunnen schrijfbewerkingen vertragen, vooral in omgevingen met veel transacties. Overweeg de volgende strategieën om het indexgebruik in balans te houden.
Indexeer alleen wat ertoe doet: Richt je op kolommen die vaak in WHERE-, JOIN- en ORDER BY-clausules voorkomen. Vermijd indexering van zelden bevraagde kolommen.
Gebruik gefilterde indexes: Maak indexes voor subsets van data om ruimte te besparen en specifieke queries te optimaliseren.
Benut compressie: Zet datacompressie aan om de opslagvoetafdruk van indexes te verkleinen.
Archiveer oude data: Verplaats zelden geraadpleegde data naar een archieftabel en verminder de indexering op de hoofdtafel.
Met bovenstaande strategieën zorg je voor optimale queryprestaties terwijl je opslag- en onderhoudskosten beheersbaar blijven.
Als ze niet goed worden onderhouden, kunnen indexes na verloop van tijd verslechteren, waardoor de database minder efficiënt wordt. Laten we bespreken hoe je deze problemen herkent en oplost.
Fragmentatie: Na verloop van tijd raken indexes gefragmenteerd, wat leidt tot inefficiënte data-opvraag. Signalen zijn langere querytijden en hoge schijf-I/O. Gebruik sys.dm_db_index_physical_stats om fragmentatie te identificeren. Reorganiseer indexes bij fragmentatie onder 30% en bouw ze opnieuw op bij fragmentatie boven 30%.
Verouderde statistieken: Verouderde statistieken leiden tot suboptimale queryplannen. Daardoor kun je trage queries ervaren ondanks passende indexes. Update statistieken handmatig voor kritieke indexes of schakel AUTO_UPDATE_STATISTICS in.
Ongebruikte of overbodige indexes: Sommige indexes blijven ongebruikt, verbruiken opslag en vertragen writes. Symptomen zijn hoge onderhoudskosten voor indexes en weinig queryvoordeel. Identificeer ongebruikte indexes met sys.dm_db_index_usage_stats en verwijder ze waar nodig.
Ontbrekende indexes: Een gebrek aan goede indexes kan tot tabelscans leiden, wat queries vertraagt. In zulke gevallen tonen queryplannen Table Scan in plaats van Index Seek. Gebruik de Missing Index DMV sys.dm_db_missing_index_details om kansen te identificeren en maak de aanbevolen indexes op basis van querypatronen.
Overlappende indexes: Meerdere indexes met vergelijkbare kolomstructuren verspillen resources, verhogen het opslaggebruik en zorgen voor dubbel onderhoud. Consolideer overlappende indexes altijd in één goed ontworpen index.
Probeer onze career track SQL Server Developer om meer te leren over het oplossen van indexproblemen in SQL Server en zo de efficiëntie van je database te verbeteren.
SQL Server-indexes beheersen is belangrijk als je databaseprestaties wilt verbeteren met efficiënte queries. Begrijp bovendien de verschillende typen SQL Server-indexes om je indexes te beheren voor optimale databaseprestaties.
Ik raad onze career track Associate Data Analyst in SQL aan om een vaardige data-analist te worden. Onze cursus Reporting in SQL helpt je ook om complexe rapporten en dashboards te bouwen voor effectieve datapresentatie. Bereid je je voor op een sollicitatiegesprek waarin je SQL Server-vaardigheden aan bod komen? Bekijk dan onze blog Top 30 SQL Server Interview Questions om te oefenen en je gesprek te rocken.
Leer SQL Server met DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


