
Last chance! 50% off DataCamp Premium
Sale ends in
Quando ho iniziato a lavorare con SQL Server, mi sono reso conto che non tutte le query lente sono uguali. Alcune erano lente per una cattiva progettazione, altre semplicemente inefficaci. Ma una scoperta ha cambiato per sempre il mio approccio alle prestazioni dei database: gli indici. Immagina di cercare un capitolo specifico in un manuale enorme senza indice: sfoglieresti centinaia di pagine, sprecando tempo prezioso. È esattamente ciò che succede nei database senza un corretto indexing.
In questo articolo ti spiego perché gli indici di SQL Server sono importanti, come funzionano e come sfruttarli al massimo per migliorare le prestazioni dei tuoi database. Se vuoi approfondire le tue competenze SQL in SQL Server, ti consiglio i nostri corsi Introduction to SQL Server e Intermediate SQL Server per imparare T-SQL per la manipolazione e l’analisi dei dati.
Gli indici in SQL Server ti permettono di interrogare le tabelle in modo efficiente senza scansionare interi dataset. Di seguito trovi la definizione degli indici di SQL Server e la loro importanza nella gestione dei database.
Gli indici sono strutture dati specializzate che consentono a SQL Server di individuare e recuperare le righe in modo più efficiente, risparmiando tempo e risorse computazionali. Funzionano organizzando i dati in modo da consentire ricerche più rapide. Invece di scansionare l’intera tabella riga per riga (un processo noto come table scan), SQL Server può usare l’indice per trovare le righe necessarie molto più velocemente rispetto a dover passare in rassegna ogni voce della tabella.
Esistono due tipi fondamentali di indici in SQL Server:
Indici cluster: un indice cluster determina l’ordine fisico dei dati in una tabella. Quando crei un indice cluster su una tabella, le righe vengono archiviate su disco nell’ordine della colonna indicizzata. Questo è particolarmente vantaggioso per le query su intervalli, perché permette un accesso sequenziale efficiente alle righe.
Indici non cluster: gli indici non cluster non influenzano l’ordine fisico dei dati. Creano invece una struttura separata che contiene puntatori alle righe di dati effettive. Gli indici non cluster sono utili per migliorare le prestazioni delle query che filtrano o ordinano in base a colonne non incluse nell’indice cluster.
Dai un’occhiata al nostro SQL Server Tutorial per capire l’utilizzo di SQL Server dalla base all’avanzato nella gestione dei dati.
Gli indici sono fondamentali per migliorare le prestazioni delle query e l’efficienza complessiva del database. Ecco alcuni vantaggi chiave dell’uso degli indici:
Esecuzione delle query più veloce: gli indici riducono il tempo necessario per trovare e recuperare i dati. Ad esempio, se stai cercando tutti gli ordini di un cliente specifico in una tabella con milioni di righe, un indice sulla colonna del cliente consente a SQL Server di individuare quelle righe quasi all’istante.
Uso efficiente delle risorse: con gli indici, SQL Server può completare le operazioni utilizzando meno risorse di CPU e memoria. Questa efficienza si traduce in migliori prestazioni complessive del sistema, soprattutto sotto carichi pesanti.
Miglior ordinamento e raggruppamento: gli indici possono accelerare le operazioni che prevedono ordinamento (ORDER BY) e raggruppamento (GROUP BY). Mantenendo i dati ordinati, permettono a SQL Server di restituire rapidamente i risultati senza ulteriore overhead di sorting.
Considera questo caso d’uso per gli indici. Immagina una grande piattaforma e-commerce in cui gli utenti cercano spesso i prodotti per nome. Creando un indice non cluster sulla colonna del nome prodotto, puoi rendere queste ricerche quasi istantanee, migliorando l’esperienza utente e riducendo il carico sul server.
Ti consiglio di esplorare lo skill track SQL Server Fundamentals di DatCamp per imparare ordinamento, raggruppamento e join tra tabelle per l’analisi dei dati.
Esistono diversi tipi di indici in SQL Server, ognuno con caratteristiche e casi d’uso specifici. Vediamo i tipi più comuni.
I due tipi principali di indici in SQL Server sono gli indici cluster e quelli non cluster.
Un indice cluster determina l’ordine fisico delle righe in una tabella, di fatto ordinando la tabella in base alle colonne dell’indice. Poiché i dati possono essere ordinati fisicamente in un solo modo, può esistere un solo indice cluster per tabella. È ideale per query che restituiscono un intervallo di valori o che necessitano di ordinare i dati in base alla colonna indicizzata.
Ad esempio, una tabella delle vendite ordinata per OrderDate può beneficiare di un indice cluster sulla colonna OrderDate. Le query che recuperano tutti gli ordini entro un intervallo di date saranno eseguite molto più velocemente.
Un indice non cluster crea una struttura separata che punta alle righe effettive della tabella. Una tabella può avere più indici non cluster, ciascuno usato per pattern di query differenti. Gli indici non cluster contengono un riferimento (row locator) ai dati reali, che può essere un ID di riga o la chiave dell’indice cluster. Questo tipo di indice si applica a colonne usate spesso in condizioni di ricerca o join (ad esempio, EmailAddress, ProductName).
Per esempio, un indice non cluster sulla colonna ProductName di una tabella di inventario consente ricerche più veloci di prodotti specifici senza modificare la struttura della tabella.
SQL Server supporta anche indici univoci e compositi, ciascuno con scopi specifici.
Un indice univoco garantisce che tutti i valori nelle colonne indicizzate siano distinti. Fa rispettare l’integrità dei dati impedendo valori duplicati ed è spesso applicato a colonne con unicità naturale, come email o username. Ad esempio, un indice univoco sulla colonna Email di una tabella utenti assicura che due utenti non possano avere lo stesso indirizzo email.
Un indice composito copre più colonne, ottimizzando le query che filtrano o ordinano in base a una combinazione di tali colonne. L’ordine delle colonne nell’indice composito è importante, poiché SQL Server elabora per prima la colonna più a sinistra. Gli indici compositi supportano query complesse con più condizioni. Per esempio, un indice composito su LastName e FirstName in una tabella clienti velocizza le ricerche per nome e cognome.
Per creare un indice in SQL Server usiamo SQL Server Management Studio (SSMS). Prima di entrare nel dettaglio, dai un’occhiata al nostro blog per capire le differenze tra i dialetti SQL Server, PostgreSQL e MySQL. Di seguito tratto i passaggi per creare e gestire gli indici in SQL Server.
Di seguito trovi una guida passo passo per creare indici sia con SQL Server Management Studio (SSMS) sia con codice SQL.
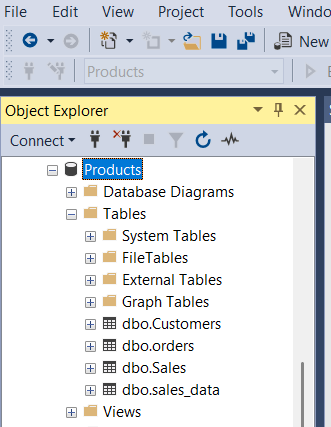
Apri Object Explorer e raggiungi la tabella per creare l’indice. Immagine dell’autore.
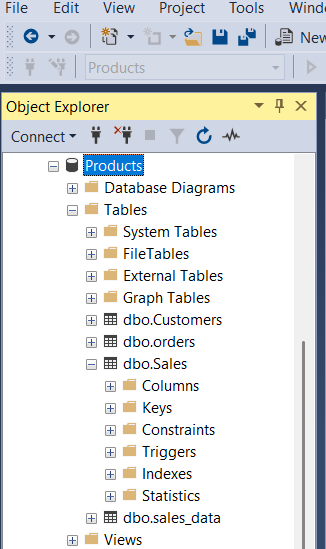
Individua la tabella su cui creare l’indice ed espandila. Immagine dell’autore.
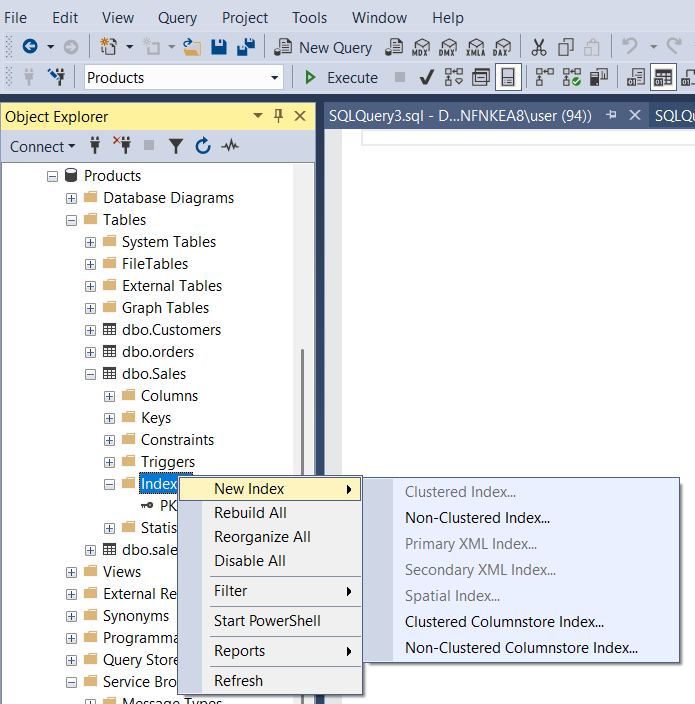
Apri la cartella Index e fai clic con il tasto destro per creare un nuovo indice. Immagine dell’autore.
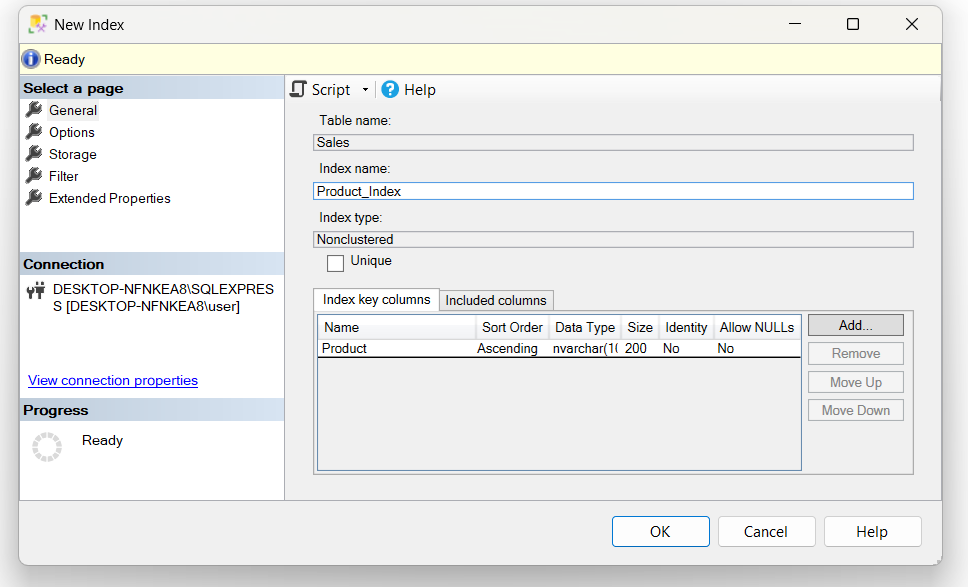
Scegli il tipo di indice e definisci le proprietà. Immagine dell’autore.
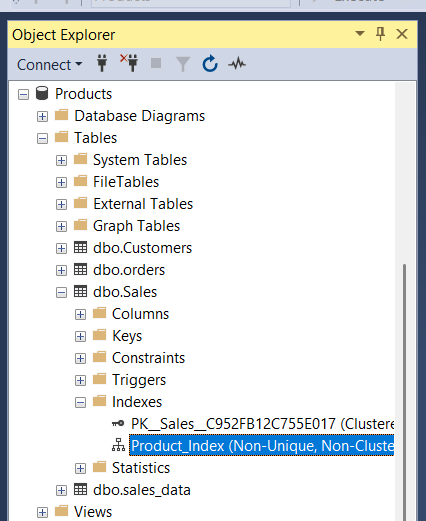
Crea l’indice facendo clic su OK. Immagine dell’autore.
Puoi anche creare indici direttamente con comandi T-SQL. Di seguito alcuni esempi di creazione di diversi tipi di indici tramite query:
-- Create a non-clustered index on the Product column
CREATE NONCLUSTERED INDEX IX_Sales_Product
ON Sales (Product);

-- Create a unique index on the combination of CustomerName and OrderDate
CREATE UNIQUE NONCLUSTERED INDEX IX_Sales_CustomerName_OrderDate
ON Sales (CustomerName, OrderDate);

-- Create a clustered index on the OrderDate column
CREATE CLUSTERED INDEX IX_Sales_OrderDate
ON Sales (OrderDate);Puoi eliminare un indice con un metodo piuttosto semplice. Fai attenzione, perché rimuovere un indice può influire sulle prestazioni delle query.
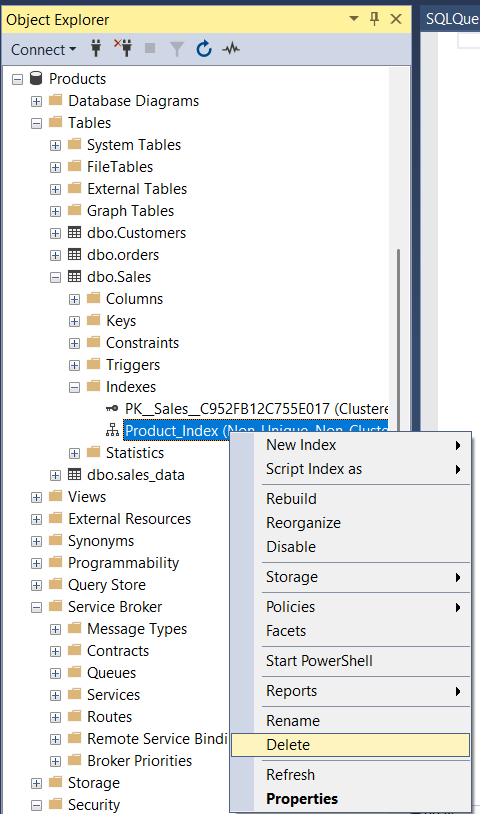
Raggiungi l’indice che vuoi eliminare. Immagine dell’autore.
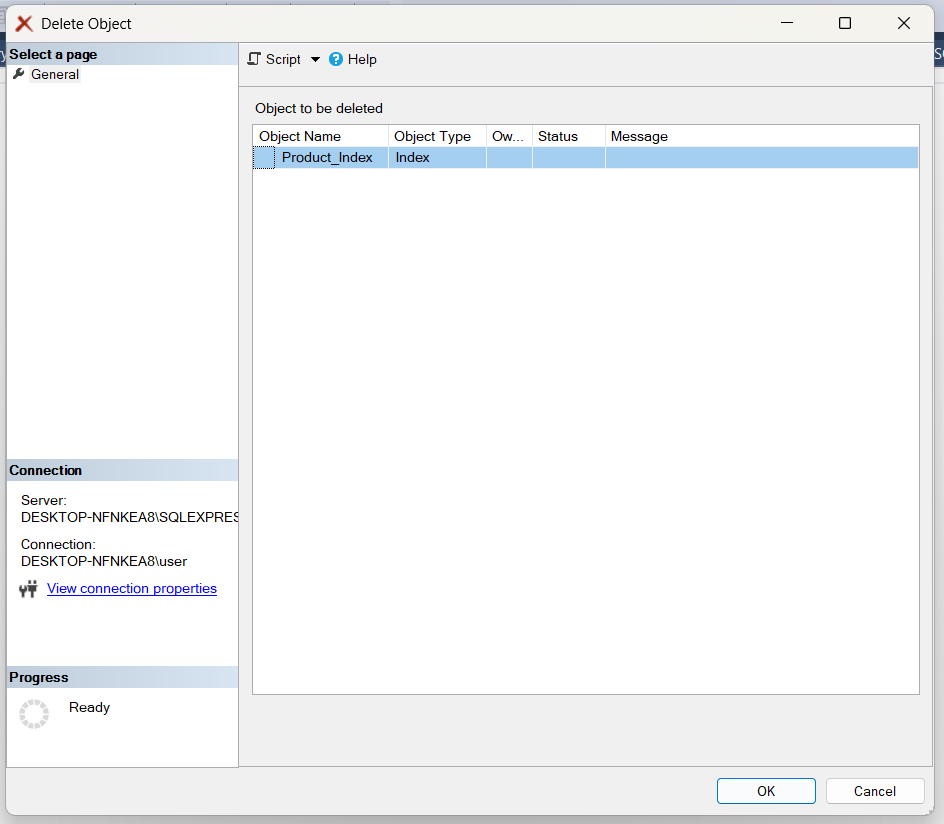
Conferma l’eliminazione nella finestra di dialogo e fai clic su OK. Immagine dell’autore.
Puoi usare i seguenti comandi per eliminare indici esistenti da una tabella in SQL Server.
-- Drop a non-clustered index
DROP INDEX IX_Sales_Product ON Sales;

-- Drop a clustered index
DROP INDEX IX_Sales_OrderDate ON Sales;La riorganizzazione di un indice deframmenta le pagine di livello foglia dell’indice, migliorando le prestazioni senza ricostruirlo completamente.
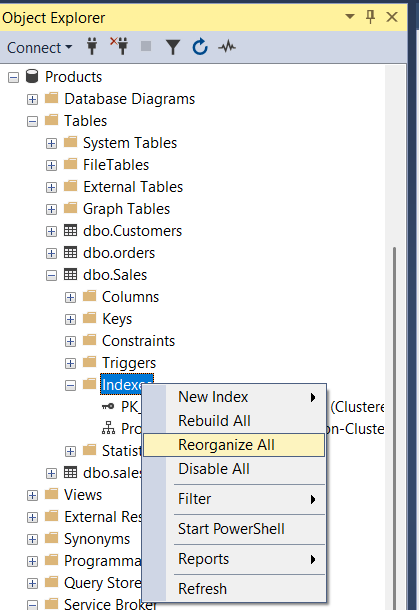
Fai clic con il tasto destro su Indexes, poi Reorganize All. Immagine dell’autore.
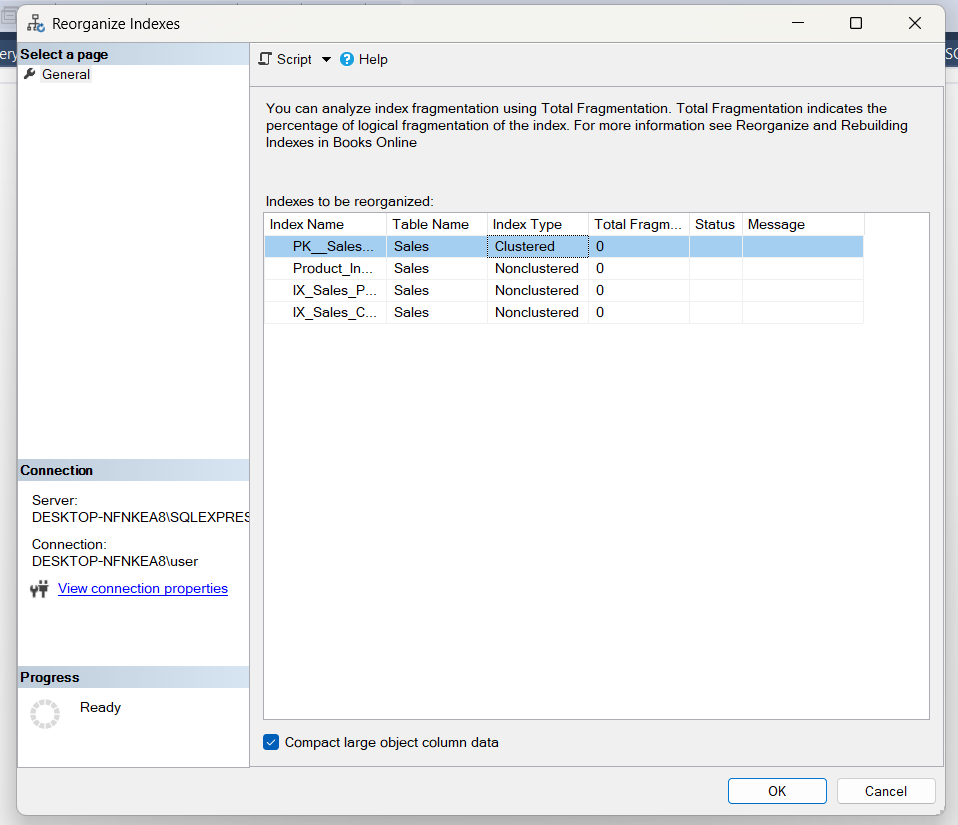
Seleziona gli indici da riorganizzare, quindi conferma. Immagine dell’autore.
Puoi anche usare le seguenti query per riorganizzare gli indici in SQL Server.
-- Reorganize a single index
ALTER INDEX IX_Sales_Product
ON Sales
REORGANIZE;

-- Reorganize all indexes on the table
ALTER INDEX ALL
ON Sales
REORGANIZE;La ricostruzione di un indice lo ricrea da zero, eliminando la frammentazione e ottimizzando l’archiviazione.
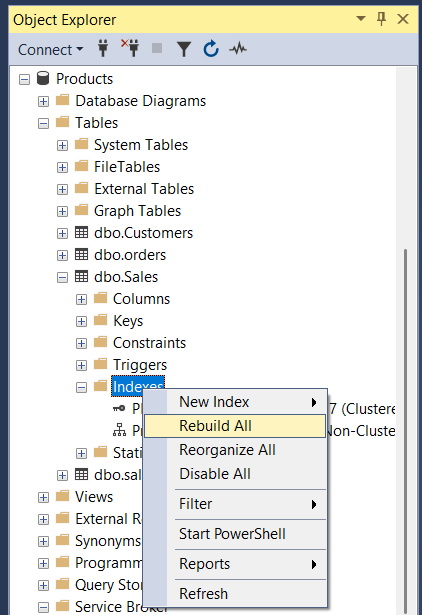
Fai clic con il tasto destro sull’indice, poi vai su Rebuild All. Immagine dell’autore
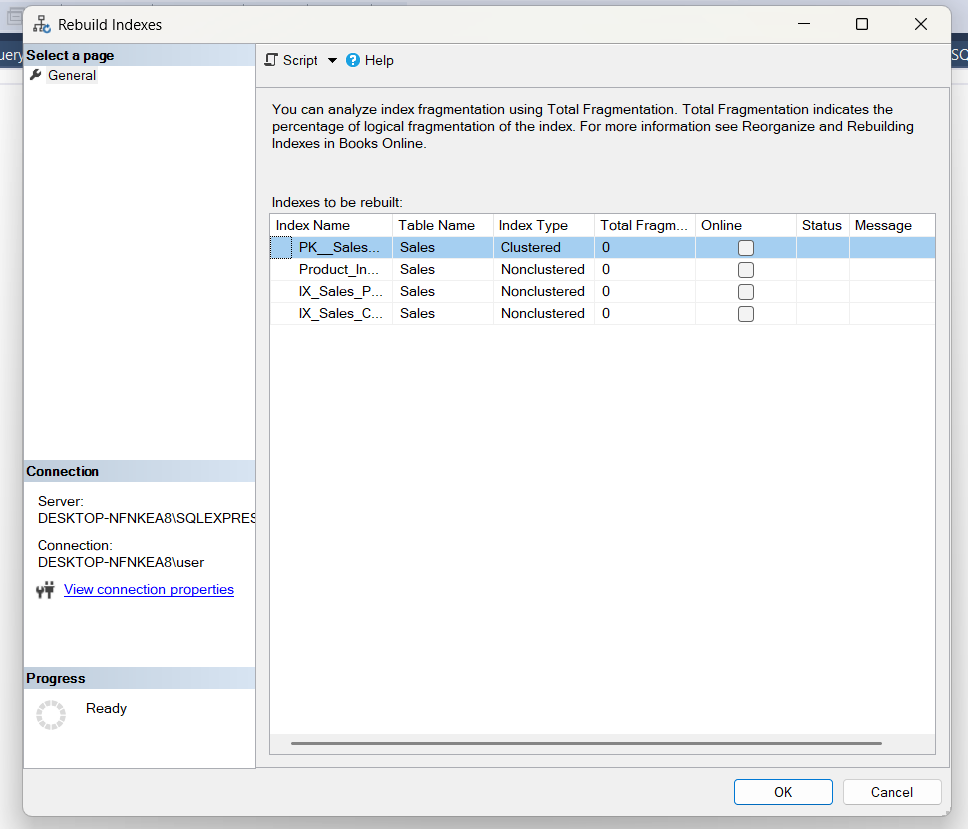
Seleziona gli indici da ricostruire e conferma. Immagine dell’autore
La seguente query ricostruirà gli indici sulla tabella.
-- Rebuild a single index
ALTER INDEX IX_Sales_Product
ON Sales
REBUILD;

-- Rebuild all indexes on the table
ALTER INDEX ALL
ON Sales
REBUILD;Mantenere e ottimizzare gli indici di SQL Server è fondamentale per garantire prestazioni ottimali del database. Ecco alcuni consigli per una gestione efficace degli indici.
Esegui manutenzione periodica degli indici: riorganizza o ricostruisci regolarmente gli indici per ridurre la frammentazione, che nel tempo può degradare le prestazioni. Usa script di manutenzione o strumenti come i Maintenance Plans di SQL Server per automatizzare queste attività.
Analizza l’utilizzo degli indici: utilizza le Dynamic Management Views (DMV), come sys.dm_db_index_usage_stats, per identificare indici inutilizzati o sottoutilizzati. Rimuovi quelli che non offrono benefici significativi per evitare overhead non necessario.
Evita l’over-indexing: troppi indici possono rallentare le operazioni di scrittura (INSERT, UPDATE, DELETE) perché vanno aggiornati tutti gli indici pertinenti. Concentrati sull’indicizzazione delle colonne usate spesso nelle query SELECT, nei join o nelle condizioni di filtro.
Monitora i livelli di frammentazione: usa sys.dm_db_index_physical_stats per identificare gli indici fortemente frammentati. Riorganizza per frammentazione sotto il 30% e ricostruisci per frammentazione sopra il 30%.
Sfrutta gli indici filtrati: usa indici filtrati per ottimizzare query che operano su un sottoinsieme di dati, come utenti attivi o intervalli di date specifici.
Dovresti anche prestare attenzione alle seguenti pratiche per evitare errori comuni nella gestione degli indici:
Over-indexing: evita di creare un indice per ogni query; impatta su scritture e storage.
Trascurare la manutenzione: non ricostruire o riorganizzare gli indici porta ad aumentare la frammentazione.
Ignorare l’impatto sugli inserimenti: gli indici velocizzano le letture, ma possono rallentare sensibilmente le scritture.
Non testare gli indici compositi: un ordine scorretto delle colonne in un indice composito può renderlo inefficace.
Dai un’occhiata allo skill track SQL Server for Database Administrators di DataCamp per saperne di più su transazioni e gestione degli errori in SQL Server per migliorare le prestazioni delle query.
Gli indici sono utili per ottimizzare le prestazioni del database, ma comportano alcuni compromessi. Capirne l’impatto e gestirli efficacemente è cruciale per mantenere un sistema performante.
Gli indici influenzano sensibilmente i piani di esecuzione e le prestazioni delle query riducendo il tempo necessario al recupero dei dati. Consentono a SQL Server di individuare rapidamente le righe, riducendo la necessità di costose scansioni complete della tabella. Nei piani di esecuzione, con indici efficaci, vedrai spesso operazioni come Index Seek invece di Table Scan.
Gli strumenti per misurare le prestazioni degli indici includono:
sys.dm_db_index_usage_stats tiene traccia di come gli indici vengono usati dalle query.
sys.dm_db_index_operational_stats fornisce metriche operative come letture e scritture di pagine.
Query store analizza le prestazioni delle query e individua inefficienze causate da indici mancanti o inutilizzati.
Per esempio, la seguente query recupera statistiche su come vengono usati gli indici nelle tabelle definite dall’utente, inclusi dettagli su seek, scan, lookup e update, per valutarne efficacia e prestazioni.
-- Retrieve index usage statistics for user tables
SELECT
    OBJECT_NAME(IXS.OBJECT_ID) AS TableName,
    I.name AS IndexName,
    IXS.user_seeks AS Seeks,
    IXS.user_scans AS Scans,
    IXS.user_lookups AS Lookups,
    IXS.user_updates AS Updates
-- DMV providing index usage stats
FROM
    sys.dm_db_index_usage_stats IXS
JOIN
    sys.indexes I ON I.OBJECT_ID = IXS.OBJECT_ID
                 AND I.index_id = IXS.index_id
WHERE
OBJECTPROPERTY(IXS.OBJECT_ID, 'IsUserTable') = 1;Pur migliorando le prestazioni, gli indici hanno un costo in termini di storage, perché consumano spazio su disco, soprattutto su dataset di grandi dimensioni. È importante saper bilanciare questi fattori quando implementi gli indici. Un numero maggiore di indici può rallentare le operazioni di scrittura, specialmente in ambienti ad alta transazionalità. Considera le seguenti strategie per bilanciare l’uso degli indici.
Indicizza solo ciò che conta: concentrati sulle colonne utilizzate di frequente nelle clausole WHERE, JOIN e ORDER BY. Evita di indicizzare colonne interrogate raramente.
Usa indici filtrati: crea indici su sottoinsiemi di dati per risparmiare spazio e ottimizzare query specifiche.
Sfrutta la compressione: abilita la compressione dei dati per ridurre l’ingombro degli indici.
Archivia i dati storici: sposta i dati raramente consultati in una tabella di archivio e riduci l’indicizzazione sulla tabella principale.
Queste strategie ti aiuteranno a garantire prestazioni ottimali delle query mantenendo sotto controllo i costi di storage e manutenzione.
Se non adeguatamente mantenuti, gli indici possono degradarsi nel tempo, riducendo l’efficienza del database. Vediamo come identificare e risolvere questi problemi.
Frammentazione: col tempo, gli indici si frammentano, portando a recuperi dati inefficaci. I segnali includono tempi di esecuzione più lunghi e alto I/O su disco. Per risolvere, usa sys.dm_db_index_physical_stats per identificare la frammentazione. Quindi riorganizza gli indici con frammentazione sotto il 30% e ricostruiscili se sopra il 30%
Statistiche obsolete: statistiche non aggiornate portano a piani di esecuzione subottimali. Potresti quindi riscontrare query lente nonostante indici appropriati. Per risolvere, aggiorna manualmente le statistiche per gli indici critici o abilita AUTO_UPDATE_STATISTICS.
Indici inutilizzati o ridondanti: alcuni indici restano inutilizzati, consumando spazio e rallentando le scritture. I sintomi sono costi di manutenzione elevati e scarso beneficio per le query. Per risolvere, identifica gli indici inutilizzati con sys.dm_db_index_usage_stats ed eliminali se necessario.
Indici mancanti: la mancanza di indici adeguati può causare table scan, rallentando le query. In questi casi, i piani di esecuzione mostrano Table Scan invece di Index Seek. Per risolvere, usa la DMV dei Missing Index sys.dm_db_missing_index_details per identificare le opportunità e crea gli indici consigliati in base ai pattern di query.
Indici sovrapposti: più indici con strutture di colonne simili sprecano risorse, aumentando l’uso di storage e la manutenzione ridondante. Consolida sempre indici sovrapposti in un singolo indice ben progettato.
Prova il nostro career track SQL Server Developer per approfondire la risoluzione dei problemi sugli indici in SQL Server e migliorare l’efficienza del database.
Padroneggiare gli indici di SQL Server è fondamentale se vuoi migliorare le prestazioni del database scrivendo query efficienti. Lavorando con gli indici, dovresti anche conoscere i diversi tipi disponibili in SQL Server per gestirli al meglio e ottenere prestazioni ottimali.
Ti consigliamo il nostro career track Associate Data Analyst in SQL per diventare un data analyst competente. Il corso Reporting in SQL ti aiuterà anche a diventare esperto nella creazione di report e dashboard complessi per una presentazione efficace dei dati. Se ti stai preparando per un colloquio che richiede di dimostrare le tue competenze in SQL Server, dai un’occhiata al nostro blog Top 30 SQL Server Interview Questions per esercitarti e arrivare pronto.
Impara SQL Server con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min




