
कोर्स
SQL Server में फंक्शंस और स्टोरड प्रोसीजर्स लिखना
4 घंटा
28K
जब मैंने SQL Server के साथ काम करना शुरू किया, तो मुझे एहसास हुआ कि हर धीमी क्वेरी एक जैसी नहीं होती। कुछ क्वेरीज़ खराब डिज़ाइन के कारण धीमी होती थीं, जबकि कुछ बस अक्षम थीं। लेकिन एक खोज ने डेटाबेस प्रदर्शन के प्रति मेरा नज़रिया हमेशा के लिए बदल दिया: इंडेक्स। कल्पना कीजिए कि आपके पास एक विशाल पाठ्यपुस्तक है और आपको बिना इंडेक्स के कोई खास अध्याय खोजना है; आप सैकड़ों पन्ने पलटते रहेंगे और कीमती समय बर्बाद होगा। डेटाबेस में उचित इंडेक्सिंग न होने पर यही स्थिति बनती है।
इस लेख में, मैं समझाऊंगा कि SQL Server इंडेक्स क्यों महत्वपूर्ण हैं, वे कैसे काम करते हैं, और आप उन्हें अपने डेटाबेस के प्रदर्शन को अधिकतम करने के लिए कैसे उपयोग कर सकते हैं। यदि आप SQL Server में अपनी SQL कौशल को और गहरा करना चाहते हैं, तो मैं हमारे Introduction to SQL Server और Intermediate SQL Server कोर्सेज़ करने की सलाह दूंगा ताकि आप डेटा मैनिपुलेशन और विश्लेषण के लिए T-SQL सीख सकें।
SQL Server इंडेक्स आपको पूरे डेटासेट को स्कैन किए बिना डेटाबेस में टेबल्स पर कुशलतापूर्वक क्वेरी करने देते हैं। नीचे SQL Server इंडेक्स की परिभाषा और डेटाबेस प्रबंधन में उनकी महत्ता दी गई है।
इंडेक्स विशेष डेटा संरचनाएँ हैं जो SQL Server को पंक्तियों का पता लगाने और उन्हें अधिक कुशलता से प्राप्त करने में सक्षम बनाती हैं, जिससे समय और कम्प्यूटेशनल संसाधन दोनों की बचत होती है। इंडेक्स डेटा को इस तरह व्यवस्थित करते हैं कि तेज़ी से खोज संभव हो। पूरी टेबल को पंक्ति-दर-पंक्ति स्कैन करने (जिसे टेबल स्कैन कहते हैं) के बजाय, SQL Server आवश्यक पंक्तियों को बहुत तेज़ी से ढूंढने के लिए इंडेक्स का उपयोग कर सकता है, मानो उसे टेबल की हर एंट्री छाननी ही न पड़े।
SQL Server में इंडेक्स के दो बुनियादी प्रकार हैं:
क्लस्टर्ड इंडेक्स: क्लस्टर्ड इंडेक्स किसी टेबल में डेटा का भौतिक क्रम निर्धारित करता है। जब आप किसी टेबल पर क्लस्टर्ड इंडेक्स बनाते हैं, तो पंक्तियाँ इंडेक्स किए गए कॉलम के क्रम में डिस्क पर संग्रहीत होती हैं। यह रेंज क्वेरीज़ के लिए विशेष रूप से फायदेमंद है, क्योंकि यह पंक्तियों तक क्रमवार और कुशल पहुँच देता है।
नॉन-क्लस्टर्ड इंडेक्स: नॉन-क्लस्टर्ड इंडेक्स डेटा के भौतिक क्रम को प्रभावित नहीं करते। इसके बजाय, वे एक अलग संरचना बनाते हैं जिसमें वास्तविक डेटा पंक्तियों के लिए पॉइंटर्स होते हैं। नॉन-क्लस्टर्ड इंडेक्स उन क्वेरीज़ के प्रदर्शन में सुधार के लिए उपयोगी हैं जो उन कॉलम्स पर फ़िल्टर या सॉर्ट करती हैं जो क्लस्टर्ड इंडेक्स में शामिल नहीं हैं।
हमारा SQL Server Tutorial देखें ताकि आप डेटा प्रबंधन में SQL Server के बुनियादी से उन्नत उपयोग को समझ सकें।
क्वेरी प्रदर्शन और समग्र डेटाबेस दक्षता बढ़ाने के लिए इंडेक्स महत्वपूर्ण हैं। इंडेक्स के कुछ प्रमुख लाभ इस प्रकार हैं:
तेज़ क्वेरी निष्पादन: इंडेक्स डेटा खोजने और प्राप्त करने में लगने वाले समय को कम करते हैं। उदाहरण के लिए, यदि आप लाखों पंक्तियों वाली टेबल में किसी विशिष्ट ग्राहक के सभी ऑर्डर्स खोज रहे हैं, तो ग्राहक वाले कॉलम पर इंडेक्स SQL Server को वे पंक्तियाँ लगभग तुरंत ढूंढने देता है।
संसाधनों का कुशल उपयोग: इंडेक्स के साथ, SQL Server कम CPU और मेमोरी संसाधनों का उपयोग करके कार्य पूरे कर सकता है। यह दक्षता विशेषकर भारी वर्कलोड के तहत समग्र सिस्टम प्रदर्शन में सुधार लाती है।
बेहतर सॉर्टिंग और ग्रुपिंग: इंडेक्स सॉर्टिंग (ORDER BY) और ग्रुपिंग (GROUP BY) से जुड़ी प्रक्रियाओं को तेज़ कर सकते हैं। डेटा को सॉर्टेड रखकर, इंडेक्स SQL Server को बिना अतिरिक्त सॉर्टिंग ओवरहेड के परिणाम जल्दी प्राप्त करने देते हैं।
इंडेक्स अनुप्रयोग के इस उपयोग-परिदृश्य पर विचार करें। मान लें कि एक बड़ा ई-कॉमर्स प्लेटफ़ॉर्म है जहाँ उपयोगकर्ता अक्सर नाम से उत्पाद खोजते हैं। प्रोडक्ट नेम कॉलम पर नॉन-क्लस्टर्ड इंडेक्स बनाकर, आप इन खोजों को लगभग तात्कालिक बना सकते हैं, जिससे उपयोगकर्ता अनुभव सुधरेगा और सर्वर लोड कम होगा।
मैं DatCamp के SQL Server Fundamentals स्किल ट्रैक को देखने की सलाह देता हूँ ताकि आप डेटा विश्लेषण के लिए सॉर्टिंग, ग्रुपिंग और टेबल्स को जॉइन करना सीख सकें।
SQL Server में अलग-अलग प्रकार के इंडेक्स होते हैं, जिनकी अपनी-अपनी विशेषताएँ और उपयोग-परिदृश्य होते हैं। आइए आम प्रकार के इंडेक्स पर बात करें।
SQL Server में इंडेक्स के दो प्रमुख प्रकार क्लस्टर्ड और नॉन-क्लस्टर्ड इंडेक्स हैं।
क्लस्टर्ड इंडेक्स किसी टेबल में पंक्तियों का भौतिक क्रम निर्धारित करता है, प्रभावी रूप से टेबल को इंडेक्स कॉलम(स्) के अनुसार सॉर्ट करता है। क्योंकि डेटा को भौतिक रूप से केवल एक ही तरीके से क्रमबद्ध किया जा सकता है, इसलिए प्रति टेबल केवल एक क्लस्टर्ड इंडेक्स हो सकता है। क्लस्टर्ड इंडेक्स उन क्वेरीज़ के लिए आदर्श है जो मूल्यों की एक रेंज लौटाती हैं या जिनमें इंडेक्स किए गए कॉलम द्वारा डेटा को सॉर्ट करना होता है।
उदाहरण के लिए, OrderDate पर सॉर्ट की गई सेल्स टेबल को OrderDate कॉलम पर क्लस्टर्ड इंडेक्स से लाभ मिलता है। जो क्वेरीज़ किसी दिनांक-सीमा के भीतर सभी ऑर्डर्स लाती हैं, वे कहीं तेज़ी से चलेंगी।
नॉन-क्लस्टर्ड इंडेक्स एक अलग संरचना बनाता है जो टेबल में वास्तविक पंक्तियों की ओर संकेत करता है। किसी टेबल में कई नॉन-क्लस्टर्ड इंडेक्स हो सकते हैं, जिनमें से प्रत्येक अलग-अलग क्वेरी पैटर्न में काम आता है। नॉन-क्लस्टर्ड इंडेक्स में वास्तविक डेटा का संदर्भ (रो लोकेटर) होता है, जो रो ID या क्लस्टर्ड इंडेक्स कुंजी हो सकता है। इस प्रकार का इंडेक्स उन कॉलम्स पर लगाया जाता है जो अक्सर सर्च कंडीशन्स या जॉइन में उपयोग होते हैं (जैसे, EmailAddress, ProductName)।
उदाहरण के लिए, इन्वेंटरी टेबल के ProductName कॉलम पर नॉन-क्लस्टर्ड इंडेक्स टेबल की संरचना बदले बिना विशिष्ट उत्पादों की तेज़ खोज की अनुमति देता है।
SQL Server यूनिक और कॉम्पोज़िट इंडेक्स का भी समर्थन करता है, जिनमें से प्रत्येक विशिष्ट उद्देश्यों की पूर्ति करता है।
यूनिक इंडेक्स सुनिश्चित करता है कि इंडेक्स किए गए कॉलम(स्) के सभी मान अलग-अलग हों। यह डुप्लिकेट मानों को रोककर डेटा अखंडता लागू करता है और अक्सर उन कॉलम्स पर लगाया जाता है जिनमें स्वाभाविक रूप से विशिष्टता होती है, जैसे ईमेल पते या यूज़रनेम। उदाहरण के लिए, यूज़र टेबल के Email कॉलम पर यूनिक इंडेक्स यह सुनिश्चित करता है कि दो यूज़र एक ही ईमेल पता न रख सकें।
कॉम्पोज़िट इंडेक्स कई कॉलम्स तक फैला होता है और उन क्वेरीज़ को ऑप्टिमाइज़ करता है जो इन कॉलम्स के संयोजन के आधार पर फ़िल्टर या सॉर्ट करती हैं। कॉम्पोज़िट इंडेक्स में कॉलम्स का क्रम मायने रखता है जहाँ SQL Server बाएँ से सबसे पहले वाले कॉलम को प्राथमिकता देता है। कॉम्पोज़िट इंडेक्स कई शर्तों वाली जटिल क्वेरीज़ का समर्थन करते हैं। उदाहरण के लिए, कस्टमर टेबल में LastName और FirstName पर कॉम्पोज़िट इंडेक्स ग्राहकों को उनके पूरे नाम से खोजने में तेजी लाता है।
हम SQL Server में इंडेक्स बनाने के लिए SQL Server Management Studio (SSMS) का उपयोग करते हैं। आगे समझाने से पहले, हमारा ब्लॉग देखें ताकि आप SQL Server, PostgreSQL, और MySQL डायलैक्ट्स के बीच के अंतर समझ सकें। मैं SQL Server इंडेक्स बनाने और प्रबंधित करने में शामिल चरणों को कवर करूंगा।
नीचे SQL Server Management Studio (SSMS) और SQL कोड दोनों का उपयोग करके इंडेक्स बनाने की चरण-दर-चरण मार्गदर्शिका दी गई है।
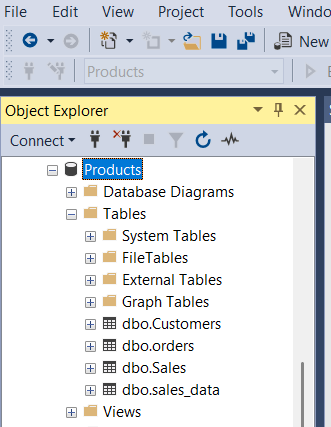
इंडेक्स बनाने के लिए ऑब्जेक्ट एक्सप्लोरर खोलें और टेबल तक जाएँ। चित्र: लेखक।
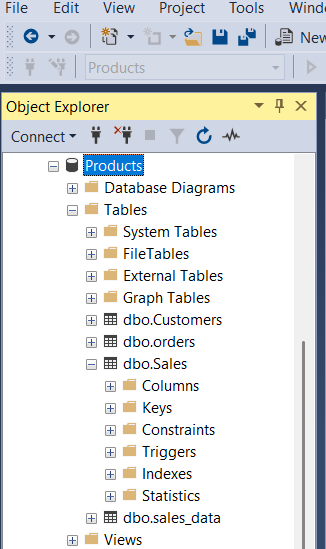
इंडेक्स बनाने के लिए टेबल ढूँढें और उसे एक्सपैंड करें। चित्र: लेखक।
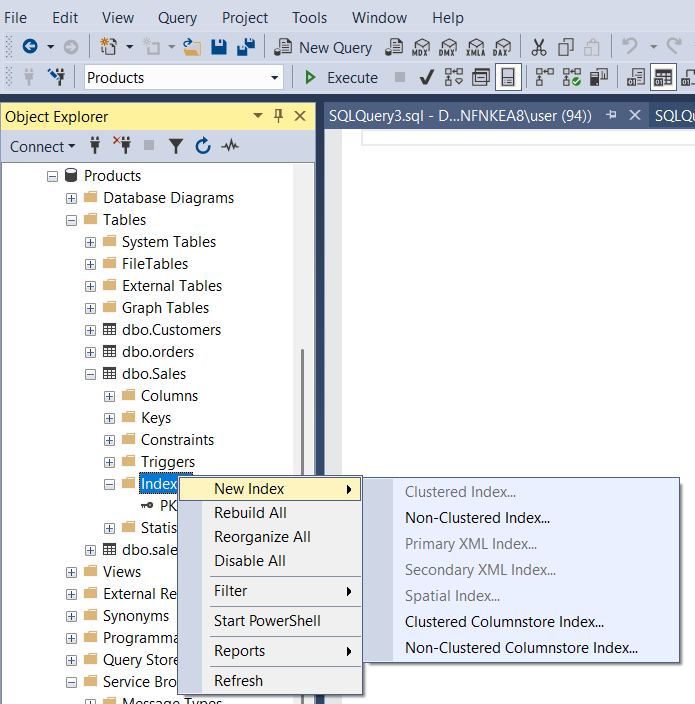
Index फ़ोल्डर खोलें और नया इंडेक्स बनाने के लिए राइट-क्लिक करें। चित्र: लेखक।
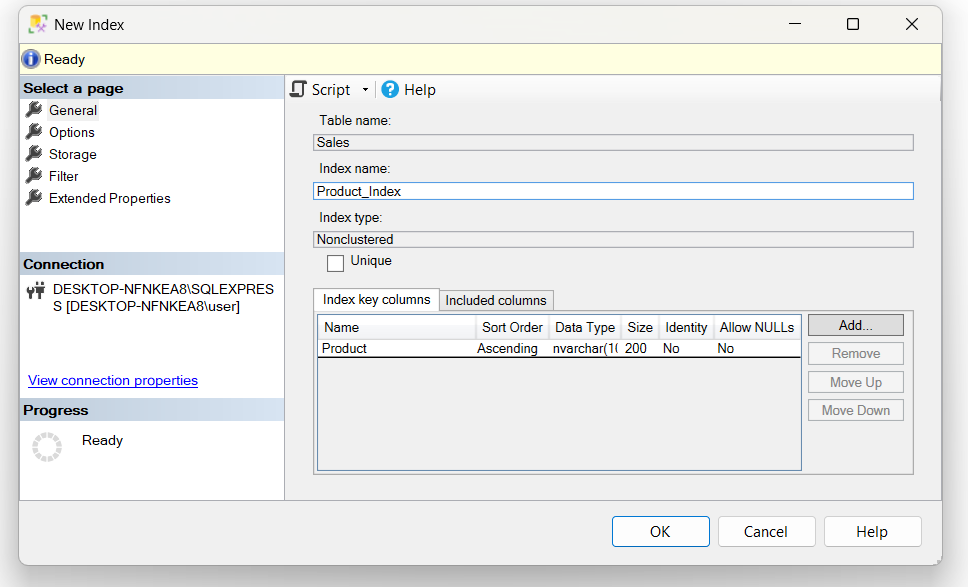
इंडेक्स का प्रकार चुनें और गुण निर्धारित करें। चित्र: लेखक।
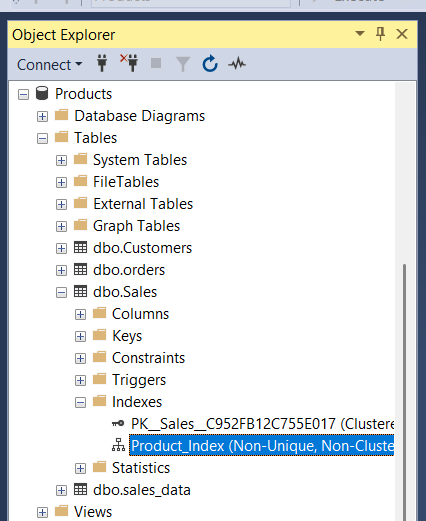
OK पर क्लिक करके इंडेक्स बनाएँ। चित्र: लेखक।
आप सीधे T-SQL कमांड्स के माध्यम से भी इंडेक्स बना सकते हैं। नीचे क्वेरीज़ का उपयोग करके अलग-अलग प्रकार के इंडेक्स बनाने के उदाहरण दिए गए हैं:
-- Create a non-clustered index on the Product column
CREATE NONCLUSTERED INDEX IX_Sales_Product
ON Sales (Product);

-- Create a unique index on the combination of CustomerName and OrderDate
CREATE UNIQUE NONCLUSTERED INDEX IX_Sales_CustomerName_OrderDate
ON Sales (CustomerName, OrderDate);

-- Create a clustered index on the OrderDate column
CREATE CLUSTERED INDEX IX_Sales_OrderDate
ON Sales (OrderDate);आप एक सीधी विधि का उपयोग करके इंडेक्स ड्रॉप कर सकते हैं। सावधान रहें, क्योंकि इंडेक्स हटाने से क्वेरी प्रदर्शन प्रभावित हो सकता है।
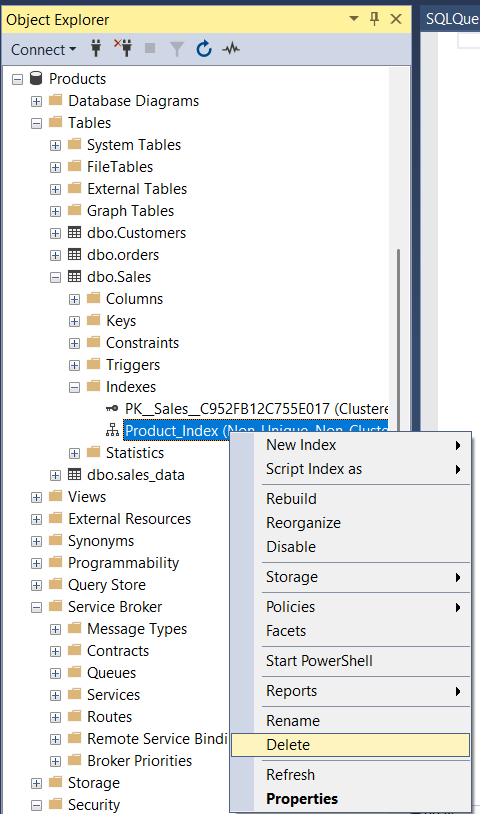
जिस इंडेक्स को हटाना है उस तक जाएँ। चित्र: लेखक।
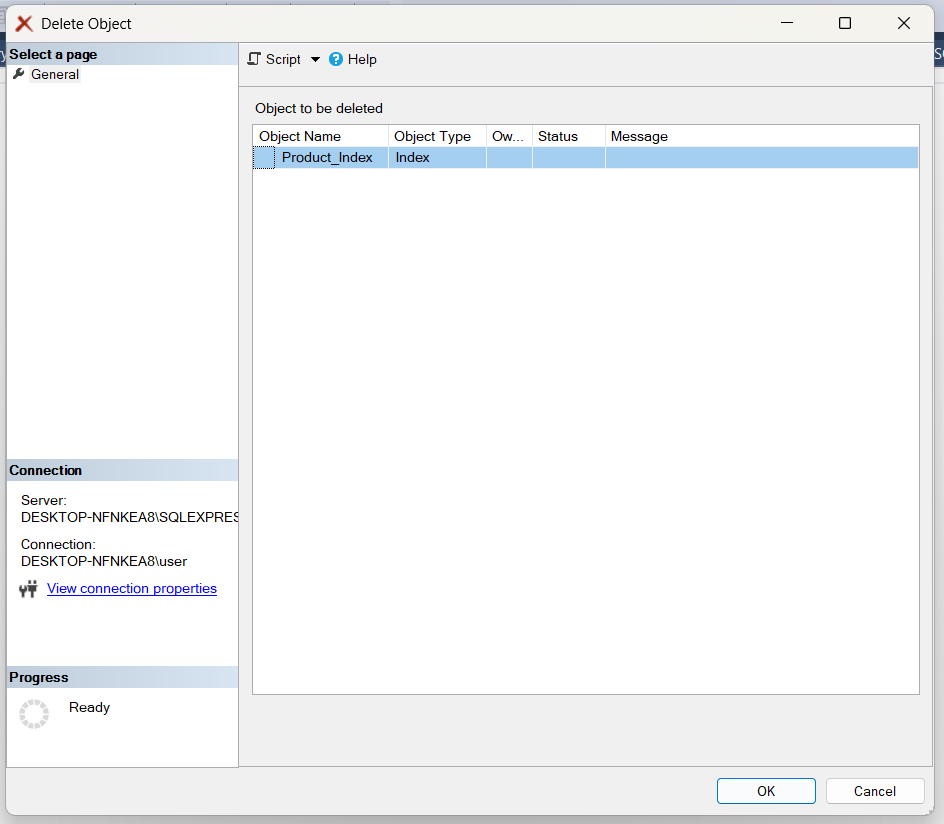
डायलॉग बॉक्स में डिलीशन की पुष्टि करें और OK पर क्लिक करें। चित्र: लेखक।
आप SQL Server में किसी टेबल से मौजूदा इंडेक्स हटाने के लिए निम्न कमांड्स का उपयोग कर सकते हैं।
-- Drop a non-clustered index
DROP INDEX IX_Sales_Product ON Sales;

-- Drop a clustered index
DROP INDEX IX_Sales_OrderDate ON Sales;किसी इंडेक्स को रीऑर्गनाइज़ करना इंडेक्स के लीफ-लेवल पेजेज़ का डीफ़्रैगमेंटेशन करता है, जिससे उसे पूरी तरह रिबिल्ड किए बिना प्रदर्शन में सुधार होता है।
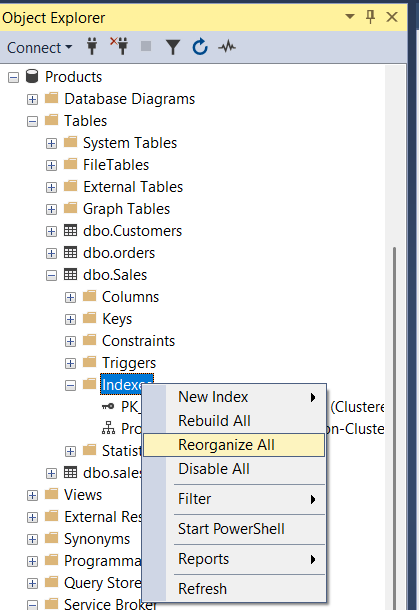
Indexes पर राइट-क्लिक करें, फिर Reorganize All। चित्र: लेखक।
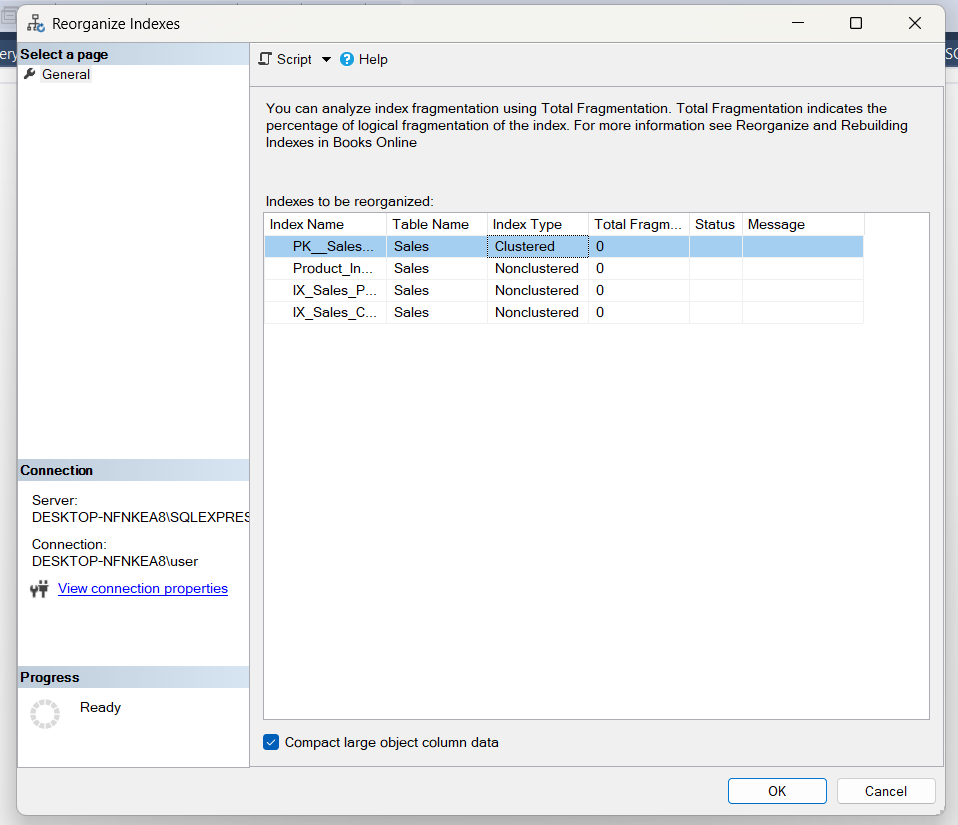
पुनर्गठित करने के लिए इंडेक्स चुनें, फिर पुष्टि करें। चित्र: लेखक
आप SQL Server में इंडेक्स को पुनर्गठित करने के लिए निम्नलिखित क्वेरियों का भी उपयोग कर सकते हैं।
-- Reorganize a single index
ALTER INDEX IX_Sales_Product
ON Sales
REORGANIZE;

-- Reorganize all indexes on the table
ALTER INDEX ALL
ON Sales
REORGANIZE;किसी इंडेक्स को रिबिल्ड करना उसे शुरू से दोबारा बनाता है, जिससे विखंडन समाप्त होता है और स्टोरेज अनुकूलित होता है।
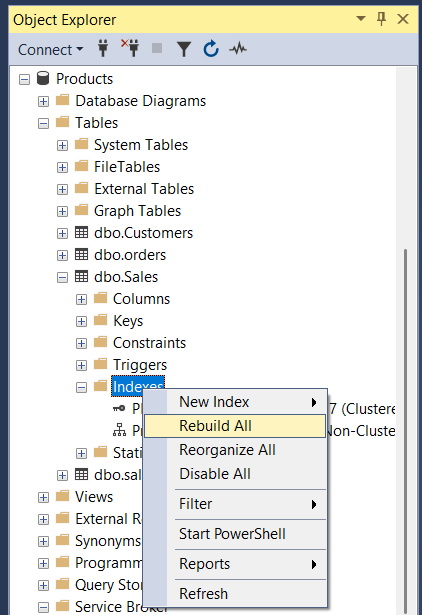
इंडेक्स पर राइट-क्लिक करें, फिर Rebuild All पर जाएँ। चित्र: लेखक
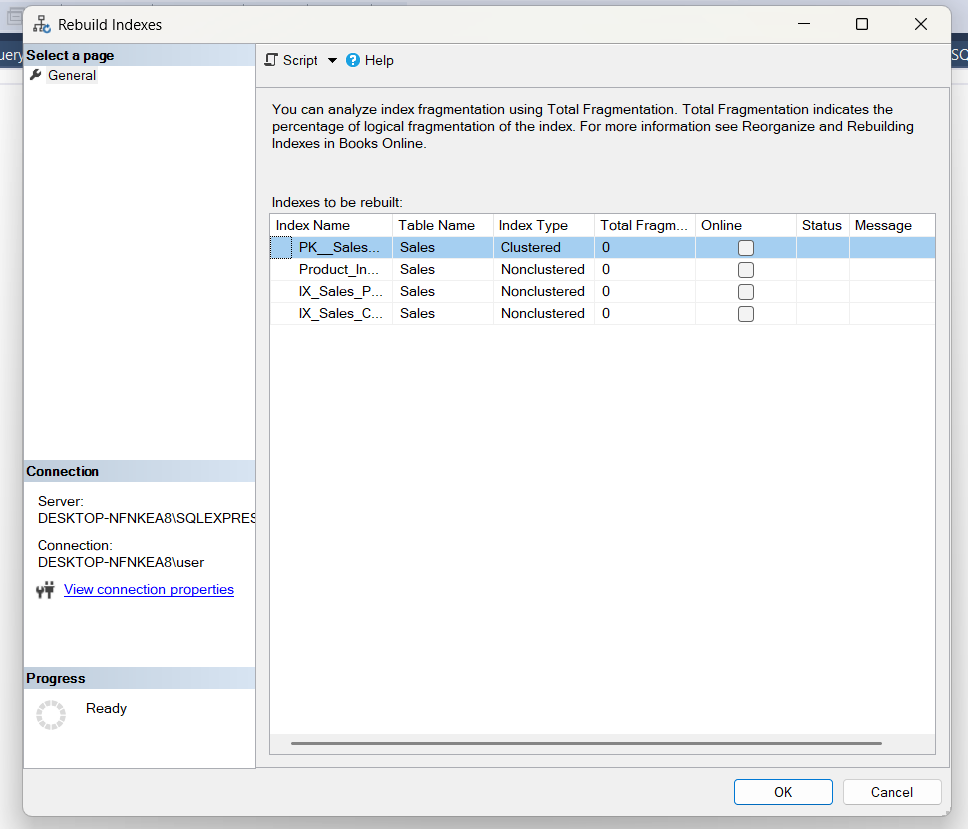
रिबिल्ड के लिए इंडेक्स चुनें और पुष्टि करें। चित्र: लेखक
निम्नलिखित क्वेरी तालिका पर मौजूद इंडेक्स को रिबिल्ड कर देगी।
-- Rebuild a single index
ALTER INDEX IX_Sales_Product
ON Sales
REBUILD;

-- Rebuild all indexes on the table
ALTER INDEX ALL
ON Sales
REBUILD;SQL Server इंडेक्स का रखरखाव और अनुकूलन उच्चतम डेटाबेस प्रदर्शन सुनिश्चित करने के लिए महत्वपूर्ण है। प्रभावी इंडेक्स प्रबंधन के लिए निम्नलिखित सुझाव ध्यान में रखें।
नियमित रूप से इंडेक्स का रखरखाव करें: अपने इंडेक्स को नियमित रूप से पुनर्गठित या रिबिल्ड करें ताकि विखंडन कम हो, जो समय के साथ प्रदर्शन घटाता है। इन कार्यों को स्वचालित करने के लिए मेंटेनेंस स्क्रिप्ट्स या SQL Server Maintenance Plans जैसे टूल का उपयोग करें।
इंडेक्स उपयोग का विश्लेषण करें: Dynamic Management Views (DMVs), जैसे sys.dm_db_index_usage_stats, का उपयोग करके अप्रयुक्त या कम उपयोग किए गए इंडेक्स की पहचान करें। ऐसे इंडेक्स हटाएँ जो कोई महत्वपूर्ण प्रदर्शन लाभ नहीं देते, ताकि अनावश्यक ओवरहेड से बचा जा सके।
ओवर-इंडेक्सिंग से बचें: बहुत अधिक इंडेक्स लिखने के ऑपरेशन्स (INSERT, UPDATE, DELETE) को धीमा कर सकते हैं क्योंकि सभी संबंधित इंडेक्स अपडेट होने होते हैं। उन कॉलम्स पर इंडेक्सिंग पर ध्यान दें जो अक्सर SELECT क्वेरियों, जॉइन्स या फिल्टरिंग कंडीशंस में उपयोग होते हैं।
विखंडन स्तरों की निगरानी करें: भारी विखंडित इंडेक्स की पहचान करने के लिए sys.dm_db_index_physical_stats का उपयोग करें। 30% से कम विखंडन पर इंडेक्स को पुनर्गठित करें और 30% से अधिक विखंडन पर उन्हें रिबिल्ड करें।
फ़िल्टर्ड इंडेक्स का लाभ उठाएँ: ऐसे क्वेरियों को अनुकूलित करने के लिए फ़िल्टर्ड इंडेक्स का उपयोग करें जो किसी डेटा उपसमूह पर काम करते हैं, जैसे सक्रिय उपयोगकर्ता या विशिष्ट तिथि रेंज।
अपने इंडेक्स प्रबंधन के दौरान सामान्य गलतियों से बचने के लिए निम्न बातों पर भी खास ध्यान दें:
ओवर-इंडेक्सिंग: हर क्वेरी के लिए इंडेक्स बनाने से बचें; इससे लिखने के ऑपरेशन्स और स्टोरेज पर प्रभाव पड़ता है।
मेंटेनेंस की उपेक्षा: इंडेक्स को रिबिल्ड या पुनर्गठित न करने से विखंडन बढ़ता है।
लिखने के लिए इंडेक्सिंग को नज़रअंदाज़ करना: जहाँ इंडेक्स रीड को तेज़ करते हैं, वे लिखने की गति को काफी धीमा कर सकते हैं।
कम्पोज़िट इंडेक्स का परीक्षण न करना: कम्पोज़िट इंडेक्स में कॉलम क्रम सही न होने पर वे प्रभावहीन हो सकते हैं।
SQL Server में ट्रांज़ैक्शन्स और एरर हैंडलिंग के बारे में अधिक जानने और क्वेरी प्रदर्शन सुधारने के लिए DataCamp का SQL Server for Database Administrators स्किल ट्रैक देखें।
इंडेक्स डेटाबेस प्रदर्शन को अनुकूलित करने के लिए उपयोगी हैं, पर कुछ ट्रेड-ऑफ भी आते हैं। उनके प्रभाव को समझना और उन्हें प्रभावी ढंग से प्रबंधित करना एक सुचारु डेटाबेस सिस्टम बनाए रखने के लिए आवश्यक है।
इंडेक्स क्वेरी निष्पादन योजनाओं और प्रदर्शन को उल्लेखनीय रूप से प्रभावित करते हैं, क्योंकि वे डेटा पुनर्प्राप्ति में लगने वाला समय घटाते हैं। ये SQL Server को पंक्तियों को तेज़ी से ढूँढने में सक्षम बनाते हैं, जिससे महंगे फुल टेबल स्कैन की आवश्यकता कम होती है। प्रभावी इंडेक्स होने पर निष्पादन योजनाएँ अक्सर Table Scan के बजाय Index Seek जैसे ऑपरेशन्स दिखाती हैं।
इंडेक्स प्रदर्शन मापने के लिए निम्नलिखित टूल उपयोगी हैं:
sys.dm_db_index_usage_stats यह ट्रैक करता है कि क्वेरियाँ इंडेक्स का कैसे उपयोग कर रही हैं।
sys.dm_db_index_operational_stats पेज रीड्स और राइट्स जैसे परिचालन मेट्रिक्स प्रदान करता है।
Query store क्वेरी प्रदर्शन का विश्लेषण करता है और मिसिंग या अप्रयुक्त इंडेक्स के कारण होने वाली अक्षमताओं की पहचान करता है।
उदाहरण के लिए, निम्नलिखित क्वेरी उपयोगकर्ता-परिभाषित तालिकाओं में इंडेक्स के उपयोग का आँकड़ा निकालती है—जिसमें seeks, scans, lookups, और updates का विवरण शामिल है—ताकि उनकी प्रभावशीलता और प्रदर्शन का आकलन किया जा सके।
-- Retrieve index usage statistics for user tables
SELECT
    OBJECT_NAME(IXS.OBJECT_ID) AS TableName,
    I.name AS IndexName,
    IXS.user_seeks AS Seeks,
    IXS.user_scans AS Scans,
    IXS.user_lookups AS Lookups,
    IXS.user_updates AS Updates
-- DMV providing index usage stats
FROM
    sys.dm_db_index_usage_stats IXS
JOIN
    sys.indexes I ON I.OBJECT_ID = IXS.OBJECT_ID
                 AND I.index_id = IXS.index_id
WHERE
OBJECTPROPERTY(IXS.OBJECT_ID, 'IsUserTable') = 1;जहाँ इंडेक्स डेटाबेस प्रदर्शन में सुधार करते हैं, वहीं वे स्टोरेज लागत भी बढ़ाते हैं क्योंकि वे डिस्क स्पेस उपयोग करते हैं, खासकर बड़े डेटा सेट पर। इंडेक्स लागू करते समय इन कारकों के बीच संतुलन समझना ज़रूरी है। अधिक इंडेक्स लिखने के ऑपरेशन्स को धीमा कर सकते हैं, विशेषकर उच्च-लेनदेन वातावरण में। संतुलन बनाने के लिए निम्नलिखित रणनीतियाँ अपनाएँ।
सिर्फ आवश्यक चीज़ों को इंडेक्स करें: उन कॉलम्स पर ध्यान दें जो अक्सर WHERE, JOIN, और ORDER BY क्लॉज़ में उपयोग होते हैं। शायद ही कभी क्वेरी किए जाने वाले कॉलम्स पर इंडेक्सिंग से बचें।
फ़िल्टर्ड इंडेक्स का उपयोग करें: डेटा के उपसमूहों के लिए इंडेक्स बनाएँ ताकि स्थान बचे और विशिष्ट क्वेरियाँ अनुकूलित हों।
कम्प्रेशन का लाभ उठाएँ: इंडेक्स के स्टोरेज फ़ुटप्रिंट को कम करने के लिए डेटा कम्प्रेशन सक्षम करें।
पुराने डेटा को आर्काइव करें: कम एक्सेस किए जाने वाले डेटा को आर्काइव तालिका में स्थानांतरित करें और मुख्य तालिका पर इंडेक्सिंग घटाएँ।
उपरोक्त रणनीतियाँ यह सुनिश्चित करेंगी कि क्वेरी प्रदर्शन उत्तम रहे, साथ ही स्टोरेज और मेंटेनेंस लागत नियंत्रित रहे।
यदि सही तरीके से मेंटेन न किए जाएँ, तो इंडेक्स समय के साथ बिगड़ सकते हैं और डेटाबेस की दक्षता घटा सकते हैं। आइए जानें कि इन समस्याओं की पहचान और समाधान कैसे करें।
विखंडन (Fragmentation): समय के साथ इंडेक्स विखंडित हो जाते हैं, जिससे डेटा पुनर्प्राप्ति अक्षम हो जाती है। इसके संकेतों में क्वेरी निष्पादन समय का बढ़ना और उच्च डिस्क I/O शामिल हैं। इसे हल करने के लिए sys.dm_db_index_physical_stats से विखंडन की पहचान करें। फिर, 30% से कम विखंडन पर इंडेक्स को पुनर्गठित करें और 30% से अधिक पर रिबिल्ड करें।
पुराना स्टैटिस्टिक्स: बासी स्टैटिस्टिक्स से सबऑप्टिमल क्वेरी निष्पादन योजनाएँ बनती हैं। इसलिए, उपयुक्त इंडेक्स होने पर भी क्वेरियाँ धीमी हो सकती हैं। इस समस्या को सुलझाने के लिए महत्वपूर्ण इंडेक्स के स्टैटिस्टिक्स मैन्युअली अपडेट करें या AUTO_UPDATE_STATISTICS सक्षम करें।
अप्रयुक्त या अनावश्यक इंडेक्स: कुछ इंडेक्स उपयोग में नहीं आते, फिर भी स्टोरेज घेरते हैं और लिखने के ऑपरेशन्स को धीमा करते हैं। इसके लक्षण हैं ऊँची इंडेक्स मेंटेनेंस लागत, कम क्वेरी लाभ। इस समस्या के समाधान के लिए sys.dm_db_index_usage_stats से अप्रयुक्त इंडेक्स पहचानें और आवश्यकता अनुसार उन्हें ड्रॉप करें।
मिसिंग इंडेक्स: उचित इंडेक्स की कमी से टेबल स्कैन होते हैं, जिससे क्वेरियाँ धीमी पड़ती हैं। ऐसी स्थितियों में क्वेरी निष्पादन योजनाएँ Index Seek के बजाय Table Scan दिखाती हैं। इसका समाधान करने के लिए Missing Index DMV sys.dm_db_missing_index_details का उपयोग करें, अवसरों की पहचान करें और क्वेरी पैटर्न के आधार पर अनुशंसित इंडेक्स बनाएँ।
ओवरलैपिंग इंडेक्स: समान कॉलम संरचनाओं वाले एकाधिक इंडेक्स संसाधनों की बर्बादी करते हैं, जिससे स्टोरेज उपयोग और अनावश्यक मेंटेनेंस ऑपरेशन्स बढ़ते हैं। हमेशा ओवरलैपिंग इंडेक्स को समेकित करके एक सुव्यवस्थित इंडेक्स बनाएँ।
डेटाबेस दक्षता बढ़ाने के लिए SQL Server में इंडेक्स संबंधी समस्याओं का निवारण सीखने हेतु हमारा SQL Server Developer करियर ट्रैक आज़माएँ।
SQL Server इंडेक्स में महारत हासिल करना, कुशल क्वेरियाँ लिखकर डेटाबेस प्रदर्शन सुधारने के लिए आवश्यक है। इंडेक्स के साथ काम करते समय, उनके अलग-अलग प्रकारों को समझना भी ज़रूरी है ताकि आप अपने इंडेक्स का प्रबंधन सर्वोत्तम डेटाबेस प्रदर्शन के लिए कर सकें।
कुशल डेटा विश्लेषक बनने के लिए मैं हमारा Associate Data Analyst in SQL करियर ट्रैक सुझाता हूँ। हमारा Reporting in SQL कोर्स भी जटिल रिपोर्ट और डैशबोर्ड बनाने में आपकी दक्षता बढ़ाएगा ताकि डेटा प्रस्तुति प्रभावी हो। यदि आप ऐसा इंटरव्यू दे रहे हैं जिसमें SQL Server कौशल दिखाने होते हैं, तो अभ्यास और सफल होने में मदद के लिए हमारा ब्लॉग Top 30 SQL Server Interview Questions देखना न भूलें।
DataCamp के साथ SQL Server सीखें
कोर्स
कोर्स
कोर्स