Curso
Entendendo a ciência de dados
2 h
872K
Embora o AWS EC2 lidere a computação em nuvem, o Google Cloud desenvolveu uma plataforma de cloud computing muito competitiva e atraente.
Neste tutorial, você vai aprender a:
Trabalhar na nuvem em vez do seu próprio computador tem duas grandes vantagens para projetos de ciência de dados:
Embora baseados nos mesmos conceitos e elementos (instâncias, imagens e snapshots), EC2 e GCE diferem tanto no acesso quanto na organização de recursos.
Um aspecto central do Google Cloud Platform (GCP) é sua organização centrada em projetos. Toda a cobrança, permissões, recursos e configurações ficam agrupados dentro de um projeto definido pelo usuário, que funciona como um namespace global. Isso não só simplifica o mapeamento interconectado dos recursos que você usa (armazenamento, bancos de dados, instâncias, ...) como também a gestão de acesso, desde permissões por função até chaves SSH e segurança. Em termos de facilidade de uso e gestão de acessos e papéis, considero o GCP mais simples que a AWS, especialmente ao usar vários serviços.
O GCP também oferece serviços particularmente relevantes para ciência de dados, incluindo (mas não só):
Curva de aprendizado baixa e serviços amigáveis a dados fazem do GCP um item indispensável na sua caixa de ferramentas de cientista de dados.
Antes de sair criando instâncias e instalando pacotes Python, vamos revisar rapidamente alguns termos comuns usados em computação em nuvem.
Uma máquina virtual (VM), também chamada de "instância", é um servidor sob demanda que você ativa conforme precisa. O hardware subjacente é compartilhado entre usuários de forma transparente e, para você, torna-se totalmente virtual. Você só escolhe a localização geográfica global da instância, hospedada em um dos data centers do Google.
Uma VM é definida pelo tipo de disco persistente e pelo sistema operacional (SO), como Windows ou Linux, sobre o qual é construída. O disco persistente é sua fatia virtual de hardware.
Uma imagem é a combinação física de um disco persistente com o sistema operacional. Imagens de VM são frequentemente usadas para compartilhar e aplicar uma configuração específica em várias outras VMs. Imagens públicas são fornecidas pelo Google com opções de SO; imagens privadas são personalizadas pelos usuários.
Um snapshot é um retrato do conteúdo de uma VM (disco, softwares, bibliotecas, arquivos) em um dado momento e é usado principalmente para backups instantâneos. A principal diferença entre snapshots e imagens é que snapshots são armazenados como diffs, em relação a snapshots anteriores, enquanto imagens não.
Tanto uma imagem quanto um snapshot podem ser usados para definir e ativar uma nova VM.
Resumindo: ao lançar uma nova instância, o GCE começa anexando um disco persistente à sua VM. Isso fornece o espaço em disco e dá à instância o sistema de arquivos raiz necessário para inicializar. O disco instala o SO associado à imagem escolhida. Ao tirar snapshots de uma imagem, você cria backups instantâneos e pode copiar dados de VMs existentes para lançar novas VMs.
Vamos colocar tudo isso em prática e criar sua primeira VM!
Para abrir uma conta no GCP, você precisa de uma conta Google (Gmail) padrão. No momento da escrita, o Google oferece um teste grátis de 12 meses / US$ 300 da plataforma. Embora essa oferta tenha algumas restrições (nada de mineração de bitcoin, por exemplo), deve ser suficiente para você começar a trabalhar nesse ambiente.
Para criar sua conta do GCP com o teste gratuito, acesse cloud.google.com e clique no botão try it free. Você será solicitado a fazer login com sua conta Google e adicionar suas informações de cobrança. Depois que a conta for criada, acesse o console web em http://console.cloud.google.com/.
Você vai usar primeiro o console web para definir e lançar uma instância baseada em Debian e, depois, alternar para o terminal web (Cloud Shell) para instalar todos os pacotes necessários para sua stack de ciência de dados.
Mas antes, é preciso criar um novo projeto:
O ID do projeto precisa ser único em todo o espaço de nomes do GCP, enquanto o título do projeto pode ser qualquer coisa. Eu nomeei meu projeto como datacamp-gcp, como mostrado abaixo:
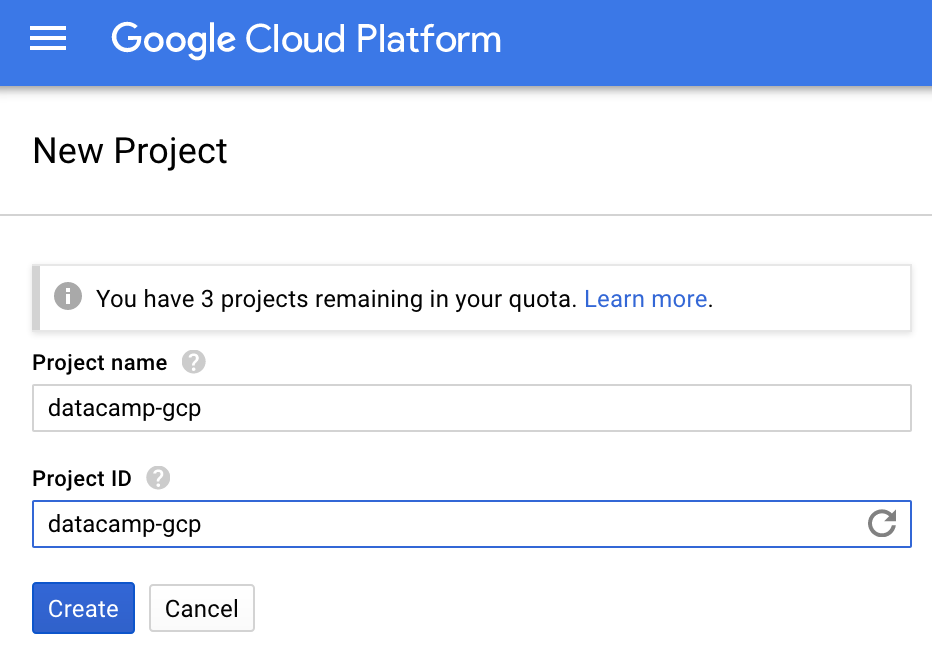
Por padrão, ao criar um novo projeto, sua conta Google é definida como proprietária do projeto, com permissões e acesso completos a todos os recursos e à cobrança do projeto.
Na seção de papéis da página IAM, você pode adicionar pessoas com funções específicas ao seu projeto. Para este tutorial, vamos pular essa parte e manter você como único usuário e admin do projeto.
Para criar sua primeira VM, faça o seguinte:
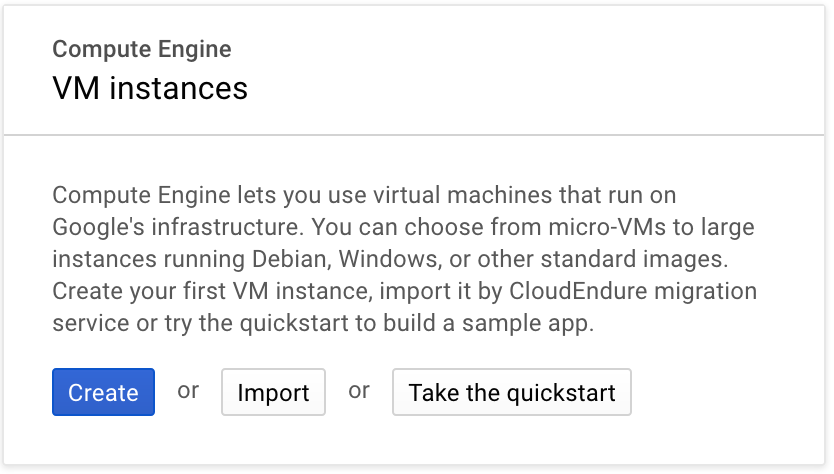
Agora você está na página "Create an Instance".
Dê um nome à instância: você pode escolher qualquer nome. Eu chamei a minha de starling.
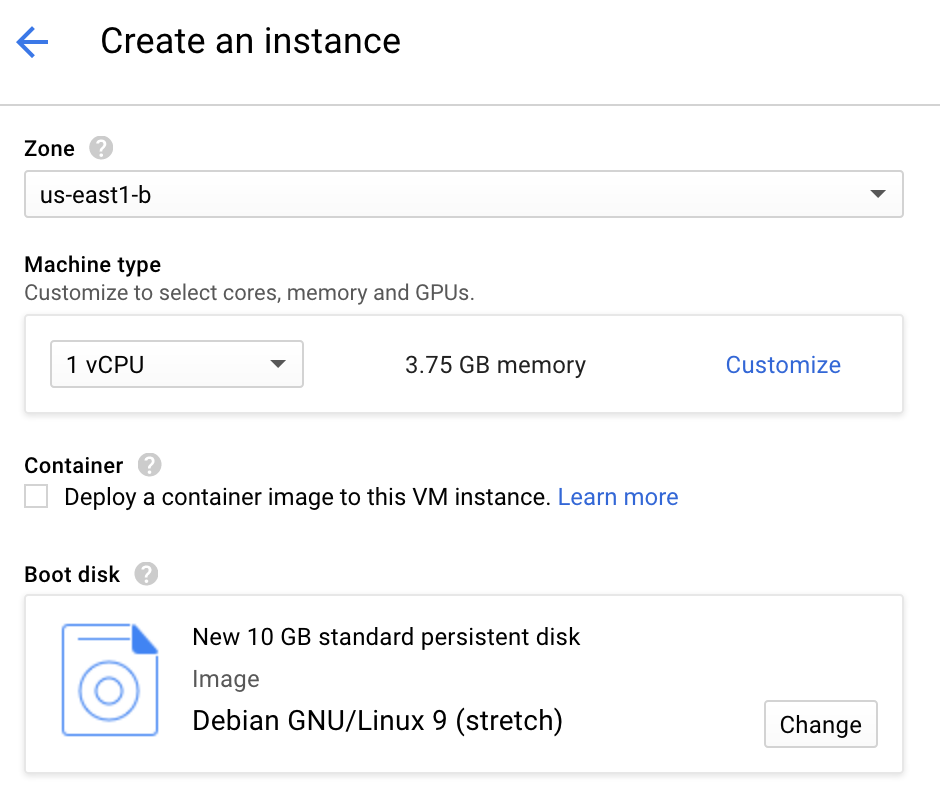
Selecione a região: a regra geral é escolher a região mais barata e mais próxima de você para minimizar a latência. Eu escolhi east-d. Observe que os preços variam bastante por região.
Selecione a memória, armazenamento e CPU que você precisa. Você pode usar um dos presets ou personalizar sua instância. Aqui, escolhi a configuração padrão n1-standard-1 com 3,75 GB de RAM e 1 vCPU por um preço estimado de US$ 24,67 por mês.
Selecione o boot disk e mantenha o Debian GNU/Linux 9 (stretch) padrão com 10 GB. Se preferir usar Ubuntu ou outra distribuição Linux, clique em "Change" e faça a seleção. Como o Ubuntu é uma derivação próxima do Debian, ambas as distribuições funcionam para este tutorial.
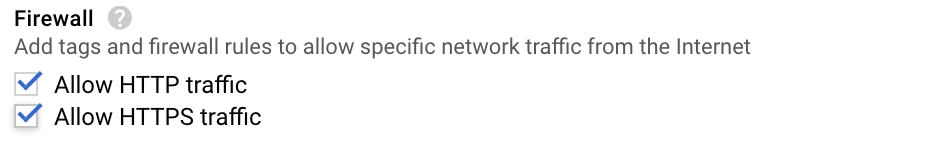
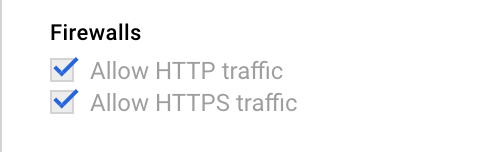
5.Certifique-se de poder acessar a VM pela internet permitindo tráfego http e https.
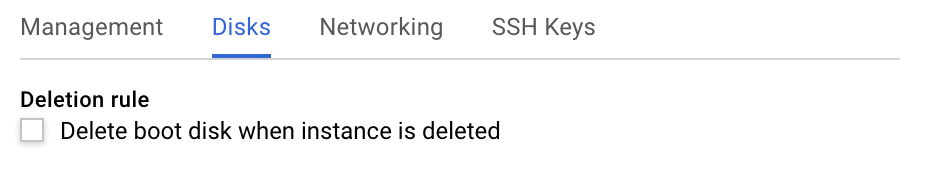
6.(Opcional) Habilite um disco persistente para fins de backup: clique no link "Management, Disks, networking, SSH keys". Isso exibe um conjunto de abas; selecione a aba "Disks" e desmarque "Deletion Rule". Assim, quando você excluir sua instância, o disco não será excluído e poderá ser usado depois para iniciar uma nova instância.
7.Por fim, clique em "Create". Sua instância ficará pronta em alguns minutos.
Repare no link "Equivalent command line" abaixo do botão Create. Ele mostra a linha de comando equivalente para criar a mesma instância do zero. É um recurso muito inteligente que facilita aprender a sintaxe do gcloud SDK.
Neste ponto, você tem uma instância em execução, praticamente vazia. Há duas formas de acessá-la: instalando o gcloud SDK na sua máquina local ou usando o Cloud Shell do Google.
O Cloud Shell do Google é um terminal standalone no seu navegador a partir do qual você gerencia seus recursos. Ative o Cloud Shell clicando no ícone >\_ no canto superior direito da página do console. A parte inferior do navegador vira um terminal.
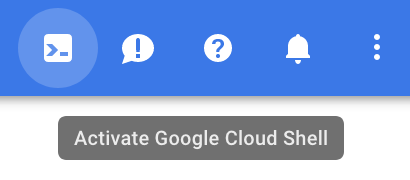
Esse terminal roda em uma VM f1-micro do Google Compute Engine com sistema Debian e 5 GB de armazenamento. É criada por usuário e por sessão. Ela persiste enquanto sua sessão do Cloud Shell estiver ativa e é excluída após 20 minutos de inatividade. Como o disco associado é persistente entre sessões, seu conteúdo (arquivos, configurações, ...) fica disponível de uma sessão para outra. A instância do Cloud Shell já vem com o gcloud SDK e o vim instalados.
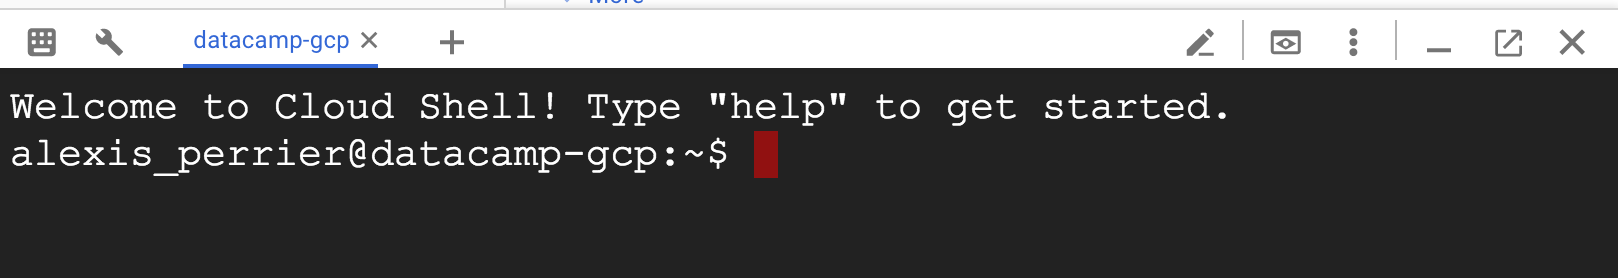
É importante diferenciar a instância do Cloud Shell, que é por usuário, da instância que você acabou de criar. A instância por trás do Cloud Shell é apenas uma forma prática de ter um ambiente de gestão de recursos e guardar configurações em uma instância efêmera. A VM que você criou, chamada starling no exemplo acima, é onde você vai instalar seu ambiente de ciência de dados.
Em vez de usar o Cloud Shell, você também pode instalar o gcloud SDK na sua máquina local e gerenciar tudo a partir do seu ambiente.
Aqui vão alguns comandos úteis para gerenciar suas instâncias.
Listar suas instâncias
gcloud compute instances list
Parar a instância (leva alguns segundos)
gcloud compute instances stop <instance name>
Iniciar a instância (também leva alguns segundos)
gcloud compute instances start <instance name>
e acessar via ssh a instância starling
gcloud compute ssh <instance name>
Rode esse último comando na janela do Google Shell para fazer login na sua instância. Os próximos passos serão:
apt-get install.Vamos começar instalando os pacotes Debian:
Execute os seguintes comandos, que funcionam tanto no Ubuntu quanto no Debian, no terminal:
$ sudo apt-get update
$ sudo apt-get install bzip2 git libxml2-dev
Depois de instalar os pacotes acima, vamos instalar a distribuição Anaconda para Python 3. Você pode escolher entre instalar a versão completa do Anaconda, que inclui muitas bibliotecas científicas Python (algumas talvez desnecessárias para você), ou instalar a versão mais leve, Miniconda, que exige a instalação manual das bibliotecas do Jupyter. O processo é bem parecido em ambos os casos.
Para instalar a distribuição Miniconda, mais enxuta, rode
$ wget https://repo.continuum.io/miniconda/Miniconda3-latest-Linux-x86_64.sh
$ bash Miniconda3-latest-Linux-x86_64.sh
$ rm Miniconda3-latest-Linux-x86_64.sh
$ source .bashrc
$ conda install scikit-learn pandas jupyter ipython
O script de instalação é baixado e executado nas 2 primeiras linhas. Aceite a licença e o local padrão. Na linha 3, o arquivo de instalação, já desnecessário, é removido. Ao executar .bashrc na linha 4, o comando conda é adicionado ao seu $PATH sem precisar abrir um novo terminal. Por fim, a última linha instala as bibliotecas Python necessárias: scikit-learn pandas jupyter ipython.
Os comandos para instalar a distribuição completa do Anaconda são muito semelhantes. Verifique a página de download para obter a versão mais recente do arquivo de instalação:
$ wget https://repo.continuum.io/archive/Anaconda3-5.0.1-Linux-x86_64.sh
$ bash Anaconda3-5.0.1-Linux-x86_64.sh
$ rm Anaconda3-5.0.1-Linux-x86_64.sh
$ source .bahsrc
Para verificar se tudo foi instalado corretamente, confira a versão do Python com python --version e verifique se o Python correto é chamado por padrão com o comando which python. Você deve obter algo semelhante a
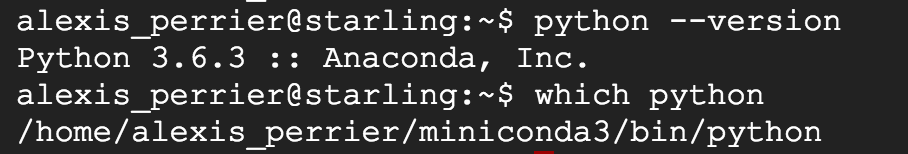
Agora você tem um ambiente Python funcionando com as bibliotecas padrão de ciência de dados instaladas (sklearn, pandas).
O terceiro e último passo é configurar sua VM para permitir o acesso via web aos seus Jupyter notebooks.
Primeiro, você precisa tornar a VM acessível pela web. Para isso, crie uma regra de firewall pelo console do Google Cloud. Volte ao painel de instâncias e, no menu superior esquerdo, selecione "VPC Network > Firewall rules". Clique em "CREATE FIREWAL RULE" e preencha os seguintes valores:
O formulário deve ficar assim:
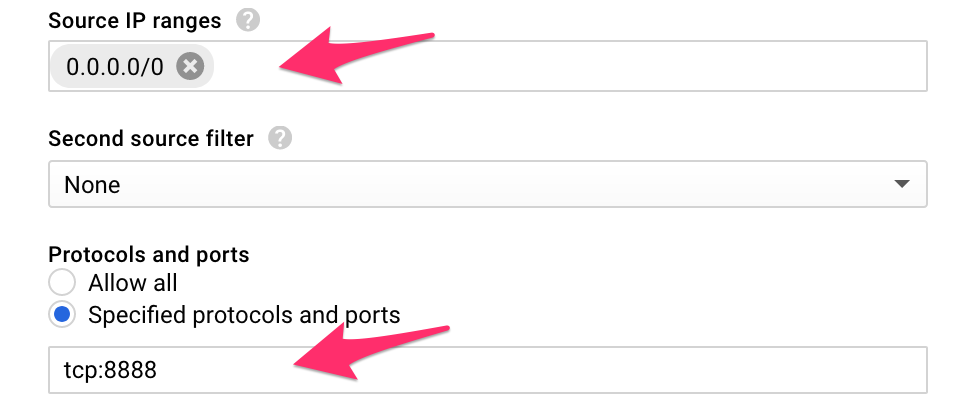
Essa regra de firewall permite que todo tráfego de entrada (de todos os IPs) acesse a porta 8888.
Usando o link "Equivalent command line", você vê que a regra de firewall também pode ser criada pelo terminal com o seguinte comando:
$ gcloud compute --project=datacamp-gcp firewall-rules create jupyter-rule --direction=INGRESS --priority=1000 --network=default --action=ALLOW --rules=tcp:8888 --source-ranges=0.0.0.0/0
Agora volte à página da VM (menu superior esquerdo > Compute Engine > VM instances) e clique no nome da sua VM.
Anote o endereço IP da sua VM. Esse é o IP que você vai usar no navegador para acessar o ambiente Jupyter. No meu exemplo, o IP é: 35.196.81.49; o seu será diferente.
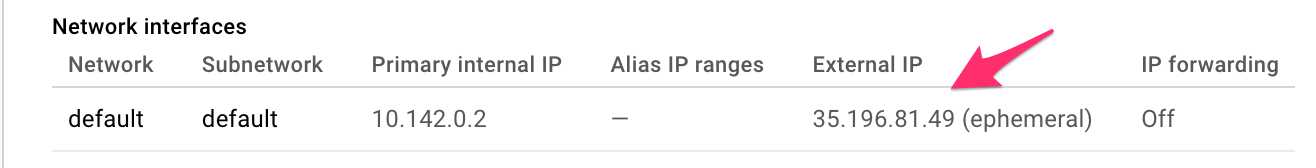
e verifique se as regras de firewall estão marcadas:
Os Jupyter notebooks têm um arquivo de configuração que precisa ser gerado e editado para habilitar o acesso online aos seus notebooks. No terminal, rode jupyter notebook --generate-config para gerar o arquivo de configuração. E jupyter notebook password para criar uma senha.
Dica: garanta que seja uma senha forte!
Agora edite o arquivo de configuração que você acabou de criar com vim .jupyter/jupyter_notebook_config.py e adicione a seguinte linha no topo do arquivo
c.NotebookApp.ip = '*'
(para entrar no modo de edição no vim, basta digitar o caractere i). Saia e salve com a sequência ESC:wq.
Isso fará com que o notebook fique disponível para todos os endereços IP da sua VM e não apenas em http://localhost:8888, URL com a qual você pode estar acostumado ao trabalhar localmente.
Agora você está pronto para iniciar seu Jupyter notebook com o comando:
$ jupyter-notebook --no-browser --port=8888
E você deverá ver algo assim no terminal:

No seu navegador, acesse a URL: http://<your_VM_IP>:8888/ para abrir seu Jupyter notebook recém-operacional.
Para checar se tudo está funcionando, crie um novo notebook Python 3 e rode import pandas
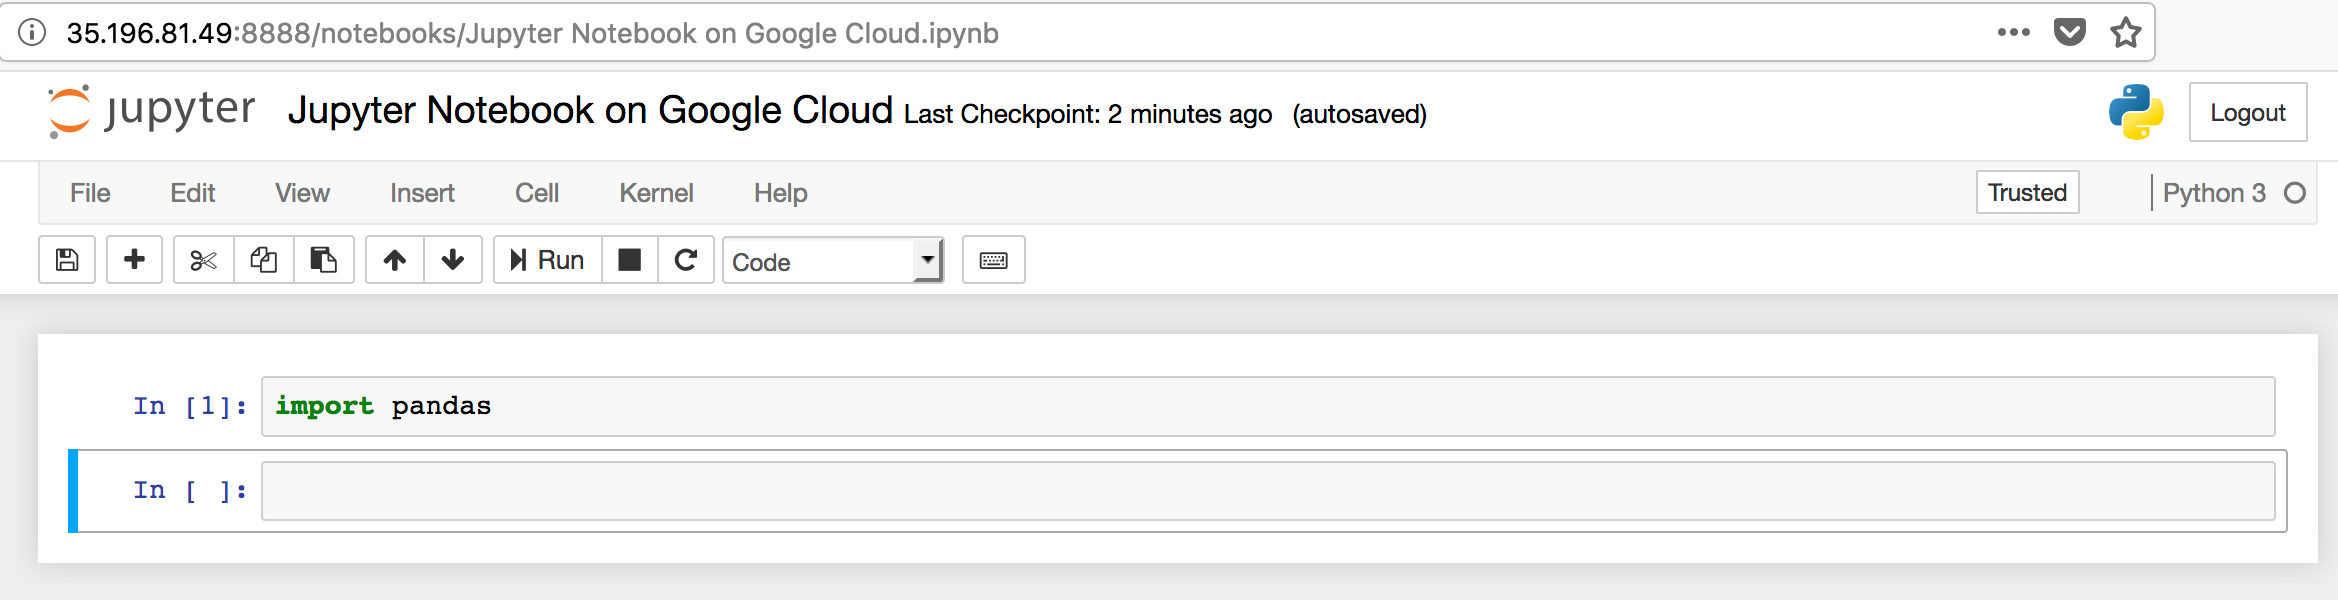
Algumas observações sobre sua configuração atual:
O endereço IP que você usou no navegador é efêmero. Ou seja, sempre que reiniciar sua VM, seus notebooks terão uma URL diferente. Você pode tornar esse IP estático indo em: Menu superior esquerdo > VPC Network > External IP addresses e selecionando "static" no menu suspenso 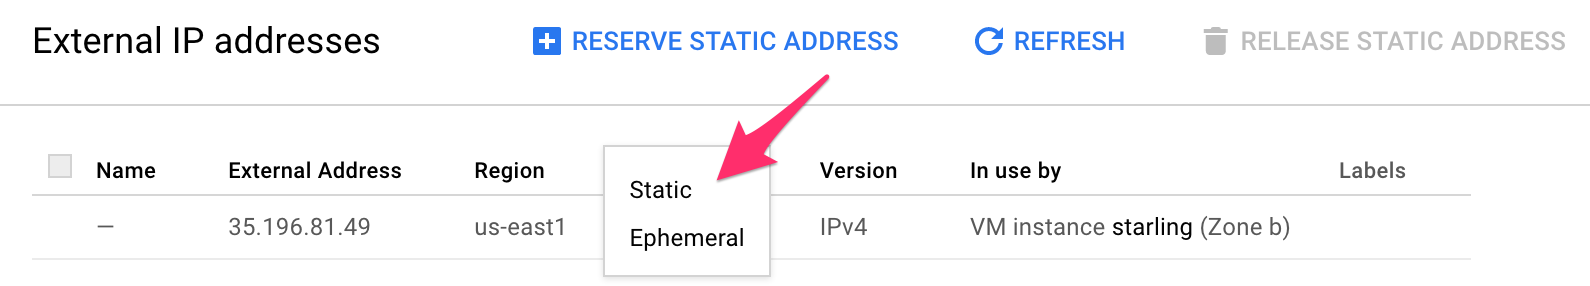
A segurança da sua configuração atual depende da força da senha do Jupyter notebook que você definiu. Qualquer pessoa na internet pode tentar acessar seu ambiente Jupyter pela mesma URL que você usa (e bots com certeza vão tentar). Um recurso poderoso, mas muito inseguro, dos Jupyter notebooks é que você pode abrir um terminal com acesso sudo diretamente do notebook. Isso significa que qualquer pessoa que invadir sua senha pode assumir o controle da sua VM e potencialmente rodar qualquer coisa, o que pode estourar sua fatura. As primeiras medidas para evitar isso incluem
Garantir que sua senha do Jupyter seja forte
Você também está executando o servidor via http e não https, o que não é seguro o suficiente. O Let’s Encrypt fornece certificados SSL/TLS gratuitos e é a solução de criptografia recomendada na documentação do Jupyter. Para saber mais sobre segurança ao rodar um Jupyter notebook público, leia este artigo.
Os Jupyter notebooks são ótimos para trabalho colaborativo online. Mas você também pode rodar uma sessão IPython diretamente no terminal com o comando ipython. Isso abre uma sessão IPython com todos os recursos de um Jupyter notebook, como magic commands (%paste, %run, ...), mas sem a interface web.
É fácil configurar sua VM para habilitar notebooks em R no console do Jupyter. As instruções para habilitar R Markdown estão disponíveis neste excelente tutorial da DataCamp: Jupyter And R Markdown: Notebooks With R, por Karlijn Willems.
O Google Cloud oferece muitos serviços interessantes para ciência de dados e instâncias de VM poderosas e fáceis de configurar, além de um teste gratuito bem atraente. O console web é fácil de navegar e frequentemente exibe a linha de comando equivalente às páginas de configuração atuais, o que reduz a barreira para usar o gcloud SDK.
Neste artigo, você aprendeu a selecionar e lançar uma instância de VM, instalar os pacotes Debian necessários, a distribuição Anaconda e a stack de ciência de dados e, por fim, como configurar as regras de acesso para iniciar um Jupyter notebook acessível pelo navegador.
Embora todo o processo possa parecer um pouco complexo na primeira vez, ele rapidamente se torna familiar conforme você cria e lança mais VMs. E, se algo ficar confuso, você sempre pode excluir a VM em que está trabalhando e recomeçar do zero. Essa é uma das vantagens de trabalhar na nuvem. Depois de algumas vezes, você vai conseguir colocar ambientes completos de ciência de dados no Google Cloud em poucos minutos. Fique à vontade para comentar e enviar suas perguntas para mim no Twitter: @alexip.
Saiba mais sobre ciência de dados
Curso
Curso
Curso
blog
Karlijn Willems
15 min
Tutorial
Adam Shafi
7 min
Tutorial
Javier Canales Luna
7 min
Tutorial
Vidhi Chugh
15 min
Tutorial
Tutorial
DataCamp Team
5 min