Cours
Comprendre la science des données
2 h
872.2K
Si AWS EC2 est le leader du cloud computing, Google Cloud a développé une plateforme cloud très convaincante et compétitive.
Dans ce tutoriel, vous allez apprendre à :
Travailler dans le cloud plutôt que sur votre propre machine présente deux avantages majeurs pour les projets de data science :
Bien que reposant sur les mêmes concepts et éléments (instances, images et instantanés), EC2 et GCE diffèrent en matière d’accès et d’organisation des ressources.
Un aspect clé de Google Cloud Platform (GCP) est son organisation centrée sur le projet. Toute la facturation, les autorisations, les ressources et les paramètres sont regroupés au sein d’un projet défini par l’utilisateur, qui agit en quelque sorte comme un espace de noms global. Cela simplifie non seulement la cartographie interconnectée des ressources que vous utilisez (stockage, bases de données, instances, ...), mais aussi la gestion des accès, des rôles aux clés SSH et à la sécurité. En termes d’ergonomie et de gestion des accès et des rôles, travailler sur GCP est, à mon sens, plus simple qu’avec AWS, surtout lorsqu’on combine plusieurs services.
GCP propose également des services particulièrement pertinents pour la data science, notamment :
Une courbe d’apprentissage douce et des services orientés données font de GCP un incontournable de la boîte à outils du data scientist.
Avant de lancer des instances et d’installer des packages Python, prenons un moment pour revoir le vocabulaire courant du cloud computing.
Une machine virtuelle (VM), aussi appelée « instance », est un serveur à la demande que vous activez selon vos besoins. Le matériel sous-jacent est partagé entre plusieurs utilisateurs de manière transparente et devient totalement virtuel pour vous. Vous choisissez uniquement une localisation géographique globale parmi les data centers de Google.
Une VM est définie par le type de disque persistant et le système d’exploitation (OS), tel que Windows ou Linux, sur lesquels elle repose. Le disque persistant est votre part virtuelle de matériel.
Une image est la combinaison du disque persistant et du système d’exploitation. Les images de VM sont souvent utilisées pour partager et déployer une configuration particulière sur plusieurs autres VM. Les images publiques sont fournies par Google avec un choix d’OS, tandis que les images privées sont personnalisées par les utilisateurs.
Un instantané (snapshot) reflète le contenu d’une VM (disque, logiciels, bibliothèques, fichiers) à un instant donné et sert principalement de sauvegarde instantanée. La principale différence entre instantanés et images est que les instantanés sont stockés sous forme de diffs par rapport aux précédents, alors que les images ne le sont pas.
Une image comme un instantané peuvent servir à définir et activer une nouvelle VM.
En résumé, lorsque vous lancez une nouvelle instance, GCE commence par attacher un disque persistant à votre VM. Cela fournit l’espace disque et le système de fichiers racine requis pour démarrer. Le disque installe l’OS associé à l’image que vous avez choisie. En prenant des instantanés d’une image, vous créez des sauvegardes instantanées et vous pouvez copier des données de VM existantes pour en lancer de nouvelles.
Passons à la pratique et démarrez votre première VM !
Pour ouvrir un compte sur GCP, vous avez besoin d’un compte Google (Gmail) standard. Au moment d’écrire ces lignes, Google propose un essai gratuit de 12 mois / 300 $ de la plateforme. Bien que cette offre comporte certaines restrictions (pas de minage de bitcoins, par exemple), elle est suffisante pour débuter.
Pour créer votre compte GCP avec l’essai gratuit, rendez-vous sur cloud.google.com et cliquez sur le bouton try it free. Il vous sera demandé de vous connecter avec votre compte Google et d’ajouter vos informations de facturation. Une fois votre compte créé, vous pouvez accéder à la console web sur http://console.cloud.google.com/.
Vous utiliserez d’abord la console web pour définir et lancer une instance basée sur Debian, puis vous basculerez vers le terminal shell en ligne pour installer tous les packages nécessaires à votre stack de data science.
Mais commencez par créer un nouveau projet :
L’ID du projet doit être unique dans l’espace de nommage GCP, tandis que le titre de projet peut être libre. Je nomme mon projet datacamp-gcp comme ci-dessous :
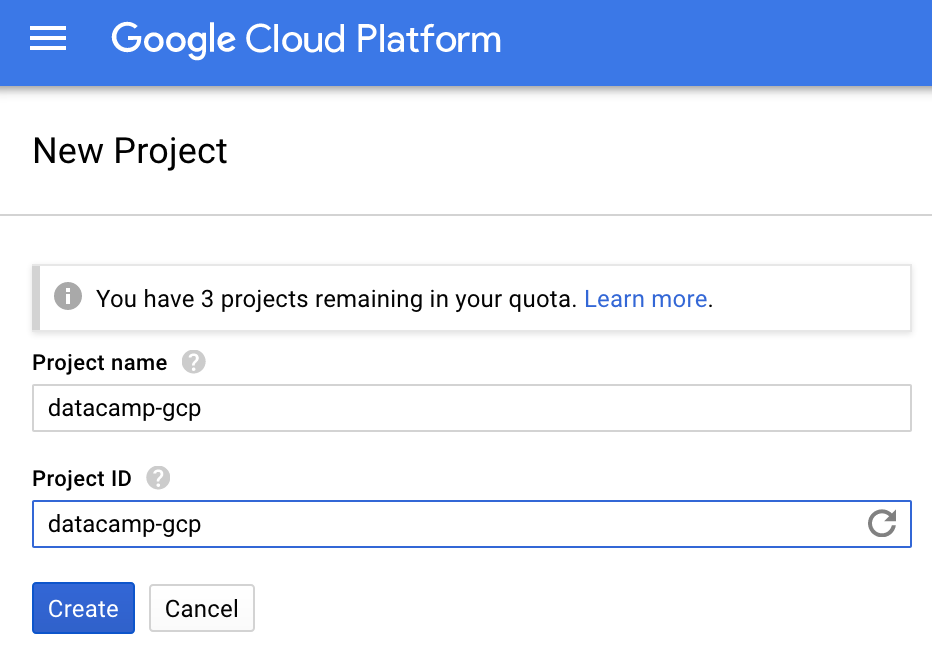
Par défaut, lorsque vous créez un nouveau projet, votre compte Google est défini comme propriétaire du projet avec tous les droits et accès sur l’ensemble des ressources et de la facturation.
Dans la section des rôles de la page IAM, vous pouvez ajouter des personnes avec des rôles spécifiques à votre projet. Pour ce tutoriel, vous passerez cette étape et resterez l’unique utilisateur et administrateur du projet.
Pour créer votre première VM, suivez simplement ces étapes :
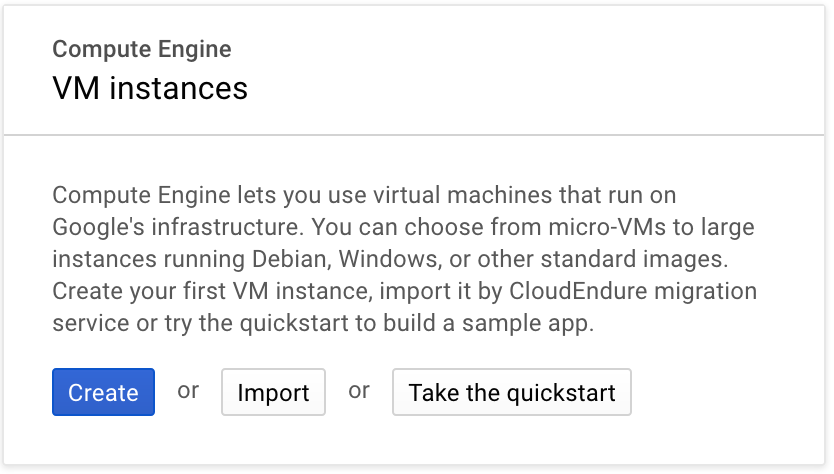
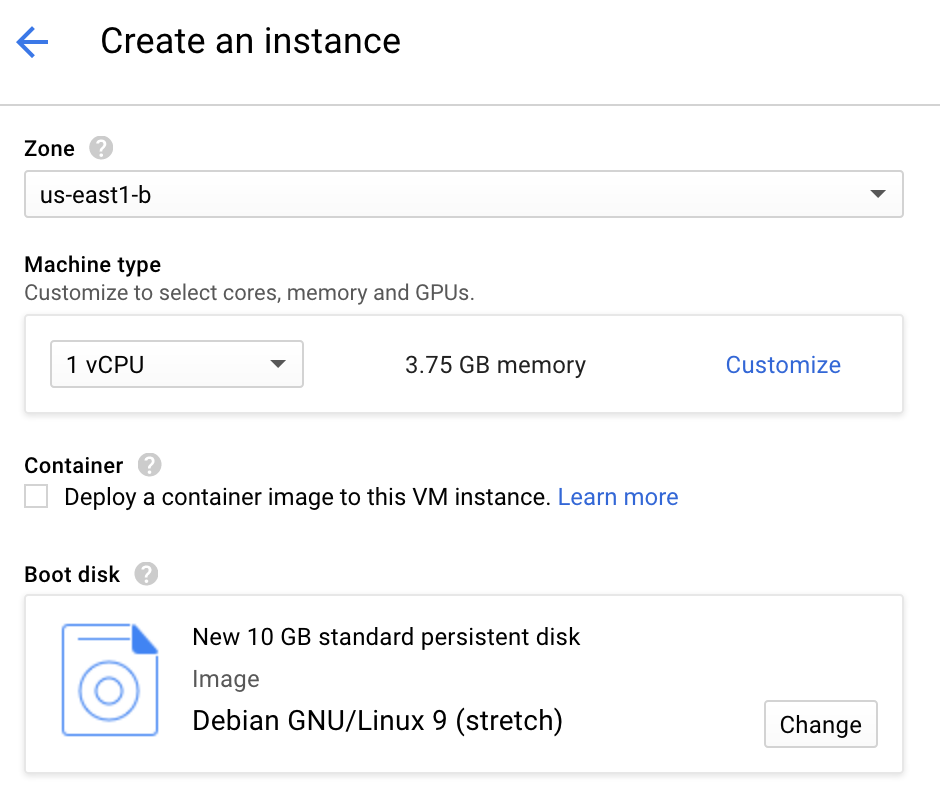
Vous êtes maintenant sur la page « Create an Instance ».
Nommez l’instance : choisissez le nom de votre choix. Je nomme mon instance starling.
Sélectionnez la région : la règle générale est de choisir la région la moins chère et la plus proche de vous pour minimiser la latence. Je choisis east-d. Notez que les prix varient sensiblement selon la région.
Sélectionnez la mémoire, le stockage et le CPU nécessaires. Vous pouvez utiliser des préréglages ou personnaliser votre instance. Ici, je choisis la configuration par défaut n1-standard-1 avec 3,75 Go de RAM et 1 vCPU pour un prix estimé à 24,67 $ par mois.
Sélectionnez le disque de démarrage et conservez l’OS par défaut Debian GNU/Linux 9 (stretch) avec 10 Go. Si vous préférez Ubuntu ou une autre distribution Linux, cliquez sur « Change » et faites votre choix. Ubuntu étant très proche de Debian, l’une ou l’autre conviendra pour ce tutoriel.
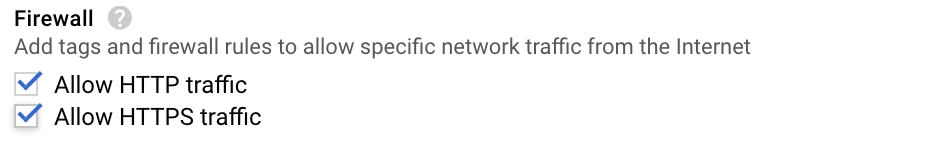
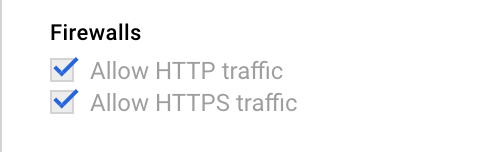
5.Assurez-vous de pouvoir accéder à la VM depuis Internet en autorisant le trafic http et https.
6.(Facultatif) Activez un disque persistant à des fins de sauvegarde : cliquez sur le lien « Management, Disks, networking, SSH keys ». Un ensemble d’onglets s’affiche, sélectionnez l’onglet « Disks » et décochez « Deletion Rule ». Ainsi, lorsque vous supprimerez votre instance, le disque ne sera pas supprimé et pourra être réutilisé pour démarrer une nouvelle instance.
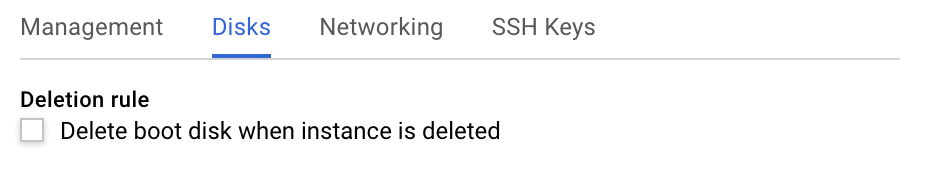
7.Enfin, cliquez sur « Create ». Votre instance sera prête en quelques minutes.
Remarquez le lien « Equivalent command line » sous le bouton Create. Ce lien affiche la ligne de commande équivalente pour créer la même instance from scratch. C’est une fonctionnalité très maligne qui facilite l’apprentissage de la syntaxe du gcloud SDK.
À ce stade, votre instance tourne mais elle est quasiment vide. Vous pouvez y accéder de deux façons : soit en installant le gcloud SDK sur votre machine locale, soit en utilisant le Cloud Shell de Google.
Le Cloud Shell de Google est un terminal autonome dans votre navigateur, depuis lequel vous pouvez accéder à vos ressources et les gérer. Activez-le en cliquant sur l’icône >\_ en haut à droite de la page console. La partie inférieure de votre navigateur devient un terminal shell.
Ce terminal tourne sur une machine virtuelle Google Compute Engine f1-micro avec un système Debian et 5 Go de stockage. Elle est créée par utilisateur et par session. Elle persiste tant que votre session Cloud Shell est active et est supprimée après 20 minutes d’inactivité. Comme le disque associé est persistant entre les sessions, votre contenu (fichiers, configurations, ...) restera disponible. L’instance Cloud Shell est préinstallée avec le gcloud SDK et vim.
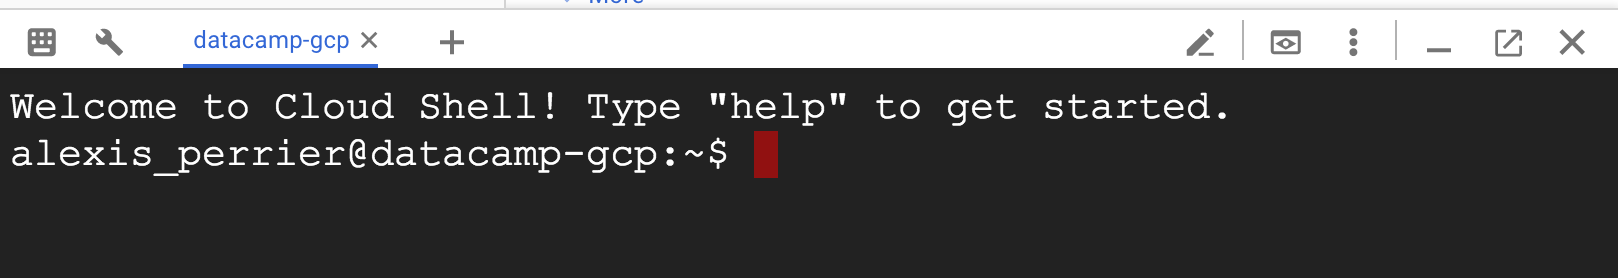
Il est important de distinguer l’instance Cloud Shell, qui est liée à l’utilisateur, de l’instance que vous venez de créer. L’instance sous-jacente au Cloud Shell est un moyen pratique de disposer d’un environnement de gestion des ressources et de stocker vos configurations sur une instance éphémère. La VM que vous venez de créer, nommée starling dans l’exemple ci-dessus, est celle sur laquelle vous allez installer votre environnement de data science.
Au lieu d’utiliser le Cloud Shell, vous pouvez aussi installer le gcloud SDK sur votre machine locale et tout gérer depuis votre environnement habituel.
Voici quelques commandes utiles pour gérer vos instances.
Lister vos instances
gcloud compute instances list
Arrêter l’instance (quelques secondes)
gcloud compute instances stop <instance name>
Démarrer l’instance (quelques secondes aussi)
gcloud compute instances start <instance name>
et se connecter en SSH à l’instance starling
gcloud compute ssh <instance name>
Exécutez cette dernière commande dans votre fenêtre Google Shell pour vous connecter à l’instance. Les prochaines étapes consistent à :
apt-get install.Commençons par installer les paquets Debian :
Exécutez les commandes suivantes, valables pour Ubuntu et Debian, dans le terminal :
$ sudo apt-get update
$ sudo apt-get install bzip2 git libxml2-dev
Une fois ces paquets installés, passez à l’installation de la distribution Anaconda pour Python 3. Vous pouvez installer la version complète d’Anaconda, qui inclut de nombreuses bibliothèques scientifiques Python (dont certaines inutiles selon vos besoins), ou la version plus légère Miniconda, qui vous demandera d’installer manuellement les bibliothèques Jupyter. Le processus est très similaire dans les deux cas.
Pour installer la distribution Miniconda plus légère, exécutez
$ wget https://repo.continuum.io/miniconda/Miniconda3-latest-Linux-x86_64.sh
$ bash Miniconda3-latest-Linux-x86_64.sh
$ rm Miniconda3-latest-Linux-x86_64.sh
$ source .bashrc
$ conda install scikit-learn pandas jupyter ipython
Le script d’installation est téléchargé puis exécuté par les deux premières lignes. Acceptez la licence et l’emplacement par défaut. À la ligne 3, le fichier d’installation devenu inutile est supprimé. En rechargeant .bashrc à la ligne 4, vous ajoutez la commande conda à votre $PATH sans ouvrir un nouveau terminal. Enfin, la dernière ligne installe les bibliothèques Python requises : scikit-learn pandas jupyter ipython.
Les commandes pour installer la distribution Anaconda complète sont très proches. Veillez à vérifier la page de téléchargement pour obtenir la dernière version du script :
$ wget https://repo.continuum.io/archive/Anaconda3-5.0.1-Linux-x86_64.sh
$ bash Anaconda3-5.0.1-Linux-x86_64.sh
$ rm Anaconda3-5.0.1-Linux-x86_64.sh
$ source .bahsrc
Pour vérifier que tout est correctement installé, contrôlez votre version de Python avec python --version et vérifiez que le bon Python est appelé par défaut avec which python. Vous devriez obtenir quelque chose comme :
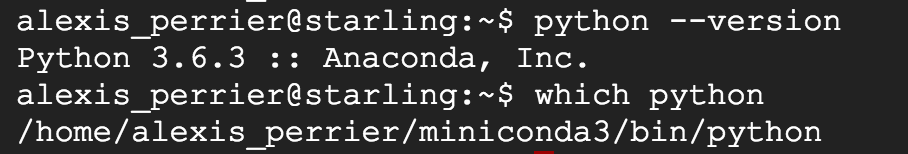
Vous disposez maintenant d’un environnement Python opérationnel avec les bibliothèques standard de data science installées (sklearn, pandas).
La troisième et dernière étape consiste à configurer votre VM pour autoriser l’accès web à vos notebooks Jupyter.
Vous devez d’abord rendre la VM accessible depuis le web. Pour cela, créez une règle de pare-feu via la console Google Cloud. Revenez à votre tableau de bord Instances et, dans le menu en haut à gauche, sélectionnez « VPC Network > Firewall rules ». Cliquez sur « CREATE FIREWAL RULE » et renseignez les valeurs suivantes :
Le formulaire devrait ressembler à ceci :
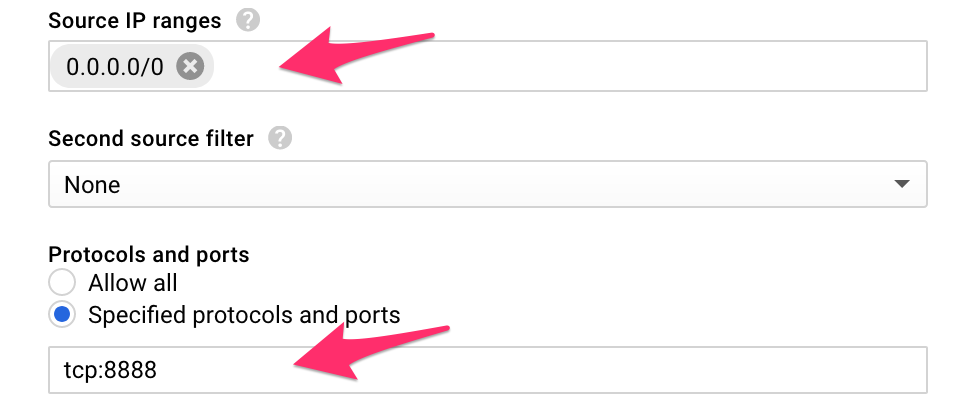
Cette règle de pare-feu autorise tout le trafic entrant (depuis toutes les IP) vers le port 8888.
À l’aide du lien « Equivalent command line », vous pouvez constater que la règle de pare-feu peut aussi être créée depuis le terminal avec la commande suivante :
$ gcloud compute --project=datacamp-gcp firewall-rules create jupyter-rule --direction=INGRESS --priority=1000 --network=default --action=ALLOW --rules=tcp:8888 --source-ranges=0.0.0.0/0
Revenez maintenant à la page de la VM (menu en haut à gauche > Compute Engine > VM instances), cliquez sur le nom de votre VM.
Notez l’adresse IP de votre VM. C’est l’adresse que vous utiliserez dans votre navigateur pour accéder à votre environnement Jupyter. Dans mon exemple, l’adresse IP est : 35.196.81.49, la vôtre sera différente.
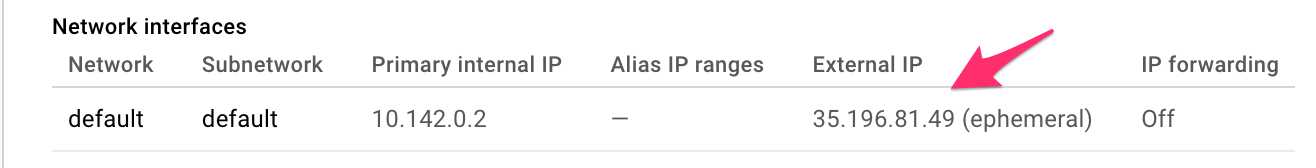
et vérifiez que les règles de pare-feu sont cochées :
Les notebooks Jupyter disposent d’un fichier de configuration qu’il faut générer et modifier pour définir l’accès en ligne à vos notebooks. Dans le terminal, exécutez jupyter notebook --generate-config pour générer le fichier de configuration. Puis jupyter notebook password pour définir un mot de passe.
Astuce : choisissez un mot de passe robuste !
Modifiez maintenant le fichier de configuration que vous venez de créer avec vim .jupyter/jupyter_notebook_config.py et ajoutez la ligne suivante en haut du fichier
c.NotebookApp.ip = '*'
(pour passer en mode édition dans vim, tapez simplement la touche i). Quittez et enregistrez avec la séquence ESC:wq.
Cela permettra au notebook d’être disponible pour toutes les adresses IP de votre VM et pas seulement via l’URL http://localhost:8888 que vous connaissez peut-être en local.
Vous êtes prêt à lancer votre notebook Jupyter avec la commande :
$ jupyter-notebook --no-browser --port=8888
Vous devriez voir apparaître quelque chose comme ceci dans le terminal :

Dans votre navigateur, allez à l’URL : http://<your_VM_IP>:8888/ pour accéder à votre notebook Jupyter opérationnel.
Pour vérifier que tout fonctionne, créez un nouveau notebook Python 3 et import pandas
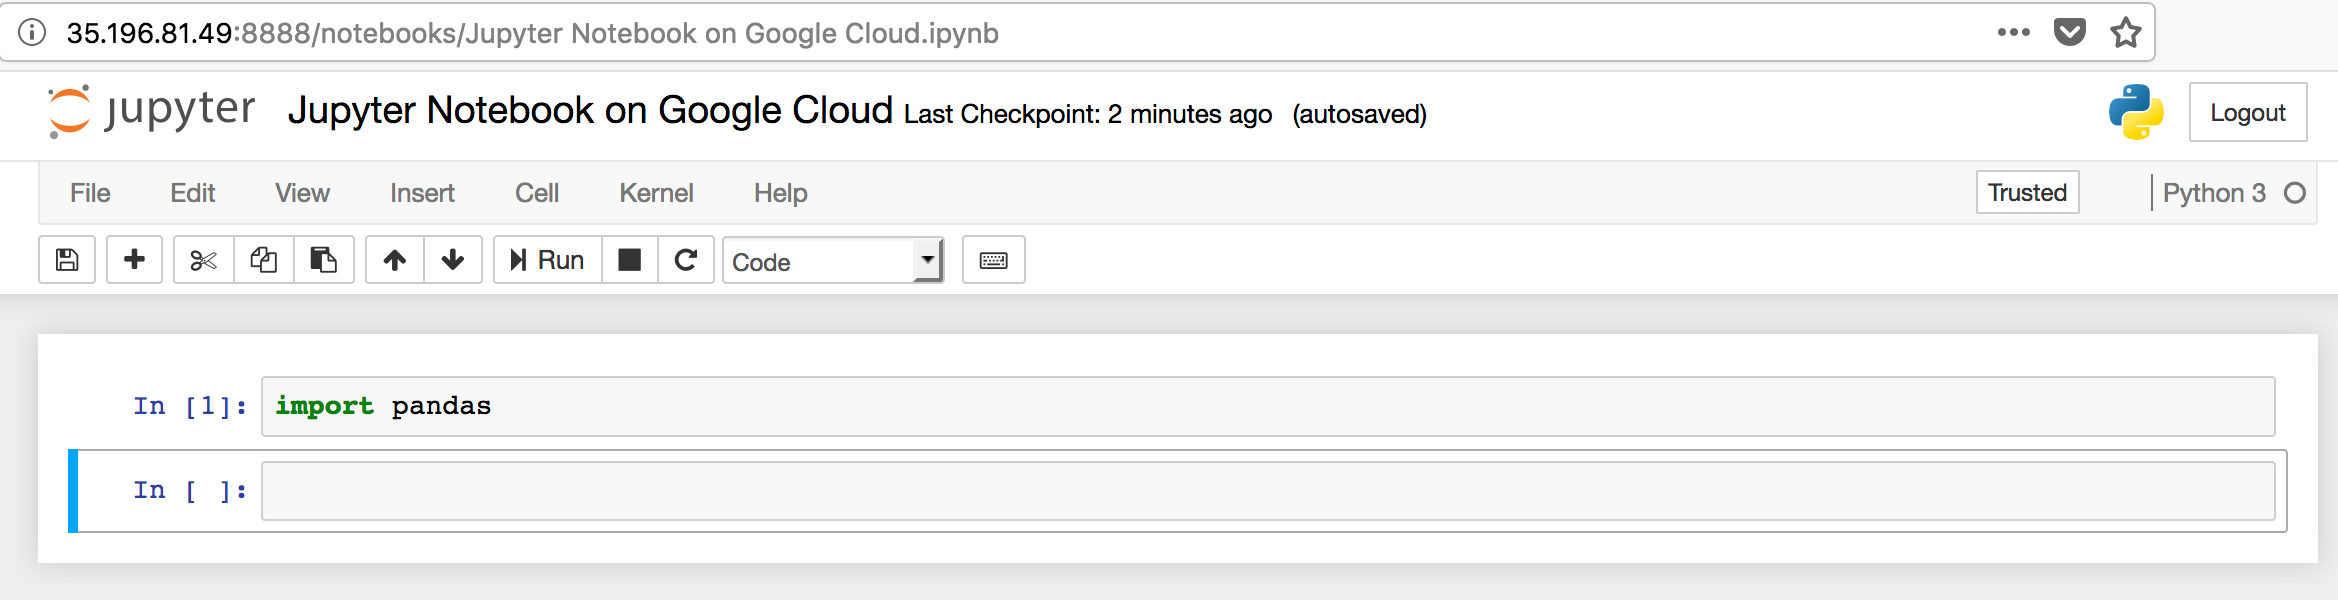
Quelques notes sur votre configuration actuelle :
L’adresse IP utilisée dans votre navigateur est éphémère. Cela signifie qu’à chaque redémarrage de la VM, l’URL de vos notebooks changera. Vous pouvez rendre cette IP statique en allant sur : Menu en haut à gauche > VPC Network > External IP addresses et en sélectionnant « static » dans le menu déroulant 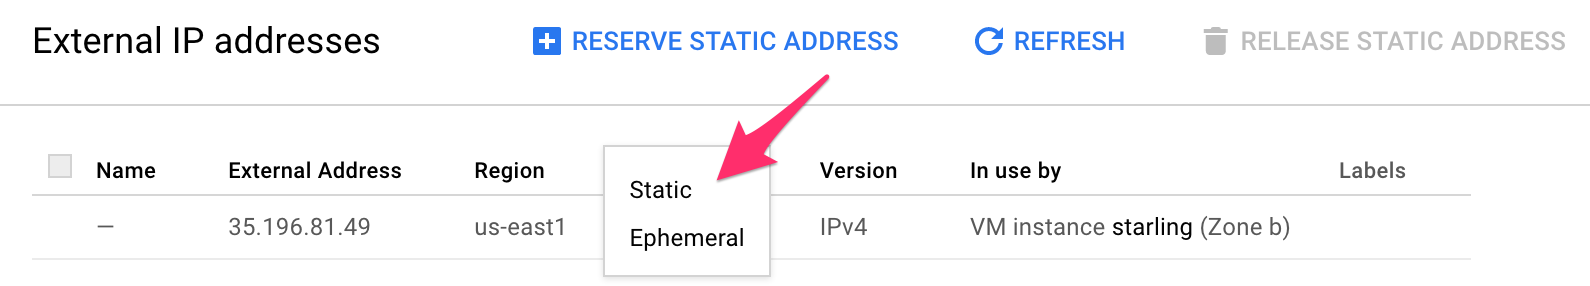
La sécurité de votre configuration actuelle repose sur la robustesse du mot de passe Jupyter défini précédemment. N’importe qui sur Internet peut tenter d’accéder à votre environnement Jupyter via la même URL que vous (et des bots essaieront, assurément). Une fonctionnalité puissante mais peu sûre des notebooks Jupyter est la possibilité d’ouvrir un terminal avec des droits sudo directement depuis le notebook. Cela signifie que toute personne accédant à votre notebook pourrait prendre le contrôle de votre VM après avoir cassé votre mot de passe et potentiellement exécuter des actions qui feraient exploser votre facture. Les premières mesures à mettre en place incluent :
Vous assurer que votre mot de passe Jupyter est solide
Vous exécutez également le serveur en http et non en https, ce qui n’est pas suffisamment sécurisé. Let’s Encrypt fournit des certificats SSL/TLS gratuits et c’est la solution de chiffrement recommandée dans la documentation Jupyter. Pour en savoir plus sur la sécurité des notebooks Jupyter publics, lisez cet article.
Les notebooks Jupyter sont très pratiques pour le travail collaboratif en ligne. Mais vous pouvez aussi lancer une session IPython depuis votre terminal simplement avec la commande ipython. Cela ouvre une session IPython qui offre tout le confort d’un notebook Jupyter (commandes magiques : %paste, %run, ...) sans l’interface web.
Il est facile de configurer votre VM pour activer les notebooks R dans votre console Jupyter. Les instructions pour activer R Markdown sont disponibles dans ce très bon tutoriel DataCamp : Jupyter And R Markdown: Notebooks With R par Karlijn Willems.
Google Cloud offre de nombreux services intéressants pour la data science, des VM puissantes et faciles à configurer, ainsi qu’une offre d’essai gratuite très attractive. La console web est simple à naviguer et affiche souvent l’équivalent en ligne de commande des pages de configuration, ce qui abaisse la barrière à l’utilisation du gcloud SDK.
Dans cet article, vous avez appris à sélectionner et lancer une instance VM, installer les paquets Debian nécessaires, la distribution Anaconda et la stack data science, puis à définir les règles d’accès pour lancer un notebook Jupyter accessible depuis votre navigateur.
Même si l’ensemble du processus peut sembler un peu complexe la première fois, il deviendra vite familier à mesure que vous créerez et lancerez davantage de VM. Et si les choses se compliquent, vous pouvez toujours supprimer la VM sur laquelle vous travaillez et repartir de zéro. C’est l’un des avantages du cloud. Après quelques essais, vous serez en mesure de déployer des environnements complets de data science sur Google Cloud en quelques minutes. N’hésitez pas à me contacter et à partager vos commentaires et questions sur Twitter : @alexip.
En savoir plus sur la data science
Cours
Cours
Cours