Curso
Comprender la ciencia de datos
2 h
872K
Aunque AWS EC2 lidera la computación en la nube, Google Cloud ha desarrollado una plataforma de computación en la nube muy atractiva y competitiva.
En este tutorial aprenderás a:
Trabajar en la nube en lugar de en tu propia máquina tiene dos grandes ventajas para los proyectos de ciencia de datos:
Aunque se basan en los mismos conceptos y elementos (instancias, imágenes y snapshots), EC2 y GCE difieren en el acceso y en cómo organizan los recursos.
Un aspecto clave de Google Cloud Platform (GCP) es su organización centrada en proyectos. Toda la facturación, permisos, recursos y ajustes se agrupan dentro de un proyecto definido por el usuario que actúa como un espacio de nombres global. Esto no solo simplifica el mapeo interconectado de los recursos que utilizas (almacenamiento, bases de datos, instancias, ...) sino también la gestión de accesos, desde permisos basados en roles hasta claves SSH y seguridad. En cuanto a facilidad de uso y gestión de accesos y roles, trabajar en GCP me resulta más sencillo que en AWS, especialmente cuando usas varios servicios.
GCP también ofrece ciertos servicios especialmente relevantes para ciencia de datos, entre ellos:
Una curva de aprendizaje suave y servicios orientados a datos hacen de GCP un imprescindible en tu caja de herramientas de data scientist.
Antes de lanzar instancias e instalar paquetes de Python, dediquemos unos minutos a repasar parte del vocabulario habitual en computación en la nube.
Una máquina virtual (VM), también llamada "instancia", es un servidor bajo demanda que activas cuando lo necesitas. El hardware subyacente se comparte con otros usuarios de forma transparente y, por tanto, se vuelve completamente virtual para ti. Solo eliges una ubicación geográfica global de la instancia alojada en uno de los centros de datos de Google.
Una VM se define por el tipo de disco persistente y el sistema operativo (OS), como Windows o Linux, sobre el que se construye. El disco persistente es tu porción virtual de hardware.
Una imagen es la combinación física de un disco persistente y el sistema operativo. Las imágenes de VM se usan a menudo para compartir e implementar una configuración concreta en varias VMs. Las imágenes públicas son las que proporciona Google con una selección de sistemas operativos específicos, mientras que las privadas están personalizadas por los usuarios.
Un snapshot es una instantánea del contenido de una VM (disco, software, librerías, archivos) en un momento dado y se utiliza principalmente para copias de seguridad instantáneas. La principal diferencia entre snapshots e imágenes es que los snapshots se almacenan como diferencias relativas a snapshots anteriores, mientras que las imágenes no.
Tanto una imagen como un snapshot pueden utilizarse para definir y activar una nueva VM.
En resumen, cuando lanzas una nueva instancia, GCE empieza adjuntando un disco persistente a tu VM. Esto proporciona el espacio en disco y da a la instancia el sistema de archivos raíz que necesita para arrancar. El disco instala el sistema operativo asociado a la imagen que has elegido. Al tomar snapshots de una imagen, creas copias de seguridad instantáneas y puedes copiar datos de VMs existentes para lanzar nuevas VMs.
¡Pongamos todo esto en práctica y arranquemos tu primera VM!
Para abrir una cuenta en GCP, necesitas una cuenta estándar de Google (Gmail). En el momento de escribir esto, Google ofrece una prueba gratuita de 12 meses / 300 $ de la plataforma. Aunque esta oferta incluye ciertas restricciones (por ejemplo, no minar bitcoin), debería ser suficiente para empezar a trabajar en este entorno.
Para crear tu cuenta de GCP con la prueba gratuita, ve a cloud.google.com y haz clic en el botón try it free. Se te pedirá iniciar sesión con tu cuenta de Google y añadir tu información de facturación. Una vez creada tu cuenta, puedes acceder a la consola web en http://console.cloud.google.com/.
Primero usarás la consola web para definir y lanzar una instancia basada en Debian y luego cambiarás al terminal web (Cloud Shell) para instalar todos los paquetes necesarios para tu stack de ciencia de datos.
Pero antes necesitas crear un proyecto nuevo:
El ID del proyecto debe ser único en todo el espacio de nombres de GCP, mientras que el título del proyecto puede ser el que quieras. Yo llamo a mi proyecto datacamp-gcp como se muestra a continuación:
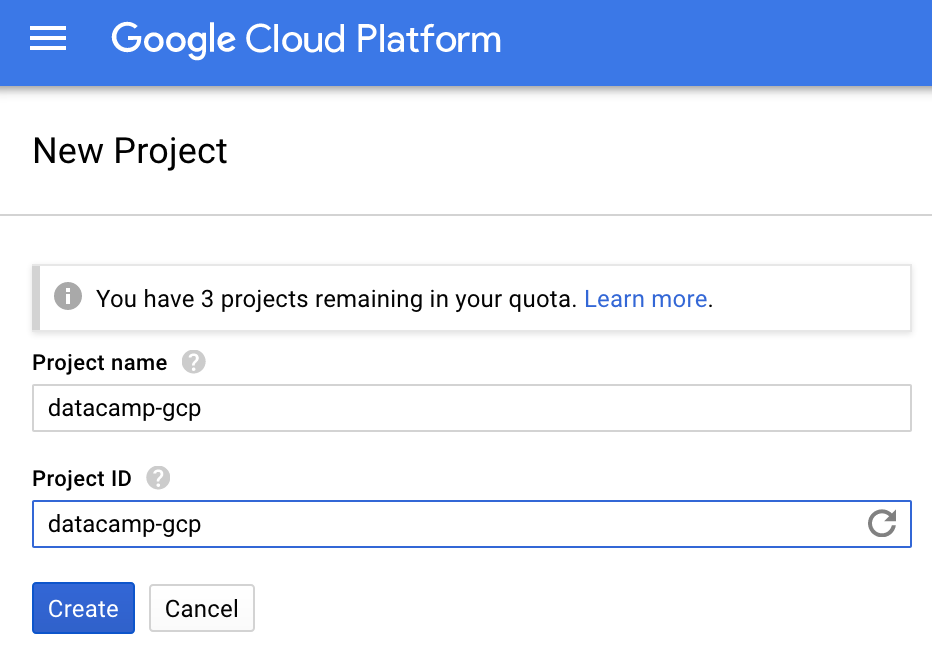
Por defecto, cuando creas un proyecto nuevo, tu cuenta de Google se establece como propietaria del proyecto con permisos completos y acceso a todos los recursos y la facturación del proyecto.
En la sección de roles de la página de IAM, puedes añadir personas con roles específicos a tu proyecto. Para este tutorial, nos saltaremos esa parte y te mantendrás como único usuario y administrador del proyecto.
Para crear tu primera VM, sigue estos pasos:
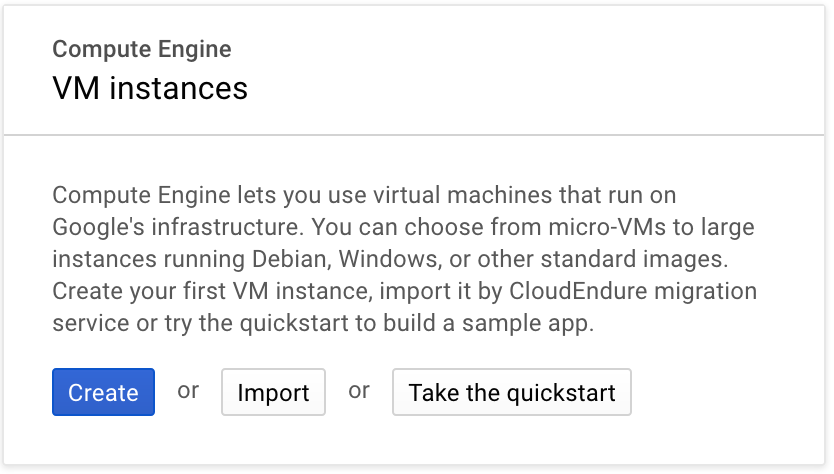
Ahora estás en la página "Create an Instance".
Asigna un nombre a la instancia: puedes elegir el que quieras. Yo llamo a mi instancia starling.
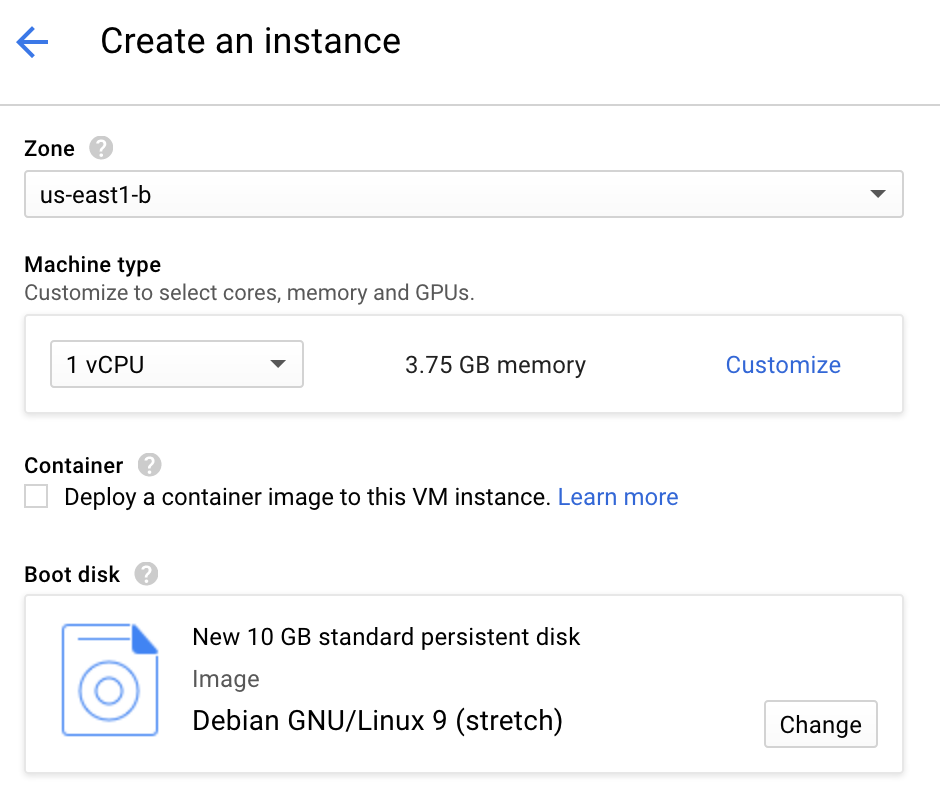
Selecciona la región: la regla general es elegir la región más barata y cercana para minimizar la latencia. Yo elijo east-d. Ten en cuenta que los precios varían bastante según la región.
Selecciona la memoria, el almacenamiento y la CPU que necesitas. Puedes usar alguno de los preajustes o personalizar tu instancia. Aquí elijo la configuración por defecto n1-standard-1 con 3,75 GB de RAM y 1 vCPU por un precio estimado de 24,67 $ al mes.
Selecciona el boot disk y mantén el OS por defecto Debian GNU/Linux 9 (stretch) con 10 GB. Si prefieres Ubuntu u otra distribución Linux, haz clic en el botón "Change" y selecciona la opción adecuada. Como Ubuntu es una derivación cercana de Debian, cualquiera de las dos distribuciones sirve para este tutorial.
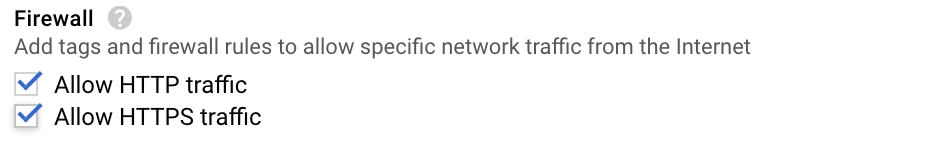
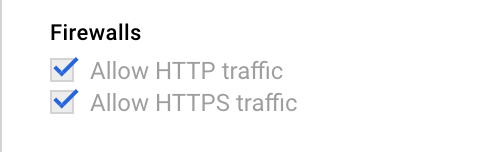
5. Asegúrate de poder acceder a la VM desde internet permitiendo tráfico http y https.
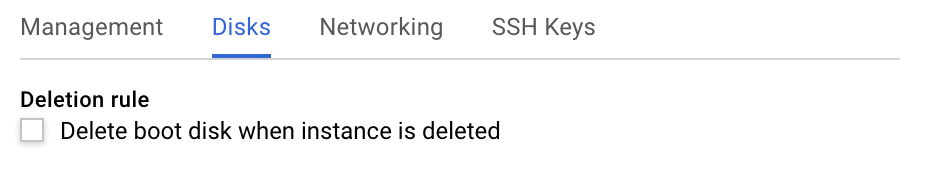
6. (Opcional) Habilita un disco persistente para copias de seguridad: haz clic en el enlace "Management, Disks, networking, SSH keys". Esto muestra un conjunto de pestañas; selecciona la pestaña "Disks" y desmarca "Deletion Rule". Así, cuando elimines tu instancia, el disco no se borrará y podrás usarlo después para arrancar una nueva instancia.
7. Por último, haz clic en "Create". Tu instancia estará lista en unos minutos.
Fíjate en el enlace "Equivalent command line" debajo del botón Create. Este enlace muestra la línea de comandos equivalente para crear esa misma instancia desde cero. Es una función muy útil que facilita aprender la sintaxis del gcloud SDK.
En este punto ya tienes una instancia en ejecución prácticamente vacía. Hay dos formas de acceder a ella: instalando el gcloud SDK en tu máquina local o usando Cloud Shell de Google.
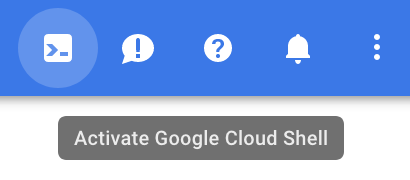
Cloud Shell es un terminal autónomo en tu navegador desde el que puedes acceder y gestionar tus recursos. Actívalo haciendo clic en el icono >\_ en la parte superior derecha de la consola. La parte inferior del navegador se convierte en un terminal.
Este terminal se ejecuta en una máquina virtual f1-micro de Google Compute Engine con sistema operativo Debian y 5 GB de almacenamiento. Se crea por usuario y por sesión. Se mantiene mientras tu sesión de Cloud Shell está activa y se elimina tras 20 minutos de inactividad. Como el disco asociado es persistente entre sesiones, tu contenido (archivos, configuraciones, ...) estará disponible de una sesión a otra. La instancia de Cloud Shell viene con gcloud SDK y vim preinstalados.
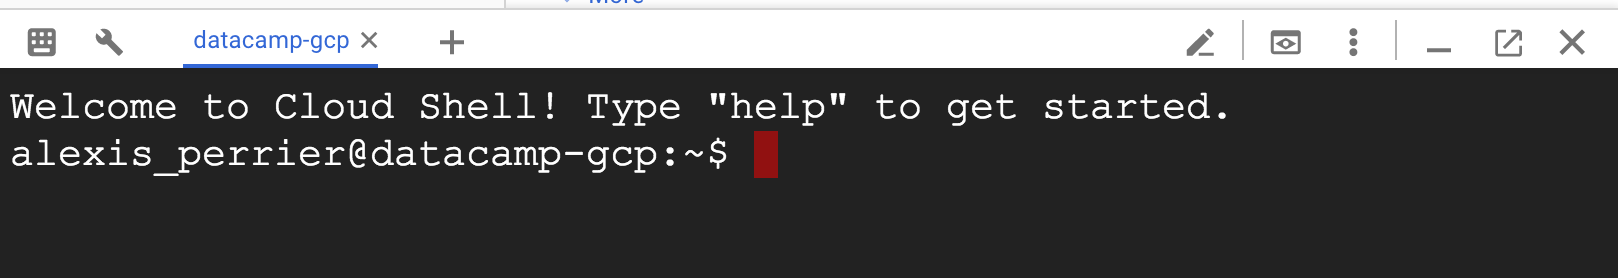
Es importante distinguir entre la instancia de Cloud Shell, que es por usuario, y la instancia que acabas de crear. La instancia subyacente de Cloud Shell es solo una forma cómoda de tener un entorno de gestión de recursos y almacenar tus configuraciones en una instancia efímera. La VM que acabas de crear, llamada starling en el ejemplo, es donde quieres instalar tu entorno de ciencia de datos.
En lugar de usar Cloud Shell, también puedes instalar gcloud SDK en tu máquina local y gestionarlo todo desde tu entorno local.
Aquí tienes algunos comandos útiles para gestionar tus instancias.
Listar tus instancias
gcloud compute instances list
Detener la instancia (tarda unos segundos)
gcloud compute instances stop <instance name>
Arrancar la instancia (también tarda unos segundos)
gcloud compute instances start <instance name>
y conectarte por ssh a la instancia starling
gcloud compute ssh <instance name>
Ejecuta el último comando en tu ventana de Cloud Shell para iniciar sesión en tu instancia. Los siguientes pasos serán:
apt-get install.Empecemos instalando los paquetes de Debian:
Ejecuta los siguientes comandos, que funcionan tanto en Ubuntu como en Debian, en el terminal:
$ sudo apt-get update
$ sudo apt-get install bzip2 git libxml2-dev
Una vez instalados los paquetes anteriores, vamos a instalar la distribución Anaconda para Python 3. Puedes elegir entre instalar la versión completa de Anaconda, que incluye muchas librerías científicas de Python (algunas quizá no las necesites), o instalar la versión ligera Miniconda, que requiere instalar manualmente las librerías de Jupyter. El proceso es muy similar en ambos casos.
Para instalar la distribución ligera Miniconda, ejecuta
$ wget https://repo.continuum.io/miniconda/Miniconda3-latest-Linux-x86_64.sh
$ bash Miniconda3-latest-Linux-x86_64.sh
$ rm Miniconda3-latest-Linux-x86_64.sh
$ source .bashrc
$ conda install scikit-learn pandas jupyter ipython
El script de instalación se descarga y ejecuta con las dos primeras líneas. Acepta la licencia y la ubicación por defecto. En la línea 3 se elimina el script ya innecesario. Al ejecutar .bashrc en la línea 4, se añade el comando conda a tu $PATH sin tener que abrir un terminal nuevo. Por último, la última línea instala las librerías de Python necesarias: scikit-learn pandas jupyter ipython.
Los comandos para instalar la distribución completa de Anaconda son muy similares. Asegúrate de comprobar la página de descargas para obtener la versión más reciente del script:
$ wget https://repo.continuum.io/archive/Anaconda3-5.0.1-Linux-x86_64.sh
$ bash Anaconda3-5.0.1-Linux-x86_64.sh
$ rm Anaconda3-5.0.1-Linux-x86_64.sh
$ source .bahsrc
Para verificar que todo se ha instalado correctamente, comprueba tu versión de Python con python --version y verifica que se llama al Python correcto por defecto con el comando which python. Deberías obtener algo similar a esto:
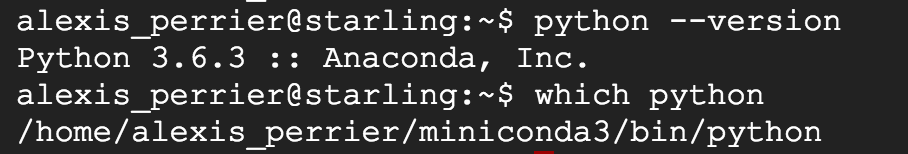
Ya tienes un entorno de Python funcional con las librerías estándar de ciencia de datos instaladas (sklearn, pandas).
El tercer y último paso es configurar tu VM para permitir el acceso web a tus Jupyter notebooks.
Primero necesitas hacer que la VM sea accesible desde la web. Para ello, crearás una regla de firewall desde la consola de Google Cloud. Vuelve a tu panel de instancias y, en el menú superior izquierdo, selecciona "VPC Network > Firewall rules". Haz clic en el enlace "CREATE FIREWAL RULE" y rellena los siguientes valores:
El formulario debería verse así:
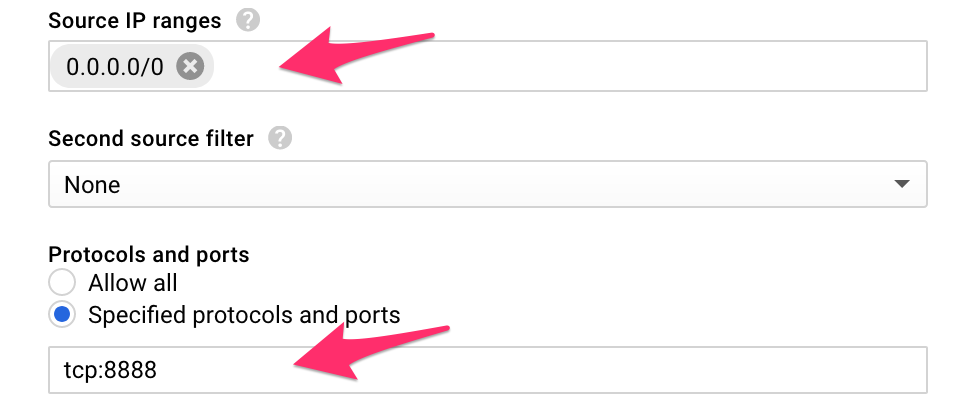
Esta regla de firewall permite que todo el tráfico entrante (desde cualquier IP) llegue al puerto 8888.
Usando el enlace "Equivalent command line", puedes ver que la regla de firewall también se puede crear desde el terminal con la siguiente línea:
$ gcloud compute --project=datacamp-gcp firewall-rules create jupyter-rule --direction=INGRESS --priority=1000 --network=default --action=ALLOW --rules=tcp:8888 --source-ranges=0.0.0.0/0
Ahora vuelve a la página de la VM (menú superior izquierdo > Compute Engine > VM instances) y haz clic en el nombre de tu VM.
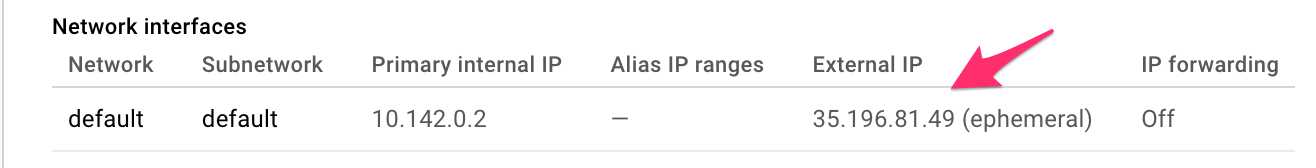
Anota la dirección IP de tu VM. Es la IP que usarás en el navegador para acceder a tu entorno de Jupyter. En mi ejemplo la IP es: 35.196.81.49, la tuya será distinta.
y asegúrate de que las reglas de firewall están marcadas:
Jupyter notebooks incluyen un archivo de configuración que hay que generar y editar para habilitar el acceso online a tus notebooks. En el terminal, ejecuta jupyter notebook --generate-config para generar el archivo de configuración. Y jupyter notebook password para crear una contraseña.
Consejo: ¡asegúrate de que sea una contraseña fuerte!
Ahora edita el archivo de configuración que acabas de crear con vim .jupyter/jupyter_notebook_config.py y añade la siguiente línea al principio del archivo
c.NotebookApp.ip = '*'
(para pasar a modo edición en vim, escribe la tecla i). Sal y guarda con la secuencia ESC:wq.
Esto permitirá que el notebook esté disponible para todas las direcciones IP de tu VM y no solo en la URL http://localhost:8888 que quizá te suene al trabajar en tu máquina local.
Ya puedes lanzar tu Jupyter notebook con el comando:
$ jupyter-notebook --no-browser --port=8888
Y en el terminal deberías ver algo como esto:

En tu navegador ve a la URL: http://<your_VM_IP>:8888/ para acceder a tu Jupyter notebook recién operativo.
Para comprobar que todo funciona como esperas, crea un notebook de Python 3 nuevo y ejecuta import pandas
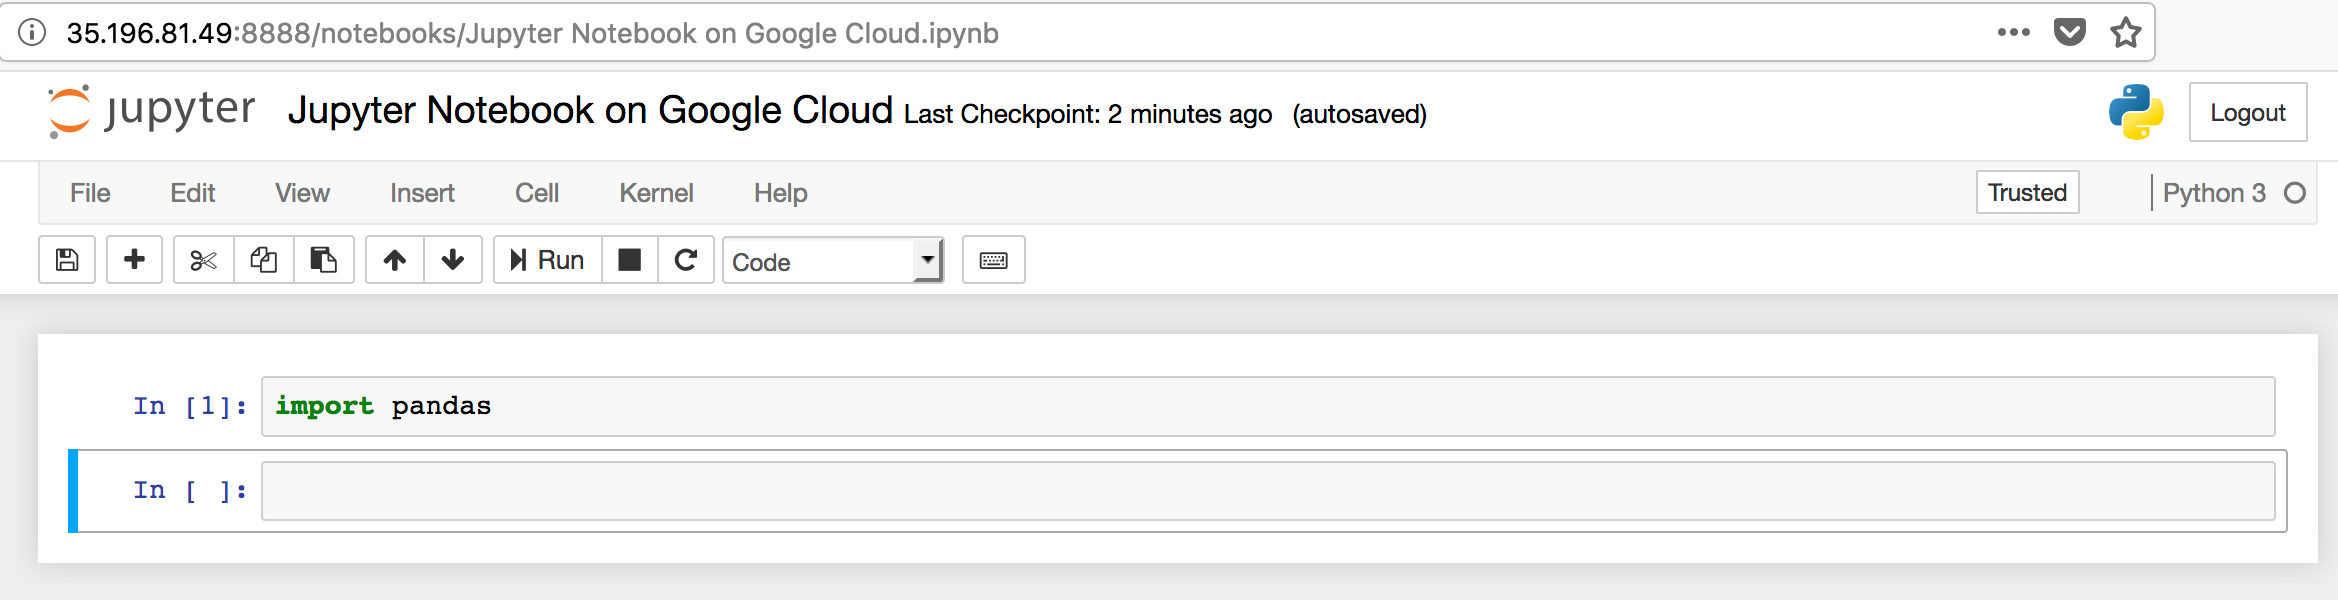
Algunas notas sobre tu configuración actual:
La dirección IP que has usado en el navegador es efímera. Es decir, cada vez que reinicies tu VM, tus notebooks tendrán una URL diferente. Puedes hacer que esa IP sea estática yendo a: Menú superior izquierdo > VPC Network > External IP addresses y seleccionando "static" en el menú desplegable 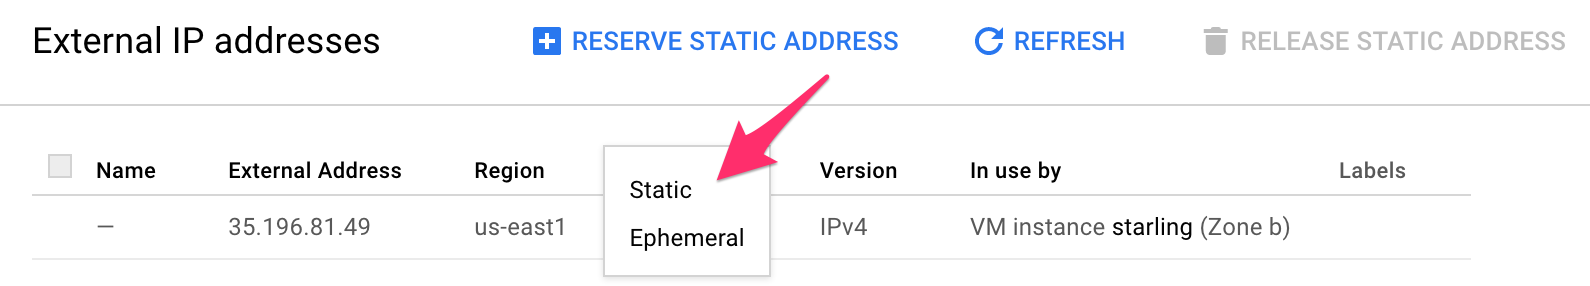
La seguridad de tu configuración actual depende de la fortaleza de la contraseña del Jupyter notebook que definiste antes. Cualquiera en internet puede intentar acceder a tu entorno de Jupyter en la misma URL que tú usas (y los bots lo intentarán). Una característica potente pero poco segura de Jupyter es que puedes abrir un terminal con acceso sudo directamente desde el notebook. Esto significa que cualquiera que acceda a tu notebook podría tomar el control de tu VM tras descifrar tu contraseña e incluso ejecutar acciones que disparen tu factura. Las primeras medidas para evitarlo incluyen:
Asegurarte de que tu contraseña de Jupyter sea robusta
Además, ahora mismo estás ejecutando el servidor sobre http y no https, lo cual no es suficientemente seguro. Let’s Encrypt proporciona certificados SSL/TLS gratuitos y es la solución de cifrado recomendada en la documentación de Jupyter. Para más información sobre seguridad al ejecutar un Jupyter notebook público, lee esto.
Los Jupyter notebooks son muy prácticos para el trabajo colaborativo online. Pero también puedes ejecutar una sesión de IPython desde tu terminal simplemente con el comando ipython. Abrirá una sesión de IPython con todas las ventajas de un Jupyter notebook (comandos mágicos como %paste, %run, ...) pero sin la interfaz web.
Es fácil preparar tu VM para habilitar notebooks de R en tu consola de Jupyter. Las instrucciones para habilitar R Markdown están disponibles en este estupendo tutorial de DataCamp: Jupyter And R Markdown: Notebooks With R, de Karlijn Willems.
Google Cloud ofrece muchos servicios interesantes para ciencia de datos y VMs potentes pero fáciles de configurar, junto con una oferta de prueba gratuita muy atractiva. La consola web es fácil de navegar y a menudo muestra la línea de comandos equivalente a las páginas de configuración, reduciendo la barrera para usar el gcloud SDK.
En este artículo has aprendido a seleccionar y lanzar una instancia de VM, a instalar los paquetes necesarios de Debian, la distribución Anaconda y el stack de ciencia de datos, y por último a configurar las reglas de acceso para lanzar un Jupyter notebook accesible desde tu navegador.
Aunque todo el proceso puede parecer algo complejo la primera vez, pronto te resultará familiar a medida que crees y lances más VMs. Y si algo se lía, siempre puedes borrar la VM en la que trabajas y empezar de cero. Es una de las ventajas de trabajar en la nube. Tras unas cuantas veces, podrás poner en marcha entornos completos de ciencia de datos en Google Cloud en pocos minutos. No dudes en contactarme y compartir tus comentarios y preguntas en Twitter: @alexip.
Amplía tus conocimientos sobre ciencia de datos
Curso
Curso
Curso
Tutorial
Duong Vu
11 min
Tutorial
Javier Canales Luna
7 min
Tutorial
Moez Ali
13 min
Tutorial
DataCamp Team
5 min
Tutorial
Natassha Selvaraj
10 min
Tutorial
Vidhi Chugh
15 min