Kurs
Datenwissenschaft verstehen
2 Std.
872K
Auch wenn AWS EC2 im Cloud-Computing vorne liegt, hat Google Cloud eine ausgesprochen überzeugende und konkurrenzfähige Cloud-Plattform aufgebaut.
In diesem Tutorial lernst du, wie du:
Arbeiten in der Cloud statt auf deinem eigenen Rechner hat für Data-Science-Projekte zwei entscheidende Vorteile:
Obwohl EC2 und GCE auf denselben Konzepten (Instanzen, Images und Snapshots) beruhen, unterscheiden sie sich bei Zugriff und Ressourcenorganisation.
Ein zentrales Merkmal der Google Cloud Platform (GCP) ist die projektzentrierte Struktur. Abrechnung, Berechtigungen, Ressourcen und Einstellungen sind in einem benutzerdefinierten Projekt gebündelt, das praktisch als globaler Namensraum fungiert. Das vereinfacht nicht nur das Zusammenspiel der genutzten Ressourcen (Storage, Datenbanken, Instanzen, …), sondern auch das Zugriffsmanagement – von rollenbasierten Rechten bis zu SSH-Schlüsseln und Sicherheit. In puncto Benutzerfreundlichkeit und Rollen-/Zugriffsverwaltung ist die Arbeit auf der GCP aus meiner Sicht oft einfacher als auf AWS, vor allem, wenn mehrere Services im Spiel sind.
Die GCP bietet außerdem Dienste, die für Data Science besonders interessant sind, unter anderem:
Eine geringe Einstiegshürde und datennahe Services machen die GCP zu einem Pflichtwerkzeug in deiner Data-Science-Toolbox.
Bevor du Instanzen startest und Python-Pakete installierst, schauen wir uns kurz die wichtigsten Begriffe im Cloud-Computing an.
Eine Virtuelle Maschine (VM), auch „Instanz“ genannt, ist ein On-Demand-Server, den du bei Bedarf aktivierst. Die zugrunde liegende Hardware wird transparent mit anderen Nutzerinnen und Nutzern geteilt und ist für dich vollständig virtualisiert. Du wählst lediglich den geografischen Standort in einem Google-Rechenzentrum.
Eine VM ist durch die Art des persistenten Datenträgers (Disk) und das Betriebssystem (OS) definiert, z. B. Windows oder Linux. Die persistente Disk ist dein virtuelles Stück Hardware.
Ein Image ist die physische Kombination aus persistenter Disk und Betriebssystem. VM-Images werden häufig genutzt, um eine bestimmte Konfiguration auf mehrere VMs zu übertragen. Öffentliche Images stellt Google mit verschiedenen OS-Optionen bereit, private Images werden von Nutzerinnen und Nutzern angepasst.
Ein Snapshot ist eine Momentaufnahme des Inhalts einer VM (Disk, Software, Bibliotheken, Dateien) zu einem bestimmten Zeitpunkt und wird vor allem für schnelle Backups verwendet. Der Hauptunterschied: Snapshots werden als Diffs relativ zu vorherigen Snapshots gespeichert, Images nicht.
Sowohl ein Image als auch ein Snapshot können verwendet werden, um eine neue VM zu definieren und zu starten.
Kurz gesagt: Wenn du eine neue Instanz startest, hängt GCE zunächst eine persistente Disk an deine VM. Das liefert den Speicherplatz und das Root-Dateisystem zum Booten. Über das gewählte Image wird das OS installiert. Mit Snapshots eines Images erzeugst du Sofort-Backups und kannst Daten von bestehenden VMs übernehmen, um neue VMs zu starten.
Setzen wir das jetzt in die Praxis um und starten deine erste VM!
Für ein GCP-Konto brauchst du ein normales Google-(Gmail-)Konto. Zum Zeitpunkt des Schreibens bietet Google eine kostenlose Testphase von 12 Monaten bzw. 300 $ Guthaben. Dieses Angebot hat zwar einige Einschränkungen (z. B. kein Bitcoin-Mining), reicht aber locker, um loszulegen.
Um dein GCP-Konto mit Free Trial zu erstellen, gehe auf cloud.google.com und klicke auf try it free. Melde dich mit deinem Google-Konto an und hinterlege deine Abrechnungsdaten. Nach der Kontoerstellung erreichst du die Webkonsole unter http://console.cloud.google.com/.
Du nutzt zunächst die Webkonsole, um eine Debian-basierte Instanz zu definieren und zu starten, und wechselst dann ins webbasierte Shell-Terminal, um die nötigen Pakete für deinen Data-Science-Stack zu installieren.
Doch zuerst legst du ein neues Projekt an:
Die Projekt-ID muss in der GCP eindeutig sein, der Projekttitel ist frei wählbar. Ich nenne mein Projekt datacamp-gcp wie unten gezeigt:
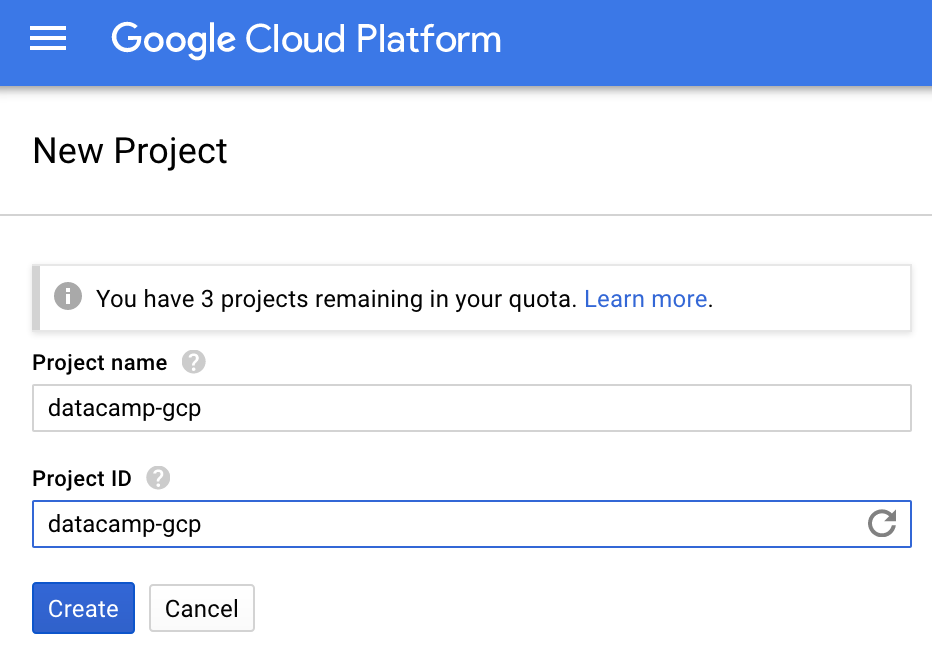
Standardmäßig wirst du beim Erstellen eines neuen Projekts als Owner mit vollen Rechten für alle Ressourcen und die Abrechnung eingetragen.
Im Bereich „Roles“ auf der IAM-Seite kannst du Personen mit bestimmten Rollen hinzufügen. Für dieses Tutorial überspringst du das und bleibst alleiniger User und Admin des Projekts.
So erstellst du deine erste VM:
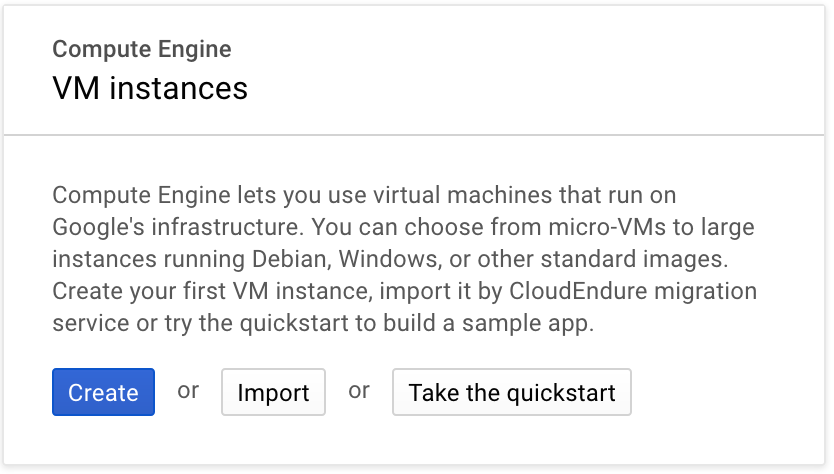
Du befindest dich jetzt auf der Seite „Create an Instance“.
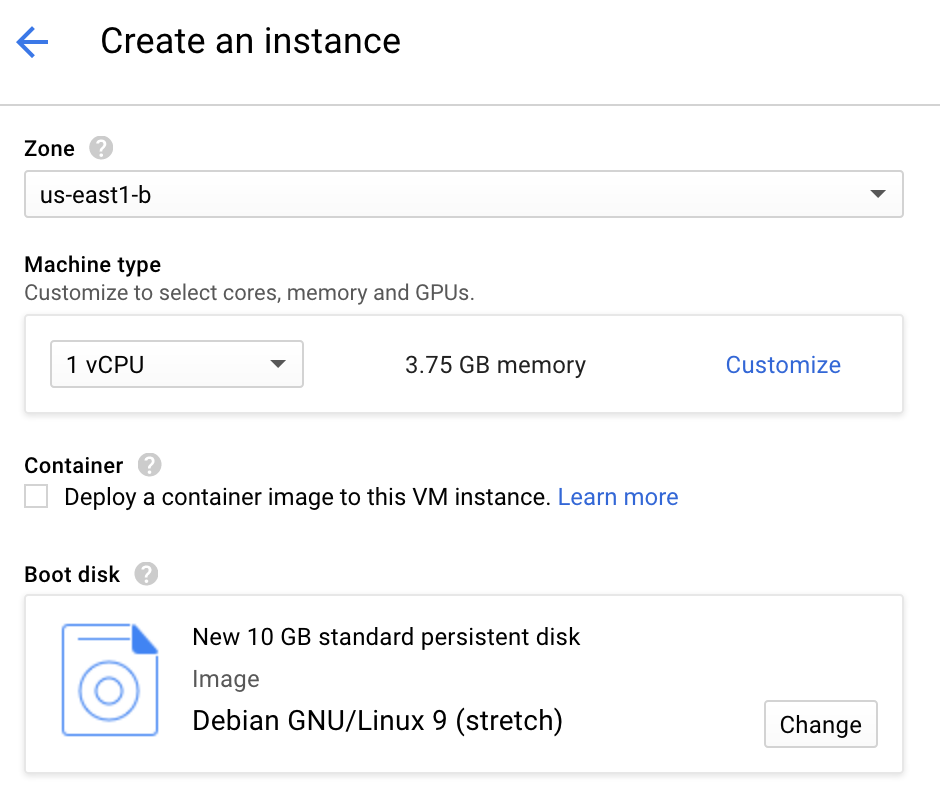
Instanz benennen: Der Name ist frei wählbar. Ich nenne meine Instanz starling.
Region wählen: Wähle in der Regel die günstigste Region in deiner Nähe, um Latenzen zu minimieren. Ich nehme east-d. Beachte: Die Preise variieren je nach Region deutlich.
Arbeitsspeicher, Storage und CPU auswählen. Du kannst Presets nutzen oder frei konfigurieren. Hier wähle ich das Default-Setup n1-standard-1 mit 3,75 GB RAM und 1 vCPU für einen geschätzten Preis von 24,67 $ pro Monat.
Boot-Disk wählen und beim Standard Debian GNU/Linux 9 (stretch) mit 10 GB bleiben. Wenn du lieber Ubuntu oder eine andere Linux-Distribution nutzt, klicke auf „Change“ und triff deine Auswahl. Da Ubuntu eng auf Debian basiert, funktionieren beide Distributionen für dieses Tutorial.
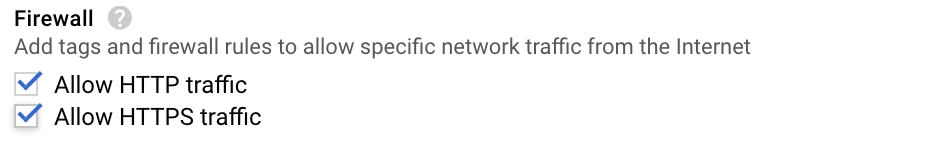
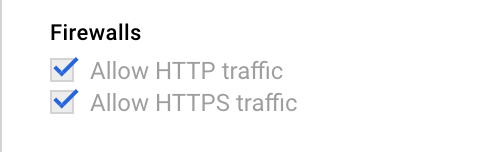
5. Stelle sicher, dass du aus dem Internet auf die VM zugreifen kannst, indem du HTTP- und HTTPS-Traffic zulässt.
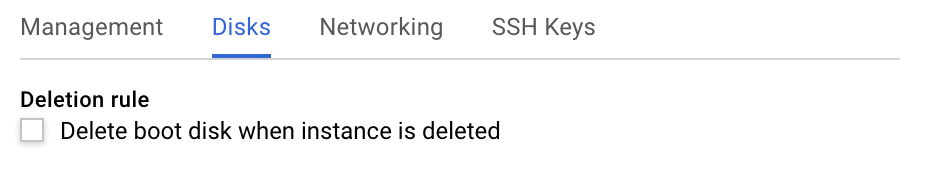
6. (Optional) Richte eine persistente Disk für Backups ein: Klicke auf „Management, Disks, networking, SSH keys“. Es öffnet sich ein Tab-Set, wähle den Tab „Disks“ und deaktiviere „Deletion Rule“. So wird beim Löschen der Instanz die Disk nicht gelöscht und kann später zum Starten einer neuen Instanz verwendet werden.
7. Klicke abschließend auf „Create“. Nach wenigen Minuten ist deine Instanz bereit.
Beachte den Link „Equivalent command line“ unter dem Create-Button. Er zeigt dir den entsprechenden Befehl, um dieselbe Instanz per Kommandozeile zu erzeugen. Eine clevere Funktion, um die Syntax des gcloud SDK zu lernen.
Jetzt läuft deine Instanz, ist aber noch weitgehend leer. Es gibt zwei Wege für den Zugriff: Entweder du installierst das gcloud SDK lokal oder du nutzt die Google Cloud Shell.
Die Google Cloud Shell ist ein eigenständiges Terminal im Browser, über das du deine Ressourcen verwaltest. Du aktivierst sie über das >\_-Icon oben rechts in der Konsole. Der untere Bereich deines Browsers wird zum Terminal.
Dieses Terminal läuft auf einer f1-micro-VM der Google Compute Engine mit Debian und 5 GB Speicher. Es wird pro Nutzer und Sitzung erstellt, bleibt aktiv, solange deine Sitzung läuft, und wird nach 20 Minuten Inaktivität gelöscht. Da der zugehörige Datenträger zwischen Sitzungen persistiert, stehen deine Inhalte (Dateien, Konfigurationen, …) sitzungsübergreifend bereit. Die Cloud-Shell-Instanz hat das gcloud SDK und vim vorinstalliert.
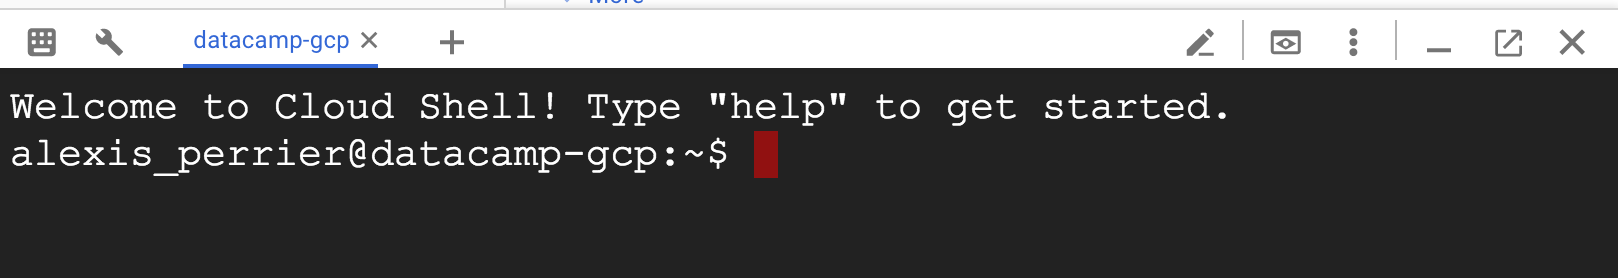
Wichtig ist die Unterscheidung zwischen der benutzerbasierten Cloud-Shell-Instanz und der Instanz, die du gerade erstellt hast. Die Cloud-Shell-Instanz ist nur eine bequeme Verwaltungsumgebung mit flüchtiger Recheninstanz. Die VM, die du erstellt hast (im Beispiel starling), ist diejenige, auf der du deine Data-Science-Umgebung installierst.
Statt der Google Cloud Shell kannst du das gcloud SDK auch lokal installieren und alles von deiner Umgebung aus steuern.
Hier ein paar nützliche Befehle zur Instanzverwaltung.
Instanzen auflisten
gcloud compute instances list
Instanz stoppen (dauert wenige Sekunden)
gcloud compute instances stop <instance name>
Instanz starten (dauert ebenfalls wenige Sekunden)
gcloud compute instances start <instance name>
Per SSH in die Instanz „starling“ einloggen
gcloud compute ssh <instance name>
Führe den letzten Befehl im Google-Shell-Fenster aus, um dich auf deiner Instanz anzumelden. Die nächsten Schritte sind:
apt-get install installieren.Beginnen wir mit den Debian-Paketen:
Führe diese Befehle im Terminal aus, sie funktionieren für Ubuntu und Debian:
$ sudo apt-get update
$ sudo apt-get install bzip2 git libxml2-dev
Nachdem die Pakete installiert sind, kümmerst du dich um Anaconda für Python 3. Du hast die Wahl zwischen der kompletten Anaconda-Version mit vielen wissenschaftlichen Bibliotheken (von denen du manche vielleicht nicht brauchst) und der schlankeren Miniconda-Version, bei der du die Jupyter-Bibliotheken manuell installierst. Der Ablauf ist in beiden Fällen sehr ähnlich.
Um die schlankere Miniconda-Distribution zu installieren, führe aus
$ wget https://repo.continuum.io/miniconda/Miniconda3-latest-Linux-x86_64.sh
$ bash Miniconda3-latest-Linux-x86_64.sh
$ rm Miniconda3-latest-Linux-x86_64.sh
$ source .bashrc
$ conda install scikit-learn pandas jupyter ipython
Die ersten zwei Zeilen laden das Installationsskript herunter und führen es aus. Akzeptiere die Lizenz und den Standardpfad. In Zeile 3 wird die nicht mehr benötigte Skriptdatei gelöscht. Das source .bashrc in Zeile 4 ergänzt den conda-Befehl in deinem $PATH, ohne ein neues Terminal zu öffnen. Die letzte Zeile installiert die benötigten Python-Bibliotheken: scikit-learn pandas jupyter ipython.
Die Befehle für die vollständige Anaconda-Distribution sind sehr ähnlich. Prüfe auf der Download-Seite die aktuelle Version des Skripts:
$ wget https://repo.continuum.io/archive/Anaconda3-5.0.1-Linux-x86_64.sh
$ bash Anaconda3-5.0.1-Linux-x86_64.sh
$ rm Anaconda3-5.0.1-Linux-x86_64.sh
$ source .bahsrc
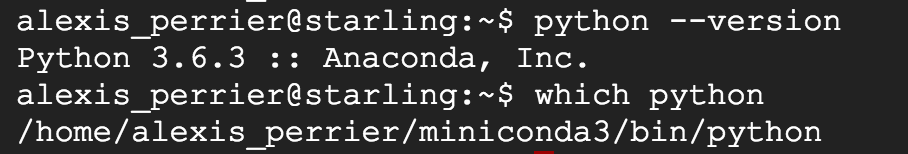
Um zu prüfen, ob alles korrekt installiert ist, überprüfe deine Python-Version mit python --version und kontrolliere mit which python, welches Python standardmäßig aufgerufen wird. Du solltest etwas Ähnliches sehen wie hier:
Damit hast du eine funktionierende Python-Umgebung mit den gängigen Data-Science-Bibliotheken (sklearn, pandas).
Als Nächstes konfigurierst du deine VM so, dass du per Web auf deine Jupyter Notebooks zugreifen kannst.
Zunächst muss die VM aus dem Web erreichbar sein. Dazu legst du in der Google-Cloud-Konsole eine Firewall-Regel an. Gehe zurück zum Instanzen-Dashboard und wähle im Menü oben links „VPC Network > Firewall rules“. Klicke auf „CREATE FIREWAL RULE“ und fülle Folgendes aus:
Das Formular sollte so aussehen:
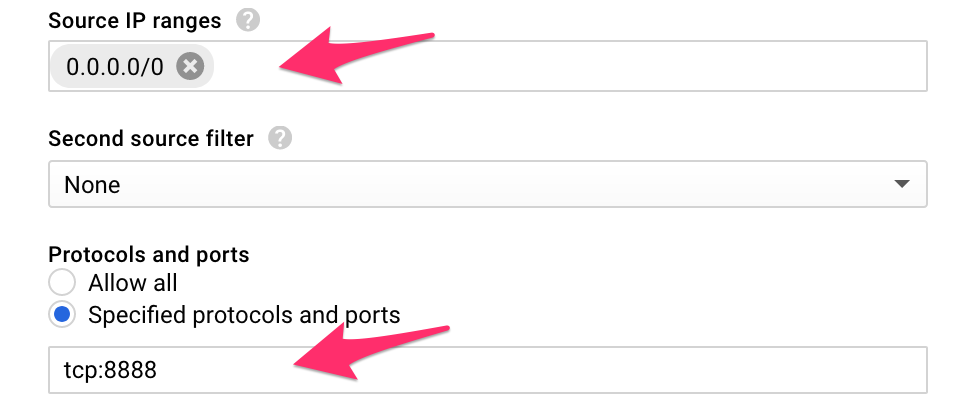
Diese Firewall-Regel erlaubt eingehenden Traffic (von allen IPs) auf Port 8888.
Über den Link „Equivalent command line“ siehst du, wie sich die Regel auch im Terminal erzeugen lässt:
$ gcloud compute --project=datacamp-gcp firewall-rules create jupyter-rule --direction=INGRESS --priority=1000 --network=default --action=ALLOW --rules=tcp:8888 --source-ranges=0.0.0.0/0
Wechsle nun zurück zur VM-Seite (Menü oben links > Compute Engine > VM instances) und klicke auf den Namen deiner VM.
Notiere dir die IP-Adresse deiner VM. Unter dieser IP greifst du im Browser auf deine Jupyter-Umgebung zu. In meinem Beispiel lautet sie 35.196.81.49, bei dir ist sie anders.
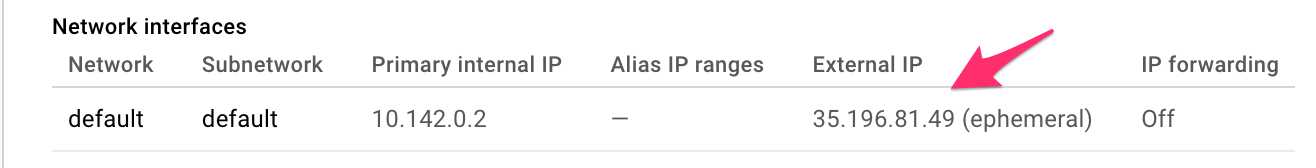
Und prüfe, ob die Firewall-Regeln aktiviert sind:
Jupyter Notebooks nutzen eine Konfigurationsdatei, die du erzeugen und bearbeiten musst, um den Onlinezugriff einzurichten. Erzeuge die Datei mit jupyter notebook --generate-config. Lege mit jupyter notebook password ein Passwort fest.
Tipp: Wähle unbedingt ein starkes Passwort!
Bearbeite anschließend die Konfigurationsdatei mit vim .jupyter/jupyter_notebook_config.py und füge am Anfang die folgende Zeile ein
c.NotebookApp.ip = '*'
(Zum Editieren in vim drücke i.) Beenden und speichern mit ESC:wq.
Damit ist das Notebook auf alle IP-Adressen deiner VM lauschen eingestellt – nicht nur auf http://localhost:8888, wie du es lokal gewohnt bist.
Jetzt kannst du dein Jupyter Notebook mit folgendem Befehl starten:
$ jupyter-notebook --no-browser --port=8888
Im Terminal siehst du dann in etwa Folgendes:

Öffne im Browser die URL: http://<your_VM_IP>:8888/, um auf dein frisch gestartetes Jupyter Notebook zuzugreifen.
Zum Testen erstellst du ein neues Python-3-Notebook und führst import pandas aus.
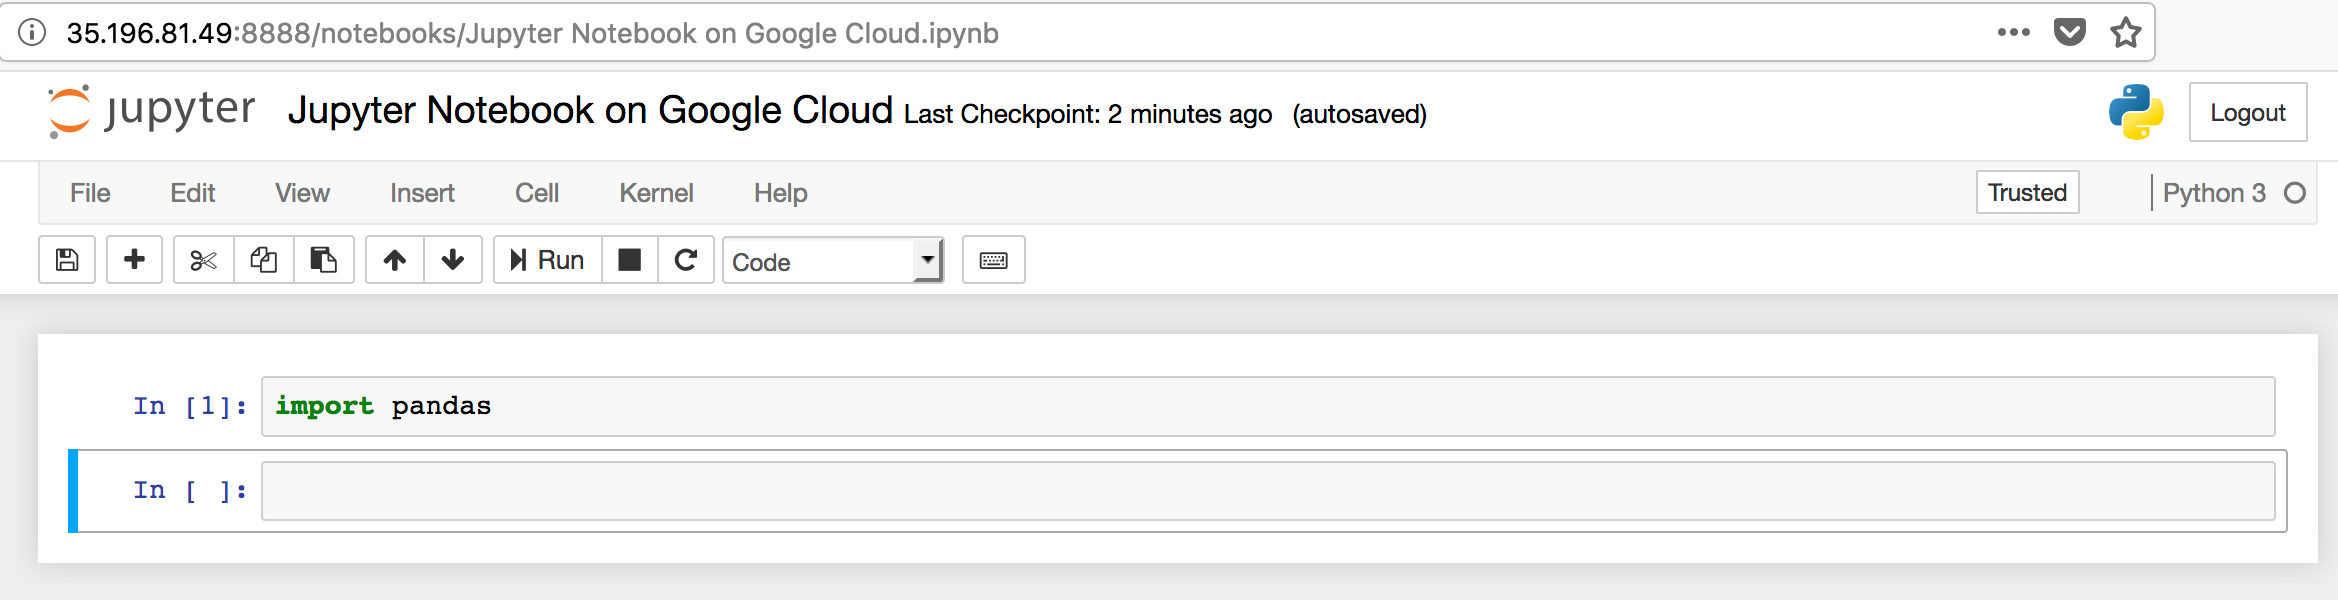
Ein paar Hinweise zu deinem aktuellen Setup:
Die im Browser genutzte IP ist flüchtig. Das heißt: Nach jedem Neustart der VM ändert sich die URL deines Notebooks. Du kannst die IP statisch machen unter: Menü oben links > VPC Network > External IP addresses und im Dropdown „static“ wählen. 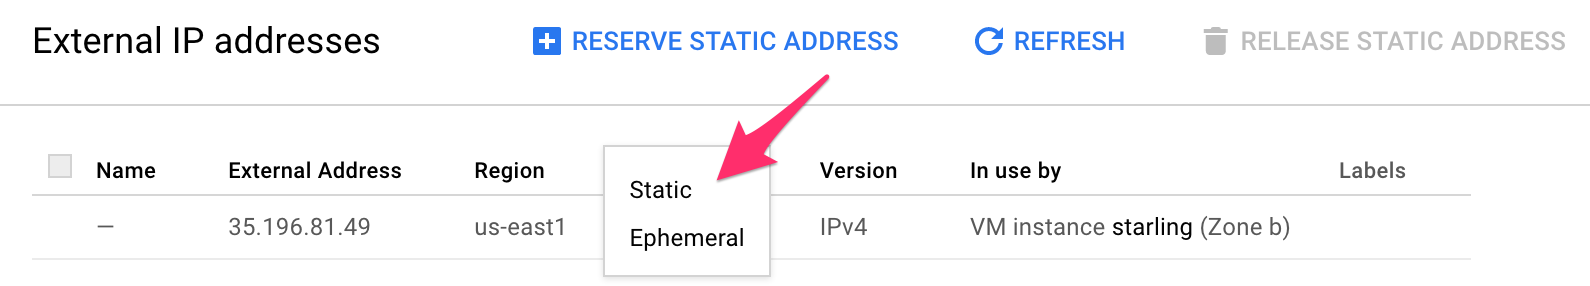
Die Sicherheit deines aktuellen Setups hängt stark von der Stärke deines Jupyter-Passworts ab. Jede Person im Internet kann deine URL aufrufen (und Bots werden es versuchen). Eine mächtige, aber unsichere Kernfunktion von Jupyter ist, dass sich aus dem Notebook ein Terminal mit sudo-Rechten öffnen lässt. Wer dein Passwort knackt, kann deine VM übernehmen und potenziell teure Aktionen ausführen. Erste Gegenmaßnahmen sind:
Sorge für ein starkes Jupyter-Passwort
Außerdem läuft der Server aktuell über HTTP, nicht HTTPS, was nicht ausreichend sicher ist. Let’s Encrypt stellt kostenlose SSL/TLS-Zertifikate bereit und ist die in der Jupyter-Dokumentation empfohlene Verschlüsselungslösung. Mehr zu Sicherheitsthemen rund um öffentliche Jupyter Notebooks findest du hier.
Jupyter Notebooks sind ideal für kollaboratives Arbeiten im Web. Du kannst aber auch einfach mit dem Befehl ipython eine IPython-Session im Terminal starten. Sie bietet dir die Vorteile eines Jupyter Notebooks (z. B. Magic Commands wie %paste, %run, …), nur ohne Weboberfläche.
R-Notebooks in deiner Jupyter-Konsole sind schnell eingerichtet. Die Anleitung zum Aktivieren von R Markdown findest du in diesem hervorragenden DataCamp-Tutorial: Jupyter And R Markdown: Notebooks With R von Karlijn Willems.
Google Cloud bietet viele spannende Services für Data Science sowie leistungsfähige, leicht einzurichtende VM-Instanzen und dazu eine sehr attraktive Testphase. Die Webkonsole ist übersichtlich und zeigt oft die Kommandozeilen-Pendants zu den aktuellen Einstellungen – das senkt die Hürde für die Nutzung des gcloud SDK.
In diesem Artikel hast du gelernt, wie du eine VM-Instanz auswählst und startest, die nötigen Debian-Pakete, die Anaconda-Distribution und den Data-Science-Stack installierst und schließlich die Zugriffsregeln einrichtest, um ein Jupyter Notebook direkt aus dem Browser zu starten.
Auch wenn der Ablauf beim ersten Mal komplex wirkt, wird er schnell zur Routine, sobald du öfter VMs erstellst und startest. Und wenn es mal zu unübersichtlich wird, löschst du die aktuelle VM und fängst von vorn an – einer der Vorteile der Cloud. Nach ein paar Durchläufen kannst du komplette Data-Science-Umgebungen in Google Cloud in wenigen Minuten hochziehen. Melde dich gern mit Feedback und Fragen bei mir auf Twitter: @alexip.
Erfahre mehr über Data Science
Kurs
Kurs
Kurs