No mundo orientado por dados de hoje, a necessidade por bancos de dados escaláveis, de alta performance e alta disponibilidade é maior do que nunca. O Amazon DynamoDB, um banco de dados totalmente gerenciado, serverless e do tipo key-value e documentos da AWS (Amazon Web Services), foi projetado para atender a essas demandas. Seja para uma aplicação web, um app móvel ou qualquer sistema que exija armazenamento flexível e confiável, o DynamoDB dá conta do recado.
Este tutorial tem como objetivo apresentar o Amazon DynamoDB e mostrar como usá-lo com eficiência em aplicações Node.js. Quer você esteja começando agora com bancos NoSQL ou já seja um desenvolvedor experiente buscando ampliar seu conjunto de habilidades, este guia vai passar pelo essencial e trazer exemplos práticos para você começar.
O que é o DynamoDB?
O Amazon DynamoDB é um banco de dados serverless, key-value e de documentos, que oferece escalabilidade contínua e baixa latência. Diferente dos bancos relacionais tradicionais, o DynamoDB não exige provisionamento de hardware nem gerenciamento de infraestrutura, o que o torna uma ótima escolha para aplicações que precisam escalar para cima ou para baixo dinamicamente conforme a carga.
Principais recursos do DynamoDB:
Escalabilidade
O DynamoDB pode lidar com milhões de requisições por segundo, sendo adequado para aplicações com diferentes níveis de tráfego.
Alta disponibilidade
Projetado para alta disponibilidade e durabilidade dos dados, com replicação nativa entre múltiplas zonas de disponibilidade.
Serviço gerenciado
A AWS cuida das operações, incluindo provisionamento de hardware, patches e backups, permitindo que você foque em construir sua aplicação.
Modelo de dados flexível
O DynamoDB suporta modelos de dados key-value e de documentos, oferecendo flexibilidade na forma como você estrutura seus dados.
Segurança
A integração com o AWS Identity and Access Management (IAM) permite controle de acesso seguro e granular aos recursos do seu banco, nos níveis de item e atributo.
Economia de custos
A arquitetura serverless do DynamoDB, somada à sua capacidade de escalonamento automático, permite otimizar custos pagando apenas pelos recursos consumidos. Não há custos iniciais de hardware nem compromissos de longo prazo, tornando-o uma opção econômica tanto para startups quanto para grandes empresas.
Tipos de dados
Tipos de dados suportados no DynamoDB:
- Tipos escalares: incluem strings, números, binários, booleanos e valores nulos.
- Tipos de documento: o DynamoDB acomoda estruturas complexas com atributos aninhados, ideal para trabalhar com dados JSON.
- Tipos de conjunto: conjuntos de strings, números e binários permitem armazenar coleções de valores relacionados de forma eficiente.
Por que usar DynamoDB com Node.js?
Node.js é um runtime popular para construir aplicações no lado do servidor, incluindo web servers e APIs. Sua arquitetura não bloqueante e orientada a eventos se encaixa muito bem com a API assíncrona do DynamoDB, sendo uma escolha natural para desenvolvedores Node.js.
Neste tutorial, vamos abordar os seguintes tópicos:
1. Criação de tabelas e definição de schema no DynamoDB.
2. Execução de operações CRUD (Create, Read, Update, Delete) usando o AWS SDK para Node.js.
3. Consultas avançadas com conformidade ACID.
Ao final, você terá uma base sólida sobre o Amazon DynamoDB e saberá como aproveitar sua força dentro das suas aplicações Node.js. Vamos lá liberar todo o potencial desse banco NoSQL versátil!
Preparação
Antes de começar, você vai precisar de uma conta AWS. Poderíamos fazer tudo isso sem uma conta, mas, para um exemplo mais realista, vamos usar terraform para criar nossa infraestrutura na AWS. Para mais informações sobre como trabalhar localmente com serviços AWS usando o Docker, tenho um demo com localstack em um repositório no GitHub que você pode consultar e experimentar.
Agora também é hora de instalar o terraform, caso ainda não tenha.
O restante deste tutorial assume que você já configurou o AWS CLI com suas credenciais e arquivos de configuração e que tem o terraform instalado.
Primeiros passos
Para este tutorial, vamos usar TypeScript e yarn. Vamos começar simples com ts-node e, no próximo tutorial, vamos para o modelo serverless e evoluir isso usando o AWS Lambda.
Para configurar nosso projeto de demonstração, crie uma nova pasta e adicione as dependências e configurações a seguir executando:
yarn init
yarn add --dev typescript ts-node @types/node @types/ramda @types/uuid
yarn add @aws-sdk/client-dynamodb ramda uuid
npx tsc --init
mkdir src src/domain infra
touch ./src/index.ts ./src/client.ts ./infra/main.tf ./src/domain/student.ts
Em seguida, adicione a seção de scripts ao package.json
  "scripts": {
    "dev": "ts-node src/index.ts"
  },
main.tf
provider "aws" {
  region = "eu-west-1"
}


resource "aws_dynamodb_table" "demo-table" {
  name = "demo-table"
  billing_mode = "PAY_PER_REQUEST"
  hash_key = "pk"
  range_key = "sk"


  attribute {
    name = "pk"
    type = "S"
  }


  attribute {
    name = "sk"
    type = "S"
  }
}
No terminal, acesse o diretório infra e execute terraform init && terraform apply -auto-approve e então abra o console da AWS para ver sua tabela do DynamoDB:
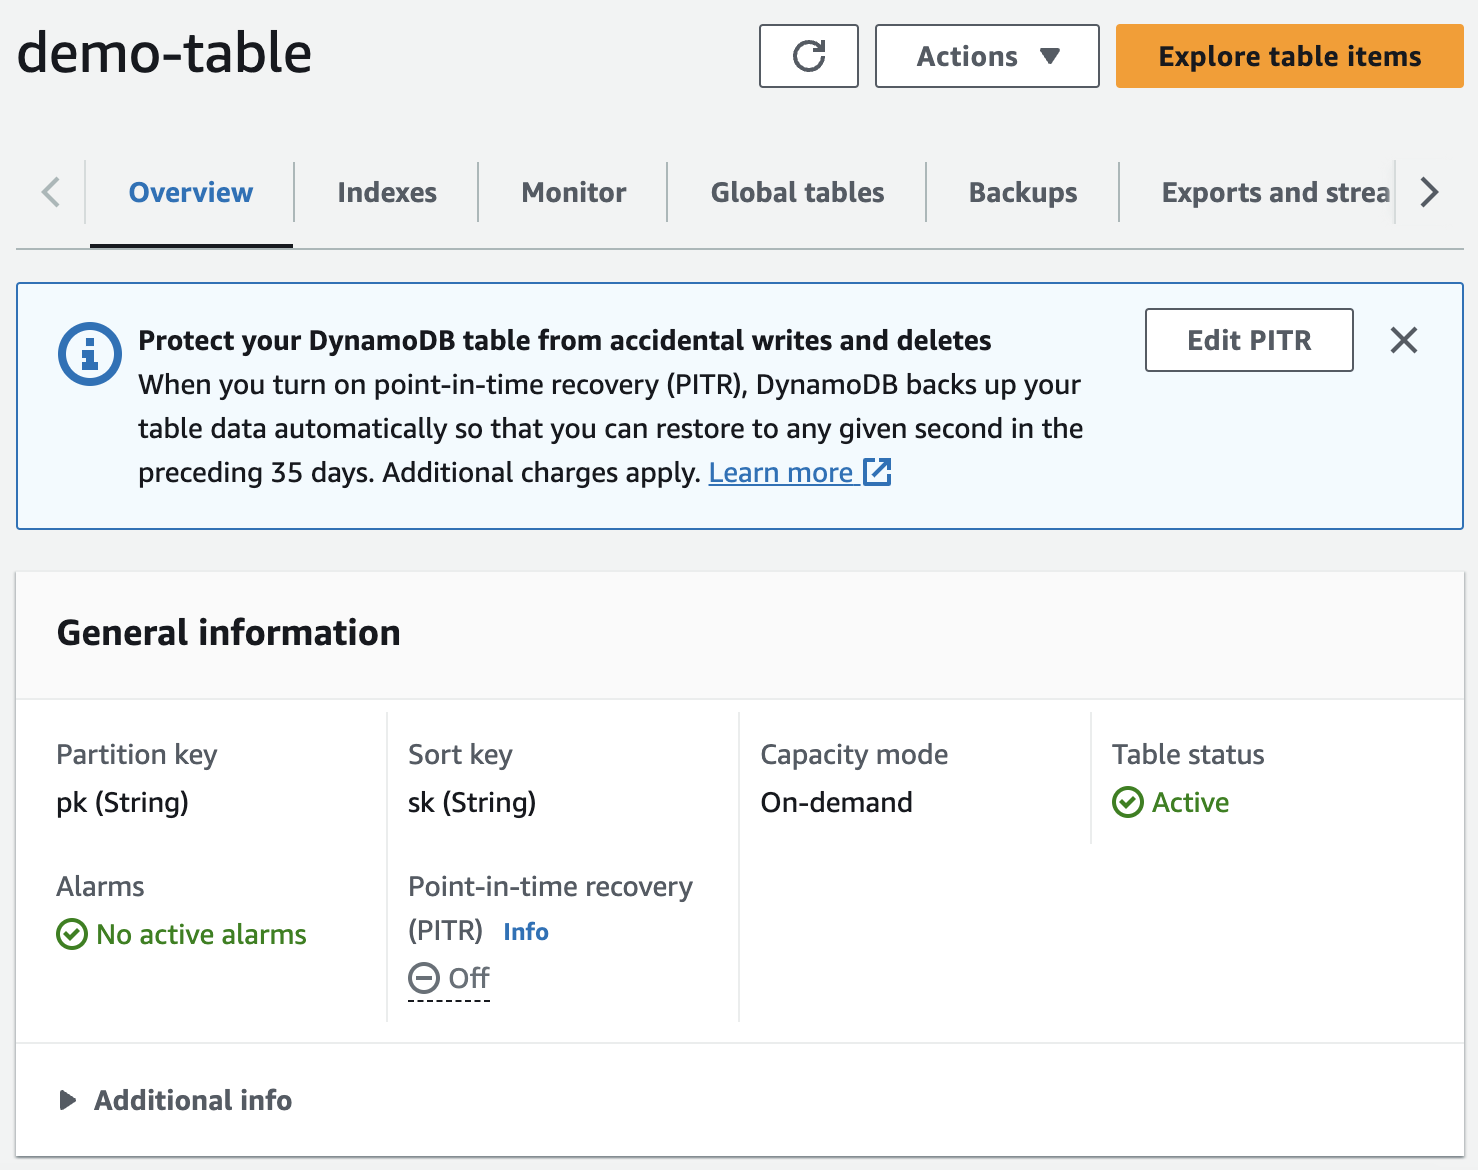
Vou abordar modos de cobrança do DynamoDB, WCU e RCU em um artigo separado
client.ts
import { DynamoDB } from "@aws-sdk/client-dynamodb";


export const TABLE_NAME = "demo-table";
export const REGION = "eu-west-1";
export const dynamoClient = new DynamoDB({ region: REGION });


export const STUDENT_PREFIX = "student#";
Modelo de dados
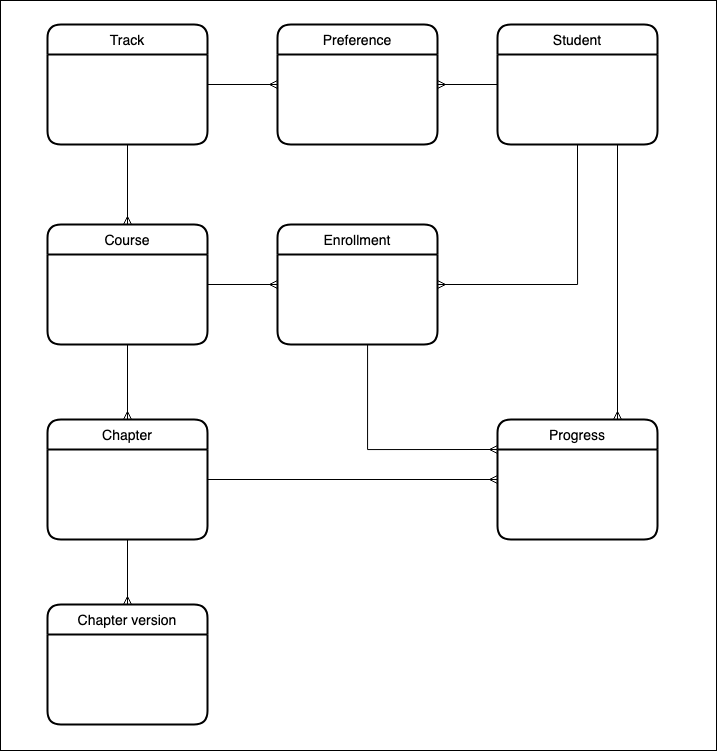
Antes de avançar, vamos definir um modelo de dados para o escopo deste tutorial. Para manter o contexto, escolhi modelar algo próximo aos recursos centrais do DataCamp.
Este tutorial não cobre todas as entidades. Vou expandir esse modelo em artigos futuros.
Operações CRUD com DynamoDB
Para entender profundamente como projetar e modelar dados no DynamoDB, veja meu tutorial sobre single table design com DynamoDB. Aqui, vou manter ao mínimo a explicação de como o DynamoDB funciona. O ponto-chave é: o DynamoDB usa chaves de partição e de ordenação para gerenciar dados com eficiência.
Chaves de partição
Chaves de partição são usadas para distribuir dados entre vários servidores de armazenamento. É importante escolher uma chave de partição que distribua os dados de forma uniforme para evitar "partições quentes" (distribuição desigual), o que pode causar problemas de performance.
Escolhas comuns de chaves de partição que ajudam a distribuir dados de maneira uniforme incluem atributos de alta cardinalidade, como:
- IDs únicos
- IDs de usuário
- valores de hash
- regiões geográficas
- chaves baseadas em tempo
- chaves compostas
A escolha da chave de partição depende bastante dos padrões de acesso e do modelo de dados da aplicação.
Chaves de ordenação
Chaves de ordenação são opcionais e permitem organizar dados dentro de uma partição. Use-as para consultas e ordenação eficientes dentro da mesma partição.
Chaves compostas
Chaves compostas incluem tanto a chave de partição quanto a de ordenação. Elas permitem criar padrões de consulta avançados, como filtragem por intervalos, tempo ou outros atributos. Use chaves compostas quando seus padrões de acesso exigirem consultas mais complexas.
Partições quentes
Para mitigar partições quentes, considere estratégias como sharding (usar prefixos aleatórios nas chaves de partição), particionamento por tempo ou distribuição uniforme de gravações. Monitore e use o AWS Auto Scaling para ajustar a capacidade dinamicamente.
student.ts
Vamos manter simples e usar o ID do aluno como chave de partição e também como chave de ordenação. Pode parecer uma escolha estranha, mas precisamos manter o schema flexível e pronto para suportar vários relacionamentos e padrões de acesso. Vou expandir esse modelo em artigos futuros sobre DynamoDB.
import { head, omit, pathOr } from "ramda";
import { STUDENT_PREFIX, TABLE_NAME, dynamoClient as client } from "../client";
import { v4 as uuidv4 } from "uuid";
import {
  addPrefix,
  attributeMapToValues,
  attributeValueToValue,
  removePrefix,
  valueToAttributeValue,
} from "../utils";


const entityType = "student";


export const dynamoRecordToStudent = (record: any) => {
  const { pk, ...data } = record;


  return omit(["sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
  });
};


export const getStudentById = (id: string) =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
  })
  .then(({ Item }) => (Item ? dynamoRecordToStudent(Item) : undefined));


export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      email: valueToAttributeValue(_email),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
utils.ts
A versão mais recente do SDK do DynamoDB da AWS aumentou a segurança de tipos para itens armazenados no banco, mas, ao fazer isso, deixou o uso um pouco mais trabalhoso. Para facilitar, vamos criar algumas funções auxiliares. Logo ficará claro por que precisamos delas quando virmos como o DynamoDB armazena dados internamente.
Crie um novo arquivo na raiz da pasta src com o nome utils.ts.
import { AttributeValue } from "@aws-sdk/client-dynamodb";


export const valueToAttributeValue = <T>(value: T): AttributeValue => {
  switch (typeof value) {
    case "string":
      return { S: value };
    case "number":
      return { N: `${value}` };
    case "boolean":
      return { BOOL: value };
    case "object":
      if (Array.isArray(value)) {
        return { L: value.map((item) => valueToAttributeValue(item)) };
      }
      return {
        M: Object.entries(value as any).reduce(
          (acc, [key, item]) => ({
            ...acc,
            [key]: valueToAttributeValue(item),
          }),
          {}
        ),
      };
    default:
      throw new Error(`Unknown type ${typeof value}`);
  }
};


export const attributeValueToValue = <T>(value: AttributeValue): T => {
  switch (true) {
    case !!value.S:
      return value.S as T;
    case !!value.N:
      return Number(value.N) as T;
    case !!value.BOOL:
      return value.BOOL as T;
    case !!value.L:
      return value.L?.map((item) =>
        attributeValueToValue(item)
      ) as unknown as T;
    case !!value.M:
      return Object.entries(value.M || []).reduce(
        (acc, [key, item]) => ({ ...acc, [key]: attributeValueToValue(item) }),
        {}
      ) as unknown as T;
    default:
      throw new Error(`Unknown type ${JSON.stringify(value)}`);
  }
};


export const attributeMapToValues = (
  items: Record<string, AttributeValue>
): unknown[] =>
  Object.keys(items).reduce(
    (acc, key) => ({
      ...acc,
      [key]: attributeValueToValue(items[key]),
    }),
    []
  );


export const removePrefix = (id: string, prefix: string): string =>
  id.replace(prefix, "");


export const addPrefix = (id: string, prefix: string): string =>
  `${prefix}${removePrefix(id, prefix)}`;
Criando um novo aluno
Agora sim, estamos prontos para começar a enviar chamadas de API de operações CRUD para o DynamoDB!
Abra o arquivo index.ts, cole o código a seguir e, no terminal, execute yarn dev.
import { getStudentById, saveStudent } from "./domain/student";


Promise.resolve()
  .then(async () => {
    const id = await saveStudent({
      firstName: "John",
      lastName: "Smith",
      email: "john@datacamp.com",
    });


    const john = await getStudentById(id);


    console.log(john);
  })
  .catch((err) => {
    console.error(err);
    process.exit(1);
  })
  .then(() => {
    console.log("done");
    process.exit(0);
  });
Você deve ver algo como isto:
{
  "entityType": "student",
  "id": "dd4c2ee4-9422-4957-ae6f-f9fff748e5ab",
  "firstName": "John",
  "lastName": "Smith",
  "email": "john@datacamp.com",
  "xp": 0
}
Agora use o CLI para fazer um scan no DynamoDB executando:
aws dynamodb scan --table-name demo-table --no-cli-pager
Pela saída, dá para ver como o DynamoDB armazena e tipa dados internamente, onde N se refere a número e S a string. Isso deve esclarecer qualquer dúvida que você tenha tido ao olhar o código em utils.ts.
{
  "Items": [
    {
      "entityType": {
        "S": "student"
      },
      "lastName": {
        "S": "Smith"
      },
      "email": {
        "S": "john@datacamp.com"
      },
      "xp": {
        "N": "0"
      },
      "sk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "pk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "firstName": {
        "S": "John"
      }
    }
  ],
  "Count": 1,
  "ScannedCount": 1,
  "ConsumedCapacity": null
}
Buscar um aluno por e-mail
E se tivermos apenas o e-mail do aluno para localizar o registro? Podemos suportar esse padrão de acesso adicionando um índice secundário global (GSI).
Primeiro, precisamos destruir a tabela original (vamos contornar essa etapa em mudanças futuras de terraform introduzindo uma função de truncate):
terraform destroy
Depois, atualize o terraform adicionando o seguinte GSI à nossa demo-table:
attribute {
  name = "gsi1_pk"
  type = "S"
}


attribute {
  name = "gsi1_sk"
  type = "S"
}


global_secondary_index {
  name = "gsi1"
  hash_key = "gsi1_pk"
  range_key = "gsi1_sk"
  projection_type = "ALL"
}
Aplique a mudança com:
terraform apply -auto-approve
Agora precisamos ajustar um pouco como salvamos um aluno:
export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      gsi1_pk: valueToAttributeValue(_email),
      gsi1_sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
Perceba que não armazenamos mais o e-mail explicitamente: usamos o e-mail como valor de PK do GSI.
Também precisamos ajustar a transformação dos dados do aluno vindos do DynamoDB:
export const dynamoRecordToStudent = (record: any) => {
  const { pk, gsi1_pk, ...data } = record;


  return omit(["sk", "gsi1_sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
    email: attributeValueToValue<string>(gsi1_pk),
  });
};
Por fim, podemos consultar usando o novo GSI gsi1 para obter um aluno pelo e-mail:
export const getStudentByEmail = (email: string) =>
  client
    .query({
      TableName: TABLE_NAME,
      IndexName: "gsi1",
      KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
      ExpressionAttributeNames: {
        "#gsi1_pk": "gsi1_pk",
      },
      ExpressionAttributeValues: {
        ":gsi1_pk": {
          S: email.toLocaleLowerCase(),
        },
      },
    })
    .then((res) => head(pathOr([], ["Items"], res).map(dynamoRecordToStudent)));
Atualizando um aluno
Para atualizar um aluno, usamos o método update e passamos as chaves de partição e de ordenação para identificar de forma única o item a ser atualizado.
export const updateStudent = async ({
  id,
  firstName,
  lastName,
  email,
}: {
  id: string;
  firstName?: string;
  lastName?: string;
  email?: string;
}) => {
  const updateExpressionParts = [];
  const ExpressionAttributeValues: Record<string, any> = {};


  if (firstName !== undefined) {
    updateExpressionParts.push("#firstName = :firstName");
    ExpressionAttributeValues[":firstName"] = valueToAttributeValue(firstName);
  }


  if (lastName !== undefined) {
    updateExpressionParts.push("#lastName = :lastName");
    ExpressionAttributeValues[":lastName"] = valueToAttributeValue(lastName);
  }


  if (email !== undefined) {
    updateExpressionParts.push("#gsi1_pk = :gsi1_pk");
    ExpressionAttributeValues[":gsi1_pk"] = valueToAttributeValue(email);
  }


  const UpdateExpression = `SET ${updateExpressionParts.join(", ")}`;


  const ExpressionAttributeNames = {
    ...(firstName && { "#firstName": "firstName" }),
    ...(lastName && { "#lastName": "lastName" }),
    ...(email && { "#gsi1_pk": "gsi1_pk" }),
  };


  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression,
    ExpressionAttributeNames,
    ExpressionAttributeValues,
  });
};
Excluindo dados
Começando pelo fato de que truncar uma tabela no DynamoDB não é suportado nativamente, a não ser excluindo a tabela inteira e recriando (como fizemos para incluir um novo GSI). Vou adicionar um método de truncate no client.ts, mas reforço que isso é apenas para testes e não deve ser usado em produção. O motivo: para saber o que excluir, precisamos escanear a tabela inteira, e toda operação no DynamoDB gera custo; se você tiver um milhão de itens, provavelmente será mais barato remover a tabela e recriá-la (com algum processo de migração de dados para não perder dados de produção). Aqui está nossa função de truncate:
type AttributeMap = Record<string, AttributeValue>;


const getItemKeyAndValue = (item: AttributeMap, key?: string) =>
  key ? { [`${key}`]: item[`${key}`] } : {};


export const truncateTable = async (
  client: DynamoDB,
  TableName: string,
  hash: string,
  range?: string
): Promise<void> => {
  const { Items } = await client.scan({ TableName });
  if (!Items) {
    return;
  }
  const keys = Items.map((item: AttributeMap) => ({
    ...getItemKeyAndValue(item, hash),
    ...getItemKeyAndValue(item, range),
  }));
  if (!keys.length) {
    return;
  }
  await Promise.all(keys?.map((Key) => client.deleteItem({ TableName, Key })));
};
Para truncar a demo-table:
await truncateTable(dynamoClient, TABLE_NAME, "pk", "sk");
Para excluir um aluno específico, não queremos usar diretamente o método deleteItem do SDK. Bancos NoSQL não têm integridade referencial e, se houver outros itens referenciando um aluno que deixou de existir, isso vira um problema — e o DynamoDB vai excluir qualquer item que você mandar, sem a rede de segurança de chaves estrangeiras de um banco relacional (que geraria erro na exclusão).
Para jogar seguro, vamos implementar um soft delete e ajustar ligeiramente as duas funções de leitura.
export const deleteStudent = async (id: string) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "SET #deleted = :deleted",
    ExpressionAttributeNames: {
      "#deleted": "deleted",
    },
    ExpressionAttributeValues: {
      ":deleted": valueToAttributeValue(true),
    },
  });
};
A consulta de getStudentByEmail agora deve filtrar registros excluídos. Importante: esse “filtro” acontece no cliente, não no banco, ou seja, a consulta ainda terá o mesmo custo para recuperar registros marcados como excluídos.
{
  TableName: TABLE_NAME,
  IndexName: "gsi1",
  KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
  ExpressionAttributeNames: {
    "#gsi1_pk": "gsi1_pk",
  },
  ExpressionAttributeValues: {
    ":gsi1_pk": {
      S: email.toLocaleLowerCase(),
    },
    ":notDeleted": {
      BOOL: false,
    },
  },
  FilterExpression:
    "attribute_not_exists(deleted) OR deleted = :notDeleted",
 }
A função getStudentById usa getItem, então não dá para aplicar uma filter expression; nesse caso, vamos escrever a lógica explicitamente:
export const getStudentById = (id: string): Promise<Student | null> =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
        pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
        sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      },
    })
    .then(({ Item }) => {
      if (!Item) {
        return null;
      }
      const _item = dynamoRecordToStudent(Item);
      return _item.deleted ? null : _item;
    });
Atualizações atômicas com conformidade ACID
O DataCamp coleta XP de cada aluno para gerar motivação, senso de conquista, uma forma simples de acompanhar o progresso geral e uma maneira de os alunos se compararem com seus pares. Em bancos relacionais, temos várias ferramentas para manipular e agregar dados; em NoSQL, nem sempre. Embora alguns bancos NoSQL, como o MongoDB, ofereçam um framework de agregação, essas ferramentas tendem a perder eficiência em grande escala — e muitas vezes escolhemos NoSQL justamente para suportar grandes volumes de dados e tráfego.
No DynamoDB, atualizações atômicas são a capacidade de executar certas operações de update em um único atributo de um item garantindo atomicidade, consistência, isolamento e durabilidade (propriedades ACID). São operações que modificam o valor de um atributo de forma que garantem sucesso mesmo com atualizações concorrentes.
Com essa técnica, podemos adicionar XP facilmente quando o usuário conclui uma meta de aprendizado.
export const updateStudentXp = async ({
  id,
  xp,
}: {
  id: string;
  xp: number;
}) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "set xp = xp + :inc",
    ExpressionAttributeValues: {
      ":inc": valueToAttributeValue(xp),
    },
  });
};
Se o código parece familiar, é porque já usamos esse padrão na função deleteStudent!
Conclusão
Neste tutorial, exploramos os fundamentos do Amazon DynamoDB, um banco serverless e altamente escalável oferecido pela AWS. Os principais recursos do DynamoDB — escalabilidade contínua, alta disponibilidade e modelagem flexível — fazem dele uma excelente escolha para aplicações modernas.
Cobrimos tópicos essenciais como criação de tabelas, operações CRUD usando Node.js e discutimos a importância de atualizações atômicas para manter a consistência dos dados. Ao longo do tutorial, desenvolvemos um modelo de dados e implementamos funções para interagir com o DynamoDB.
À medida que você avança, vale mergulhar em temas como single table design, otimização de performance e DynamoDB Streams para processamento de dados em tempo real. A versatilidade e a escalabilidade do DynamoDB permitem construir aplicações serverless de alta performance dentro do ecossistema AWS.
Você encontra o código-fonte completo deste tutorial no GitHub. Bons códigos!
Materiais de aprendizado adicionais
- Tutorial DataCamp: Single table design com DynamoDB
- Curso DataCamp: Conceitos de NoSQL
- AWS re:Invent: padrões avançados de design para DynamoDB
- Rick Houlihan: fundamentos do single table design no DynamoDB
- Alex DeBrie: o livro do DynamoDB