Dans un monde guidé par les données, le besoin de bases de données à la fois scalables, performantes et hautement disponibles n’a jamais été aussi pressant. Amazon DynamoDB, un magasin de clés-valeurs à larges colonnes, totalement géré et serverless proposé par AWS (Amazon Web Services), répond à ces exigences. Que vous construisiez une application web, mobile ou tout système nécessitant un stockage flexible et fiable, DynamoDB est au rendez-vous.
Ce tutoriel a pour objectif de vous faire découvrir Amazon DynamoDB et de vous montrer comment l’utiliser efficacement dans des applications Node.js. Que vous débutiez avec les bases NoSQL ou que vous soyez un développeur expérimenté souhaitant élargir votre palette de compétences, ce guide vous présentera l’essentiel et des exemples concrets pour bien démarrer.
Qu’est-ce que DynamoDB ?
Amazon DynamoDB est une base de données serverless, clé-valeur et documentaire, offrant une mise à l’échelle transparente et une latence très faible. Contrairement aux bases relationnelles classiques, DynamoDB ne vous impose ni de provisionner du matériel ni de gérer l’infrastructure, ce qui en fait un excellent choix pour des applications qui doivent s’adapter dynamiquement à la charge.
Parmi ses fonctionnalités clés :
Mise à l’échelle
DynamoDB peut gérer des millions de requêtes par seconde, idéal pour des applications aux volumes de trafic très variables.
Haute disponibilité
Conçu pour une haute disponibilité et une durabilité des données, avec réplication intégrée sur plusieurs zones de disponibilité.
Service managé
AWS prend en charge l’exploitation : provisionnement du matériel, correctifs, sauvegardes ; vous pouvez ainsi vous concentrer sur votre application.
Modèle de données flexible
DynamoDB gère à la fois les modèles clé-valeur et document, vous laissant de la souplesse dans la structuration des données.
Sécurité
L’intégration à AWS Identity and Access Management (IAM) permet un contrôle d’accès fin et sécurisé à vos ressources de base de données, au niveau des éléments comme des attributs.
Maîtrise des coûts
L’architecture serverless de DynamoDB, associée à la mise à l’échelle automatique, vous aide à optimiser vos dépenses : vous ne payez que ce que vous consommez. Aucun coût matériel initial ni engagement long terme : un choix économique, tant pour les startups que pour les grandes entreprises.
Types de données
Types pris en charge dans DynamoDB :
- Types scalaires : chaînes de caractères, nombres, binaires, booléens et valeurs nulles.
- Types document : DynamoDB accepte des structures complexes avec des attributs imbriqués, idéal pour traiter des données JSON.
- Types ensemble (set) : ensembles de chaînes, de nombres et de binaires pour stocker efficacement des collections de valeurs liées.
Pourquoi utiliser DynamoDB avec Node.js ?
Node.js est un environnement d’exécution très populaire pour développer des applications côté serveur, dont des serveurs web et des API. Son architecture non bloquante et événementielle se marie bien avec l’API asynchrone de DynamoDB, ce qui en fait un choix naturel pour les développeurs Node.js.
Dans ce tutoriel, nous allons couvrir :
1. La création de tables et la définition d’un schéma dans DynamoDB.
2. Les opérations CRUD de base (Create, Read, Update, Delete) avec l’AWS SDK pour Node.js.
3. Des requêtes avancées avec conformité ACID.
Au terme de ce tutoriel, vous aurez une bonne compréhension d’Amazon DynamoDB et saurez l’exploiter efficacement dans vos applications Node.js. Allons-y !
Prérequis
Avant de commencer, vous aurez besoin d’un compte AWS. Nous pourrions tout faire sans compte AWS, mais pour un exemple plus réaliste, nous allons utiliser terraform pour créer notre infrastructure sur AWS. Pour en savoir plus sur l’utilisation locale des services AWS avec Docker, j’ai un exemple de démo localstack et un référentiel GitHub que vous pouvez consulter et expérimenter.
C’est aussi le moment d’installer terraform si ce n’est pas déjà fait.
La suite de ce tutoriel suppose que vous avez configuré l’AWS CLI avec vos identifiants et vos fichiers de configuration, et que terraform est installé.
Premiers pas
Pour ce tutoriel, nous allons utiliser TypeScript et yarn. Nous commencerons simplement avec ts-node, puis, dans le prochain tutoriel, nous passerons en serverless et irons plus loin avec AWS Lambda.
Pour préparer notre projet de démo, créez un nouveau dossier puis ajoutez les dépendances et la configuration suivantes en exécutant :
yarn init
yarn add --dev typescript ts-node @types/node @types/ramda @types/uuid
yarn add @aws-sdk/client-dynamodb ramda uuid
npx tsc --init
mkdir src src/domain infra
touch ./src/index.ts ./src/client.ts ./infra/main.tf ./src/domain/student.ts
Ajoutez ensuite la section scripts suivante dans package.json
  "scripts": {
    "dev": "ts-node src/index.ts"
  },
main.tf
provider "aws" {
  region = "eu-west-1"
}


resource "aws_dynamodb_table" "demo-table" {
  name = "demo-table"
  billing_mode = "PAY_PER_REQUEST"
  hash_key = "pk"
  range_key = "sk"


  attribute {
    name = "pk"
    type = "S"
  }


  attribute {
    name = "sk"
    type = "S"
  }
}
Depuis la ligne de commande, placez-vous dans le répertoire infra et exécutez terraform init && terraform apply -auto-approve, puis rendez-vous dans la console AWS pour visualiser votre table DynamoDB :
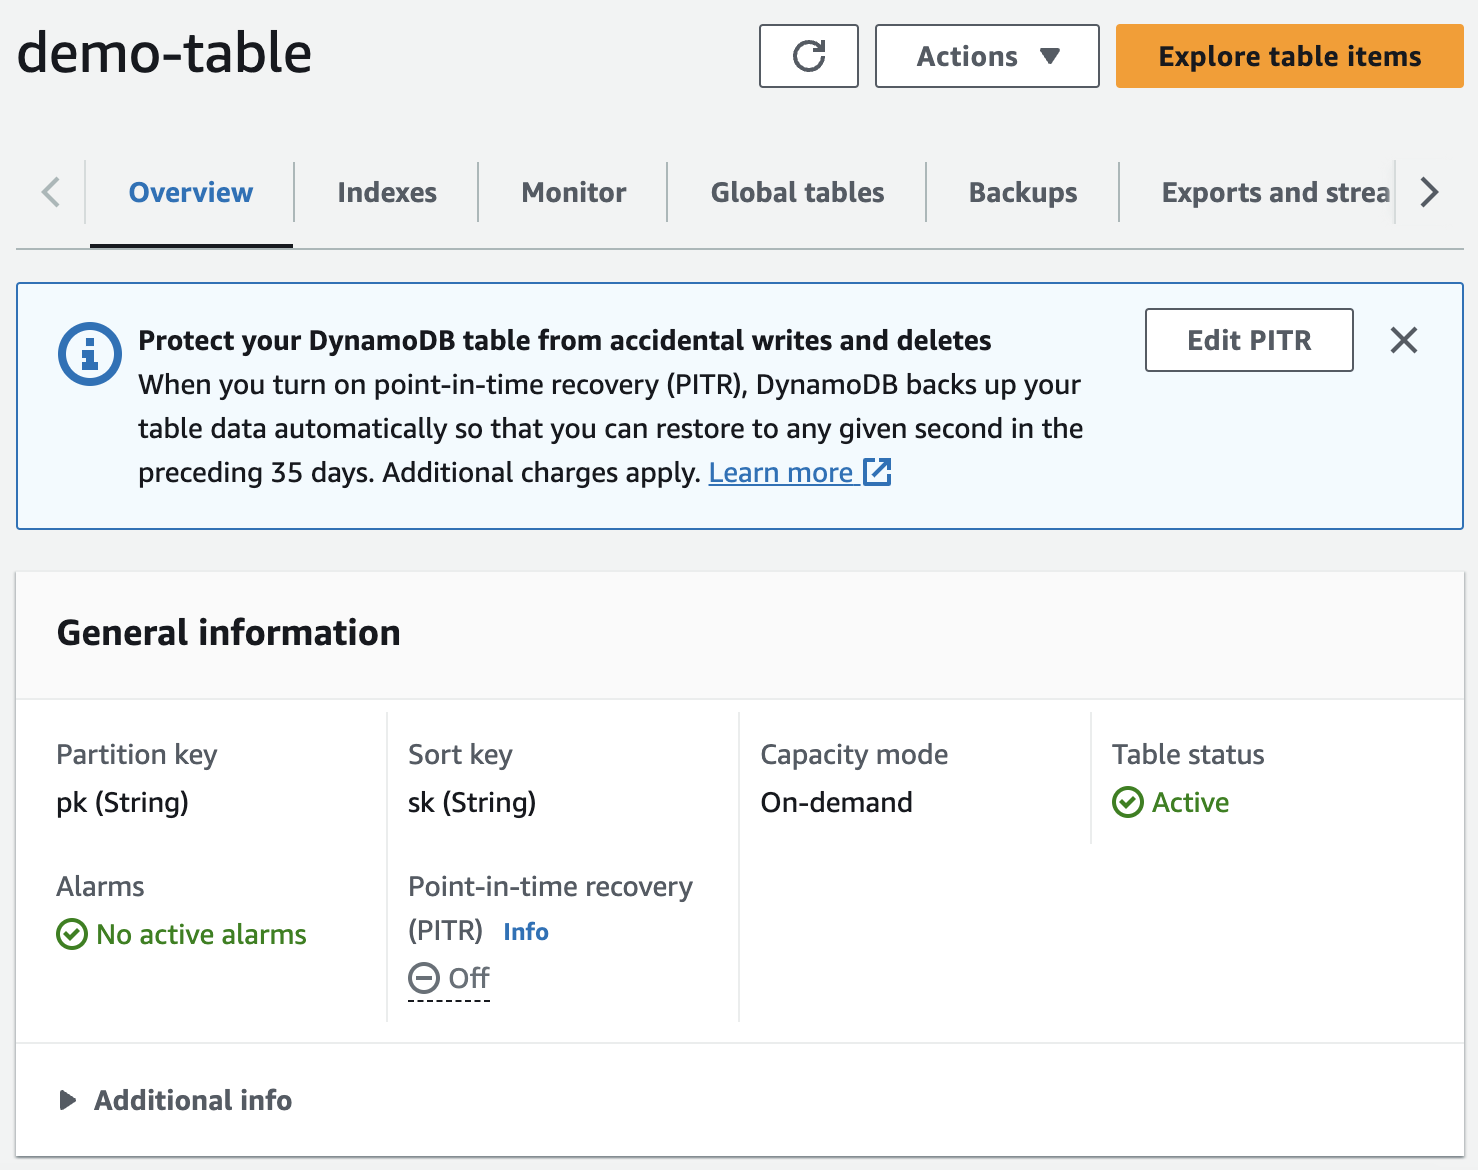
Je traiterai les modes de facturation DynamoDB, WCU et RCU dans un autre article
client.ts
import { DynamoDB } from "@aws-sdk/client-dynamodb";


export const TABLE_NAME = "demo-table";
export const REGION = "eu-west-1";
export const dynamoClient = new DynamoDB({ region: REGION });


export const STUDENT_PREFIX = "student#";
Modèle de données
Avant d’aller plus loin, définissons un modèle de données pour le cadre de ce tutoriel. Pour rester concret, j’ai choisi de modéliser quelque chose de proche des fonctionnalités cœur de DataCamp.
Ce tutoriel ne couvre pas toutes les entités. J’étofferai ce modèle dans de prochains articles.
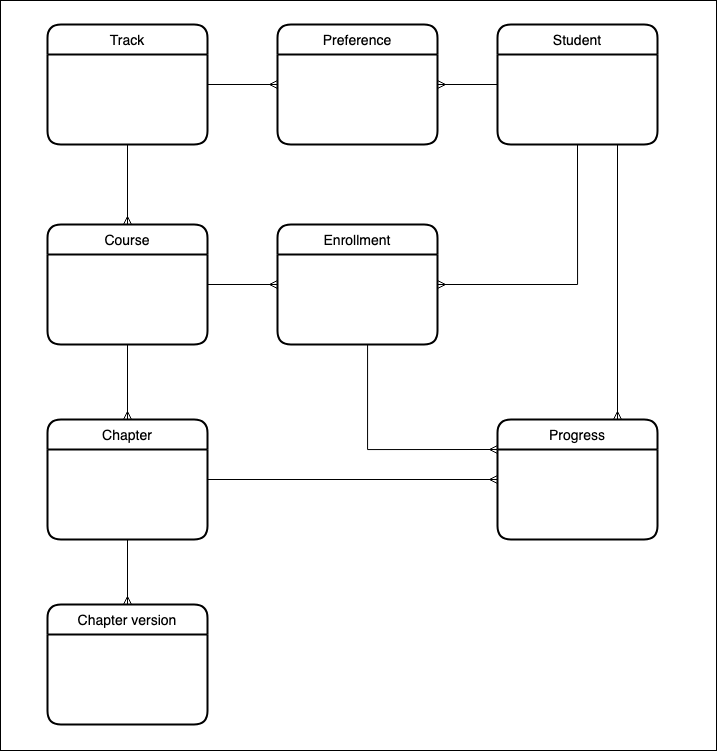
Opérations CRUD avec DynamoDB
Pour une compréhension complète de la conception et du modèle de données avec DynamoDB, consultez mon tutoriel sur la conception en table unique avec DynamoDB. Ici, je limiterai au minimum l’explication du fonctionnement interne de DynamoDB. L’idée à retenir : DynamoDB utilise des clés de partition et des clés de tri pour une gestion efficace des données.
Clés de partition
Les clés de partition servent à répartir les données sur plusieurs serveurs de stockage. Il est crucial de choisir une clé qui distribue les données de manière homogène pour éviter les « partitions chaudes » (répartition inégale), sources de problèmes de performance.
Des choix fréquents pour bien répartir les données reposent sur des attributs à forte cardinalité :
- ID uniques
- ID utilisateur
- valeurs de hachage
- régions géographiques
- clés basées sur le temps
- clés composites
Le choix de la clé de partition dépend fortement des modes d’accès de l’application et du modèle de données.
Clés de tri
Les clés de tri sont facultatives et permettent d’organiser les données au sein d’une partition. Utilisez-les pour des requêtes et tris efficaces à l’intérieur d’une partition.
Clés composites
Les clés composites combinent clé de partition et clé de tri. Elles permettent des schémas de requêtes riches (filtrage par plage, par temps, par attributs…). Optez pour ces clés si vos accès imposent des requêtes complexes.
Partitions chaudes
Pour réduire le risque de partitions chaudes, pensez au sharding (préfixes aléatoires sur les clés de partition), à la partition temporelle ou à une répartition uniforme des écritures. Surveillez et utilisez l’Auto Scaling AWS pour ajuster la capacité dynamiquement.
student.ts
Pour rester simple, nous utiliserons l’ID de l’étudiant comme clé de partition et clé de tri. Ce choix peut sembler étonnant, mais il nous laisse un schéma flexible, prêt à prendre en charge divers liens entre données et modes d’accès. Je détaillerai ce modèle dans de futurs articles DynamoDB.
import { head, omit, pathOr } from "ramda";
import { STUDENT_PREFIX, TABLE_NAME, dynamoClient as client } from "../client";
import { v4 as uuidv4 } from "uuid";
import {
  addPrefix,
  attributeMapToValues,
  attributeValueToValue,
  removePrefix,
  valueToAttributeValue,
} from "../utils";


const entityType = "student";


export const dynamoRecordToStudent = (record: any) => {
  const { pk, ...data } = record;


  return omit(["sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
  });
};


export const getStudentById = (id: string) =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
  })
  .then(({ Item }) => (Item ? dynamoRecordToStudent(Item) : undefined));


export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      email: valueToAttributeValue(_email),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
utils.ts
La dernière version du SDK DynamoDB d’AWS renforce la sécurité de typage des éléments stockés, au prix d’une manipulation un peu plus verbeuse. Pour nous faciliter la vie, créons quelques fonctions utilitaires. Leur intérêt deviendra évident quand nous verrons comment DynamoDB stocke les données en interne.
Créez un nouveau fichier à la racine du dossier src nommé utils.ts.
import { AttributeValue } from "@aws-sdk/client-dynamodb";


export const valueToAttributeValue = <T>(value: T): AttributeValue => {
  switch (typeof value) {
    case "string":
      return { S: value };
    case "number":
      return { N: `${value}` };
    case "boolean":
      return { BOOL: value };
    case "object":
      if (Array.isArray(value)) {
        return { L: value.map((item) => valueToAttributeValue(item)) };
      }
      return {
        M: Object.entries(value as any).reduce(
          (acc, [key, item]) => ({
            ...acc,
            [key]: valueToAttributeValue(item),
          }),
          {}
        ),
      };
    default:
      throw new Error(`Unknown type ${typeof value}`);
  }
};


export const attributeValueToValue = <T>(value: AttributeValue): T => {
  switch (true) {
    case !!value.S:
      return value.S as T;
    case !!value.N:
      return Number(value.N) as T;
    case !!value.BOOL:
      return value.BOOL as T;
    case !!value.L:
      return value.L?.map((item) =>
        attributeValueToValue(item)
      ) as unknown as T;
    case !!value.M:
      return Object.entries(value.M || []).reduce(
        (acc, [key, item]) => ({ ...acc, [key]: attributeValueToValue(item) }),
        {}
      ) as unknown as T;
    default:
      throw new Error(`Unknown type ${JSON.stringify(value)}`);
  }
};


export const attributeMapToValues = (
  items: Record<string, AttributeValue>
): unknown[] =>
  Object.keys(items).reduce(
    (acc, key) => ({
      ...acc,
      [key]: attributeValueToValue(items[key]),
    }),
    []
  );


export const removePrefix = (id: string, prefix: string): string =>
  id.replace(prefix, "");


export const addPrefix = (id: string, prefix: string): string =>
  `${prefix}${removePrefix(id, prefix)}`;
Créer un nouvel étudiant
Nous sommes enfin prêts à envoyer des appels d’API CRUD à DynamoDB !
Ouvrez le fichier index.ts, collez le code suivant puis, en ligne de commande, exécutez yarn dev.
import { getStudentById, saveStudent } from "./domain/student";


Promise.resolve()
  .then(async () => {
    const id = await saveStudent({
      firstName: "John",
      lastName: "Smith",
      email: "john@datacamp.com",
    });


    const john = await getStudentById(id);


    console.log(john);
  })
  .catch((err) => {
    console.error(err);
    process.exit(1);
  })
  .then(() => {
    console.log("done");
    process.exit(0);
  });
Vous devriez obtenir un résultat similaire :
{
  "entityType": "student",
  "id": "dd4c2ee4-9422-4957-ae6f-f9fff748e5ab",
  "firstName": "John",
  "lastName": "Smith",
  "email": "john@datacamp.com",
  "xp": 0
}
Utilisez maintenant la CLI pour scanner DynamoDB :
aws dynamodb scan --table-name demo-table --no-cli-pager
Vous pouvez voir dans la sortie comment DynamoDB stocke et typé les données en interne, où N désigne un nombre et S une chaîne. Cela devrait éclaircir les points soulevés par le code de utils.ts.
{
  "Items": [
    {
      "entityType": {
        "S": "student"
      },
      "lastName": {
        "S": "Smith"
      },
      "email": {
        "S": "john@datacamp.com"
      },
      "xp": {
        "N": "0"
      },
      "sk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "pk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "firstName": {
        "S": "John"
      }
    }
  ],
  "Count": 1,
  "ScannedCount": 1,
  "ConsumedCapacity": null
}
Retrouver un étudiant par adresse e-mail
Et si nous ne disposions que de l’adresse e-mail de l’étudiant pour retrouver son enregistrement ? Nous pouvons prendre en charge ce mode d’accès en ajoutant un index secondaire global.
Commencez par détruire la table initiale (nous éviterons cette étape pour les prochaines modifications terraform en ajoutant une fonction de troncature de table) :
terraform destroy
Ensuite, mettez à jour terraform en ajoutant le GSI suivant à notre demo-table :
attribute {
  name = "gsi1_pk"
  type = "S"
}


attribute {
  name = "gsi1_sk"
  type = "S"
}


global_secondary_index {
  name = "gsi1"
  hash_key = "gsi1_pk"
  range_key = "gsi1_sk"
  projection_type = "ALL"
}
Appliquez le changement :
terraform apply -auto-approve
Nous devons ensuite légèrement modifier la sauvegarde d’un étudiant :
export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      gsi1_pk: valueToAttributeValue(_email),
      gsi1_sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
Remarquez que nous ne stockons plus explicitement l’e-mail : nous l’utilisons comme valeur de PK du GSI.
Nous adaptons aussi la transformation des données DynamoDB pour les étudiants :
export const dynamoRecordToStudent = (record: any) => {
  const { pk, gsi1_pk, ...data } = record;


  return omit(["sk", "gsi1_sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
    email: attributeValueToValue<string>(gsi1_pk),
  });
};
Enfin, nous pouvons interroger le GSI gsi1 pour obtenir un étudiant par e-mail :
export const getStudentByEmail = (email: string) =>
  client
    .query({
      TableName: TABLE_NAME,
      IndexName: "gsi1",
      KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
      ExpressionAttributeNames: {
        "#gsi1_pk": "gsi1_pk",
      },
      ExpressionAttributeValues: {
        ":gsi1_pk": {
          S: email.toLocaleLowerCase(),
        },
      },
    })
    .then((res) => head(pathOr([], ["Items"], res).map(dynamoRecordToStudent)));
Mettre à jour un étudiant
Pour mettre à jour un étudiant, nous devons utiliser la méthode update et fournir la clé de partition et la clé de tri pour identifier l’élément de façon unique.
export const updateStudent = async ({
  id,
  firstName,
  lastName,
  email,
}: {
  id: string;
  firstName?: string;
  lastName?: string;
  email?: string;
}) => {
  const updateExpressionParts = [];
  const ExpressionAttributeValues: Record<string, any> = {};


  if (firstName !== undefined) {
    updateExpressionParts.push("#firstName = :firstName");
    ExpressionAttributeValues[":firstName"] = valueToAttributeValue(firstName);
  }


  if (lastName !== undefined) {
    updateExpressionParts.push("#lastName = :lastName");
    ExpressionAttributeValues[":lastName"] = valueToAttributeValue(lastName);
  }


  if (email !== undefined) {
    updateExpressionParts.push("#gsi1_pk = :gsi1_pk");
    ExpressionAttributeValues[":gsi1_pk"] = valueToAttributeValue(email);
  }


  const UpdateExpression = `SET ${updateExpressionParts.join(", ")}`;


  const ExpressionAttributeNames = {
    ...(firstName && { "#firstName": "firstName" }),
    ...(lastName && { "#lastName": "lastName" }),
    ...(email && { "#gsi1_pk": "gsi1_pk" }),
  };


  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression,
    ExpressionAttributeNames,
    ExpressionAttributeValues,
  });
};
Suppression de données
Commençons par rappeler qu’il n’est pas possible de tronquer une table DynamoDB nativement, hormis en supprimant puis recréant la table (comme nous l’avons fait pour ajouter un GSI). Je vais ajouter une méthode de troncature dans client.ts, mais je souligne que c’est uniquement pour les tests et à proscrire en production. En effet, pour savoir quoi supprimer, il faut scanner toute la table, et chaque opération DynamoDB a un coût. Si votre table contient un million d’éléments, il sera souvent plus économique de supprimer la table et de repartir de zéro (avec un processus de migration pour ne pas perdre de données de production). Voici la fonction de troncature :
type AttributeMap = Record<string, AttributeValue>;


const getItemKeyAndValue = (item: AttributeMap, key?: string) =>
  key ? { [`${key}`]: item[`${key}`] } : {};


export const truncateTable = async (
  client: DynamoDB,
  TableName: string,
  hash: string,
  range?: string
): Promise<void> => {
  const { Items } = await client.scan({ TableName });
  if (!Items) {
    return;
  }
  const keys = Items.map((item: AttributeMap) => ({
    ...getItemKeyAndValue(item, hash),
    ...getItemKeyAndValue(item, range),
  }));
  if (!keys.length) {
    return;
  }
  await Promise.all(keys?.map((Key) => client.deleteItem({ TableName, Key })));
};
Pour tronquer la demo-table :
await truncateTable(dynamoClient, TABLE_NAME, "pk", "sk");
Pour supprimer un étudiant précis, nous éviterons en règle générale la méthode deleteItem du SDK. Les bases NoSQL n’ont pas de notion d’intégrité référentielle : si d’autres éléments réfèrent un étudiant supprimé, cela pose problème, et DynamoDB supprimera sans vérification de clés étrangères (contrairement à une base relationnelle, qui refuserait l’opération).
Par sécurité, nous allons implémenter une suppression logique (soft delete) et adapter légèrement nos deux fonctions de lecture.
export const deleteStudent = async (id: string) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "SET #deleted = :deleted",
    ExpressionAttributeNames: {
      "#deleted": "deleted",
    },
    ExpressionAttributeValues: {
      ":deleted": valueToAttributeValue(true),
    },
  });
};
La requête getStudentByEmail doit maintenant exclure les enregistrements supprimés. Important : ce « filtrage » se fait côté client, pas dans la base. La requête coûtera donc autant, même pour des éléments supprimés.
{
  TableName: TABLE_NAME,
  IndexName: "gsi1",
  KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
  ExpressionAttributeNames: {
    "#gsi1_pk": "gsi1_pk",
  },
  ExpressionAttributeValues: {
    ":gsi1_pk": {
      S: email.toLocaleLowerCase(),
    },
    ":notDeleted": {
      BOOL: false,
    },
  },
  FilterExpression:
    "attribute_not_exists(deleted) OR deleted = :notDeleted",
 }
La fonction getStudentById utilise getItem, nous ne pouvons donc pas appliquer de filtre ; nous gérons la logique explicitement :
export const getStudentById = (id: string): Promise<Student | null> =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
        pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
        sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      },
    })
    .then(({ Item }) => {
      if (!Item) {
        return null;
      }
      const _item = dynamoRecordToStudent(Item);
      return _item.deleted ? null : _item;
    });
Mises à jour atomiques et conformité ACID
DataCamp collecte les points d’expérience (XP) de chaque étudiant : c’est motivant, valorisant, facile pour suivre la progression et se situer par rapport à ses pairs. En base relationnelle, divers outils permettent de manipuler et d’agréger les données ; ce n’est pas toujours le cas en NoSQL. Certaines bases NoSQL comme MongoDB offrent un framework d’agrégation, mais ces outils montrent leurs limites à très grande échelle — l’une des raisons d’opter pour le NoSQL étant justement de supporter des volumes massifs.
Dans DynamoDB, les mises à jour atomiques permettent de modifier un attribut unique d’un élément en garantissant l’atomicité, la cohérence, l’isolation et la durabilité (propriétés ACID), même en présence de mises à jour concurrentes.
Avec cette technique, nous pouvons facilement ajouter des XP quand un utilisateur atteint un objectif d’apprentissage.
export const updateStudentXp = async ({
  id,
  xp,
}: {
  id: string;
  xp: number;
}) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "set xp = xp + :inc",
    ExpressionAttributeValues: {
      ":inc": valueToAttributeValue(xp),
    },
  });
};
Si ce code vous semble familier, c’est normal : nous avons déjà utilisé ce motif dans la fonction deleteStudent !
Conclusion
Dans ce tutoriel, nous avons exploré les fondamentaux d’Amazon DynamoDB, une base de données serverless hautement scalable proposée par AWS. Ses points forts — mise à l’échelle transparente, haute disponibilité, modélisation flexible — en font un excellent choix pour les applications modernes.
Nous avons couvert des thèmes essentiels : création de tables, opérations CRUD en Node.js, et importance des mises à jour atomiques pour maintenir la cohérence des données. Tout au long du tutoriel, nous avons conçu un modèle de données et implémenté des fonctions pour interagir avec DynamoDB.
Pour aller plus loin, explorez des sujets avancés : conception en table unique, optimisation des performances, ou DynamoDB Streams pour le temps réel. La souplesse et l’évolutivité de DynamoDB vous permettent de créer des applications serverless performantes dans l’écosystème AWS.
Vous trouverez le code source complet de ce tutoriel sur GitHub. Bon développement !
Ressources pour aller plus loin
- Tutoriel DataCamp : Conception en table unique avec DynamoDB
- Cours DataCamp : Concepts NoSQL
- AWS re:Invent : Advanced Design Patterns for DynamoDB
- Rick Houlihan : Fundamentals of DynamoDB Single Table Design
- Alex DeBrie : le DynamoDB book