Curso
Manipulação de dados em SQL
4 h
335K
Os Jupyter Notebooks são parte essencial de qualquer fluxo de trabalho em Data Science — a ponto de empresas como a Netflix os considerarem indispensáveis. O ambiente de computação no navegador, somado a um formato de documento reproduzível, fez deles a escolha padrão de milhões de cientistas de dados e pesquisadores no mundo todo. O Jupyter tem uma grande comunidade internacional, com gente de praticamente todos os países. A própria comunidade desenvolveu vários kernels.
O Jupyter Lab é a interface de próxima geração do Project Jupyter e oferece todos os blocos familiares do clássico Jupyter Notebook — como notebook, terminal, editor de texto, explorador de arquivos, saídas ricas etc. Mas, diferente dos notebooks clássicos, todos esses recursos vêm em uma interface flexível e poderosa. A ideia do Jupyter Lab é reunir, em um só lugar, todos os blocos do notebook clássico e ainda trazer novidades.

O JupyterLab exibindo sua área de trabalho com notebooks, arquivos de texto, terminais e saídas de notebook, todos capazes de interagir entre si.
Vamos primeiro instalar e executar o Jupyter Lab no seu sistema.
O JupyterLab pode ser instalado via conda, pip ou pipenv.
conda install -c conda-forge jupyterlab
or
pip install jupyterlab
or
pipenv install jupyterlab
pipenv shell
Confira a documentação oficial de instalação para mais detalhes.
Você pode iniciar o Jupyter digitando o seguinte no console:
jupyter lab
O JupyterLab vai abrir automaticamente no navegador com uma interface parecida com a abaixo. Isso significa que está tudo pronto para começar.

A área de trabalho principal é onde a mágica acontece. Ela reúne notebooks, documentos, consoles, terminais etc. Basta dar um duplo clique ou arrastar um arquivo para essa área para começar a trabalhar.
Na maioria das vezes, os dados com que trabalhamos ficam em bancos de dados, e uma tarefa essencial de quem trabalha com dados é conseguir acessá-los e analisá-los. Por isso, ter uma interface fluida entre bancos SQL e o Jupyter Notebook/Lab facilita muito o acesso e a manipulação dos dados, tornando o processo mais simples e eficiente. Essa interface pode ser implementada de duas formas:
Os comandos magic são um conjunto de funções práticas no Jupyter Notebook, pensadas para resolver problemas comuns em análises de dados. Você pode ver todas as magics disponíveis com %lsmagic.
A extensão IPython SQL magic permite escrever consultas SQL diretamente nas células de código e ler os resultados em DataFrames do pandas (Fonte). Isso funciona tanto nos notebooks tradicionais quanto no Jupyter Lab.
Instalando o módulo SQL no notebook
!pip install ipython-sql
Carregando o módulo SQL
%load_ext sql
O comando magic acima carrega a extensão ipython-sql. Podemos nos conectar a qualquer banco de dados compatível com o SQLAlchemy. Aqui, vamos conectar a um banco SQLite. Digite o seguinte na célula de código:
%sql sqlite://
Se a saída for ‘Connected: @None', a conexão foi estabelecida.
Vamos criar uma tabela de demonstração chamada EMPLOYEE para mostrar o funcionamento.
%%sql
CREATE TABLE EMPLOYEE(firstname varchar(50),lastname varchar(50));
INSERT INTO EMPLOYEE VALUES('Tom','Mitchell');
INSERT INTO EMPLOYEE VALUES('Jack','Ryan');
Agora já podemos executar consultas no banco.
 %sql SELECT * from EMPLOYEE;
 ----------------------------------
 * sqlite://
 Done.
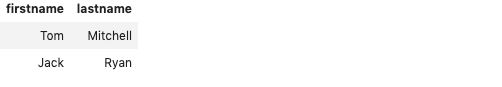
A consulta acima produz a seguinte tabela.
Também podemos conectar a um banco já existente usando a magic. Neste tutorial, vamos usar o banco SQL_SAFI (Studying African Farmer-led Irrigation (SAFI) database). "O Projeto SAFI é uma pesquisa sobre práticas de cultivo e irrigação usadas por agricultores na Tanzânia e em Moçambique. Este dataset é composto por dados de pesquisas domiciliares e agrícolas" (Fonte). Você pode baixá-lo aqui.
 #Specifying the path of the database
 %sql sqlite:////Users/Parul/Desktop/SQL_SAFI.sqlite
 -----------------------------------------------------------

 'Connected: @/Users/Parul/Desktop/SQL_SAFI.sqlite'
O comando acima abriu o banco chamado SQL_SAFI.sqlite, que está no caminho Users/Parul/Desktop. Vamos selecionar a tabela Crops e exibir seu conteúdo.
%sql select * from Crops
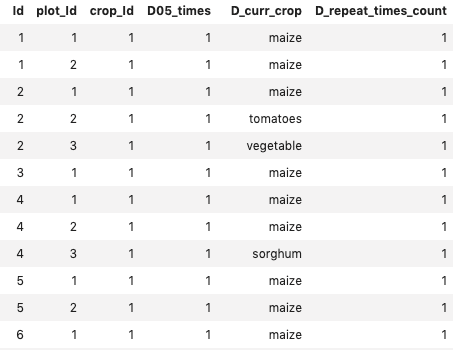
Exibindo as primeiras linhas da tabela Crops
%sql select * from Crops where D_curr_crop = "maize" AND ID <= 3;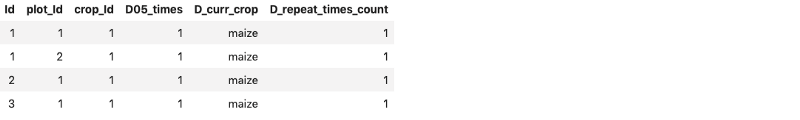
O resultado também pode ser convertido em um dataframe do pandas, assim:
result = %sql select * from Crops where D_curr_crop = "maize" AND ID <= 3;
dataframe = result.DataFrame()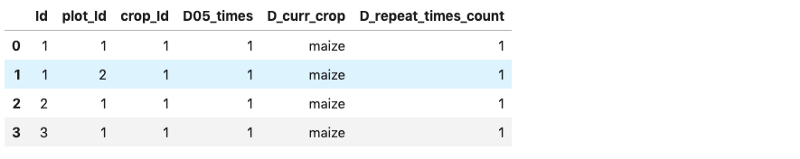
dataframe.info()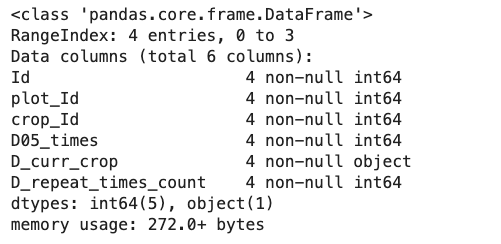
Antes de seguir, vamos falar rapidamente sobre extensões do Jupyter.
Extensões do JupyterLab
As extensões são um dos recursos mais úteis do Jupyter Lab e elevam bastante a experiência de uso. O próprio Jupyter Lab é um ambiente extensível — notebook, terminal e editor existem como extensões.
"As extensões do JupyterLab são pacotes npm (o formato padrão de pacotes no desenvolvimento em JavaScript)" (Fonte). Elas permitem personalizar e melhorar o JupyterLab, oferecendo temas, visualizadores, atalhos de teclado, opções avançadas de configuração e muito mais. Há muitas extensões criadas pela comunidade no GitHub. Procure pelo tópico jupyterlab-extension para encontrá-las.
Para instalar extensões do JupyterLab, você precisa ter o Node.js instalado — dá para baixar pelo site ou assim:
conda install -c conda-forge nodejs
or
brew install node #for MacOS users
A jupyterlab-sql é uma dessas extensões úteis que adiciona uma interface SQL ao Jupyter Lab. Isso traz duas vantagens principais:
Você encontra mais detalhes no repositório no GitHub.
Para instalar o jupyterlab-sql, execute os comandos abaixo nesta ordem:
pip install jupyterlab_sql
jupyter serverextension enable jupyterlab_sql --py --sys-prefix
jupyter lab build
Depois, reinicie qualquer servidor Jupyter que esteja em execução.
Importante: o jupyterlab-sql funciona apenas com Python 3.5 ou superior.
Após reiniciar o Jupyter Lab, um novo ícone de SQL aparece no launcher.
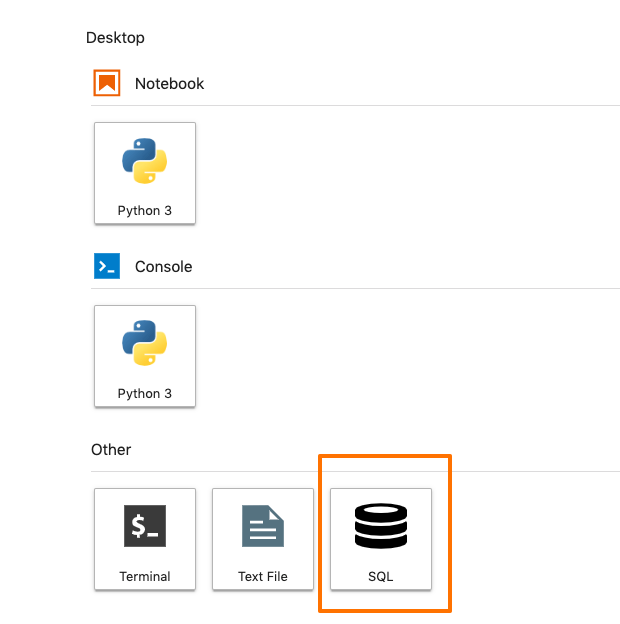
Isso indica que deu tudo certo e você já pode conectar sua instância a um banco de dados.
Para se conectar ao banco, você precisa de uma URL válida. O jupyterlab-sql foi amplamente testado com SQLite, PostgreSQL e MySQL (Fonte). Siga o guia do SQLAlchemy sobre URLs. A URL deve ser de banco de dados, por exemplo:
postgres://localhost:5432/postgres
postgres://username:password@localhost:5432/postgres
mysql://localhost/employees
sqlite://
sqlite:///myfile.db
Vamos nos conectar ao banco SQL_SAFI que usamos antes. Clique no ícone de SQL no launcher e informe a URL do banco. Pressione enter para conectar.
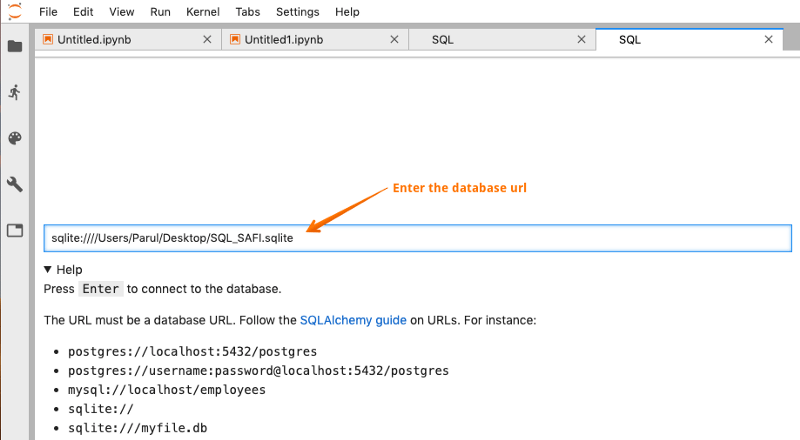
Assim que a conexão for estabelecida, você verá todas as tabelas do banco.
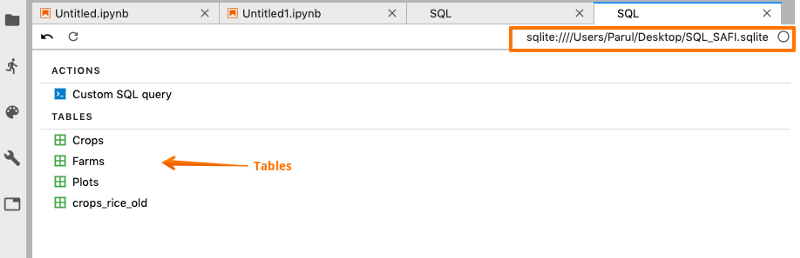
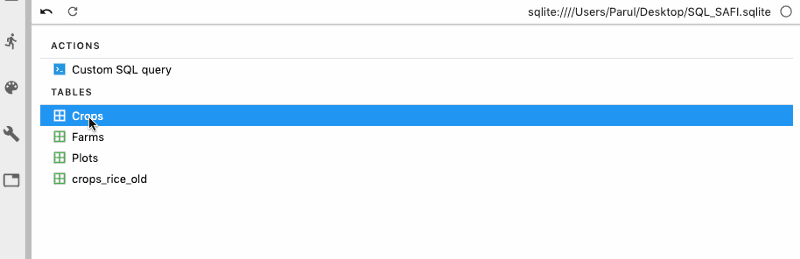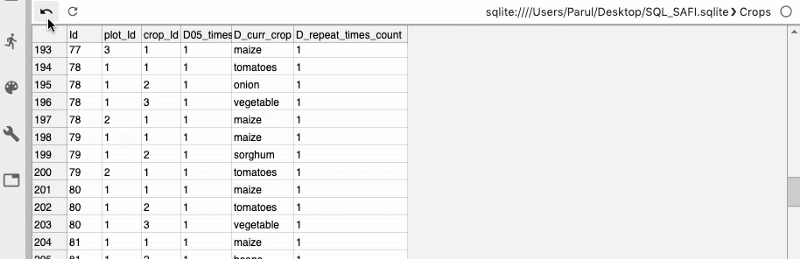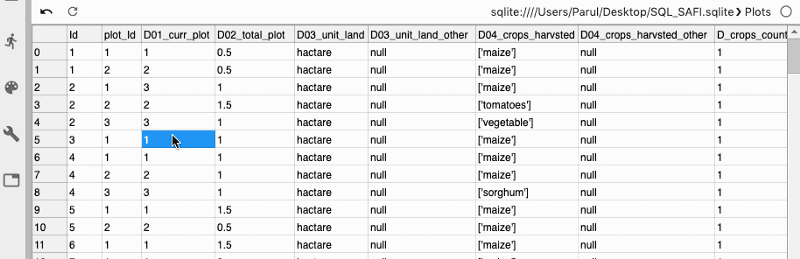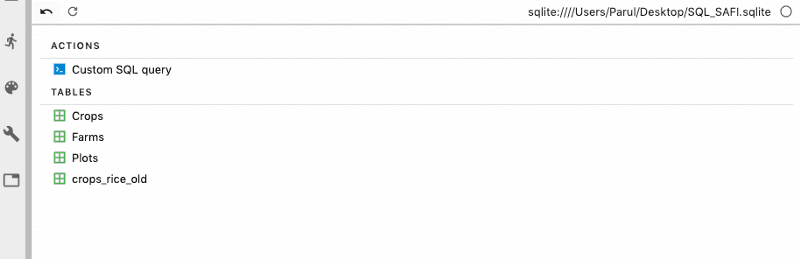
Em seguida, também podemos escrever consultas SQL personalizadas para obter os dados desejados das tabelas.
Usar SQL e JupyterLab juntos leva sua análise de dados a outro nível. A interface jupyter-sql facilita conectar servidores SQL ao ecossistema do Jupyter e extrair dados diretamente para lá, sem sair da interface.
Se quiser se aprofundar em SQL, faça o curso Data-Driven Decision Making in SQL da DataCamp.
Veja também nosso tutorial Remote Python and R in SQL.
Cursos relacionados
Curso
Curso
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
13 min
Tutorial
DataCamp Team
3 min
Tutorial
DataCamp Team
3 min
Tutorial
Javier Canales Luna
7 min
Tutorial
Elena Kosourova
8 min