Curso
Introdução à Ciência de Dados em Python
4 h
502.2K
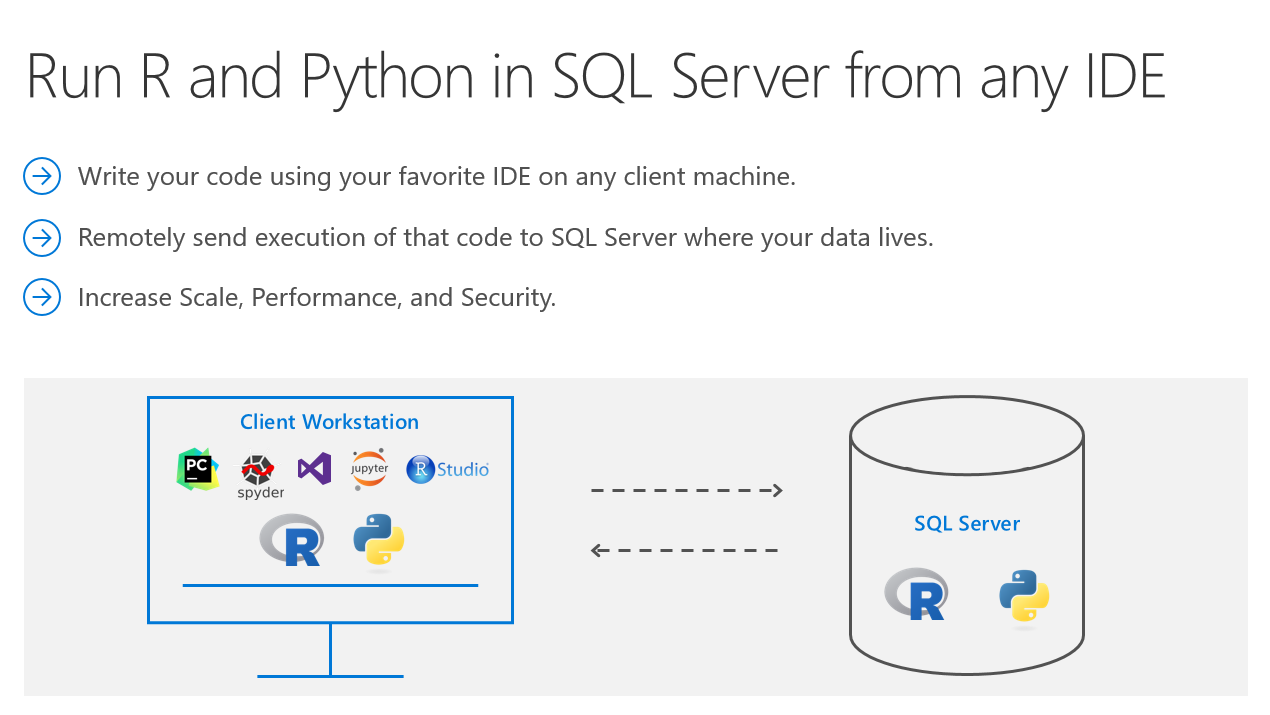
Você sabia que dá para executar código R e Python remotamente no SQL Server a partir do Jupyter Notebooks ou de qualquer IDE? O recurso Machine Learning Services no SQL Server elimina a necessidade de mover dados. Em vez de transferir dados grandes e sensíveis pela rede ou perder precisão ao treinar modelos com arquivos CSV de amostra, você pode executar seu código R/Python dentro do próprio banco de dados. Trabalhe no Jupyter Notebooks, RStudio, PyCharm, VSCode, Visual Studio, onde preferir, e envie a execução das funções para o SQL Server — levando inteligência para onde seus dados vivem.
Este tutorial mostra um exemplo de como enviar seu código Python do Jupyter Notebooks para ser executado dentro do SQL Server. Os mesmos princípios valem para R e para qualquer outra IDE. Se preferir aprender por vídeo, este tutorial também está no YouTube:
Para que R ou Python sejam executados dentro do SQL, primeiro é preciso instalar e configurar o recurso Machine Learning Services. Veja este guia passo a passo.
Para enviar a execução de Python ao SQL a partir do Jupyter Notebooks, você precisa usar o pacote RevoscalePy da Microsoft. Para obtê-lo, baixe e instale o Microsoft ML Services Python Client. Página de documentação ou link direto para download (para Windows).
Depois do download, abra o PowerShell como administrador e navegue até a pasta do arquivo. Inicie a instalação com este comando (sinta-se à vontade para personalizar a pasta): .\Install-PyForMLS.ps1 -InstallFolder "C:\Program Files\MicrosoftPythonClient"
Tenha um pouco de paciência: a instalação pode levar alguns minutos. Quando terminar, navegue até o novo caminho instalado. Vamos criar uma pasta vazia e abrir o Jupyter Notebooks: mkdir JupyterNotebooks; cd JupyterNotebooks; ..\Scripts\jupyter-notebook
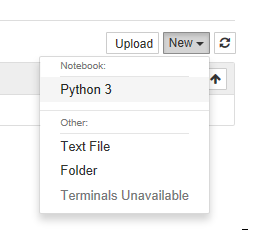
Crie um novo notebook com o interpretador Python 3:
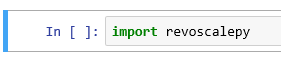
Para testar se está tudo certo, importe o revoscalepy na primeira célula e execute. Se não aparecer nenhuma mensagem de erro, pode seguir em frente.
No restante do tutorial, você pode clonar este Jupyter Notebook no Github se não quiser copiar e colar todo o código. Esta configuração do banco é um passo único para garantir que você tenha os mesmos dados deste tutorial. Você não precisa fazer nada disso para usar seus próprios dados.
Ajuste a string de conexão do seu servidor e use pyodbc para criar um novo banco.
 import pyodbc

# creating a new db to load Iris sample in
new_db_name = "MLRemoteExec"
connection_string = "Driver=SQL Server;Server=localhost\MSSQLSERVER2017;Database={0};Trusted_Connection=Yes;"
cnxn = pyodbc.connect(connection_string.format("master"), autocommit=True)
cnxn.cursor().execute("IF EXISTS(SELECT * FROM sys.databases WHERE [name] = '{0}') DROP DATABASE {0}".format(new_db_name))
cnxn.cursor().execute("CREATE DATABASE " + new_db_name)
cnxn.close()

print("Database created")Iris é um conjunto de dados clássico em tutoriais de ciência de dados para iniciantes. Ele vem por padrão no pacote sklearn.
from sklearn import datasets
import pandas as pd

# SkLearn has the Iris sample dataset built into the package
iris = datasets.load_iris()
df = pd.DataFrame(iris.data, columns=iris.feature_names)(Você também pode fazer isso com pyodbc, sqlalchemy ou outros pacotes)
 from revoscalepy import RxSqlServerData, rx_data_step

# Example of using RX APIs to load data into SQL table. You can also do this with pyodbc
table_ref = RxSqlServerData(connection_string=connection_string.format(new_db_name), table="Iris")
rx_data_step(input_data = df, output_file = table_ref, overwrite = True)

print("New Table Created: Iris")
print("Sklearn Iris sample loaded into Iris table")Escreva qualquer código Python que você queira executar no SQL. Neste exemplo, vamos criar uma scatter matrix com o conjunto Iris e retornar apenas o bytestream do .png para o Jupyter Notebooks renderizar no cliente.
def send_this_func_to_sql():from revoscalepy import RxSqlServerData, rx_import
    from pandas.tools.plotting import scatter_matrix
    import matplotlib.pyplot as plt
    import io

    # remember the scope of the variables in this func are within our SQL Server Python Runtime
    connection_string = "Driver=SQL Server;Server=localhost\MSSQLSERVER2017;Database=MLRemoteExec;Trusted_Connection=Yes;"# specify a query and load into pandas dataframe df
    sql_query = RxSqlServerData(connection_string=connection_string, sql_query = "select * from Iris")
    df = rx_import(sql_query)

    scatter_matrix(df)

    # return bytestream of image created by scatter_matrix
    buf = io.BytesIO()
    plt.savefig(buf, format="png")
    buf.seek(0)

return buf.getvalue()Agora que está tudo configurado, veja como é simples enviar a execução remota! Primeiro, import revoscalepy. Crie um sql_compute_context e envie a execução de qualquer função para o SQL Server com RxExec. Nenhum dado bruto precisou ser transferido do SQL para o Jupyter Notebook. Todo o processamento aconteceu dentro do banco, e só o arquivo de imagem voltou para ser exibido.
from IPython import display
import matplotlib.pyplot as plt
from revoscalepy import RxInSqlServer, rx_exec

# create a remote compute context with connection to SQL Server
sql_compute_context = RxInSqlServer(connection_string=connection_string.format(new_db_name))

# use rx_exec to send the function execution to SQL Server
image = rx_exec(send_this_func_to_sql, compute_context=sql_compute_context)[0]

# only an image was returned to my jupyter client. All data remained secure and was manipulated in my db.
display.Image(data=image)
Embora este exemplo com o Iris seja simples, imagine o ganho de escala, desempenho e segurança que você acabou de destravar. Você pode usar os pacotes open source mais atuais de R/Python para criar aplicações de Deep Learning e IA com grandes volumes de dados no SQL Server. Também oferecemos algoritmos de última geração, de alta performance, nas APIs RevoScaleR e RevoScalePy da Microsoft. Usar isso junto com as inovações do mundo open source permite levar variedade, performance e escala sem precedentes para suas aplicações.
Dê uma olhada no tutorial da DataCamp sobre como executar Python/R no SQL.
Confira a documentação do SQL Machine Learning Services para aprender a implantar seu código R/Python com stored procedures do SQL, tornando-o acessível nos seus processos de ETL ou por qualquer aplicação. Treine e armazene modelos de machine learning no seu banco de dados, levando inteligência para onde seus dados vivem.
Execução básica de R e Python no SQL Server: https://aka.ms/BasicMLServicesExecution
Configure o Machine Learning Services no SQL Server: https://aka.ms/SetupMLServices
Soluções de tutoriais ponta a ponta no Github: https://microsoft.github.io/sql-ml-tutorials/
Outros tutoriais no YouTube:
Se quiser se aprofundar, conheça os cursos introdutórios da DataCamp.
Saiba mais sobre Python, R e SQL
Curso
Curso
Curso
blog
Karlijn Willems
15 min
blog
Matt Crabtree
9 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Joleen Bothma
9 min
Tutorial
Javier Canales Luna
14 min