Stable Diffusion Web UI (SDUI) é uma interface no navegador, simples de usar, para o poderoso modelo de IA generativa conhecido como Stable Diffusion. Esse é um modelo avançado de IA capaz de gerar imagens a partir de descrições em texto ou modificar imagens existentes com base em prompts textuais. A interface desenvolvida por AUTOMATIC1111 oferece uma plataforma prática para você interagir com os modelos Stable Diffusion sem precisar de habilidades técnicas ou de programação avançadas.
Você pode usar a Web UI localmente em um notebook ou PC, com suporte a CPU e GPU. Além disso, dá para implantar seu próprio modelo em um servidor, permitindo que outras pessoas explorem e façam testes. Ela é compatível com praticamente todos os sistemas operacionais e GPUs, incluindo Nvidia, AMD e Intel. Essa ferramenta revolucionária mudou a forma como artistas criam arte de alta qualidade em seus computadores pessoais, possibilitando uma criatividade com IA privada e acessível.
Neste tutorial, vamos aprender a baixar e configurar o SDUI em um notebook com Windows 11 e GPU Nvidia. Depois que tudo estiver pronto, vamos explorar os recursos da Web UI, incluindo extensões e modelos personalizados de stable diffusion. Este guia é indicado para pessoas de todos os perfis, inclusive quem não é técnico ou adolescentes.
Baixe e instale o CUDA para GPUs Nvidia
Você pode usar o Stable Diffusion Web UI sem GPU ou sem instalar o CUDA. A Web UI consegue rodar na CPU e gerar resultados rapidamente. Porém, para obter resultados muito mais rápidos, é altamente recomendado usar aceleração por GPU sempre que possível.
Este guia foca apenas em usuários de GPU Nvidia com Windows como sistema operacional.
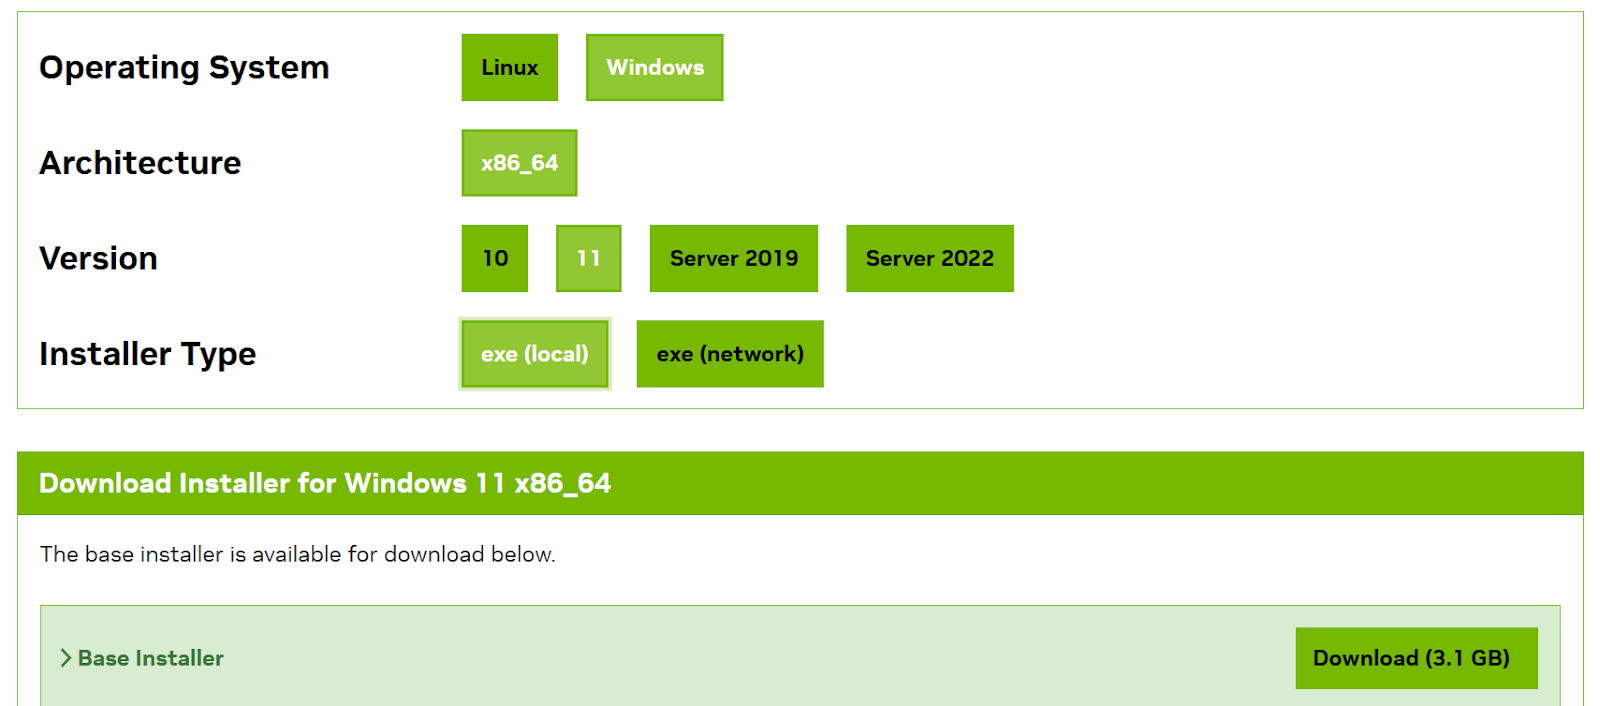
Primeiro, baixe e instale a versão mais recente do CUDA Toolkit 12.3. Selecione as opções corretas de acordo com seu sistema e baixe o instalador Base.
Em seguida, instale a versão mais recente do cuDNN. Você pode baixar o arquivo zip em Nvidia cuDNN. Certifique-se de que a versão corresponde à do CUDA Toolkit.
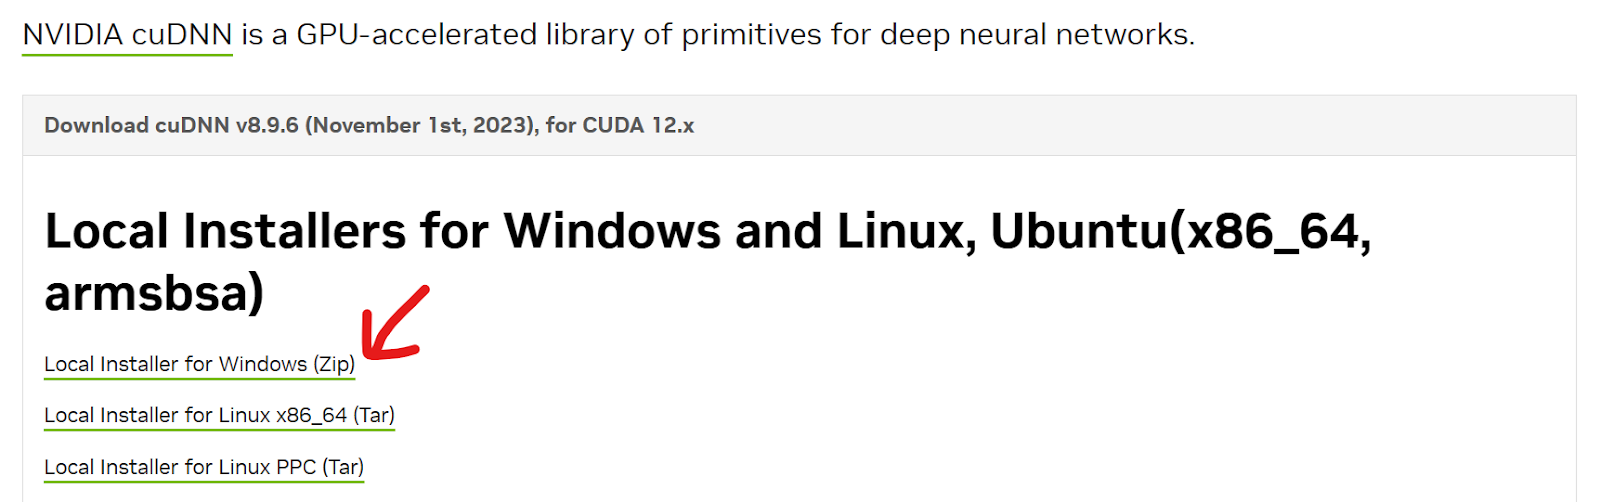
Extraia todas as pastas do arquivo zip, abra e mova o conteúdo para a pasta do CUDA Toolkit. No nosso caso, o diretório é C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA\v12.3; no seu computador pode ser diferente. Se aparecer um aviso sobre arquivos duplicados, selecione "Replace All".
Observação: garanta sempre que os drivers Nvidia estejam atualizados no seu computador para obter o melhor desempenho.
Baixe e instale o Stable Diffusion Web UI
Nesta seção, vamos aprender a forma mais fácil e automatizada de instalar o SDUI. Vamos instalar usando uma distribuição binária, ideal para quem não pode instalar Python e Git.
- Baixe o arquivo
sd.Web UI.zipem Release v1.0.0-pre. Embora seja uma versão mais antiga, ela será atualizada automaticamente para a versão mais recente durante a instalação. - Extraia o conteúdo do zip no local de sua preferência. Por exemplo, você pode extrair em
C:\Desktop\Web UI. - Para atualizar o Stable Diffusion Web UI, basta dar um duplo clique no arquivo
update.bat. - Depois disso, dê um duplo clique no arquivo
run.batpara iniciar a Web UI. Na primeira vez, pode levar quase uma hora para baixar os arquivos necessários e o modelo. - Quando todos os pacotes Python e o modelo do Stable Diffusion forem baixados e instalados, você será redirecionado ao navegador com a URL local "http://127.0.0.1:7860". Se o link não abrir automaticamente, é só clicar no link exibido no terminal.
Observação: o repositório do Stable Diffusion Web UI traz instruções de instalação para outros sistemas operacionais.
Guia da aba txt2img
No seu navegador padrão, você verá a interface com várias opções. Vamos testar cada uma para gerar imagens de alta qualidade.
Primeiro, vamos clicar na aba txt2img e digitar prompts positivos e negativos para gerar a imagem de uma garota em uma floresta escura vestindo roupas de Natal. Palavras-chave adicionais ajudam a melhorar a qualidade e o estilo da imagem.
Vamos começar com um prompt negativo enxuto e ir adicionando mais termos para eliminar deformidades recorrentes na imagem.
Prompt positivo: “masterpiece, best quality, ultra high res, visually stunning, a beautiful, 1girl, dark forest, style illustration, sorceress, dark theme, wearing Christmas clothes, close up, looking at camera”
Prompt negativo: “bad quality, bad anatomy, worst quality, low quality, low resolution, extra fingers, blur, blurry, ugly, wrong proportions, watermark, image artifacts, lowres, ugly, jpeg artifacts, deformed, noisy image, 2girls, double images,”
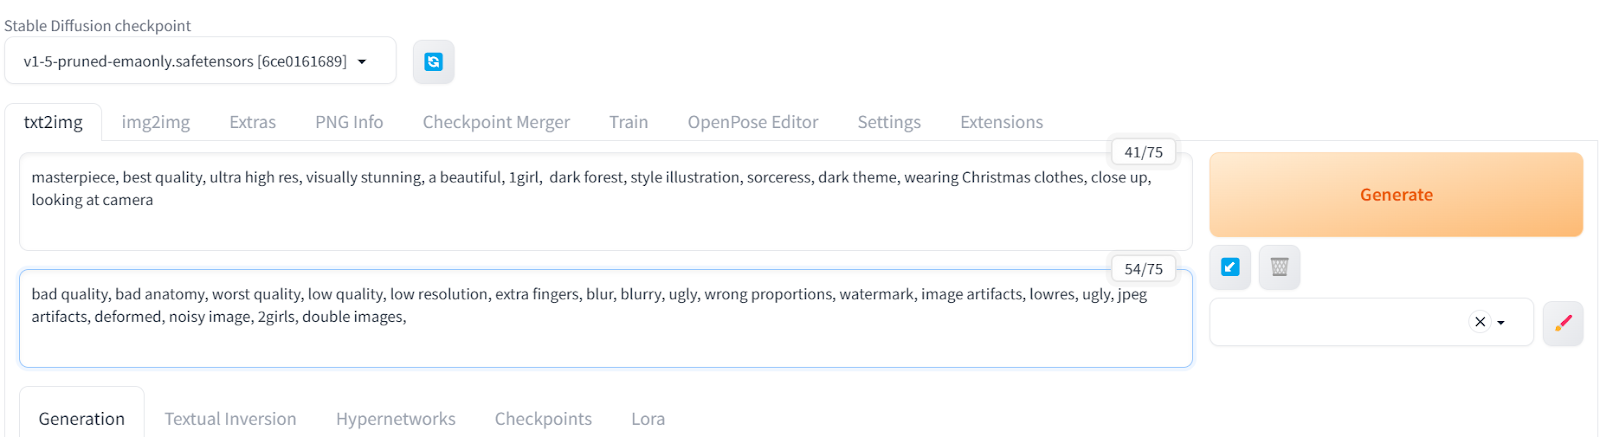
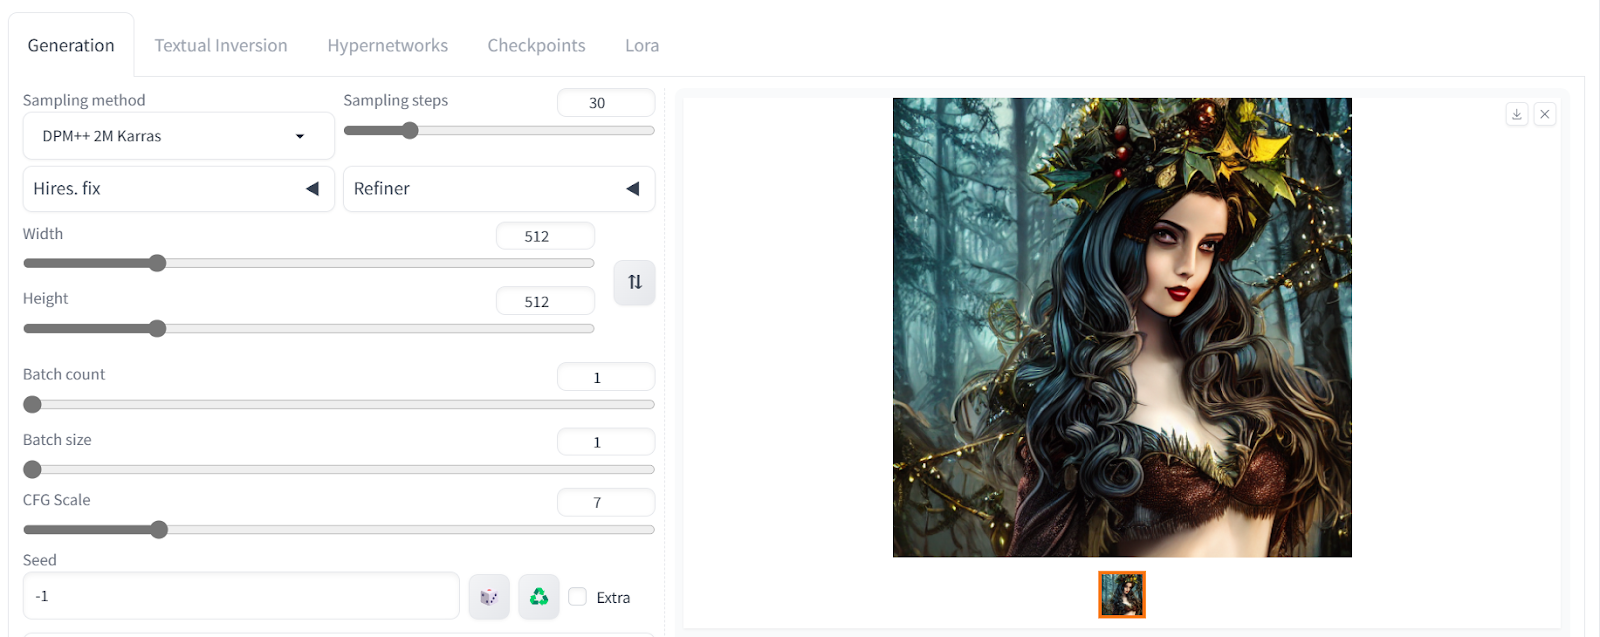
A arte que geramos mostra uma mulher em um cenário natalino sombrio, com qualidade excelente.
Vamos ajustar as configurações avançadas. Podemos mudar o tamanho da imagem e aumentar os passos de amostragem para adicionar mais detalhes.
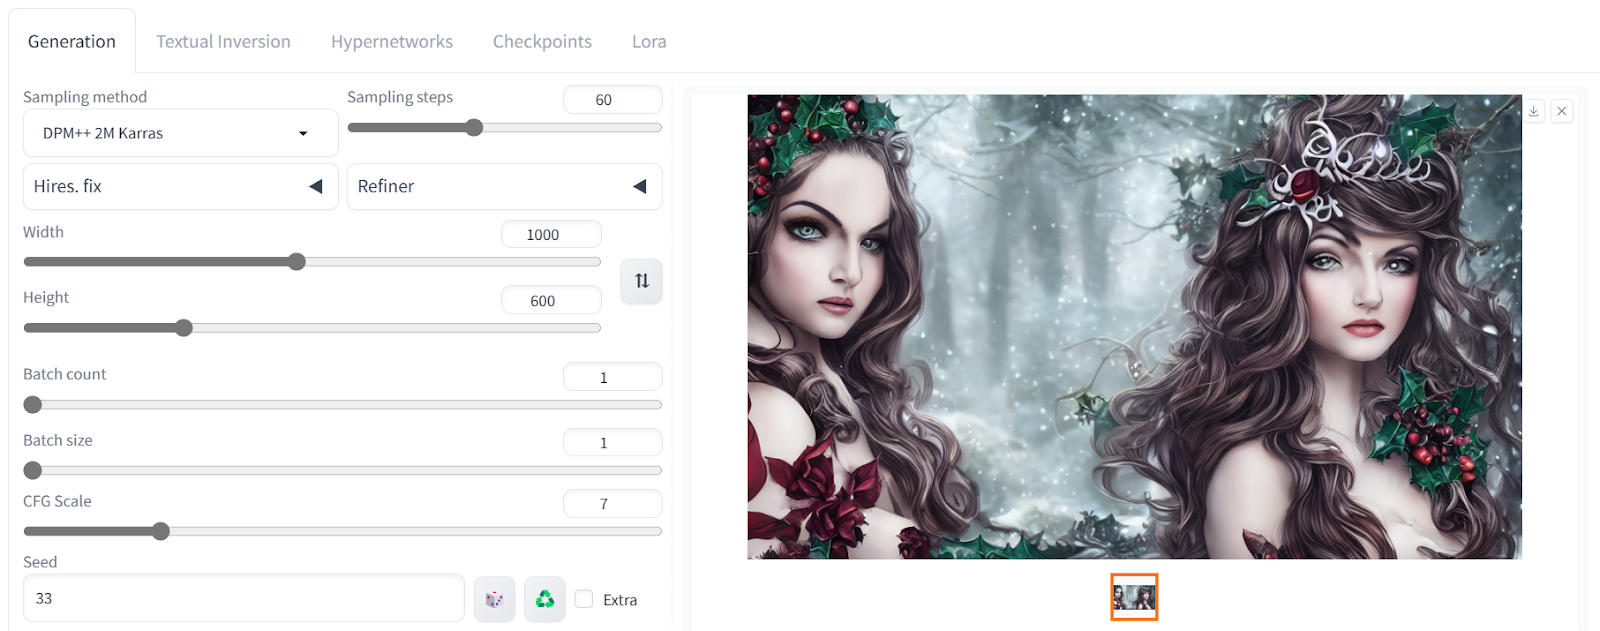
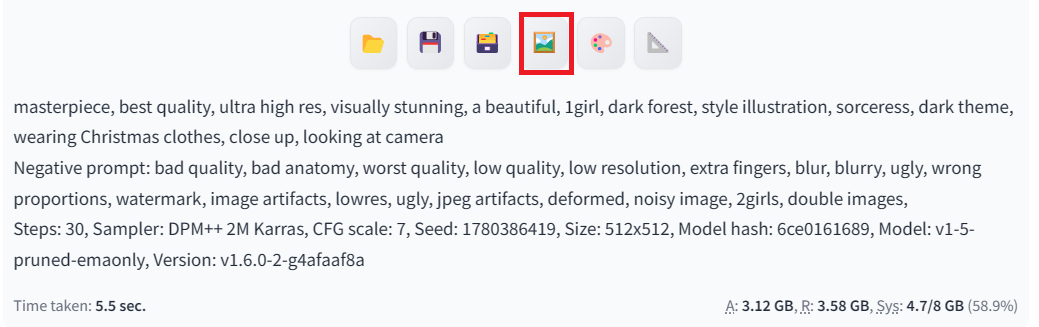
Todas as imagens geradas vêm com metadados que incluem os prompts positivos e negativos e as configurações avançadas. Você pode usá-los para reproduzir o mesmo resultado.
Agora vamos mover a imagem para a aba 'img2img' clicando no botão com o emoji de foto abaixo da imagem, como mostrado acima.
Se você quiser criar seu próprio modelo de IA generativa do zero, siga este guia: Building a Diffuser Model From Scratch with PyTorch.
Guia da aba img2img
A aba img2img permite enviar uma imagem de referência para gerar uma imagem semelhante usando prompts diferentes para estilos distintos. Incluímos um novo prompt positivo e mantivemos o negativo igual para gerar quatro imagens com estilos variados. Se quiser gerar várias imagens com um único prompt, ajuste o Batch count nas configurações de geração.
Prompt positivo: “masterpiece, best quality, ultra high res, visually stunning, a beautiful, 1barbie, pink theme, wearing Christmas clothes, close up, looking at camera, 3d, ”
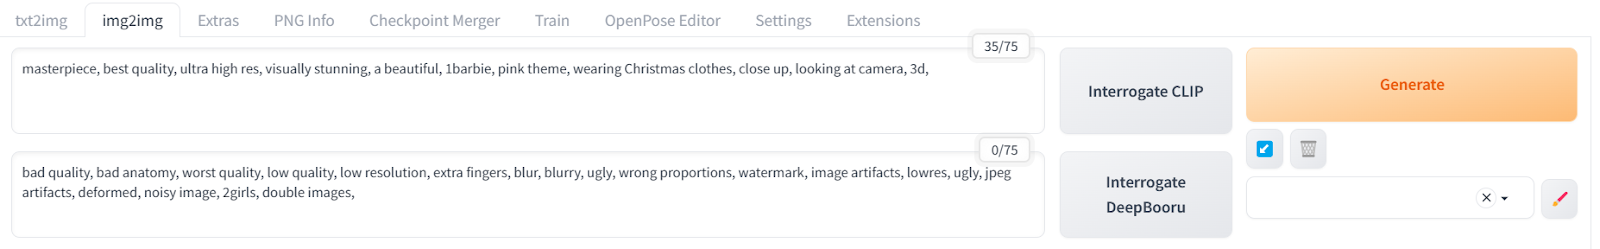
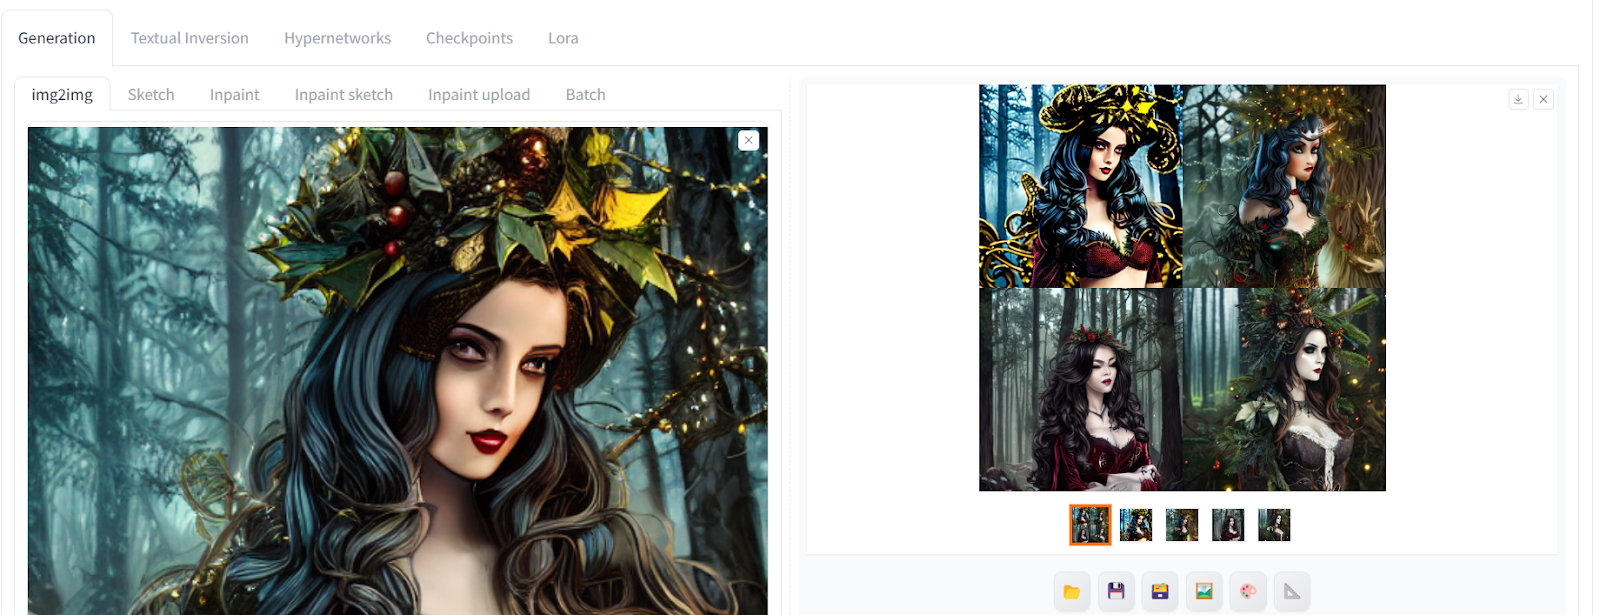
As imagens resultantes ficaram incríveis, com estilos e elementos diferentes. Algumas sem coroa, outras bem coloridas.
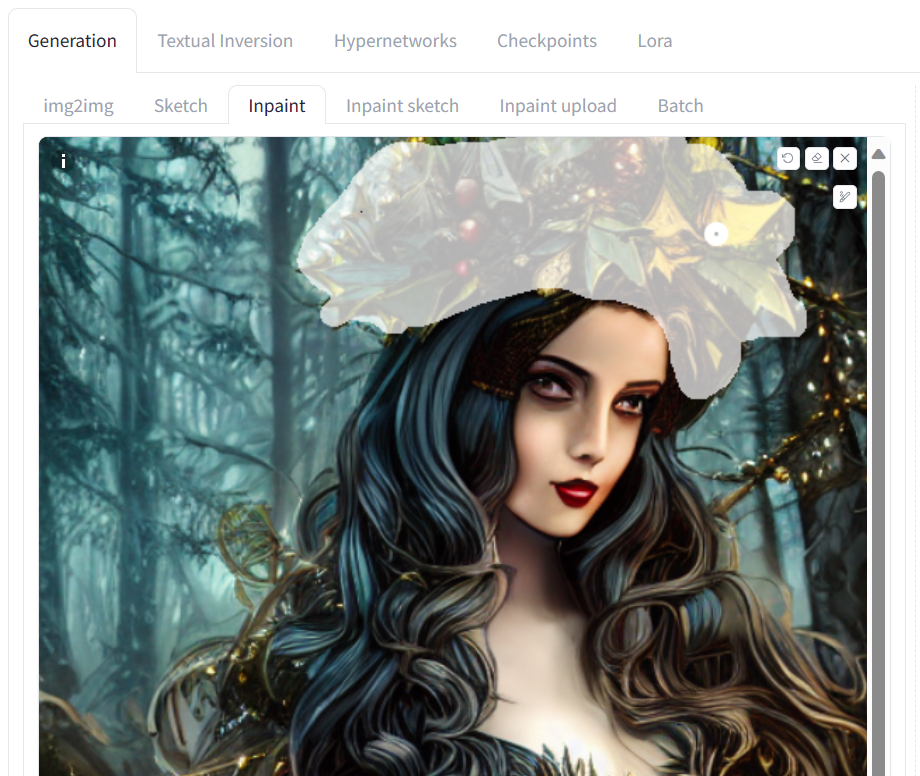
Vamos para a aba 'Inpaint' e tentar trocar a coroa de madeira da foto. Podemos usar a ferramenta de inpainting para selecionar apenas a parte superior da cabeça da garota e transformá-la em uma coroa dourada. O inpainting permite modificar somente a parte selecionada da imagem.
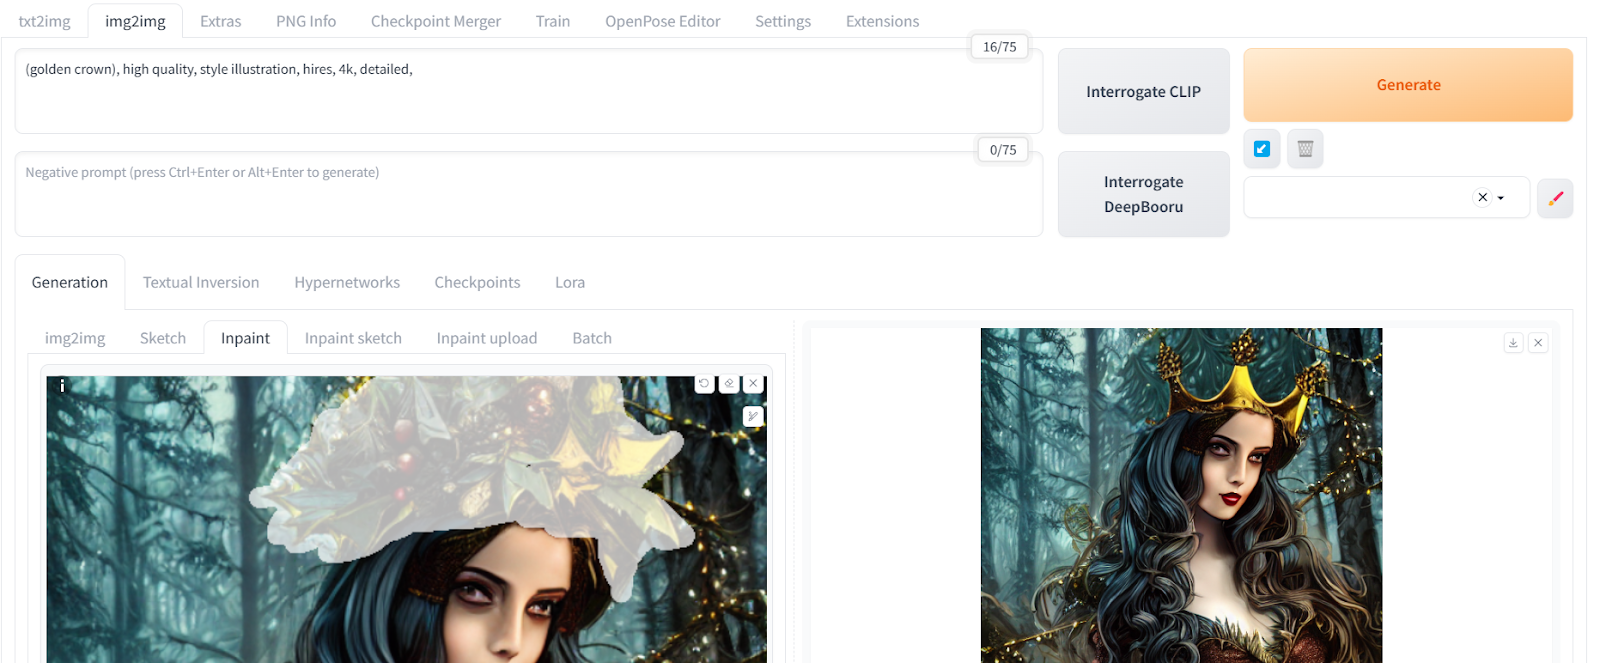
A nova coroa dourada se integra perfeitamente à imagem, sem precisar de Photoshop. Usando a ferramenta de marcação e um prompt simples, conseguimos alterar uma parte da imagem.
Usando o upscaler
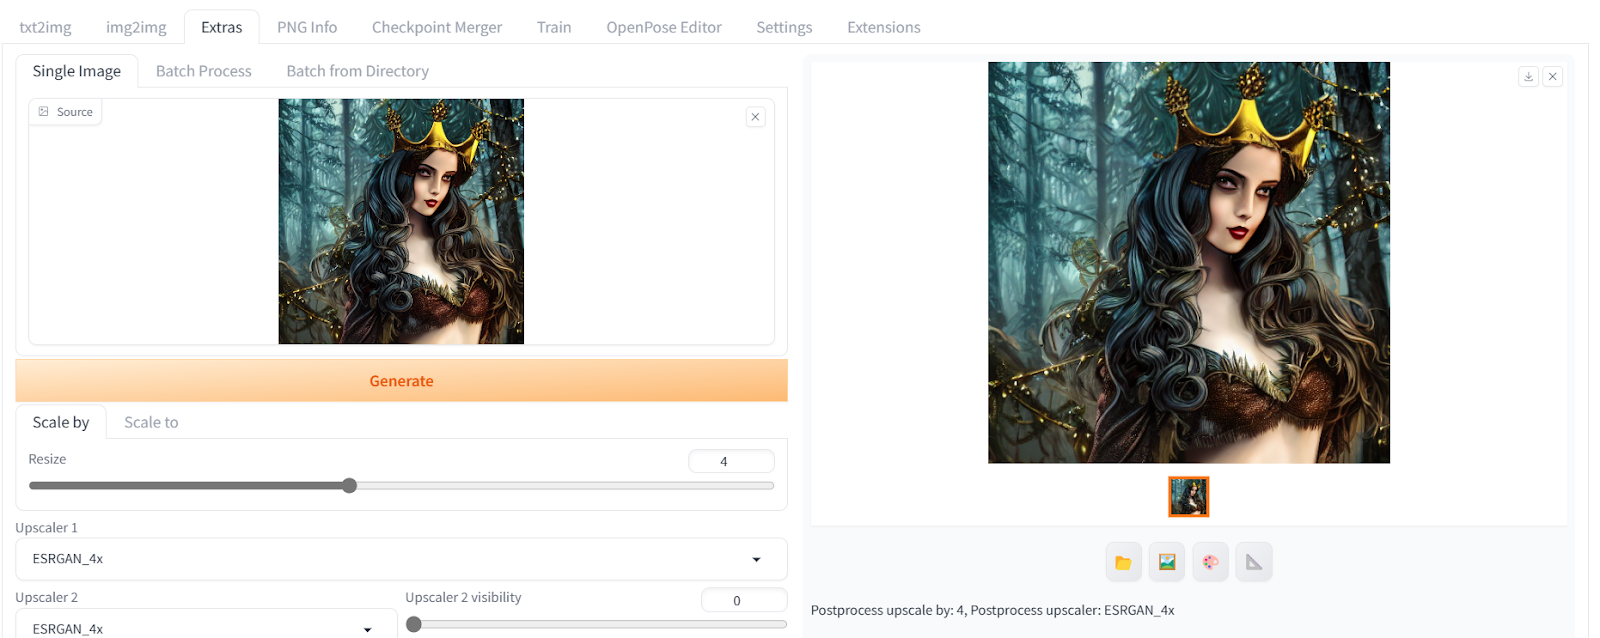
Para ampliar a imagem que geramos, vamos enviá-la para a aba Extras. Vamos aumentar a escala em quatro vezes e manter o restante igual.
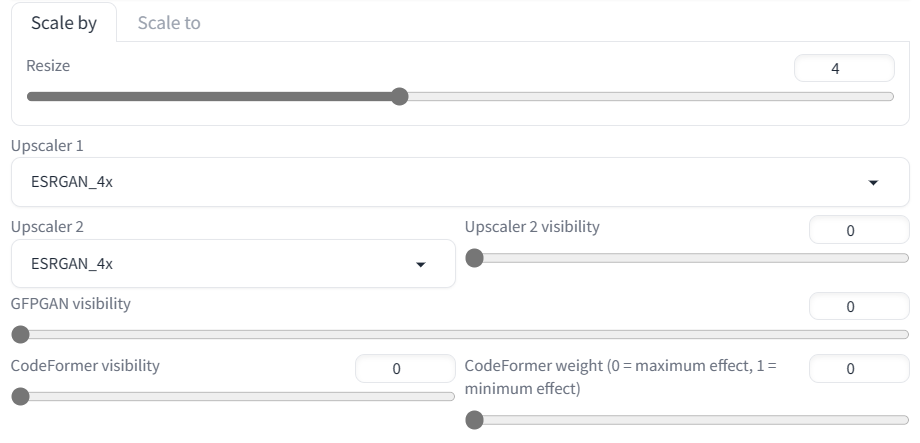
Depois disso, clique no botão Generate para converter “512X512” em “2048X2048” em poucos segundos, sem perda de qualidade.
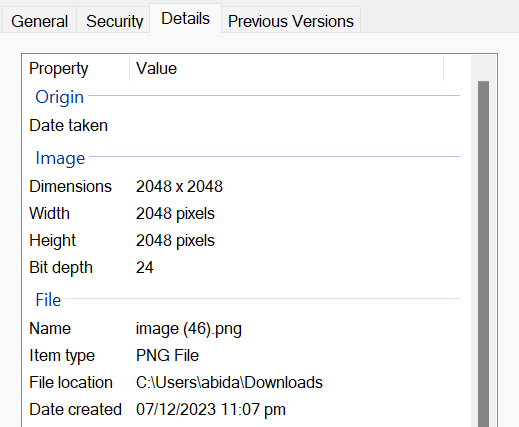
Você pode conferir o tamanho da imagem baixando-a para seu computador e abrindo as propriedades do arquivo.
PNG Info
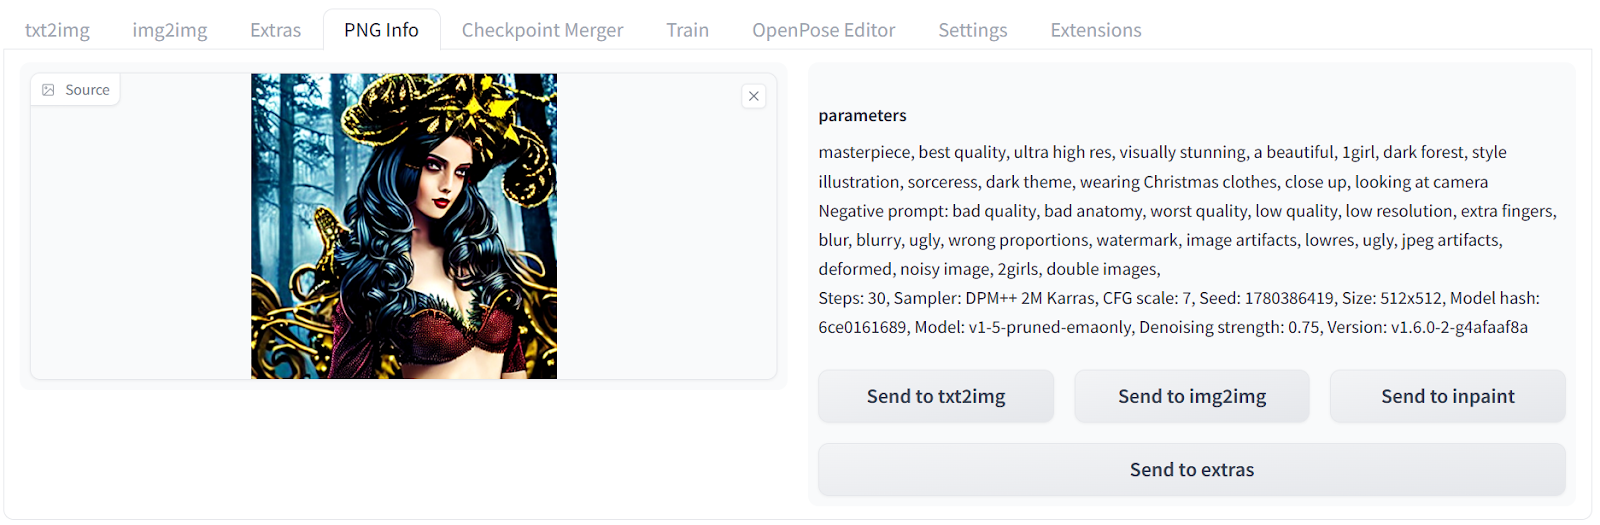
Como vimos, toda imagem contém metadados que indicam como ela foi gerada. Se quiser ver as informações de uma imagem gerada anteriormente, envie-a para a aba "PNG Info". Lá você consegue ver os prompts positivos e negativos e as configurações avançadas.
Instalando extensões
Para instalar extensões na Web UI, vá para a aba Extensions e clique em install from URL. Depois, adicione a URL do repositório da extensão. No nosso caso, vamos instalar a extensão ControNet usando https://github.com/Mikubill/sd-Web UI-controlnet. ControNet é uma arquitetura de rede neural que permite controlar modelos de difusão fornecendo condições extras.
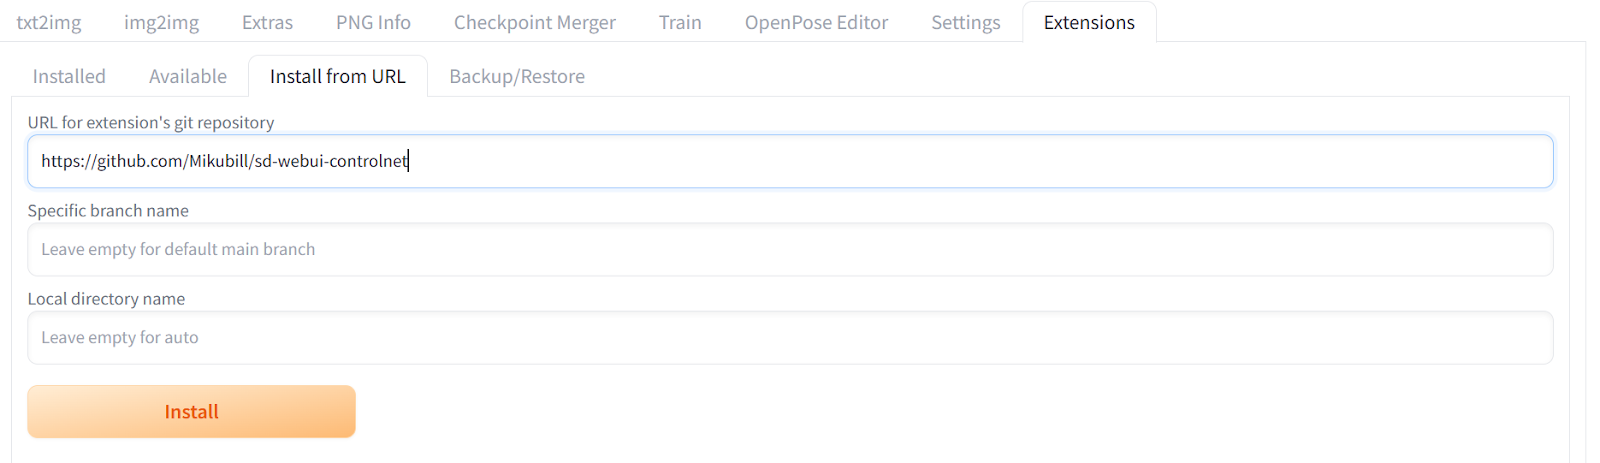
- Depois, vamos instalar a extensão OpenPose Editor usando a URL do Github:
https://github.com/fkunn1326/openpose-editore clicar em Install. - Baixe o modelo OpenPose no repositório da Hugging Face:
hf.co/lllyasviel/ControlNet-v1-1/tree/main. Certifique-se de baixar o arquivo “control_v11p_sd15_openpose.pth”. - Mova o arquivo do modelo para o diretório do Stable Diffusion Web UI:
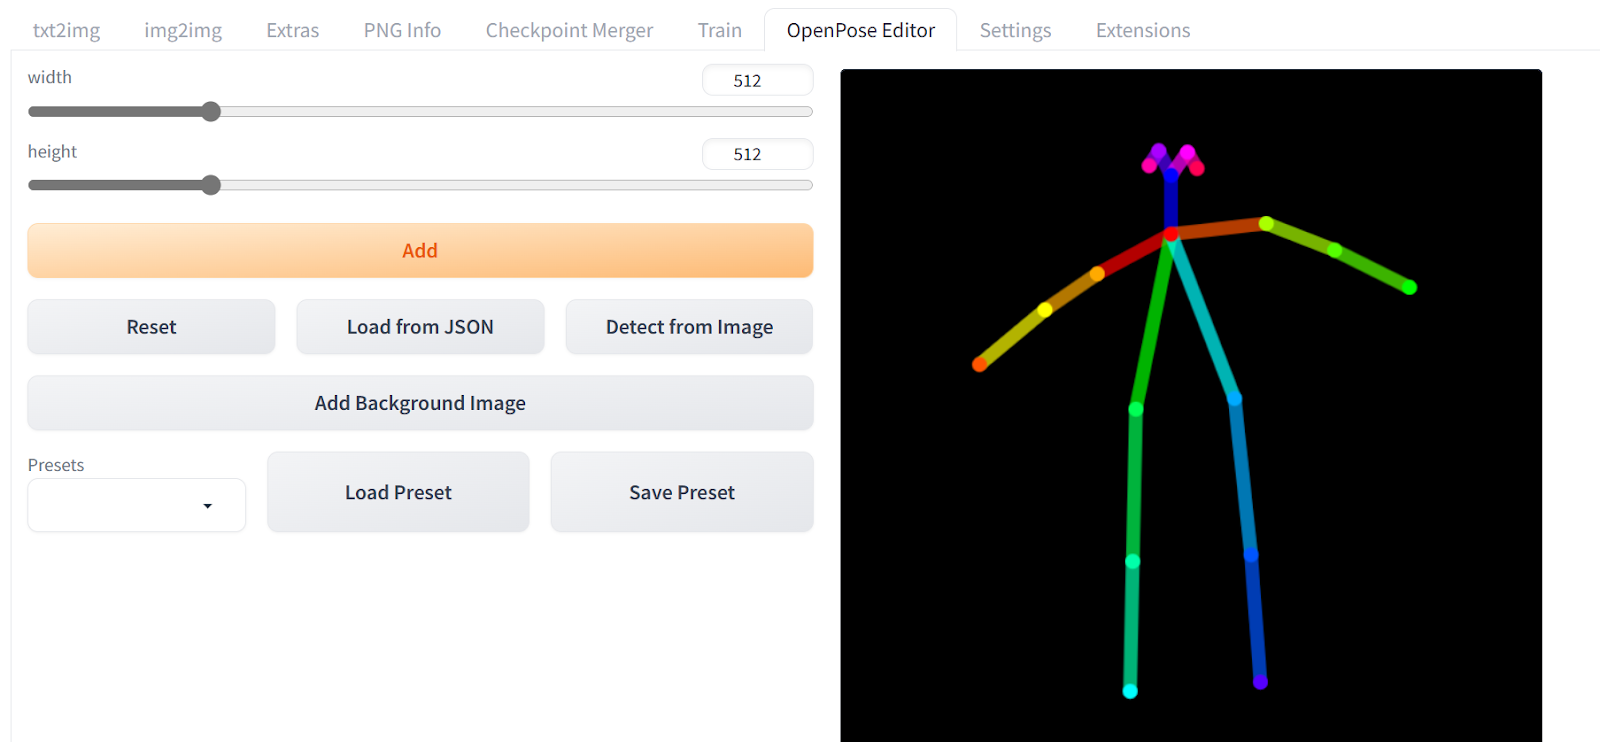
stable-diffusion-Web UI\extensions\sd-Web UI-controlnet\models - Após a instalação, você terá acesso ao
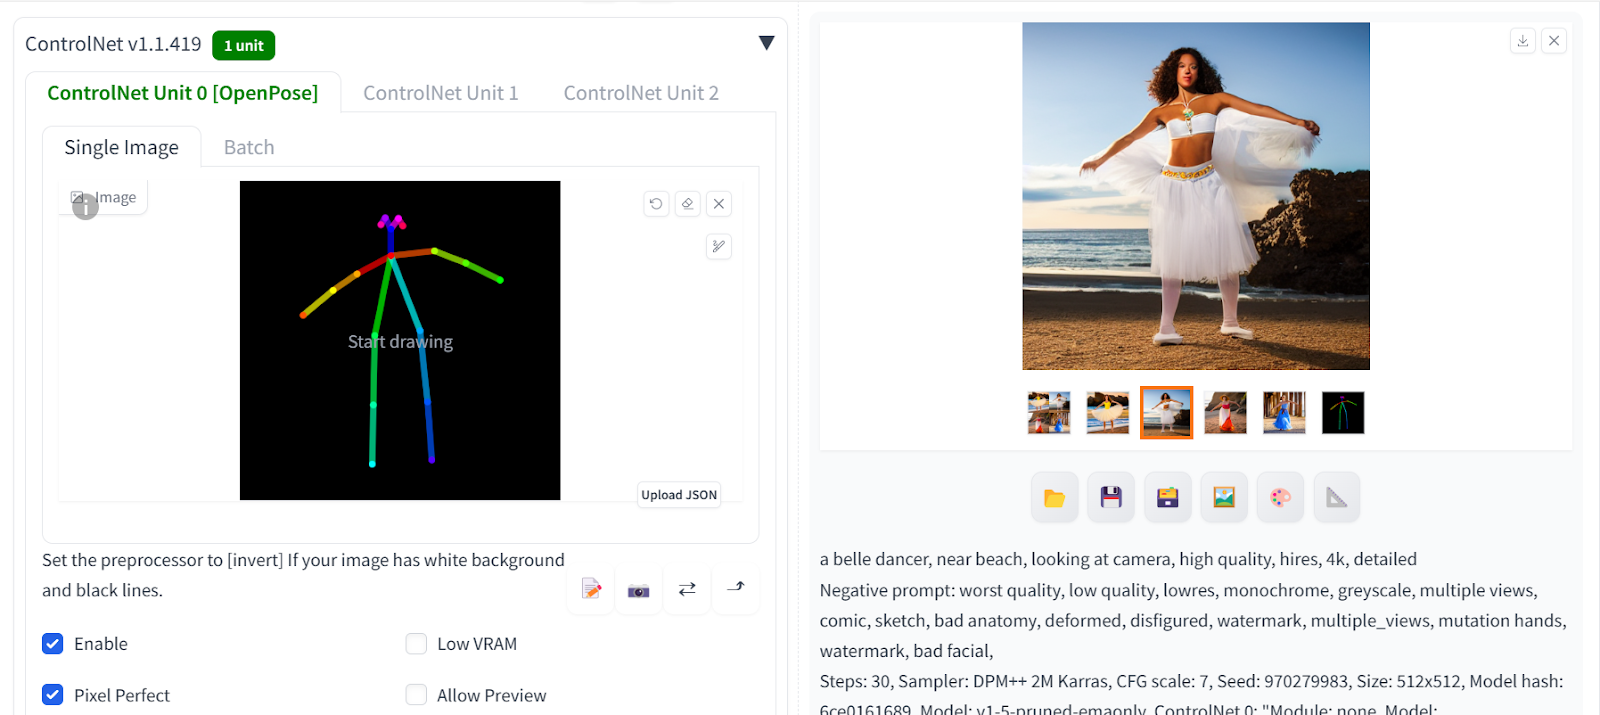
OpenPose Editor. - Altere a pose do boneco com o mouse e, quando terminar, clique em “Send to txt2img”.
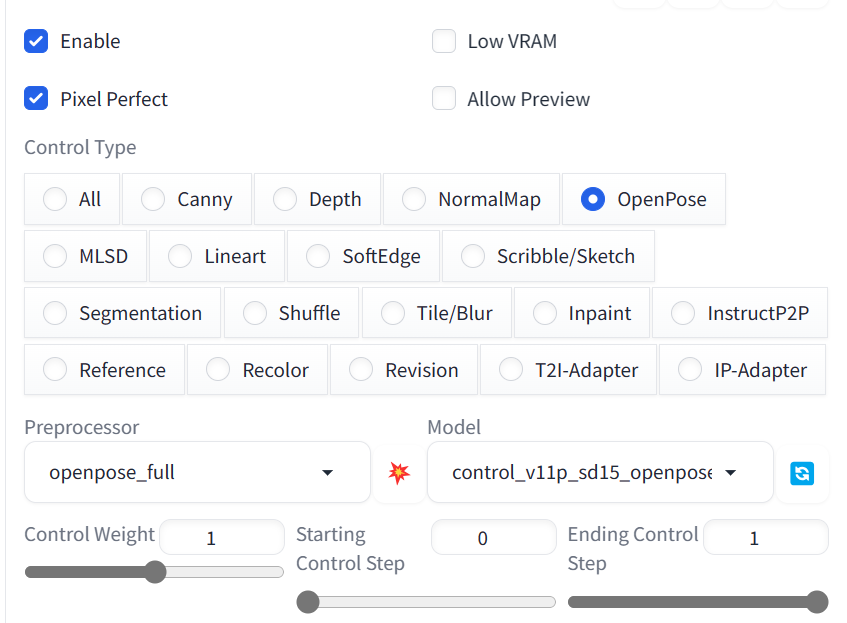
Role a página e abra o painel do ControlNet. Selecione Enable, Pixel Perfect e a opção OpenPose.
Depois, volte para cima e escreva um prompt positivo e um negativo para gerar quatro imagens com poses semelhantes.
Prompt positivo: “a belle dancer, near beach, looking at camera, high quality, hires, 4k, detailed ”
Prompt negativo: “worst quality, low quality, lowres, monochrome, greyscale, multiple views, comic, sketch, bad anatomy, deformed, disfigured, watermark, multiple_views, mutation hands, watermark, bad facial,”
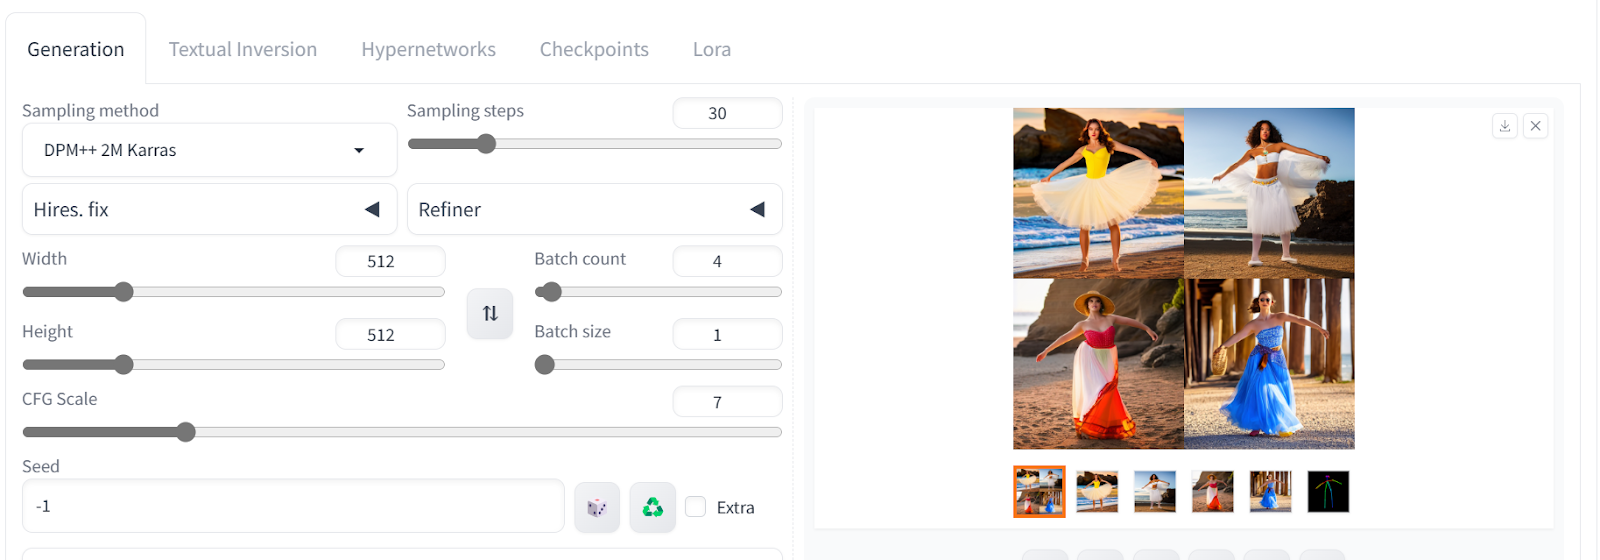
Temos quatro imagens de mulheres na mesma pose. Clique em qualquer uma para visualizá-las como uma imagem única.
Usando modelos personalizados
Nesta seção, vamos baixar e carregar um modelo personalizado ajustado com retratos de alta qualidade para gerar imagens bem realistas. O CivitAI é uma plataforma com vários modelos abertos de geração de imagens. Você consegue buscar um modelo específico e baixá-lo sem nem criar conta.
Você pode ajustar o modelo Stable Diffusion seguindo o guia Fine-tuning Stable Diffusion XL with DreamBooth and LoRA. O passo a passo mostra como fazer o fine-tuning no Kaggle usando GPU gratuita.
No nosso caso, vamos baixar o modelo RealVisXL V2.0 pesquisando por ele no site e clicando no botão de download no painel da direita.
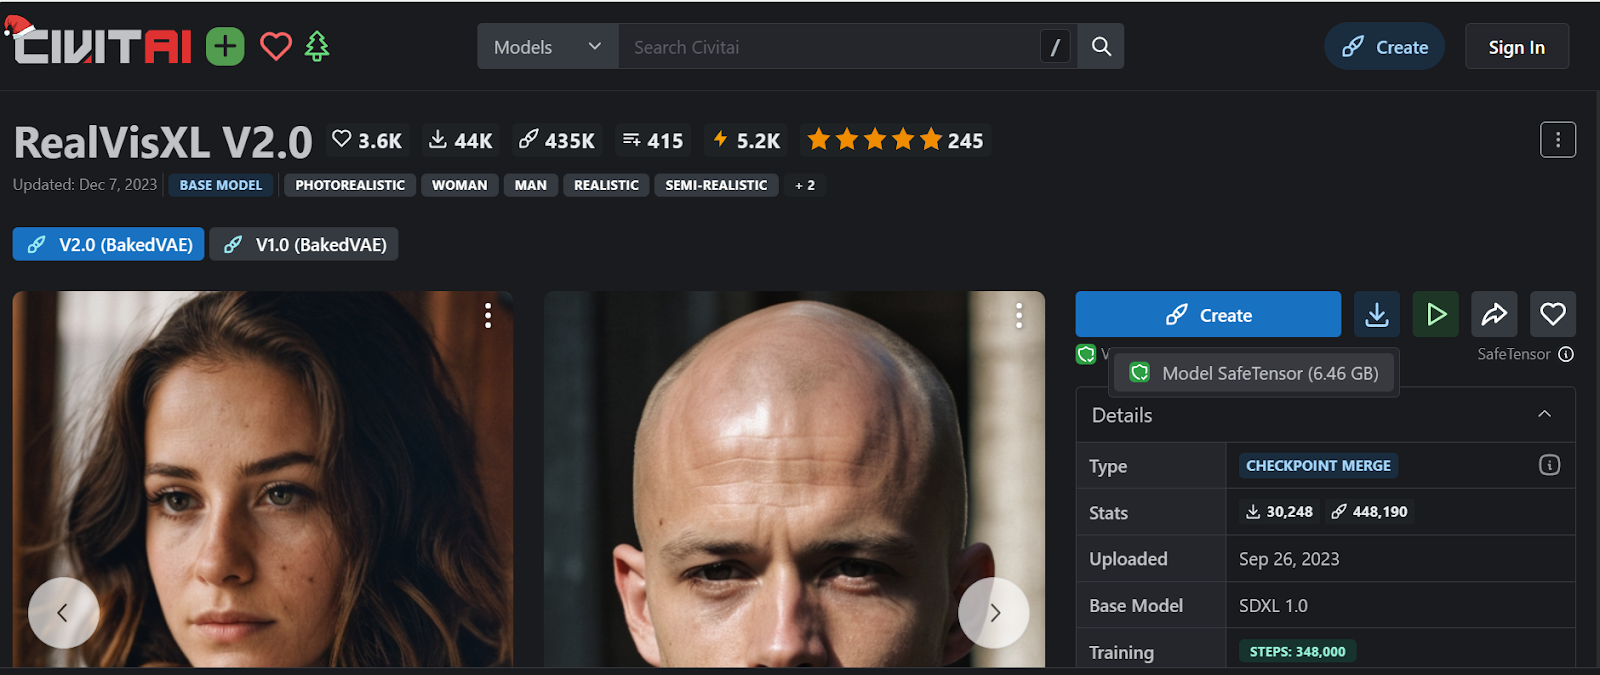
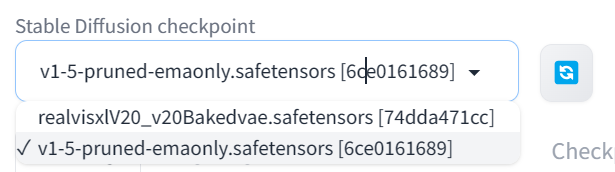
Depois de baixar o modelo, mova-o para o diretório de modelos do Stable Diffusion Web UI em C:\Desktop\Web UI\Web UI\models\Stable-diffusion.
Clique no botão de atualizar no canto superior esquerdo e selecione o modelo RealVisXL mais recente no menu suspenso para ativá-lo.
Observação: se você estiver usando uma máquina acelerada por CPU, a geração de uma única imagem pode levar até 5 minutos. Por isso, procure rodar a Web UI em uma máquina com GPU.
Para acessar prompts positivos e negativos otimizados para o modelo ReallVisXL, role a página do modelo e clique na imagem desejada. Essas imagens têm metadados que podem ser usados para gerar resultados realistas. Por exemplo, se quisermos gerar uma imagem da Spiderwoman olhando para cima e de frente para a câmera, podemos usar os metadados adequados.
Prompt positivo: “An image from a marvel spiderwoman, focused, decisive, surreal, dynamic pose, ultra highres, sharpness texture, High detail RAW Photo, detailed face, shallow depth of field, sharp eyes, (realistic skin texture:1.2), (freckles, moles:0.6), dslr, film grain”
Prompt negativo: “(worst quality, low quality, illustration, 3d, 2d, painting, cartoons, sketch), open mouth”
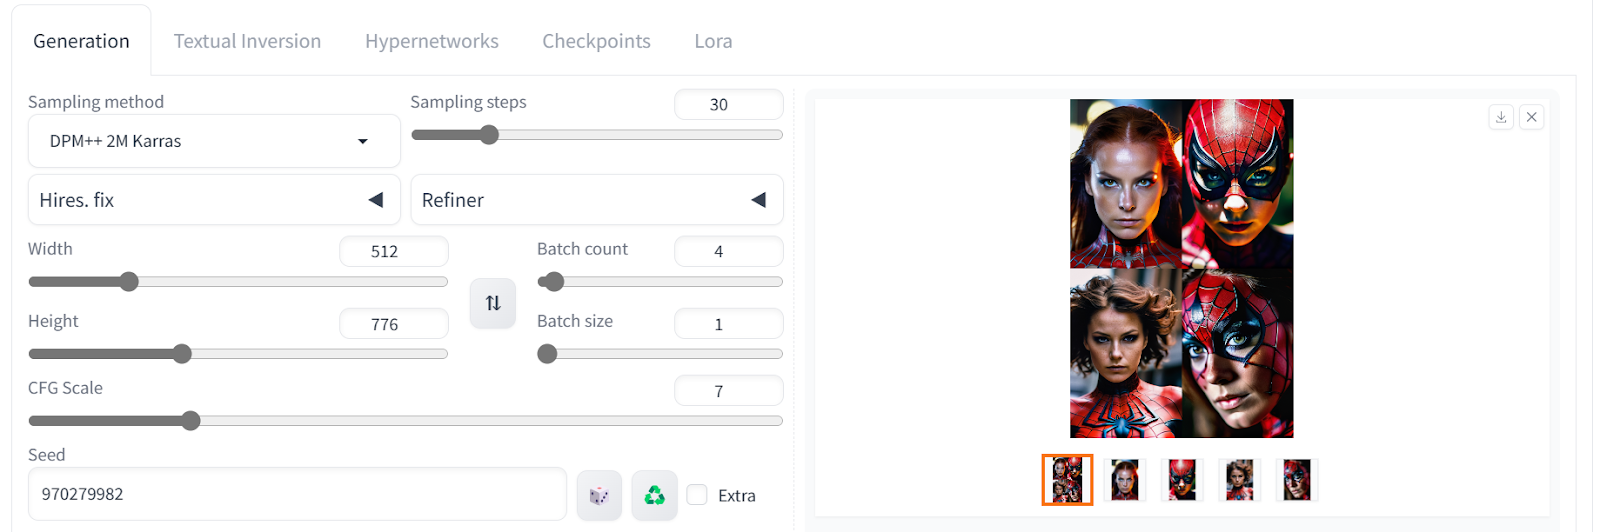
Os resultados ficaram acima das expectativas. Acertamos em cheio na iluminação, cor, textura da pele, cabelo e traços faciais.
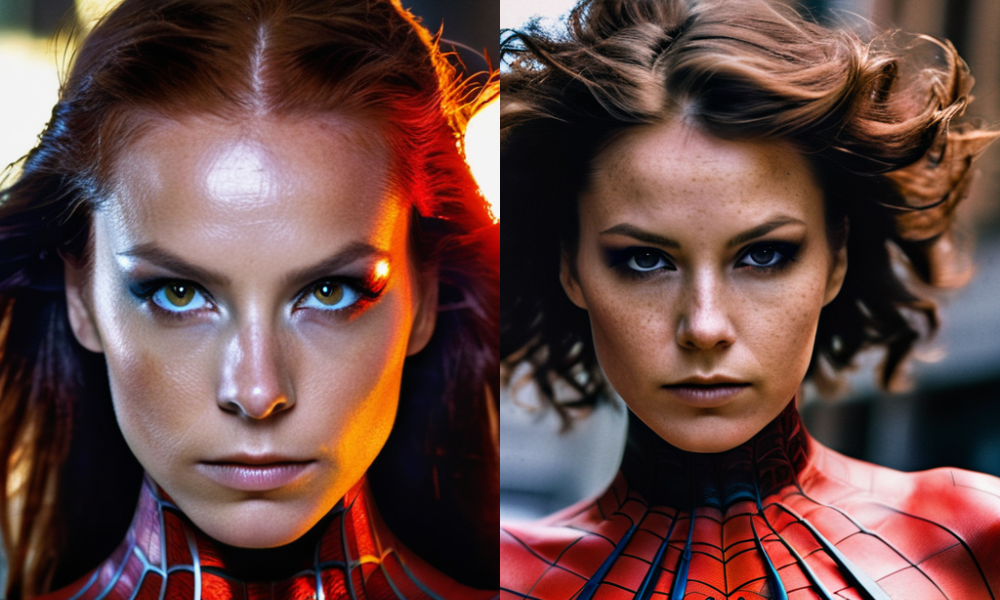
Aqui estão as duas melhores imagens. Se você mostrasse para seus colegas, muitos nem acreditariam que foram geradas por IA.
Atualmente, o modelo com melhor desempenho é o DALLE-3; você pode saber mais lendo o artigo An Introduction to Using DALL-E 3: Tips, Examples, and Features.
Conclusão
O Stable Diffusion Web UI é uma forma acessível para qualquer pessoa aproveitar o poder da geração de imagens com IA. A interface amigável facilita a interação com modelos de difusão de ponta como o Stable Diffusion, mesmo para quem não é técnico.
Neste tutorial, vimos como baixar, instalar e atualizar a Web UI no Windows com GPU Nvidia. Com o SDUI configurado, exploramos recursos centrais como geração de texto para imagem, edição de imagem para imagem, aumento de resolução e mais. Também instalamos extensões para ampliar as capacidades da ferramenta, usando o ControNet para controlar as imagens geradas com o modelo OpenPose.
Por fim, usamos um modelo ajustado para gerar rostos humanos incrivelmente realistas. Fica claro que a Web UI libera um potencial criativo que antes exigia conhecimentos avançados de IA e programação.
No seu próximo projeto, experimente usar diffusers em Python para gerar imagens fotorrealistas com IA. Isso vai ajudar você a criar sua própria interface e gerar imagens com facilidade.

Série Code Along: Torne-se um desenvolvedor de IA
Crie sistemas de IA e desenvolva aplicativos de IA usando OpenAI, LangChain, Pinecone e Hugging Face!