Programa
Fundamentos da IA
10 h
Neste tutorial, você vai conhecer o Stable Diffusion XL e o DreamBooth, e como acessar o modelo de geração de imagens usando a biblioteca diffusers. Além disso, vamos fazer o fine-tuning do modelo com fotos pessoais e avaliar seu desempenho. Se você está começando em IA, recomendamos fazer o curso de AI Fundamentals para ter uma base sólida.
A equipe da Stability AI lançou o Stable Diffusion XL (SDXL) 1.0, a próxima evolução em modelos de IA para geração de imagens a partir de texto. Esse modelo open source expande o SDXL 0.9 (antes apenas para pesquisa) e se tornou o modelo público de criação de imagens mais robusto disponível no mundo.
Tanto análises quantitativas quanto avaliações humanas qualitativas, realizadas ao longo de semanas de experimentos, mostram que o SDXL gera imagens de qualidade superior e mais preferidas em comparação com outros modelos open source.
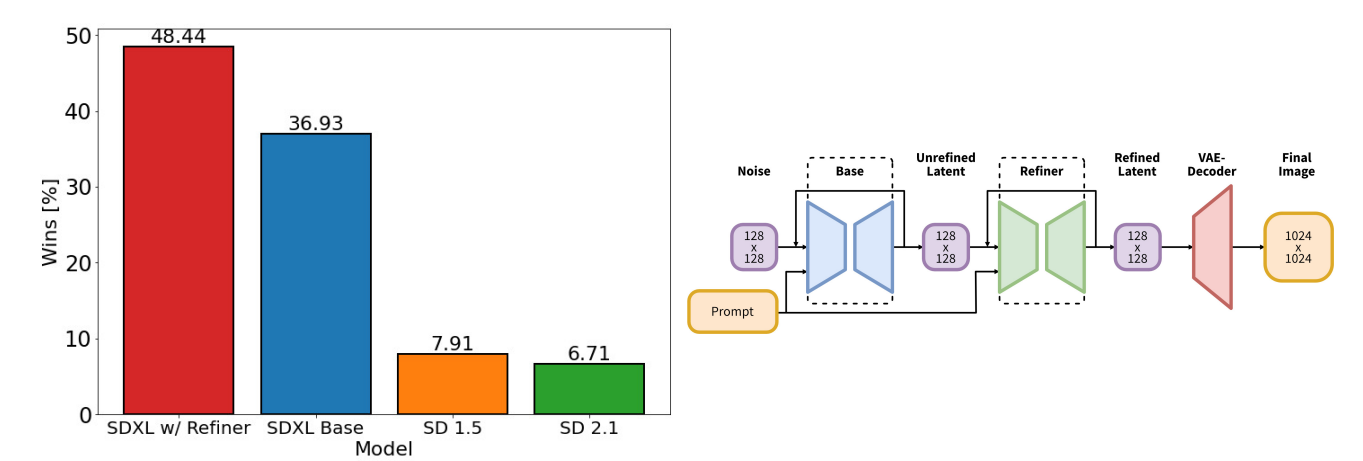
Imagem de arxiv.org
Essa alta qualidade foi alcançada usando um conjunto de dois modelos: um gerador base com 3,5 bilhões de parâmetros e um refinador com 6,6 bilhões. Esse pipeline duplo maximiza a qualidade visual e, ao mesmo tempo, é eficiente o bastante para rodar em GPUs de consumo.
Agora, com o SDXL 1.0, você não precisa mais de prompts longos e complexos para criar imagens impressionantes. Sua inteligência permite gerar composições detalhadas a partir de poucas palavras.
Fazer fine-tuning do SDXL em datasets e tarefas personalizadas ficou ainda mais simples. Ele oferece controle minucioso sobre estrutura, estilo e composição.
O DreamBooth, apresentado em 2022 pela equipe de pesquisa do Google, marcou um avanço importante na IA generativa, principalmente em modelos de texto para imagem como o Stable Diffusion.
Ele recebeu o nome DreamBooth porque, nas palavras dos pesquisadores do Google:
"É como uma cabine de fotos, mas captura o assunto de um jeito que permite sintetizá-lo em qualquer cenário que a sua imaginação levar."
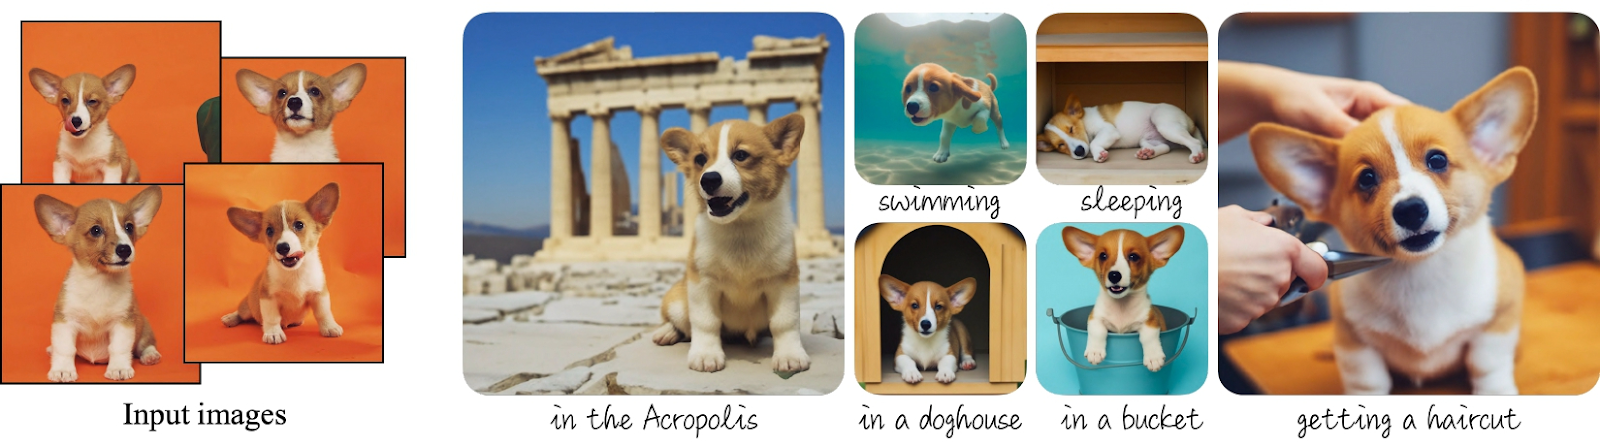
Imagem de DreamBooth
O DreamBooth permite injetar um assunto específico e personalizado, no qual o modelo ajustado se especializa para renderizar de diferentes maneiras. Em outras palavras, você pode criar seu próprio gerador de imagens focado em uma pessoa, personagem, objeto ou cena.
O DreamBooth precisa de poucas imagens (geralmente 3 a 5) do assunto para treinar o modelo com eficácia. Depois de treinado, o modelo consegue colocar o assunto em inúmeros cenários, ambientes e poses — limitados apenas pela imaginação do usuário.
Fazer fine-tuning do modelo de geração de imagens com o DreamBooth pode beneficiar vários setores. Ele dá mais liberdade para experimentar e gerar imagens de alta qualidade sem precisar dominar o Photoshop. Veja alguns exemplos de como ele pode agregar valor ao dia a dia de trabalho.
Nas próximas seções, vamos explorar como acessar e fazer fine-tuning do SDXL em um dataset personalizado usando GPUs gratuitas do Kaggle.
Você pode testar a demo do Stable Diffusion XL no Hugging Face Spaces, que gera rapidamente quatro imagens com base na sua entrada. Brinque um pouco antes de decidir se ele atende ao seu caso.
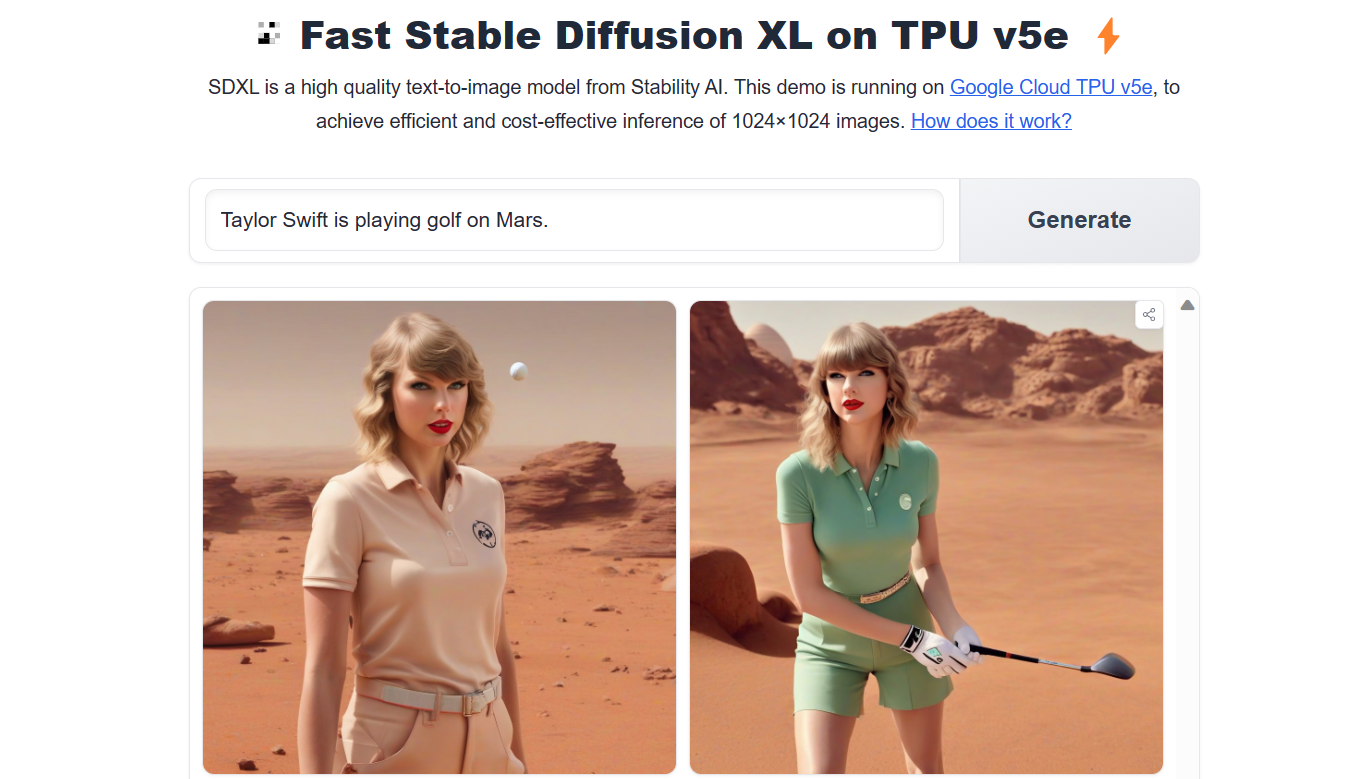
Imagem de Stable Diffusion XL on TPUv5e
Outra forma é usar a biblioteca Python diffusers para gerar imagens com um prompt personalizado.
Antes de rodar o código, garanta que você está usando uma máquina com GPU e suporte a CUDA.
!nvidia-smi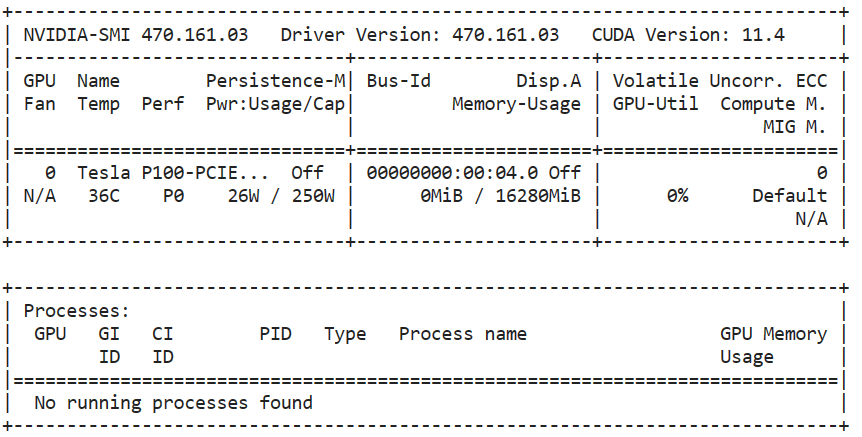
Em seguida, instale o pacote diffusers com o PIP.
%pip install --upgrade diffusers[torch] -qVamos carregar o decodificador VAE personalizado, modificado para rodar em precisão fp16 sem gerar NaNs.
Depois, vamos montar um pipeline carregando o modelo base do SDXL em precisão fp16 e integrando o VAE ao fluxo do diffusers.
Poderíamos carregar o modelo base diretamente sem "fp16", mas isso causaria problemas de memória na GPU. Então, para rodar no Kaggle, Colab e GPUs de laptops, é preciso usar a variante fp16.
from diffusers import DiffusionPipeline, AutoencoderKL
import torch

vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix",
    torch_dtype=torch.float16
)
pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
)
pipe.to("cuda");Para gerar a imagem, você precisa informar um prompt simples, o número de passos de inferência e quantas imagens gerar por prompt.
No nosso caso, vamos gerar quatro imagens a partir de um único prompt.
prompt = "A man in a spacesuit is running a marathon in the jungle."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 4)
Para exibir as imagens em grade, podemos escrever uma função Python simples que redimensiona e organiza as imagens em um grid.
from PIL import Image

def image_grid(imgs, rows, cols, resize=256):
    assert len(imgs) == rows * cols

    if resize is not None:
        imgs = [img.resize((resize, resize)) for img in imgs]

    w, h = imgs[0].size
    grid_w, grid_h = cols * w, rows * h
    grid = Image.new("RGB", size=(grid_w, grid_h))

    for i, img in enumerate(imgs):
        x = i % cols * w
        y = i // cols * h
        grid.paste(img, box=(x, y))

    return grid
Vamos exibir quatro imagens em uma grade 2x2 para comparar facilmente a saída do modelo.
image_grid(image.images, 2, 2)Os resultados são excelentes. Sem dúvida, o SDXL é muito melhor que o Stable Diffusion 1.6.
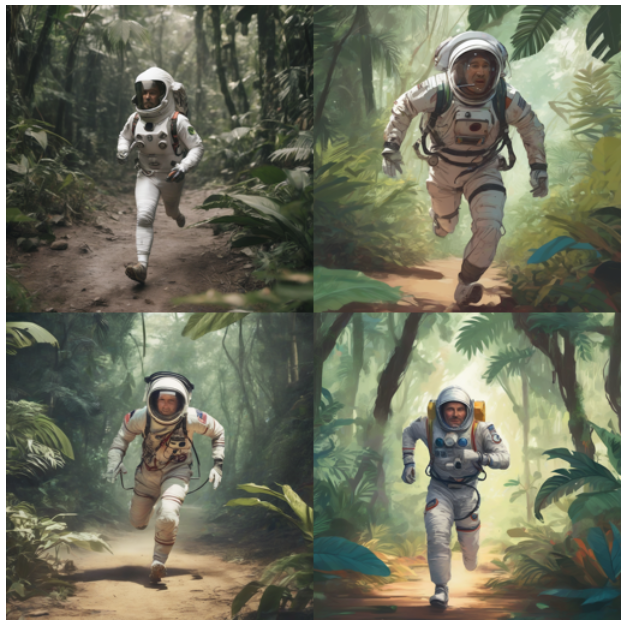
Vamos escrever outro prompt e gerar três imagens de um macaco brincando com fogos de artifício.
prompt = "A playful monkey handling fireworks with ease."
image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)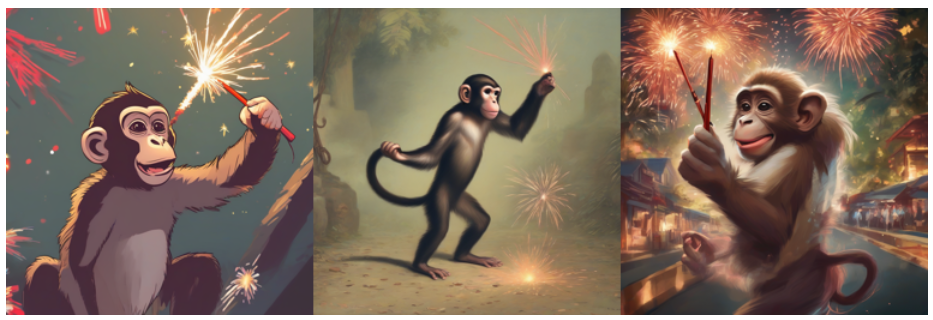
Aprenda a acessar o Stable Diffusion online e localmente seguindo o tutorial How to Run Stable Diffusion.
Para melhorar ainda mais a qualidade e a fidelidade das imagens, vamos usar o Refiner.
refiner = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
)
refiner.to("cuda")

n_steps = 40
high_noise_frac = 0.7

image = pipe(
    prompt=prompt,
    num_inference_steps=n_steps,
    denoising_end=high_noise_frac,
    output_type="latent",
).images

image = refiner(
    prompt=prompt,
    num_inference_steps=n_steps,
    denoising_start=high_noise_frac,
    image=image,
).images[0]

image
A imagem refinada tem alta qualidade e segue o prompt com precisão.
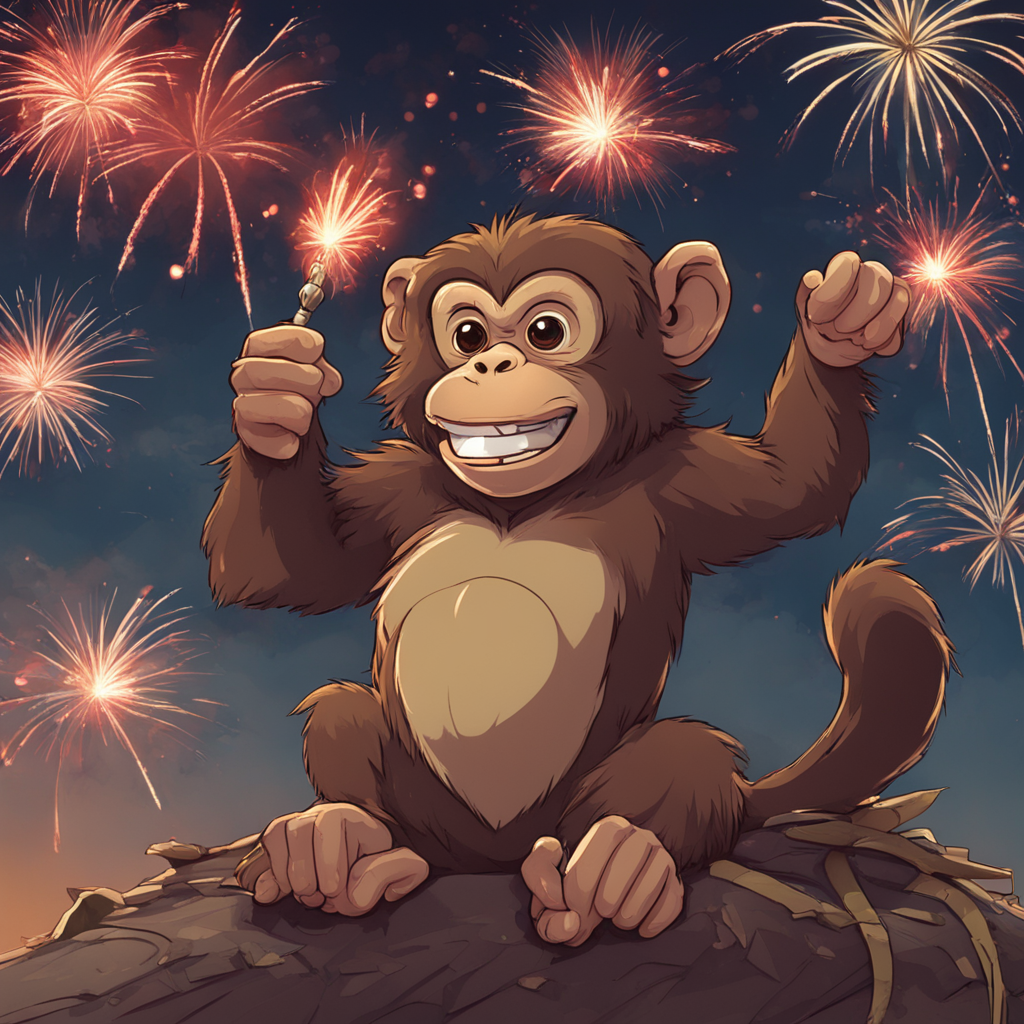
Aprenda a gerar imagens fotorrealistas em Python com modelos de difusão de última geração assistindo ao code-along Generating Photorealistic Images using AI with Diffusers in Python.
Fazer fine-tuning do SDXL ficou muito mais fácil com o tempo. Graças ao AutoTrain Advance, agora dá para ajustar o modelo com um único script em Python. Essa biblioteca de AutoML foi feita para treinar e publicar modelos de ponta com o mínimo de código.
Você pode instalar o pacote Python com PIP:
%pip install -U autotrain-advancedSe quiser fazer fine-tuning do SDXL com accelerate e transformers, confira o Colab Notebook SDXL DreamBoot LoRA. O notebook está um pouco desatualizado e pode exigir alguns ajustes para rodar corretamente.
Antes de rodar o script do DreamBooth, vamos definir algumas variáveis que usaremos na execução.
PROJECT_NAME = "Dreambooth_SDXL"
MODEL_NAME = "stabilityai/stable-diffusion-xl-base-1.0"
DATA_DIR = "/kaggle/input/abids-photos"
REPO_ID = "kingabzpro/sdxl-lora-abid"
Depois, configure um token do Hugging Face usando o recurso de Secret do Kaggle. Saiba como configurar secrets lendo o Mistral 7B Tutorial: Step-by-Step Guide for Using Mistral 7B.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
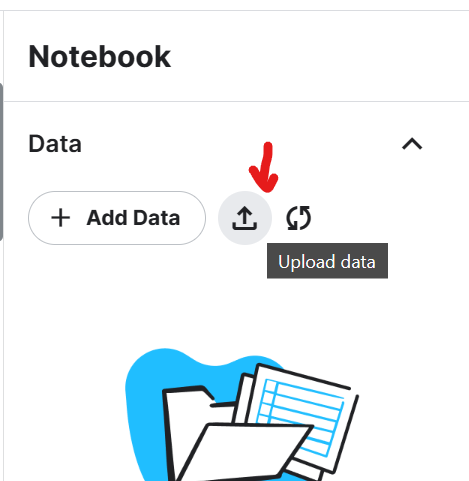
HF_TOKEN = user_secrets.get_secret("HUGGINGFACE_TOKEN")Para criar o dataset privado com suas selfies no Kaggle, clique no botão de upload no painel direito do notebook.
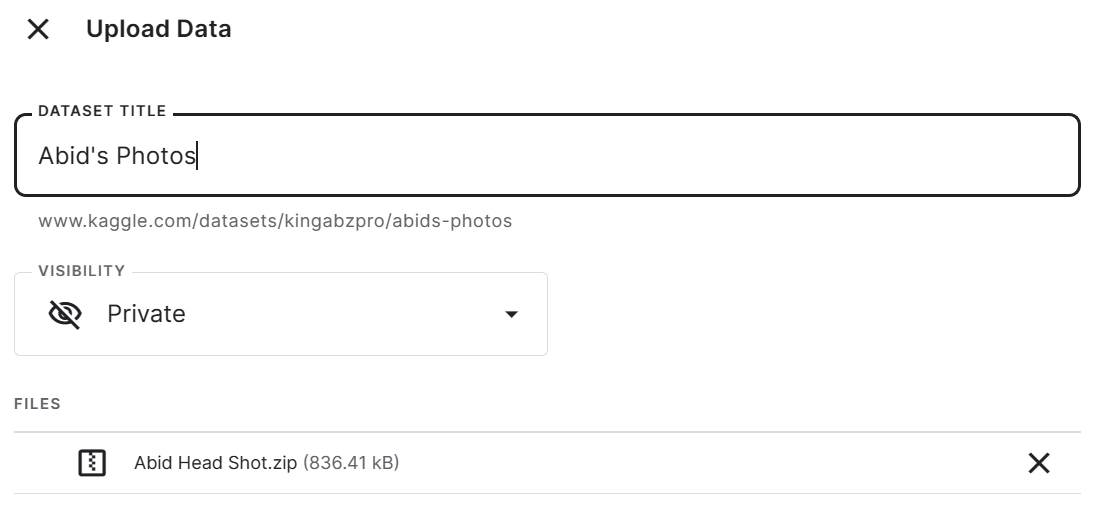
Adicione um título ao dataset e faça upload do arquivo zip com cinco fotos de selfies tiradas em locais diferentes. Neste caso, são fotos do autor.
Para ver as cinco imagens no Jupyter Notebook, vamos carregá-las com o PIL e passá-las para a função image_grid.
from PIL import Image

def image_grid(imgs, rows, cols, resize=256):
    assert len(imgs) == rows * cols

    if resize is not None:
        imgs = [img.resize((resize, resize)) for img in imgs]

    w, h = imgs[0].size
    grid_w, grid_h = cols * w, rows * h
    grid = Image.new("RGB", size=(grid_w, grid_h))

    for i, img in enumerate(imgs):
        x = i % cols * w
        y = i // cols * h
        grid.paste(img, box=(x, y))

    return grid

import glob
Exibimos cinco imagens de alta qualidade do autor em locais diferentes. Garanta que todas as fotos sejam de boa qualidade e tenham tamanho semelhante.
imgs = [Image.open(path) for path in glob.glob("/kaggle/input/abids-photos/*.jpg")]
image_grid(imgs, 1, 5)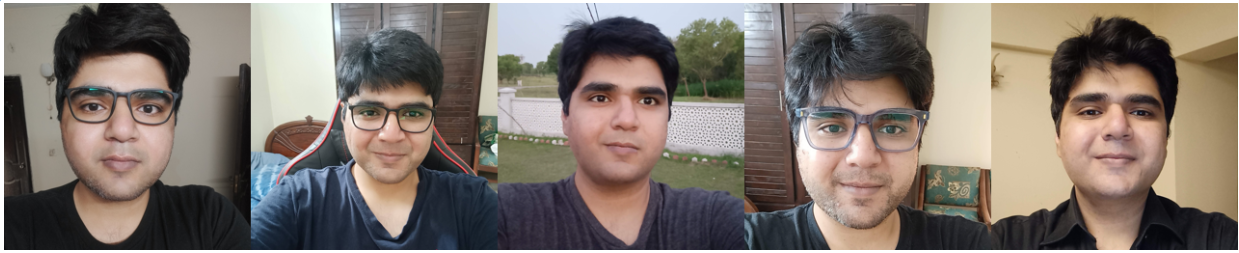
Hora de fazer o fine-tuning do nosso modelo nessas cinco imagens usando o script DreamBooth do AutoTrain.
!autotrain dreambooth \
--model $MODEL_NAME \
--project-name $PROJECT_NAME \
--image-path $DATA_DIR \
--prompt "A photo of Abid Ali Awan wearing casual clothes, taking a selfie, and smiling." \
--resolution 1024 \
--batch-size 1 \
--num-steps 500 \
--gradient-accumulation 4 \
--lr 1e-4 \
--fp16 \
--gradient-checkpointing \
--push-to-hub \
--token $HF_TOKEN \
--repo-id $REPO_ID
O treinamento levou 2 horas e 15 minutos para concluir e enviar os pesos LoRA para o Hugging Face.
LoRA, sigla para Low-Rank Adaptation, é uma técnica que adiciona pequenas camadas treináveis a um modelo existente sem modificar os pesos originais.
O LoRA é útil porque permite introduzir novos conceitos, como estilos artísticos, personagens ou temas, sem exigir muita computação ou memória.
Steps: 100%|█████████| 500/500 [2:15:11<00:00, 14.49s/it, loss=0.119, lr=0.0001]Model weights saved in Dreambooth_SDXL/pytorch_lora_weights.safetensors
Steps: 100%|█████████| 500/500 [2:15:11<00:00, 16.22s/it, loss=0.119, lr=0.0001]
pytorch_lora_weights.safetensors: 100%|████| 23.4M/23.4M [00:01<00:00, 11.9MB/s]
Em vez de salvar um arquivo de modelo de 7 GB, vamos salvar um adaptador LoRA de 23,4 MB que será anexado ao modelo base durante a inferência.
Imagem de kingabzpro/sdxl-lora-abid
Vamos criar um pipeline de difusão para gerar imagens, usando um decodificador VAE personalizado e o modelo base do SDXL com precisão FP16.
Em seguida, vamos carregar os pesos LoRA e anexá-los ao modelo base usando o nosso repo ID do Hugging Face.
Por fim, vamos rodar o pipeline com o prompt e gerar três imagens.
from diffusers import DiffusionPipeline, AutoencoderKL, StableDiffusionXLImg2ImgPipeline

import torch

vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix",
    torch_dtype=torch.float16
)
pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
)
pipe.to("cuda");
pipe.load_lora_weights(REPO_ID, weight_name="pytorch_lora_weights.safetensors")


prompt = "A photo of Abid Ali Awan participating in a marathon."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)
Os resultados são impressionantes. Conseguimos ajustar o modelo para gerar imagens do autor, "Abid Ali Awan".
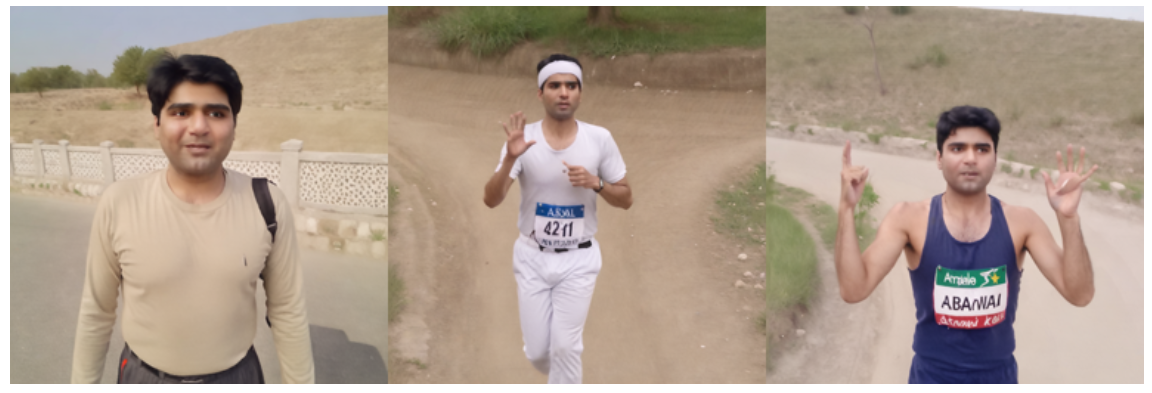
Vamos tentar novamente com outro prompt.
prompt = "A photo of Abid Ali Awan giving a press conference."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)
Mais uma vez, os resultados são excelentes.
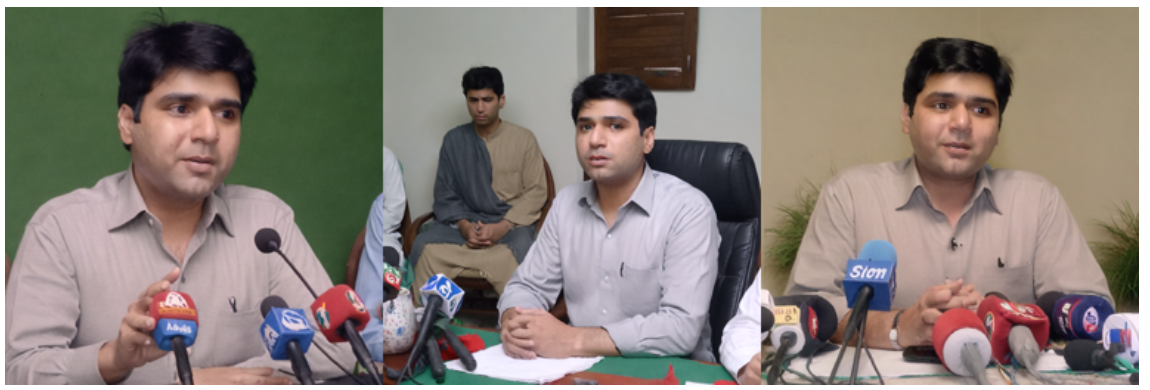
Nesta seção, vamos melhorar a imagem gerada com o SDXL Refiner 1.0.
Primeiro, vamos gerar a imagem com o pipeline do Stable Diffusion e definir uma semente manual para garantir reprodutibilidade.
prompt = "A photo of Abid Ali Awan wearing a business suit at an office meeting."

seed = 65
generator = torch.Generator("cuda").manual_seed(seed)
image = pipe(prompt=prompt, num_inference_steps=25, generator=generator).images[0]
image.resize((300, 300))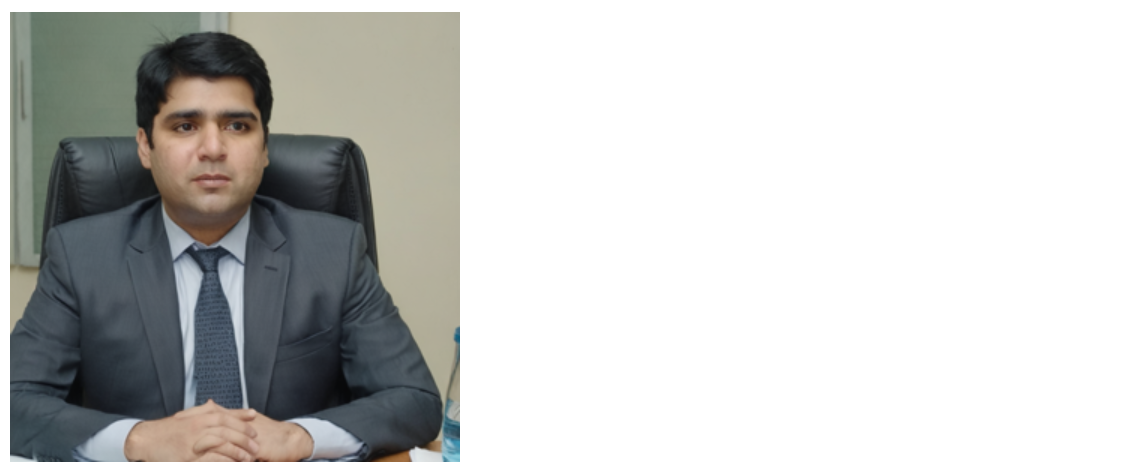
Depois, vamos carregar o SDXL refiner e rodar o pipeline de refinamento com o mesmo prompt, o mesmo gerador e a imagem gerada.
refiner = StableDiffusionXLImg2ImgPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
)
refiner.to("cuda");

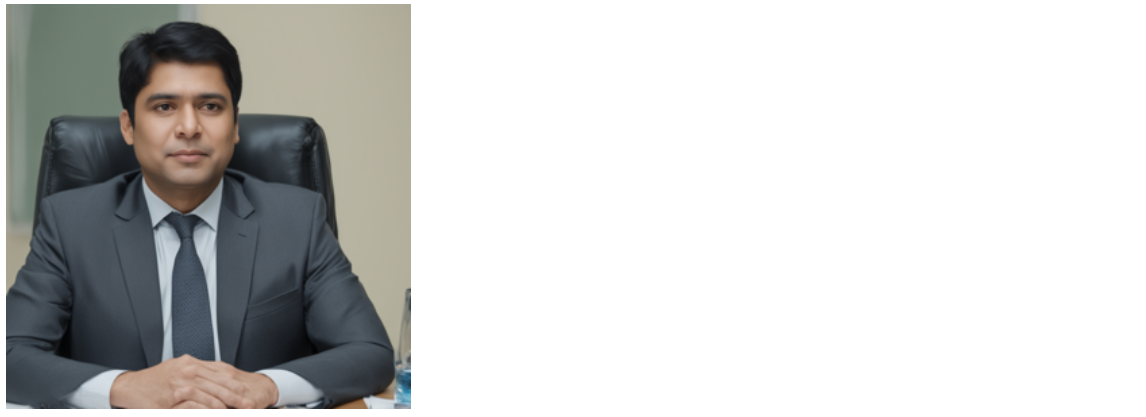
image = refiner(prompt=prompt, num_inference_steps=25, generator=generator, image=image)
image.images[0].resize((300, 300))
O refiner melhorou a qualidade da imagem, mas o resultado final não se parece com a foto original do autor. Em vez disso, mostra um empresário genérico do sul da Ásia. Talvez, para modelos ajustados, seja melhor evitar o refiner.
Depois de fazer fine-tuning do SDXL, o próximo passo é criar uma aplicação de IA generativa. Para se inspirar, confira o post 5 Projects Built with Generative Models and Open Source Tools.
Neste tutorial, conhecemos o modelo Stable Diffusion XL e a técnica DreamBooth. Também aprendemos a fazer fine-tuning do Stable Diffusion XL usando o script DreamBooth do AutoTrain Advance para gerar imagens personalizadas.
Após carregar o modelo base do SDXL, treinamos um adaptador LoRA leve usando apenas cinco fotos do autor. Em seguida, os pesos LoRA foram anexados ao SDXL base, permitindo gerar imagens de alta qualidade do autor em diversos cenarios imaginados, preservando as capacidades do modelo completo de múltiplos bilhões de parâmetros.
Embora o SDXL Refiner tenha melhorado a qualidade visual, ele funcionou melhor com prompts genéricos e pareceu sobrepor parte da personalização obtida pelo fine-tuning. Mesmo assim, o tutorial mostrou como é simples ajustar um modelo SDXL com o AutoTrain Advance usando apenas algumas imagens.
Se você está entrando agora no mundo da IA e quer entender o motivo de tanto buzz, sugerimos fazer o curso de AI Fundamentals. Ele ajuda você a aprender sobre IA generativa e grandes modelos de linguagem. Além disso, você pode dar o pontapé inicial na sua carreira em engenharia de IA se inscrevendo na trilha de carreira Machine Learning Scientist with Python. Esse programa completo vai te ajudar a aprender processamento de linguagem natural, processamento de imagens e os pacotes populares de machine learning em Python, como scikit-learn, PySpark e Keras.
Comece sua jornada em IA hoje mesmo!
Programa
Programa
blog
Richie Cotton
blog
Abid Ali Awan
9 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Josep Ferrer
11 min
Tutorial
Aashi Dutt
14 min