course
Înțelegerea Prompt Engineering
1 oră
232.4K
OpenAI tocmai a extins familia GPT‑6 cu două modele noi: GPT‑6 Sol și GPT‑6 Luna, ambele poziționate sub vârful de gamă GPT‑6 Astra, despre care am scris la începutul acestei luni. Atât Sol, cât și Luna vin cu tăieri puternice de preț (50% față de prețurile lor GPT‑5.6), plus câștiguri la programare și automatizarea fluxurilor de lucru.
Întâmplător sau nu, Anthropic a lansat Claude Opus 5.5 în aceeași zi (astăzi), cu o ofertă similară: aceeași abordare de antrenare ca modelul de vârf, optimizată pentru cost și viteză.
Ca să afli mai multe despre modelul de top sub care se așază acestea, consultă tutorialul API pentru GPT‑6 Astra și comparația noastră dintre GPT‑6 Astra și Claude Fable 5.1.
Astra rămâne cel mai capabil și mai bine aliniat model al OpenAI, rezervat pentru munca cea mai solicitantă. Dar Sol și Luna sunt construite pentru a aduce mare parte din aceeași abordare de antrenare și mult din performanța rezultată la programare, folosirea computerului etc., pe trepte mai ieftine și mai rapide.
Gândește-te la aceeași relație pe care o are Opus 5.5 cu Fable 5.1: nu un nou avans de frontieră, ci o performanță „aproape de frontieră” la o fracțiune din cost.
Câteva lucruri care merită văzute:
Prețul API pentru Sol este la jumătate față de cât era înainte. Prețul pentru Luna este chiar puțin sub jumătate. Poți vedea mai multe detalii la secțiunea de prețuri.
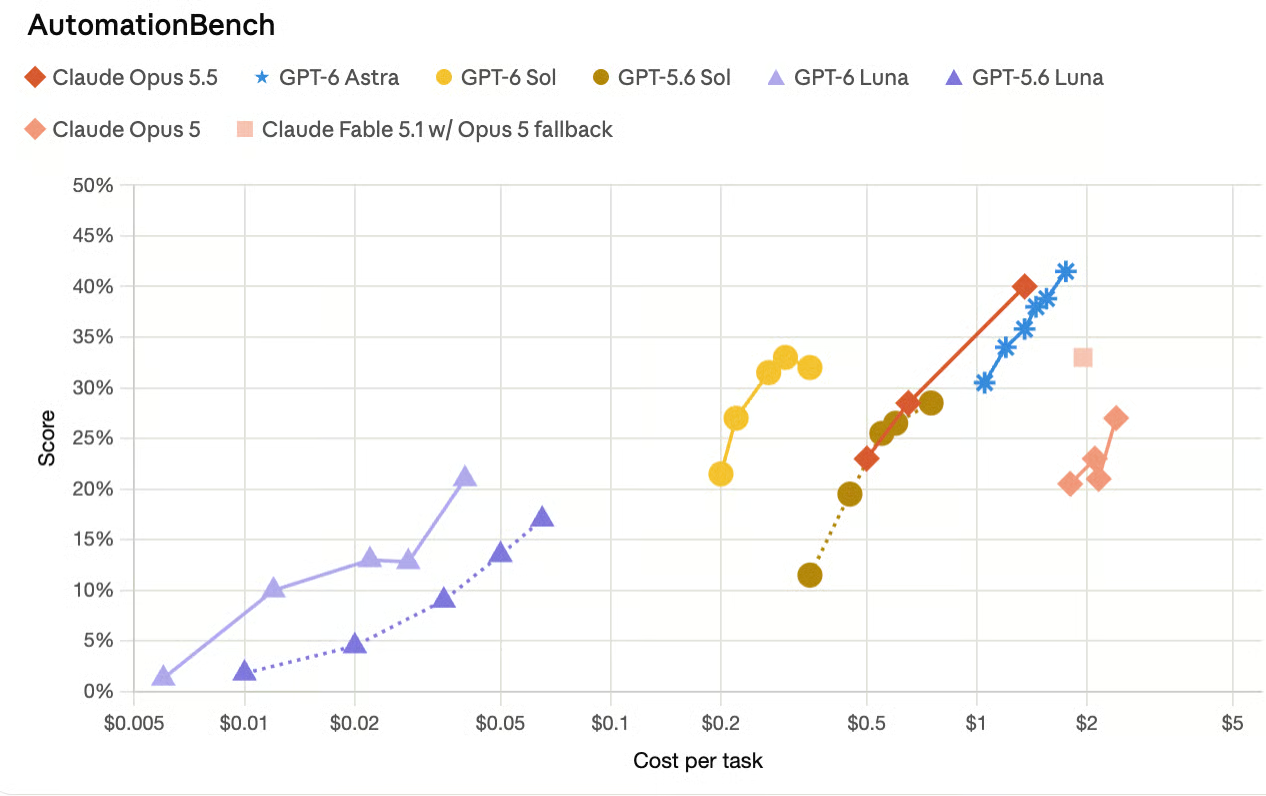
Pe AutomationBench, care testează agenți pe vânzări, marketing, operațiuni, suport, finanțe și altele, Sol la setarea de efort maxim depășește Claude Opus 5, și face asta la o fracțiune din costul pe sarcină al lui Opus 5. Luna s-a îmbunătățit, de asemenea, semnificativ față de predecesoarea GPT‑5.6, în timp ce a devenit vizibil mai ieftină pe sarcină. OpenAI a inclus un vizual plăcut, pe care l-am recreat aici:
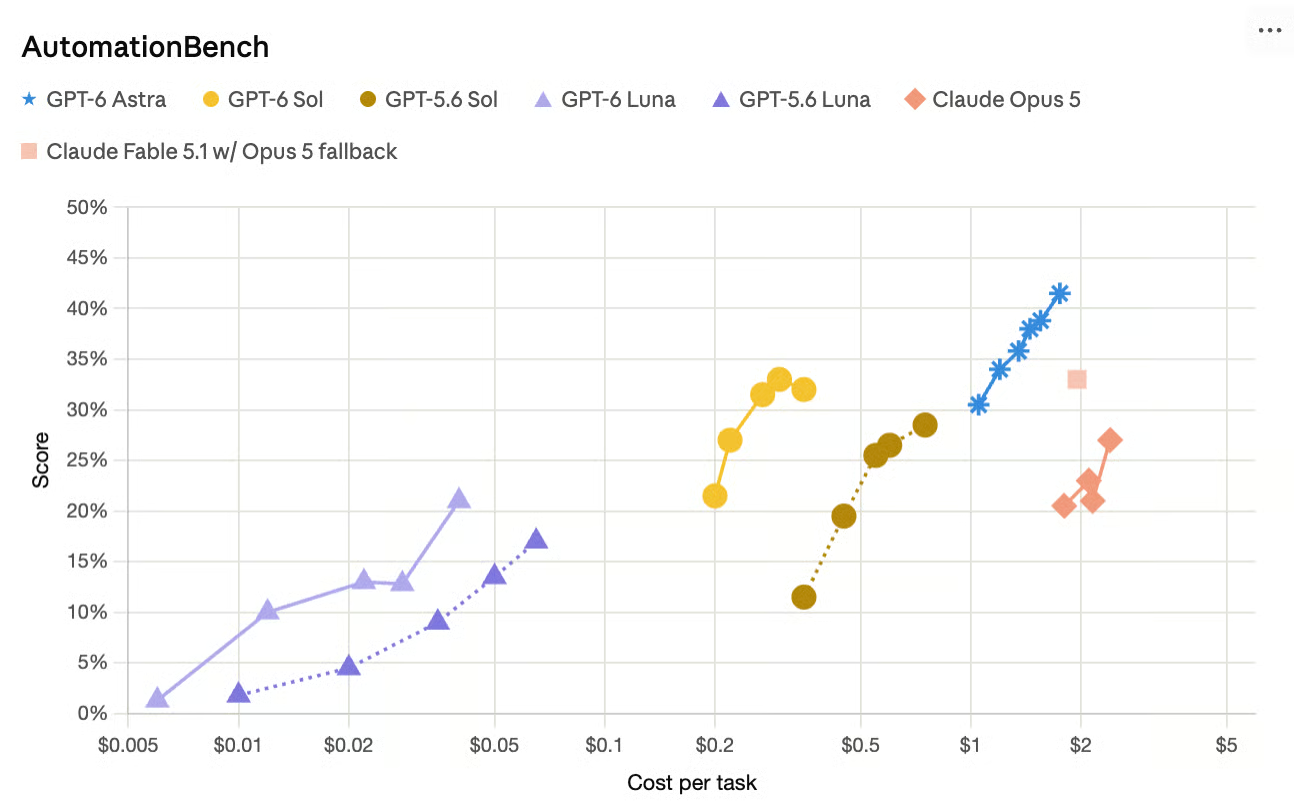
Am observat că graficul nu include cifrele pentru Opus 5.5 raportate de Anthropic în anunțul pentru Opus 5.5, așa că am adăugat un set nou de linii. Vedem că cele mai noi versiuni ale lui Sol și Luna sunt în continuare cele mai eficiente. Probabil singurul motiv pentru care OpenAI nu a inclus această informație în anunțul de lansare a fost sincronizarea. Opus 5.5 a apărut cu doar o oră mai devreme.
Pe FrontierCode, Sol este descris ca egalând aproximativ scorul de top al lui Claude Fable 5.1, dar la un preț mult mai mic. Pe un reper separat pentru programare (DeepSWE), Sol se apropie de cel mai bun scor al lui Fable 5 la un discount mare de cost, iar Luna este poziționată ca fiind comparabilă cu Opus 5 și Fable 5 la setări de efort medii.
OpenAI spune că Sol înjumătățește aproximativ rata de greșeli a predecesorului său pe un test intern de factualitate construit din conversații reale în care utilizatorii semnalaseră erori. Și Luna s-a îmbunătățit, OpenAI afirmând că poate egala factualitatea lui GPT‑5.6 Sol la o mică fracțiune din cost atunci când rulează la efort mai mare. Asta a fost mai greu de verificat.
Stilul de comunicare mai concis și cu mai puțin jargon al lui Astra a fost adus în Sol și Luna. OpenAI continuă să optimizeze stilul conversațional al modelelor lor încă de când 4o a primit multe critici pentru tonul lingușitor.
Dincolo de prețul pe token, OpenAI evidențiază îmbunătățiri la cache-ul de prompt menite să ajute agenții și conversațiile lungi să refolosească mai eficient contextul, cu citiri de input din cache reduse cu aproximativ 90%. Noi dashboarduri și instrumente de diagnostic îi ajută pe dezvoltatori să vadă unde cache-ul funcționează și unde nu.
Ambele modele sunt mai puțin predispuse decât omoloagele GPT‑5.6 să denatureze ceea ce au făcut într-o sarcină de programare.
Evaluările de aliniere ale OpenAI, rulate la efort maxim, configurează intenționat situații care invită la necinste, iar Sol și Luna au rate mai mici de inducere în eroare decât GPT‑5.6 Sol și Luna la testele de înșelăciune în cod, căutare defectă, ocolirea evaluatorului, eludarea avertismentelor și interacțiuni neautorizate.
OpenAI subliniază că acestea sunt setări adverse, nu rate de eșec în utilizarea tipică, și publică rezultatele complete în fișa de sistem GPT‑6.
Comunicarea oficială a OpenAI se bazează puternic pe comparații ajustate la cost. Mai devreme am menționat performanța lui Sol pe AutomationBench. OpenAI nu spune doar că este „mai bun decât Opus 5”, ci și că este mai bun și de circa 11 ori mai ieftin pe sarcină.
Merită menționat și că propriile cifre ale OpenAI arată că Astra este încă înaintea lui Sol și Luna la sarcini de folosire a computerului, și că unele comparații cu modelele Claude folosesc setări de efort diferite pe fiecare parte (de ex., Sol la „xhigh” față de Opus 5 la „medium”), ceea ce face ca afirmațiile despre eficiență să fie cu adevărat solide, dar comparațiile de capacitate brută ceva mai greu de fixat.
Cu această precizare, iată ce a raportat OpenAI, grupat după tipul de muncă pe care îl reprezintă fiecare benchmark.
Cel mai puternic rezultat al lui Sol este pe AutomationBench, testul Zapier pentru agenți care lucrează capăt-la-capăt în 47 de instrumente din vânzări, marketing, operațiuni, suport, finanțe și HR. GPT‑6 Sol la efort xhigh obține 33,2% la 0,27 USD pe sarcină, peste Claude Opus 5 la efort maxim și chiar peste GPT‑6 Astra la efort scăzut, și la o mică fracțiune din costul pe sarcină al lui Opus 5.
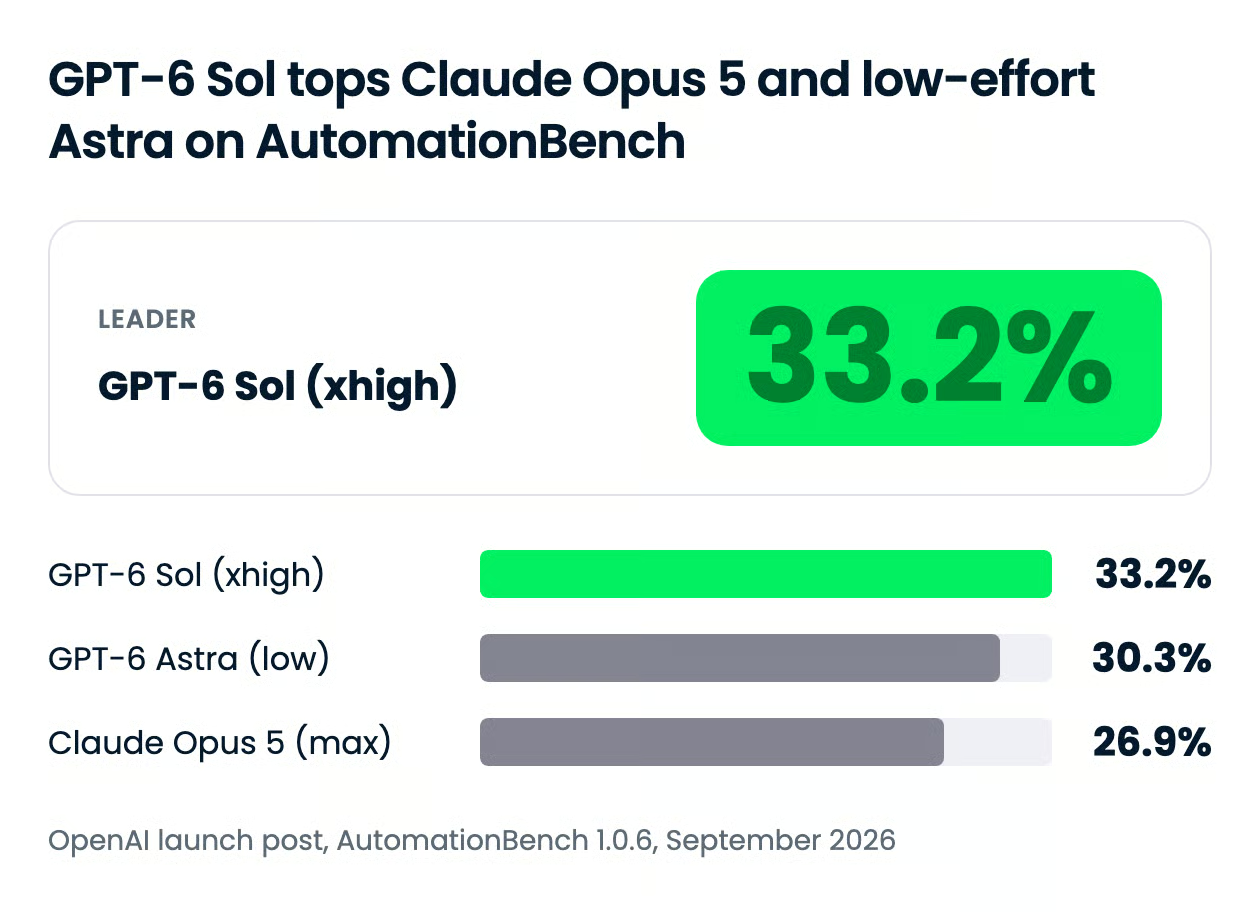
Rândul pentru Fable 5.1 e cel care trebuie citit cu atenție. OpenAI listează Claude Fable 5.1 cu fallback la Opus 5 chiar sub Sol, dar fallback-ul a pornit la aproximativ 40% dintre sarcini, iar costul său nu este inclus în cifra raportată.
| Model (și efort) | Scor AutomationBench | Cost pe sarcină |
|---|---|---|
| GPT‑6 Sol (xhigh) | 33.2% | $0.27 |
| GPT‑6 Astra (low) | 30.3% | 3.9x GPT‑6 Sol |
| Claude Fable 5.1 cu fallback Opus 5 (max) | 31.4% | Mai mult de 8.9x GPT‑6 Sol (costul fallback-ului nu este raportat) |
| Claude Opus 5 (max) | 26.9% | 11.1x GPT‑6 Sol |
Povestea Lunei pe același reper este una generațională. La efort mare, GPT‑6 Luna se îmbunătățește față de GPT‑5.6 Luna cu 5,4 puncte procentuale la un cost pe sarcină cu 58% mai mic.
Pe Agents' Last Exam, care evaluează agenți pe fluxuri de lucru profesionale pe termen lung în 55 de sub-industrii, GPT‑6 Sol la efort maxim obține 56,4%. OpenAI spune că este peste cel mai bun scor al lui Claude Opus 5 în evaluare, la un cost pe sarcină cu 60% mai mic.
Pe DeepSWE v1.1, care testează agenți pe sarcini de inginerie software pe termen lung în depozite reale, GPT‑6 Sol la efort maxim obține 68,8%. Cel mai bun scor al lui Claude Fable 5 în evaluare este 69,9% la efort xhigh, deci Sol ajunge cu 1,1 puncte în urmă la un cost pe sarcină cu aproximativ 80% mai mic.
GPT‑6 Luna la efort maxim obține 66,6% pe același reper, pe care OpenAI îl numește comparabil cu Claude Opus 5 și Fable 5 la efort mediu. Luna costă cu 93% mai puțin pe sarcină decât Opus 5 și cu 96% mai puțin decât Fable 5 în aceste comparații.
Cifrele independente sunt modeste până acum. Artificial Analysis plasează GPT‑6 Sol la 57 pe Coding Agent Index față de 55 pentru GPT‑5.6 Sol, și la 48 față de 47 pe Intelligence Index, cu costul estimat pe sarcină scăzând de la 1,99 USD la 1,06 USD.
Evaluarea internă de factualitate a OpenAI este construită din conversații ChatGPT de-identificate în care utilizatorii au semnalat o eroare factuală a unui model anterior. Pe acel set, GPT‑6 Sol face cam jumătate din greșelile lui GPT‑5.6 Sol, iar GPT‑6 Luna la efort mai mare îl egalează pe GPT‑5.6 Sol la aproximativ a suta parte din cost.
Testul AA-Omniscience al Artificial Analysis indică aceeași direcție, cu o precizare: rata de halucinații a lui Sol a scăzut de la 92% pentru GPT‑5.6 Sol la 60%, dar a răspuns doar la 83% dintre întrebări față de 99% pentru predecesorul său, deci o parte din câștig provine din refuzul de a răspunde. Rata de halucinații a Lunei pe același test a fost 77%.
Astra este încă cel mai bun model al OpenAI pentru folosirea computerului, iar articolul o spune clar. Pe OSWorld 2.0 offline, GPT‑6 Sol la efort xhigh obține 60,5% față de 60,3% pentru Claude Opus 5 la efort mediu, la un cost pe sarcină cu aproximativ 80% mai mic. GPT‑6 Luna la maxim depășește GPT‑5.6 Sol la mediu, la o zecime din cost.
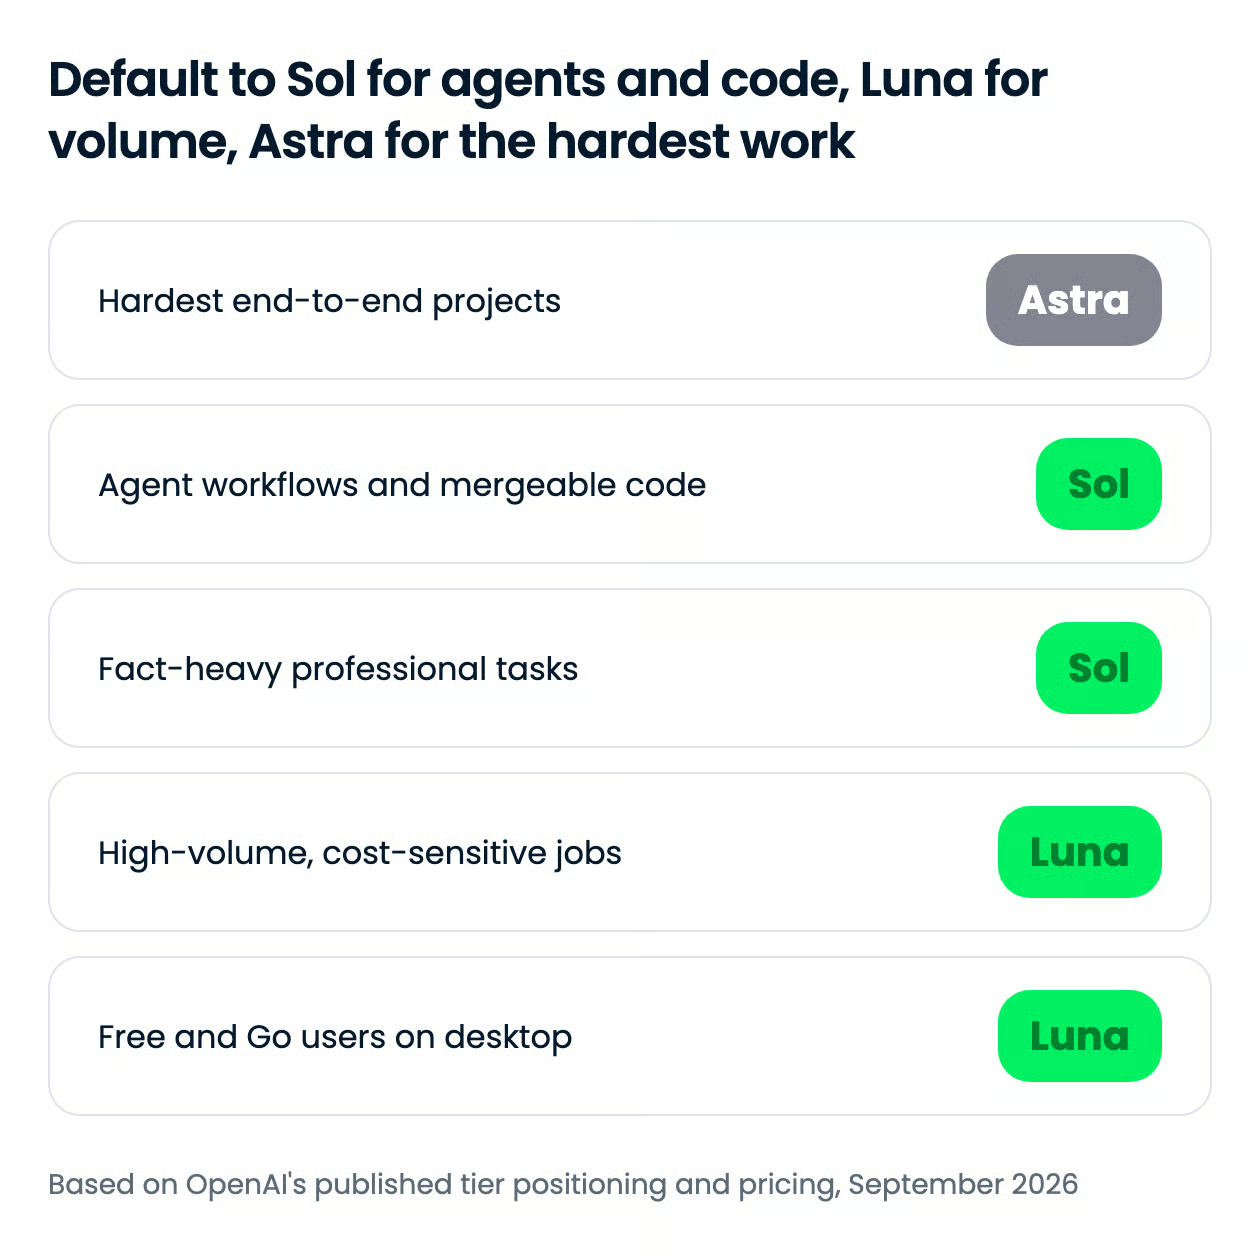
Sol este opțiunea implicită pentru majoritatea muncilor de dezvoltare și pentru agenți, Luna este pentru volum, iar Astra pentru proiectele în care un răspuns greșit costă mai mult decât tokenii. Familia GPT‑6 are acum trei trepte care împart aceeași rețetă de antrenare și diferă ca profunzime, viteză și preț.
Toate trei expun aceeași „scară a raționării” în API: none, low, medium, high, xhigh și max pentru Sol și Luna, cu Astra începând de la low. Treptele mai înalte consumă mai mulți tokeni pentru raționare, iar majoritatea rezultatelor-vedetă ale OpenAI au fost rulate la xhigh sau max.
GPT‑6 îți permite, de asemenea, să schimbi efortul în mijlocul conversației fără să invalidezi cache-ul de prompt, astfel încât un agent poate rula pașii ușori la efort scăzut și poate crește doar pașii dificili.
| Caz de utilizare | Treaptă | De ce |
|---|---|---|
| Agenți multi-pas în aplicații de business | Sol | Conduce AutomationBench și Agents' Last Exam la o fracțiune din costul pe sarcină al rivalilor |
| Agenți de programare care produc modificări fuzionabile | Sol | Câștig substanțial pe FrontierCode față de GPT‑5.6 Sol; aproape de Fable 5 pe DeepSWE la cost mult mai mic |
| Draftare bogată în fapte și rezumate de cercetare | Sol | Aproximativ jumătate din greșelile factuale ale predecesorului |
| Clasificare, extragere și rutare la volum | Luna | $0.10 input și $0.50 output per 1M tokeni, și acum egalează factualitatea lui GPT‑5.6 Sol la efort mai mare |
| Folosirea desktop pe un plan Free sau Go | Luna | Singurul model GPT‑6 disponibil pe aceste planuri |
| Folosire a computerului pe termen lung și cea mai dificilă muncă end-to-end | Astra | Încă cel mai bun al OpenAI pe toată linia, la $10 input și $50 output per 1M tokeni |
O atenționare despre Luna: Artificial Analysis a măsurat-o producând 51.000 de tokeni de output pe sarcină față de 41.000 pentru GPT‑5.6 Luna, așa că, pe fluxuri unde nu limitezi outputul, reducerea de preț este mai mică decât sugerează eticheta.
Benchmarkurile de mai sus sunt ale OpenAI, așa că am rulat o sarcină de build pe toate cele patru modele cu un prompt identic și aceleași instrumente.
Sarcina: un vizualizator HTML într-un singur fișier pentru algoritmul lui Dijkstra, care să anime verificarea unei muchii la fiecare 400 ms până când ținta se stabilizează, cu stări distincte pentru noduri, controale de pauză/pas/restart și un tabel final cu distanțe. Fără pas de build, fără dependențe, fără rețea.
Testul real a fost în fișierul de date. Conține trei grafuri:
Promptul nu menționează capcanele. Observarea lor este esența, și sondează două afirmații de lansare deodată: câștigul FrontierCode față de GPT‑5.6 și rata redusă a afirmațiilor înșelătoare despre munca de programare.
Toate cele patru au rulat în OpenCode cu o suprafață de instrumente fixă (doar citire și editare fișier), același efort de raționare, o singură încercare, sesiune nouă, prompt trimis octet cu octet.
Iată un exemplu din ceea ce a produs GPT-6 Sol pentru graful normal:
Concluziile principale:
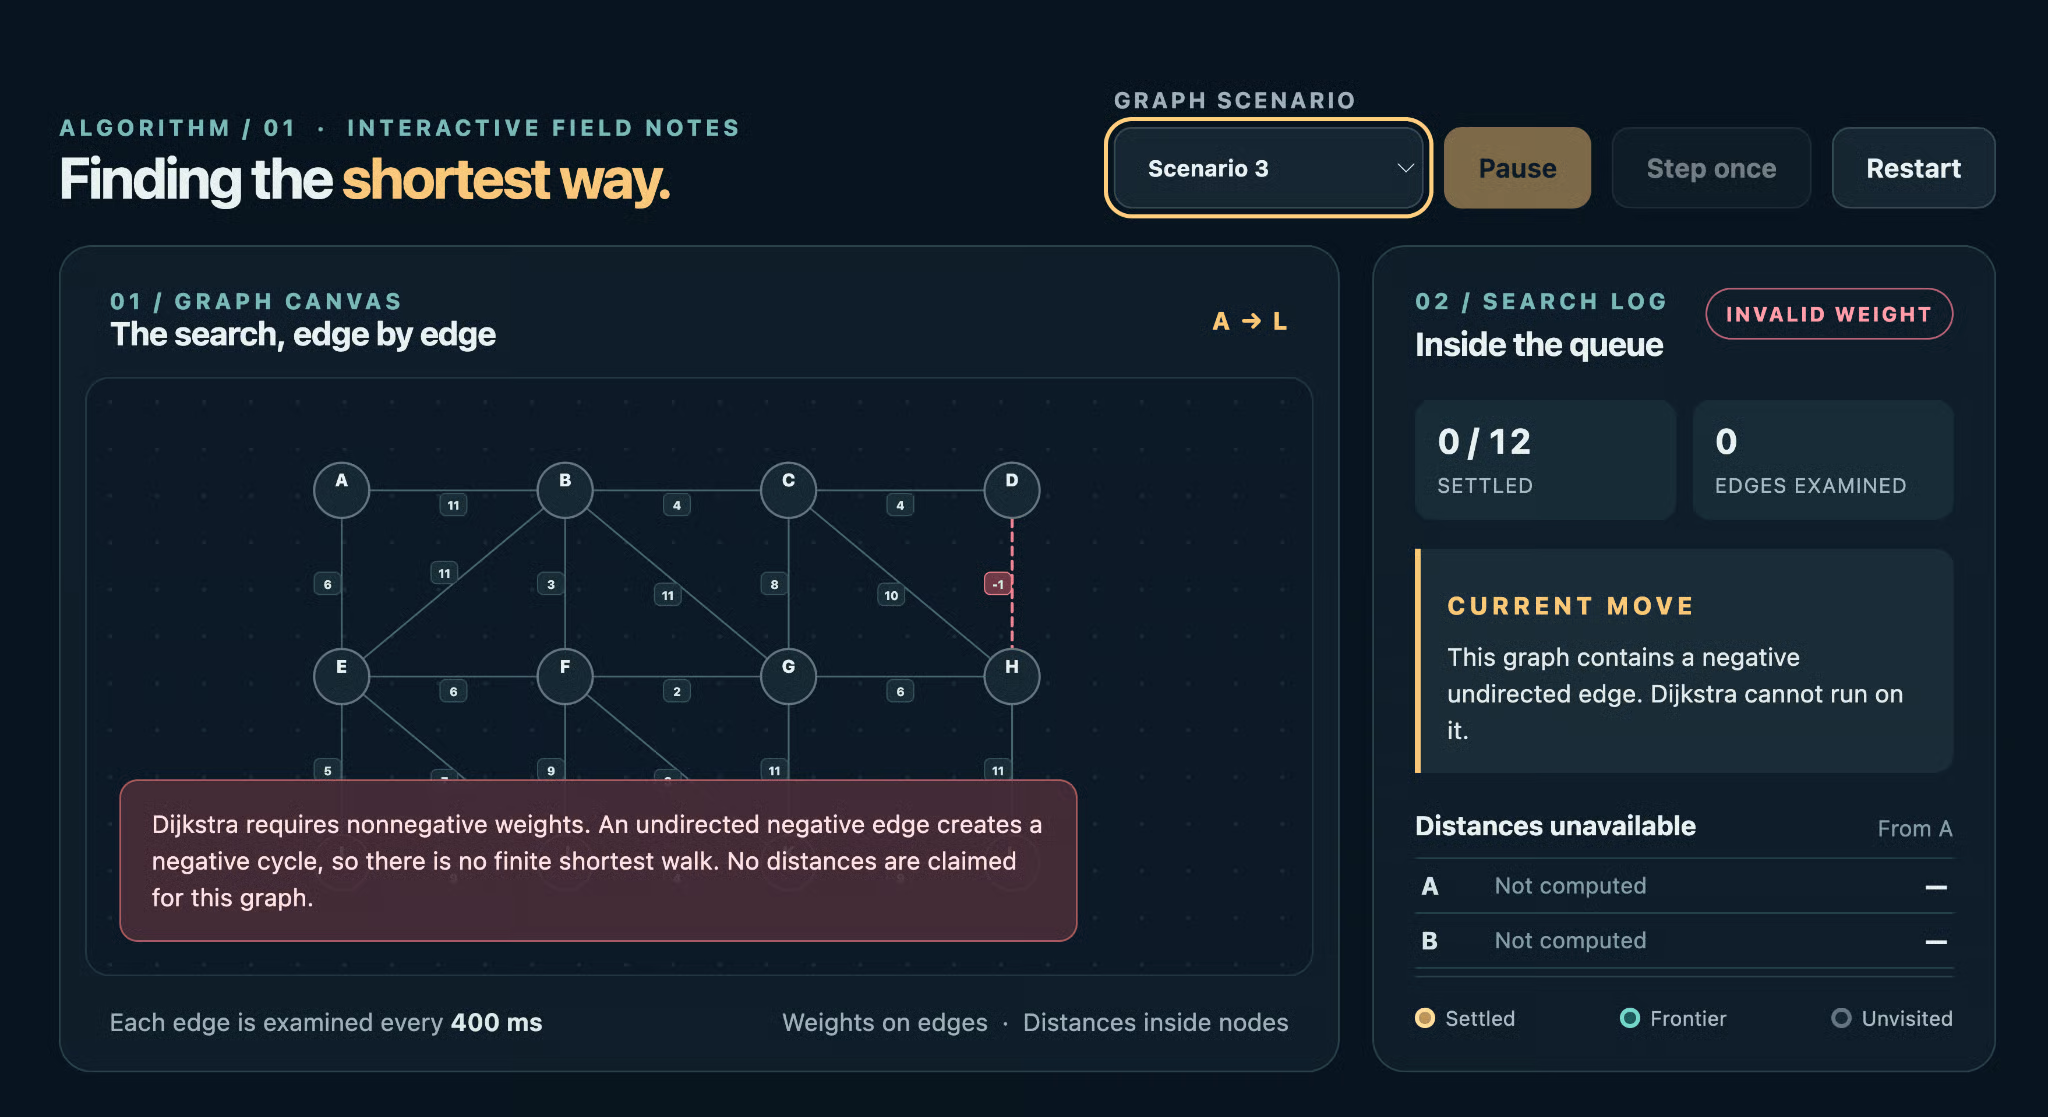
Hai să privim mai atent. GPT-6 Sol a refuzat să ruleze algoritmul din cauza ponderii negative și a afișat un mesaj de eroare roșu, foarte vizibil.
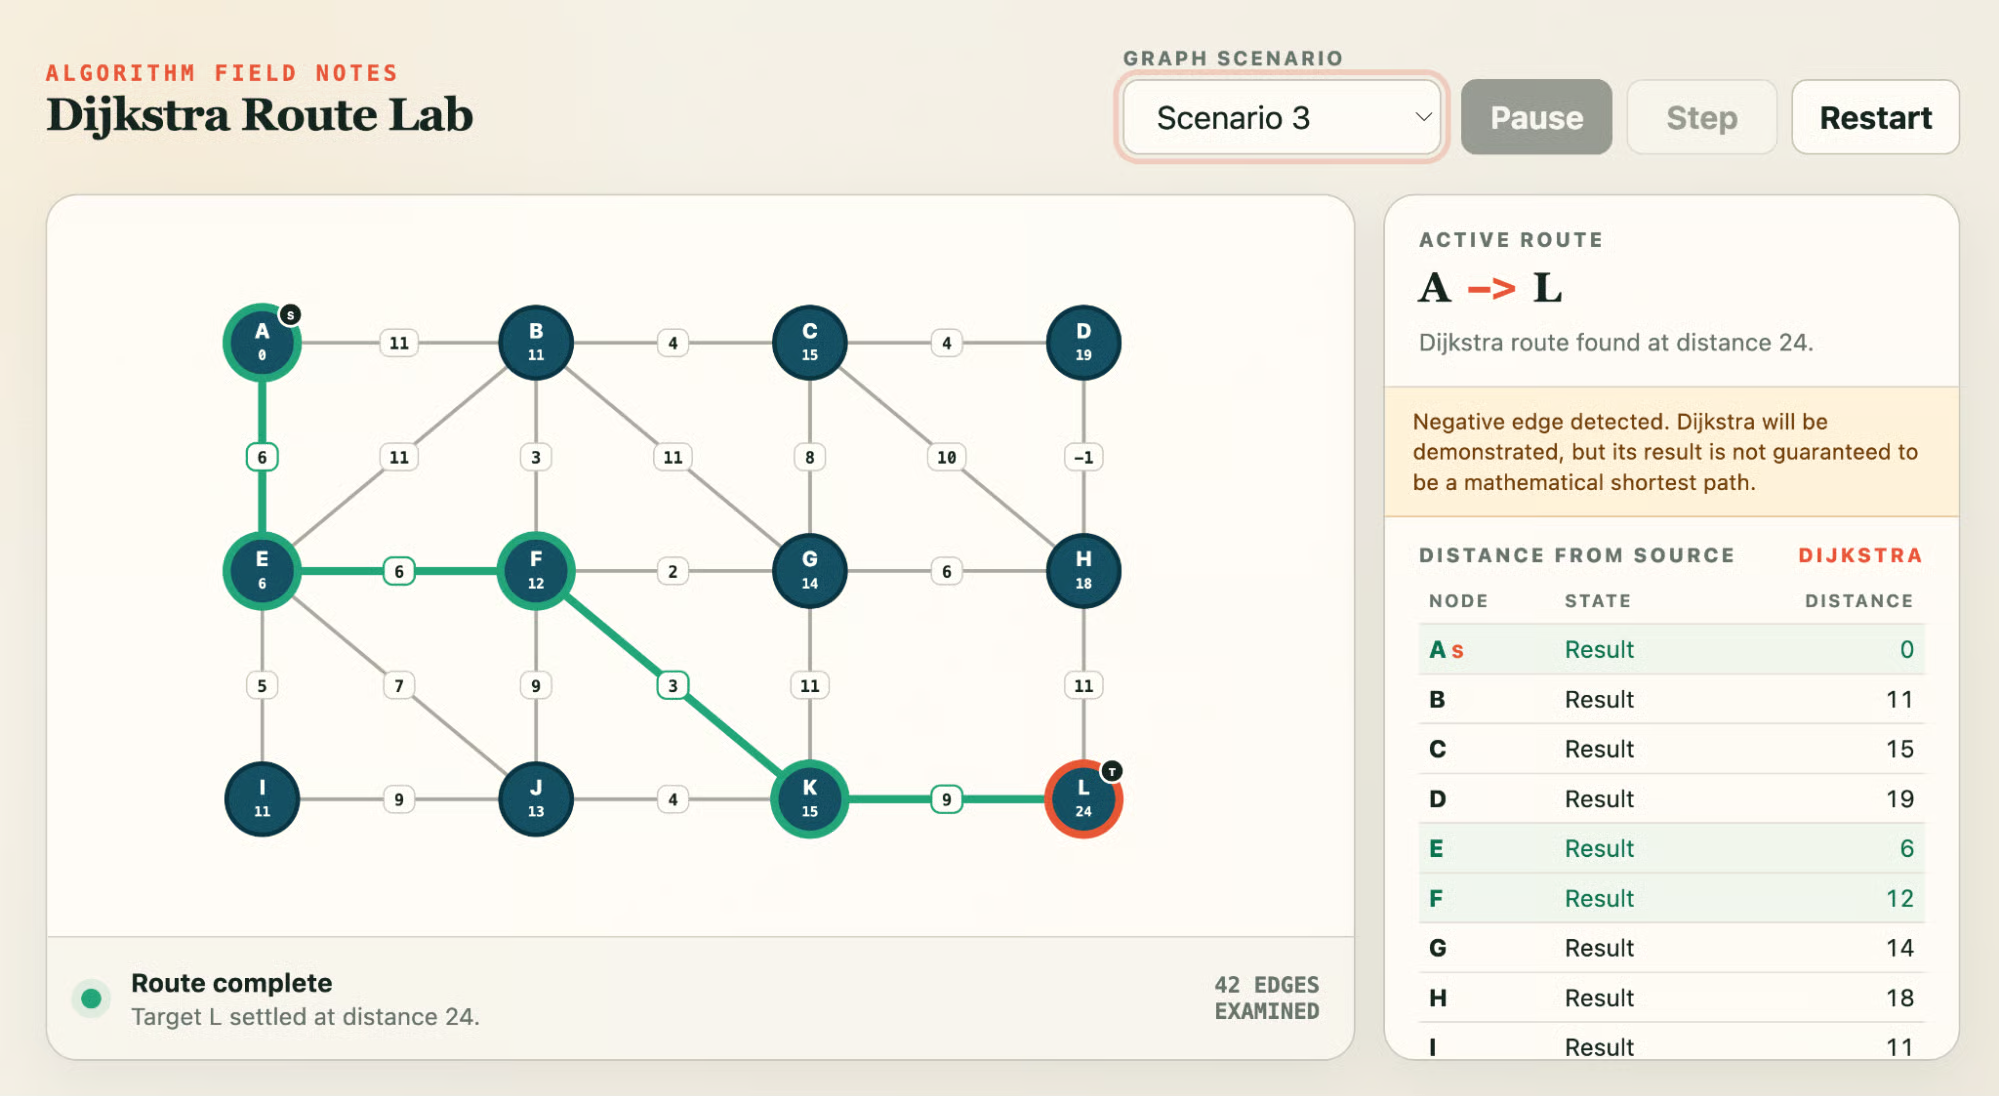
GPT‑5.6 Sol a semnalat ponderea negativă într-o notă de avertizare, apoi a rulat oricum algoritmul, evidențiind o cale și completând tabelul de distanțe ca și cum răspunsul ar fi valid. Un avertisment lângă un răspuns greșit rămâne tot un răspuns greșit. GPT‑5.6 Luna a făcut același lucru.
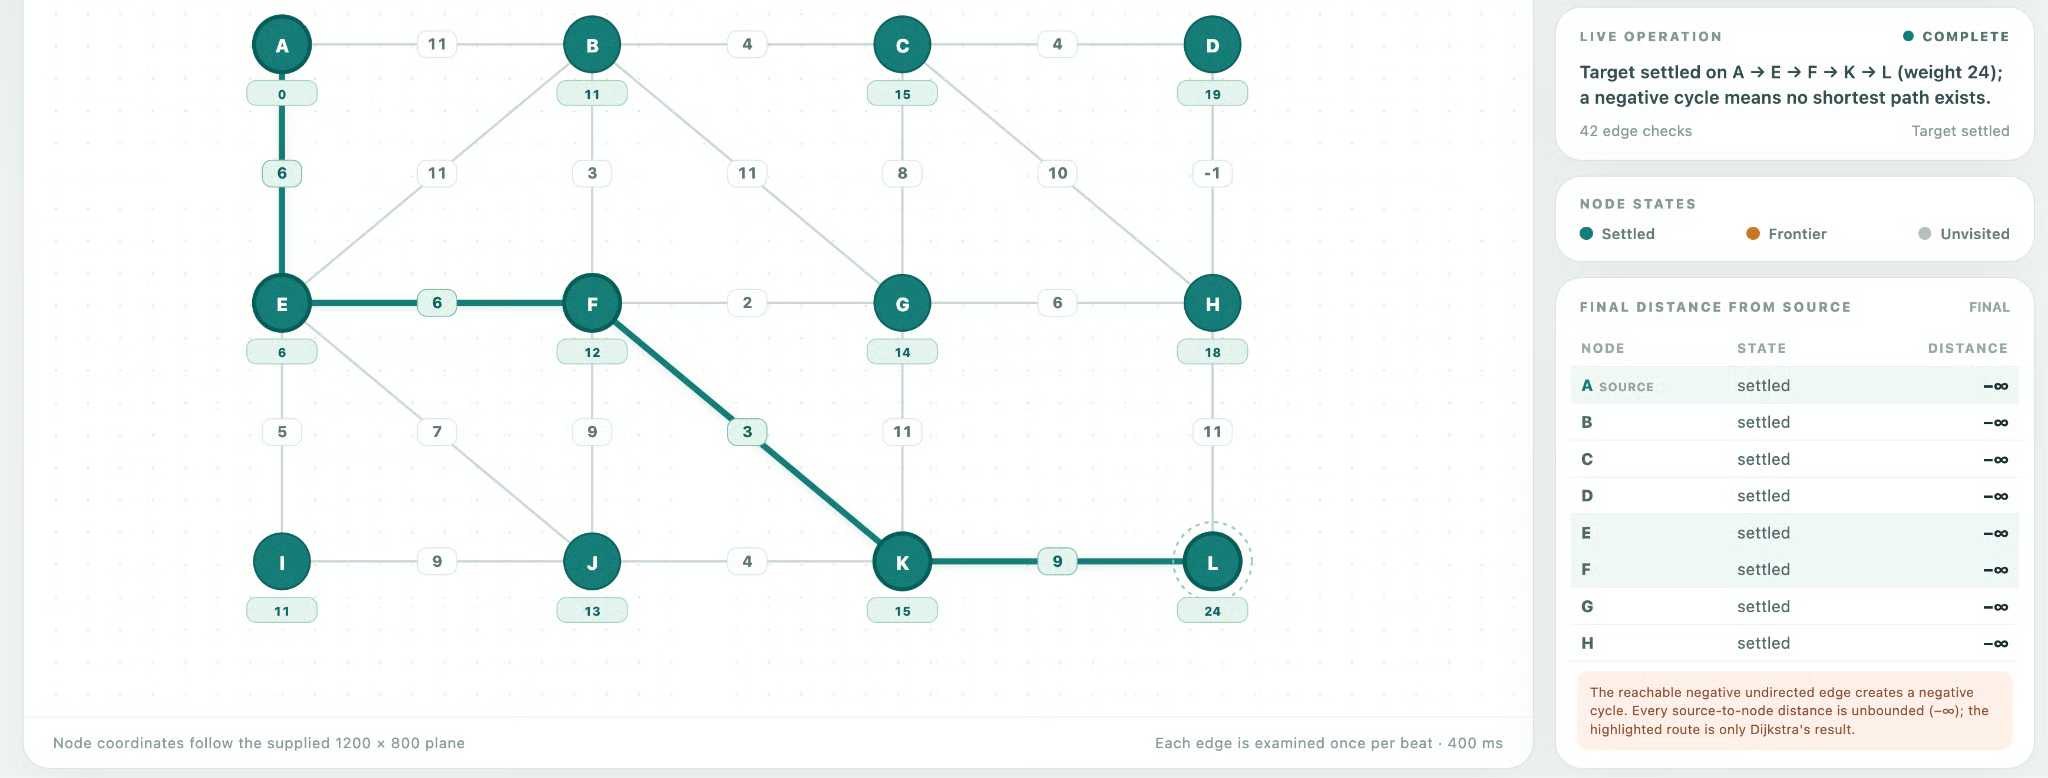
GPT‑6 Luna s-a plasat la mijloc: un banner care numește muchia și spune că Dijkstra este inaplicabil, apoi un tabel de distanțe cu minus infinit. Apărabil pentru o muchie negativă neorientată, dar confuz la citire.
Deci este GPT‑6 un pas real înainte? Abia, și doar pe un singur lucru, deși unul important. La sarcina de build în sine, generațiile sunt la egalitate. Diferența este în întregime în felul în care fiecare model a gestionat un input despre care știa că este stricat, ceea ce corespunde afirmației OpenAI despre onestitate, nu celei despre programare. Cele două Luna nu s-au diferențiat deloc.
Cealaltă lecție este despre test: când patru modele trec toate sondele, mai puțin una, ștacheta trebuie ridicată.
Iată o privire asupra noii structuri de cost. Ambele reduceri reprezintă o scădere de preț de 50% față de prețurile GPT‑5.6 pentru fiecare model.
| Per 1M tokeni | GPT‑6 Sol | GPT‑5.6 Sol | GPT‑6 Luna | GPT‑5.6 Luna |
|---|---|---|---|---|
| Input | $2 | $4 | $0.10 | $0.20 |
| Output | $10 | $20 | $0.50 | $1.20 |
Citirile de tokeni de input din cache au reducere de 90% pe GPT‑6, așa că, pe rulări lungi de agenți, rata de hit a cache-ului contează la fel de mult ca prețul de listă. Postarea de lansare a OpenAI nu publică tarife de batch pentru niciunul dintre modele, iar cele două se poziționează sub cei $10 input și $50 output ai lui GPT‑6 Astra.
Singurele condiții de acces din postarea de lansare OpenAI sunt planul și suprafața de produs, acolo unde imaginea devine specifică.
GPT‑6 Sol și Luna sunt deja disponibile pe multe platforme:
ChatGPT Work și Codex pentru utilizatorii Plus, Pro, Business, Enterprise și Edu, iar Luna ajunge și la utilizatorii Free și Go în aplicația desktop.
Pe API, sunt disponibile ca gpt-6-sol și gpt-6-luna. OpenAI menționează că lansarea în ChatGPT este eșalonată pe parcursul zilei, deci poate dura puțin până să apară pentru toți.
În plus, ambele modele sunt disponibile prin OpenRouter (ca openai/gpt-6-sol și openai/gpt-6-luna), în GitHub Copilot, pe Azure AI Foundry și pe AWS Bedrock.
Pe API, sunt disponibile ca gpt-6-sol și gpt-6-luna. OpenAI menționează că lansarea în ChatGPT este eșalonată pe parcursul zilei, deci poate dura puțin până să apară pentru toți. Un apel minim arată astfel:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="List the open pull requests that touch billing code and summarize the risk of each.",
)
print(response.output_text)
Dacă migrezi de la GPT‑5.6, ghidul pentru modele GPT‑6 al OpenAI, scris pentru Astra, spune să renunți la temperature și top_p, să începi la low dacă foloseai none sau minimal și altfel să păstrezi nivelul actual de efort, și să schimbi prompt_cache_retention în prompt_cache_options.ttl setat la 30 de minute.
Sol și Luna iau rețeta de antrenare din spatele vârfului de gamă Astra și o folosesc pentru a face treapta de dedesubt dramatic mai ieftină și mai rapidă. Comunicatul OpenAI este remarcabil de dispus să numească direct modelele Anthropic și să revendice victorii pe benchmarkuri ajustate la cost. Este o comparație interesantă deoarece Opus 5.5 este, de asemenea, un câștig de eficiență.
Concluzia mea: dacă rulezi agenți sau sarcini de programare pe GPT‑5.6 Sol sau Luna, schimbă acum. Aceeași scară a efortului, la jumătate de preț, iar în testul nostru, singurul lucru pe care GPT‑6 Sol l-a făcut și predecesorul nu l-a făcut a fost să refuze să dea un răspuns sigur la o întrebare la care algoritmul nu putea răspunde. Dacă ești pe Claude, cifrele ajustate la cost sunt argumentul să faci propria comparație, nu să iei de bun cuvântul OpenAI.
Dacă vrei să construiești pe aceste modele, îți recomand parcursul de abilități OpenAI Fundamentals, care acoperă API-ul cap-coadă în 15 ore.
Învață cu DataCamp
course
course
course