Courses
ทำความเข้าใจ Prompt Engineering
1 ชม.
232.4K
OpenAI เพิ่งขยายตระกูล GPT‑6 ด้วยโมเดลใหม่ 2 รุ่น: GPT‑6 Sol และ GPT‑6 Luna ซึ่งวางตำแหน่งต่ำกว่ารุ่นเรือธง GPT‑6 Astra ที่เขียนถึงไปเมื่อต้นเดือนนี้ ทั้ง Sol และ Luna มาพร้อมส่วนลดราคาหนัก (ลด 50% จากราคาในยุค GPT‑5.6) และยังมีพัฒนาการด้านการเขียนโค้ดและการทำงานแบบอัตโนมัติของเวิร์กโฟลว์
บังเอิญหรือไม่บังเอิญ Anthropic ก็ออก Claude Opus 5.5 ในวันเดียวกัน (วันนี้) พร้อมแนวทางคล้ายกัน: ใช้วิธีเทรนพื้นฐานแบบเดียวกับรุ่นเรือธง แต่ปรับให้คุ้มค่าและรวดเร็วขึ้น
หากต้องการรู้จักรุ่นเรือธงที่ทั้งสองรุ่นวางอยู่ใต้ ลองดู บทเรียน API ของ GPT‑6 Astra และบทเปรียบเทียบ GPT‑6 Astra กับ Claude Fable 5.1 ของเรา
Astra ยังเป็นโมเดลที่ทรงพลังและจัดแนวดีที่สุดของ OpenAI สำหรับงานที่โหดที่สุด แต่ Sol และ Luna ถูกสร้างมาเพื่อนำแนวทางการเทรนส่วนใหญ่แบบเดียวกัน และประสิทธิภาพที่ตามมาในงานโค้ด การใช้คอมพิวเตอร์ ฯลฯ ลงมาสู่ชั้นราคาที่ถูกกว่าและเร็วกว่ามาก
ให้นึกถึงความสัมพันธ์แบบเดียวกับที่ Opus 5.5 มีกับ Fable 5.1: ไม่ใช่การบุกเบิกเส้นขอบฟ้าใหม่ แต่เป็นประสิทธิภาพใกล้ระดับแนวหน้าในต้นทุนเพียงเสี้ยวเดียว
มีหลายอย่างที่น่าสนใจ:
ราคา API ของ Sol ลดลงครึ่งหนึ่งจากก่อนหน้า ส่วนของ Luna ลดลงมากกว่าครึ่งด้วยซ้ำ รายละเอียดเพิ่มเติมดูได้ในส่วนราคา
บน AutomationBench ซึ่งทดสอบเอเจนต์ในงานขาย การตลาด ปฏิบัติการ ซัพพอร์ต ไฟแนนซ์ ฯลฯ Sol ที่ตั้งค่า effort สูงสุดทำคะแนนเหนือ Claude Opus 5 และทำได้ที่ต้นทุนต่อภารกิจเพียงเสี้ยวเดียวของ Opus 5 ส่วน Luna ก็พัฒนาขึ้นอย่างมีนัยสำคัญเมื่อเทียบกับรุ่น GPT‑5.6 ในขณะที่ราคาต่อภารกิจถูกลงชัดเจน OpenAI มีภาพสวยๆ ซึ่งได้ทำซ้ำไว้ที่นี่:
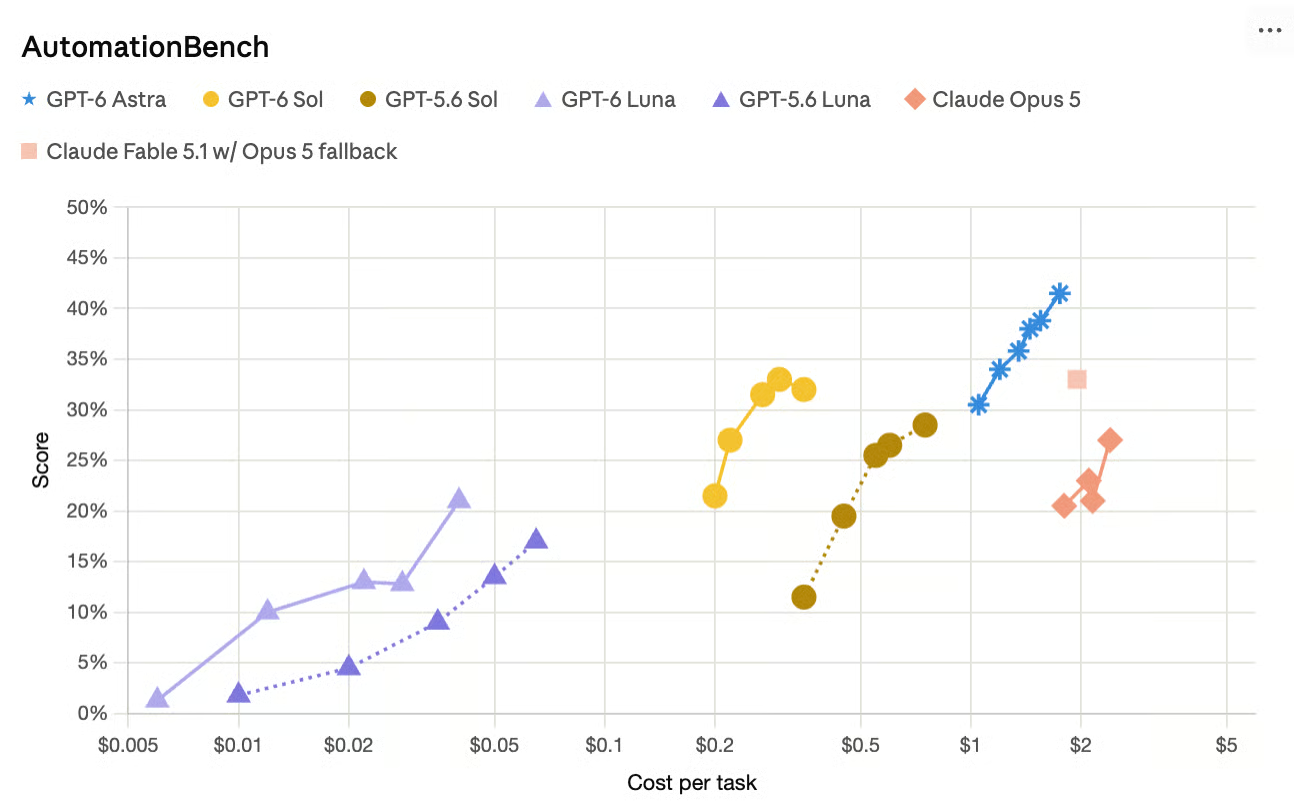
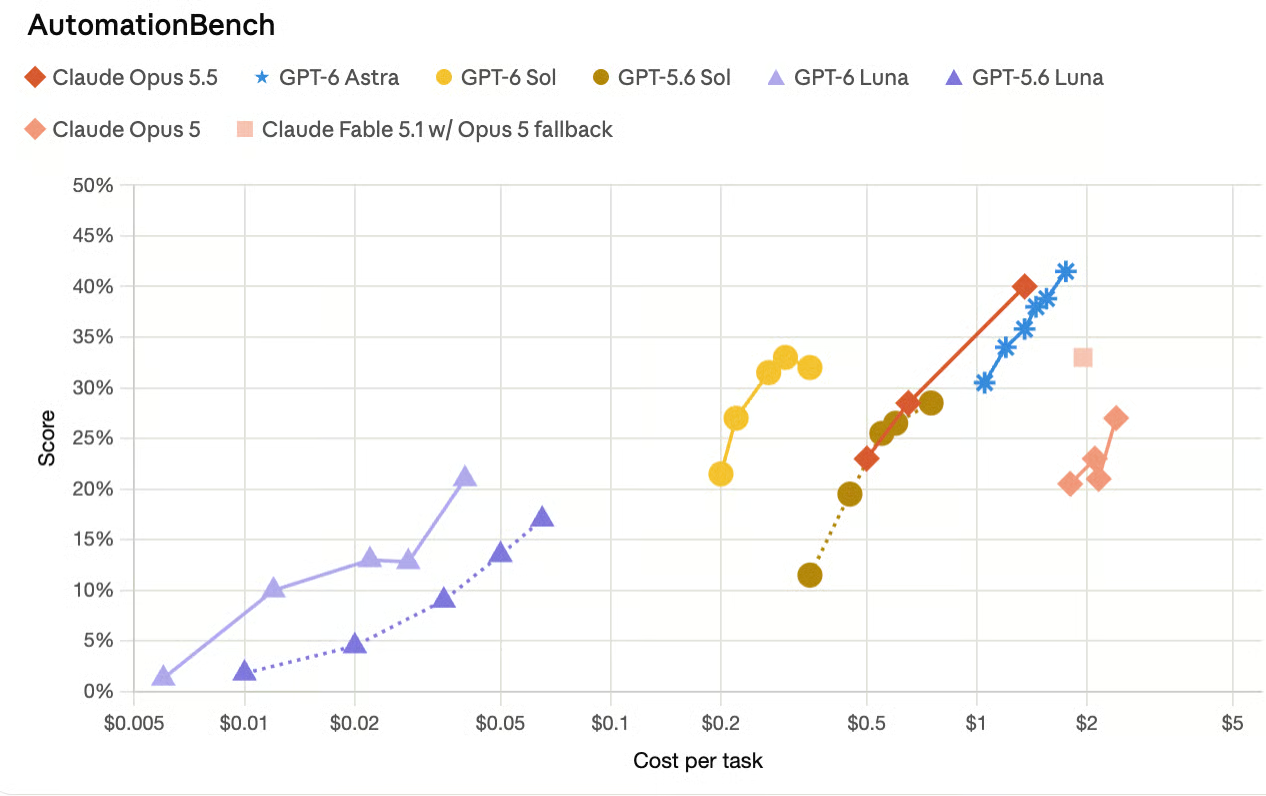
สังเกตว่าแผนภาพไม่ได้รวมตัวเลขของ Opus 5.5 ที่ Anthropic รายงานไว้ใน ประกาศ Opus 5.5 จึงได้เพิ่มเส้นอีกชุดหนึ่งให้เห็นว่า Sol และ Luna เวอร์ชันล่าสุดยังคงมีประสิทธิภาพต่อราคาดีที่สุด เป็นไปได้ว่าเหตุผลที่ OpenAI ไม่ใส่ข้อมูลนี้ในประกาศเปิดตัวก็เพราะจังหวะเวลา Opus 5.5 เพิ่งปล่อยก่อนหน้าประมาณหนึ่งชั่วโมง
บน FrontierCode มีการระบุว่า Sol ทำคะแนนใกล้เคียงคะแนนสูงสุดของ Claude Fable 5.1 แต่มีราคาต่ำกว่ามาก บนเบนช์มาร์กโค้ดอีกชุด (DeepSWE) Sol เข้าใกล้คะแนนสูงสุดของ Fable 5 ที่ส่วนลดต้นทุนอย่างมาก และ Luna ถูกวางตำแหน่งว่าใกล้เคียงกับ Opus 5 และ Fable 5 ที่การตั้งค่าความพยายามระดับกลาง
OpenAI ระบุว่า Sol ลดอัตราความผิดพลาดลงประมาณครึ่งหนึ่งจากรุ่นก่อน บนแบบทดสอบ factuality ภายในที่สร้างจากบทสนทนาจริงซึ่งผู้ใช้เคยรายงานข้อผิดพลาด ส่วน Luna ก็พัฒนาขึ้นด้วย โดย OpenAI อ้างว่าสามารถทำ factuality เทียบเท่า GPT‑5.6 Sol ได้ที่ต้นทุนเพียงเสี้ยวเมื่อรันที่ effort สูง ข้อนี้ตรวจสอบยากกว่า
สไตล์การสื่อสารของ Astra ที่กระชับและลดศัพท์แสงได้ถูกนำมาสู่ Sol และ Luna ด้วย OpenAI ปรับสไตล์การสนทนาของโมเดลอย่างต่อเนื่องตั้งแต่ 4o เคยถูกวิจารณ์เรื่องการเออออตามใจเกินไป
นอกเหนือจากราคาแบบต่อโทเคน OpenAI เน้นการปรับปรุงการแคชพรอมป์ตเพื่อช่วยให้เอเจนต์และบทสนทนายาวๆ ใช้คอนเท็กซ์ซ้ำได้มีประสิทธิภาพมากขึ้น โดยการอ่านอินพุตจากแคชมีส่วนลดราว 90% มีแดชบอร์ดและเครื่องมือวินิจฉัยใหม่เพื่อช่วยนักพัฒนาเห็นว่าการแคชทำงานหรือไม่ทำงานตรงไหน
ทั้งสองโมเดลมีแนวโน้มที่จะไม่บิดเบือนสิ่งที่ทำไว้ในงานโค้ด น้อยกว่าคู่กันในยุค GPT‑5.6
การประเมิน alignment ของ OpenAI เมื่อรันที่ effort สูงสุด ตั้งใจสร้างสถานการณ์ชวนให้ไม่ซื่อสัตย์ และ Sol กับ Luna ให้ค่า deception ต่ำกว่า GPT‑5.6 Sol และ Luna ในการทดสอบการหลอกลวงด้านโค้ด การค้นหาที่พัง การเลี่ยงผู้ตรวจ การเลี่ยงคำเตือน และการโต้ตอบที่ไม่ได้รับอนุญาต
OpenAI เน้นว่านี่เป็นการตั้งค่าเชิงปฏิปักษ์ ไม่ใช่อัตราความล้มเหลวในการใช้งานทั่วไป และเผยแพร่ผลเต็มใน system card ของ GPT‑6
ประกาศของ OpenAI เองพึ่งพาการเปรียบเทียบที่ปรับตามต้นทุนอย่างมาก ก่อนหน้านี้ได้กล่าวถึงผลงานของ Sol บน AutomationBench OpenAI ไม่ได้บอกแค่ว่า "ดีกว่า Opus 5" แต่บอกว่าดีกว่า และ ถูกกว่าต่อภารกิจราว 11 เท่า
นอกจากนี้ควรสังเกตว่าตัวเลขของ OpenAI เองแสดงให้เห็นว่า Astra ยังนำหน้า Sol และ Luna ในงานใช้คอมพิวเตอร์ และบางการเปรียบเทียบกับรุ่นของ Claude ใช้การตั้งค่า effort ต่างกันระหว่างกัน (เช่น Sol ที่ "xhigh" เทียบกับ Opus 5 ที่ "medium") ซึ่งทำให้ข้ออ้างด้านประสิทธิภาพต่อราคาน่าเชื่อมาก แต่การเปรียบเทียบศักยภาพดิบจับต้องยากขึ้นเล็กน้อย
ด้วยข้อแม้ดังกล่าว นี่คือสิ่งที่ OpenAI รายงาน โดยจัดกลุ่มตามประเภทงานที่แต่ละเบนช์มาร์กเป็นตัวแทน
ผลลัพธ์ที่แข็งแกร่งที่สุดของ Sol คือบน AutomationBench แบบทดสอบเอเจนต์ของ Zapier ที่ทำงานปลายทางถึงปลายทางกับ 47 เครื่องมือในงานขาย การตลาด ปฏิบัติการ ซัพพอร์ต ไฟแนนซ์ และ HR GPT‑6 Sol ที่ effort ระดับ xhigh ได้ 33.2% ที่ $0.27 ต่อภารกิจ เหนือ Claude Opus 5 ที่ effort สูงสุด และยังเหนือ GPT‑6 Astra ที่ effort ต่ำ ทั้งยังมีต้นทุนต่อภารกิจเพียงเสี้ยวของ Opus 5
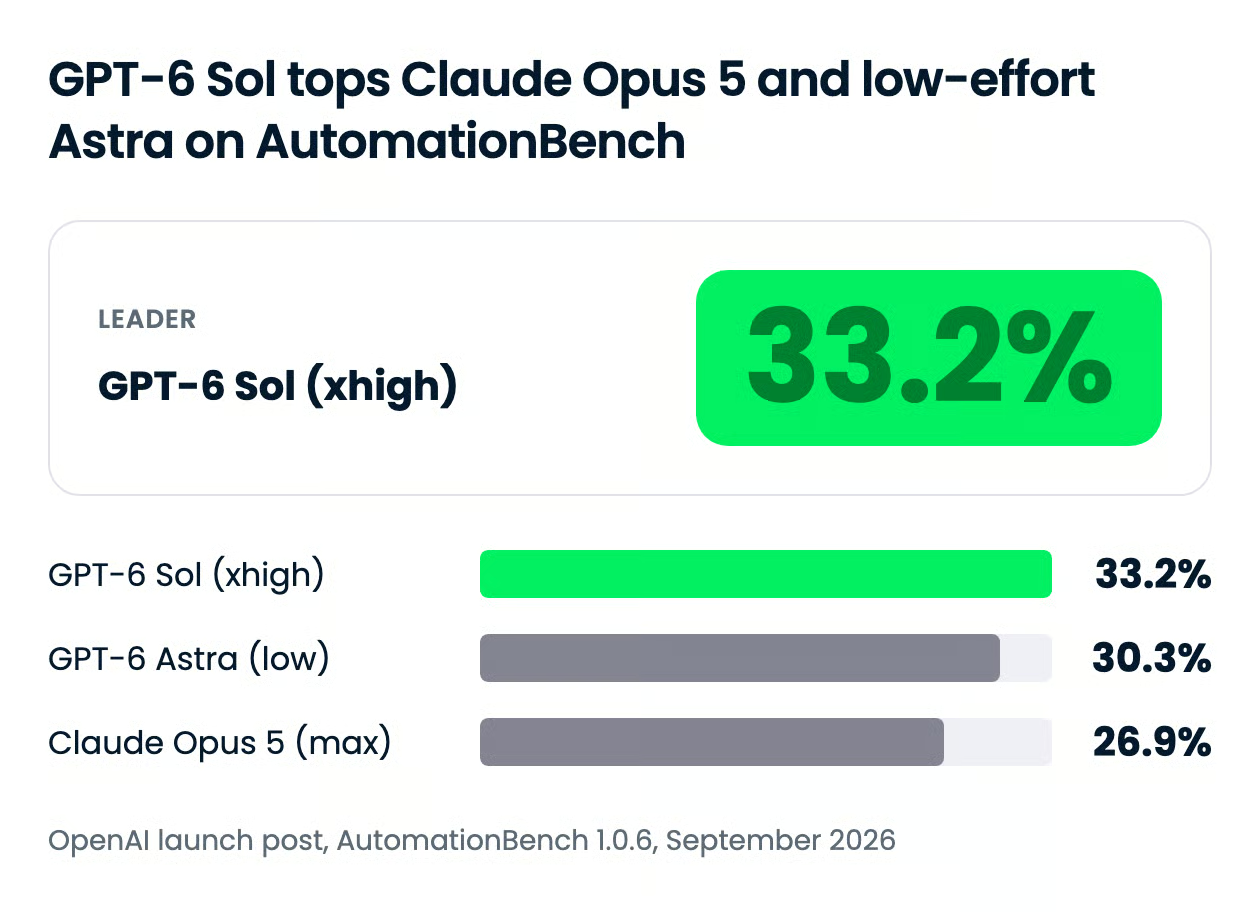
แถวของ Fable 5.1 ต้องอ่านอย่างระมัดระวัง OpenAI ลงรายการ Claude Fable 5.1 พร้อม fallback ไป Opus 5 อยู่ถัดลงมาจาก Sol แต่ fallback ทำงานในประมาณ 40% ของภารกิจ และต้นทุน fallback ไม่ถูกนับรวมในตัวเลขที่รายงาน
| โมเดล (และ effort) | คะแนน AutomationBench | ต้นทุนต่อภารกิจ |
|---|---|---|
| GPT‑6 Sol (xhigh) | 33.2% | $0.27 |
| GPT‑6 Astra (low) | 30.3% | 3.9 เท่าของ GPT‑6 Sol |
| Claude Fable 5.1 พร้อม Opus 5 fallback (max) | 31.4% | มากกว่า 8.9 เท่าของ GPT‑6 Sol (ไม่รวมต้นทุน fallback) |
| Claude Opus 5 (max) | 26.9% | 11.1 เท่าของ GPT‑6 Sol |
สำหรับ Luna บนเบนช์มาร์กเดียวกันเป็นเรื่องของการก้าวกระโดดข้ามรุ่น ที่ effort สูง GPT‑6 Luna ดีขึ้นจาก GPT‑5.6 Luna 5.4 จุด เปอร์เซ็นต์ ที่ต้นทุนต่อภารกิจลดลง 58%
บน Agents' Last Exam ซึ่งประเมินเอเจนต์ในเวิร์กโฟลว์สายอาชีพระยะยาวทั่ว 55 อุตสาหกรรมย่อย GPT‑6 Sol ที่ effort สูงสุดทำได้ 56.4% OpenAI ระบุว่าเหนือคะแนนดีที่สุดของ Claude Opus 5 ในการประเมินนี้ ที่ต้นทุนต่อภารกิจต่ำกว่าราว 60%
บน DeepSWE v1.1 ซึ่งทดสอบเอเจนต์ในงานวิศวกรรมซอฟต์แวร์ระยะยาวในรีโพจริง GPT‑6 Sol ที่ effort สูงสุดได้ 68.8% คะแนนที่ดีที่สุดของ Claude Fable 5 ในการประเมินนี้คือ 69.9% ที่ effort ระดับ xhigh ดังนั้น Sol ตามหลัง 1.1 คะแนน ที่ต้นทุนต่อภารกิจต่ำกว่าราว 80%
GPT‑6 Luna ที่ effort สูงสุดได้ 66.6% บนเบนช์มาร์กเดียวกัน ซึ่ง OpenAI บอกว่าใกล้เคียงกับ Claude Opus 5 และ Fable 5 ที่ effort ระดับกลาง Luna มีต้นทุนต่อภารกิจต่ำกว่า Opus 5 93% และต่ำกว่า Fable 5 96% ในการเปรียบเทียบดังกล่าว
ตัวเลขอิสระยังมีไม่มาก Artificial Analysis ให้ GPT‑6 Sol ได้ 57 บนดัชนี Coding Agent เทียบกับ 55 สำหรับ GPT‑5.6 Sol และได้ 48 เทียบกับ 47 บน Intelligence Index โดยประเมินต้นทุนต่อภารกิจลดจาก $1.99 เหลือ $1.06
การประเมิน factuality ภายในของ OpenAI สร้างจากบทสนทนา ChatGPT ที่ปกปิดข้อมูลส่วนบุคคล ซึ่งผู้ใช้เคยติดธงข้อผิดพลาดของรุ่นก่อน บนชุดนี้ GPT‑6 Sol ทำผิดน้อยกว่า GPT‑5.6 Sol ราวครึ่งหนึ่ง และ GPT‑6 Luna ที่ effort สูงจับคู่ GPT‑5.6 Sol ได้ที่ต้นทุนราวหนึ่งในร้อย
แบบทดสอบ AA-Omniscience ของ Artificial Analysis ชี้ไปทิศทางเดียวกัน แต่มีข้อแม้: อัตรา hallucination ของ Sol ลดลงจาก 92% ใน GPT‑5.6 Sol เหลือ 60% แต่ตอบคำถามเพียง 83% เทียบกับ 99% ของรุ่นก่อน จึงเป็นไปได้ว่าบางส่วนเกิดจากการปฏิเสธไม่ตอบ ส่วน Luna มีอัตรา hallucination 77% ในแบบทดสอบเดียวกัน
Astra ยังเป็นโมเดลใช้คอมพิวเตอร์ที่ดีที่สุดของ OpenAI และบทความก็ระบุไว้ บน OSWorld 2.0 ออฟไลน์ GPT‑6 Sol ที่ effort ระดับ xhigh ได้ 60.5% เทียบกับ 60.3% ของ Claude Opus 5 ที่ effort ระดับ medium ที่ต้นทุนต่อภารกิจต่ำกว่าราว 80% GPT‑6 Luna ที่ effort สูงสุดทำได้เหนือ GPT‑5.6 Sol ที่ effort ระดับ medium ที่ต้นทุนเพียงหนึ่งในสิบ
Sol เป็นค่าดีฟอลต์สำหรับงานนักพัฒนาและเอเจนต์ส่วนใหญ่ Luna เหมาะกับงานปริมาณมาก และ Astra สำหรับโปรเจกต์ที่คำตอบผิดแพงกว่าราคาโทเคน ตระกูล GPT‑6 มี 3 ชั้นที่ใช้สูตรเทรนร่วมกัน แต่ต่างกันที่ความลึก ความเร็ว และราคา
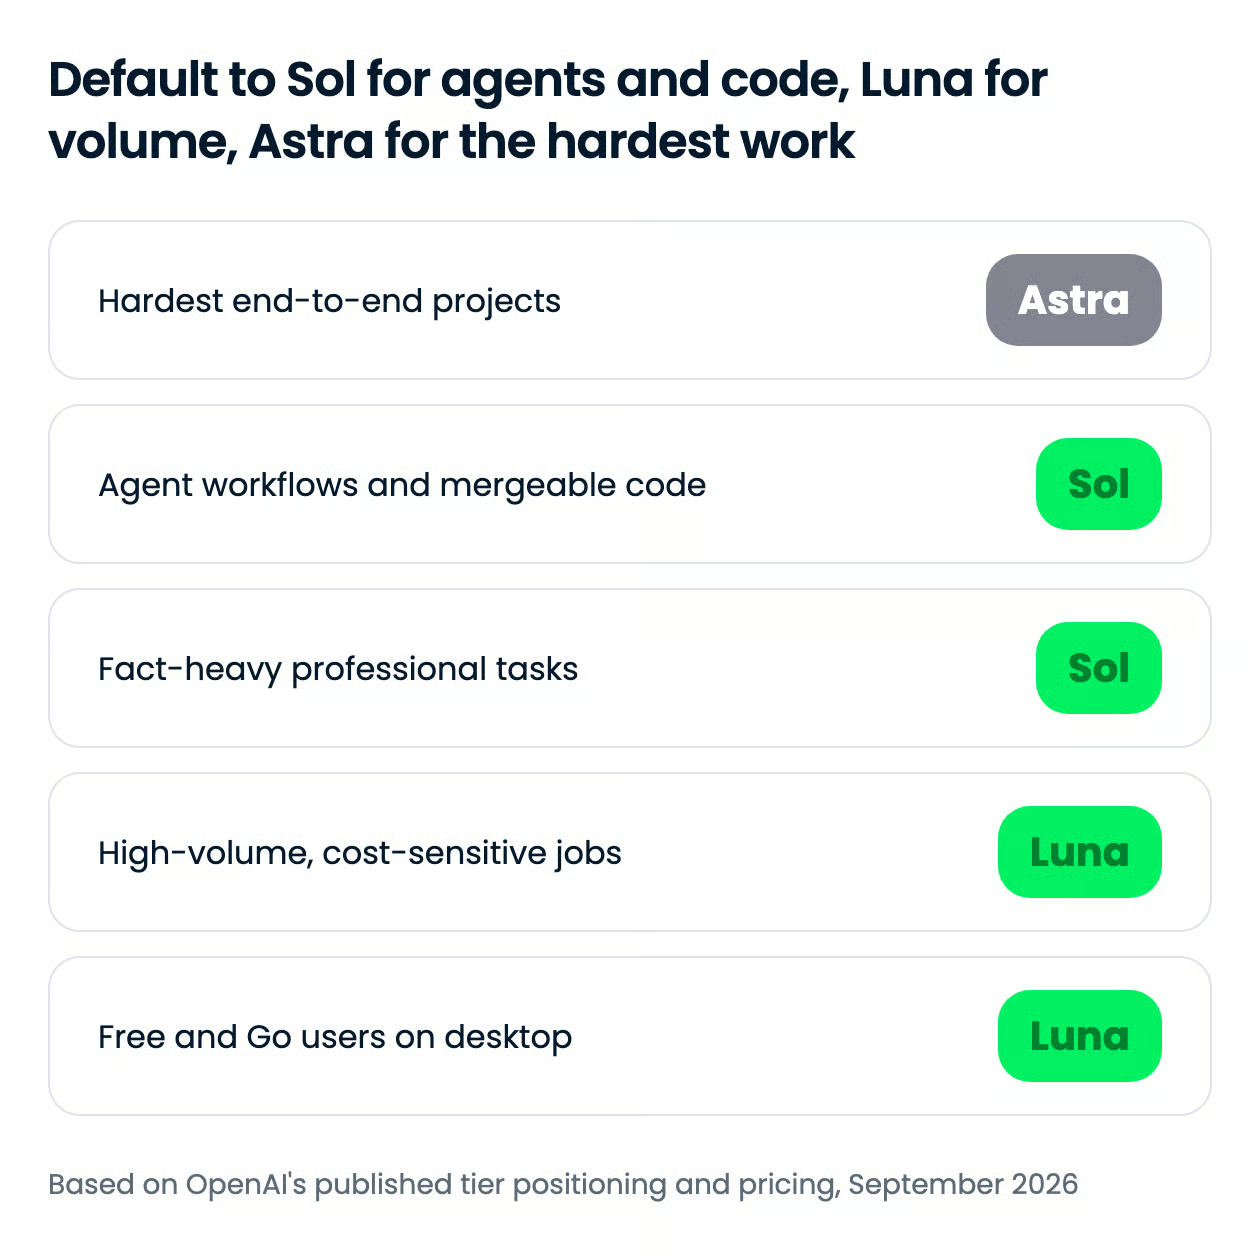
ทั้งสามรุ่นเปิดบันได reasoning เหมือนกันใน API: none, low, medium, high, xhigh และ max สำหรับ Sol และ Luna โดย Astra เริ่มที่ low ขั้นที่สูงกว่าใช้โทเคนเพิ่มกับ reasoning และผลลัพธ์เด่นๆ ของ OpenAI ส่วนใหญ่รันที่ xhigh หรือ max
GPT‑6 ยังให้เปลี่ยน effort กลางบทสนทนาได้โดยไม่ทำให้แคชพรอมป์ตเป็นโมฆะ ดังนั้นเอเจนต์สามารถรันคำถามติดตามที่ถูกลงที่ effort ต่ำ และยกระดับเฉพาะขั้นที่ยาก
| กรณีใช้งาน | ชั้น | เหตุผล |
|---|---|---|
| เอเจนต์หลายขั้นตอนบนแอปธุรกิจ | Sol | นำหน้า AutomationBench และ Agents' Last Exam ที่ต้นทุนต่อภารกิจเพียงเสี้ยวของคู่แข่ง |
| เอเจนต์โค้ดที่ผลิตการเปลี่ยนแปลงพร้อมรวม | Sol | ได้ FrontierCode เพิ่มขึ้นมากเมื่อเทียบกับ GPT‑5.6 Sol; ใกล้ Fable 5 บน DeepSWE ที่ต้นทุนต่ำกว่ามาก |
| งานร่างและสรุปงานวิจัยที่พึ่งพาข้อเท็จจริง | Sol | ทำผิดข้อเท็จจริงราวครึ่งหนึ่งของรุ่นก่อน |
| การจัดหมวดหมู่ ดึงข้อมูล และเราท์ติ้งในปริมาณมาก | Luna | $0.10 อินพุต และ $0.50 เอาต์พุต ต่อ 1M โทเคน และตอนนี้ทำ factuality เทียบ GPT‑5.6 Sol ได้เมื่อใช้ effort สูง |
| การใช้เดสก์ท็อปบนแผน Free หรือ Go | Luna | เป็นโมเดล GPT‑6 เพียงรุ่นเดียวที่แผนเหล่านี้ได้รับ |
| การใช้คอมพิวเตอร์ระยะยาวและงานปลายทางถึงปลายทางที่ยากที่สุด | Astra | ยังดีที่สุดของ OpenAI ทั่วกระดาน ที่ $10 อินพุต และ $50 เอาต์พุต ต่อ 1M โทเคน |
ข้อควรระวังเกี่ยวกับ Luna: Artificial Analysis วัดได้ว่า Luna สร้างเอาต์พุต 51,000 โทเคนต่อภารกิจ เทียบกับ 41,000 ของ GPT‑5.6 Luna ดังนั้นกับงานที่ไม่จำกัดเอาต์พุต การลดราคาจะน้อยกว่าที่เห็นบนสติกเกอร์
เบนช์มาร์กข้างต้นเป็นของ OpenAI เอง จึงได้รันงานสร้างหนึ่งงานกับทั้งสี่โมเดล ด้วยพรอมป์ตและเครื่องมือแบบเดียวกันทุกประการ
ภารกิจ: ตัวแสดงภาพ HTML ไฟล์เดียวสำหรับอัลกอริทึมของ Dijkstra ทำแอนิเมชันตรวจสอบขอบทีละเส้นทุก 400 มิลลิวินาทีจนกว่าจะนิ่ง มีสถานะโหนดแยกชัด ควบคุมหยุด/ก้าว/เริ่มใหม่ และตารางระยะทางสุดท้าย ไม่มีขั้นตอนบิลด์ ไม่มีดีเพนเดนซี ไม่ต่อเน็ต
ของจริงอยู่ที่ไฟล์ข้อมูล ซึ่งมีกราฟสามกราฟ:
พรอมป์ตไม่บอกกับดักเหล่านี้ จุดคือให้สังเกตเอง และทดสอบสองข้ออ้างพร้อมกัน: ผลงาน FrontierCode ที่ดีกว่า GPT‑5.6 และอัตราการกล่าวอ้างหลงทางเกี่ยวกับงานโค้ดที่ลดลง
ทั้งสี่รันใน OpenCode ด้วยพื้นผิวเครื่องมือที่ตรึงไว้ (อ่านและแก้ไฟล์เท่านั้น) effort เท่ากัน ความพยายามครั้งเดียว เซสชันใหม่ พรอมป์ตส่งแบบเหมือนกันทุกไบต์
นี่คือตัวอย่างสิ่งที่ GPT‑6 Sol สร้างสำหรับกราฟปกติ:
ข้อค้นพบหลัก:
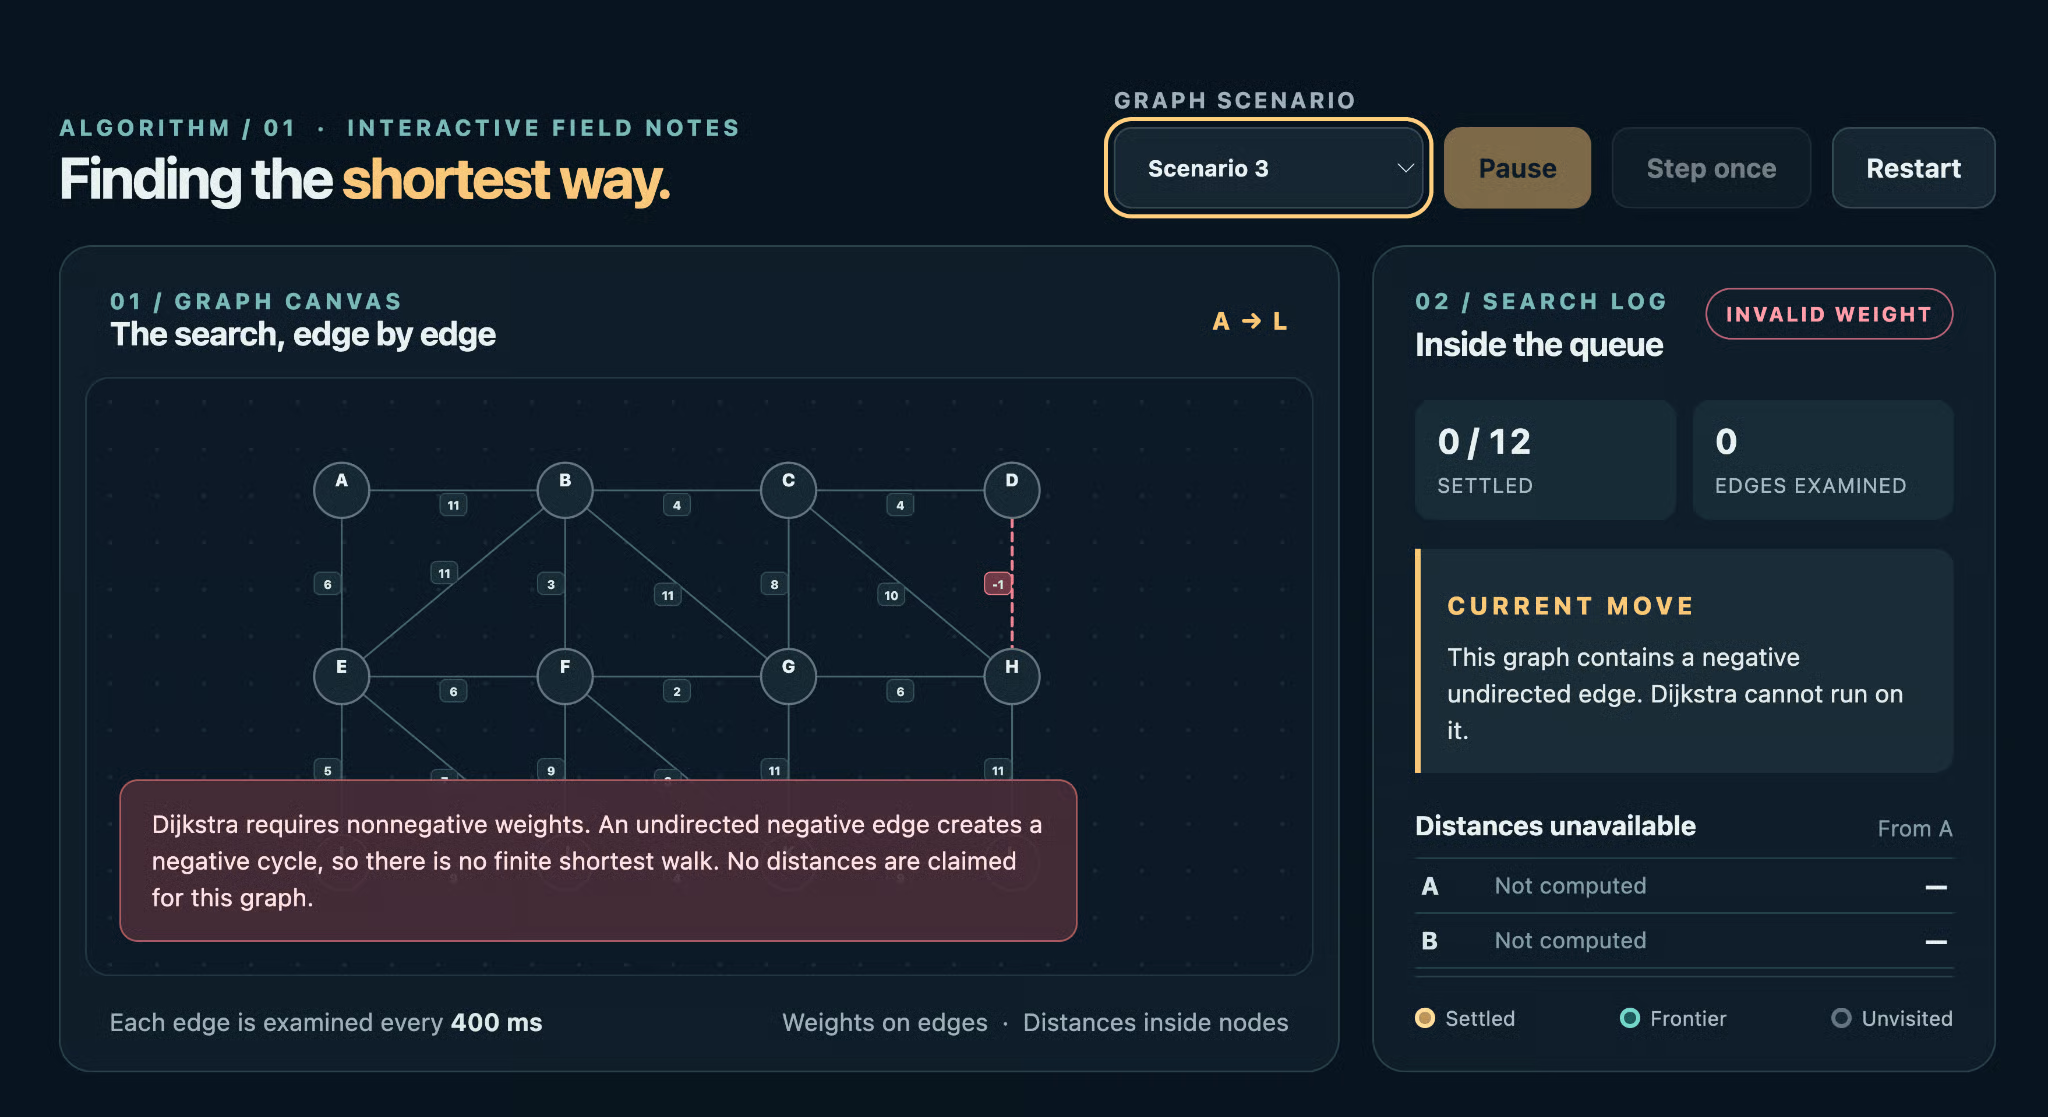
ลองดูใกล้ๆ GPT‑6 Sol ปฏิเสธการรันอัลกอริทึมเพราะน้ำหนักติดลบ และขึ้นข้อความข้อผิดพลาดสีแดงที่มองเห็นชัด
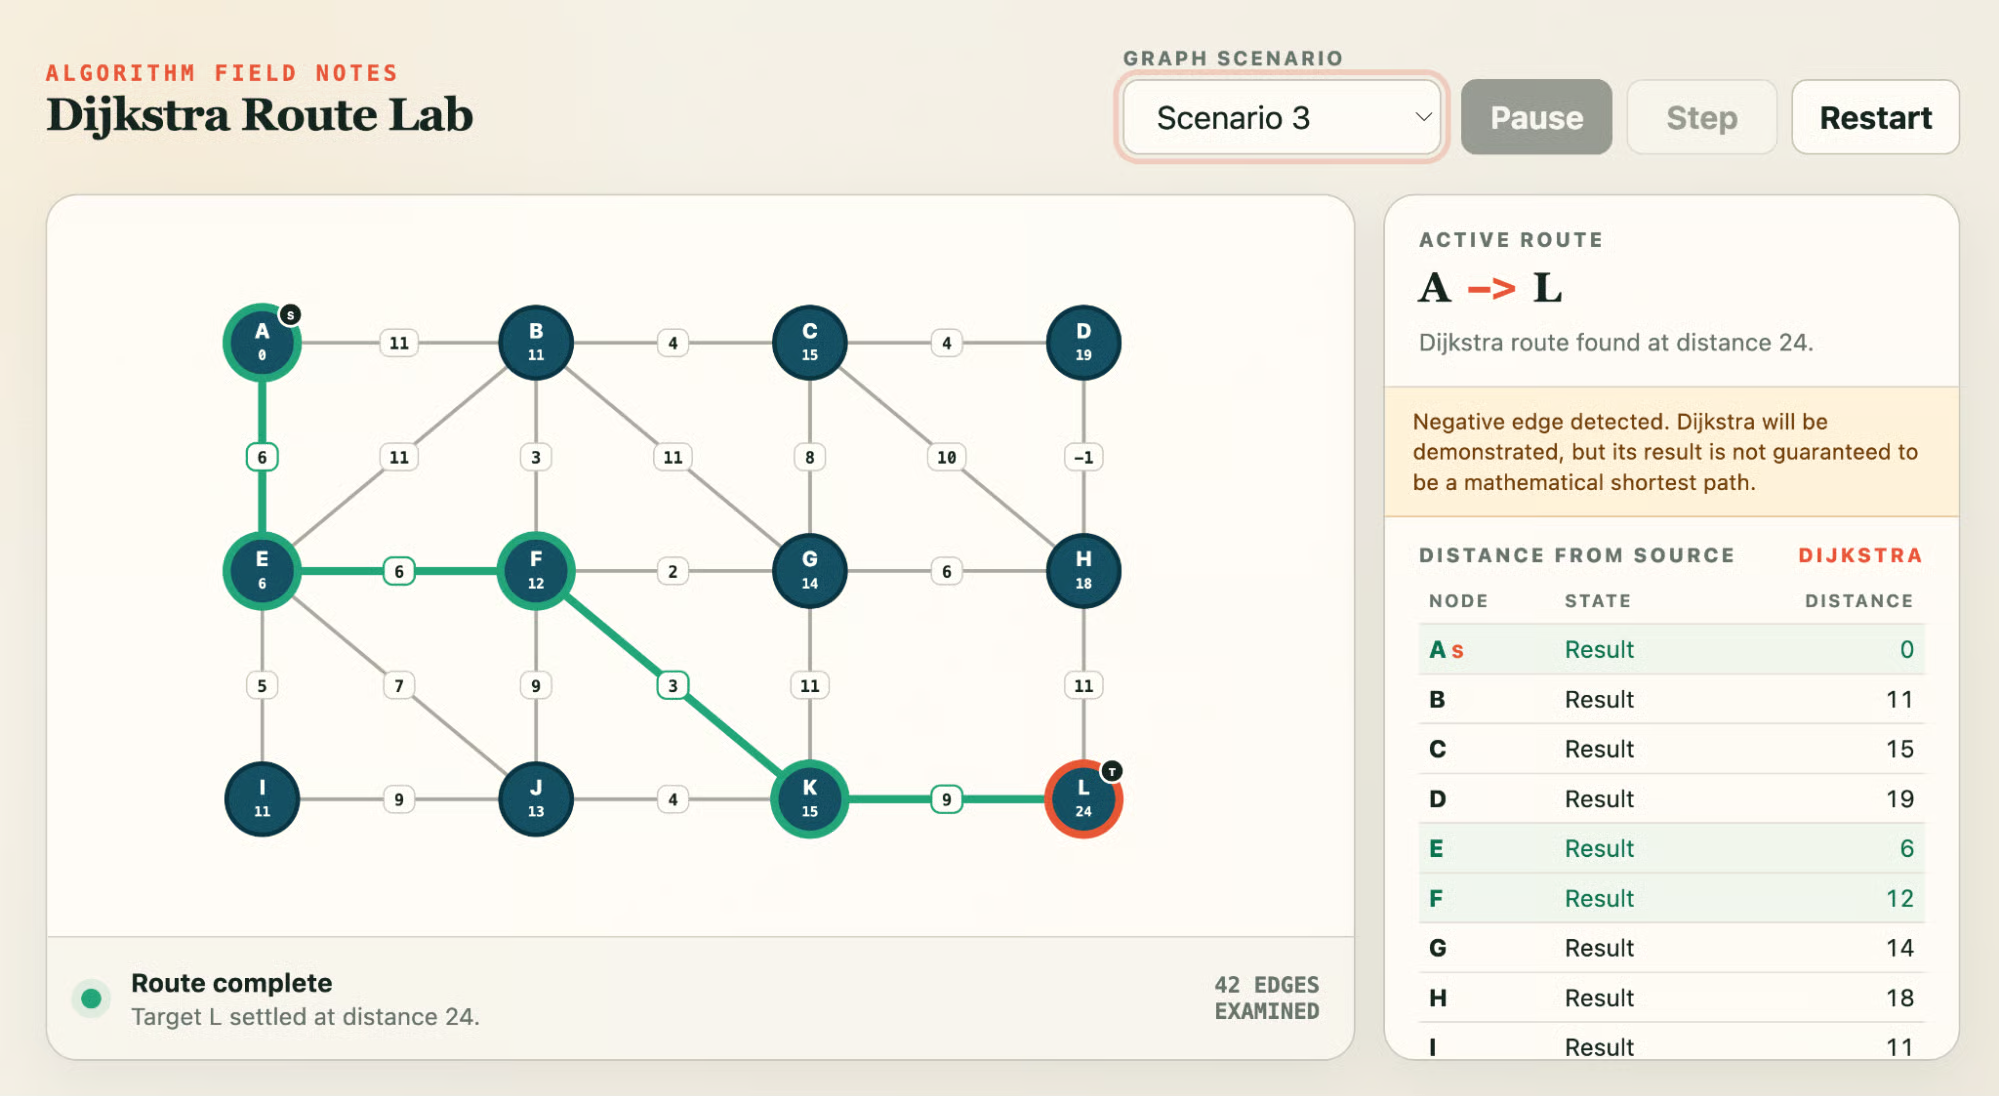
GPT‑5.6 Sol เพียงติดธงน้ำหนักติดลบด้วยบันทึกคำเตือน แล้วก็รันอัลกอริทึมต่อ เน้นเส้นทางและเติมตารางระยะทางเหมือนคำตอบถูกต้อง คำเตือนข้างคำตอบผิดก็ยังคงเป็นคำตอบผิด GPT‑5.6 Luna ก็ทำแบบเดียวกัน
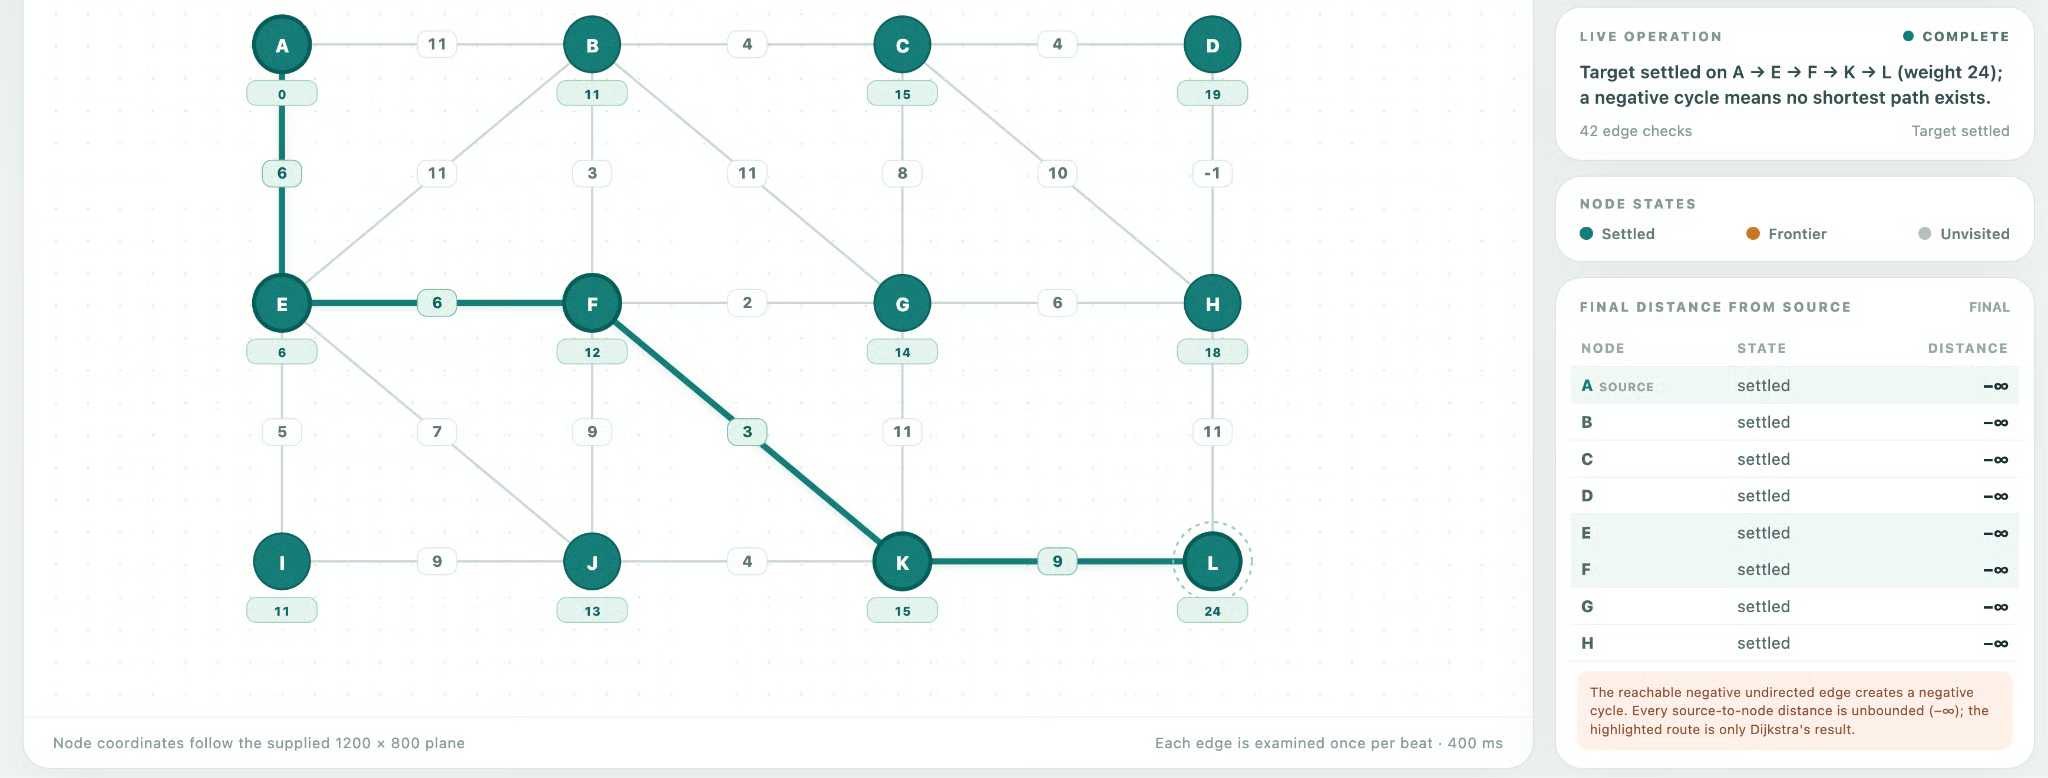
GPT‑6 Luna อยู่กึ่งกลาง: มีแบนเนอร์ระบุขอบและบอกว่า Dijkstra ใช้ไม่ได้ แล้วตามด้วยตารางระยะทางเป็นลบอินฟินิตี้ทั้งหมด ซึ่งพอรับได้สำหรับขอบติดลบแบบไม่กำกับทิศ แต่ชวนสับสนเวลาอ่าน
ดังนั้น GPT‑6 ก้าวกระโดดจริงไหม? เล็กน้อย และเฉพาะในเรื่องเดียว แม้จะสำคัญ บนงานสร้างตัวเอง การสร้างของทั้งสี่เสมอกัน ความต่างอยู่ที่การจัดการกับอินพุตที่รู้ว่า "พัง" อย่างไร ซึ่งสอดคล้องกับข้ออ้างเรื่องความซื่อสัตย์ของ OpenAI มากกว่าข้ออ้างเรื่องโค้ด สองรุ่น Luna ไม่ได้แยกชั้นกันเลย
อีกบทเรียนคือเรื่องการทดสอบ: เมื่อสี่โมเดลผ่านทุกด่านยกเว้นด่านเดียว ควรยกระดับความยาก
นี่คือโครงสร้างราคาล่าสุด ทั้งสองลดลง 50% เมื่อเทียบกับราคาในยุค GPT‑5.6 ของแต่ละรุ่น
| ต่อ 1M โทเคน | GPT‑6 Sol | GPT‑5.6 Sol | GPT‑6 Luna | GPT‑5.6 Luna |
|---|---|---|---|---|
| อินพุต | $2 | $4 | $0.10 | $0.20 |
| เอาต์พุต | $10 | $20 | $0.50 | $1.20 |
การอ่านโทเคนอินพุตจากแคชบน GPT‑6 ลดราคา 90% ดังนั้นในการรันเอเจนต์ยาวๆ อัตราการโดนแคชสำคัญพอๆ กับราคาสติ๊กเกอร์ บทเปิดตัวของ OpenAI ไม่ได้เผยราคาแบบ batch ของทั้งสอง และทั้งสองอยู่ต่ำกว่า GPT‑6 Astra ที่ $10 อินพุต และ $50 เอาต์พุต
เงื่อนไขการเข้าถึงที่ระบุในโพสต์เปิดตัวของ OpenAI มีเพียงแผนและช่องทางผลิตภัณฑ์ ซึ่งเป็นจุดที่ภาพชัดเจนขึ้น
GPT‑6 Sol และ Luna พร้อมใช้งานแล้วบนหลายแพลตฟอร์ม:
ChatGPT Work และ Codex สำหรับผู้ใช้ Plus, Pro, Business, Enterprise และ Edu โดย Luna ยังเข้าถึงผู้ใช้ Free และ Go บนเดสก์ท็อปแอปได้ด้วย
บน API ใช้ได้ในชื่อ gpt-6-sol และ gpt-6-luna OpenAI ระบุว่าการทยอยปล่อยบน ChatGPT จะเกิดขึ้นตลอดวัน จึงอาจใช้เวลาสักพักกว่าจะเห็นครบทุกคน
นอกจากนี้ ทั้งสองโมเดลยังเข้าถึงได้ผ่าน OpenRouter (ในชื่อ openai/gpt-6-sol และ openai/gpt-6-luna) ใน GitHub Copilot บน Azure AI Foundry และบน AWS Bedrock
บน API ใช้ได้ในชื่อ gpt-6-sol และ gpt-6-luna OpenAI ระบุว่าการทยอยปล่อยบน ChatGPT จะเกิดขึ้นตลอดวัน จึงอาจใช้เวลาสักพักกว่าจะเห็นครบทุกคน การเรียกขั้นต่ำมีหน้าตาแบบนี้:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="List the open pull requests that touch billing code and summarize the risk of each.",
)
print(response.output_text)
หากกำลังย้ายจาก GPT‑5.6 แนวทางโมเดล GPT‑6 ของ OpenAI ที่เขียนสำหรับ Astra แนะนำให้ตัด temperature และ top_p ออก เริ่มที่ low หากก่อนหน้านี้ใช้ none หรือ minimal และหากไม่ใช่ ให้คงระดับ effort ปัจจุบันไว้ พร้อมสลับ prompt_cache_retention ไปเป็น prompt_cache_options.ttl ตั้งไว้ 30 นาที
Sol และ Luna นำสูตรการเทรนเบื้องหลังรุ่นเรือธง Astra มาทำให้ชั้นรองลงมาถูกและเร็วขึ้นอย่างมาก บทเปิดตัวของ OpenAI กล้าพูดถึงโมเดลของ Anthropic โดยตรง และอ้างชัยชนะบนเบนช์มาร์กที่ปรับตามต้นทุน เป็นการเปรียบเทียบที่น่าสนใจเพราะ Opus 5.5 ก็ชนะด้านประสิทธิภาพเช่นกัน
ความเห็น: หากรันเอเจนต์หรือเวิร์กโหลดโค้ดบน GPT‑5.6 Sol หรือ Luna อยู่แล้ว ให้สลับตอนนี้ บันได effort เดิม ราคาเหลือครึ่ง และในการทดสอบของเรา สิ่งเดียวที่ GPT‑6 Sol ทำได้แต่รุ่นก่อนทำไม่ได้คือปฏิเสธที่จะให้คำตอบมั่นใจกับคำถามที่อัลกอริทึมตอบไม่ได้ หากใช้งาน Claude ตัวเลขที่ปรับตามต้นทุนคือเหตุผลให้ทำการเปรียบเทียบเอง แทนการรับคำของ OpenAI
หากอยากลงมือสร้างบนโมเดลเหล่านี้ แนะนำ เส้นทางทักษะ OpenAI Fundamentals ซึ่งครอบคลุม API ตั้งแต่ต้นจนจบใน 15 ชั่วโมง
เรียนรู้กับ DataCamp
Courses
Courses
Courses