

Curso
Noções Básicas de Engenharia de Prompts.
1 h
232.4K
A OpenAI acabou de ampliar a família GPT‑6 com dois novos modelos: GPT‑6 Sol e GPT‑6 Luna, ambos posicionados abaixo do carro-chefe GPT‑6 Astra, sobre o qual escrevemos no início do mês. Sol e Luna chegam com cortes de preço agressivos (50% em relação ao GPT‑5.6) e ganhos em programação e automação de workflows.
Coincidência ou não, a Anthropic lançou o Claude Opus 5.5 no mesmo dia (hoje), com uma proposta parecida: mesma base de treinamento do topo de linha, otimizada para custo e velocidade.
Para saber mais sobre o carro-chefe dessa linha, confira nosso tutorial da API do GPT‑6 Astra e nossa comparação entre GPT‑6 Astra e Claude Fable 5.1.
O Astra continua sendo o modelo mais capaz e mais alinhado da OpenAI, reservado para trabalhos de maior exigência. Já o Sol e o Luna trazem grande parte da mesma abordagem de treinamento — e boa parte do desempenho em código, uso de computador etc. — para níveis mais baratos e rápidos.
Pense na mesma relação que o Opus 5.5 tem com o Fable 5.1: não é um novo limite tecnológico, mas entrega desempenho próximo ao de ponta por uma fração do custo.
Alguns destaques que valem a pena:
O preço da API do Sol caiu pela metade. O Luna ficou ainda um pouco abaixo da metade. Você encontra mais detalhes na seção de preços.
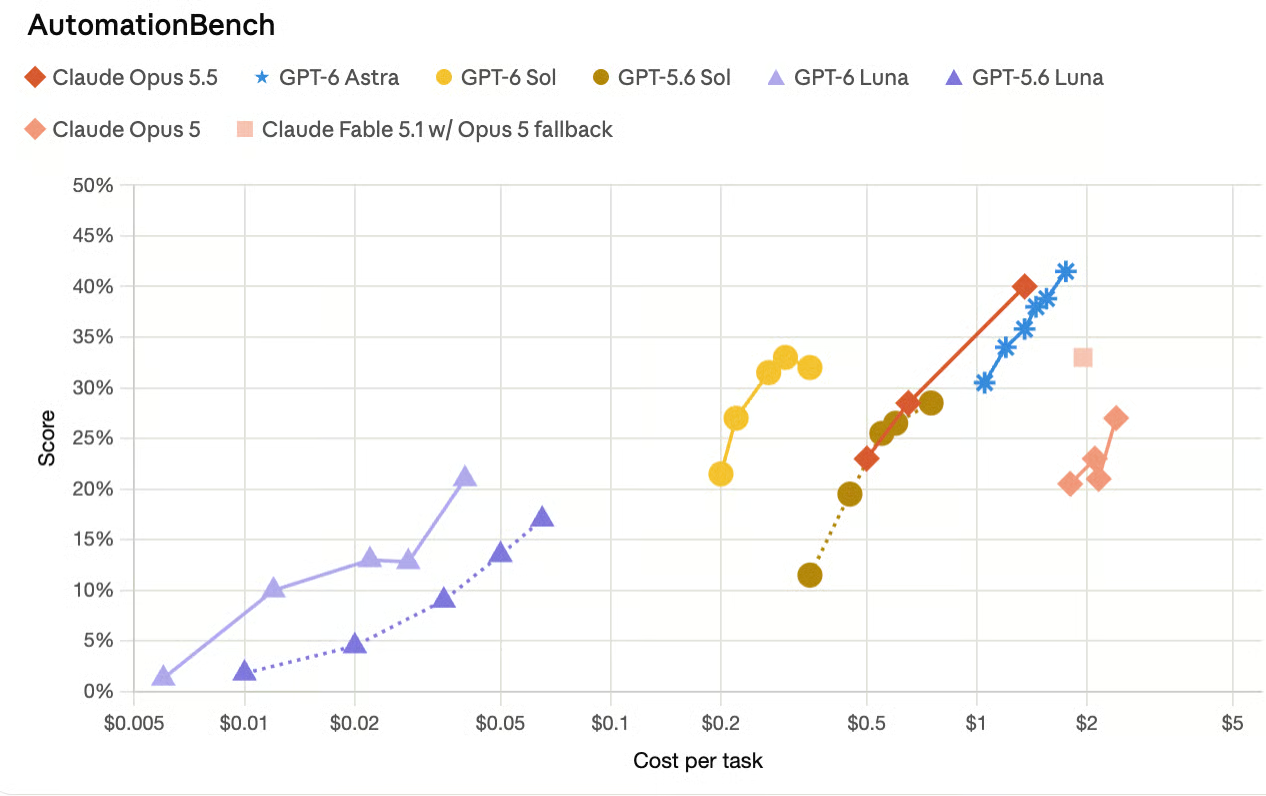
No AutomationBench, que testa agentes em vendas, marketing, operações, suporte, finanças e afins, o Sol no esforço máximo supera o Claude Opus 5 — e faz isso por uma fração do custo por tarefa do Opus 5. O Luna também melhorou bem em relação ao seu antecessor GPT‑5.6, ficando notavelmente mais barato por tarefa. A OpenAI incluiu um bom gráfico, que eu recriei aqui:
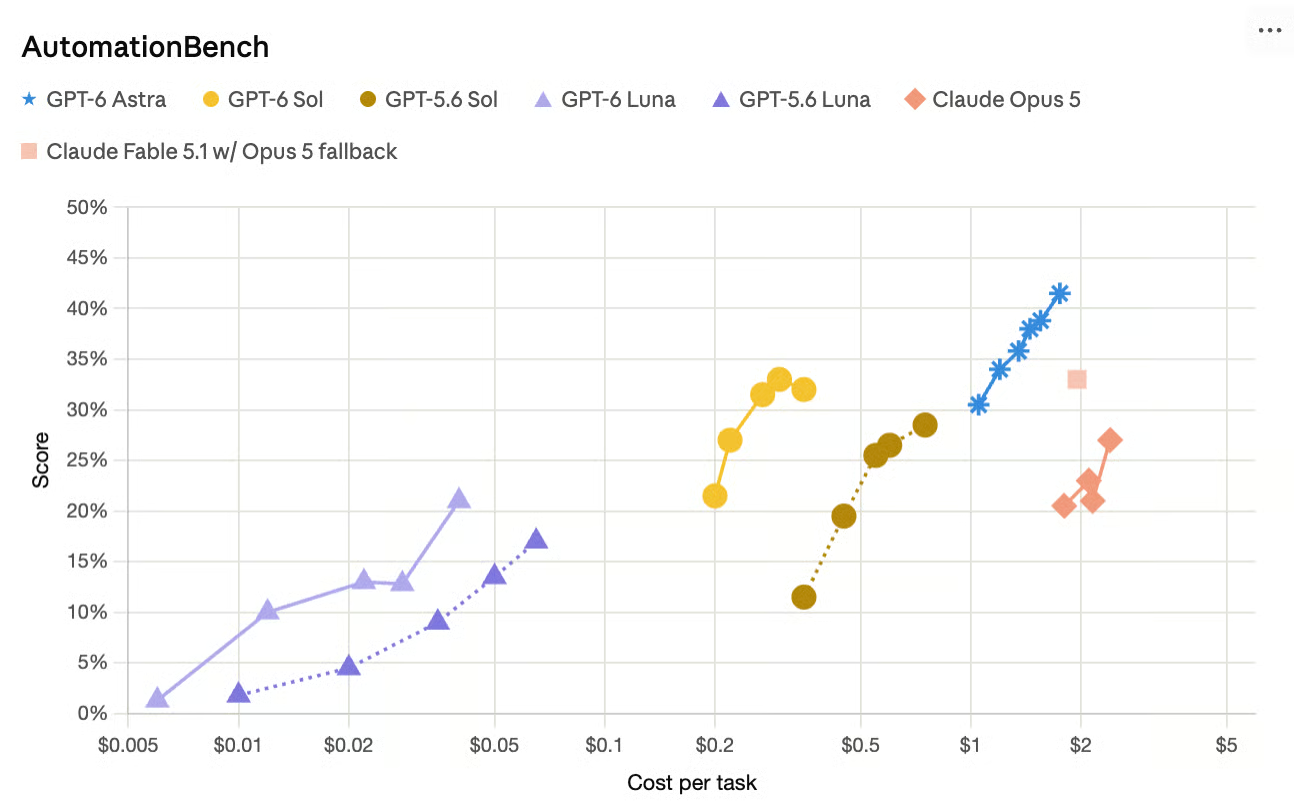
Notei que o gráfico não incluía os números do Opus 5.5 reportados pela Anthropic no anúncio do Opus 5.5, então adicionei uma nova série. Dá para ver que as versões mais recentes do Sol e do Luna continuam as mais eficientes. Provavelmente a OpenAI não incluiu essa informação no anúncio de lançamento só por questão de timing: o Opus 5.5 saiu uma hora antes.
No FrontierCode, o Sol fica próximo da melhor pontuação do Claude Fable 5.1, porém com preço bem menor. Em outro benchmark de código (DeepSWE), o Sol chega perto da melhor marca do Fable 5 com um grande desconto de custo, e o Luna aparece como comparável ao Opus 5 e ao Fable 5 em níveis intermediários de esforço.
Segundo a OpenAI, o Sol reduz pela metade a taxa de erro do seu antecessor em uma checagem interna de factualidade construída a partir de conversas reais em que usuários apontaram falhas. O Luna também melhorou; a OpenAI afirma que, em esforço mais alto, ele iguala a factualidade do GPT‑5.6 Sol a uma pequena fração do custo. Essa foi mais difícil de verificar.
O estilo mais conciso e com menos jargão do Astra chegou ao Sol e ao Luna. A OpenAI vem otimizando o tom de conversa dos modelos desde que o 4o foi bastante criticado por ser bajulador.
Além do preço por token, a OpenAI destaca melhorias no cache de prompt para ajudar agentes e conversas longas a reutilizarem contexto com mais eficiência, com leituras em cache com desconto de cerca de 90%. Novos dashboards e diagnósticos ajudam desenvolvedores a ver onde o cache funciona — e onde não funciona.
Ambos os modelos têm menor probabilidade do que seus equivalentes no GPT‑5.6 de deturpar o que fizeram em uma tarefa de código.
As avaliações de alinhamento da OpenAI, rodadas no esforço máximo, criam situações deliberadas que convidam à desonestidade, e o Sol e o Luna apresentam taxas menores de engano do que o GPT‑5.6 Sol e Luna nos testes de engano em código, busca quebrada, bypass de revisor, contorno de avisos e interações não autorizadas.
A OpenAI ressalta que são cenários adversariais, não taxas de falha em uso típico, e publica os resultados completos no system card do GPT‑6.
O anúncio da OpenAI enfatiza comparações ajustadas por custo. Antes, citei o desempenho do Sol no AutomationBench. A OpenAI não diz apenas que ele é "melhor que o Opus 5", mas que é melhor e cerca de 11 vezes mais barato por tarefa.
Também vale destacar que os números da própria OpenAI mostram o Astra ainda à frente do Sol e do Luna em tarefas de uso de computador, e que algumas comparações com os modelos Claude usam níveis de esforço diferentes de cada lado (por exemplo, Sol em "xhigh" versus Opus 5 em "medium"), o que torna as alegações de eficiência realmente fortes, mas deixa as comparações de capacidade bruta um pouco mais difíceis de cravar.
Com esse alerta, veja o que a OpenAI reportou, agrupado pelo tipo de trabalho que cada benchmark representa.
O resultado mais forte do Sol é no AutomationBench, o teste da Zapier para agentes funcionando ponta a ponta em 47 ferramentas de vendas, marketing, operações, suporte, finanças e RH. O GPT‑6 Sol em esforço xhigh marca 33,2% a US$0,27 por tarefa, à frente do Claude Opus 5 no esforço máximo e até acima do GPT‑6 Astra em esforço baixo — e por uma fração do custo por tarefa do Opus 5.
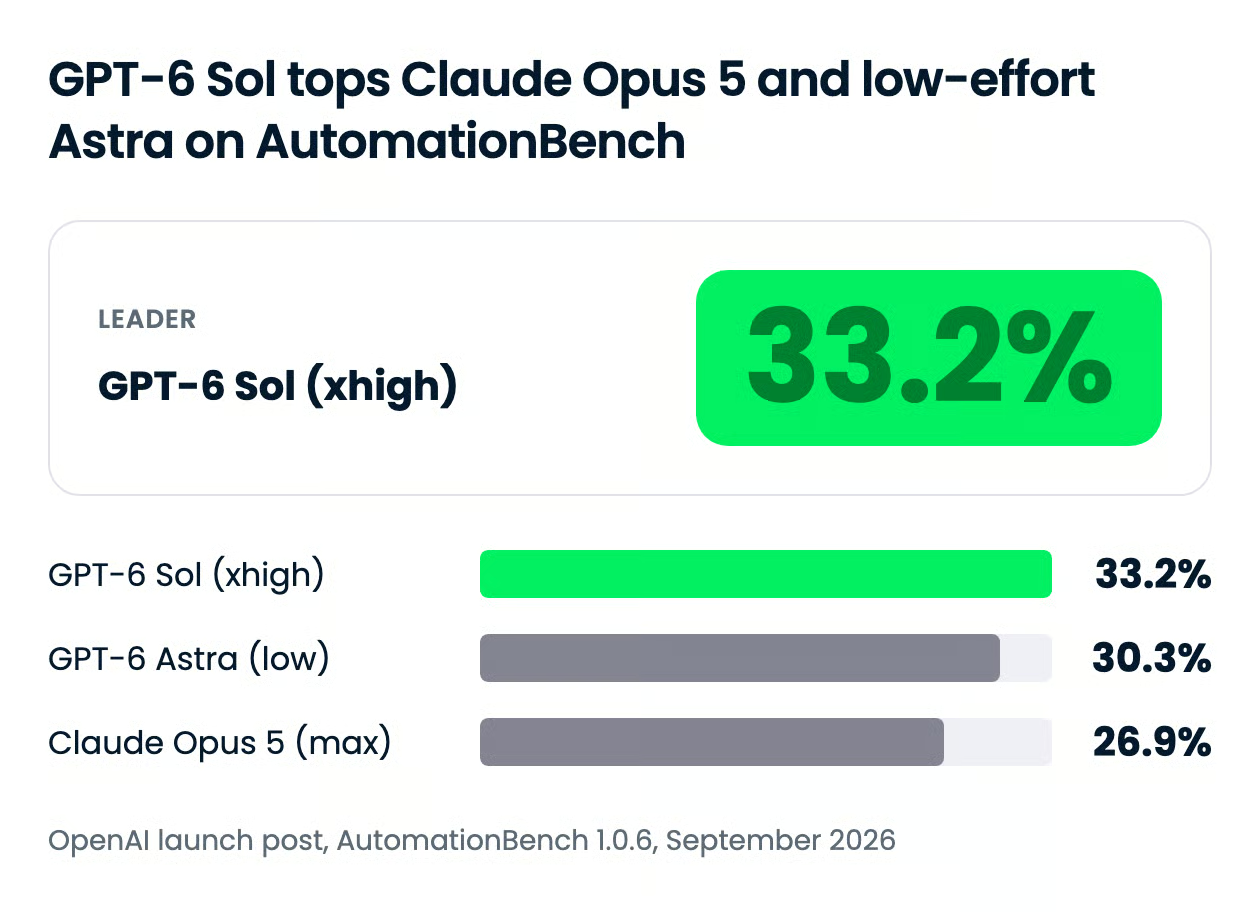
A linha do Fable 5.1 merece atenção. A OpenAI lista o Claude Fable 5.1 com fallback no Opus 5 logo abaixo do Sol, mas o fallback acionou em cerca de 40% das tarefas — e esse custo não entra no número reportado.
| Modelo (e esforço) | Pontuação no AutomationBench | Custo por tarefa |
|---|---|---|
| GPT‑6 Sol (xhigh) | 33,2% | US$0,27 |
| GPT‑6 Astra (low) | 30,3% | 3,9x o GPT‑6 Sol |
| Claude Fable 5.1 com fallback Opus 5 (max) | 31,4% | Mais de 8,9x o GPT‑6 Sol (custo do fallback não informado) |
| Claude Opus 5 (max) | 26,9% | 11,1x o GPT‑6 Sol |
No mesmo benchmark, a história do Luna é geracional. Em esforço alto, o GPT‑6 Luna melhora o GPT‑5.6 Luna em 5,4 pontos percentuais, com 58% de redução no custo por tarefa.
No Agents' Last Exam, que avalia agentes em workflows profissionais de longo horizonte em 55 subindústrias, o GPT‑6 Sol em esforço máximo marca 56,4%. A OpenAI diz que fica acima da melhor pontuação do Claude Opus 5 na avaliação, com 60% menos custo por tarefa.
No DeepSWE v1.1, que testa agentes em tarefas de engenharia de software de longo horizonte em repositórios reais, o GPT‑6 Sol em esforço máximo marca 68,8%. A melhor pontuação do Claude Fable 5 na avaliação é 69,9% em xhigh, então o Sol fica 1,1 ponto atrás com cerca de 80% de redução no custo por tarefa.
O GPT‑6 Luna em esforço máximo marca 66,6% no mesmo benchmark, que a OpenAI classifica como comparável ao Claude Opus 5 e ao Fable 5 em esforço médio. Nessas comparações, o Luna custa 93% menos por tarefa que o Opus 5 e 96% menos que o Fable 5.
Números independentes ainda são modestos. A Artificial Analysis coloca o GPT‑6 Sol em 57 no seu Coding Agent Index contra 55 do GPT‑5.6 Sol, e em 48 contra 47 no seu Intelligence Index, com custo estimado por tarefa caindo de US$1,99 para US$1,06.
A avaliação interna de factualidade da OpenAI é construída a partir de conversas desidentificadas do ChatGPT em que usuários apontaram um erro factual de um modelo anterior. Nesse conjunto, o GPT‑6 Sol comete cerca de metade dos erros do GPT‑5.6 Sol, e o GPT‑6 Luna em esforço mais alto iguala o GPT‑5.6 Sol a cerca de um centésimo do custo.
O teste AA-Omniscience da Artificial Analysis aponta na mesma direção, com ressalvas: a taxa de alucinação do Sol caiu de 92% (GPT‑5.6 Sol) para 60%, mas ele respondeu apenas 83% das perguntas contra 99% do antecessor — parte do ganho vem de se recusar a responder. A taxa do Luna no mesmo teste foi 77%.
O Astra ainda é o melhor modelo da OpenAI para uso de computador, e o post diz isso claramente. No OSWorld 2.0 offline, o GPT‑6 Sol em xhigh faz 60,5% contra 60,3% do Claude Opus 5 em medium, com cerca de 80% menos custo por tarefa. O GPT‑6 Luna em máximo supera o GPT‑5.6 Sol em médio a um décimo do custo.
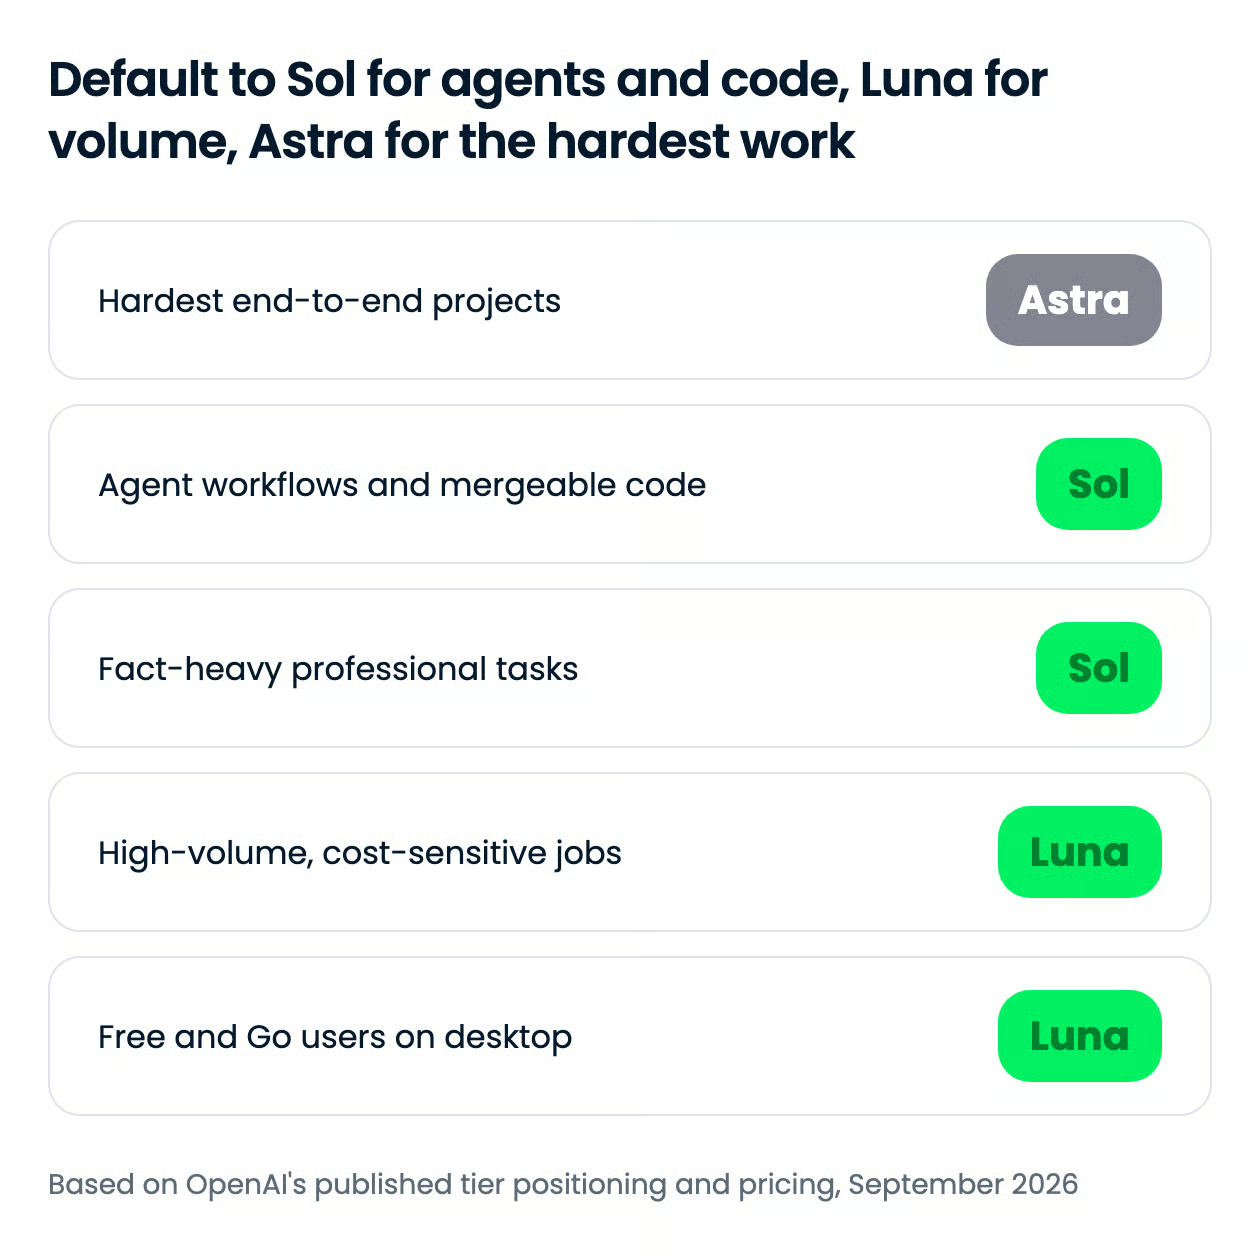
Sol é o padrão para a maioria dos trabalhos de desenvolvedor e agentes, Luna é para volume, e Astra é para projetos em que uma resposta errada custa mais do que os tokens. A família GPT‑6 agora tem três níveis que compartilham a mesma receita de treinamento e variam em profundidade, velocidade e preço.
Os três expõem a mesma escada de raciocínio na API: none, low, medium, high, xhigh e max para Sol e Luna, com o Astra começando em low. Degraus mais altos gastam mais tokens com raciocínio, e a maioria dos resultados de destaque da OpenAI rodou em xhigh ou max.
O GPT‑6 também permite mudar o esforço no meio da conversa sem invalidar o cache de prompt, então um agente pode fazer follow-ups baratos em esforço baixo e escalar só os passos difíceis.
| Caso de uso | Nível | Por quê |
|---|---|---|
| Agentes de múltiplos passos em apps de negócio | Sol | Lidera o AutomationBench e o Agents' Last Exam por uma fração do custo por tarefa dos rivais |
| Agentes de código gerando mudanças mergeáveis | Sol | Ganho substancial no FrontierCode vs. GPT‑5.6 Sol; perto do Fable 5 no DeepSWE com custo bem menor |
| Redação e resumos de pesquisa com muitos fatos | Sol | Cerca de metade dos erros factuais do antecessor |
| Classificação, extração e roteamento em alto volume | Luna | US$0,10 de entrada e US$0,50 de saída por 1M de tokens; agora iguala o GPT‑5.6 Sol em factualidade em esforço alto |
| Uso de desktop nos planos Free ou Go | Luna | O único modelo GPT‑6 disponível nesses planos |
| Uso de computador de longo horizonte e o trabalho ponta a ponta mais difícil | Astra | Ainda é o melhor da OpenAI em tudo, a US$10 de entrada e US$50 de saída por 1M de tokens |
Um cuidado com o Luna: a Artificial Analysis mediu 51.000 tokens de saída por tarefa contra 41.000 no GPT‑5.6 Luna, então, em cargas sem limite de saída, o corte de preço é menor do que o rótulo sugere.
Como os benchmarks acima são da própria OpenAI, rodei uma tarefa de build nos quatro modelos com o mesmo prompt e as mesmas ferramentas.
A tarefa: um visualizador HTML de arquivo único para o algoritmo de Dijkstra, animando a análise de uma aresta a cada 400 ms até o alvo estabilizar, com estados distintos dos nós, controles de pausar/avançar/reiniciar e uma tabela final de distâncias. Sem etapa de build, sem dependências, sem rede.
O verdadeiro teste estava no arquivo de dados. Ele tinha três grafos:
O prompt não menciona as armadilhas. Percebê-las é o ponto — e isso testa duas promessas do lançamento: o ganho no FrontierCode em relação ao GPT‑5.6 e a redução em afirmações enganosas sobre o trabalho de código.
Os quatro rodaram no OpenCode com o mesmo conjunto de ferramentas (ler e editar arquivos), mesmo esforço de raciocínio, uma tentativa, sessão nova e prompt entregue byte a byte.
Aqui está um exemplo do que o GPT‑6 Sol produziu para o grafo normal:
Principais achados:
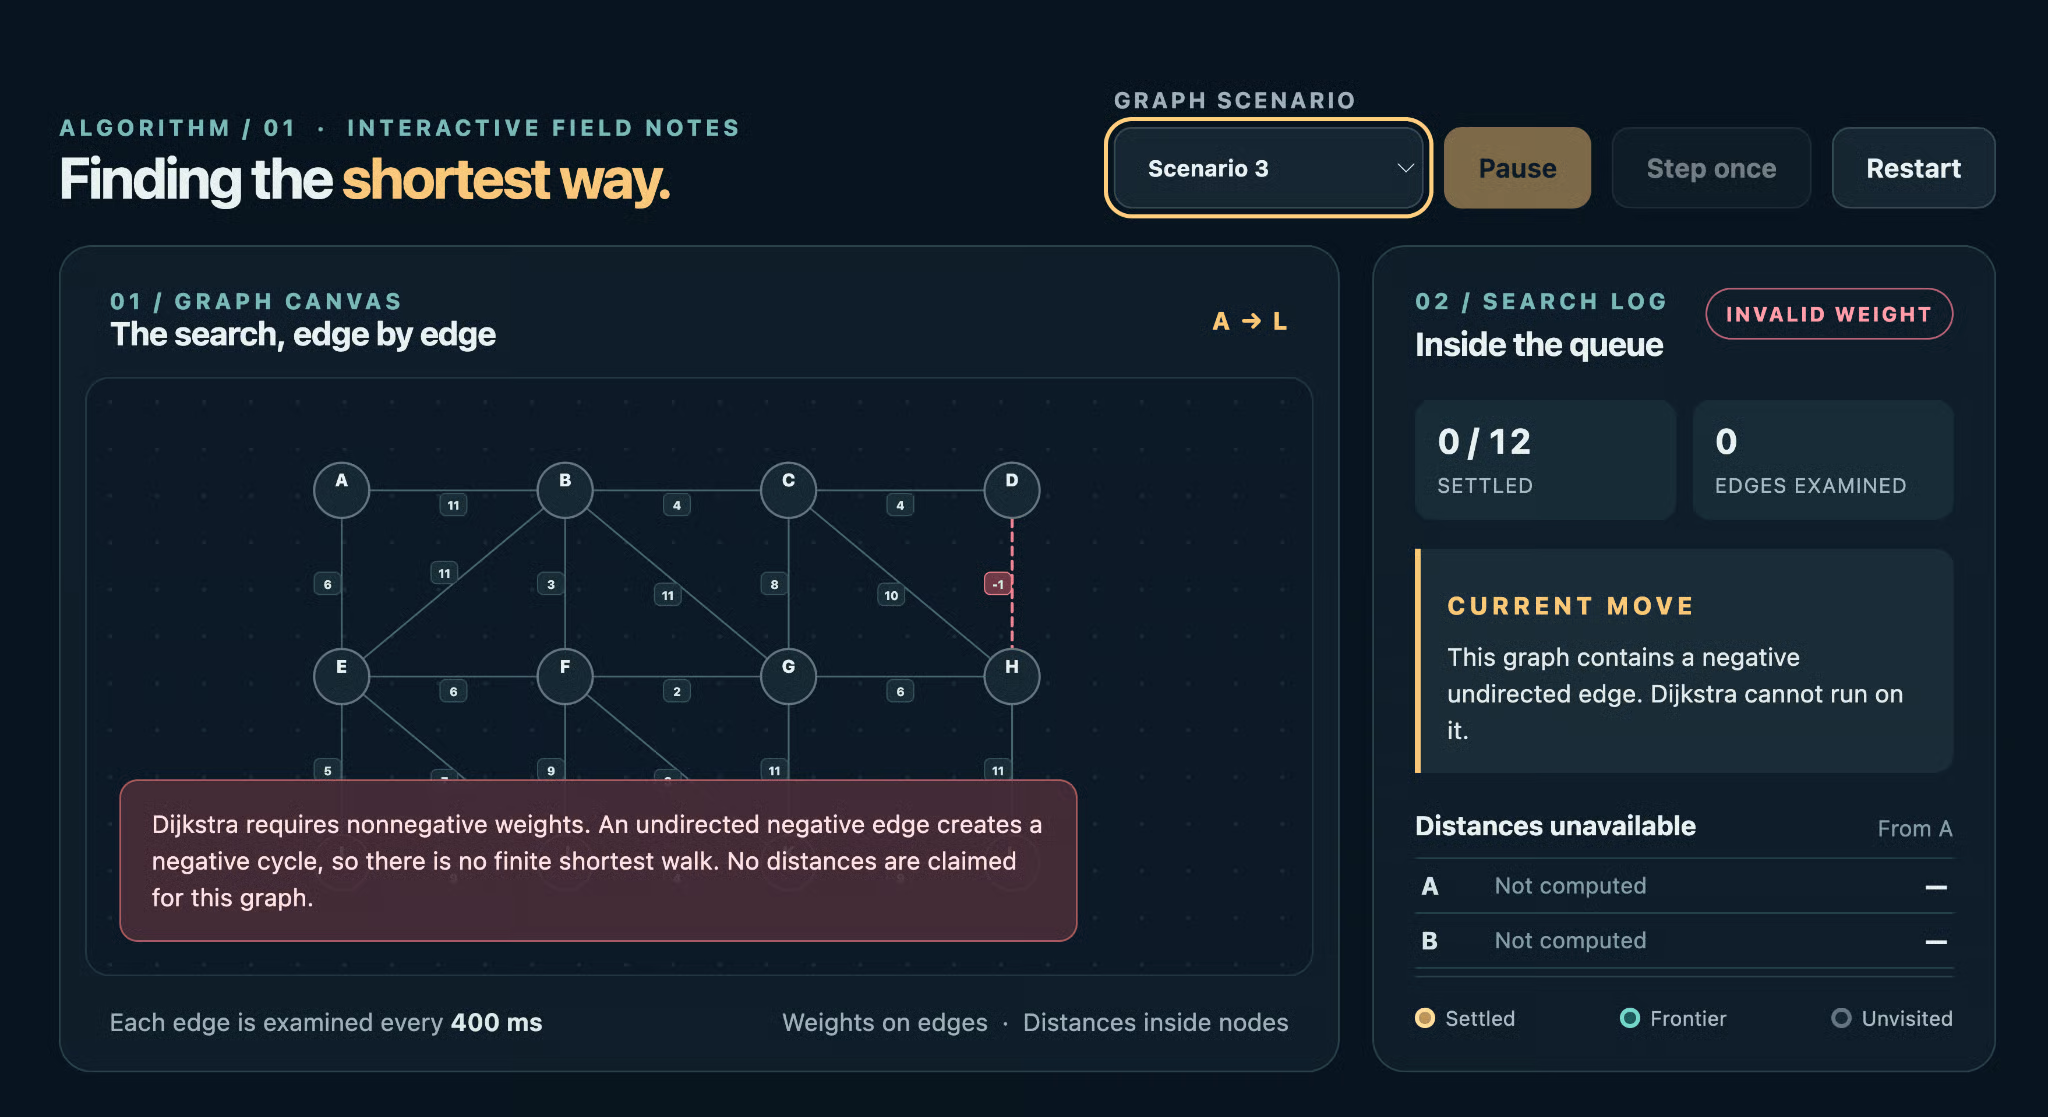
Vamos olhar mais de perto. O GPT‑6 Sol recusou rodar o algoritmo por causa do peso negativo e exibiu uma mensagem de erro vermelha bem visível.
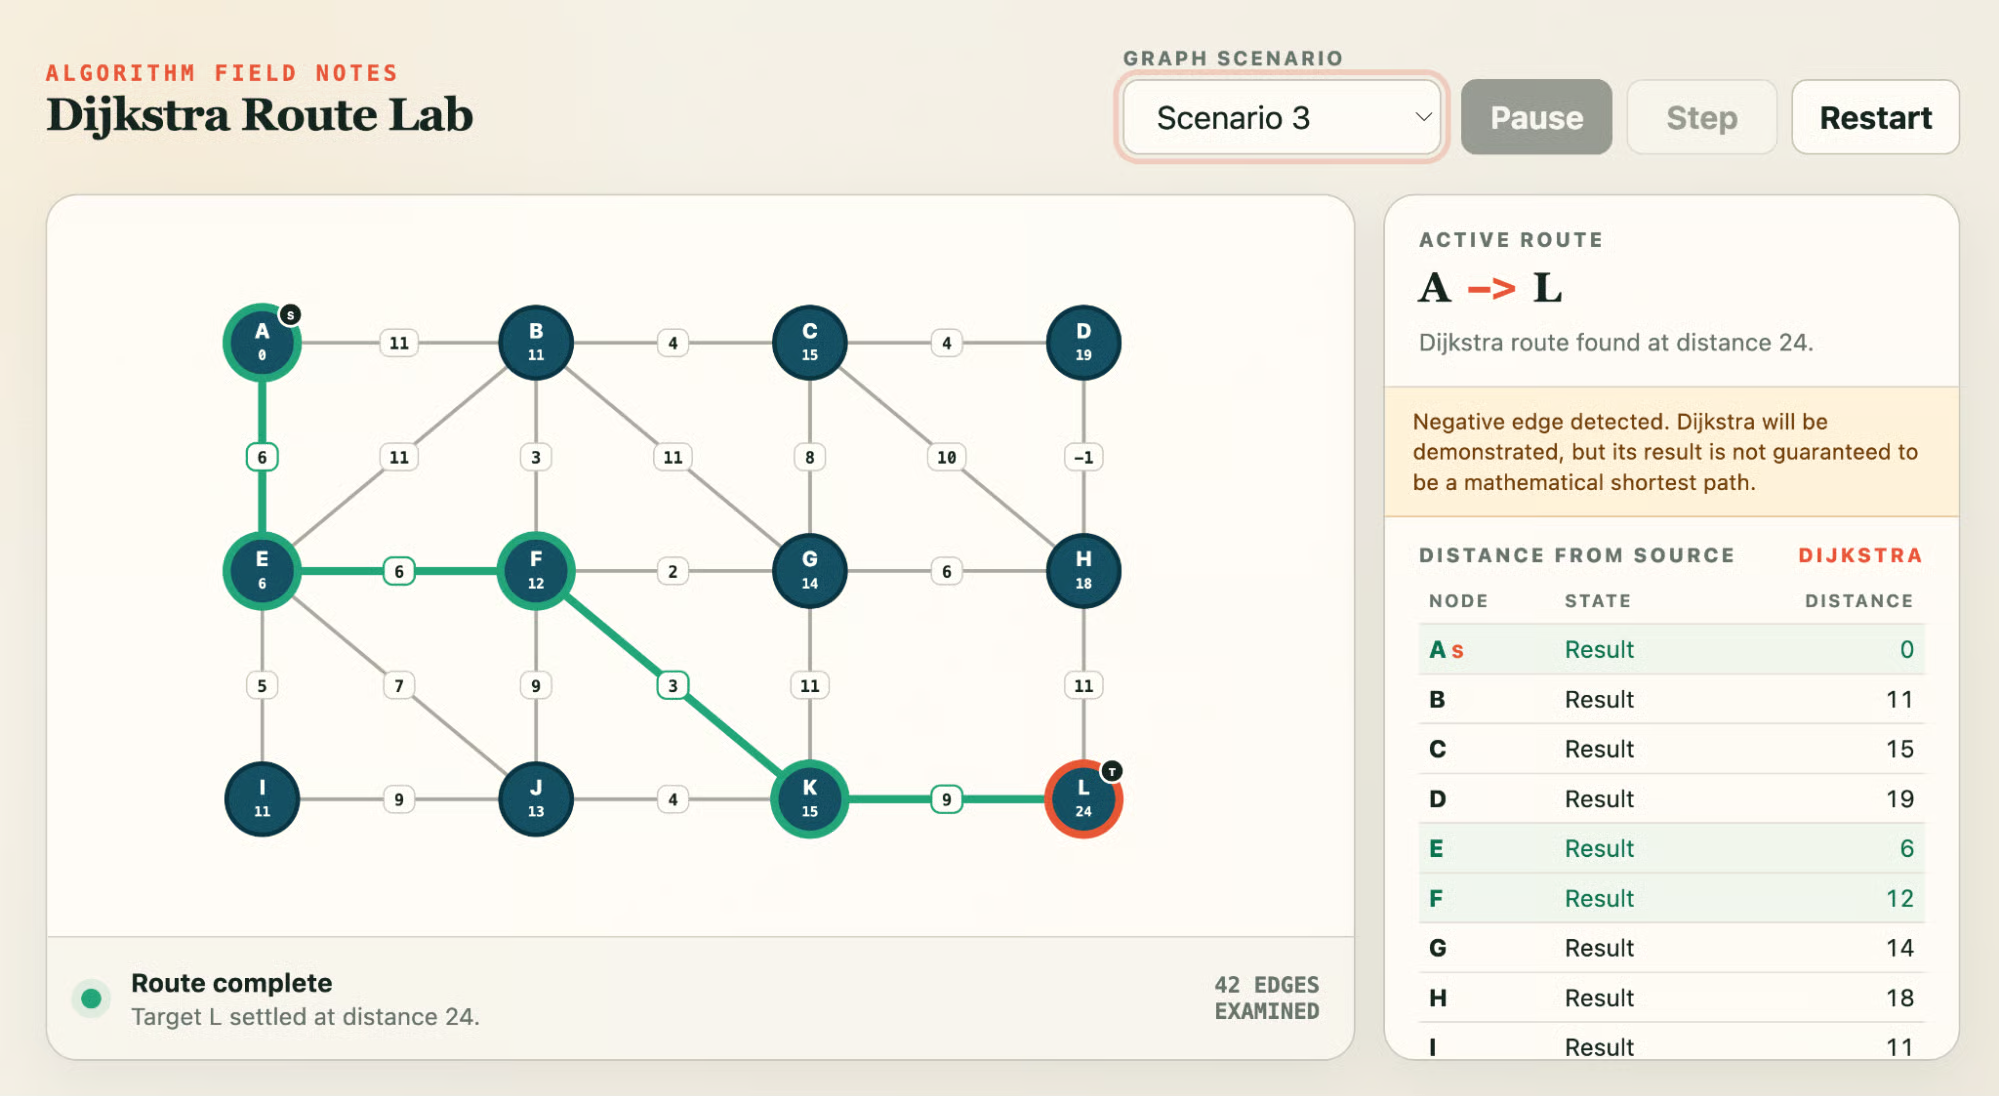
O GPT‑5.6 Sol sinalizou o peso negativo em um aviso, mas rodou o algoritmo mesmo assim, destacando um caminho e preenchendo a tabela de distâncias como se a resposta fosse válida. Um aviso ao lado de uma resposta errada ainda é uma resposta errada. O GPT‑5.6 Luna fez o mesmo.
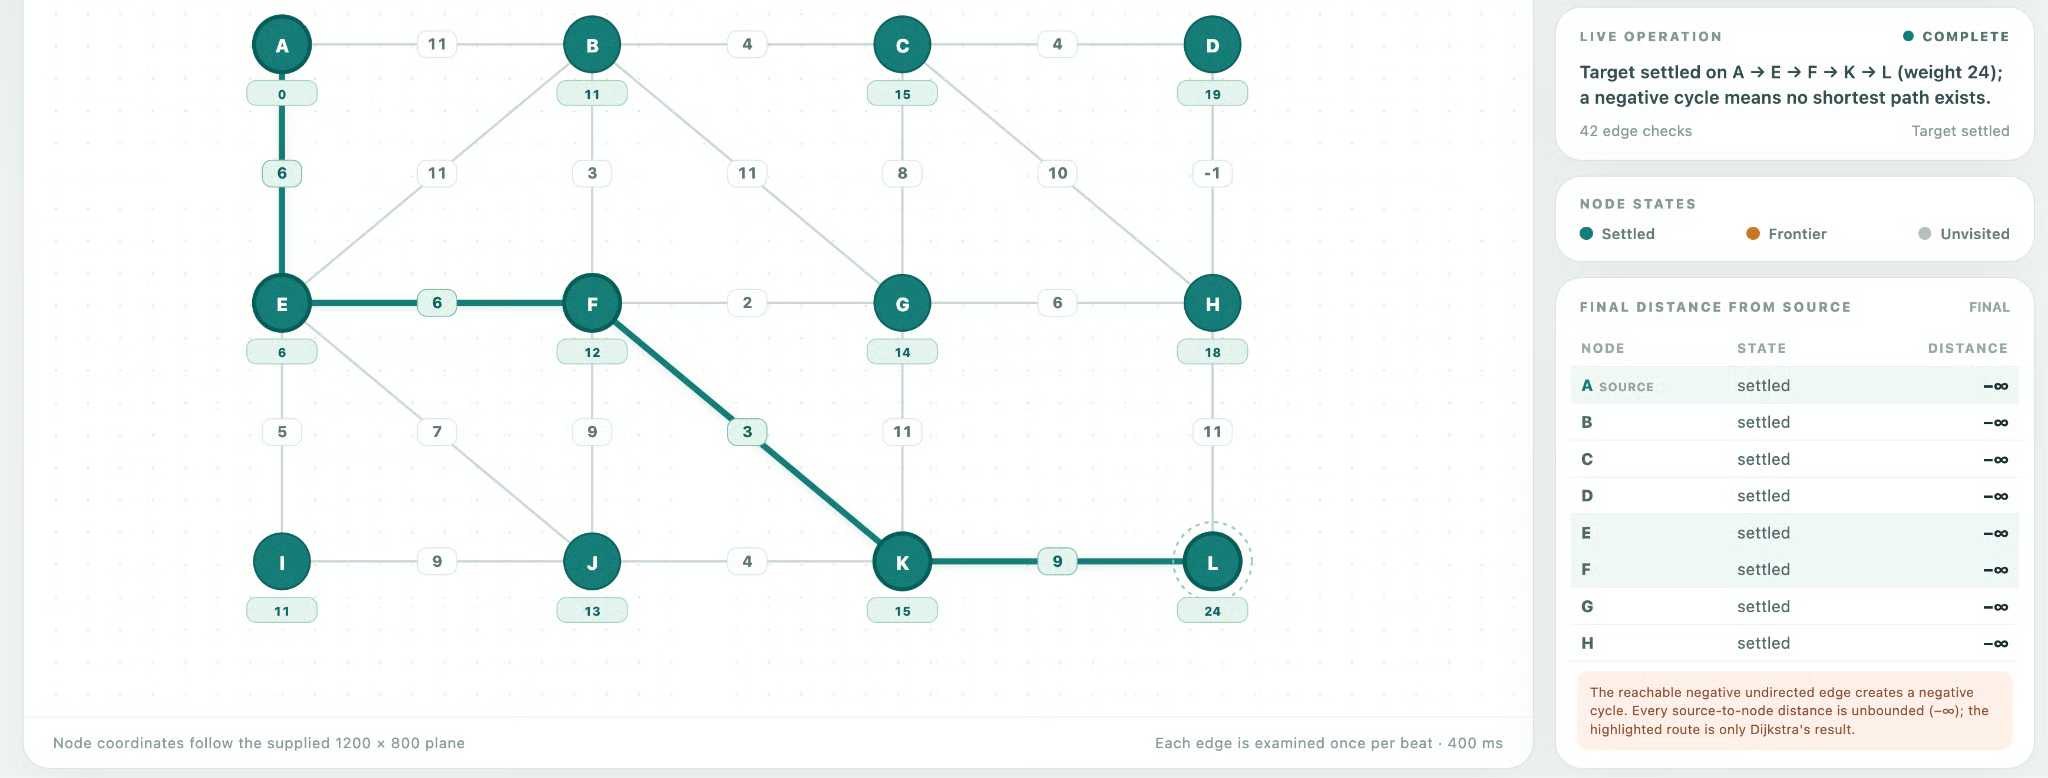
O GPT‑6 Luna ficou no meio-termo: um banner nomeando a aresta e dizendo que Dijkstra é inaplicável, depois uma tabela de distâncias com infinitos negativos. Defensável para aresta negativa não direcionada, mas confuso de ler.
Então o GPT‑6 é um avanço real? Pouco, e em um ponto específico — embora importante. Na tarefa de build em si, houve empate. A diferença está toda em como cada modelo lidou com uma entrada sabidamente problemática, o que bate com a promessa de mais honestidade da OpenAI, não com a de melhor código. As duas versões do Luna não se separaram.
Outra lição é sobre o teste: quando quatro modelos passam em todas as sondagens menos uma, é hora de subir a barra.
Aqui vai a nova estrutura de custos. Ambos representam redução de 50% em relação aos preços promocionais do GPT‑5.6 de cada modelo.
| Por 1M de tokens | GPT‑6 Sol | GPT‑5.6 Sol | GPT‑6 Luna | GPT‑5.6 Luna |
|---|---|---|---|---|
| Entrada | US$2 | US$4 | US$0,10 | US$0,20 |
| Saída | US$10 | US$20 | US$0,50 | US$1,20 |
Leituras de tokens de entrada em cache têm 90% de desconto no GPT‑6, então, em execuções longas de agentes, a taxa de acerto do cache importa tanto quanto o preço de tabela. O post de lançamento da OpenAI não divulga preços de batch para nenhum dos modelos, e ambos ficam abaixo dos US$10 de entrada e US$50 de saída do GPT‑6 Astra.
As únicas condições de acesso mencionadas são plano e superfície de produto — é aí que a foto fica mais específica.
O GPT‑6 Sol e o Luna já estão disponíveis em várias plataformas:
ChatGPT Work e Codex para usuários Plus, Pro, Business, Enterprise e Edu, com o Luna também chegando aos usuários Free e Go no app de desktop.
Na API, eles aparecem como gpt-6-sol e gpt-6-luna. A OpenAI observa que a liberação no ChatGPT é gradual ao longo do dia, então pode levar um pouco para aparecer para todo mundo.
Além disso, ambos os modelos estão disponíveis via OpenRouter (como openai/gpt-6-sol e openai/gpt-6-luna), no GitHub Copilot, no Azure AI Foundry e no AWS Bedrock.
Na API, eles aparecem como gpt-6-sol e gpt-6-luna. A OpenAI observa que a liberação no ChatGPT é gradual ao longo do dia, então pode levar um pouco para aparecer para todo mundo. Uma chamada mínima fica assim:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="List the open pull requests that touch billing code and summarize the risk of each.",
)
print(response.output_text)
Se você vai migrar do GPT‑5.6, a orientação para o GPT‑6 (escrita para o Astra) diz para remover temperature e top_p, começar em low se você usava none ou minimal e, do contrário, manter o nível atual de esforço, além de trocar prompt_cache_retention por prompt_cache_options.ttl ajustado para 30 minutos.
Sol e Luna aproveitam a receita de treinamento do Astra para tornar o nível abaixo dramaticamente mais barato e rápido. O anúncio da OpenAI cita diretamente os modelos da Anthropic e reivindica vitórias em benchmarks ajustados por custo. É uma comparação interessante porque o Opus 5.5 também é um ganho de eficiência.
Minha leitura: se você roda agentes ou cargas de trabalho de código no GPT‑5.6 Sol ou Luna, mude agora. A mesma escada de esforço, metade do preço e, no nosso teste, a única coisa que o GPT‑6 Sol fez e o antecessor não fez foi se recusar a dar uma resposta confiante para uma pergunta que o algoritmo não podia responder. Se você usa Claude, os números ajustados por custo são o argumento para fazer seu próprio comparativo, em vez de só aceitar a palavra da OpenAI.
Se você quer construir em cima desses modelos, recomendo a trilha de habilidades OpenAI Fundamentals, que cobre a API de ponta a ponta em 15 horas.
Aprenda com a DataCamp
Curso
Curso
Curso
blog
Richie Cotton
7 min
blog
Abid Ali Awan
9 min
blog
Josep Ferrer
8 min
blog
Khalid Abdelaty
15 min
Tutorial
Josep Ferrer
11 min
Tutorial
Arunn Thevapalan
12 min






