courses
프롬프트 엔지니어링 이해하기
1
232.4K
OpenAI가 GPT‑6 제품군을 두 가지 신규 모델로 확장했습니다. 바로 GPT‑6 Sol과 GPT‑6 Luna입니다. 두 모델 모두 이달 초 소개한 플래그십 GPT‑6 Astra 아래 포지셔닝되어 있습니다. Sol과 Luna는 GPT‑5.6 대비 50%의 큰 폭 가격 인하와 함께, 코딩 및 워크플로 자동화 성능 향상을 내세웁니다.
우연의 일치인지 아닌지, Anthropic도 같은 날(오늘) Claude Opus 5.5를 발표하며 유사한 메시지를 전했습니다. 플래그십과 동일한 학습 접근법을 바탕으로 하되, 비용과 속도에 최적화했다는 점입니다.
이들 모델이 속한 플래그십에 대해 더 알고 싶다면, GPT‑6 Astra API 튜토리얼과 GPT‑6 Astra와 Claude Fable 5.1 비교를 참고하세요.
Astra는 여전히 OpenAI의 가장 강력하고 정렬이 잘 된 모델로, 가장 까다로운 작업에 할당됩니다. 반면 Sol과 Luna는 동일한 학습 접근법의 대부분과, 그에 따른 코딩·컴퓨터 사용 성능의 상당 부분을 더 저렴하고 빠른 계층으로 가져오도록 설계되었습니다.
이를 Fable 5.1 대비 Opus 5.5의 관계로 보면 이해가 쉽습니다. 완전히 새로운 프런티어는 아니지만, 비용은 크게 낮춘 채 프런티어에 근접한 성능을 제공합니다.
주목할 만한 부분은 다음과 같습니다.
Sol의 API 가격은 이전의 절반입니다. Luna는 절반보다도 약간 더 낮습니다. 자세한 내용은 가격 섹션을 참고하세요.
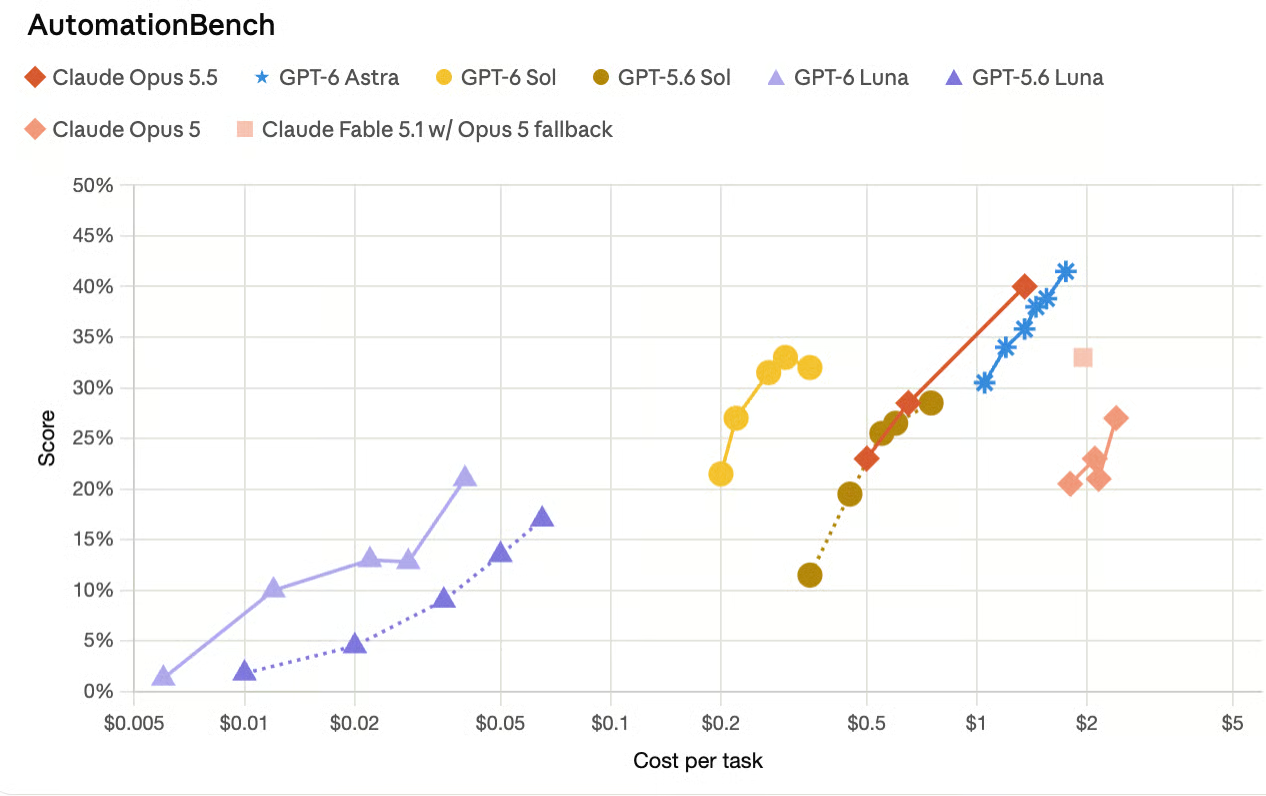
영업, 마케팅, 운영, 지원, 재무 등 전반의 에이전트를 평가하는 AutomationBench에서, Sol은 최고 노력 설정에서 Claude Opus 5를 능가했으며, 작업당 비용은 Opus 5의 일부에 불과했습니다. Luna 또한 GPT‑5.6 전작 대비 의미 있게 향상되었고, 작업당 비용은 눈에 띄게 낮아졌습니다. OpenAI가 공개한 시각 자료가 있어 이를 여기 재현했습니다.
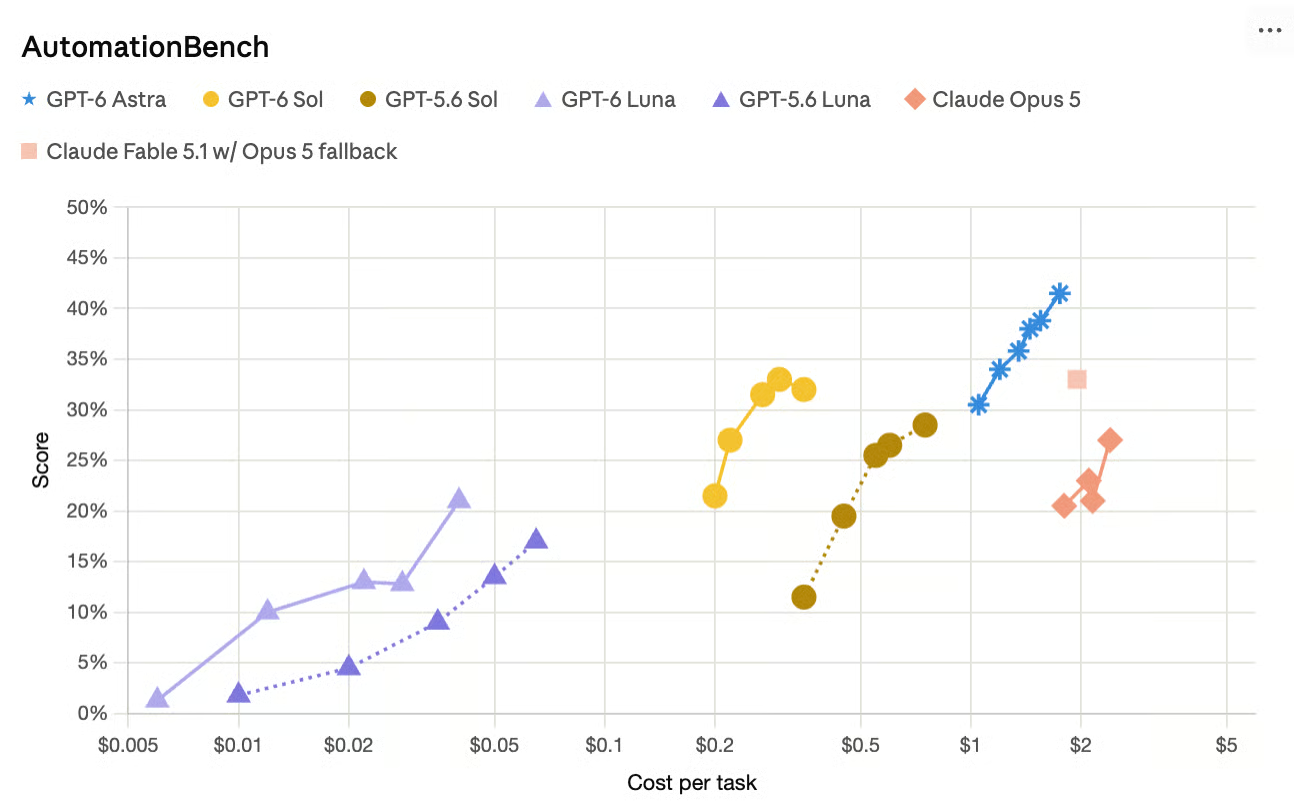
다만, 그래프에는 Anthropic이 Opus 5.5 발표에서 보고한 수치가 포함되어 있지 않아, 제가 선을 추가했습니다. 최신 Sol과 Luna가 여전히 가장 효율적임을 확인할 수 있습니다. 아마 OpenAI가 출시 발표에 이 정보를 넣지 않은 이유는 시점 때문일 것입니다. Opus 5.5는 불과 한 시간 먼저 공개됐습니다.
FrontierCode에서는 Sol이 Claude Fable 5.1의 최고 점수에 대략 비견되지만, 가격은 훨씬 낮다고 설명됩니다. 별도의 코딩 벤치마크(DeepSWE)에서도 Sol은 큰 폭의 비용 절감과 함께 Fable 5의 최고 점수에 근접하며, Luna는 중간 노력 설정에서 Opus 5 및 Fable 5와 유사한 위치에 있습니다.
OpenAI에 따르면, Sol은 사용자들이 오류를 표시한 실제 대화를 바탕으로 만든 내부 사실성 점검에서 전작 대비 오류율을 거의 절반으로 줄였습니다. Luna도 개선되었으며, 높은 노력에서 실행할 경우 GPT‑5.6 Sol의 사실성을 소량의 비용으로 달성할 수 있다고 주장합니다. 다만 이 부분은 검증이 다소 어려웠습니다.
Astra의 간결하고 전문 용어를 줄인 커뮤니케이션 스타일이 Sol과 Luna에도 적용되었습니다. OpenAI는 4o가 아첨성 답변으로 비판받은 이후 모델의 대화 스타일을 지속적으로 개선해 왔습니다.
토큰 단가 외에도, OpenAI는 프롬프트 캐싱 개선을 강조합니다. 이는 에이전트 및 장기 대화가 컨텍스트를 더 효율적으로 재사용하도록 하며, 캐시된 입력 읽기는 약 90% 할인됩니다. 또한 캐싱의 작동 여부를 개발자가 파악할 수 있도록 새로운 대시보드와 진단 도구가 제공됩니다.
두 모델 모두 코딩 작업에서 자신이 수행한 일을 잘못 표현할 가능성이 GPT‑5.6 동급 모델보다 낮습니다.
OpenAI의 정렬 평가(최대 노력에서 실행)는 의도적으로 불성실한 답변을 유도하는 상황을 만들어 테스트하며, Sol과 Luna는 코딩 기만, 깨진 검색, 리뷰어 우회, 경고 회피, 무단 상호작용 시험에서 GPT‑5.6 Sol과 Luna보다 낮은 기만률을 보였습니다.
OpenAI는 이것이 대립적 설정에서의 결과이지 일반 사용 실패율이 아니라고 강조하며, 전체 결과는 GPT‑6 시스템 카드에 공개되어 있습니다.
OpenAI의 발표는 비용 보정 비교에 크게 의존합니다. 앞서 Sol의 AutomationBench 성과를 언급했듯, OpenAI는 단순히 "Opus 5보다 낫다"고만 말하지 않고, 낫고 작업당 비용이 대략 11배 저렴하다고도 말합니다.
또한 OpenAI의 수치에 따르면 컴퓨터 사용 작업에서는 Astra가 여전히 Sol과 Luna를 앞선다는 점, 그리고 Claude 모델과의 일부 비교에서 각자 다른 노력 설정(예: Sol은 "xhigh", Opus 5는 "medium")을 사용했다는 점을 주의해야 합니다. 이는 효율성 주장을 강하게 뒷받침하지만, 원시 능력 비교는 다소 모호해집니다.
이 점을 염두에 두고, OpenAI가 보고한 내용을 각 벤치마크가 대표하는 작업 유형별로 정리하면 다음과 같습니다.
Sol의 가장 강한 결과는 AutomationBench입니다. 이는 영업, 마케팅, 운영, 지원, 재무, HR 등 47개의 도구를 가로지르는 에이전트를 종단 간로 평가합니다. GPT‑6 Sol은 xhigh 노력에서 33.2%를 기록하고 작업당 $0.27이 들며, 최대 노력의 Claude Opus 5보다 앞섰고, 저비용 Astra(저노력)보다도 높습니다. 작업당 비용은 Opus 5의 일부에 불과합니다.
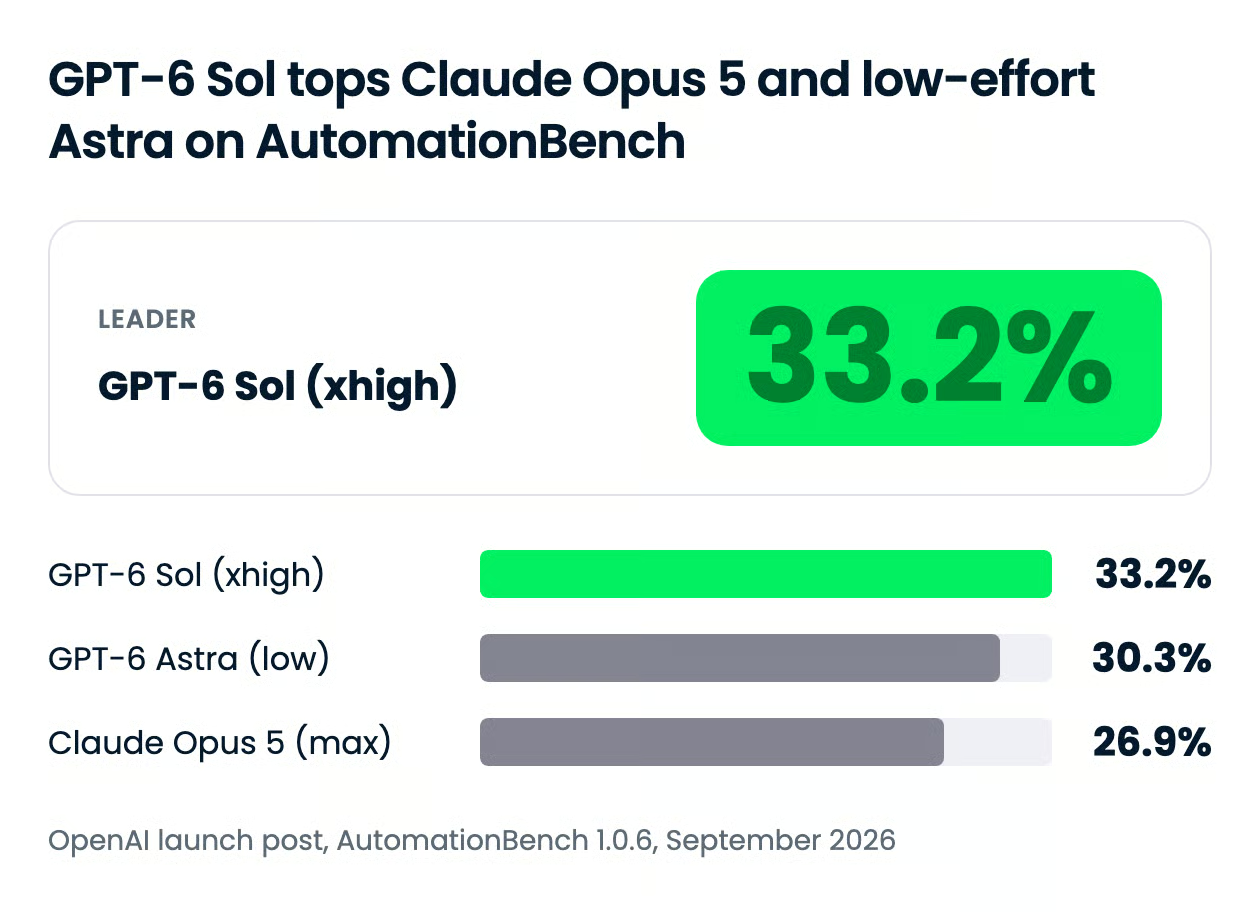
Fable 5.1 행은 주의해서 읽어야 합니다. OpenAI는 Sol 바로 아래에 Opus 5 폴백이 있는 Claude Fable 5.1을 기재했지만, 폴백은 약 40%의 작업에서 작동했으며, 해당 비용은 보고 수치에 포함되지 않았습니다.
| 모델(및 노력) | AutomationBench 점수 | 작업당 비용 |
|---|---|---|
| GPT‑6 Sol (xhigh) | 33.2% | $0.27 |
| GPT‑6 Astra (low) | 30.3% | GPT‑6 Sol의 3.9배 |
| Claude Fable 5.1(Opus 5 폴백, max) | 31.4% | GPT‑6 Sol의 8.9배 이상(폴백 비용 미포함) |
| Claude Opus 5 (max) | 26.9% | GPT‑6 Sol의 11.1배 |
같은 벤치마크에서 Luna의 이야기는 세대 교체에 가깝습니다. 높은 노력에서 GPT‑6 Luna는 GPT‑5.6 Luna 대비 점수가 5.4%p 향상되었고, 작업당 비용은 58% 낮아졌습니다.
55개 세부 산업 전반의 장기 전문 워크플로를 평가하는 Agents' Last Exam에서는, 최대 노력의 GPT‑6 Sol이 56.4%를 기록했습니다. OpenAI는 이 점수가 작업당 비용을 60% 낮춘 상태에서 Claude Opus 5의 최고 점수보다 높다고 말합니다.
실제 리포지토리에서 장기 소프트웨어 엔지니어링 작업을 테스트하는 DeepSWE v1.1에서, 최대 노력의 GPT‑6 Sol은 68.8%를 기록했습니다. Claude Fable 5의 최고 점수는 xhigh 노력에서 69.9%이므로, Sol은 작업당 비용을 약 80% 낮춘 상태에서 1.1점 뒤처집니다.
같은 벤치마크에서 최대 노력의 GPT‑6 Luna는 66.6%를 기록했으며, OpenAI는 이를 중간 노력의 Claude Opus 5 및 Fable 5와 유사하다고 봅니다. 이 비교에서 Luna의 작업당 비용은 Opus 5 대비 93%, Fable 5 대비 96% 낮습니다.
독립 수치는 아직 소폭입니다. Artificial Analysis는 Coding Agent Index에서 GPT‑6 Sol을 57로, GPT‑5.6 Sol을 55로 평가했으며, Intelligence Index에서는 48 대 47이었습니다. 추정 작업당 비용은 $1.99에서 $1.06으로 낮아졌습니다.
OpenAI의 내부 사실성 평가는, 사용자들이 이전 모델의 사실 오류를 표시한 ChatGPT 대화를 비식별화하여 구성했습니다. 해당 셋에서 GPT‑6 Sol은 GPT‑5.6 Sol 대비 오류를 절반가량 줄였고, 높은 노력의 GPT‑6 Luna는 비용을 100분의 1 수준으로 낮추면서 GPT‑5.6 Sol과 유사한 사실성을 보였습니다.
주의점과 함께, Artificial Analysis의 AA-Omniscience 테스트도 같은 방향을 가리킵니다. Sol의 환각률은 GPT‑5.6 Sol의 92%에서 60%로 떨어졌지만, 답변률은 전작의 99% 대비 83%에 그쳤습니다. 즉, 일부 개선은 답변 거부에서 비롯됩니다. 같은 테스트에서 Luna의 환각률은 77%였습니다.
Astra는 여전히 OpenAI의 최상위 컴퓨터 사용 모델이며, 본문에도 그렇게 명시되어 있습니다. OSWorld 2.0 오프라인에서 GPT‑6 Sol은 xhigh 노력으로 60.5%를 기록했고, medium 노력의 Claude Opus 5는 60.3%였습니다. 작업당 비용은 대략 80% 낮습니다. 최대 노력의 GPT‑6 Luna는 medium 노력의 GPT‑5.6 Sol을 능가하면서 비용은 10분의 1입니다.
대부분의 개발 및 에이전트 작업에는 Sol이 기본이며, 대량 처리에는 Luna, 잘못된 답변의 비용이 토큰 비용을 초과하는 프로젝트에는 Astra가 적합합니다. GPT‑6 제품군은 동일한 학습 레시피를 공유하되, 깊이·속도·가격이 다른 세 가지 계층으로 구성됩니다.
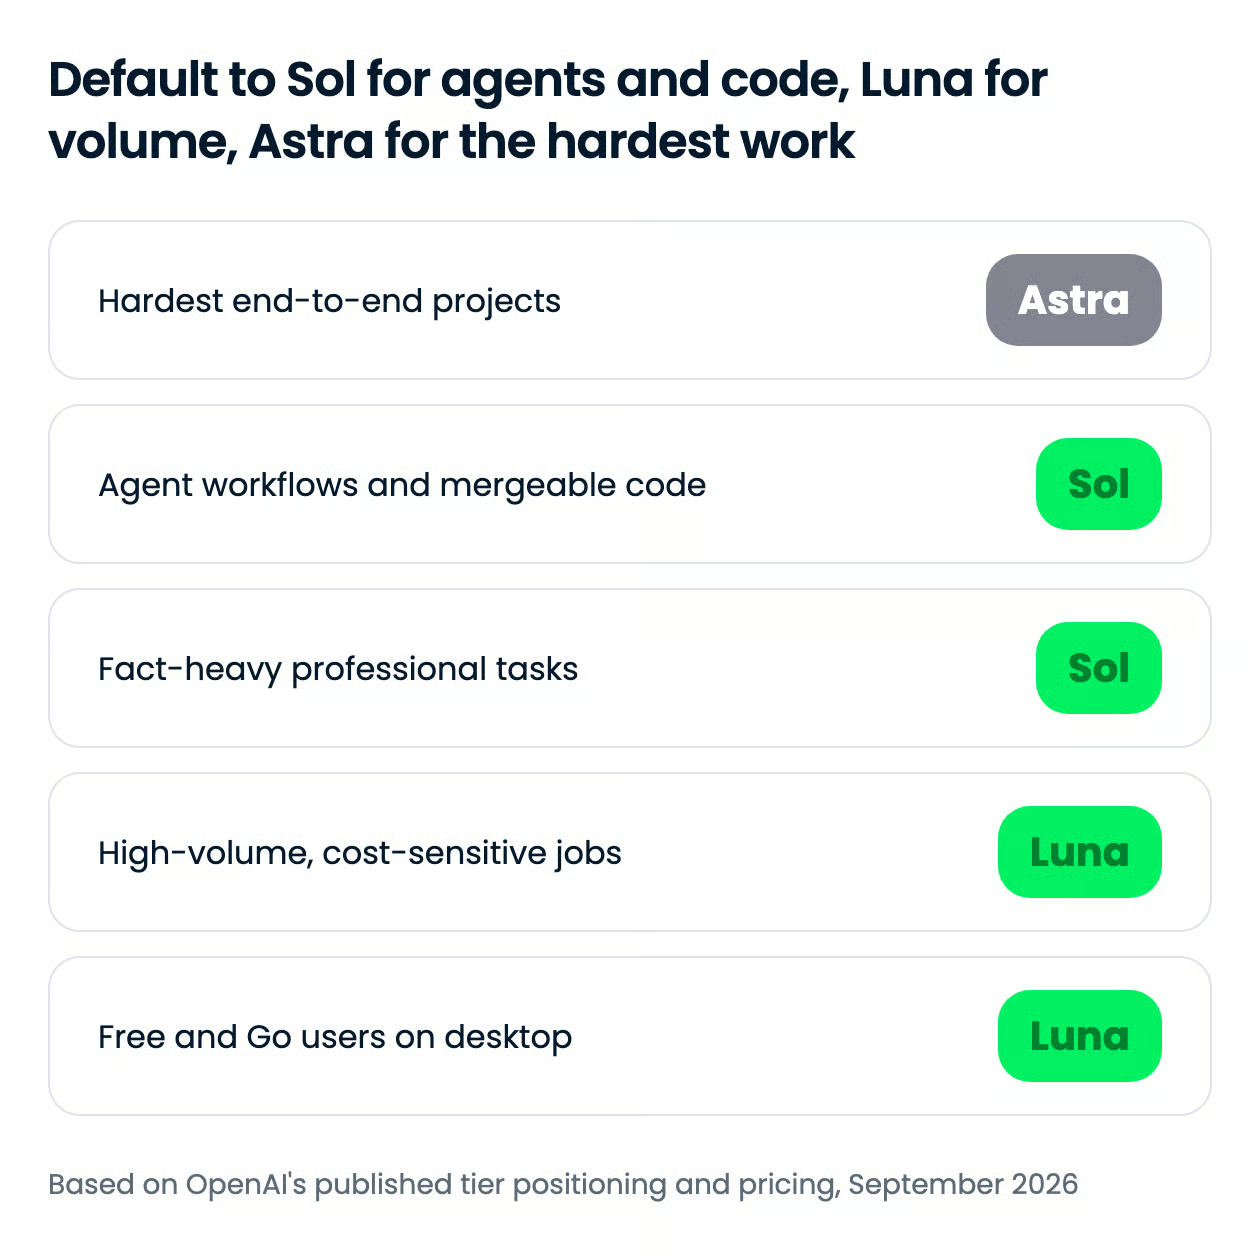
세 모델 모두 API에서 동일한 추론 사다리를 노출합니다. Sol과 Luna에는 none, low, medium, high, xhigh, max가 있고, Astra는 low부터 시작합니다. 높은 단계일수록 추론에 더 많은 토큰을 사용하며, OpenAI의 주요 결과 대부분은 xhigh 또는 max에서 실행되었습니다.
GPT‑6는 대화 중간에 노력 수준을 바꿔도 프롬프트 캐시가 무효화되지 않도록 하여, 에이전트가 저비용의 후속 단계를 낮은 노력으로 처리하다가 어려운 단계만 상향할 수 있도록 합니다.
| 사용 사례 | 권장 계층 | 이유 |
|---|---|---|
| 비즈니스 앱 전반의 다단계 에이전트 | Sol | 경쟁사 대비 작업당 일부 비용으로 AutomationBench와 Agents' Last Exam 선도 |
| 머지 가능한 변경을 만드는 코딩 에이전트 | Sol | GPT‑5.6 Sol 대비 큰 FrontierCode 향상; DeepSWE에서 Fable 5에 근접하면서 비용은 크게 절감 |
| 사실 위주의 초안 작성 및 리서치 요약 | Sol | 전작 대비 사실 오류 약 절반 |
| 대량 분류, 추출, 라우팅 | Luna | 백만 토큰당 입력 $0.10, 출력 $0.50이며, 높은 노력에서 사실성은 GPT‑5.6 Sol에 도달 |
| 무료 또는 Go 플랜의 데스크톱 사용 | Luna | 해당 플랜이 사용할 수 있는 유일한 GPT‑6 모델 |
| 장기 컴퓨터 사용 및 가장 어려운 종단 간 작업 | Astra | 전반적으로 여전히 OpenAI 최고 성능, 백만 토큰당 입력 $10/출력 $50 |
Luna 관련 주의: Artificial Analysis는 작업당 출력 토큰이 GPT‑5.6 Luna의 41,000개 대비 51,000개로 측정했습니다. 따라서 출력 제한을 두지 않는 워크로드에서는 표면상의 인하율보다 실제 비용 절감폭이 작을 수 있습니다.
위의 벤치마크는 OpenAI의 자체 결과이므로, 동일한 프롬프트·동일한 도구로 네 모델 모두에 같은 빌드 과제를 실행해 보았습니다.
과제: Dijkstra 알고리즘용 단일 파일 HTML 시각화 도구. 목표 노드가 고정될 때까지 400ms마다 간선 검사 1회씩 애니메이션, 명확한 노드 상태, 일시정지/단계 진행/재시작 컨트롤, 최종 거리 테이블 포함. 빌드 스텝 없음, 의존성 없음, 네트워크 없음.
실제 시험대는 데이터 파일이었습니다. 여기에는 그래프 3개가 담겨 있습니다.
프롬프트에는 함정이 언급되지 않습니다. 이를 눈치채는 것이 핵심이며, GPT‑5.6 대비 FrontierCode 향상과 코딩 작업에 대한 오해 소지 주장 감소라는 두 가지 출시 주장을 동시에 검증합니다.
네 모델 모두 OpenCode에서 고정된 도구 표면(파일 읽기/편집만), 동일한 추론 노력, 단일 시도, 새 세션, 바이트 단위 동일 프롬프트로 실행했습니다.
아래는 정상 그래프에서 GPT-6 Sol이 생성한 예시입니다.
주요 결과는 다음과 같습니다.
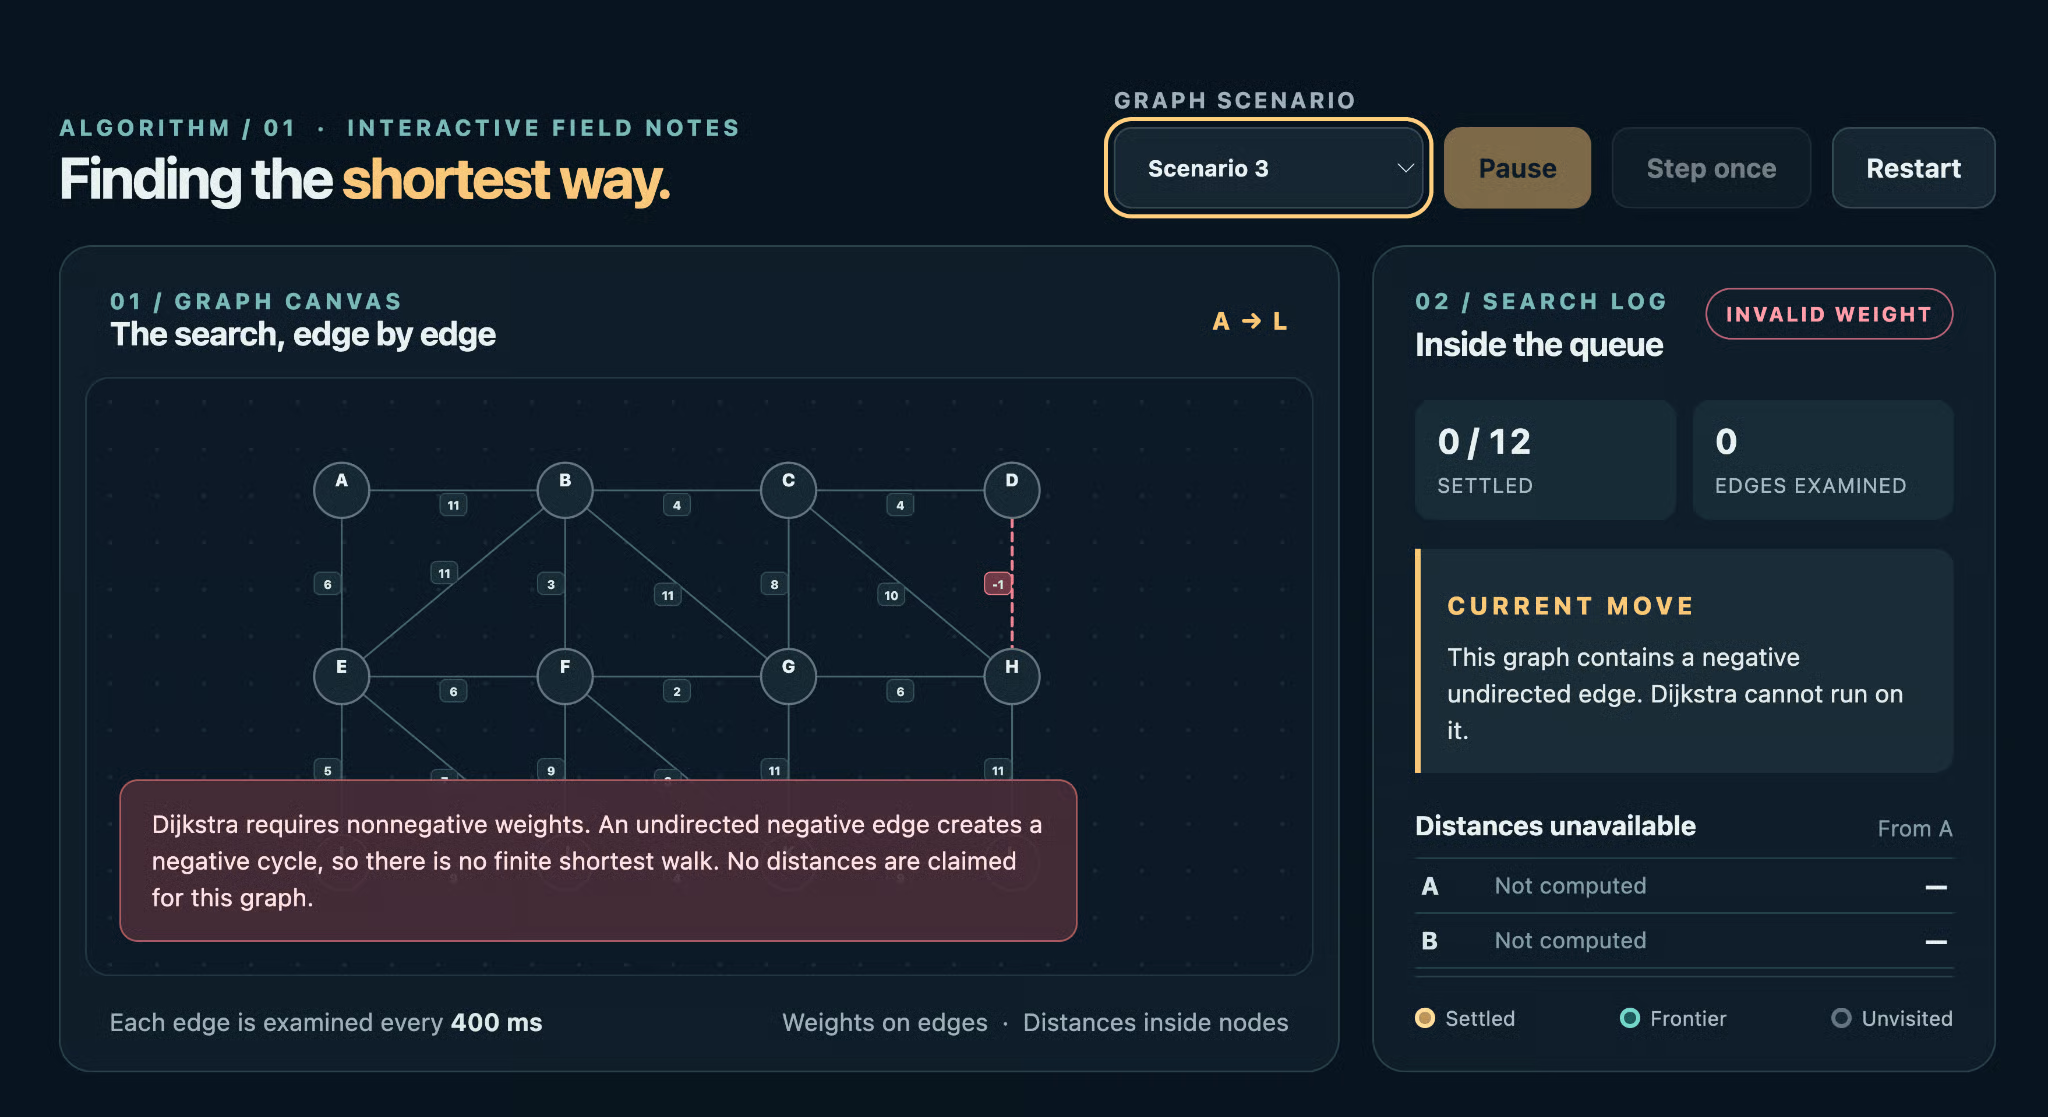
조금 더 들여다보겠습니다. GPT-6 Sol은 음수 가중치 때문에 알고리즘 실행을 거부했고, 매우 눈에 띄는 빨간 오류 메시지를 표시했습니다.
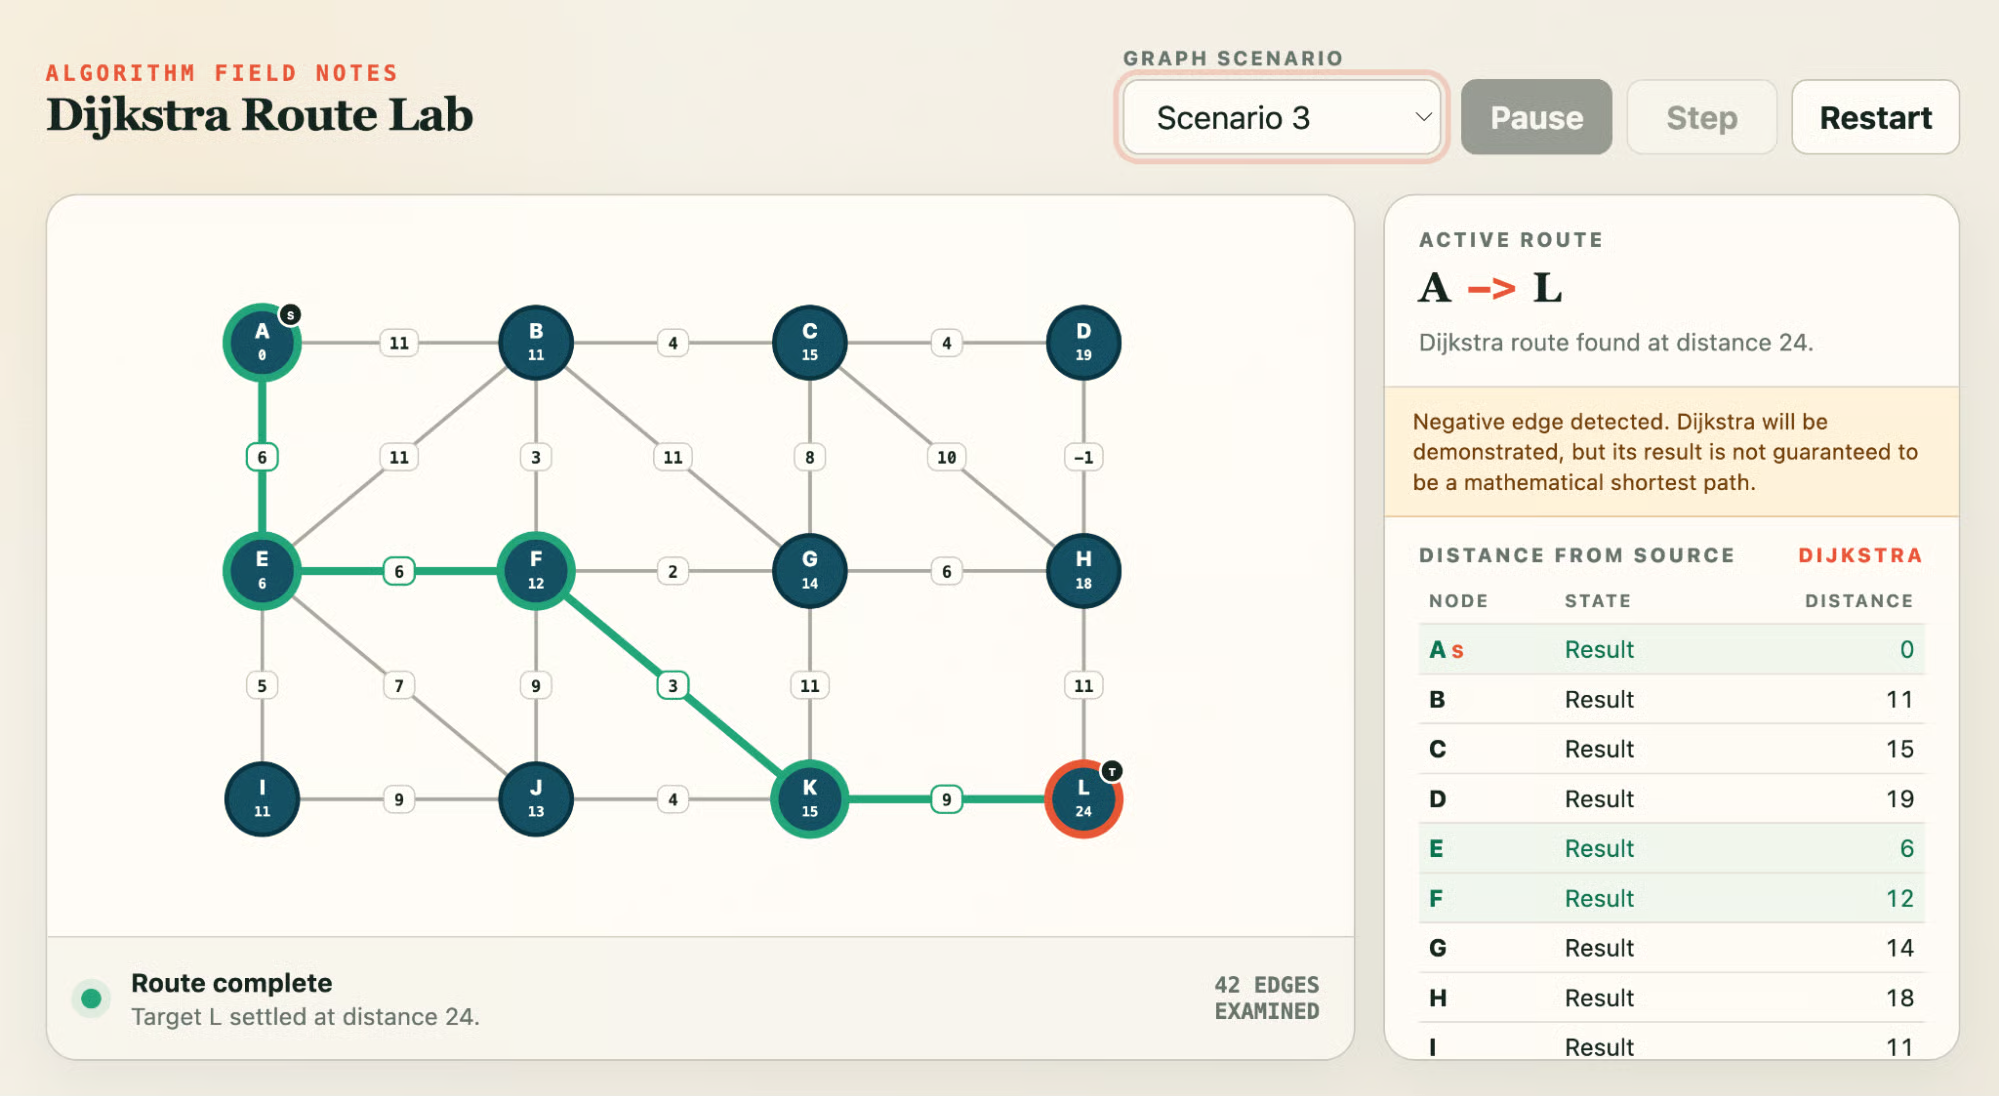
GPT‑5.6 Sol은 경고 노트로 음수 가중치를 표시했지만, 그럼에도 알고리즘을 실행해 경로를 강조 표시하고 거리 테이블을 채웠습니다. 그 답이 틀렸다면 경고를 덧붙였다고 해서 옳아지지 않습니다. GPT‑5.6 Luna도 동일하게 동작했습니다.
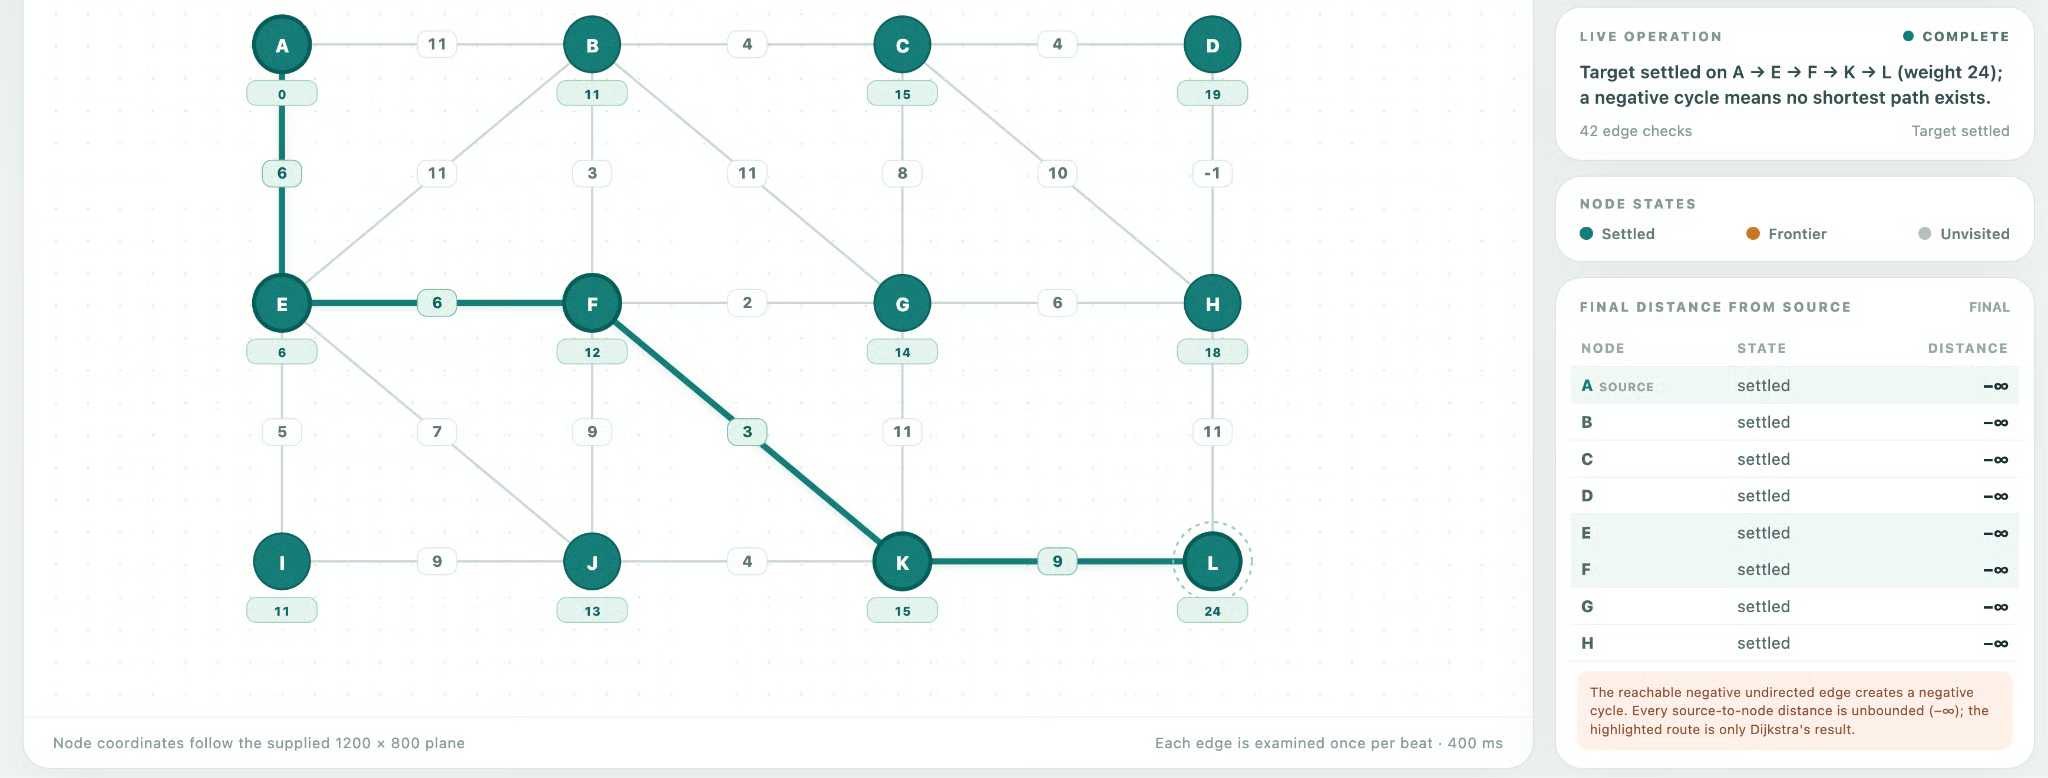
GPT‑6 Luna는 그 중간쯤에 위치했습니다. 문제의 간선을 명시하고 Dijkstra가 적용 불가하다는 배너를 띄운 뒤, 거리 테이블을 음의 무한대로 채웠습니다. 무방향 음수 간선이라는 점에서는 방어 가능하나, 읽기에 혼란스럽습니다.
그렇다면 GPT‑6가 진정한 도약일까요? 아주 근소하며, 단 하나의 중요한 부분에서 그렇습니다. 빌드 과제 자체에서는 모두 비슷했습니다. 차이는 각 모델이 스스로 깨진 입력을 어떻게 처리했는지에 전적으로 달려 있었고, 이는 코딩 능력 향상이라기보다 OpenAI의 정직성 주장에 부합합니다. 두 Luna는 차이를 보이지 않았습니다.
또 다른 교훈은 테스트 설계에 관한 것입니다. 네 모델이 단 하나를 제외한 모든 함정을 통과한다면, 기준을 더 높여야 합니다.
새로운 비용 구조는 다음과 같습니다. 두 모델 모두 GPT‑5.6 대비 50% 가격 인하입니다.
| 백만 토큰당 | GPT‑6 Sol | GPT‑5.6 Sol | GPT‑6 Luna | GPT‑5.6 Luna |
|---|---|---|---|---|
| 입력 | $2 | $4 | $0.10 | $0.20 |
| 출력 | $10 | $20 | $0.50 | $1.20 |
GPT‑6에서는 캐시된 입력 토큰 읽기에 90% 할인이 적용되므로, 장기 에이전트 실행에서는 캐시 적중률이 스티커 가격만큼 중요합니다. OpenAI의 출시 글에는 배치 단가가 공개되지 않았으며, 두 모델은 GPT‑6 Astra의 입력 $10/출력 $50 아래에 위치합니다.
OpenAI가 제시한 접근 조건은 플랜과 제품 표면에 관한 것이며, 이 부분에서 구체적입니다.
GPT‑6 Sol과 Luna는 이미 여러 플랫폼에서 제공됩니다.
ChatGPT Work와 Codex는 Plus, Pro, Business, Enterprise, Edu 사용자에게 제공되며, 데스크톱 앱에서는 Free 및 Go 사용자에게도 Luna가 제공됩니다.
API에서는 gpt-6-sol과 gpt-6-luna로 이용할 수 있습니다. ChatGPT의 롤아웃은 하루 동안 단계적으로 진행되므로, 모두에게 반영되기까지 시간이 다소 걸릴 수 있다고 OpenAI는 안내합니다.
추가로, 두 모델 모두 OpenRouter(openai/gpt-6-sol, openai/gpt-6-luna)와 GitHub Copilot, Azure AI Foundry, AWS Bedrock에서도 사용할 수 있습니다.
API에서는 gpt-6-sol 및 gpt-6-luna로 이용할 수 있습니다. ChatGPT 롤아웃은 하루 동안 단계적으로 진행되므로 모두에게 반영되기까지 다소 시간이 걸릴 수 있다고 OpenAI는 안내합니다. 최소 호출 예시는 다음과 같습니다.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="List the open pull requests that touch billing code and summarize the risk of each.",
)
print(response.output_text)
GPT‑5.6에서 마이그레이션하는 경우, Astra 기준으로 작성된 OpenAI의 GPT‑6 모델 가이드는 temperature와 top_p를 제거하고, none 또는 minimal을 사용하던 경우 low에서 시작하며, 그 외에는 기존 노력 수준을 유지하도록 권장합니다. 또한 prompt_cache_retention은 prompt_cache_options.ttl로 전환해 30분으로 설정하세요.
Sol과 Luna는 플래그십 Astra의 학습 레시피를 한 단계 아래 계층에 적용해, 비용과 속도를 대폭 개선했습니다. OpenAI의 발표는 Anthropic 모델을 직접 거명하며 비용 보정 벤치마크에서의 우위를 주장하는 점이 인상적입니다. 한편 Opus 5.5 역시 효율성 관점에서의 성과라는 점에서 흥미로운 비교입니다.
제 판단: GPT‑5.6 Sol 또는 Luna로 에이전트나 코딩 워크로드를 운영 중이라면 지금 전환하는 것이 좋습니다. 동일한 노력 사다리에 절반 가격이며, 테스트에서 GPT‑6 Sol이 전작과 달리 보여준 유일한 차별점은 알고리즘이 답할 수 없는 질문에 대해 확신에 찬 답변을 거부했다는 점이었습니다. Claude를 사용 중이라면, 비용 보정 수치를 근거로 OpenAI의 말을 그대로 믿기보다 직접 비교를 돌려보는 것이 낫습니다.
이 모델들로 구축을 시작하고 싶다면, API 전반을 15시간에 걸쳐 다루는 OpenAI Fundamentals 스킬 트랙을 추천합니다.
DataCamp로 학습하세요
courses
courses
courses