Cursus
Prompt Engineering begrijpen
1 Hr
232.4K
OpenAI heeft zojuist de GPT‑6-familie uitgebreid met twee nieuwe modellen: GPT‑6 Sol en GPT‑6 Luna, beide gepositioneerd onder vlaggenschip GPT‑6 Astra, waar we eerder deze maand over schreven. Zowel Sol als Luna komen met forse prijsverlagingen (50% korting ten opzichte van hun GPT‑5.6-prijzen) en leveren bovendien winst op in coderen en workflowautomatisering.
Toevallig of niet, Anthropic bracht op dezelfde dag (vandaag) Claude Opus 5.5 uit, met een vergelijkbare pitch: dezelfde trainingsaanpak als het vlaggenschip, geoptimaliseerd voor kosten en snelheid.
Wil je meer weten over het vlaggenschip waar ze onder vallen, bekijk dan onze GPT‑6 Astra API-tutorial en onze vergelijking van GPT‑6 Astra en Claude Fable 5.1.
Astra blijft OpenAI's meest capabele en best uitgelijnde model, gereserveerd voor het meest veeleisende werk. Maar Sol en Luna zijn gebouwd om veel van diezelfde trainingsaanpak, en een groot deel van de resulterende performance in coderen, computergebruik, enz., naar goedkopere, snellere lagen te brengen.
Zie het als dezelfde relatie die Opus 5.5 heeft met Fable 5.1: geen nieuwe frontier, maar frontier-achtige prestaties tegen een fractie van de kosten.
Een paar dingen die het bekijken waard zijn:
De API-prijs van Sol is gehalveerd ten opzichte van eerder. De prijs van Luna is zelfs iets minder dan de helft. Je vindt meer details in de prijssectie.
Op AutomationBench, dat agents test over sales, marketing, operations, support, finance en dergelijke, presteert Sol op de hoogste inspanningsstand beter dan Claude Opus 5, en dat tegen een klein deel van de per-taakkosten van Opus 5. Luna verbeterde ook aanzienlijk ten opzichte van zijn GPT‑5.6-voorganger terwijl het per taak duidelijk goedkoper werd. OpenAI voegde een mooie visual toe, die ik hier heb gereproduceerd:
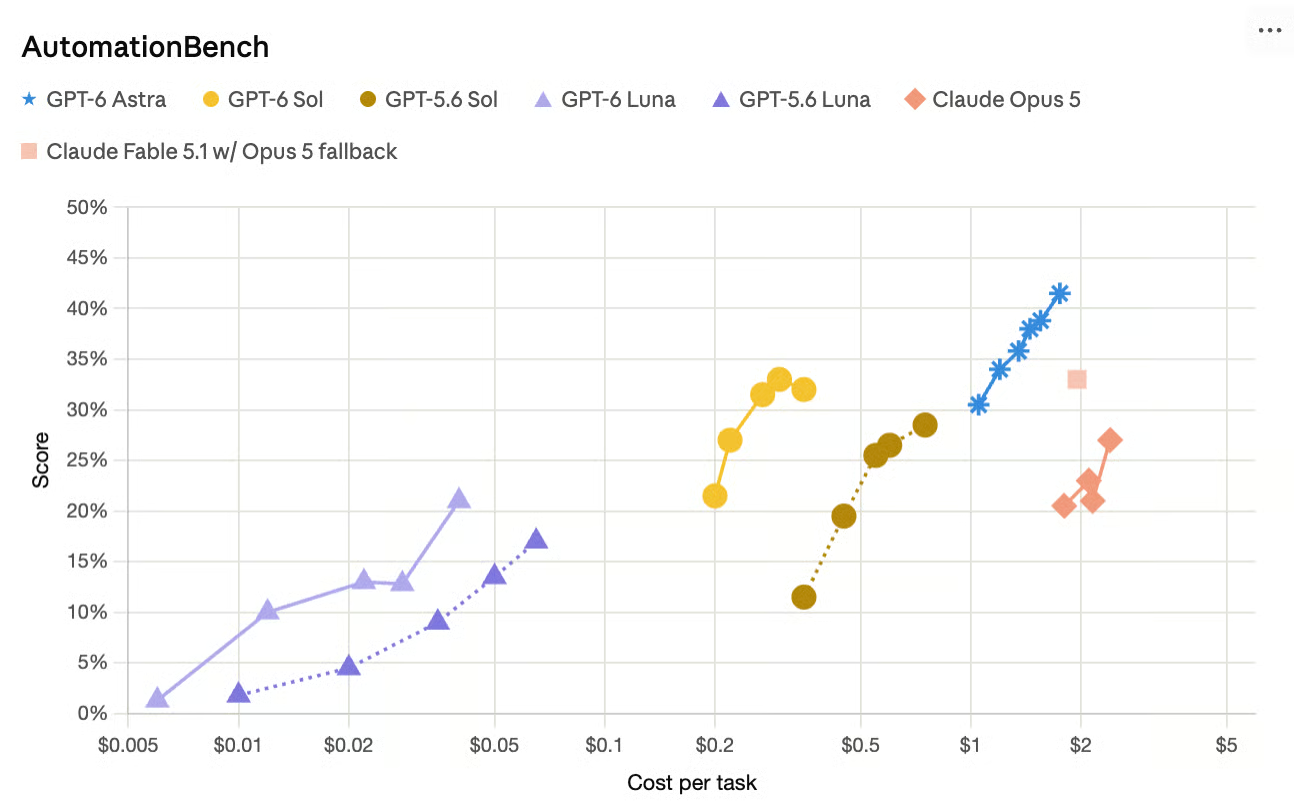
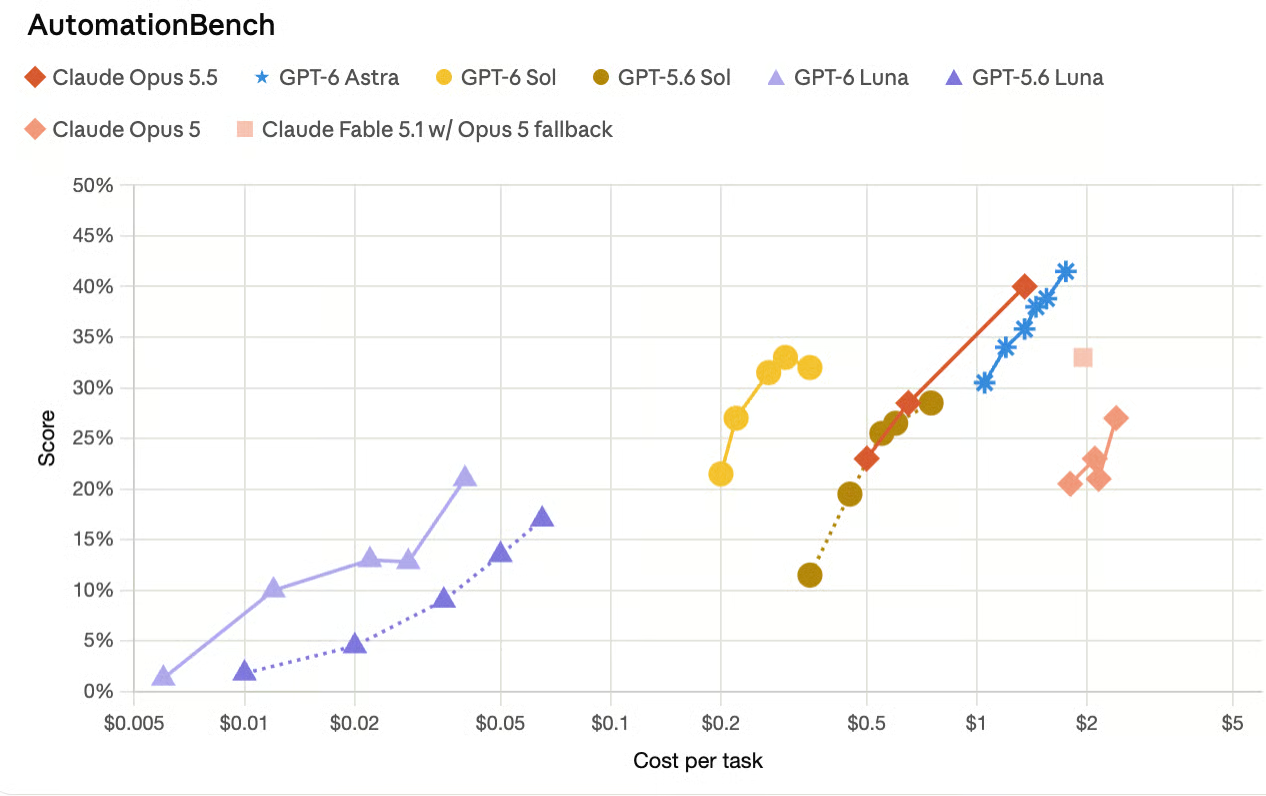
Het viel me op dat de grafiek de Opus 5.5-cijfers die Anthropic rapporteerde in de Opus 5.5-aankondiging niet bevatte, dus ik heb een nieuwe set lijnen toegevoegd. We zien dat de nieuwste versies van Sol en Luna nog steeds het meest efficiënt zijn. Waarschijnlijk is de enige reden dat OpenAI deze informatie niet in hun launchaankondiging opnam de timing. Opus 5.5 kwam slechts een uur eerder uit.
Op FrontierCode wordt Sol beschreven als ongeveer gelijk aan de topscore van Claude Fable 5.1, maar voor een veel lagere prijs. Op een aparte codeerbenchmark (DeepSWE) komt Sol dicht bij Fable 5's beste score met een grote kostenbesparing, en wordt Luna gepositioneerd als vergelijkbaar met Opus 5 en Fable 5 bij middenniveau-inspanningsstanden.
OpenAI zegt dat Sol het foutenpercentage van zijn voorganger ongeveer halveert op een interne factualiteitscheck, opgebouwd uit echte gesprekken waarin gebruikers fouten hadden gemarkeerd. Luna verbeterde ook; volgens OpenAI kan het bij hogere inspanning de factualiteit van GPT‑5.6 Sol evenaren tegen een fractie van de kosten. Dit was lastiger te verifiëren.
Astra's beknoptere, minder jargonrijke communicatiestijl is overgebracht naar Sol en Luna. OpenAI blijft de conversatiestijl van hun modellen optimaliseren sinds 4o veel kritiek kreeg voor het slaafs bevestigend zijn.
Naast per-tokenprijzen benadrukt OpenAI verbeteringen in promptcaching die agents en lange gesprekken moeten helpen context efficiënter te hergebruiken, met cached input-reads die circa 90% korting krijgen. Nieuwe dashboards en diagnostiek moeten ontwikkelaars helpen zien waar caching wel en niet werkt.
Beide modellen zijn minder geneigd dan hun GPT‑5.6-tegenhangers om verkeerd weer te geven wat ze deden bij een codeertaak.
OpenAI's alignment-evaluaties, gedraaid op maximale inspanning, zetten bewust situaties op die om oneerlijkheid vragen, en Sol en Luna noteren lagere deceptiecijfers dan GPT‑5.6 Sol en Luna op de tests voor coding deception, broken search, reviewer bypass, warning circumvention en unauthorized interaction.
OpenAI benadrukt dat dit adversariële setups zijn, geen faalpercentages bij typisch gebruik, en publiceert de volledige resultaten in de GPT‑6 system card.
OpenAI's eigen release leunt sterk op kosten-gecorrigeerde vergelijkingen. Eerder noemde ik Sol's AutomationBench-prestaties. OpenAI zegt niet alleen dat het "beter is dan Opus 5", maar ook dat het beter is en ongeveer 11 keer goedkoper per taak.
Het is ook het vermelden waard dat OpenAI's eigen cijfers laten zien dat Astra nog steeds voorloopt op Sol en Luna bij computergebruikstaken, en dat sommige vergelijkingen met Claude-modellen verschillende inspanningsstanden aan elke kant gebruiken (bijv. Sol op "xhigh" versus Opus 5 op "medium"), wat de efficiëntieclaims oprecht sterk maakt maar de ruwe capaciteitsvergelijkingen wat lastiger vast te pinnen.
Met die kanttekening, hier is wat OpenAI rapporteerde, gegroepeerd naar het soort werk waar elke benchmark voor staat.
Sol's sterkste resultaat is op AutomationBench, Zapier's test van agents die end-to-end werken over 47 tools in sales, marketing, operations, support, finance en HR. GPT‑6 Sol op xhigh-inspanning scoort 33,2% voor $0,27 per taak, boven Claude Opus 5 op maximale inspanning en zelfs boven GPT‑6 Astra op lage inspanning, en tegen een klein deel van de per-taakkosten van Opus 5.
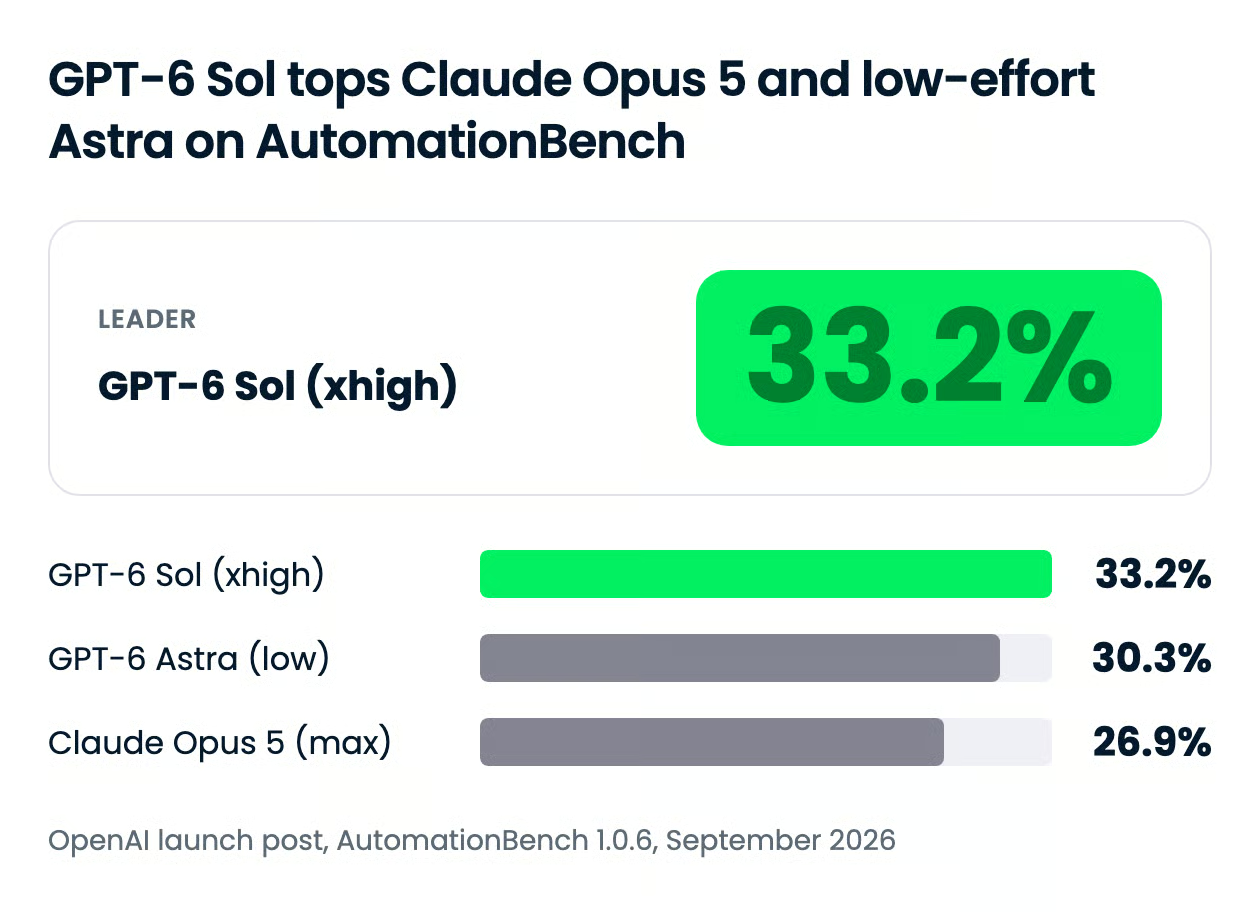
De rij voor Fable 5.1 moet je aandachtig lezen. OpenAI vermeldt Claude Fable 5.1 met een Opus 5-fallback net onder Sol, maar die fallback trad op bij ongeveer 40% van de taken, en de kosten daarvan zijn niet opgenomen in het gerapporteerde cijfer.
| Model (en inspanning) | AutomationBench-score | Kosten per taak |
|---|---|---|
| GPT‑6 Sol (xhigh) | 33,2% | $0,27 |
| GPT‑6 Astra (laag) | 30,3% | 3,9x GPT‑6 Sol |
| Claude Fable 5.1 met Opus 5-fallback (max) | 31,4% | Meer dan 8,9x GPT‑6 Sol (fallback-kosten niet gerapporteerd) |
| Claude Opus 5 (max) | 26,9% | 11,1x GPT‑6 Sol |
Luna's verhaal op dezelfde benchmark is er een van een nieuwe generatie. Bij hoge inspanning verbetert GPT‑6 Luna ten opzichte van GPT‑5.6 Luna met 5,4 procentpunt bij 58% lagere kosten per taak.
Op Agents' Last Exam, dat agents evalueert op langetermijn-beroepsworkflows in 55 subindustrieën, scoort GPT‑6 Sol op maximale inspanning 56,4%. OpenAI zegt dat dit boven de beste score van Claude Opus 5 in de evaluatie ligt, tegen 60% lagere kosten per taak.
Op DeepSWE v1.1, dat agents test op langetermijnsoftware-engineeringtaken in echte repositories, scoort GPT‑6 Sol op maximale inspanning 68,8%. Claude Fable 5's beste score in de evaluatie is 69,9% bij xhigh-inspanning, dus Sol komt 1,1 punt daarachter tegen ongeveer 80% lagere kosten per taak.
GPT‑6 Luna scoort op maximale inspanning 66,6% op dezelfde benchmark, wat OpenAI vergelijkbaar noemt met Claude Opus 5 en Fable 5 bij medium inspanning. Luna kost in die vergelijkingen 93% minder per taak dan Opus 5 en 96% minder dan Fable 5.
Onafhankelijke cijfers zijn tot nu toe bescheiden. Artificial Analysis zet GPT‑6 Sol op 57 op zijn Coding Agent Index tegen 55 voor GPT‑5.6 Sol, en op 48 tegen 47 op zijn Intelligence Index, met geschatte kosten per taak dalend van $1,99 naar $1,06.
OpenAI's interne factualiteitsevaluatie is opgebouwd uit geanonimiseerde ChatGPT-gesprekken waarin gebruikers een feitelijke fout van een eerder model markeerden. Op die set maakt GPT‑6 Sol ongeveer half zoveel fouten als GPT‑5.6 Sol, en GPT‑6 Luna op hogere inspanning evenaart GPT‑5.6 Sol tegen ongeveer een honderdste van de kosten.
De AA-Omniscience-test van Artificial Analysis wijst dezelfde kant op, met een kanttekening: Sol's hallucinatiepercentage daalde van 92% voor GPT‑5.6 Sol naar 60%, maar het beantwoordde slechts 83% van de vragen tegen 99% voor zijn voorganger, dus een deel van de winst komt door niet te antwoorden. Luna's hallucinatiepercentage op dezelfde test was 77%.
Astra is nog steeds OpenAI's beste model voor computergebruik, en de post zegt dat ook. Op OSWorld 2.0 offline scoort GPT‑6 Sol bij xhigh-inspanning 60,5% tegen 60,3% voor Claude Opus 5 bij medium inspanning, tegen ongeveer 80% lagere kosten per taak. GPT‑6 Luna op max overtreft GPT‑5.6 Sol op medium tegen een tiende van de kosten.
Sol is de standaard voor het meeste ontwikkelaars- en agentwerk, Luna is voor volume, en Astra is voor de projecten waar een fout antwoord meer kost dan de tokens. De GPT‑6-familie heeft nu drie lagen die een trainingsrecept delen en verschillen in diepte, snelheid en prijs.
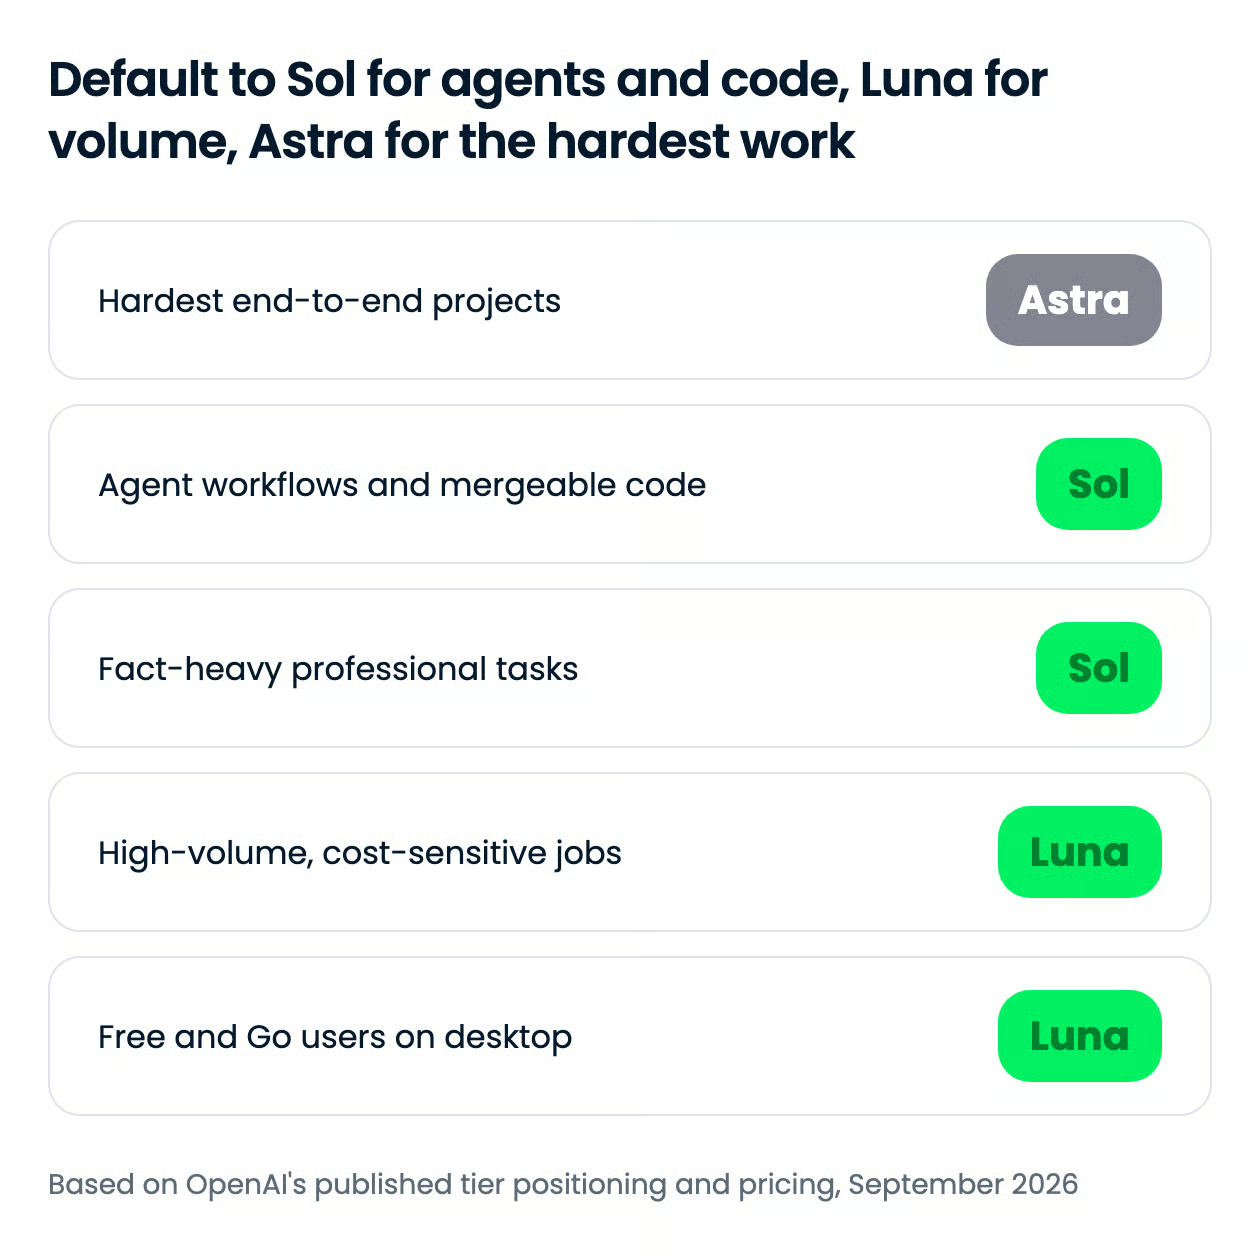
Alle drie bieden dezelfde redeneerlader in de API: none, low, medium, high, xhigh en max voor Sol en Luna, met Astra dat begint op low. Hogere treden besteden meer tokens aan redeneren, en de meeste headline-resultaten van OpenAI zijn gedraaid op xhigh of max.
GPT‑6 laat je ook de inspanning midden in een gesprek wijzigen zonder de promptcache ongeldig te maken, zodat een agent goedkope follow-ups op lage inspanning kan draaien en alleen de moeilijke stappen kan opschalen.
| Use case | Laag | Waarom |
|---|---|---|
| Meertrapsagents over bedrijfsapps | Sol | Leidt AutomationBench en Agents' Last Exam tegen een fractie van de per-taakkosten van rivalen |
| Codeeragents die mergebare changes produceren | Sol | Aanzienlijke FrontierCode-winst ten opzichte van GPT‑5.6 Sol; dicht bij Fable 5 op DeepSWE tegen veel lagere kosten |
| Feitrijke drafts en onderzoeks-samenvattingen | Sol | Ongeveer de helft van de feitelijke fouten van zijn voorganger |
| Classificatie, extractie en routing op volume | Luna | $0,10 input en $0,50 output per 1M tokens, en evenaart nu GPT‑5.6 Sol op factualiteit bij hogere inspanning |
| Desktopgebruik op een Free- of Go-abonnement | Luna | Het enige GPT‑6-model dat die abonnementen krijgen |
| Langetermijn computergebruik en het zwaarste end-to-end werk | Astra | Nog steeds OpenAI's beste over de hele linie, voor $10 input en $50 output per 1M tokens |
Eén waarschuwing over Luna: Artificial Analysis mat dat het 51.000 outputtokens per taak produceerde tegen 41.000 voor GPT‑5.6 Luna, dus bij workloads waar je de output niet begrenst, is de prijsdaling kleiner dan het etiket doet vermoeden.
De benchmarks hierboven zijn van OpenAI zelf, dus ik draaide één buildtaak tegen alle vier modellen met een identieke prompt en identieke tooling.
De taak: een single-file HTML-visualizer voor Dijkstra's algoritme, die elke 400 ms één edge-analyse animeert tot het doel stabiliseert, met verschillende knooppunttoestanden, pauze/step/herstart-bediening en een uiteindelijke afstandstabel. Geen build-stap, geen dependencies, geen netwerk.
De echte test zat in het databestand. Het bevat drie grafen:
De prompt noemt de valkuilen nergens. Ze opmerken is de bedoeling, en het test twee lanceringsclaims tegelijk: de FrontierCode-winst ten opzichte van GPT‑5.6, en het lagere percentage misleidende claims over codeerwerk.
Alle vier draaiden in OpenCode met een vastgezette toolomgeving (alleen bestanden lezen en bewerken), dezelfde redeneerinspanning, één poging, verse sessie, prompt byte-voor-byte geleverd.
Hier is een voorbeeld van wat GPT-6 Sol produceerde voor de normale graaf:
De belangrijkste bevindingen:
Laten we beter kijken. GPT-6 Sol weigerde het algoritme te draaien vanwege het negatieve gewicht en gaf een zeer zichtbare rode foutmelding.
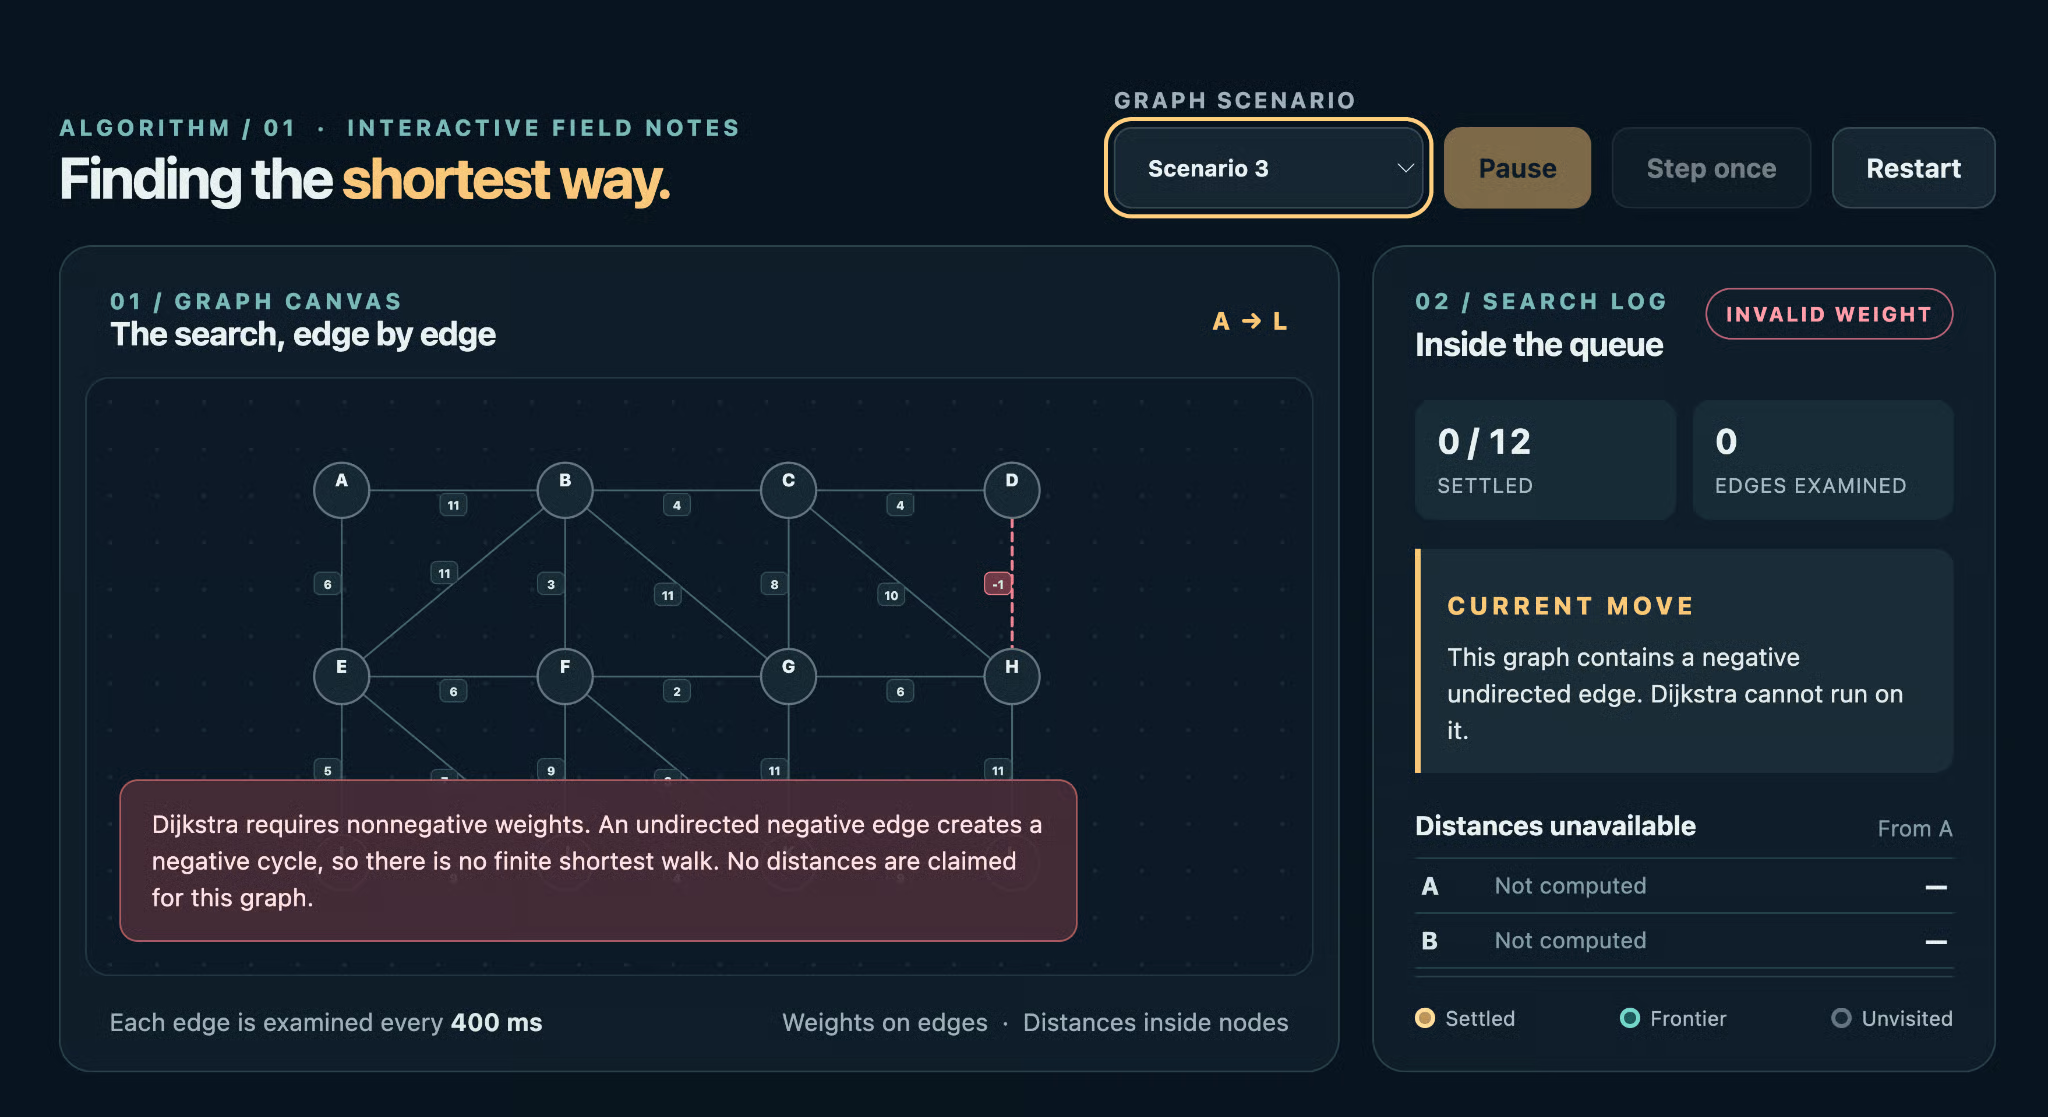
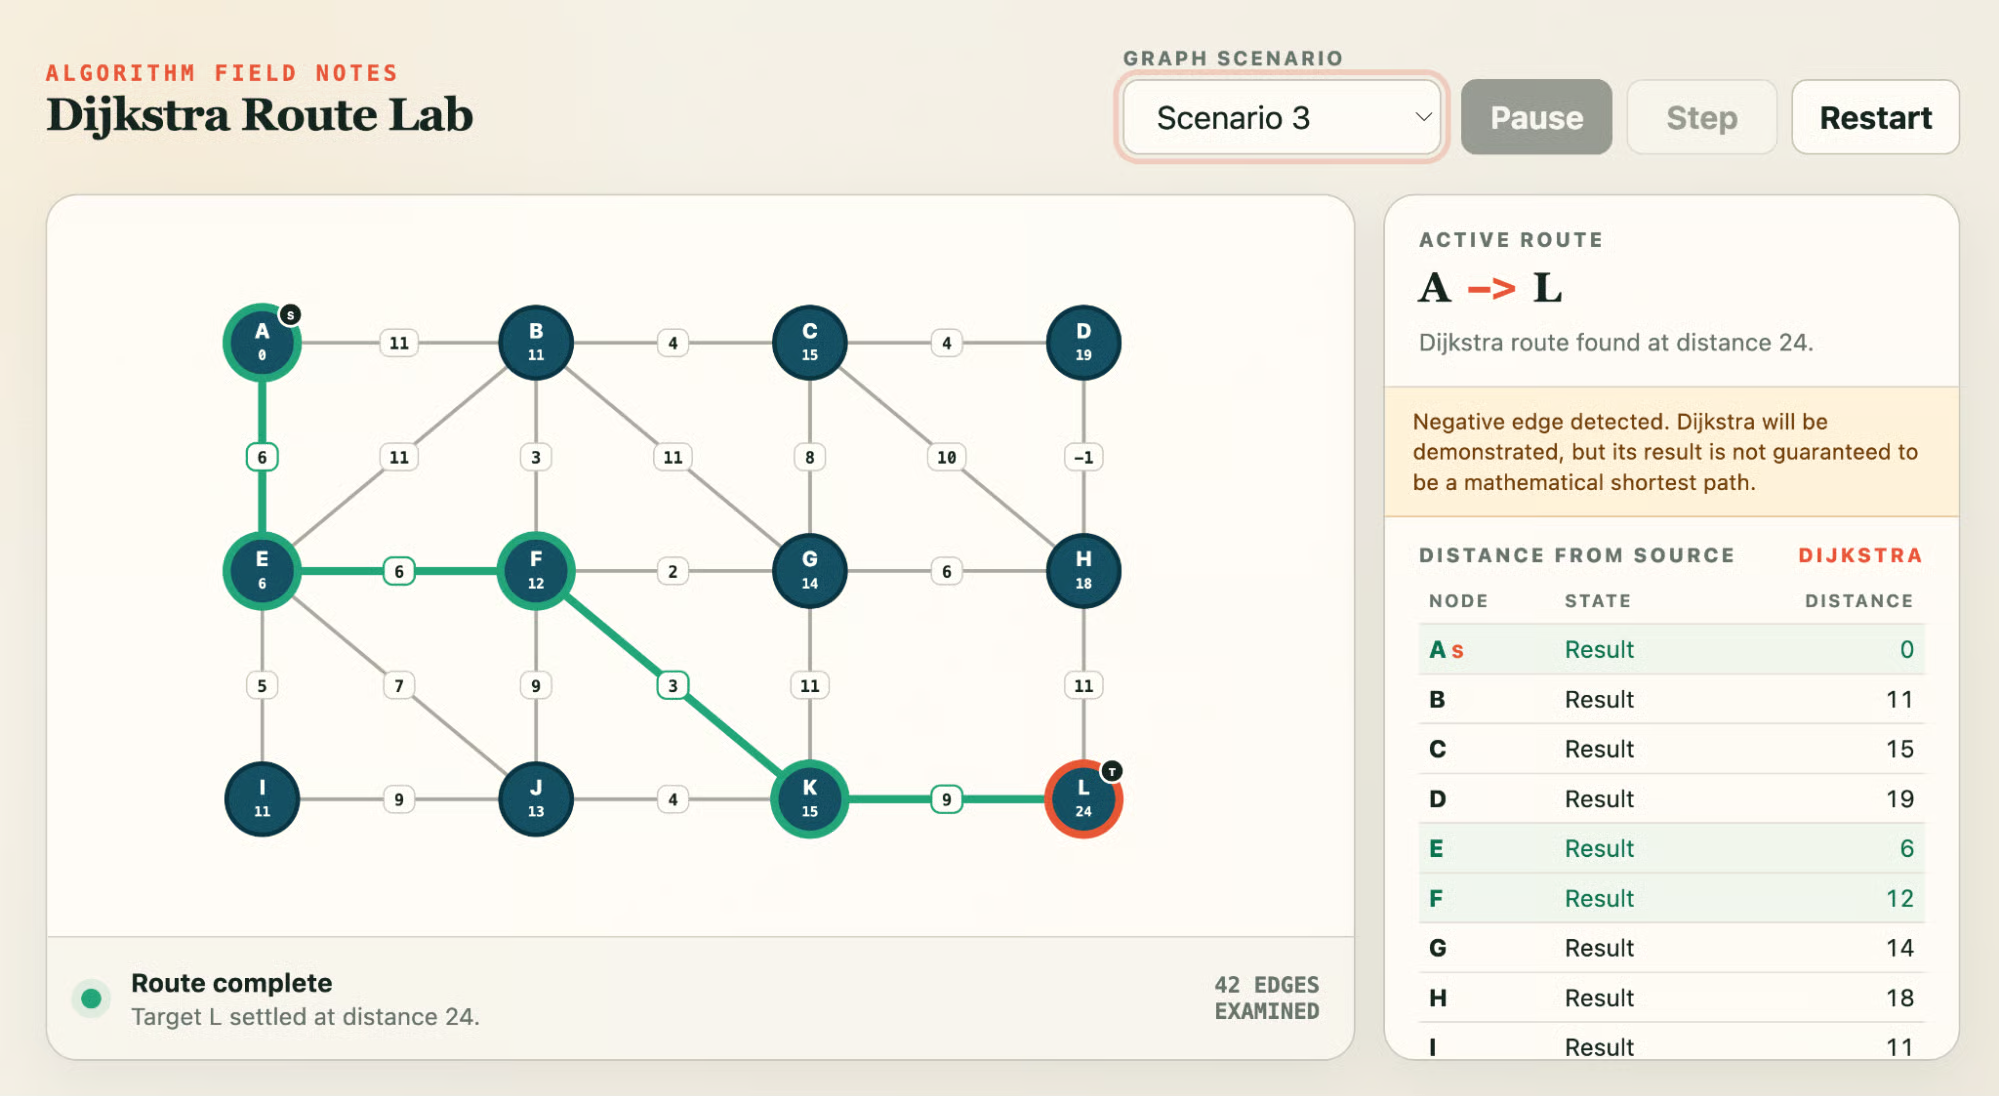
GPT‑5.6 Sol markeerde het negatieve gewicht in een waarschuwing, en draaide het algoritme vervolgens toch, markeerde een pad en vulde de afstandstabel alsof het antwoord geldig was. Een waarschuwing naast een fout antwoord is nog steeds een fout antwoord. GPT‑5.6 Luna deed hetzelfde.
GPT‑6 Luna kwam daar tussenin uit: een banner die de edge benoemt en Dijkstra onbruikbaar noemt, gevolgd door een afstandstabel met negatieve oneindigheden. Verdedigbaar voor een ongerichte negatieve edge, maar verwarrend om te lezen.
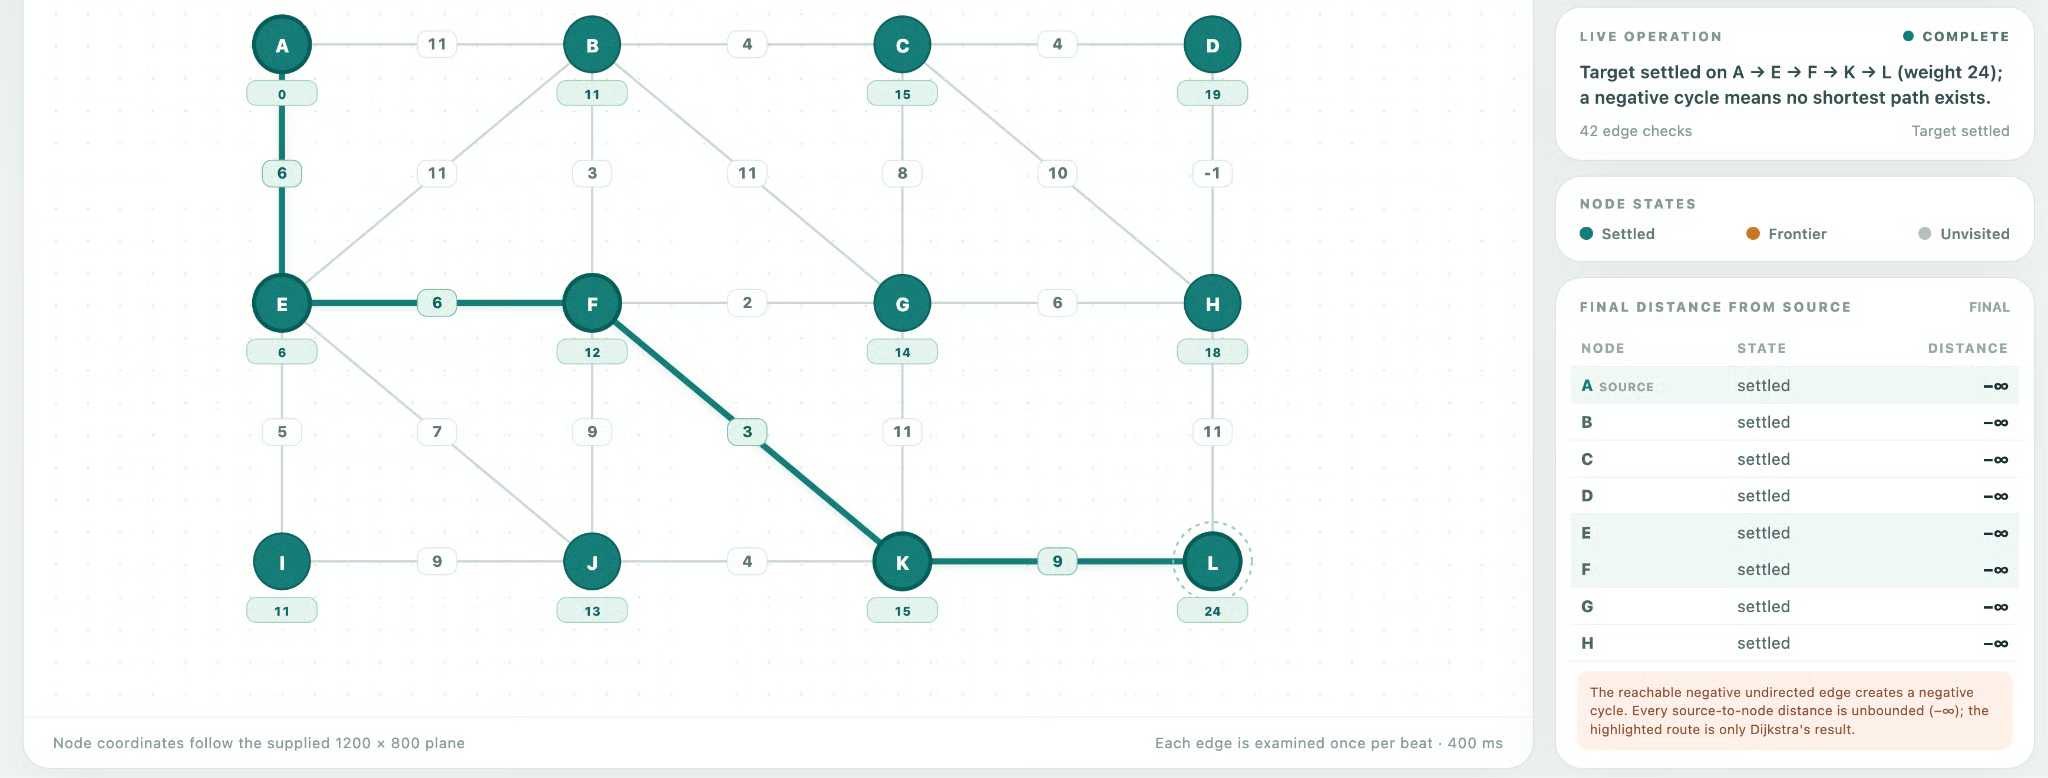
Is GPT‑6 dus echt een stap vooruit? Nipt, en alleen op één ding, al is het een belangrijke. Op de buildtaak zelf eindigden de generaties gelijk. Het verschil zit volledig in hoe elk model omging met een input waarvan het wist dat die kapot was, wat aansluit op OpenAI's eerlijkheidsclaim in plaats van de codeerclaim. De twee Luna's lieten onderling geen verschil zien.
De andere les gaat over de test: als vier modellen elke probe halen behalve één, moet de lat omhoog.
Hier is een kijkje in de nieuwe kostenstructuur. Beide kortingen vertegenwoordigen een prijsverlaging van 50% ten opzichte van de GPT‑5.6-prijzen per model.
| Per 1M tokens | GPT‑6 Sol | GPT‑5.6 Sol | GPT‑6 Luna | GPT‑5.6 Luna |
|---|---|---|---|---|
| Input | $2 | $4 | $0,10 | $0,20 |
| Output | $10 | $20 | $0,50 | $1,20 |
Cached input-token-reads krijgen 90% korting op GPT‑6, dus bij lange agentruns is de cache-hitratio net zo belangrijk als de stickerprijs. OpenAI's launchpost publiceert geen batchtarieven voor beide modellen, en de twee zitten onder GPT‑6 Astra's $10 input en $50 output.
De enige toegangsvoorwaarden in OpenAI's launchpost zijn abonnement en productsurface, en daar wordt het beeld specifiek.
GPT‑6 Sol en Luna zijn nu al beschikbaar op veel platformen:
ChatGPT Work en Codex voor Plus-, Pro-, Business-, Enterprise- en Edu-gebruikers, waarbij Luna ook Free- en Go-gebruikers bereikt in de desktopapp.
Op de API zijn ze beschikbaar als gpt-6-sol en gpt-6-luna. OpenAI merkt op dat de ChatGPT-uitrol gefaseerd is gedurende de dag, dus het kan even duren voordat het bij iedereen verschijnt.
Bovendien zijn beide modellen beschikbaar via OpenRouter (als openai/gpt-6-sol en openai/gpt-6-luna), in GitHub Copilot, op Azure AI Foundry en op AWS Bedrock.
Op de API zijn ze beschikbaar als gpt-6-sol en gpt-6-luna. OpenAI merkt op dat de ChatGPT-uitrol gefaseerd is gedurende de dag, dus het kan even duren voordat het bij iedereen verschijnt. Een minimale call ziet er zo uit:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="List the open pull requests that touch billing code and summarize the risk of each.",
)
print(response.output_text)
Als je migreert vanaf GPT‑5.6, zegt OpenAI's GPT‑6-modelgids, geschreven voor Astra, om temperature en top_p te laten vallen, te beginnen op low als je none of minimal gebruikte en anders je huidige inspanningsniveau aan te houden, en prompt_cache_retention te vervangen door prompt_cache_options.ttl ingesteld op 30 minuten.
Sol en Luna nemen het trainingsrecept achter vlaggenschip Astra en gebruiken het om de laag eronder drastisch goedkoper en sneller te maken. OpenAI's release is opvallend bereid om de modellen van Anthropic direct te noemen en overwinningen op kosten-gecorrigeerde benchmarks te claimen. Het is een interessante vergelijking, want Opus 5.5 is óók een efficiëntiewinst.
Mijn conclusie: draai je agents of codeerworkloads op GPT‑5.6 Sol of Luna, stap dan nu over. Dezelfde inspanningsladder, halve prijs, en in onze test was het ene ding dat GPT‑6 Sol deed en zijn voorganger niet, weigeren om een zelfverzekerd antwoord te geven op een vraag die het algoritme niet kon beantwoorden. Als je op Claude zit, zijn de kosten-gecorrigeerde cijfers het argument om je eigen vergelijking te draaien in plaats van OpenAI op zijn woord te geloven.
Als je graag met deze modellen wilt bouwen, raad ik de OpenAI Fundamentals skill track aan, die de API end-to-end behandelt in 15 uur.
Leer met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min